Les questions de system design surgissent dans bien plus d'entretiens qu'on ne l'imagine. Évidemment pour les rôles backend. Mais aussi en infrastructure, data engineering, et même sur des postes très produits où personne ne vous demandera d'écrire une ligne de code pendant le loop.
Alors, qu'évalue vraiment l'intervieweur ? Pas votre connaissance de « l'architecture correcte » — elle n'existe pas. Il veut voir une pensée structurée, des arbitrages honnêtes, et votre capacité à raisonner quand les contraintes sont floues et que le temps tourne.
Les attentes varient fortement selon le niveau. Un profil junior qui pose de bonnes questions de clarification et esquisse un schéma propre avec quelques boîtes fait un excellent début. Un senior qui ne fait que cela est en difficulté, car à ce niveau on attend des chiffres, des modes de panne, et un avis sur ce qu'il faut construire en premier.
Le rôle compte aussi. Un data engineer sera poussé sur les pipelines et les backfills, un développeur frontend sur le cache et l'état, un profil infra sur les déploiements et le rayon d'impact. Même compétence sous-jacente, vocabulaire différent.
Je souligne cela parce que la plupart des listes de questions ignorent ces deux dimensions et se contentent de déverser 50 sujets. Celle-ci est organisée d'abord par niveau, puis par rôle, avec des questions de scénario à la fin. Si la partie stockage de ces réponses vous semble fragile, notre Database Design course couvre les fondamentaux.
Même structure à chaque fois, environ 45 minutes :
- Clarifier (5 min). Qui l'utilise, ce que cela doit faire, ce qui est hors périmètre, et à quoi ressemble « bien fait ».
- Mettre des chiffres (2 min). Utilisateurs, requêtes par seconde, mix lecture/écriture, croissance du stockage par an. Approximatif vaut mieux que silence.
- Esquisser la vue d'ensemble (10 min). Clients, couche API, stockage, cache, file. Cinq ou six boîtes, pas plus.
- Montrer le modèle de données (5 min). Tables ou collections, clés, et les schémas d'accès qu'elles servent.
- Plonger en profondeur sur une partie (10 min). Laissez l'intervieweur choisir, ou proposez la partie qui vous intéresse le plus.
- Modes de panne et arbitrages (le reste). Ce qui casse, ce que vous surveilleriez, ce que vous construiriez en premier si c'était réel.
Racontez tout à voix haute. Un intervieweur ne peut pas noter une réflexion silencieuse.
Questions de system design pour débutants
Ici, on teste les fondamentaux : clarifier les besoins avant de dessiner quoi que ce soit, produire un schéma d'architecture simple, et faire des choix de stockage sensés. Personne n'attend des algorithmes de consensus à ce stade.
1. Concevoir un raccourcisseur d'URL
Un raccourcisseur transforme une longue URL en un code court et redirige à la visite, donc il faut d'abord statuer sur l'expiration des liens et le volume attendu. Une hypothèse raisonnable : 100 millions de nouveaux liens par mois, avec un ratio lectures/écritures d'environ 100 pour 1.
Ce mix très orienté lecture façonne la conception : un serveur d'API, une base de données, et un cache devant. Pour le code court, soit encoder en base62 un ID auto-incrémenté (sept caractères donnent environ 3,5 billions de combinaisons), soit générer une chaîne aléatoire et vérifier les collisions.
Une seule table suffit : short_code en clé primaire, long_url, created_at, expires_at, et un user_id optionnel. Les codes les plus chauds vivent dans Redis pour que la base ne voie que les misses. Utilisez une redirection 302 si vous voulez des analytics de clics, car les navigateurs mettent en cache une 301 et vous ne voyez jamais la seconde visite.
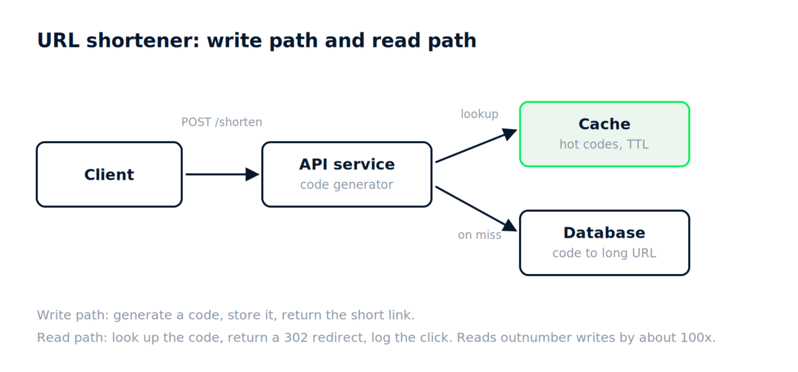
À 10 milliards de liens, vous shardez par code et le générateur d'ID devient le goulot d'étranglement ; si les gens commencent à deviner les codes, passez du séquentiel à l'aléatoire et ajoutez du rate limiting.
2. Concevoir un limiteur de débit basique
Un rate limiter autorise N requêtes par utilisateur et par minute et renvoie un 429 au-delà. La première chose à clarifier est si la limite est par utilisateur, par IP, ou par clé d'API, car cela détermine votre clé de cache.
Trois algorithmes couvrent la plupart des réponses. La fenêtre fixe compte les requêtes dans chaque minute, simple mais permettant jusqu'au double de la limite aux frontières. La fenêtre glissante avec journal stocke chaque timestamp, exact mais gourmand en mémoire. Le seau à jetons se remplit à cadence régulière et laisse passer de petits bursts, raison pour laquelle de nombreuses gateways l'utilisent.
Exécutez le limiteur en middleware dans l'API gateway avec des compteurs dans Redis sous TTL ; INCR plus EXPIRE couvre la version à fenêtre fixe.
Avec dix instances de gateway, soit vous partagez les compteurs Redis, soit vous acceptez un léger surcomptage avec des compteurs locaux. Et décidez à l'avance de ce qui se passe si Redis tombe : fail open avec risque d'abus, ou fail closed et tout le monde est bloqué.
3. Concevoir un magasin clé-valeur simple
Un key-value store a besoin de get, put et delete, et pour une question débutant, restez sur un seul nœud. Une table de hachage en mémoire gère les opérations. Pour la durabilité, écrivez chaque modification dans un journal sur disque avant de l'accuser réception, et faites des snapshots périodiques pour que la reprise n'ait pas à rejouer toute l'histoire.
Ce que l'intervieweur veut entendre, c'est que vous avez séparé le chemin rapide en mémoire du chemin durable sur disque, et que vous comprenez pourquoi le journal vient en premier.
Si les données dépassent la mémoire, la réponse est un arbre LSM, à peu près comme fonctionnent RocksDB et Cassandra. Si vous avez besoin d'un second nœud, le primaire réplique le journal vers un follower, et le hachage cohérent prend le relais au-delà.
4. Concevoir un cache (conceptuel)
Un cache se place entre votre application et un stockage plus lent ; le motif de base est cache-aside. L'app vérifie le cache, manque, lit la base, et réécrit le résultat avec un TTL. Simple, mais l'invalidation est à votre charge.
L'éviction signifie généralement LRU, parfois LFU pour des charges très biaisées. L'indicateur qui compte est le taux de hit ; en dessous de 80 % environ, demandez-vous si le cache aide vraiment.
Là où ça devient intéressant : la fraîcheur. Si la base change et que la copie en cache non, les utilisateurs voient des données anciennes jusqu'à l'expiration du TTL. Des TTL courts réduisent cette fenêtre mais augmentent la charge sur la base.
Quand une clé populaire expire et que 10 000 requêtes frappent la base d'un coup, soit vous regroupez ces requêtes, soit vous rafraîchissez la clé avant son expiration. En write-through versus write-back, le write-through garde le cache correct au prix d'écritures plus lentes, tandis que le write-back est rapide mais perd les écritures récentes si le cache meurt avant de purger.
5. Concevoir un service de notifications basique
Un service de notification envoie des emails, SMS et push, et retente quand un fournisseur échoue. Avant de le concevoir, demandez le volume et si l'ordre de livraison compte — généralement non.
Le cœur du design est une file. Les producteurs y écrivent un événement de notification, et un worker par canal lit les événements et appelle un fournisseur comme SendGrid ou Twilio. Cette séparation distingue la décision de notifier de l'envoi effectif, de sorte qu'un fournisseur SMS lent ne bloque jamais l'app.
Stockez chaque notification avec un statut (pending, sent, failed) et une clé d'idempotence pour qu'un retry n'envoie pas deux fois.
Les utilisateurs qui veulent couper le marketing mais garder les alertes de sécurité nécessitent une table de préférences vérifiée avant toute mise en file, et un fournisseur qui vous limite à 100 messages par seconde impose un throttling par canal côté worker.
6. Concevoir un service simple de stockage de fichiers
Pensez à Dropbox à petite échelle. Les utilisateurs téléversent un fichier, obtiennent un lien, et le téléchargent plus tard. Clarifiez la taille max et l'importance du partage.
Les métadonnées (propriétaire, nom, taille, checksum, date de création) vont dans une base relationnelle. Les octets vont en stockage objet type S3, jamais dans la base. Pour les uploads, l'API renvoie une URL pré-signée pour que le client écrive directement dans le stockage objet et que vos serveurs ne touchent jamais le fichier.
Deux utilisateurs qui téléversent le même fichier de 2 Go posent un problème de déduplication résolu en hachant le contenu, et les fichiers de plus de 5 Go nécessitent un upload multipart avec checksum par chunk.
7. Concevoir un classement de jeu
Un leaderboard doit mettre à jour le score d'un joueur, renvoyer le top 10, et donner le rang d'un joueur ; commencez par demander combien de joueurs et la fréquence des changements.
Une table relationnelle avec un index sur le score fonctionne jusqu'à un point, mais « quel est mon rang » devient un COUNT sur tous ceux au-dessus de vous. Les ensembles triés Redis règlent cela : ZADD pour mettre à jour, ZREVRANGE pour le top N, ZREVRANK pour un joueur donné, le tout en temps logarithmique.
Des classements quotidien et « tous temps » sont un ensemble trié par période, avec une clé du type lb:2026-09-14. Si 50 millions de joueurs poussent la mémoire Redis trop loin, gardez seulement le top 100k là et le reste dans la base.
Questions de system design intermédiaires
À ce niveau, l'intervieweur suppose que vous avez construit et opéré de vrais systèmes. Les questions introduisent les files, le scaling lecture/écriture, et la tension entre latence, coût et cohérence.
8. Concevoir un fil d'actualités
Un feed doit permettre de publier, de suivre d'autres comptes, et de lire ce qu'ils écrivent, en ordre antéchronologique ou classé. Supposez 10 millions d'utilisateurs actifs quotidiens ouvrant cinq fois par jour, soit environ 600 lectures par seconde en moyenne et bien davantage aux pics.
Le choix central est le moment d'assembler le feed. Le fan-out à l'écriture pousse chaque nouveau post dans le feed pré-calculé de chaque abonné, avec des lectures rapides au prix d'écritures coûteuses. Le fan-out à la lecture assemble à la demande, arbitre inverse. La plupart des systèmes réels mixent : fan-out à l'écriture pour les utilisateurs « normaux » et à la lecture pour les comptes à des millions d'abonnés.
Le modèle de données comprend posts, follows, et une liste de feed par utilisateur dans Redis contenant des IDs de posts. Paginez avec un curseur sur l'ID plutôt qu'un offset.
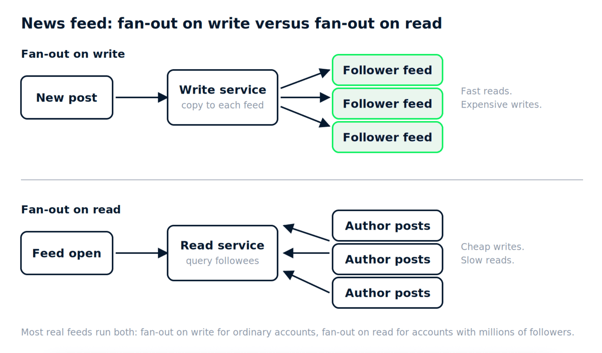
Ajouter du ranking ensuite n'impose pas de tout reconstruire ; vous scorez les IDs candidats de la liste au moment de la lecture.
9. Concevoir un système de chat avec synchronisation multi-appareils
Le chat multi-appareils implique des messages 1:1 et de groupe, la livraison sur tous les appareils d'un utilisateur, et un historique qui survit à un changement de téléphone. Supposez 50 millions d'utilisateurs quotidiens envoyant ~40 messages chacun, soit 2 milliards par jour, environ 23 000 écritures par seconde en moyenne et plusieurs fois plus aux pics régionaux.
Chaque client maintient un WebSocket vers un serveur de chat, qui écrit les messages dans un store partitionné par ID de conversation, avec un numéro de séquence croissant par conversation. Chaque appareil mémorise le dernier numéro vu et demande les nouveaux à la reconnexion — c'est ce qui permet la sync multi-appareils.
Le store doit supporter un débit d'écriture élevé et des lectures par plage sur la conversation ; des bases en colonnes larges comme Cassandra sont la réponse courante. Les accusés de livraison et de lecture sont de petits événements qui rebroussent le même chemin.
Quand deux amis sont connectés à des serveurs différents, un pub/sub entre serveurs ou un service de routage qui mappe les utilisateurs aux serveurs achemine le message. Des groupes de 500 diffusent côté serveur, et garantir l'ordre devient plus délicat.
10. Concevoir un service d'appariement pour VTC
Gardez-le plus léger que la version senior. Les chauffeurs envoient leur position toutes les quelques secondes, les passagers demandent une course, et le service doit retourner un chauffeur proche en quelques secondes.
Les mises à jour de position sont le problème de volume : 200 000 chauffeurs actifs avec une mise à jour toutes les 4 secondes, c'est 50 000 écritures par seconde. Stockez les positions courantes en mémoire indexées par geohash ou cellule H3, pas dans une table relationnelle. Le matching devient « trouvez les chauffeurs dans ma cellule et les voisines », classez par ETA, et verrouillez un chauffeur pour éviter un double-assignement.
Si un chauffeur accepte puis perd la connexion, le verrou expire et le passager est réassigné. Une cellule chaude en centre-ville se subdivise plus finement dans les zones denses — exactement ce que fournissent des index hiérarchiques comme H3.
11. Concevoir un système de collecte de métriques
Un système de métriques reçoit quelques centaines de mesures toutes les 10 secondes de milliers de serveurs et permet des requêtes en dashboards.
Des agents batchent les métriques et poussent vers une couche d'ingestion, qui écrit dans une base de séries temporelles (ou un Kafka avec des consommateurs qui y écrivent). Le stockage est étagé : résolution brute sur un ou deux jours, agrégats à la minute pour un mois, à l'heure pour un an. Le downsampling tourne en tâche de fond.
Les requêtes tapent l'agrégat qui correspond à la plage de temps demandée, ce qui évite à un graphe 30 jours de scanner la donnée brute. La cardinalité des tags (par ex. un ID utilisateur en label) peut tuer la base — dites-le explicitement.
Push ou pull ? Prometheus tire, mais le push marche mieux à travers des firewalls et pour des jobs éphémères. Un agent qui rapporte des timestamps hors ordre est accepté dans une fenêtre de retard bornée puis rejeté au-delà, avec un compteur de rejets pour qu'une horloge fautive soit visible.
12. Concevoir un système d'autocomplétion de recherche
L'autocomplétion renvoie les cinq meilleures propositions en ~100 millisecondes à chaque frappe. Précisez si les suggestions sont globales ou personnalisées — la personnalisation change tout.
La réponse est de pré-calculer. Un pipeline offline agrège les logs de requêtes, compte les fréquences, et construit un trie (ou une table préfixe-vers-top-k) où chaque nœud stocke déjà ses meilleures complétions. La couche de service fait alors une seule lookup par frappe, et toute la structure tient en mémoire sur quelques réplicas.
Les mises à jour se font en batch, peut-être à l'heure, en reconstruisant la structure et en la basculant. Les tendances en temps réel peuvent être gérées par une petite surcouche fusionnée à la requête.
Un préfixe comme « a » toucherait un énorme sous-arbre, d'où le stockage top-k à chaque nœud plutôt que la traversée. Les fautes de frappe nécessitent un index flou dédié, sinon vous acceptez le miss.
13. Concevoir un ordonnanceur de jobs distribué
Un ordonnanceur distribué, c'est cron à l'échelle d'une entreprise : définir un job et un horaire, l'exécuter à l'heure et au plus une fois par tick, retenter en cas d'échec, et exposer l'historique.
Stockez définitions et horaires en base. Un service de planification calcule la prochaine exécution et pousse les jobs dus dans une file ; des pools de workers tirent et exécutent. Le point délicat est d'exécuter exactement une instance de scheduler par job sans point unique de défaillance, ce qui implique généralement une élection de leader (un verrou dans ZooKeeper, etcd, ou une ligne en base avec bail).
Enregistrez chaque exécution avec statut, heure de début, de fin, et l'emplacement des logs. Cette table devient l'écran que tout le monde consulte.
Un job plus long que son intervalle doit sauter, mettre en file, ou se chevaucher — et cela doit être configurable. Dès que le job B dépend du job A, les dépendances forment un DAG et le scheduler n'enfile qu'après succès de l'amont.
Questions de system design avancées
Niveau senior. Échelles massives, multi-région, objectifs de fiabilité chiffrés, et le coût de chaque décision. L'intervieweur s'attend à ce que vous évoquiez spontanément les modes de panne.
Le streaming vidéo, ce sont deux systèmes sous un même nom. À l'upload, l'utilisateur envoie un fichier brut et un pipeline le transcode en plusieurs résolutions et bitrates, le découpe en segments de quelques secondes, et stocke ces segments en objet. À la lecture, un CDN sert ces segments et le lecteur adapte le bitrate à la bande passante — c'est le streaming adaptatif via HLS ou DASH.
Annoncez l'échelle : des centaines d'heures uploadées par minute, des milliards de vues par jour, du stockage en exaoctets. Le transcodage est massivement parallélisable, donc une grande flotte de workers tire des jobs d'une file. Les métadonnées — titre, propriétaire, vues — vivent dans une base shardée avec un cache intensif, car la page d'accueil les lit constamment. Le stockage objet et les edges CDN sont répliqués entre régions, et le SLO clé est le temps de démarrage de lecture, la métrique ressentie étant le taux de rebuffering.
Les compteurs de vues d'une vidéo virale sont des compteurs approximatifs agrégés en batch, jamais un incrément en base par vue, et la détection de copyright est un fingerprinting dans le même pipeline d'upload.
Une plateforme de logs ingère les logs de chaque service, les rend consultables en quelques secondes, et les conserve 30 jours en chaud et un an en froid.
Des agents suivent les fichiers de log et les envoient vers un tampon durable type Kafka, qui absorbe les pics et permet aux indexeurs de prendre du retard sans perte. Les indexeurs écrivent vers un cluster de recherche avec un index par jour et par service, et les anciens index descendent en fichiers compressés dans du stockage objet.
Le coût est la vraie contrainte : indexez les champs structurés et gardez le texte brut bon marché. Donnez un quota à chaque service, surveillez le retard d'indexation, et nettoyez les PII à l'ingestion.
Un service qui loggue à 100x son volume normal est d'abord limité par quota, puis échantillonné, puis drop, puis alerté — dans cet ordre. Les requêtes inter-régions impliquent une recherche fédérée, chaque région gardant ses données.
16. Concevoir un système d'analytics en temps réel
L'analytics temps réel signifie des dashboards affichant des agrégats sur les dernières minutes, mis à jour en quelques secondes, au-dessus d'un flux d'un million d'événements par seconde peut-être.
Un processeur de flux comme Flink maintient des agrégats fenêtrés — par exemple des comptes par minute par dimension — et les écrit dans un store à lecture rapide comme ClickHouse ou Druid. Les dashboards interrogent ce store, jamais le flux brut.
Citez les arbitrages : comptes exacts versus HyperLogLog pour les distincts, fenêtres tumbling versus sliding, et watermarks pour les événements en retard. Fixez un SLO de fraîcheur et suivez le lag du processeur par rapport à celui-ci.
Une dimension à forte cardinalité comme l'ID utilisateur fait exploser la table d'agrégats, donc interrogez les événements bruts pour celle-là. Un backfill après un bug se fait en rejouant depuis le flux avec offsets retenus.
17. Concevoir un système de paiement
Les paiements sont le seul design où la justesse prime l'échelle. Le système doit débiter un client, l'enregistrer, ne jamais doubler, ne jamais perdre un enregistrement, et se réconcilier quotidiennement avec la banque.
L'idempotence porte l'essentiel : chaque requête a une clé, et le service stocke le résultat associé et renvoie le même en cas de retry. L'argent circule via un grand livre en double entrée, append-only, où les écritures d'une transaction somment à zéro, dans une base relationnelle à isolation sérialisable. Ici, l'éventuelle cohérence est une mauvaise réponse.
Les appels au réseau cartes peuvent expirer de manière ambiguë ; les débits passent en statut pending et un job de réconciliation les règle. Multi-région signifie une région « maison » par compte, jamais d'écritures actives-actives sur le même solde.
Multi-devises implique des montants entiers en unités mineures avec un code devise, et un remboursement arrivant avant le règlement du débit est géré par une machine à états avec transitions explicites.
18. Concevoir un système de messagerie à grande échelle
Un système de messagerie à grande échelle permet aux producteurs de publier et aux consommateurs de s'abonner, survit aux redémarrages des brokers, et préserve l'ordre là où c'est nécessaire, à des millions de messages par seconde.
Partitionnez chaque topic pour que les messages avec la même clé atterrissent sur la même partition — vous obtenez un ordre par clé sans ordre global. Chaque partition est un journal append-only répliqué sur quelques brokers, et les consommateurs valident leur offset après traitement.
Par défaut, livraison au moins une fois avec des consommateurs idempotents. Les retries passent par un topic de retry avec backoff et les messages « poison » vont dans une dead-letter queue. Le lag consommateur est le signal sur lequel poser un SLO, et entre régions, une région doit posséder les écritures par clé sinon l'ordre se réinversera.
Un consommateur qui crash après traitement mais avant de commit produit un doublon — d'où l'importance de l'idempotence. Les tempêtes de rééquilibrage se calment avec l'assignation sticky et le rebalancing coopératif.
Questions de system design pour ingénieurs backend
Ici, on se concentre sur les APIs, les modèles de données, et les limites de service. Attendez-vous à des relances sur la cohérence, le caching, et ce que vous journaliseriez.
19. Concevoir un service d'authentification et d'autorisation
L'authentification répond « qui êtes-vous » et l'autorisation « que pouvez-vous faire », et les candidats qui séparent bien les deux marquent des points.
Utilisez OAuth 2.0 et OpenID Connect plutôt que d'inventer un protocole. Émettez des tokens d'accès de courte durée et des tokens de rafraîchissement plus longs stockés côté serveur pour pouvoir les révoquer. Les permissions vivent dans un modèle de rôles vérifié par une petite librairie ou un service de politiques. Logguez chaque tentative de login, refresh et refus avec IP et appareil, sans jamais journaliser les tokens eux-mêmes.
Les JWT évitent un lookup à chaque requête, mais les révoquer tôt impose une denylist, qui réintroduit la lookup. Le credential stuffing se freine par rate limiting par IP et par compte, délais après échecs répétés, et second facteur sur les connexions suspectes.
20. Concevoir une API gateway
Une API gateway est un point d'entrée unique devant vos services qui prend en charge les préoccupations transverses pour éviter de les dupliquer : routage par chemin et version, terminaison TLS, authentification, rate limiting, et logs de requêtes.
La gateway elle-même doit être sans état et scaler horizontalement derrière un load balancer. La configuration de routage vit dans un plan de contrôle et est poussée aux instances, pour ne jamais redéployer la gateway à chaque ajout de route. Les tokens d'auth sont validés une fois à l'edge et la gateway propage l'identité utilisateur via un header.
Prononcez « rayon d'impact ». La gateway est sur tous les chemins de requêtes ; une mauvaise conf peut tout faire tomber. Validez les configs, déployez progressivement, et gardez la logique propre et mince côté gateway.
La gestion de versions sans casser des clients mobiles non mis à jour passe par le versioning dans le chemin ou le header, avec maintien des anciennes versions. Et la gateway ne doit pas agréger des réponses de plusieurs services ; cela relève d'une couche backend-for-frontend.
21. Concevoir un système de commande pour e-commerce
Un système de commandes crée une commande, réserve le stock, encaisse, expédie, et permet au client de voir le statut. Les commandes sont une machine à états (created, paid, packed, shipped, delivered, cancelled), avec transitions autorisées explicites.
La création est un POST avec clé d'idempotence pour qu'un double-clic ne crée pas deux commandes. La réservation de stock et le paiement impliquent d'autres services — utilisez une saga : chaque étape publie un événement et les échecs déclenchent des compensations (libérer le stock, rembourser). Écrivez l'événement dans une table outbox dans la même transaction que la mise à jour de commande pour éviter toute divergence entre base et bus de messages.
Côté lecture, une table orders plus une table order_items, avec un résumé matérialisé en cache pour la page « mes commandes ».
Deux clients qui achètent la dernière unité en même temps sont arbitrés par un verrou de ligne ou un décrément atomique du stock ; l'un reçoit une rupture de stock. À surveiller : les commandes bloquées trop longtemps dans un état.
22. Concevoir un service de feature flags
Un service de feature flags bascule des fonctionnalités par environnement, cible par attributs utilisateur ou pourcentage, et permet de couper globalement en quelques secondes quand ça casse.
Les définitions et règles vivent dans une petite base derrière une API d'admin. Les applications embarquent un SDK qui récupère tous les flags au démarrage, les met en cache localement, et évalue les règles en process, pour qu'un check de flag ne coûte rien sur le chemin de requête. Les mises à jour se propagent via une connexion streaming ou polling court, et le SDK conserve le dernier état connu si le service de flags est indisponible.
Les pourcentages se calculent via un hash stable de l'ID utilisateur et de la clé du flag, pour garder le même côté pour un même utilisateur.
Les flags périmés sont repérés via les derniers timestamps d'évaluation et des rappels aux propriétaires, et si le service est down au démarrage, l'application retombe sur les valeurs par défaut embarquées.
23. Concevoir une API de recommandation
Une API de recommandation renvoie 20 items pour un utilisateur en moins de 100 ms à quelques milliers de requêtes par seconde, sans avoir besoin de ML avancé pour la concevoir.
Séparez offline et online. Un job offline calcule des listes candidates par utilisateur dans un KV à faible latence. L'API en ligne les récupère, rerank avec quelques features fraîches comme l'état de stock, filtre ce qui a déjà été acheté, et renvoie la liste. Gardez un fallback d'articles populaires par catégorie, et logguez chaque liste servie avec un ID de requête pour la relier aux clics plus tard.
Un nouvel utilisateur obtient le fallback jusqu'à quelques interactions. Les 100 ms se répartissent grossièrement en 10 pour la lecture, 30 pour le rerank, 10 pour la sérialisation, et 50 de marge.
Questions de system design pour l'infrastructure / DevOps
Fiabilité, déploiement, automatisation, observabilité. Le fil rouge : comment changer en sécurité et savoir vite quand on s'est trompé.
24. Concevoir un pipeline CI/CD pour microservices
Un pipeline CI/CD pour microservices doit gérer des dizaines de services déployables indépendamment avec tests, contrôles de sécurité, et une voie vers la production qui n'exige pas un humain à 3 h du matin.
Build once, deploy same artifact partout. Le pipeline lint, lance les tests unitaires, construit une image container taguée par le SHA du commit, la scanne, et la pousse au registre. Le déploiement promeut ensuite cette image à travers les environnements (dev, staging, prod) via configuration sans reconstruire.
La mise en production doit être progressive : canary sur quelques pourcents de trafic, surveiller taux d'erreur et latence pendant une fenêtre définie, puis continuer ou rollback automatique. Le rollback, c'est redéployer le tag précédent — rapide car vous n'avez rien rebâti.
Quand le changement du service A casse le contrat du service B, la solution est des tests de contrat en CI et des changements d'API rétro-compatibles. Monorepo versus multi-repos importe moins qu'on ne le croit, tant que le pipeline ne construit que ce qui a changé.
25. Concevoir une supervision et une alerte centralisées
La supervision centralisée rassemble métriques, logs et traces de chaque service au même endroit, avec des alertes qui ne réveillent les gens que quand les utilisateurs sont affectés.
Les métriques vont dans un store séries temporelles, les logs dans la plateforme de la question 15, les traces dans un backend de tracing — le tout corrélé par un ID de requête partagé. La décision clé est ce sur quoi alerter. Alertez sur les symptômes (taux d'erreur, percentiles de latence, saturation) liés aux SLOs, pas sur des causes comme « CPU à 80 % ».
La fatigue d'astreinte tue les rotations : chaque page doit avoir un runbook et une revue. Toute alerte qui page deux fois en une semaine sans action claire est rétrogradée en ticket.
Un SLO pour un service tout neuf se déduit en mesurant quelques semaines puis en fixant un objectif légèrement meilleur que l'actuel. Et quand la supervision elle-même est down, des checks synthétiques externes et une alerte « homme mort » vous préviennent.
26. Concevoir une gestion des secrets
La gestion des secrets rend disponibles mots de passe base, clés d'API, certificats aux services à l'exécution, jamais en code source, avec rotation régulière et audit.
Un store central (HashiCorp Vault, secrets manager cloud) contient tout. Les services s'y authentifient via leur identité de workload (compte de service Kubernetes, rôle IAM), jamais un token longue durée, et récupèrent les secrets au démarrage ou à la demande. Préférez les secrets dynamiques quand c'est possible : le store génère une crédential base valide une heure — la rotation est gratuite.
Auditez chaque lecture. Et documentez une voie « briser la vitre » quand le store lui-même est down — cela arrivera.
Une clé commitée par erreur est détectée en CI, immédiatement rotatée, et traitée comme compromise quoi qu'il arrive. Les secrets en variables d'environnement sont fréquents mais fuient via dumps et processus enfants — montez-les en fichiers ou récupérez-les en process.
27. Concevoir l'autoscaling et une stratégie de déploiement
Autoscaling et rollout doivent ensemble permettre à un service d'encaisser des variations quotidiennes x5 sans intervention manuelle, tout en déployant plusieurs fois par jour.
Scalez sur un signal corrélé à la douleur utilisateur — souvent le taux de requêtes ou la latence par instance — plutôt que sur CPU seul. Fixez des réplicas minimum pour qu'un cold start n'affronte pas un pic, et un maximum pour qu'un bug ne vous ruine pas. Scale up rapide, scale down lent.
Pour le rollout, utilisez blue/green quand vous voulez un switch et un rollback instantanés, et canary quand vous voulez observer un petit pourcentage réel d'abord. Combinez canary et autoscaler avec soin, car un canary qui scale indépendamment peut biaiser la comparaison.
Si le scaling accuse deux minutes de retard sur un pic soudain, un scaling prédictif programmé ou un minimum plus haut comble la brèche. Et 50 nouvelles instances qui épuisent les connexions base illustrent pourquoi le pooling doit vivre dans un proxy.
Questions de system design pour data engineers
Pipelines, formats de stockage, batch versus streaming, et fiabilité de la donnée. Même cadre qu'avant, mais les échecs portent sur la perte, la duplication, ou le retard des données plutôt que des requêtes.
28. Concevoir un pipeline d'ingestion d'événements
Un pipeline d'ingestion reçoit des événements comportementaux des clients web et mobile et les rend requêtables en moins d'une heure. Supposez 50 000 événements/s au pic, avec des clients hors ligne qui retentent.
Les clients batchent via un SDK et postent vers un collecteur qui valide contre un registre de schéma et écrit dans un stream (Kafka ou équivalent managé). Un consommateur dépose les bruts en stockage objet partitionné par heure, en format colonne type Parquet. Les jobs aval lisent là-dedans.
Les retries impliquent des doublons, donc chaque événement porte un UUID généré côté client et le job de landing déduplique dans une fenêtre. Les changements de schéma passent par le registre avec vérification de compatibilité — une app mobile ancienne enverra l'ancien format des mois durant.
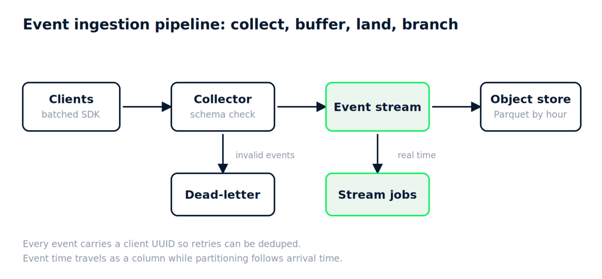
Un événement avec un timestamp d'il y a trois jours atterrit par heure d'arrivée, conserve son heure d'événement en colonne, et laisse l'aval décider. Les événements invalides vont dans une dead-letter path et ne sont jamais jetés silencieusement.
29. Concevoir un système d'ETL streaming
Le streaming ETL transforme les événements à l'arrivée, les joint avec des données de référence, et écrit les résultats dans un store de service en quelques secondes.
Un processeur de flux lit depuis le topic d'ingestion, applique les transformations, et enrichit avec des référentiels chargés en mémoire et rafraîchis périodiquement. L'état (pour les joins fenêtrés ou agrégations) est checkpointé dans un stockage durable pour qu'un crash reprenne sans tout retraiter.
L'arbitrage attendu : exactly-once versus at-least-once. Exactly-once est atteignable de bout en bout si le sink supporte des transactions ou écritures idempotentes, mais au prix de latence et de complexité. At-least-once avec des sinks idempotents offre l'essentiel des bénéfices.
Les données en retard se gèrent avec watermarks et une période de grâce définie, au-delà elles vont dans une table late-arrivals.
Des référentiels qui changent en cours de flux doivent être versionnés, avec la jointure sur la version valide au temps de l'événement. Un backfill six mois après un correctif de logique se rejoue depuis le brut en batch, pas via le stream.
30. Concevoir un data warehouse et l'approche de modélisation
Un entrepôt doit offrir aux analystes et dashboards des métriques cohérentes entre ventes, marketing et produit, avec l'historique conservé.
Atterrissez les données brutes inchangées en bronze, nettoyez et conformez en silver, et construisez les tables métier en gold. Modélisez l'or en schéma en étoile : tables de faits au grain le plus fin utile (par ex. une ligne par ligne de commande) et dimensions pour clients, produits, dates. Les dimensions à évolutions lentes reçoivent un traitement Type 2 quand l'historique importe — un changement de région client ne réécrit pas le CA de l'an passé.
Partitionnez les grands faits par date, regroupez par colonnes de filtrage usuelles, et mettez les transformations en contrôle de version (dbt ou équivalent) avec tests.
Quand deux équipes définissent différemment « client actif », une couche de métriques avec une définition unique tranche. Un fait arrivant en retard qui référence une clé de dimension non encore présente obtient une ligne dimension placeholder, backfillée plus tard.
31. Concevoir un feature store
Un feature store calcule des features une fois et les réutilise pour l'entraînement et la prédiction temps réel, sans décalage entraînement/service. C'est deux stores pour une définition : l'offline (entrepôt ou lac) tient l'historique pour les jeux d'entraînement, l'online (Redis, DynamoDB) tient la dernière valeur par entité pour des lookups à faible latence à l'inférence.
Une définition unique pilote les deux, et un job matérialise de l'offline vers l'online selon un planning.
Le concept critique est la justesse point-in-time. En construisant un training set, chaque ligne doit utiliser les valeurs telles qu'elles existaient au timestamp de la ligne, pas les actuelles. Sinon, votre modèle apprend du futur et paraît excellent jusqu'à sa mise en prod.
Une feature coûteuse à calculer en temps réel est soit pré-calculée avec un peu de staleness, soit calculée à l'écriture. Pour garantir la concordance online/offline, échantillonnez et comparez, et logguez les features réellement servies.
32. Concevoir une couche de qualité et de lignage des données
Une couche qualité/lignage détecte les données cassées avant les dashboards et répond à « d'où vient cette colonne » sans lire le code.
Les checks qualité tournent comme étapes de pipeline : comptes de lignes vs fourchettes attendues, taux de null, fraîcheur (la partition est-elle arrivée à l'heure), et quelques assertions métier (le revenu n'est jamais négatif). Les échecs bloquent l'aval et alertent le propriétaire. Stockez les résultats dans le temps pour voir les dérives, pas seulement le statut du jour.
Le lignage est capturé depuis le code de transformation (parsing SQL, ou métadonnées de l'orchestrateur) et stocké en graphe : table-à-table, colonne-à-colonne si possible. Ce graphe alimente l'analyse d'impact quand on veut supprimer une colonne.
Si les checks durent plus que le pipeline, échantillonnez ou exécutez les lourds en asynchrone et alertez plutôt que de bloquer. Le lignage entre outils qui ne se parlent pas passe par OpenLineage ou des annotations manuelles, avec les lacunes documentées.
Questions de system design pour frontend / full-stack
Performance client, gestion d'état, caching, et dialogue navigateur-API. Les basiques de sécurité apparaissent aussi.
33. Concevoir l'architecture d'une web app à fort trafic
Ici, une web app à fort trafic signifie un site riche en contenu, des millions de visiteurs quotidiens, un premier rendu rapide, et des sections personnalisées pour les connectés.
Les assets statiques vont sur un CDN avec un cache long et des noms de fichiers hashés. Les pages identiques pour tous sont rendues côté serveur et cachées en edge ; les parties personnalisées chargent côté client après le shell. Ce mode hybride garde un TTFB bas sans servir de données perso périmées.
Les appels API côté client passent par la gateway avec des tokens de courte durée. Réglez les headers de cache consciemment : Cache-Control avec stale-while-revalidate pour du contenu tolérant quelques secondes de retard, no-store pour toute donnée personnelle.
Pour un dashboard derrière login, le rendu client est souvent suffisant — le SSR n'apporte pas grand-chose sans SEO. Et une clé de cache qui inclut par erreur le cookie de session donne une copie par utilisateur, et le taux de hit s'effondre.
34. Concevoir une synchronisation offline-first
Offline-first signifie une app de prise de notes ou de saisie terrain qui fonctionne sans connexion et se synchronise au retour, sans perdre les modifications de quiconque.
Chaque écriture va d'abord dans un store local (IndexedDB, SQLite sur mobile) et dans une file de mutations en attente. Quand la connectivité revient, le client pousse la file dans l'ordre et tire les changements depuis son dernier jeton de sync. Chaque mutation porte un ID client et un numéro de séquence pour permettre la déduplication côté serveur.
Les conflits sont le cœur du sujet. Last-write-wins est simple et perd des données. La fusion au niveau champ couvre la plupart des cas.
Les CRDT offrent des fusions automatiques pour texte et listes au prix de complexité ; je ne les choisirais que si l'édition collaborative est un vrai besoin.
Un utilisateur qui édite sur deux appareils hors ligne, puis les ramène, voit les deux éditions appliquées, le conflit signalé, et l'UI l'afficher. Une file en attente qui atteint 10 000 mutations doit être compactée — dix éditions d'un même champ deviennent une.
35. Concevoir des mises à jour d'UI en temps réel
Des mises à jour d'UI en temps réel signifient un dashboard ou un chat qui reflète les changements serveur en une seconde pour des milliers d'utilisateurs concurrents.
Choisissez le transport selon la direction. Server-Sent Events quand les données ne vont que serveur→client (scores en direct, notifications) ; WebSockets quand le client envoie aussi beaucoup (chat, édition collaborative). Long polling en repli pour les réseaux qui bloquent les deux.
Côté serveur, une couche pub/sub diffuse vers le serveur de connexions qui tient l'utilisateur. Côté client, gérez la reconnexion avec backoff et reprise depuis le dernier event ID pour qu'une coupure ne fasse pas rater une mise à jour. Throttlez le rendu : 50 updates/s sur un graphique doivent être batchés en quelques repaints, pas 50.
100 000 utilisateurs regardant un live, c'est du fan-out serveur, éventuellement via un CDN supportant le streaming. Authentifier un WebSocket passe par un token dans le handshake initial, revalidé périodiquement.
Objectif : un dashboard analytique avec 20 graphiques qui charge en moins de 3 secondes et reste fluide pendant le filtrage.
Ne récupérez pas 20 graphiques d'un coup. Chargez d'abord les visibles, lazy-loadez le reste au scroll, et affichez des squelettes plutôt que des spinners. Pré-agrégez côté serveur pour que le client reçoive quelques centaines de lignes par graphique, jamais les événements bruts.
Cachez les résultats des requêtes en mémoire, indexés par l'état des filtres, pour éviter de refetch en cas d'allers-retours.
Les tables à milliers de lignes nécessitent la virtualisation (ne rendre que l'écran). Les calculs lourds vont dans un web worker pour libérer le thread principal.
Si l'API est lente et que vous ne pouvez pas la changer, cachez agressivement, montrez des données périmées avec horodatage, et rafraîchissez en arrière-plan. Des erreurs CORS quand le dashboard appelle une nouvelle API signifient que l'API doit autoriser l'origine du dashboard — soyez capable d'expliquer les preflight.
Questions de system design basées sur des scénarios
Ici, on teste votre jugement plus que l'architecture. Les besoins changent, la production casse, et l'intervieweur veut voir comment vous priorisez.
37. Le trafic explose x10 du jour au lendemain. Que changez-vous en premier ?
Commencez par ce qui casse en premier — rarement la couche sans état. L'autoscaling gère les web servers ; la base, le cache et les limites des tiers sont les points de rupture.
Immédiatement, vérifiez les métriques de saturation (connexions, CPU, profondeur de file) pour la base et le cache, relevez le plafond de l'autoscaler, et activez tout shedding disponible : couper des fonctionnalités non critiques ou servir des pages en cache. Sous 24 h, ajoutez des réplicas de lecture, optimisez le taux de hit du cache, et identifiez les requêtes dominantes. À plus long terme, faites le sharding et la mise en file que vous repoussiez.
Distinguer une vraie croissance d'un bot revient aux patterns de requêtes, aux user agents, et à l'évolution des conversions.
38. Vous atteignez les limites de lecture de la base. Cache, réplicas, ou sharding ?
Dans cet ordre, en général. Un cache devant les lectures les plus chaudes est peu coûteux et peut diviser par deux la charge base en un jour ; vérifiez le taux de hit et les logs de requêtes pour confirmer la répétitivité.
Les réplicas de lecture viennent ensuite quand le mix de lectures est large plutôt que chaud. Ils ajoutent de la latence de réplication, donc tout chemin read-after-write (un utilisateur sauvegarde et doit voir son changement) doit cibler le primaire. Le sharding résout plus les limites d'écriture que de lecture et coûte des requêtes cross-shard et une migration, donc en dernier, quand les deux premières options sont épuisées.
Si un client massif sur une seule table cause la charge, isolez ce tenant ou partitionnez par ID client.
39. Une dépendance critique en aval est instable. Retries, timeouts, coupe-circuits ?
Tout cela, mais dans le bon ordre. D'abord un timeout, car un appel sans timeout transforme une dépendance lente en votre panne — les threads s'accumulent. Puis des retries avec backoff exponentiel et jitter, mais seulement pour des appels idempotents et en nombre limité, sinon vous amplifiez la charge sur un service déjà en difficulté.
Ensuite un circuit breaker : après un seuil d'échecs, on cesse d'appeler un temps et on sert un fallback (cache, dégradé, message aimable). Surveillez l'état du breaker ; un breaker bloqué ouvert est un incident en soi.
Si la dépendance instable est votre prestataire de paiement, pas de fallback pour le débit lui-même ; mettez la commande en pending et traitez-la plus tard.
D'abord, confirmez et cadrez : quel percentile a bougé (p50 ou seulement p99), quelles endpoints, quelle région. Comparez à la timeline des déploiements ; si la régression coïncide avec une release, rollback d'abord et enquête ensuite.
Si rollback n'est pas la solution, suivez la requête. Les traces montrent quelle span a grossi. Coupables fréquents : une nouvelle requête sans index, un N+1 introduit par un nouveau champ, un changement de clé de cache qui a fait chuter le hit rate, ou un appel aval passé d'async à synchrone sur le chemin de requête.
Si seul le p99 a bougé et que le rollback n'a rien changé, cherchez des pauses GC, un voisin bruyant, ou un verrou.
41. Un bug d'incohérence des données apparaît. Que vérifiez-vous, que revenez-vous en arrière ?
Mesurez l'ampleur avant d'agir. Quelles tables ou enregistrements divergent, depuis quand, et cela continue-t-il ? Le « depuis quand » pointe souvent une release ou un run de job.
Vérifiez le chemin d'écriture des enregistrements affectés : migrations récentes, job exécuté deux fois, retry sans idempotence, course entre deux writers. Stoppez l'hémorragie en pausant le job fautif ou en rollbackant le code, puis réparez depuis une source de vérité (log d'événements bruts, grand livre, backup) plutôt qu'à la main. Gardez une trace de ce que vous avez changé et pourquoi.
Sans source de vérité, reconstituez ce que vous pouvez, marquez le reste, et ajoutez le pattern outbox pour éviter la récidive.
Erreurs courantes en entretien de system design
La plupart des candidats échouent pour une poignée de raisons récurrentes. Aucune n'est liée à « savoir moins ».
- Zapper les questions de clarification. Sauter direct aux boîtes, c'est risquer de résoudre le mauvais problème pendant 40 minutes.
- Pas de chiffres. « Il faut que ça scale » ne dit rien. 5 000 écritures/s et 2 To/an, ça dit quelque chose — et ça change le design.
- Une architecture parfaite unique. Les intervieweurs veulent entendre « je choisirais X pour Y, au coût de Z ». Une réponse sûre d'elle sans arbitrages sonne par cœur.
- Des microservices trop tôt. Un monolithe avec de bons contours est une très bonne réponse pour la plupart des questions débutant/intermédiaire. Découper en 12 services sur tableau ajoute des pannes que vous devrez défendre.
- Oublier l'exploitation. Comment ça se déploie, que surveillez-vous, que se passe-t-il si un nœud meurt. Les seniors demanderont, et les juniors gagnent des points à l'évoquer d'eux-mêmes.
- Oublier le modèle de données. Des boîtes et des flèches sans idée de ce qu'il y a dans les tables. Particulièrement coûteux pour les rôles data.
- Se taire. Réfléchir en silence deux minutes, c'est une éternité pour l'intervieweur. Racontez, même « j'hésite entre deux options ».
La préparation fonctionne quand elle est répétable. Voici un process que je suivrais réellement.
- Gardez la même structure à chaque fois. Les six étapes du début de cet article, dans cet ordre, sur chaque question d'entraînement. Écrivez-les sur une carte et répétez jusqu'à automatisme pour économiser votre attention.
- Faites des mocks chronométrés. Avec un ami, un collègue, ou juste un enregistreur, faites 45 minutes à voix haute avec des interruptions. Les premières seront rudes — c'est normal.
- Bâtissez un template de design. Une fiche d'une page listant les patterns que vous utilisez souvent : cache-aside, file pour découpler, pub/sub pour fan-out, CQRS quand lectures/écritures divergent, sharding par clé, outbox pour la cohérence base/bus. Relisez-la avant chaque session.
- Entraînez l'explication des arbitrages, pas juste le dessin. Pour chaque pattern, sachez dire en une phrase ce qu'il apporte et ce qu'il coûte. Cette phrase fait la différence entre « pass » et « strong pass ».
- Allez par niveau et par rôle. Choisissez cinq questions de votre niveau et quatre de votre rôle dans cette liste et entraînez-les vraiment plutôt que de survoler les 41. Si les questions pipeline data vous ont paru étrangères, nos Introduction to Data Engineering et Streaming Concepts courses couvrent le vocabulaire sur lequel ces réponses s'appuient.
Conclusion
Chaque question de cette liste vient d'un système que quelqu'un a dû construire puis garder en vie à 3 h du matin. Plus vous faites cela, moins l'entretien ressemble à une performance, et plus il ressemble à la description de votre mardi. Montez un side project avec une vraie file, faites l'astreinte, et assistez à une revue de design même quand ce n'est pas le vôtre.
Et si vous voulez un cadre structuré d'ici votre prochain loop, ces ressources vont plus loin sur les éléments sur lesquels s'appuient ces réponses :



Les questions de system design surgissent dans bien plus d'entretiens qu'on ne l'imagine. Évidemment pour les rôles backend. Mais aussi en infrastructure, data engineering, et même sur des postes très produits où personne ne vous demandera d'écrire une ligne de code pendant le loop.
Alors, qu'évalue vraiment l'intervieweur ? Pas votre connaissance de « l'architecture correcte » — elle n'existe pas. Il veut voir une pensée structurée, des arbitrages honnêtes, et votre capacité à raisonner quand les contraintes sont floues et que le temps tourne.
Les attentes varient fortement selon le niveau. Un profil junior qui pose de bonnes questions de clarification et esquisse un schéma propre avec quelques boîtes fait un excellent début. Un senior qui ne fait que cela est en difficulté, car à ce niveau on attend des chiffres, des modes de panne, et un avis sur ce qu'il faut construire en premier.
Le rôle compte aussi. Un data engineer sera poussé sur les pipelines et les backfills, un développeur frontend sur le cache et l'état, un profil infra sur les déploiements et le rayon d'impact. Même compétence sous-jacente, vocabulaire différent.
Je souligne cela parce que la plupart des listes de questions ignorent ces deux dimensions et se contentent de déverser 50 sujets. Celle-ci est organisée d'abord par niveau, puis par rôle, avec des questions de scénario à la fin. Si la partie stockage de ces réponses vous semble fragile, notre Database Design course couvre les fondamentaux.
Comment aborder un entretien de system design
Même structure à chaque fois, environ 45 minutes :
Racontez tout à voix haute. Un intervieweur ne peut pas noter une réflexion silencieuse.
Questions de system design pour débutants
Ici, on teste les fondamentaux : clarifier les besoins avant de dessiner quoi que ce soit, produire un schéma d'architecture simple, et faire des choix de stockage sensés. Personne n'attend des algorithmes de consensus à ce stade.
1. Concevoir un raccourcisseur d'URL
Un raccourcisseur transforme une longue URL en un code court et redirige à la visite, donc il faut d'abord statuer sur l'expiration des liens et le volume attendu. Une hypothèse raisonnable : 100 millions de nouveaux liens par mois, avec un ratio lectures/écritures d'environ 100 pour 1.
Ce mix très orienté lecture façonne la conception : un serveur d'API, une base de données, et un cache devant. Pour le code court, soit encoder en base62 un ID auto-incrémenté (sept caractères donnent environ 3,5 billions de combinaisons), soit générer une chaîne aléatoire et vérifier les collisions.
Une seule table suffit :
short_codeen clé primaire,long_url,created_at,expires_at, et unuser_idoptionnel. Les codes les plus chauds vivent dans Redis pour que la base ne voie que les misses. Utilisez une redirection 302 si vous voulez des analytics de clics, car les navigateurs mettent en cache une 301 et vous ne voyez jamais la seconde visite.À 10 milliards de liens, vous shardez par code et le générateur d'ID devient le goulot d'étranglement ; si les gens commencent à deviner les codes, passez du séquentiel à l'aléatoire et ajoutez du rate limiting.
2. Concevoir un limiteur de débit basique
Un rate limiter autorise N requêtes par utilisateur et par minute et renvoie un 429 au-delà. La première chose à clarifier est si la limite est par utilisateur, par IP, ou par clé d'API, car cela détermine votre clé de cache.
Trois algorithmes couvrent la plupart des réponses. La fenêtre fixe compte les requêtes dans chaque minute, simple mais permettant jusqu'au double de la limite aux frontières. La fenêtre glissante avec journal stocke chaque timestamp, exact mais gourmand en mémoire. Le seau à jetons se remplit à cadence régulière et laisse passer de petits bursts, raison pour laquelle de nombreuses gateways l'utilisent.
Exécutez le limiteur en middleware dans l'API gateway avec des compteurs dans Redis sous TTL ; INCR plus EXPIRE couvre la version à fenêtre fixe.
Avec dix instances de gateway, soit vous partagez les compteurs Redis, soit vous acceptez un léger surcomptage avec des compteurs locaux. Et décidez à l'avance de ce qui se passe si Redis tombe : fail open avec risque d'abus, ou fail closed et tout le monde est bloqué.
3. Concevoir un magasin clé-valeur simple
Un key-value store a besoin de get, put et delete, et pour une question débutant, restez sur un seul nœud. Une table de hachage en mémoire gère les opérations. Pour la durabilité, écrivez chaque modification dans un journal sur disque avant de l'accuser réception, et faites des snapshots périodiques pour que la reprise n'ait pas à rejouer toute l'histoire.
Ce que l'intervieweur veut entendre, c'est que vous avez séparé le chemin rapide en mémoire du chemin durable sur disque, et que vous comprenez pourquoi le journal vient en premier.
Si les données dépassent la mémoire, la réponse est un arbre LSM, à peu près comme fonctionnent RocksDB et Cassandra. Si vous avez besoin d'un second nœud, le primaire réplique le journal vers un follower, et le hachage cohérent prend le relais au-delà.
4. Concevoir un cache (conceptuel)
Un cache se place entre votre application et un stockage plus lent ; le motif de base est cache-aside. L'app vérifie le cache, manque, lit la base, et réécrit le résultat avec un TTL. Simple, mais l'invalidation est à votre charge.
L'éviction signifie généralement LRU, parfois LFU pour des charges très biaisées. L'indicateur qui compte est le taux de hit ; en dessous de 80 % environ, demandez-vous si le cache aide vraiment.
Là où ça devient intéressant : la fraîcheur. Si la base change et que la copie en cache non, les utilisateurs voient des données anciennes jusqu'à l'expiration du TTL. Des TTL courts réduisent cette fenêtre mais augmentent la charge sur la base.
Quand une clé populaire expire et que 10 000 requêtes frappent la base d'un coup, soit vous regroupez ces requêtes, soit vous rafraîchissez la clé avant son expiration. En write-through versus write-back, le write-through garde le cache correct au prix d'écritures plus lentes, tandis que le write-back est rapide mais perd les écritures récentes si le cache meurt avant de purger.
5. Concevoir un service de notifications basique
Un service de notification envoie des emails, SMS et push, et retente quand un fournisseur échoue. Avant de le concevoir, demandez le volume et si l'ordre de livraison compte — généralement non.
Le cœur du design est une file. Les producteurs y écrivent un événement de notification, et un worker par canal lit les événements et appelle un fournisseur comme SendGrid ou Twilio. Cette séparation distingue la décision de notifier de l'envoi effectif, de sorte qu'un fournisseur SMS lent ne bloque jamais l'app.
Stockez chaque notification avec un statut (pending, sent, failed) et une clé d'idempotence pour qu'un retry n'envoie pas deux fois.
Les utilisateurs qui veulent couper le marketing mais garder les alertes de sécurité nécessitent une table de préférences vérifiée avant toute mise en file, et un fournisseur qui vous limite à 100 messages par seconde impose un throttling par canal côté worker.
6. Concevoir un service simple de stockage de fichiers
Pensez à Dropbox à petite échelle. Les utilisateurs téléversent un fichier, obtiennent un lien, et le téléchargent plus tard. Clarifiez la taille max et l'importance du partage.
Les métadonnées (propriétaire, nom, taille, checksum, date de création) vont dans une base relationnelle. Les octets vont en stockage objet type S3, jamais dans la base. Pour les uploads, l'API renvoie une URL pré-signée pour que le client écrive directement dans le stockage objet et que vos serveurs ne touchent jamais le fichier.
Deux utilisateurs qui téléversent le même fichier de 2 Go posent un problème de déduplication résolu en hachant le contenu, et les fichiers de plus de 5 Go nécessitent un upload multipart avec checksum par chunk.
7. Concevoir un classement de jeu
Un leaderboard doit mettre à jour le score d'un joueur, renvoyer le top 10, et donner le rang d'un joueur ; commencez par demander combien de joueurs et la fréquence des changements.
Une table relationnelle avec un index sur le score fonctionne jusqu'à un point, mais « quel est mon rang » devient un
COUNTsur tous ceux au-dessus de vous. Les ensembles triés Redis règlent cela :ZADDpour mettre à jour,ZREVRANGEpour le top N,ZREVRANKpour un joueur donné, le tout en temps logarithmique.Des classements quotidien et « tous temps » sont un ensemble trié par période, avec une clé du type
lb:2026-09-14. Si 50 millions de joueurs poussent la mémoire Redis trop loin, gardez seulement le top 100k là et le reste dans la base.Questions de system design intermédiaires
À ce niveau, l'intervieweur suppose que vous avez construit et opéré de vrais systèmes. Les questions introduisent les files, le scaling lecture/écriture, et la tension entre latence, coût et cohérence.
8. Concevoir un fil d'actualités
Un feed doit permettre de publier, de suivre d'autres comptes, et de lire ce qu'ils écrivent, en ordre antéchronologique ou classé. Supposez 10 millions d'utilisateurs actifs quotidiens ouvrant cinq fois par jour, soit environ 600 lectures par seconde en moyenne et bien davantage aux pics.
Le choix central est le moment d'assembler le feed. Le fan-out à l'écriture pousse chaque nouveau post dans le feed pré-calculé de chaque abonné, avec des lectures rapides au prix d'écritures coûteuses. Le fan-out à la lecture assemble à la demande, arbitre inverse. La plupart des systèmes réels mixent : fan-out à l'écriture pour les utilisateurs « normaux » et à la lecture pour les comptes à des millions d'abonnés.
Le modèle de données comprend
posts,follows, et une liste de feed par utilisateur dans Redis contenant des IDs de posts. Paginez avec un curseur sur l'ID plutôt qu'un offset.Ajouter du ranking ensuite n'impose pas de tout reconstruire ; vous scorez les IDs candidats de la liste au moment de la lecture.
9. Concevoir un système de chat avec synchronisation multi-appareils
Le chat multi-appareils implique des messages 1:1 et de groupe, la livraison sur tous les appareils d'un utilisateur, et un historique qui survit à un changement de téléphone. Supposez 50 millions d'utilisateurs quotidiens envoyant ~40 messages chacun, soit 2 milliards par jour, environ 23 000 écritures par seconde en moyenne et plusieurs fois plus aux pics régionaux.
Chaque client maintient un WebSocket vers un serveur de chat, qui écrit les messages dans un store partitionné par ID de conversation, avec un numéro de séquence croissant par conversation. Chaque appareil mémorise le dernier numéro vu et demande les nouveaux à la reconnexion — c'est ce qui permet la sync multi-appareils.
Le store doit supporter un débit d'écriture élevé et des lectures par plage sur la conversation ; des bases en colonnes larges comme Cassandra sont la réponse courante. Les accusés de livraison et de lecture sont de petits événements qui rebroussent le même chemin.
Quand deux amis sont connectés à des serveurs différents, un pub/sub entre serveurs ou un service de routage qui mappe les utilisateurs aux serveurs achemine le message. Des groupes de 500 diffusent côté serveur, et garantir l'ordre devient plus délicat.
10. Concevoir un service d'appariement pour VTC
Gardez-le plus léger que la version senior. Les chauffeurs envoient leur position toutes les quelques secondes, les passagers demandent une course, et le service doit retourner un chauffeur proche en quelques secondes.
Les mises à jour de position sont le problème de volume : 200 000 chauffeurs actifs avec une mise à jour toutes les 4 secondes, c'est 50 000 écritures par seconde. Stockez les positions courantes en mémoire indexées par geohash ou cellule H3, pas dans une table relationnelle. Le matching devient « trouvez les chauffeurs dans ma cellule et les voisines », classez par ETA, et verrouillez un chauffeur pour éviter un double-assignement.
Si un chauffeur accepte puis perd la connexion, le verrou expire et le passager est réassigné. Une cellule chaude en centre-ville se subdivise plus finement dans les zones denses — exactement ce que fournissent des index hiérarchiques comme H3.
11. Concevoir un système de collecte de métriques
Un système de métriques reçoit quelques centaines de mesures toutes les 10 secondes de milliers de serveurs et permet des requêtes en dashboards.
Des agents batchent les métriques et poussent vers une couche d'ingestion, qui écrit dans une base de séries temporelles (ou un Kafka avec des consommateurs qui y écrivent). Le stockage est étagé : résolution brute sur un ou deux jours, agrégats à la minute pour un mois, à l'heure pour un an. Le downsampling tourne en tâche de fond.
Les requêtes tapent l'agrégat qui correspond à la plage de temps demandée, ce qui évite à un graphe 30 jours de scanner la donnée brute. La cardinalité des tags (par ex. un ID utilisateur en label) peut tuer la base — dites-le explicitement.
Push ou pull ? Prometheus tire, mais le push marche mieux à travers des firewalls et pour des jobs éphémères. Un agent qui rapporte des timestamps hors ordre est accepté dans une fenêtre de retard bornée puis rejeté au-delà, avec un compteur de rejets pour qu'une horloge fautive soit visible.
12. Concevoir un système d'autocomplétion de recherche
L'autocomplétion renvoie les cinq meilleures propositions en ~100 millisecondes à chaque frappe. Précisez si les suggestions sont globales ou personnalisées — la personnalisation change tout.
La réponse est de pré-calculer. Un pipeline offline agrège les logs de requêtes, compte les fréquences, et construit un trie (ou une table préfixe-vers-top-k) où chaque nœud stocke déjà ses meilleures complétions. La couche de service fait alors une seule lookup par frappe, et toute la structure tient en mémoire sur quelques réplicas.
Les mises à jour se font en batch, peut-être à l'heure, en reconstruisant la structure et en la basculant. Les tendances en temps réel peuvent être gérées par une petite surcouche fusionnée à la requête.
Un préfixe comme « a » toucherait un énorme sous-arbre, d'où le stockage top-k à chaque nœud plutôt que la traversée. Les fautes de frappe nécessitent un index flou dédié, sinon vous acceptez le miss.
13. Concevoir un ordonnanceur de jobs distribué
Un ordonnanceur distribué, c'est cron à l'échelle d'une entreprise : définir un job et un horaire, l'exécuter à l'heure et au plus une fois par tick, retenter en cas d'échec, et exposer l'historique.
Stockez définitions et horaires en base. Un service de planification calcule la prochaine exécution et pousse les jobs dus dans une file ; des pools de workers tirent et exécutent. Le point délicat est d'exécuter exactement une instance de scheduler par job sans point unique de défaillance, ce qui implique généralement une élection de leader (un verrou dans ZooKeeper, etcd, ou une ligne en base avec bail).
Enregistrez chaque exécution avec statut, heure de début, de fin, et l'emplacement des logs. Cette table devient l'écran que tout le monde consulte.
Un job plus long que son intervalle doit sauter, mettre en file, ou se chevaucher — et cela doit être configurable. Dès que le job B dépend du job A, les dépendances forment un DAG et le scheduler n'enfile qu'après succès de l'amont.
Questions de system design avancées
Niveau senior. Échelles massives, multi-région, objectifs de fiabilité chiffrés, et le coût de chaque décision. L'intervieweur s'attend à ce que vous évoquiez spontanément les modes de panne.
14. Concevoir une plateforme de streaming vidéo type YouTube
Le streaming vidéo, ce sont deux systèmes sous un même nom. À l'upload, l'utilisateur envoie un fichier brut et un pipeline le transcode en plusieurs résolutions et bitrates, le découpe en segments de quelques secondes, et stocke ces segments en objet. À la lecture, un CDN sert ces segments et le lecteur adapte le bitrate à la bande passante — c'est le streaming adaptatif via HLS ou DASH.
Annoncez l'échelle : des centaines d'heures uploadées par minute, des milliards de vues par jour, du stockage en exaoctets. Le transcodage est massivement parallélisable, donc une grande flotte de workers tire des jobs d'une file. Les métadonnées — titre, propriétaire, vues — vivent dans une base shardée avec un cache intensif, car la page d'accueil les lit constamment. Le stockage objet et les edges CDN sont répliqués entre régions, et le SLO clé est le temps de démarrage de lecture, la métrique ressentie étant le taux de rebuffering.
Les compteurs de vues d'une vidéo virale sont des compteurs approximatifs agrégés en batch, jamais un incrément en base par vue, et la détection de copyright est un fingerprinting dans le même pipeline d'upload.
15. Concevoir une plateforme de logs distribuée
Une plateforme de logs ingère les logs de chaque service, les rend consultables en quelques secondes, et les conserve 30 jours en chaud et un an en froid.
Des agents suivent les fichiers de log et les envoient vers un tampon durable type Kafka, qui absorbe les pics et permet aux indexeurs de prendre du retard sans perte. Les indexeurs écrivent vers un cluster de recherche avec un index par jour et par service, et les anciens index descendent en fichiers compressés dans du stockage objet.
Le coût est la vraie contrainte : indexez les champs structurés et gardez le texte brut bon marché. Donnez un quota à chaque service, surveillez le retard d'indexation, et nettoyez les PII à l'ingestion.
Un service qui loggue à 100x son volume normal est d'abord limité par quota, puis échantillonné, puis drop, puis alerté — dans cet ordre. Les requêtes inter-régions impliquent une recherche fédérée, chaque région gardant ses données.
16. Concevoir un système d'analytics en temps réel
L'analytics temps réel signifie des dashboards affichant des agrégats sur les dernières minutes, mis à jour en quelques secondes, au-dessus d'un flux d'un million d'événements par seconde peut-être.
Un processeur de flux comme Flink maintient des agrégats fenêtrés — par exemple des comptes par minute par dimension — et les écrit dans un store à lecture rapide comme ClickHouse ou Druid. Les dashboards interrogent ce store, jamais le flux brut.
Citez les arbitrages : comptes exacts versus HyperLogLog pour les distincts, fenêtres tumbling versus sliding, et watermarks pour les événements en retard. Fixez un SLO de fraîcheur et suivez le lag du processeur par rapport à celui-ci.
Une dimension à forte cardinalité comme l'ID utilisateur fait exploser la table d'agrégats, donc interrogez les événements bruts pour celle-là. Un backfill après un bug se fait en rejouant depuis le flux avec offsets retenus.
17. Concevoir un système de paiement
Les paiements sont le seul design où la justesse prime l'échelle. Le système doit débiter un client, l'enregistrer, ne jamais doubler, ne jamais perdre un enregistrement, et se réconcilier quotidiennement avec la banque.
L'idempotence porte l'essentiel : chaque requête a une clé, et le service stocke le résultat associé et renvoie le même en cas de retry. L'argent circule via un grand livre en double entrée, append-only, où les écritures d'une transaction somment à zéro, dans une base relationnelle à isolation sérialisable. Ici, l'éventuelle cohérence est une mauvaise réponse.
Les appels au réseau cartes peuvent expirer de manière ambiguë ; les débits passent en statut pending et un job de réconciliation les règle. Multi-région signifie une région « maison » par compte, jamais d'écritures actives-actives sur le même solde.
Multi-devises implique des montants entiers en unités mineures avec un code devise, et un remboursement arrivant avant le règlement du débit est géré par une machine à états avec transitions explicites.
18. Concevoir un système de messagerie à grande échelle
Un système de messagerie à grande échelle permet aux producteurs de publier et aux consommateurs de s'abonner, survit aux redémarrages des brokers, et préserve l'ordre là où c'est nécessaire, à des millions de messages par seconde.
Partitionnez chaque topic pour que les messages avec la même clé atterrissent sur la même partition — vous obtenez un ordre par clé sans ordre global. Chaque partition est un journal append-only répliqué sur quelques brokers, et les consommateurs valident leur offset après traitement.
Par défaut, livraison au moins une fois avec des consommateurs idempotents. Les retries passent par un topic de retry avec backoff et les messages « poison » vont dans une dead-letter queue. Le lag consommateur est le signal sur lequel poser un SLO, et entre régions, une région doit posséder les écritures par clé sinon l'ordre se réinversera.
Un consommateur qui crash après traitement mais avant de commit produit un doublon — d'où l'importance de l'idempotence. Les tempêtes de rééquilibrage se calment avec l'assignation sticky et le rebalancing coopératif.
Questions de system design pour ingénieurs backend
Ici, on se concentre sur les APIs, les modèles de données, et les limites de service. Attendez-vous à des relances sur la cohérence, le caching, et ce que vous journaliseriez.
19. Concevoir un service d'authentification et d'autorisation
L'authentification répond « qui êtes-vous » et l'autorisation « que pouvez-vous faire », et les candidats qui séparent bien les deux marquent des points.
Utilisez OAuth 2.0 et OpenID Connect plutôt que d'inventer un protocole. Émettez des tokens d'accès de courte durée et des tokens de rafraîchissement plus longs stockés côté serveur pour pouvoir les révoquer. Les permissions vivent dans un modèle de rôles vérifié par une petite librairie ou un service de politiques. Logguez chaque tentative de login, refresh et refus avec IP et appareil, sans jamais journaliser les tokens eux-mêmes.
Les JWT évitent un lookup à chaque requête, mais les révoquer tôt impose une denylist, qui réintroduit la lookup. Le credential stuffing se freine par rate limiting par IP et par compte, délais après échecs répétés, et second facteur sur les connexions suspectes.
20. Concevoir une API gateway
Une API gateway est un point d'entrée unique devant vos services qui prend en charge les préoccupations transverses pour éviter de les dupliquer : routage par chemin et version, terminaison TLS, authentification, rate limiting, et logs de requêtes.
La gateway elle-même doit être sans état et scaler horizontalement derrière un load balancer. La configuration de routage vit dans un plan de contrôle et est poussée aux instances, pour ne jamais redéployer la gateway à chaque ajout de route. Les tokens d'auth sont validés une fois à l'edge et la gateway propage l'identité utilisateur via un header.
Prononcez « rayon d'impact ». La gateway est sur tous les chemins de requêtes ; une mauvaise conf peut tout faire tomber. Validez les configs, déployez progressivement, et gardez la logique propre et mince côté gateway.
La gestion de versions sans casser des clients mobiles non mis à jour passe par le versioning dans le chemin ou le header, avec maintien des anciennes versions. Et la gateway ne doit pas agréger des réponses de plusieurs services ; cela relève d'une couche backend-for-frontend.
21. Concevoir un système de commande pour e-commerce
Un système de commandes crée une commande, réserve le stock, encaisse, expédie, et permet au client de voir le statut. Les commandes sont une machine à états (
created,paid,packed,shipped,delivered,cancelled), avec transitions autorisées explicites.La création est un
POSTavec clé d'idempotence pour qu'un double-clic ne crée pas deux commandes. La réservation de stock et le paiement impliquent d'autres services — utilisez une saga : chaque étape publie un événement et les échecs déclenchent des compensations (libérer le stock, rembourser). Écrivez l'événement dans une table outbox dans la même transaction que la mise à jour de commande pour éviter toute divergence entre base et bus de messages.Côté lecture, une table
ordersplus une tableorder_items, avec un résumé matérialisé en cache pour la page « mes commandes ».Deux clients qui achètent la dernière unité en même temps sont arbitrés par un verrou de ligne ou un décrément atomique du stock ; l'un reçoit une rupture de stock. À surveiller : les commandes bloquées trop longtemps dans un état.
22. Concevoir un service de feature flags
Un service de feature flags bascule des fonctionnalités par environnement, cible par attributs utilisateur ou pourcentage, et permet de couper globalement en quelques secondes quand ça casse.
Les définitions et règles vivent dans une petite base derrière une API d'admin. Les applications embarquent un SDK qui récupère tous les flags au démarrage, les met en cache localement, et évalue les règles en process, pour qu'un check de flag ne coûte rien sur le chemin de requête. Les mises à jour se propagent via une connexion streaming ou polling court, et le SDK conserve le dernier état connu si le service de flags est indisponible.
Les pourcentages se calculent via un hash stable de l'ID utilisateur et de la clé du flag, pour garder le même côté pour un même utilisateur.
Les flags périmés sont repérés via les derniers timestamps d'évaluation et des rappels aux propriétaires, et si le service est down au démarrage, l'application retombe sur les valeurs par défaut embarquées.
23. Concevoir une API de recommandation
Une API de recommandation renvoie 20 items pour un utilisateur en moins de 100 ms à quelques milliers de requêtes par seconde, sans avoir besoin de ML avancé pour la concevoir.
Séparez offline et online. Un job offline calcule des listes candidates par utilisateur dans un KV à faible latence. L'API en ligne les récupère, rerank avec quelques features fraîches comme l'état de stock, filtre ce qui a déjà été acheté, et renvoie la liste. Gardez un fallback d'articles populaires par catégorie, et logguez chaque liste servie avec un ID de requête pour la relier aux clics plus tard.
Un nouvel utilisateur obtient le fallback jusqu'à quelques interactions. Les 100 ms se répartissent grossièrement en 10 pour la lecture, 30 pour le rerank, 10 pour la sérialisation, et 50 de marge.
Questions de system design pour l'infrastructure / DevOps
Fiabilité, déploiement, automatisation, observabilité. Le fil rouge : comment changer en sécurité et savoir vite quand on s'est trompé.
24. Concevoir un pipeline CI/CD pour microservices
Un pipeline CI/CD pour microservices doit gérer des dizaines de services déployables indépendamment avec tests, contrôles de sécurité, et une voie vers la production qui n'exige pas un humain à 3 h du matin.
Build once, deploy same artifact partout. Le pipeline lint, lance les tests unitaires, construit une image container taguée par le SHA du commit, la scanne, et la pousse au registre. Le déploiement promeut ensuite cette image à travers les environnements (dev, staging, prod) via configuration sans reconstruire.
La mise en production doit être progressive : canary sur quelques pourcents de trafic, surveiller taux d'erreur et latence pendant une fenêtre définie, puis continuer ou rollback automatique. Le rollback, c'est redéployer le tag précédent — rapide car vous n'avez rien rebâti.
Quand le changement du service A casse le contrat du service B, la solution est des tests de contrat en CI et des changements d'API rétro-compatibles. Monorepo versus multi-repos importe moins qu'on ne le croit, tant que le pipeline ne construit que ce qui a changé.
25. Concevoir une supervision et une alerte centralisées
La supervision centralisée rassemble métriques, logs et traces de chaque service au même endroit, avec des alertes qui ne réveillent les gens que quand les utilisateurs sont affectés.
Les métriques vont dans un store séries temporelles, les logs dans la plateforme de la question 15, les traces dans un backend de tracing — le tout corrélé par un ID de requête partagé. La décision clé est ce sur quoi alerter. Alertez sur les symptômes (taux d'erreur, percentiles de latence, saturation) liés aux SLOs, pas sur des causes comme « CPU à 80 % ».
La fatigue d'astreinte tue les rotations : chaque page doit avoir un runbook et une revue. Toute alerte qui page deux fois en une semaine sans action claire est rétrogradée en ticket.
Un SLO pour un service tout neuf se déduit en mesurant quelques semaines puis en fixant un objectif légèrement meilleur que l'actuel. Et quand la supervision elle-même est down, des checks synthétiques externes et une alerte « homme mort » vous préviennent.
26. Concevoir une gestion des secrets
La gestion des secrets rend disponibles mots de passe base, clés d'API, certificats aux services à l'exécution, jamais en code source, avec rotation régulière et audit.
Un store central (HashiCorp Vault, secrets manager cloud) contient tout. Les services s'y authentifient via leur identité de workload (compte de service Kubernetes, rôle IAM), jamais un token longue durée, et récupèrent les secrets au démarrage ou à la demande. Préférez les secrets dynamiques quand c'est possible : le store génère une crédential base valide une heure — la rotation est gratuite.
Auditez chaque lecture. Et documentez une voie « briser la vitre » quand le store lui-même est down — cela arrivera.
Une clé commitée par erreur est détectée en CI, immédiatement rotatée, et traitée comme compromise quoi qu'il arrive. Les secrets en variables d'environnement sont fréquents mais fuient via dumps et processus enfants — montez-les en fichiers ou récupérez-les en process.
27. Concevoir l'autoscaling et une stratégie de déploiement
Autoscaling et rollout doivent ensemble permettre à un service d'encaisser des variations quotidiennes x5 sans intervention manuelle, tout en déployant plusieurs fois par jour.
Scalez sur un signal corrélé à la douleur utilisateur — souvent le taux de requêtes ou la latence par instance — plutôt que sur CPU seul. Fixez des réplicas minimum pour qu'un cold start n'affronte pas un pic, et un maximum pour qu'un bug ne vous ruine pas. Scale up rapide, scale down lent.
Pour le rollout, utilisez blue/green quand vous voulez un switch et un rollback instantanés, et canary quand vous voulez observer un petit pourcentage réel d'abord. Combinez canary et autoscaler avec soin, car un canary qui scale indépendamment peut biaiser la comparaison.
Si le scaling accuse deux minutes de retard sur un pic soudain, un scaling prédictif programmé ou un minimum plus haut comble la brèche. Et 50 nouvelles instances qui épuisent les connexions base illustrent pourquoi le pooling doit vivre dans un proxy.
Questions de system design pour data engineers
Pipelines, formats de stockage, batch versus streaming, et fiabilité de la donnée. Même cadre qu'avant, mais les échecs portent sur la perte, la duplication, ou le retard des données plutôt que des requêtes.
28. Concevoir un pipeline d'ingestion d'événements
Un pipeline d'ingestion reçoit des événements comportementaux des clients web et mobile et les rend requêtables en moins d'une heure. Supposez 50 000 événements/s au pic, avec des clients hors ligne qui retentent.
Les clients batchent via un SDK et postent vers un collecteur qui valide contre un registre de schéma et écrit dans un stream (Kafka ou équivalent managé). Un consommateur dépose les bruts en stockage objet partitionné par heure, en format colonne type Parquet. Les jobs aval lisent là-dedans.
Les retries impliquent des doublons, donc chaque événement porte un UUID généré côté client et le job de landing déduplique dans une fenêtre. Les changements de schéma passent par le registre avec vérification de compatibilité — une app mobile ancienne enverra l'ancien format des mois durant.
Un événement avec un timestamp d'il y a trois jours atterrit par heure d'arrivée, conserve son heure d'événement en colonne, et laisse l'aval décider. Les événements invalides vont dans une dead-letter path et ne sont jamais jetés silencieusement.
29. Concevoir un système d'ETL streaming
Le streaming ETL transforme les événements à l'arrivée, les joint avec des données de référence, et écrit les résultats dans un store de service en quelques secondes.
Un processeur de flux lit depuis le topic d'ingestion, applique les transformations, et enrichit avec des référentiels chargés en mémoire et rafraîchis périodiquement. L'état (pour les joins fenêtrés ou agrégations) est checkpointé dans un stockage durable pour qu'un crash reprenne sans tout retraiter.
L'arbitrage attendu : exactly-once versus at-least-once. Exactly-once est atteignable de bout en bout si le sink supporte des transactions ou écritures idempotentes, mais au prix de latence et de complexité. At-least-once avec des sinks idempotents offre l'essentiel des bénéfices.
Les données en retard se gèrent avec watermarks et une période de grâce définie, au-delà elles vont dans une table late-arrivals.
Des référentiels qui changent en cours de flux doivent être versionnés, avec la jointure sur la version valide au temps de l'événement. Un backfill six mois après un correctif de logique se rejoue depuis le brut en batch, pas via le stream.
30. Concevoir un data warehouse et l'approche de modélisation
Un entrepôt doit offrir aux analystes et dashboards des métriques cohérentes entre ventes, marketing et produit, avec l'historique conservé.
Atterrissez les données brutes inchangées en bronze, nettoyez et conformez en silver, et construisez les tables métier en gold. Modélisez l'or en schéma en étoile : tables de faits au grain le plus fin utile (par ex. une ligne par ligne de commande) et dimensions pour clients, produits, dates. Les dimensions à évolutions lentes reçoivent un traitement Type 2 quand l'historique importe — un changement de région client ne réécrit pas le CA de l'an passé.
Partitionnez les grands faits par date, regroupez par colonnes de filtrage usuelles, et mettez les transformations en contrôle de version (dbt ou équivalent) avec tests.
Quand deux équipes définissent différemment « client actif », une couche de métriques avec une définition unique tranche. Un fait arrivant en retard qui référence une clé de dimension non encore présente obtient une ligne dimension placeholder, backfillée plus tard.
31. Concevoir un feature store
Un feature store calcule des features une fois et les réutilise pour l'entraînement et la prédiction temps réel, sans décalage entraînement/service. C'est deux stores pour une définition : l'offline (entrepôt ou lac) tient l'historique pour les jeux d'entraînement, l'online (Redis, DynamoDB) tient la dernière valeur par entité pour des lookups à faible latence à l'inférence.
Une définition unique pilote les deux, et un job matérialise de l'offline vers l'online selon un planning.
Le concept critique est la justesse point-in-time. En construisant un training set, chaque ligne doit utiliser les valeurs telles qu'elles existaient au timestamp de la ligne, pas les actuelles. Sinon, votre modèle apprend du futur et paraît excellent jusqu'à sa mise en prod.
Une feature coûteuse à calculer en temps réel est soit pré-calculée avec un peu de staleness, soit calculée à l'écriture. Pour garantir la concordance online/offline, échantillonnez et comparez, et logguez les features réellement servies.
32. Concevoir une couche de qualité et de lignage des données
Une couche qualité/lignage détecte les données cassées avant les dashboards et répond à « d'où vient cette colonne » sans lire le code.
Les checks qualité tournent comme étapes de pipeline : comptes de lignes vs fourchettes attendues, taux de null, fraîcheur (la partition est-elle arrivée à l'heure), et quelques assertions métier (le revenu n'est jamais négatif). Les échecs bloquent l'aval et alertent le propriétaire. Stockez les résultats dans le temps pour voir les dérives, pas seulement le statut du jour.
Le lignage est capturé depuis le code de transformation (parsing SQL, ou métadonnées de l'orchestrateur) et stocké en graphe : table-à-table, colonne-à-colonne si possible. Ce graphe alimente l'analyse d'impact quand on veut supprimer une colonne.
Si les checks durent plus que le pipeline, échantillonnez ou exécutez les lourds en asynchrone et alertez plutôt que de bloquer. Le lignage entre outils qui ne se parlent pas passe par OpenLineage ou des annotations manuelles, avec les lacunes documentées.
Questions de system design pour frontend / full-stack
Performance client, gestion d'état, caching, et dialogue navigateur-API. Les basiques de sécurité apparaissent aussi.
33. Concevoir l'architecture d'une web app à fort trafic
Ici, une web app à fort trafic signifie un site riche en contenu, des millions de visiteurs quotidiens, un premier rendu rapide, et des sections personnalisées pour les connectés.
Les assets statiques vont sur un CDN avec un cache long et des noms de fichiers hashés. Les pages identiques pour tous sont rendues côté serveur et cachées en edge ; les parties personnalisées chargent côté client après le shell. Ce mode hybride garde un TTFB bas sans servir de données perso périmées.
Les appels API côté client passent par la gateway avec des tokens de courte durée. Réglez les headers de cache consciemment :
Cache-Controlavecstale-while-revalidatepour du contenu tolérant quelques secondes de retard,no-storepour toute donnée personnelle.Pour un dashboard derrière login, le rendu client est souvent suffisant — le SSR n'apporte pas grand-chose sans SEO. Et une clé de cache qui inclut par erreur le cookie de session donne une copie par utilisateur, et le taux de hit s'effondre.
34. Concevoir une synchronisation offline-first
Offline-first signifie une app de prise de notes ou de saisie terrain qui fonctionne sans connexion et se synchronise au retour, sans perdre les modifications de quiconque.
Chaque écriture va d'abord dans un store local (IndexedDB, SQLite sur mobile) et dans une file de mutations en attente. Quand la connectivité revient, le client pousse la file dans l'ordre et tire les changements depuis son dernier jeton de sync. Chaque mutation porte un ID client et un numéro de séquence pour permettre la déduplication côté serveur.
Les conflits sont le cœur du sujet. Last-write-wins est simple et perd des données. La fusion au niveau champ couvre la plupart des cas.
Les CRDT offrent des fusions automatiques pour texte et listes au prix de complexité ; je ne les choisirais que si l'édition collaborative est un vrai besoin.
Un utilisateur qui édite sur deux appareils hors ligne, puis les ramène, voit les deux éditions appliquées, le conflit signalé, et l'UI l'afficher. Une file en attente qui atteint 10 000 mutations doit être compactée — dix éditions d'un même champ deviennent une.
35. Concevoir des mises à jour d'UI en temps réel
Des mises à jour d'UI en temps réel signifient un dashboard ou un chat qui reflète les changements serveur en une seconde pour des milliers d'utilisateurs concurrents.
Choisissez le transport selon la direction. Server-Sent Events quand les données ne vont que serveur→client (scores en direct, notifications) ; WebSockets quand le client envoie aussi beaucoup (chat, édition collaborative). Long polling en repli pour les réseaux qui bloquent les deux.
Côté serveur, une couche pub/sub diffuse vers le serveur de connexions qui tient l'utilisateur. Côté client, gérez la reconnexion avec backoff et reprise depuis le dernier event ID pour qu'une coupure ne fasse pas rater une mise à jour. Throttlez le rendu : 50 updates/s sur un graphique doivent être batchés en quelques repaints, pas 50.
100 000 utilisateurs regardant un live, c'est du fan-out serveur, éventuellement via un CDN supportant le streaming. Authentifier un WebSocket passe par un token dans le handshake initial, revalidé périodiquement.
36. Concevoir un plan de performance côté client pour des dashboards
Objectif : un dashboard analytique avec 20 graphiques qui charge en moins de 3 secondes et reste fluide pendant le filtrage.
Ne récupérez pas 20 graphiques d'un coup. Chargez d'abord les visibles, lazy-loadez le reste au scroll, et affichez des squelettes plutôt que des spinners. Pré-agrégez côté serveur pour que le client reçoive quelques centaines de lignes par graphique, jamais les événements bruts.
Cachez les résultats des requêtes en mémoire, indexés par l'état des filtres, pour éviter de refetch en cas d'allers-retours.
Les tables à milliers de lignes nécessitent la virtualisation (ne rendre que l'écran). Les calculs lourds vont dans un web worker pour libérer le thread principal.
Si l'API est lente et que vous ne pouvez pas la changer, cachez agressivement, montrez des données périmées avec horodatage, et rafraîchissez en arrière-plan. Des erreurs CORS quand le dashboard appelle une nouvelle API signifient que l'API doit autoriser l'origine du dashboard — soyez capable d'expliquer les preflight.
Questions de system design basées sur des scénarios
Ici, on teste votre jugement plus que l'architecture. Les besoins changent, la production casse, et l'intervieweur veut voir comment vous priorisez.
37. Le trafic explose x10 du jour au lendemain. Que changez-vous en premier ?
Commencez par ce qui casse en premier — rarement la couche sans état. L'autoscaling gère les web servers ; la base, le cache et les limites des tiers sont les points de rupture.
Immédiatement, vérifiez les métriques de saturation (connexions, CPU, profondeur de file) pour la base et le cache, relevez le plafond de l'autoscaler, et activez tout shedding disponible : couper des fonctionnalités non critiques ou servir des pages en cache. Sous 24 h, ajoutez des réplicas de lecture, optimisez le taux de hit du cache, et identifiez les requêtes dominantes. À plus long terme, faites le sharding et la mise en file que vous repoussiez.
Distinguer une vraie croissance d'un bot revient aux patterns de requêtes, aux user agents, et à l'évolution des conversions.
38. Vous atteignez les limites de lecture de la base. Cache, réplicas, ou sharding ?
Dans cet ordre, en général. Un cache devant les lectures les plus chaudes est peu coûteux et peut diviser par deux la charge base en un jour ; vérifiez le taux de hit et les logs de requêtes pour confirmer la répétitivité.
Les réplicas de lecture viennent ensuite quand le mix de lectures est large plutôt que chaud. Ils ajoutent de la latence de réplication, donc tout chemin read-after-write (un utilisateur sauvegarde et doit voir son changement) doit cibler le primaire. Le sharding résout plus les limites d'écriture que de lecture et coûte des requêtes cross-shard et une migration, donc en dernier, quand les deux premières options sont épuisées.
Si un client massif sur une seule table cause la charge, isolez ce tenant ou partitionnez par ID client.
39. Une dépendance critique en aval est instable. Retries, timeouts, coupe-circuits ?
Tout cela, mais dans le bon ordre. D'abord un timeout, car un appel sans timeout transforme une dépendance lente en votre panne — les threads s'accumulent. Puis des retries avec backoff exponentiel et jitter, mais seulement pour des appels idempotents et en nombre limité, sinon vous amplifiez la charge sur un service déjà en difficulté.
Ensuite un circuit breaker : après un seuil d'échecs, on cesse d'appeler un temps et on sert un fallback (cache, dégradé, message aimable). Surveillez l'état du breaker ; un breaker bloqué ouvert est un incident en soi.
Si la dépendance instable est votre prestataire de paiement, pas de fallback pour le débit lui-même ; mettez la commande en pending et traitez-la plus tard.
40. La latence a régressé après un lancement. Comment diagnostiquer ?
D'abord, confirmez et cadrez : quel percentile a bougé (p50 ou seulement p99), quelles endpoints, quelle région. Comparez à la timeline des déploiements ; si la régression coïncide avec une release, rollback d'abord et enquête ensuite.
Si rollback n'est pas la solution, suivez la requête. Les traces montrent quelle span a grossi. Coupables fréquents : une nouvelle requête sans index, un N+1 introduit par un nouveau champ, un changement de clé de cache qui a fait chuter le hit rate, ou un appel aval passé d'async à synchrone sur le chemin de requête.
Si seul le p99 a bougé et que le rollback n'a rien changé, cherchez des pauses GC, un voisin bruyant, ou un verrou.
41. Un bug d'incohérence des données apparaît. Que vérifiez-vous, que revenez-vous en arrière ?
Mesurez l'ampleur avant d'agir. Quelles tables ou enregistrements divergent, depuis quand, et cela continue-t-il ? Le « depuis quand » pointe souvent une release ou un run de job.
Vérifiez le chemin d'écriture des enregistrements affectés : migrations récentes, job exécuté deux fois, retry sans idempotence, course entre deux writers. Stoppez l'hémorragie en pausant le job fautif ou en rollbackant le code, puis réparez depuis une source de vérité (log d'événements bruts, grand livre, backup) plutôt qu'à la main. Gardez une trace de ce que vous avez changé et pourquoi.
Sans source de vérité, reconstituez ce que vous pouvez, marquez le reste, et ajoutez le pattern outbox pour éviter la récidive.
Erreurs courantes en entretien de system design
La plupart des candidats échouent pour une poignée de raisons récurrentes. Aucune n'est liée à « savoir moins ».
Comment se préparer aux entretiens de system design
La préparation fonctionne quand elle est répétable. Voici un process que je suivrais réellement.
Conclusion
Chaque question de cette liste vient d'un système que quelqu'un a dû construire puis garder en vie à 3 h du matin. Plus vous faites cela, moins l'entretien ressemble à une performance, et plus il ressemble à la description de votre mardi. Montez un side project avec une vraie file, faites l'astreinte, et assistez à une revue de design même quand ce n'est pas le vôtre.
Et si vous voulez un cadre structuré d'ici votre prochain loop, ces ressources vont plus loin sur les éléments sur lesquels s'appuient ces réponses :