System-Design-Fragen tauchen in mehr Interviews auf, als du denkst. Klar, bei Backend-Rollen. Aber auch bei Infrastruktur, Data Engineering und sogar in produktlastigen Positionen, in denen niemand erwartet, dass du im Loop eine Zeile Code schreibst.
Was wird hier wirklich getestet? Nicht, ob du die „richtige“ Architektur kennst – die gibt es nicht. Gesucht sind strukturiertes Denken, ehrliche Abwägungen und die Fähigkeit, weiter sauber zu argumentieren, wenn die Rahmenbedingungen unscharf sind und die Uhr tickt.
Die Erwartungen hängen stark vom Level ab. Eine Junior-Kandidatin, die gute Rückfragen stellt und ein klares Diagramm mit ein paar Kästchen skizziert, ist auf Kurs. Ein Senior, der nur das macht, hat ein Problem – auf diesem Level erwartet man Zahlen, Ausfallmodi und eine Meinung dazu, was man zuerst baut.
Die Rolle zählt ebenfalls. Eine Data-Engineer-Rolle wird bei Pipelines und Backfills nachhaken, eine Frontend-Entwicklerin bei Caching und State, jemand aus der Infra bei Rollouts und Blast Radius. Dieselbe Kernkompetenz, anderes Vokabular.
Ich erwähne das, weil die meisten Fragenlisten beide Dimensionen ignorieren und dir einfach 50 Prompts hinwerfen. Diese ist zuerst nach Level und dann nach Rolle sortiert, mit Szenariofragen am Ende. Wenn dir die Storage-Seite der Antworten wackelig vorkommt, unser Database Design Kurs deckt die Grundlagen ab.
So gehst du an ein System-Design-Interview heran
Immer die gleiche Struktur, etwa 45 Minuten:
- Klären (5 Min). Wer nutzt es, was muss es können, was ist außerhalb des Scopes, und wie sieht „gut“ aus.
- Mit Zahlen unterfüttern (2 Min). Nutzer, Requests pro Sekunde, Read/Write-Mix, Speicherwachstum pro Jahr. Grob ist okay, still bleiben nicht.
- High-Level skizzieren (10 Min). Clients, API-Layer, Storage, Cache, Queue. Fünf bis sechs Kästchen, nicht mehr.
- Datenmodell zeigen (5 Min). Tabellen oder Collections, Keys und die Access-Patterns, die sie bedienen.
- Deep Dive in ein Teilstück (10 Min). Lass die Interviewerin wählen oder nimm das Teil, das du am spannendsten findest.
- Ausfallmodi und Trade-offs (Rest). Was bricht, was würdest du monitoren, was würdest du zuerst bauen, wenn es echt wäre.
Erkläre alles laut. Stilles Denken kann niemand bewerten.
System-Design-Interviewfragen für Einsteiger
Hier geht es um Grundlagen: Anforderungen klären, bevor du zeichnest, ein einfaches Architekturdiagramm liefern und sinnvolle Storage-Entscheidungen treffen. Konsensus-Algorithmen erwartet hier niemand.
1. Entwirf einen URL-Shortener
Ein Shortener verwandelt eine lange URL in einen kurzen Code und leitet beim Aufruf weiter. Kläre zuerst, ob Links ablaufen und wie viele du erwartest. Sinnvolle Annahme: 100 Millionen neue Links pro Monat, mit etwa 100-fach mehr Reads als Writes.
Dieser read-lastige Mix prägt das Design: ein API-Server, eine Datenbank und ein Cache davor. Für den Shortcode entweder eine auto-inkrementierende ID base62-kodieren (sieben Zeichen ergeben rund 3,5 Billionen Kombinationen) oder einen zufälligen String generieren und auf Kollisionen prüfen.
Eine einzige Tabelle reicht: short_code als Primärschlüssel, long_url, created_at, expires_at und optional user_id. Heiße Codes liegen in Redis, sodass die Datenbank nur Misses sieht. Nutze einen 302-Redirect, wenn du Klick-Analytics willst, denn Browser cachen einen 301 und der zweite Besuch taucht nicht mehr auf.
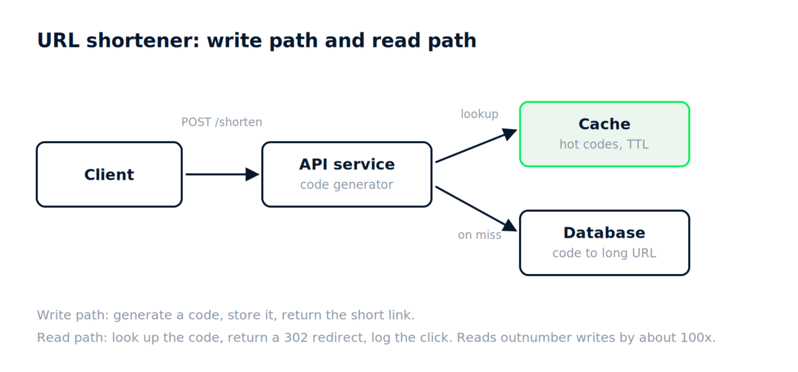
Bei 10 Milliarden Links shardest du nach Code, der ID-Generator wird zum Engpass, und wenn Leute Codes raten, wechselst du von sequentiell zu zufällig und fügst Rate Limiting hinzu.
2. Entwirf einen einfachen Rate Limiter
Ein Rate Limiter erlaubt N Requests pro Nutzer und Minute und liefert darüber hinaus einen 429. Kläre zuerst, ob das Limit pro Nutzer, pro IP oder pro API-Key gilt – das bestimmt deinen Cache-Key.
Drei Algorithmen decken die meisten Antworten ab. Fixed Window zählt Requests pro Minuten-Bucket, ist simpel, erlaubt aber am Rand das Doppelte. Sliding Window Log speichert jeden Timestamp, ist exakt, aber speicherhungrig. Token Bucket füllt mit konstanter Rate nach und erlaubt kleine Bursts – deshalb nutzen viele Gateways ihn.
Betreibe den Limiter als Middleware im API-Gateway mit Zählern in Redis unter einem TTL; INCR plus EXPIRE reicht für Fixed Window.
Mit zehn Gateway-Instanzen teilst du entweder die Redis-Zähler oder akzeptierst leichtes Überzählen mit lokalen Zählern. Lege vorab fest, was passiert, wenn Redis ausfällt: fail open und Missbrauch riskieren oder fail closed und alle blockieren.
3. Entwirf einen einfachen Key-Value-Store
Ein Key-Value-Store braucht get, put und delete. Für eine Einsteigerfrage bleibst du bei einem einzelnen Node. Ein In-Memory-Hash-Map bedient die Operationen. Für Haltbarkeit wird jeder Write zuerst an ein Log auf Disk angehängt, bevor du ihn bestätigst, und regelmäßig werden Snapshots gezogen, damit die Recovery nicht die gesamte Historie abspulen muss.
Wichtig ist, dass du den schnellen Pfad im Speicher vom dauerhaften Pfad auf Disk trennst – und verstehst, warum das Log zuerst kommt.
Wenn die Daten den Speicher sprengen, lautet die Antwort LSM-Tree – so arbeiten grob RocksDB und Cassandra. Brauchst du einen zweiten Node, repliziert der Primary das Log zu einem Follower, und ab mehr Nodes übernimmt Consistent Hashing.
4. Entwirf einen Cache (konzeptionell)
Ein Cache sitzt zwischen Anwendung und langsamerem Store, das Grundmuster ist Cache-Aside. Die App prüft den Cache, bei Miss liest sie die Datenbank und schreibt das Ergebnis mit TTL zurück. Einfach – aber die Invalidierungslogik gehört dir.
Eviction ist meist LRU, manchmal LFU bei schiefen Workloads. Die entscheidende Kennzahl ist die Hit-Rate; unter 80 % solltest du fragen, ob der Cache überhaupt hilft.
Spannend wird es bei Staleness. Wenn sich die Datenbank ändert und die Kopie im Cache nicht, sehen Nutzer alte Daten, bis die TTL abläuft. Kurze TTLs verkürzen das Fenster, erhöhen aber die Datenbanklast.
Wenn ein populärer Key abläuft und 10.000 Requests gleichzeitig die Datenbank treffen, bündelst du die Anfragen oder erneuerst den Key proaktiv. Write-Through vs. Write-Back: Write-Through hält den Cache korrekt, macht Writes aber langsamer; Write-Back ist schnell, verliert aber jüngste Writes, wenn der Cache vor dem Flush stirbt.
5. Entwirf einen einfachen Benachrichtigungsdienst
Ein Benachrichtigungsdienst sendet E-Mail, SMS und Push und versucht es erneut, wenn ein Provider ausfällt. Kläre Volumen und ob die Zustellreihenfolge wichtig ist – meist nicht.
Der Kern ist eine Queue. Producer schreiben ein Notification-Event hinein, und ein Worker pro Kanal zieht Events und ruft einen Provider wie SendGrid oder Twilio auf. Diese Trennung hält die Entscheidung „benachrichtigen“ getrennt vom „senden“, sodass ein langsamer SMS-Provider die App nicht blockiert.
Speichere jede Benachrichtigung mit Status (pending, sent, failed) und einem Idempotency-Key, damit ein Retry nicht doppelt sendet.
Nutzer, die Marketing aus, aber Sicherheitsalerts an wollen, brauchen eine Präferenzentabelle, die vor dem Enqueue geprüft wird. Ein Provider mit Limit 100 Nachrichten/Sekunde erfordert kanalweises Throttling im Worker.
6. Entwirf einen einfachen Dateispeicherdienst
Denk an Dropbox im Kleinen. Nutzer laden eine Datei hoch, bekommen einen Link und laden später wieder herunter. Kläre maximale Dateigröße und ob Teilen wichtig ist.
Metadaten (Owner, Dateiname, Größe, Checksumme, Erstellungsdatum) gehören in eine relationale Datenbank. Die Bytes in Object Storage wie S3 – niemals in die Datenbank. Für Uploads gibt die API eine vorunterzeichnete URL zurück, damit der Client direkt in den Object Storage schreibt und deine Server die Datei nie anfassen.
Zwei Nutzer laden dieselbe 2-GB-Datei hoch – das ist Dedup durch Hashing des Inhalts. Dateien über 5 GB brauchen Multipart-Upload mit Checksumme pro Chunk.
7. Entwirf ein Game-Leaderboard
Ein Leaderboard muss den Score eines Spielers aktualisieren, die Top 10 zurückgeben und den Rang eines einzelnen Spielers liefern. Frage zuerst, wie viele Spieler es gibt und wie oft sich Scores ändern.
Eine relationale Tabelle mit Index auf Score funktioniert bis zu einem Punkt, aber „Wie ist mein Rang?“ wird zu einem COUNT über alle über dir. Redis Sorted Sets lösen das: ZADD zum Aktualisieren, ZREVRANGE für die Top N, ZREVRANK für einen einzelnen Spieler – alles in logarithmischer Zeit.
Daily- und All-Time-Boards sind je ein Sorted Set pro Zeitraum, z. B. lb:2026-09-14. Wenn 50 Millionen Spieler den Redis-Speicher sprengen, halte dort nur die Top 100k und den Rest in der Datenbank.
System-Design-Interviewfragen für Fortgeschrittene
Auf diesem Level geht man davon aus, dass du echte Systeme gebaut und betrieben hast. Die Fragen bringen Queues, Read/Write-Skalierung und das Spannungsfeld zwischen Latenz, Kosten und Konsistenz ins Spiel.
8. Entwirf einen Newsfeed
Ein Feed erlaubt Posts, das Folgen anderer und das Lesen deren Beiträge – in Reverse-Chrono oder gerankt. Nimm 10 Millionen täglich aktive Nutzer an, die fünfmal am Tag öffnen – grob 600 Reads/Sekunde im Schnitt und deutlich mehr in Peaks.
Die zentrale Entscheidung ist, wann der Feed zusammengesetzt wird. Fan-out on write pusht jeden neuen Post in die vorcomputeten Feeds aller Follower – schnelle Reads, teure Writes. Fan-out on read baut beim Request zusammen – umgekehrter Trade-off. Meist mischt man: Fan-out on write für normale Nutzer, on read für Accounts mit Millionen Followern.
Das Datenmodell: posts, follows und eine pro Nutzer in Redis gehaltene Feed-Liste mit Post-IDs. Paginieren mit Cursor auf Post-ID statt Offset.
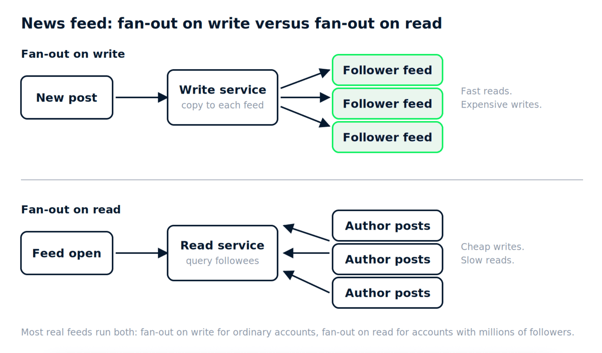
Ranking später hinzufügen heißt nicht, alles neu zu bauen; du scorst die Kandidaten-IDs aus der Feed-Liste zur Lesezeit.
9. Entwirf ein Chatsystem mit Multi-Device-Sync
Chat mit Multi-Device-Sync umfasst 1:1 und Gruppen, Zustellung auf jedes Gerät eines Nutzers und Historie, die Handywechsel überlebt. Nimm 50 Mio. tägliche Nutzer mit ~40 Messages je Nutzer an – 2 Mrd./Tag, etwa 23.000 Writes/Sek. im Schnitt und regional Peaks darüber.
Jeder Client hält einen WebSocket zu einem Chatserver, der Nachrichten in einen Store schreibt, partitioniert nach Konversations-ID, mit steigender Sequenznummer pro Konversation. Jedes Gerät merkt sich die letzte gesehene Sequenznummer und fordert bei Reconnect alles Neuere an – so funktioniert Multi-Device-Sync.
Der Store braucht hohen Schreibdurchsatz und Range-Reads nach Konversation – Wide-Column-Datenbanken wie Cassandra sind üblich. Delivery- und Read-Receipts laufen als kleine Events auf demselben Pfad zurück.
Sind zwei Freunde an unterschiedliche Chatserver verbunden, bringt Pub/Sub zwischen Servern oder ein Routingdienst (User→Server) die Nachricht ans Ziel. Gruppen mit 500 Mitgliedern fächern serverseitig aus, und Ordnungszusagen werden schwieriger.
10. Entwirf einen Ride-Sharing-Matching-Service
Halte es leichter als die Senior-Version. Fahrer senden alle paar Sekunden ihre Position, Rider fordern eine Fahrt an, und der Service muss binnen Sekunden einen nahen Fahrer zurückgeben.
Positionsupdates sind das Volumenproblem: 200.000 aktive Fahrer bei einem Update alle 4 Sekunden ergeben 50.000 Writes/Sek. Speichere aktuelle Positionen im Speicher, indiziert per Geohash oder H3-Zelle, nicht in einer relationalen Tabelle. Matching heißt dann: „Finde Fahrer in meiner Zelle und den Nachbarzellen“, nach ETA ranken und einen Fahrer sperren, damit nicht zwei Rider dasselbe Auto bekommen.
Akzeptiert ein Fahrer und verliert dann die Verbindung, läuft der Lock ab und der Rider wird neu gematcht. Eine heiße Zelle im Stadtzentrum bekommt feinere Zellen in dichten Gebieten – genau dafür sind hierarchische Indizes wie H3 da.
11. Entwirf ein System zur Metrikerfassung
Ein Metriksystem nimmt alle 10 Sekunden ein paar Hundert Metriken von Tausenden Servern entgegen und macht sie in Dashboards abfragbar.
Agenten bündeln Metriken und pushen in eine Ingestion-Schicht, die in eine Time-Series-Datenbank schreibt (oder in ein Kafka-Topic, von dem Consumer schreiben). Storage ist gestuft: Rohdaten mit voller Auflösung ein, zwei Tage; Ein-Minuten-Rollups für einen Monat; stündlich für ein Jahr. Downsampling läuft als Hintergrundjob.
Abfragen treffen das Rollup passend zum Zeitraum, damit ein 30-Tage-Chart nicht die Rohdaten scannt. Tag-Kardinalität (z. B. User-IDs als Label) killt die Datenbank – sag das ausdrücklich.
Push vs. Pull: Prometheus pullt, aber Push funktioniert besser durch Firewalls und für kurzlebige Jobs. Ein Agent mit verspäteten Timestamps wird innerhalb eines Lateness-Fensters akzeptiert und darüber abgelehnt, mit Zähler auf Rejections, damit eine kaputte Uhr sichtbar wird.
12. Entwirf eine Such-Autocomplete-Funktion
Autocomplete liefert die Top fünf Vervollständigungen innerhalb ~100 ms pro Tastenanschlag. Kläre, ob Vorschläge global oder personalisiert sind – Personalisierung ändert alles.
Die Antwort ist Vorberechnung. Eine Offline-Pipeline aggregiert Query-Logs, zählt Häufigkeiten und baut einen Trie (oder eine Prefix→Top-k-Tabelle), in dem jeder Knoten bereits seine besten Completions speichert. Die Serving-Schicht macht dann pro Keystroke nur ein Lookup, und die Struktur passt verteilt in den Speicher einiger Replikas.
Updates passieren batchweise, vielleicht stündlich, durch Rebuild und Swap. Trendende Queries können ein kleines Echtzeit-Overlay bekommen, das zur Lesezeit gemerged wird.
Ein Prefix wie „a“ trifft einen riesigen Teilbaum – deshalb speicherst du Top-k je Knoten statt zu traversieren. Typos brauchen einen separaten Fuzzy-Index – oder du akzeptierst den Miss.
13. Entwirf einen verteilten Job-Scheduler
Ein verteilter Scheduler ist cron für die ganze Firma: Job und Zeitplan definieren, zur richtigen Zeit höchstens einmal pro Tick ausführen, bei Fehlern retryen und zeigen, was passiert ist.
Jobdefinitionen und Zeitpläne liegen in einer Datenbank. Ein Scheduler-Service berechnet die nächste Laufzeit je Job und pusht fällige Jobs in eine Queue; Worker-Pools ziehen und führen aus. Das Knifflige ist, genau eine Scheduler-Instanz pro Job laufen zu lassen ohne SPOF – meist per Leader Election (Lock in ZooKeeper, etcd oder eine DB-Zeile mit Lease).
Jede Ausführung wird mit Status, Startzeit, Endzeit und Log-Standort erfasst. Diese Tabelle ist am Ende das, worauf alle schauen.
Ein Job, der länger als sein Intervall läuft, sollte überspringen, sich stauen oder überlappen – konfigurierbar. Sobald Job B von A abhängt, wird die Abhängigkeit ein DAG und der Scheduler enqueued erst, wenn Upstream erfolgreich war.
System-Design-Interviewfragen für Senior-Level
Senior-Terrain. Riesenskalierung, Multi-Region, Zuverlässigkeitsziele als Zahlen und die Kosten jeder Entscheidung. Erwartet wird, dass du Ausfallmodi proaktiv nennst.
Videostreaming sind zwei Systeme unter einem Namen. Beim Upload schiebt der Nutzer eine Rohdatei, eine Pipeline transkodiert mehrere Auflösungen und Bitraten, chunked in ein paar Sekunden lange Stücke und legt sie im Object Storage ab. Beim Abspielen liefert ein CDN diese Chunks, und der Player wechselt die Bitrate passend zur Bandbreite – adaptives Streaming via HLS oder DASH.
Nenne die Größenordnung: Hunderte Stunden Upload pro Minute, Milliarden Views am Tag, Storage im Exabyte-Bereich. Transcoding ist peinlich parallel – eine große Workerflotte zieht Jobs aus einer Queue. Metadaten wie Titel, Owner und View-Count leben in einer geshardeten Datenbank mit starkem Caching, weil die Startseite sie permanent liest. Object Storage und CDN-Edges replizieren über Regionen, und das relevante SLO ist die Playback-Startzeit, gefühlt wird die Rebuffering-Rate.
View-Counts bei viralen Videos sind approximative Zähler in Batches aggregiert – niemals ein DB-Increment pro View. Copyright-Matching ist Fingerprinting im selben Upload-Pfad.
Eine Logging-Plattform nimmt Logs von jedem Service, macht sie binnen Sekunden durchsuchbar und hält sie 30 Tage „hot“ und ein Jahr „cold“.
Agenten tailen Logfiles und schicken sie in einen dauerhaften Buffer wie Kafka, der Spikes abfedert und Indexer nachhinken lässt, ohne Daten zu verlieren. Indexer schreiben in einen Suchcluster mit einem Index pro Tag und Service, alte Indizes wandern komprimiert in Object Storage.
Kosten sind die eigentliche Restriktion – strukturierte Felder indexieren, Rohtext günstig halten. Jedem Service ein Quota geben, Index-Lag monitoren und PII bereits bei Ingestion säubern.
Ein Service, der 100× lauter loggt als üblich, wird der Reihe nach quotiert, gesampled, gedroppt und alarmiert. Regionsübergreifende Abfragen bedeuten föderierte Suche, jede Region besitzt ihre Daten.
16. Entwirf ein Echtzeit-Analytics-System
Echtzeit-Analytics heißt Dashboards mit Aggregaten der letzten Minuten, innerhalb von Sekunden aktualisiert, auf einem Stream von vielleicht einer Million Events pro Sekunde.
Ein Stream-Prozessor wie Flink hält Fenster-Aggregate, z. B. Minutencounts nach Dimension, und schreibt sie in einen schnellen Read-Store wie ClickHouse oder Druid. Dashboards fragen dort ab, nie den Rohstream.
Nenne die Trade-offs: exakte Counts vs. HyperLogLog für Distinct-User, Tumbling- vs. Sliding-Windows und Watermarks für späte Events. Setze ein Freshness-SLO und überwache Processor-Lag dagegen.
Eine hochkardinale Dimension wie User-ID sprengt die Aggregat-Tabelle – für diese Dimension auf Rohereignisse gehen. Backfill nach einem Bug heißt Replay aus dem Stream mit aufbewahrten Offsets.
17. Entwirf ein Zahlungssystem
Zahlungen sind das eine Design, bei dem Korrektheit über Skalierung steht. Das System muss einen Kunden belasten, es verbuchen, nie doppelt belasten, nie einen Eintrag verlieren und täglich mit der Bank abgleichen.
Idempotenz trägt das meiste: Jede Anfrage hat einen Key, der Service speichert das Ergebnis dazu und liefert bei Retries dasselbe Resultat. Geld bewegt sich durch ein Append-only-Doppik-Ledger, bei dem die Einträge einer Transaktion zu null summieren, in einer relationalen DB mit serialisierbarer Isolation. Hier ist Eventual Consistency die falsche Antwort.
Card-Network-Calls können zweifelhaft timeouten – Charges bekommen einen Pending-Status und ein Reconciliation-Job klärt sie. Multi-Region heißt eine Home-Region pro Konto – niemals Active-Active-Writes auf demselben Saldo.
Multiwährung heißt Ganzzahlen in Minor Units mit Währungscode, und eine Rückerstattung, die vor Settlement des Charges ankommt, wird von einer State Machine mit expliziten Übergängen gehandhabt.
18. Entwirf ein großskaliges Messaging-System
Ein Messaging-System lässt Producer publizieren und Consumer subscriben, übersteht Broker-Neustarts und erhält Ordnung dort, wo es zählt – bei Millionen Messages pro Sekunde.
Partitioniere jedes Topic so, dass Messages mit demselben Key auf derselben Partition landen – das ergibt Ordnung pro Key ohne globale Ordnung. Jede Partition ist ein Append-only-Log, repliziert auf wenige Broker, und Consumer committen ihren Offset nach Verarbeitung.
Standard ist At-least-once mit idempotenten Consumern. Retries gehen über ein Retry-Topic mit Backoff, „Gift-“Nachrichten in eine Dead-Letter-Queue. Consumer-Lag ist das Signal fürs SLO, und über Regionen hinweg besitzt pro Key eine Region die Writes – sonst reordnen sich beide gegenseitig.
Cr asht ein Consumer nach Verarbeitung, aber vor dem Commit, entsteht ein Duplikat – darum Idempotenz. Rebalancing-Stürme beruhigt man mit Sticky Assignment und Cooperative Rebalancing.
System-Design-Fragen für Backend Engineers
Hier geht es um APIs, Datenmodelle und sinnvolle Servicegrenzen. Erwarte Follow-ups zu Konsistenz, Caching und Logging.
19. Entwirf einen Authentifizierungs- und Autorisierungsdienst
Authentifizierung beantwortet „Wer bist du?“ und Autorisierung „Was darfst du?“ – Interviewer mögen, wenn du das trennst.
Nutze OAuth 2.0 und OpenID Connect statt eines Eigengewächses. Vergib kurzlebige Access Tokens und längerlebige Refresh Tokens, serverseitig gespeichert, damit du sie widerrufen kannst. Berechtigungen leben in einem Rollenmodell, geprüft durch eine kleine Bibliothek oder einen Policy-Service. Logge jeden Login-Versuch, Refresh und jede Verweigerung mit IP und Device – Tokens selbst nie loggen.
JWTs vermeiden ein Lookup pro Request, aber frühes Widerrufen braucht eine Denylist – das Lookup ist wieder da. Credential Stuffing bremst du mit Rate Limiting pro IP und Konto, Verzögerungen nach wiederholtem Scheitern und einem zweiten Faktor bei verdächtigen Logins.
20. Entwirf ein API-Gateway
Ein API-Gateway ist der zentrale Einstiegspunkt vor deinen Services und übernimmt Querschnittsaufgaben, damit es nicht jeder Service tut: Routing nach Pfad und Version, TLS-Terminierung, Authentifizierung, Rate Limiting und Request-Logging.
Das Gateway selbst sollte zustandslos sein und horizontal hinter einem Load Balancer skalieren. Routen-Konfiguration lebt in einer Control Plane und wird an Instanzen gepusht – nie neu deployen, um eine Route hinzuzufügen. Auth-Tokens werden einmal am Rand validiert, und das Gateway leitet die Nutzeridentität als Header weiter.
Wichtig aussprechen: Blast Radius. Das Gateway liegt auf jedem Request-Pfad, eine schlechte Config legt alles lahm; Configs validieren, schrittweise ausrollen und die eigene Logik des Gateways schlank halten.
Versionierung ohne Bruch bei mobilen Clients, die du nicht updaten kannst, heißt Pfad- oder Header-Versionierung mit weiterlebenden Altversionen. Das Gateway sollte keine Antworten mehrerer Services aggregieren – das gehört in eine Backend-for-Frontend-Schicht.
21. Entwirf ein Ordersystem für einen E-Commerce-Shop
Ein Ordersystem erstellt eine Bestellung, reserviert Inventar, kassiert, versendet und zeigt dem Kunden den Status. Orders sind eine State Machine (created, paid, packed, shipped, delivered, cancelled), und die erlaubten Transitionen sollten explizit sein.
Order-Erstellung ist ein POST mit Idempotency-Key, damit Doppelklicks keine zwei Orders erzeugen. Inventarreservierung und Zahlung involvieren andere Services – nutze eine Saga: Jeder Schritt publiziert ein Event, Fehler triggern kompensierende Aktionen (Inventar freigeben, erstatten). Schreibe das Event in eine Outbox-Tabelle in derselben Transaktion wie das Order-Update, damit Datenbank und Message-Bus nie widersprechen.
Auf der Read-Seite: eine Orders-Tabelle plus order_items, mit einem materialisierten Order-Überblick, gecacht für „Meine Bestellungen“.
Zwei Kunden kaufen gleichzeitig die letzte Einheit – gelöst per Row-Lock oder atomarem Decrement auf Inventar, einer bekommt „ausverkauft“. Monitoren solltest du Orders, die länger als erwartet in einem Status hängen.
22. Entwirf einen Feature-Flag-Service
Ein Feature-Flag-Service schaltet Features pro Umgebung, targetet nach Nutzerattributen oder Prozent und kann weltweit innerhalb von Sekunden flippen, wenn etwas bricht.
Flag-Definitionen und Targeting-Regeln liegen in einer kleinen Datenbank hinter einer Admin-API. Anwendungen binden ein SDK ein, das beim Start alle Flags holt, lokal cached und Regeln im Prozess auswertet – der Flag-Check kostet zur Request-Zeit praktisch nichts. Updates propagieren über eine Streaming-Verbindung oder Short Polling, und das SDK behält den letzten Stand, wenn der Flag-Service down ist.
Prozentuale Rollouts werden mit einem stabilen Hash aus User-ID und Flag-Key ausgewertet, sodass derselbe Nutzer immer auf derselben Seite landet.
Stale Flags findest du, indem du letzte Auswertungszeitpunkte trackst und Owner erinnerst. Fällt der Flag-Service beim Start aus, fällt die App auf Defaults im Code zurück.
23. Entwirf eine Recommendation-Serving-API
Eine Recommendation-API liefert 20 Items pro Nutzer unter 100 ms bei einigen Tausend Requests pro Sekunde – ohne tiefe ML-Kenntnisse im Design.
Trenne Offline und Online. Ein Offline-Job berechnet Kandidatenlisten pro Nutzer in einen Low-Latency-Key-Value-Store. Die Online-API holt sie, rerankt mit ein paar frischen Features wie „auf Lager“, filtert Gekauftes raus und liefert die Liste. Halte einen Fallback mit beliebten Items pro Kategorie vor und logge jede ausgelieferte Liste mit Request-ID, damit du sie später mit Klicks joinen kannst.
Ein neuer Nutzer bekommt den Fallback, bis ein paar Interaktionen eintreffen. Die 100 ms teilen sich grob auf: 10 fürs Fetch, 30 fürs Reranking, 10 für Serialisierung und 50 als Puffer.
System-Design-Fragen für Infrastruktur/DevOps
Reliability, Deployment, Automatisierung und Observability. Das Leitmotiv: Wie änderst du Dinge sicher – und wie merkst du schnell, wenn es falsch war.
24. Entwirf eine CI/CD-Pipeline für Microservices
Eine CI/CD-Pipeline für Microservices muss Dutzende unabhängig deploybarer Services mit Tests, Security-Checks und einem Weg in die Produktion handhaben, der keinen Menschen um 3 Uhr morgens braucht.
Einmal bauen, dasselbe Artefakt überall deployen. Die Pipeline lintet, läuft Unit-Tests, baut ein Container-Image mit Commit-SHA als Tag, scannt es und pusht es in ein Registry. Deployment promotet das Image dann durch Umgebungen (Dev, Staging, Prod) per Konfiguration – ohne Neubau.
Der Produktionsrollout sollte progressiv sein: Canary auf ein paar Prozent Traffic, Fehler- und Latenzraten in einem definierten Fenster beobachten, dann automatisch fortsetzen oder zurückrollen. Rollback heißt: das vorherige Image-Tag erneut deployen – schnell, weil du nie neu gebaut hast.
Wenn die Änderung von Service A den Vertrag von Service B bricht, helfen Contract-Tests in CI und rückwärtskompatible API-Änderungen. Monorepo vs. viele Repos ist weniger wichtig, solange die Pipeline nur baut, was sich geändert hat.
25. Entwirf zentrales Monitoring und Alerting
Zentrales Monitoring bringt Metriken, Logs und Traces aus allen Services an einen Ort – mit Alerts, die nur dann wecken, wenn Nutzer betroffen sind.
Metriken fließen in einen Time-Series-Store, Logs in die Plattform aus Frage 15, Traces in ein Tracing-Backend – alles korreliert über eine gemeinsame Request-ID. Die entscheidende Designfrage ist: Worauf alerten wir? Auf Symptome (Error-Rate, Latenz-Perzentile, Sättigung) verknüpft mit SLOs, nicht auf Ursachen wie „CPU bei 80 %“.
Paging-Müdigkeit killt Rufbereitschaften – jeder Page braucht ein Runbook und ein Review. Alles, was zweimal in einer Woche ohne klare Aktion paged, wird zur Ticketmeldung degradiert.
Ein SLO für einen brandneuen Service ergibt sich aus ein paar Wochen Messung – Ziel leicht besser als der aktuelle Zustand setzen. Und wenn das Monitoring selbst down ist, sagen dir externe synthetische Checks und ein Dead-Man’s-Switch-Alert Bescheid.
26. Entwirf einen Ansatz zum Secrets Management
Secrets Management stellt Datenbankpasswörter, API-Keys und Zertifikate zur Laufzeit bereit – nie im Source Code, regelmäßig rotiert und auditiert.
Ein zentraler Secrets-Store (HashiCorp Vault, ein Cloud-Secrets-Manager) hält alles. Services authentifizieren sich mit ihrer Workload-Identität (ein Kubernetes-Service-Account, eine IAM-Rolle), nie mit einem langlebigen Token, und holen Secrets beim Start oder on demand. Bevorzuge dynamische Secrets, wo möglich: Der Store generiert eine DB-Credential für eine Stunde – Rotation inklusive.
Jeden Read auditieren. Und einen „Break-Glass“-Pfad dokumentieren, wenn der Secrets-Store selbst down ist – das wird passieren.
Ein Key, den eine Entwicklerin versehentlich committed, wird durch Scans in CI entdeckt, sofort rotiert und als kompromittiert behandelt. Secrets in Umgebungsvariablen sind verbreitet, leaken aber über Crash-Dumps und Child-Prozesse – besser als Files mounten oder im Prozess abrufen.
27. Entwirf Autoscaling und eine Rollout-Strategie
Autoscaling und Rollout zusammen müssen tägliche Traffic-Schwankungen von 5× ohne Handarbeit abfangen, während mehrmals täglich deployt wird.
Skaliere anhand eines Signals, das Nutzerschmerz abbildet – meist Request-Rate oder Latenz pro Instanz – nicht nur CPU. Setze Mindestreplikas, damit ein Kaltstart keinen Spike abbekommt, und ein Maximum, damit ein Bug dich nicht ruiniert. Hoch schnell, runter langsam.
Für Rollouts: Blue/Green, wenn du sofort switchen und zurückrollen willst; Canary, wenn du echte Last erst auf einem kleinen Anteil beobachten möchtest. Kombiniere Canary vorsichtig mit dem Autoscaler, sonst verzerrt unabhängiges Skalieren den Vergleich.
Wenn das Scaling einen plötzlichen Spike zwei Minuten hinterher hinkt, helfen vorausschauendes Skalieren per Zeitplan oder ein höheres Minimum. Und 50 neue Instanzen, die DB-Verbindungen leeren, sind der Grund für Connection-Pooling in einer Proxy-Schicht.
System-Design-Fragen für Data Engineers
Pipelines, Speicherformate, Batch vs. Streaming und ob die Daten vertrauenswürdig sind. Dasselbe Framework wie zuvor, aber die Ausfallmodi drehen sich um verlorene, doppelte oder verspätete Daten – nicht um verlorene Requests.
28. Entwirf eine Event-Ingestion-Pipeline
Eine Event-Ingestion-Pipeline nimmt Verhaltensevents von Web- und Mobile-Clients entgegen und macht sie innerhalb einer Stunde abfragbar. Nimm 50.000 Events/Sek. im Peak an, mit Clients, die offline gehen und retryen.
Clients bündeln Events über ein SDK und posten an einen Collector-Service, der sie gegen ein Schema-Registry validiert und in einen Stream (Kafka oder Managed-Äquivalent) schreibt. Ein Consumer landet Rohdaten im Object Storage, partitioniert nach Stunde, in einem spaltenorientierten Format wie Parquet. Downstream-Jobs lesen von dort.
Retries bedeuten Duplikate, daher trägt jedes Event eine clientgenerierte UUID und der Landing-Job dedupliziert innerhalb eines Fensters. Schemaänderungen laufen über die Registry mit Kompatibilitätsprüfungen – eine Mobile-App in alter Version sendet monatelang die alte Form.
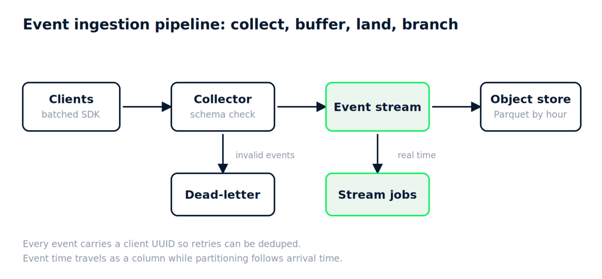
Ein Event mit Timestamp von vor drei Tagen landet nach Ankunftszeit, behält seine Event-Zeit als Spalte und lässt Downstream entscheiden. Schlechte Events gehen auf einen Dead-Letter-Pfad und werden nie stillschweigend gedroppt.
29. Entwirf ein Streaming-ETL-System
Streaming-ETL transformiert Events bei Ankunft, joint sie mit Referenzdaten und schreibt Ergebnisse innerhalb von Sekunden in einen Serving-Store.
Ein Stream-Prozessor liest vom Ingestion-Topic, appliziert Transformationen und reichert mit Referenzdaten an, die im Speicher geladen und periodisch aktualisiert werden. State (für Fenster-Joins oder Aggregationen) checkpointet in dauerhaften Storage, damit ein abgestürzter Job ohne Reprocessing vom Anfang fortsetzen kann.
Der gewünschte Trade-off: Exactly-once vs. At-least-once. Exactly-once ist Ende-zu-Ende erreichbar, wenn der Sink Transaktionen oder idempotente Writes unterstützt – kostet aber Latenz und Komplexität. At-least-once mit idempotenten Sinks bringt den Großteil des Nutzens.
Spätdaten handhabst du mit Watermarks und einer definierten Grace-Periode – danach geht es in eine Late-Arrivals-Tabelle.
Referenzdaten, die sich mitten im Stream ändern, sollten versioniert sein – gejoint wird auf die zum Eventzeitpunkt gültige Version. Ein Backfill sechs Monate nach einem Logikfix spielt Rohdaten im Batch neu ab – nicht durch den Stream.
30. Entwirf ein Data Warehouse und den Modellierungsansatz
Ein Warehouse muss Analysten und Dashboards konsistente Metriken über Sales-, Marketing- und Produktdaten liefern – mit Historie.
Rohdaten unverändert in Bronze landen, in Silver bereinigen und konform machen, in Gold geschäftsnahe Tabellen bauen. Gold als Star-Schema modellieren: Faktentabellen in feinster sinnvoller Körnung (z. B. eine Zeile pro Order-Position) und Dimensionstabellen für Kunden, Produkte, Datum. Slowly Changing Dimensions wo wichtig als Type 2, damit ein Regionswechsel eines Kunden den Umsatz des Vorjahres nicht überschreibt.
Große Faktentabellen nach Datum partitionieren, nach häufigen Filterspalten clustern und Transformationen in Versionskontrolle (dbt o. Ä.) mit Tests halten.
Wenn zwei Teams „aktiver Kunde“ unterschiedlich definieren, setzt eine Metrics-Layer mit einer verbindlichen Definition dem ein Ende. Ein spät eintreffender Fakt, der auf einen noch fehlenden Dimensionsschlüssel verweist, bekommt eine Platzhalter-Dimension, die später nachgezogen wird.
31. Entwirf einen Feature Store
Ein Feature Store berechnet Features einmal und nutzt sie für Training und Online-Prediction – ohne Training/Serving-Skew. Es sind zwei Stores mit einer Definition: Der Offline-Store (Warehouse oder Lake) hält Feature-Historie für Trainingssätze, der Online-Store (Redis, DynamoDB) den neuesten Wert pro Entität für Low-Latency-Lookups zur Prediction-Zeit.
Eine einzige Feature-Definition treibt beide an, und ein Job materialisiert regelmäßig von Offline nach Online.
Kritisch ist Point-in-Time-Korrektheit. Beim Erstellen eines Trainingssatzes muss jede Zeile Feature-Werte zum Timestamp der Zeile verwenden – nicht die aktuellen. Sonst lernt dein Modell aus der Zukunft und glänzt nur bis zum Go-Live.
Ein Feature, das in Echtzeit teuer ist, wird vorab mit etwas Staleness berechnet oder beim Write berechnet. Um zu wissen, dass Online- und Offline-Werte übereinstimmen, stichproben und vergleichen – und logge die tatsächlich servierten Features.
32. Entwirf eine Schicht für Datenqualität und -lineage
Eine Datenqualitäts- und Lineage-Schicht erkennt kaputte Daten, bevor Dashboards es tun, und beantwortet „Woher kommt diese Spalte?“ ohne Code zu lesen.
Qualitätschecks laufen als Pipeline-Schritte: Zeilenzahlen in erwarteten Bereichen, Nullraten, Freshness (ist die Partition pünktlich gelandet) und einige Business-Checks (Umsatz nie negativ). Fehler blockieren Downstream-Jobs und alarmieren den Owner. Check-Ergebnisse werden über die Zeit gespeichert, damit du Drift siehst – nicht nur das heutige Pass/Fail.
Lineage wird aus dem Transformationscode erfasst (SQL-Parsing oder Metadaten des Orchestrators) und als Graph gespeichert: Tabelle→Tabelle, wo möglich Spalte→Spalte. Dieser Graph treibt Impact-Analysen, wenn jemand eine Spalte droppen will.
Wenn Checks länger dauern als die Pipeline, stichprobe oder führe schwere Checks asynchron aus und alarme statt zu blockieren. Lineage über inkompatible Tools hinweg heißt OpenLineage oder manuelle Annotationen – mit dokumentierten Lücken.
System-Design-Fragen für Frontend/Full-Stack
Client-Performance, State-Management, Caching und wie der Browser mit der API spricht. Sicherheitsbasics tauchen hier ebenfalls auf.
33. Entwirf die Architektur für eine stark frequentierte Web-App
Hier: inhaltslastige Seite mit Millionen täglichen Besuchern, schneller First Paint und personalisierten Bereichen für eingeloggte Nutzer.
Statische Assets auf ein CDN mit langen Cache-Lebenszeiten und gehashten Dateinamen. Seiten, die für alle gleich sind, werden serverseitig gerendert und am Edge gecacht; personalisierte Teile laden clientseitig nach dem Shell-Paint. Dieses Hybrid hält die Time-to-First-Byte niedrig, ohne persönliche Daten stale auszuliefern.
API-Calls vom Client gehen durchs Gateway mit kurzlebigen Tokens. Setze Cache-Header bewusst: Cache-Control mit stale-while-revalidate für Inhalte, die ein paar Sekunden alt sein dürfen, no-store für alles Persönliche.
Für ein Dashboard hinter Login ist Client-Side-Rendering meist okay, da SSR ohne SEO wenig bringt. Und ein Cache-Key, der versehentlich das Session-Cookie enthält, gibt jedem seine eigene Kopie – die Hit-Rate bricht ein.
34. Entwirf Offline-First-Sync
Offline-First-Sync meint eine Notiz- oder Felddaten-App, die ohne Verbindung funktioniert und bei Rückkehr synchronisiert – ohne Bearbeitungen zu verlieren.
Jeder Write geht zuerst in einen lokalen Store (IndexedDB, auf Mobile SQLite) und in eine Queue ausstehenden Mutationen. Wenn die Verbindung zurück ist, pusht der Client die Queue in Reihenfolge und pullt Änderungen seit seinem letzten Sync-Token. Jede Mutation trägt Client-ID und Sequenznummer, damit der Server deduplizieren kann.
Konflikte sind das Hauptproblem. Last-Write-Wins ist simpel und verliert Daten. Field-Level-Merging löst die meisten Fälle.
CRDTs ermöglichen automatische Merges für Text und Listen, kosten aber Komplexität – nur, wenn kollaboratives Editieren wirklich verlangt ist.
Bearbeitet ein Nutzer offline auf zwei Geräten und bringt beide zurück, werden beide Edits angewandt, der Konflikt markiert und im UI gezeigt. Eine Pending-Queue, die auf 10.000 Mutationen wächst, sollte kompaktiert werden – zehn Edits an einem Feld werden zu einem.
35. Entwirf Echtzeit-UI-Updates
Echtzeit-UI-Updates bedeuten ein Dashboard oder Chat, das serverseitige Änderungen binnen einer Sekunde an Tausende gleichzeitige Nutzer ausliefert.
Wähle den Transport nach Richtung: Server-Sent Events, wenn Daten nur Server→Client fließen (Live-Scores, Notifications); WebSockets, wenn der Client viel sendet (Chat, kollaboratives Editieren). Long Polling als Fallback für Netzwerke, die beides blocken.
Serverseitig fächert eine Pub/Sub-Schicht Änderungen an den Connection-Server aus, der den Nutzer hält. Clientseitig: Reconnect mit Backoff und Resume ab der letzten Event-ID, damit ein Drop kein Updateverlust ist. Rendering drosseln: 50 Updates/Sek. für ein Chart werden gebatcht – nicht 50 Repaints.
100.000 Nutzer, die ein Live-Event schauen, bedeuten serverseitigen Fan-out – ggf. über ein CDN mit Streaming-Support. WebSocket-Auth: Token im initialen Handshake, periodisch revalidiert.
Ziel: Ein Analytics-Dashboard mit 20 Charts lädt in unter drei Sekunden und bleibt beim Filtern reaktionsschnell.
Nicht 20 Charts auf einmal laden. Sichtbare zuerst, den Rest lazy on Scroll, Skeletons statt Spinnern. Serverseitig voraggregieren, damit der Client pro Chart nur ein paar Hundert Zeilen erhält – niemals Rohereignisse.
Query-Ergebnisse im Speicher nach Filterzustand cachen, damit ein Filter-Toggle nicht neu lädt.
Tabellen mit Tausenden Zeilen brauchen Virtualisierung (nur Sichtbares rendern). Schwere Berechnungen in einen Web Worker auslagern, damit der Main Thread frei bleibt.
Wenn die API langsam ist und du sie nicht ändern kannst, cache aggressiv, zeige veraltete Daten mit Zeitstempel und refreshe im Hintergrund. CORS-Fehler beim Aufruf einer neuen API bedeuten: Die API muss die Origin des Dashboards erlauben – und du solltest Preflight Requests erklären können.
Szenario-basierte System-Design-Interviewfragen
Hier zählt Urteilsvermögen mehr als Architektur. Anforderungen ändern sich, Produktion bricht, und es geht darum, wie du triagierst.
37. Traffic verzehnfacht sich über Nacht. Was änderst du zuerst?
Starte mit dem, was zuerst bricht – selten die zustandslose Schicht. Autoscaling fängt Webserver ab; Datenbank, Cache und Third-Party-Rate-Limits sind die typischen Kippunkte.
Sofort: Sättigungsmetriken (Connections, CPU, Queue-Tiefe) für DB und Cache prüfen, das Autoscaler-Limit erhöhen und Lastabwurf einschalten – nicht kritische Features droppen oder gecachte Seiten serven. Innerhalb eines Tages Read-Replikas hinzufügen, die Cache-Hit-Rate tunen und die dominanten Queries finden. Langfristig die Sharding- und Queueing-Arbeiten angehen, die du aufgeschoben hast.
Echtes Wachstum vs. Bot erkennst du an Requestmustern, User Agents und daran, ob Conversions mitziehen.
38. Du stößt an DB-Read-Grenzen. Cache, Replikas oder Sharding?
In dieser Reihenfolge, meist. Ein Cache vor den heißesten Reads ist günstig und halbiert die DB-Last oft binnen eines Tages – prüfe Hit-Rate und Query-Log, ob Reads wirklich repetitiv sind.
Read-Replikas kommen als Nächstes, wenn die Read-Last breit statt heiß ist. Sie bringen Lag mit – jeder Read-after-Write-Pfad (User speichert und will es sofort sehen) muss zum Primary. Sharding löst eher Write-Grenzen als Read-Grenzen und kostet Cross-Shard-Queries und Migration – also zuletzt, wenn die ersten zwei ausgeschöpft sind.
Verursacht ein einzelner Großkunde die Last auf einer Tabelle, isoliere diesen Tenant oder partitioniere nach Kunden-ID.
39. Eine kritische Downstream-Abhängigkeit ist flaky. Retries, Timeouts, Circuit Breaker?
Alle – in der richtigen Reihenfolge. Zuerst ein Timeout, denn ein Call ohne Timeout macht eine langsame Abhängigkeit zu deinem eigenen Ausfall, wenn Threads sich stauen. Dann Retries mit Exponential Backoff und Jitter – aber nur für idempotente Calls und nur wenige Male, sonst verstärkst du die Last auf einen ohnehin strauchelnden Service.
Dann ein Circuit Breaker: Nach einem Fehler-Schwellwert rufst du eine Zeitlang nicht an und lieferst ein Fallback (Cache, degradierte Antwort, freundlicher Fehler). Überwache den Breaker-State – ein offen hängender Breaker ist ein eigener Incident.
Ist der flaky Dependency dein Payment-Provider, gibt es kein Fallback für den Charge selbst; stelle die Order als „pending“ in die Queue und verarbeite später.
40. Latenz ist nach einem Launch schlechter. Wie gehst du vor?
Zuerst verifizieren und einschränken: Welches Perzentil (p50 oder nur p99), welche Endpunkte, welche Region. Mit dem Deploy-Timeline vergleichen; passt der Anstieg zu einem Release, erst zurückrollen, dann untersuchen.
Wenn Rollback nicht hilft, folge der Anfrage. Traces zeigen, welcher Span wuchs. Häufige Übeltäter: neue Query ohne Index, ein N+1-Muster durch ein neues Feld, ein geänderter Cache-Key, der die Hit-Rate fallen ließ, oder ein Downstream-Call, der früher asynchron war und nun im Requestpfad liegt.
Wenn nur p99 gestiegen ist und Rollback nicht half, prüfe Garbage-Collection-Pausen, einen noisy neighbor oder einen Lock.
41. Ein Dateninkonsistenz-Bug taucht auf. Was prüfst du, was rollst du zurück?
Begrenze den Schaden, bevor du etwas änderst. Welche Tabellen oder Datensätze widersprechen sich, seit wann, und passiert es noch? Das „seit wann“ zeigt meist auf ein Deploy oder einen Joblauf.
Prüfe den Write-Pfad der betroffenen Datensätze: jüngste Migrationen, ein Job, der doppelt lief, ein Retry ohne Idempotenz, ein Race zwischen zwei Schreibern. Stoppe die Blutung, indem du den schuldigen Job pausierst oder Code zurückrollst, und repariere aus einer Source of Truth (Raw-Event-Log, Ledger, Backup) statt Zeilen von Hand zu editieren. Halte fest, was du warum geändert hast.
Ohne Source of Truth rekonstruierst du, was geht, markierst den Rest und führst das Outbox-Pattern ein, damit es nicht erneut passiert.
Häufige Fehler in System-Design-Interviews
Die meisten scheitern an denselben wenigen Gründen. Keiner hat mit „Wissen“ zu tun.
- Rückfragen überspringen. Direkt zu Kästchen springen heißt oft: 40 Minuten lang das falsche Problem lösen.
- Keine Zahlen. „Es muss skalieren“ sagt nichts. 5.000 Writes/Sek. und 2 TB/Jahr sagen etwas – und ändern das Design.
- Eine perfekte Architektur. Interviewer wollen hören: „Ich nehme X wegen Y, die Kosten sind Z.“ Eine einzelne selbstsichere Antwort ohne Trade-offs wirkt auswendig gelernt.
- Zu früh Microservices. Ein Monolith mit guten Grenzen ist für die meisten Einsteiger- und Mittelstufenfragen ein gutes Antwortmuster. 12 Services auf dem Whiteboard erzeugen Ausfallmodi, die du verteidigen musst.
- Betrieb ignorieren. Wie wird deployt, was monitorst du, was passiert beim Node-Ausfall. Seniors fragen das – und Juniors punkten, wenn sie es von sich aus ansprechen.
- Das Datenmodell vergessen. Kästchen und Pfeile ohne Vorstellung, was in den Tabellen steht. Besonders teuer für Data-Rollen.
- Still werden. Zwei Minuten still denken sind für das Gegenüber eine Ewigkeit. Erkläre, auch wenn es nur ist: „Ich wäge hier zwei Optionen ab.“
So bereitest du dich auf System-Design-Interviews vor
Vorbereitung wirkt, wenn sie wiederholbar ist. Hier ein Prozess, dem ich wirklich folgen würde.
- Immer dieselbe Struktur. Die sechs Schritte vom Anfang dieses Artikels, in dieser Reihenfolge, bei jeder Übungsfrage. Schreib sie auf eine Karte und übe, bis die Abfolge automatisch ist und du keine Aufmerksamkeit mehr auf „was kommt als Nächstes“ verschwendest.
- Mock-Interviews mit Timer. Such dir eine Freundin, einen Kollegen oder nutze einen Voice-Recorder – und mach 45 Minuten laut, mit Zwischenfragen. Die ersten Male sind holprig – genau darum geht’s.
- Bau dir eine Design-Checkliste. Eine Einseiter-Cheat-Sheet mit deinen Standardmustern: Cache-Aside, Queues zum Entkoppeln, Pub/Sub für Fan-out, CQRS bei divergierenden Reads/Writes, Sharding nach Key, Outbox für Konsistenz zwischen DB und Bus. Vor jeder Session kurz durchgehen.
- Trade-offs erklären, nicht nur zeichnen. Zu jedem Muster in einem Satz sagen können, was es bringt und was es kostet. Dieser Satz trennt „Bestanden“ von „Stark bestanden“.
- Nach Level und Rolle üben. Nimm fünf Fragen für dein Level und vier für deine Rolle aus dieser Liste – übe die richtig statt alle 41 zu überfliegen. Wenn dir die Datenpipeline-Fragen fremd waren, unsere Introduction to Data Engineering und Streaming Concepts Kurse decken die Vokabeln, auf denen diese Antworten beruhen.
Fazit
Jede Frage in dieser Liste stammt aus einem System, das jemand bauen und dann um 3 Uhr morgens am Leben halten musste. Je mehr du davon tust, desto weniger fühlt sich das Interview wie Theater an – und desto mehr wie die Beschreibung deines Dienstags. Starte ein Side Project mit echter Queue, geh in die Rufbereitschaft, bitte darum, bei einem Design-Review dabei zu sein – auch wenn es nicht dein Design ist.
Und wenn du bis zum nächsten Loop strukturiert Land gewinnen willst, diese vertiefen die Bausteine, auf die sich die Antworten hier stützen:



System-Design-Fragen tauchen in mehr Interviews auf, als du denkst. Klar, bei Backend-Rollen. Aber auch bei Infrastruktur, Data Engineering und sogar in produktlastigen Positionen, in denen niemand erwartet, dass du im Loop eine Zeile Code schreibst.
Was wird hier wirklich getestet? Nicht, ob du die „richtige“ Architektur kennst – die gibt es nicht. Gesucht sind strukturiertes Denken, ehrliche Abwägungen und die Fähigkeit, weiter sauber zu argumentieren, wenn die Rahmenbedingungen unscharf sind und die Uhr tickt.
Die Erwartungen hängen stark vom Level ab. Eine Junior-Kandidatin, die gute Rückfragen stellt und ein klares Diagramm mit ein paar Kästchen skizziert, ist auf Kurs. Ein Senior, der nur das macht, hat ein Problem – auf diesem Level erwartet man Zahlen, Ausfallmodi und eine Meinung dazu, was man zuerst baut.
Die Rolle zählt ebenfalls. Eine Data-Engineer-Rolle wird bei Pipelines und Backfills nachhaken, eine Frontend-Entwicklerin bei Caching und State, jemand aus der Infra bei Rollouts und Blast Radius. Dieselbe Kernkompetenz, anderes Vokabular.
Ich erwähne das, weil die meisten Fragenlisten beide Dimensionen ignorieren und dir einfach 50 Prompts hinwerfen. Diese ist zuerst nach Level und dann nach Rolle sortiert, mit Szenariofragen am Ende. Wenn dir die Storage-Seite der Antworten wackelig vorkommt, unser Database Design Kurs deckt die Grundlagen ab.
So gehst du an ein System-Design-Interview heran
Immer die gleiche Struktur, etwa 45 Minuten:
Erkläre alles laut. Stilles Denken kann niemand bewerten.
System-Design-Interviewfragen für Einsteiger
Hier geht es um Grundlagen: Anforderungen klären, bevor du zeichnest, ein einfaches Architekturdiagramm liefern und sinnvolle Storage-Entscheidungen treffen. Konsensus-Algorithmen erwartet hier niemand.
1. Entwirf einen URL-Shortener
Ein Shortener verwandelt eine lange URL in einen kurzen Code und leitet beim Aufruf weiter. Kläre zuerst, ob Links ablaufen und wie viele du erwartest. Sinnvolle Annahme: 100 Millionen neue Links pro Monat, mit etwa 100-fach mehr Reads als Writes.
Dieser read-lastige Mix prägt das Design: ein API-Server, eine Datenbank und ein Cache davor. Für den Shortcode entweder eine auto-inkrementierende ID base62-kodieren (sieben Zeichen ergeben rund 3,5 Billionen Kombinationen) oder einen zufälligen String generieren und auf Kollisionen prüfen.
Eine einzige Tabelle reicht:
short_codeals Primärschlüssel,long_url,created_at,expires_atund optionaluser_id. Heiße Codes liegen in Redis, sodass die Datenbank nur Misses sieht. Nutze einen 302-Redirect, wenn du Klick-Analytics willst, denn Browser cachen einen 301 und der zweite Besuch taucht nicht mehr auf.Bei 10 Milliarden Links shardest du nach Code, der ID-Generator wird zum Engpass, und wenn Leute Codes raten, wechselst du von sequentiell zu zufällig und fügst Rate Limiting hinzu.
2. Entwirf einen einfachen Rate Limiter
Ein Rate Limiter erlaubt N Requests pro Nutzer und Minute und liefert darüber hinaus einen 429. Kläre zuerst, ob das Limit pro Nutzer, pro IP oder pro API-Key gilt – das bestimmt deinen Cache-Key.
Drei Algorithmen decken die meisten Antworten ab. Fixed Window zählt Requests pro Minuten-Bucket, ist simpel, erlaubt aber am Rand das Doppelte. Sliding Window Log speichert jeden Timestamp, ist exakt, aber speicherhungrig. Token Bucket füllt mit konstanter Rate nach und erlaubt kleine Bursts – deshalb nutzen viele Gateways ihn.
Betreibe den Limiter als Middleware im API-Gateway mit Zählern in Redis unter einem TTL; INCR plus EXPIRE reicht für Fixed Window.
Mit zehn Gateway-Instanzen teilst du entweder die Redis-Zähler oder akzeptierst leichtes Überzählen mit lokalen Zählern. Lege vorab fest, was passiert, wenn Redis ausfällt: fail open und Missbrauch riskieren oder fail closed und alle blockieren.
3. Entwirf einen einfachen Key-Value-Store
Ein Key-Value-Store braucht get, put und delete. Für eine Einsteigerfrage bleibst du bei einem einzelnen Node. Ein In-Memory-Hash-Map bedient die Operationen. Für Haltbarkeit wird jeder Write zuerst an ein Log auf Disk angehängt, bevor du ihn bestätigst, und regelmäßig werden Snapshots gezogen, damit die Recovery nicht die gesamte Historie abspulen muss.
Wichtig ist, dass du den schnellen Pfad im Speicher vom dauerhaften Pfad auf Disk trennst – und verstehst, warum das Log zuerst kommt.
Wenn die Daten den Speicher sprengen, lautet die Antwort LSM-Tree – so arbeiten grob RocksDB und Cassandra. Brauchst du einen zweiten Node, repliziert der Primary das Log zu einem Follower, und ab mehr Nodes übernimmt Consistent Hashing.
4. Entwirf einen Cache (konzeptionell)
Ein Cache sitzt zwischen Anwendung und langsamerem Store, das Grundmuster ist Cache-Aside. Die App prüft den Cache, bei Miss liest sie die Datenbank und schreibt das Ergebnis mit TTL zurück. Einfach – aber die Invalidierungslogik gehört dir.
Eviction ist meist LRU, manchmal LFU bei schiefen Workloads. Die entscheidende Kennzahl ist die Hit-Rate; unter 80 % solltest du fragen, ob der Cache überhaupt hilft.
Spannend wird es bei Staleness. Wenn sich die Datenbank ändert und die Kopie im Cache nicht, sehen Nutzer alte Daten, bis die TTL abläuft. Kurze TTLs verkürzen das Fenster, erhöhen aber die Datenbanklast.
Wenn ein populärer Key abläuft und 10.000 Requests gleichzeitig die Datenbank treffen, bündelst du die Anfragen oder erneuerst den Key proaktiv. Write-Through vs. Write-Back: Write-Through hält den Cache korrekt, macht Writes aber langsamer; Write-Back ist schnell, verliert aber jüngste Writes, wenn der Cache vor dem Flush stirbt.
5. Entwirf einen einfachen Benachrichtigungsdienst
Ein Benachrichtigungsdienst sendet E-Mail, SMS und Push und versucht es erneut, wenn ein Provider ausfällt. Kläre Volumen und ob die Zustellreihenfolge wichtig ist – meist nicht.
Der Kern ist eine Queue. Producer schreiben ein Notification-Event hinein, und ein Worker pro Kanal zieht Events und ruft einen Provider wie SendGrid oder Twilio auf. Diese Trennung hält die Entscheidung „benachrichtigen“ getrennt vom „senden“, sodass ein langsamer SMS-Provider die App nicht blockiert.
Speichere jede Benachrichtigung mit Status (pending, sent, failed) und einem Idempotency-Key, damit ein Retry nicht doppelt sendet.
Nutzer, die Marketing aus, aber Sicherheitsalerts an wollen, brauchen eine Präferenzentabelle, die vor dem Enqueue geprüft wird. Ein Provider mit Limit 100 Nachrichten/Sekunde erfordert kanalweises Throttling im Worker.
6. Entwirf einen einfachen Dateispeicherdienst
Denk an Dropbox im Kleinen. Nutzer laden eine Datei hoch, bekommen einen Link und laden später wieder herunter. Kläre maximale Dateigröße und ob Teilen wichtig ist.
Metadaten (Owner, Dateiname, Größe, Checksumme, Erstellungsdatum) gehören in eine relationale Datenbank. Die Bytes in Object Storage wie S3 – niemals in die Datenbank. Für Uploads gibt die API eine vorunterzeichnete URL zurück, damit der Client direkt in den Object Storage schreibt und deine Server die Datei nie anfassen.
Zwei Nutzer laden dieselbe 2-GB-Datei hoch – das ist Dedup durch Hashing des Inhalts. Dateien über 5 GB brauchen Multipart-Upload mit Checksumme pro Chunk.
7. Entwirf ein Game-Leaderboard
Ein Leaderboard muss den Score eines Spielers aktualisieren, die Top 10 zurückgeben und den Rang eines einzelnen Spielers liefern. Frage zuerst, wie viele Spieler es gibt und wie oft sich Scores ändern.
Eine relationale Tabelle mit Index auf Score funktioniert bis zu einem Punkt, aber „Wie ist mein Rang?“ wird zu einem
COUNTüber alle über dir. Redis Sorted Sets lösen das:ZADDzum Aktualisieren,ZREVRANGEfür die Top N,ZREVRANKfür einen einzelnen Spieler – alles in logarithmischer Zeit.Daily- und All-Time-Boards sind je ein Sorted Set pro Zeitraum, z. B.
lb:2026-09-14. Wenn 50 Millionen Spieler den Redis-Speicher sprengen, halte dort nur die Top 100k und den Rest in der Datenbank.System-Design-Interviewfragen für Fortgeschrittene
Auf diesem Level geht man davon aus, dass du echte Systeme gebaut und betrieben hast. Die Fragen bringen Queues, Read/Write-Skalierung und das Spannungsfeld zwischen Latenz, Kosten und Konsistenz ins Spiel.
8. Entwirf einen Newsfeed
Ein Feed erlaubt Posts, das Folgen anderer und das Lesen deren Beiträge – in Reverse-Chrono oder gerankt. Nimm 10 Millionen täglich aktive Nutzer an, die fünfmal am Tag öffnen – grob 600 Reads/Sekunde im Schnitt und deutlich mehr in Peaks.
Die zentrale Entscheidung ist, wann der Feed zusammengesetzt wird. Fan-out on write pusht jeden neuen Post in die vorcomputeten Feeds aller Follower – schnelle Reads, teure Writes. Fan-out on read baut beim Request zusammen – umgekehrter Trade-off. Meist mischt man: Fan-out on write für normale Nutzer, on read für Accounts mit Millionen Followern.
Das Datenmodell:
posts,followsund eine pro Nutzer in Redis gehaltene Feed-Liste mit Post-IDs. Paginieren mit Cursor auf Post-ID statt Offset.Ranking später hinzufügen heißt nicht, alles neu zu bauen; du scorst die Kandidaten-IDs aus der Feed-Liste zur Lesezeit.
9. Entwirf ein Chatsystem mit Multi-Device-Sync
Chat mit Multi-Device-Sync umfasst 1:1 und Gruppen, Zustellung auf jedes Gerät eines Nutzers und Historie, die Handywechsel überlebt. Nimm 50 Mio. tägliche Nutzer mit ~40 Messages je Nutzer an – 2 Mrd./Tag, etwa 23.000 Writes/Sek. im Schnitt und regional Peaks darüber.
Jeder Client hält einen WebSocket zu einem Chatserver, der Nachrichten in einen Store schreibt, partitioniert nach Konversations-ID, mit steigender Sequenznummer pro Konversation. Jedes Gerät merkt sich die letzte gesehene Sequenznummer und fordert bei Reconnect alles Neuere an – so funktioniert Multi-Device-Sync.
Der Store braucht hohen Schreibdurchsatz und Range-Reads nach Konversation – Wide-Column-Datenbanken wie Cassandra sind üblich. Delivery- und Read-Receipts laufen als kleine Events auf demselben Pfad zurück.
Sind zwei Freunde an unterschiedliche Chatserver verbunden, bringt Pub/Sub zwischen Servern oder ein Routingdienst (User→Server) die Nachricht ans Ziel. Gruppen mit 500 Mitgliedern fächern serverseitig aus, und Ordnungszusagen werden schwieriger.
10. Entwirf einen Ride-Sharing-Matching-Service
Halte es leichter als die Senior-Version. Fahrer senden alle paar Sekunden ihre Position, Rider fordern eine Fahrt an, und der Service muss binnen Sekunden einen nahen Fahrer zurückgeben.
Positionsupdates sind das Volumenproblem: 200.000 aktive Fahrer bei einem Update alle 4 Sekunden ergeben 50.000 Writes/Sek. Speichere aktuelle Positionen im Speicher, indiziert per Geohash oder H3-Zelle, nicht in einer relationalen Tabelle. Matching heißt dann: „Finde Fahrer in meiner Zelle und den Nachbarzellen“, nach ETA ranken und einen Fahrer sperren, damit nicht zwei Rider dasselbe Auto bekommen.
Akzeptiert ein Fahrer und verliert dann die Verbindung, läuft der Lock ab und der Rider wird neu gematcht. Eine heiße Zelle im Stadtzentrum bekommt feinere Zellen in dichten Gebieten – genau dafür sind hierarchische Indizes wie H3 da.
11. Entwirf ein System zur Metrikerfassung
Ein Metriksystem nimmt alle 10 Sekunden ein paar Hundert Metriken von Tausenden Servern entgegen und macht sie in Dashboards abfragbar.
Agenten bündeln Metriken und pushen in eine Ingestion-Schicht, die in eine Time-Series-Datenbank schreibt (oder in ein Kafka-Topic, von dem Consumer schreiben). Storage ist gestuft: Rohdaten mit voller Auflösung ein, zwei Tage; Ein-Minuten-Rollups für einen Monat; stündlich für ein Jahr. Downsampling läuft als Hintergrundjob.
Abfragen treffen das Rollup passend zum Zeitraum, damit ein 30-Tage-Chart nicht die Rohdaten scannt. Tag-Kardinalität (z. B. User-IDs als Label) killt die Datenbank – sag das ausdrücklich.
Push vs. Pull: Prometheus pullt, aber Push funktioniert besser durch Firewalls und für kurzlebige Jobs. Ein Agent mit verspäteten Timestamps wird innerhalb eines Lateness-Fensters akzeptiert und darüber abgelehnt, mit Zähler auf Rejections, damit eine kaputte Uhr sichtbar wird.
12. Entwirf eine Such-Autocomplete-Funktion
Autocomplete liefert die Top fünf Vervollständigungen innerhalb ~100 ms pro Tastenanschlag. Kläre, ob Vorschläge global oder personalisiert sind – Personalisierung ändert alles.
Die Antwort ist Vorberechnung. Eine Offline-Pipeline aggregiert Query-Logs, zählt Häufigkeiten und baut einen Trie (oder eine Prefix→Top-k-Tabelle), in dem jeder Knoten bereits seine besten Completions speichert. Die Serving-Schicht macht dann pro Keystroke nur ein Lookup, und die Struktur passt verteilt in den Speicher einiger Replikas.
Updates passieren batchweise, vielleicht stündlich, durch Rebuild und Swap. Trendende Queries können ein kleines Echtzeit-Overlay bekommen, das zur Lesezeit gemerged wird.
Ein Prefix wie „a“ trifft einen riesigen Teilbaum – deshalb speicherst du Top-k je Knoten statt zu traversieren. Typos brauchen einen separaten Fuzzy-Index – oder du akzeptierst den Miss.
13. Entwirf einen verteilten Job-Scheduler
Ein verteilter Scheduler ist cron für die ganze Firma: Job und Zeitplan definieren, zur richtigen Zeit höchstens einmal pro Tick ausführen, bei Fehlern retryen und zeigen, was passiert ist.
Jobdefinitionen und Zeitpläne liegen in einer Datenbank. Ein Scheduler-Service berechnet die nächste Laufzeit je Job und pusht fällige Jobs in eine Queue; Worker-Pools ziehen und führen aus. Das Knifflige ist, genau eine Scheduler-Instanz pro Job laufen zu lassen ohne SPOF – meist per Leader Election (Lock in ZooKeeper, etcd oder eine DB-Zeile mit Lease).
Jede Ausführung wird mit Status, Startzeit, Endzeit und Log-Standort erfasst. Diese Tabelle ist am Ende das, worauf alle schauen.
Ein Job, der länger als sein Intervall läuft, sollte überspringen, sich stauen oder überlappen – konfigurierbar. Sobald Job B von A abhängt, wird die Abhängigkeit ein DAG und der Scheduler enqueued erst, wenn Upstream erfolgreich war.
System-Design-Interviewfragen für Senior-Level
Senior-Terrain. Riesenskalierung, Multi-Region, Zuverlässigkeitsziele als Zahlen und die Kosten jeder Entscheidung. Erwartet wird, dass du Ausfallmodi proaktiv nennst.
14. Entwirf eine Videostreaming-Plattform wie YouTube
Videostreaming sind zwei Systeme unter einem Namen. Beim Upload schiebt der Nutzer eine Rohdatei, eine Pipeline transkodiert mehrere Auflösungen und Bitraten, chunked in ein paar Sekunden lange Stücke und legt sie im Object Storage ab. Beim Abspielen liefert ein CDN diese Chunks, und der Player wechselt die Bitrate passend zur Bandbreite – adaptives Streaming via HLS oder DASH.
Nenne die Größenordnung: Hunderte Stunden Upload pro Minute, Milliarden Views am Tag, Storage im Exabyte-Bereich. Transcoding ist peinlich parallel – eine große Workerflotte zieht Jobs aus einer Queue. Metadaten wie Titel, Owner und View-Count leben in einer geshardeten Datenbank mit starkem Caching, weil die Startseite sie permanent liest. Object Storage und CDN-Edges replizieren über Regionen, und das relevante SLO ist die Playback-Startzeit, gefühlt wird die Rebuffering-Rate.
View-Counts bei viralen Videos sind approximative Zähler in Batches aggregiert – niemals ein DB-Increment pro View. Copyright-Matching ist Fingerprinting im selben Upload-Pfad.
15. Entwirf eine verteilte Logging-Plattform
Eine Logging-Plattform nimmt Logs von jedem Service, macht sie binnen Sekunden durchsuchbar und hält sie 30 Tage „hot“ und ein Jahr „cold“.
Agenten tailen Logfiles und schicken sie in einen dauerhaften Buffer wie Kafka, der Spikes abfedert und Indexer nachhinken lässt, ohne Daten zu verlieren. Indexer schreiben in einen Suchcluster mit einem Index pro Tag und Service, alte Indizes wandern komprimiert in Object Storage.
Kosten sind die eigentliche Restriktion – strukturierte Felder indexieren, Rohtext günstig halten. Jedem Service ein Quota geben, Index-Lag monitoren und PII bereits bei Ingestion säubern.
Ein Service, der 100× lauter loggt als üblich, wird der Reihe nach quotiert, gesampled, gedroppt und alarmiert. Regionsübergreifende Abfragen bedeuten föderierte Suche, jede Region besitzt ihre Daten.
16. Entwirf ein Echtzeit-Analytics-System
Echtzeit-Analytics heißt Dashboards mit Aggregaten der letzten Minuten, innerhalb von Sekunden aktualisiert, auf einem Stream von vielleicht einer Million Events pro Sekunde.
Ein Stream-Prozessor wie Flink hält Fenster-Aggregate, z. B. Minutencounts nach Dimension, und schreibt sie in einen schnellen Read-Store wie ClickHouse oder Druid. Dashboards fragen dort ab, nie den Rohstream.
Nenne die Trade-offs: exakte Counts vs. HyperLogLog für Distinct-User, Tumbling- vs. Sliding-Windows und Watermarks für späte Events. Setze ein Freshness-SLO und überwache Processor-Lag dagegen.
Eine hochkardinale Dimension wie User-ID sprengt die Aggregat-Tabelle – für diese Dimension auf Rohereignisse gehen. Backfill nach einem Bug heißt Replay aus dem Stream mit aufbewahrten Offsets.
17. Entwirf ein Zahlungssystem
Zahlungen sind das eine Design, bei dem Korrektheit über Skalierung steht. Das System muss einen Kunden belasten, es verbuchen, nie doppelt belasten, nie einen Eintrag verlieren und täglich mit der Bank abgleichen.
Idempotenz trägt das meiste: Jede Anfrage hat einen Key, der Service speichert das Ergebnis dazu und liefert bei Retries dasselbe Resultat. Geld bewegt sich durch ein Append-only-Doppik-Ledger, bei dem die Einträge einer Transaktion zu null summieren, in einer relationalen DB mit serialisierbarer Isolation. Hier ist Eventual Consistency die falsche Antwort.
Card-Network-Calls können zweifelhaft timeouten – Charges bekommen einen Pending-Status und ein Reconciliation-Job klärt sie. Multi-Region heißt eine Home-Region pro Konto – niemals Active-Active-Writes auf demselben Saldo.
Multiwährung heißt Ganzzahlen in Minor Units mit Währungscode, und eine Rückerstattung, die vor Settlement des Charges ankommt, wird von einer State Machine mit expliziten Übergängen gehandhabt.
18. Entwirf ein großskaliges Messaging-System
Ein Messaging-System lässt Producer publizieren und Consumer subscriben, übersteht Broker-Neustarts und erhält Ordnung dort, wo es zählt – bei Millionen Messages pro Sekunde.
Partitioniere jedes Topic so, dass Messages mit demselben Key auf derselben Partition landen – das ergibt Ordnung pro Key ohne globale Ordnung. Jede Partition ist ein Append-only-Log, repliziert auf wenige Broker, und Consumer committen ihren Offset nach Verarbeitung.
Standard ist At-least-once mit idempotenten Consumern. Retries gehen über ein Retry-Topic mit Backoff, „Gift-“Nachrichten in eine Dead-Letter-Queue. Consumer-Lag ist das Signal fürs SLO, und über Regionen hinweg besitzt pro Key eine Region die Writes – sonst reordnen sich beide gegenseitig.
Cr asht ein Consumer nach Verarbeitung, aber vor dem Commit, entsteht ein Duplikat – darum Idempotenz. Rebalancing-Stürme beruhigt man mit Sticky Assignment und Cooperative Rebalancing.
System-Design-Fragen für Backend Engineers
Hier geht es um APIs, Datenmodelle und sinnvolle Servicegrenzen. Erwarte Follow-ups zu Konsistenz, Caching und Logging.
19. Entwirf einen Authentifizierungs- und Autorisierungsdienst
Authentifizierung beantwortet „Wer bist du?“ und Autorisierung „Was darfst du?“ – Interviewer mögen, wenn du das trennst.
Nutze OAuth 2.0 und OpenID Connect statt eines Eigengewächses. Vergib kurzlebige Access Tokens und längerlebige Refresh Tokens, serverseitig gespeichert, damit du sie widerrufen kannst. Berechtigungen leben in einem Rollenmodell, geprüft durch eine kleine Bibliothek oder einen Policy-Service. Logge jeden Login-Versuch, Refresh und jede Verweigerung mit IP und Device – Tokens selbst nie loggen.
JWTs vermeiden ein Lookup pro Request, aber frühes Widerrufen braucht eine Denylist – das Lookup ist wieder da. Credential Stuffing bremst du mit Rate Limiting pro IP und Konto, Verzögerungen nach wiederholtem Scheitern und einem zweiten Faktor bei verdächtigen Logins.
20. Entwirf ein API-Gateway
Ein API-Gateway ist der zentrale Einstiegspunkt vor deinen Services und übernimmt Querschnittsaufgaben, damit es nicht jeder Service tut: Routing nach Pfad und Version, TLS-Terminierung, Authentifizierung, Rate Limiting und Request-Logging.
Das Gateway selbst sollte zustandslos sein und horizontal hinter einem Load Balancer skalieren. Routen-Konfiguration lebt in einer Control Plane und wird an Instanzen gepusht – nie neu deployen, um eine Route hinzuzufügen. Auth-Tokens werden einmal am Rand validiert, und das Gateway leitet die Nutzeridentität als Header weiter.
Wichtig aussprechen: Blast Radius. Das Gateway liegt auf jedem Request-Pfad, eine schlechte Config legt alles lahm; Configs validieren, schrittweise ausrollen und die eigene Logik des Gateways schlank halten.
Versionierung ohne Bruch bei mobilen Clients, die du nicht updaten kannst, heißt Pfad- oder Header-Versionierung mit weiterlebenden Altversionen. Das Gateway sollte keine Antworten mehrerer Services aggregieren – das gehört in eine Backend-for-Frontend-Schicht.
21. Entwirf ein Ordersystem für einen E-Commerce-Shop
Ein Ordersystem erstellt eine Bestellung, reserviert Inventar, kassiert, versendet und zeigt dem Kunden den Status. Orders sind eine State Machine (
created,paid,packed,shipped,delivered,cancelled), und die erlaubten Transitionen sollten explizit sein.Order-Erstellung ist ein
POSTmit Idempotency-Key, damit Doppelklicks keine zwei Orders erzeugen. Inventarreservierung und Zahlung involvieren andere Services – nutze eine Saga: Jeder Schritt publiziert ein Event, Fehler triggern kompensierende Aktionen (Inventar freigeben, erstatten). Schreibe das Event in eine Outbox-Tabelle in derselben Transaktion wie das Order-Update, damit Datenbank und Message-Bus nie widersprechen.Auf der Read-Seite: eine Orders-Tabelle plus
order_items, mit einem materialisierten Order-Überblick, gecacht für „Meine Bestellungen“.Zwei Kunden kaufen gleichzeitig die letzte Einheit – gelöst per Row-Lock oder atomarem Decrement auf Inventar, einer bekommt „ausverkauft“. Monitoren solltest du Orders, die länger als erwartet in einem Status hängen.
22. Entwirf einen Feature-Flag-Service
Ein Feature-Flag-Service schaltet Features pro Umgebung, targetet nach Nutzerattributen oder Prozent und kann weltweit innerhalb von Sekunden flippen, wenn etwas bricht.
Flag-Definitionen und Targeting-Regeln liegen in einer kleinen Datenbank hinter einer Admin-API. Anwendungen binden ein SDK ein, das beim Start alle Flags holt, lokal cached und Regeln im Prozess auswertet – der Flag-Check kostet zur Request-Zeit praktisch nichts. Updates propagieren über eine Streaming-Verbindung oder Short Polling, und das SDK behält den letzten Stand, wenn der Flag-Service down ist.
Prozentuale Rollouts werden mit einem stabilen Hash aus User-ID und Flag-Key ausgewertet, sodass derselbe Nutzer immer auf derselben Seite landet.
Stale Flags findest du, indem du letzte Auswertungszeitpunkte trackst und Owner erinnerst. Fällt der Flag-Service beim Start aus, fällt die App auf Defaults im Code zurück.
23. Entwirf eine Recommendation-Serving-API
Eine Recommendation-API liefert 20 Items pro Nutzer unter 100 ms bei einigen Tausend Requests pro Sekunde – ohne tiefe ML-Kenntnisse im Design.
Trenne Offline und Online. Ein Offline-Job berechnet Kandidatenlisten pro Nutzer in einen Low-Latency-Key-Value-Store. Die Online-API holt sie, rerankt mit ein paar frischen Features wie „auf Lager“, filtert Gekauftes raus und liefert die Liste. Halte einen Fallback mit beliebten Items pro Kategorie vor und logge jede ausgelieferte Liste mit Request-ID, damit du sie später mit Klicks joinen kannst.
Ein neuer Nutzer bekommt den Fallback, bis ein paar Interaktionen eintreffen. Die 100 ms teilen sich grob auf: 10 fürs Fetch, 30 fürs Reranking, 10 für Serialisierung und 50 als Puffer.
System-Design-Fragen für Infrastruktur/DevOps
Reliability, Deployment, Automatisierung und Observability. Das Leitmotiv: Wie änderst du Dinge sicher – und wie merkst du schnell, wenn es falsch war.
24. Entwirf eine CI/CD-Pipeline für Microservices
Eine CI/CD-Pipeline für Microservices muss Dutzende unabhängig deploybarer Services mit Tests, Security-Checks und einem Weg in die Produktion handhaben, der keinen Menschen um 3 Uhr morgens braucht.
Einmal bauen, dasselbe Artefakt überall deployen. Die Pipeline lintet, läuft Unit-Tests, baut ein Container-Image mit Commit-SHA als Tag, scannt es und pusht es in ein Registry. Deployment promotet das Image dann durch Umgebungen (Dev, Staging, Prod) per Konfiguration – ohne Neubau.
Der Produktionsrollout sollte progressiv sein: Canary auf ein paar Prozent Traffic, Fehler- und Latenzraten in einem definierten Fenster beobachten, dann automatisch fortsetzen oder zurückrollen. Rollback heißt: das vorherige Image-Tag erneut deployen – schnell, weil du nie neu gebaut hast.
Wenn die Änderung von Service A den Vertrag von Service B bricht, helfen Contract-Tests in CI und rückwärtskompatible API-Änderungen. Monorepo vs. viele Repos ist weniger wichtig, solange die Pipeline nur baut, was sich geändert hat.
25. Entwirf zentrales Monitoring und Alerting
Zentrales Monitoring bringt Metriken, Logs und Traces aus allen Services an einen Ort – mit Alerts, die nur dann wecken, wenn Nutzer betroffen sind.
Metriken fließen in einen Time-Series-Store, Logs in die Plattform aus Frage 15, Traces in ein Tracing-Backend – alles korreliert über eine gemeinsame Request-ID. Die entscheidende Designfrage ist: Worauf alerten wir? Auf Symptome (Error-Rate, Latenz-Perzentile, Sättigung) verknüpft mit SLOs, nicht auf Ursachen wie „CPU bei 80 %“.
Paging-Müdigkeit killt Rufbereitschaften – jeder Page braucht ein Runbook und ein Review. Alles, was zweimal in einer Woche ohne klare Aktion paged, wird zur Ticketmeldung degradiert.
Ein SLO für einen brandneuen Service ergibt sich aus ein paar Wochen Messung – Ziel leicht besser als der aktuelle Zustand setzen. Und wenn das Monitoring selbst down ist, sagen dir externe synthetische Checks und ein Dead-Man’s-Switch-Alert Bescheid.
26. Entwirf einen Ansatz zum Secrets Management
Secrets Management stellt Datenbankpasswörter, API-Keys und Zertifikate zur Laufzeit bereit – nie im Source Code, regelmäßig rotiert und auditiert.
Ein zentraler Secrets-Store (HashiCorp Vault, ein Cloud-Secrets-Manager) hält alles. Services authentifizieren sich mit ihrer Workload-Identität (ein Kubernetes-Service-Account, eine IAM-Rolle), nie mit einem langlebigen Token, und holen Secrets beim Start oder on demand. Bevorzuge dynamische Secrets, wo möglich: Der Store generiert eine DB-Credential für eine Stunde – Rotation inklusive.
Jeden Read auditieren. Und einen „Break-Glass“-Pfad dokumentieren, wenn der Secrets-Store selbst down ist – das wird passieren.
Ein Key, den eine Entwicklerin versehentlich committed, wird durch Scans in CI entdeckt, sofort rotiert und als kompromittiert behandelt. Secrets in Umgebungsvariablen sind verbreitet, leaken aber über Crash-Dumps und Child-Prozesse – besser als Files mounten oder im Prozess abrufen.
27. Entwirf Autoscaling und eine Rollout-Strategie
Autoscaling und Rollout zusammen müssen tägliche Traffic-Schwankungen von 5× ohne Handarbeit abfangen, während mehrmals täglich deployt wird.
Skaliere anhand eines Signals, das Nutzerschmerz abbildet – meist Request-Rate oder Latenz pro Instanz – nicht nur CPU. Setze Mindestreplikas, damit ein Kaltstart keinen Spike abbekommt, und ein Maximum, damit ein Bug dich nicht ruiniert. Hoch schnell, runter langsam.
Für Rollouts: Blue/Green, wenn du sofort switchen und zurückrollen willst; Canary, wenn du echte Last erst auf einem kleinen Anteil beobachten möchtest. Kombiniere Canary vorsichtig mit dem Autoscaler, sonst verzerrt unabhängiges Skalieren den Vergleich.
Wenn das Scaling einen plötzlichen Spike zwei Minuten hinterher hinkt, helfen vorausschauendes Skalieren per Zeitplan oder ein höheres Minimum. Und 50 neue Instanzen, die DB-Verbindungen leeren, sind der Grund für Connection-Pooling in einer Proxy-Schicht.
System-Design-Fragen für Data Engineers
Pipelines, Speicherformate, Batch vs. Streaming und ob die Daten vertrauenswürdig sind. Dasselbe Framework wie zuvor, aber die Ausfallmodi drehen sich um verlorene, doppelte oder verspätete Daten – nicht um verlorene Requests.
28. Entwirf eine Event-Ingestion-Pipeline
Eine Event-Ingestion-Pipeline nimmt Verhaltensevents von Web- und Mobile-Clients entgegen und macht sie innerhalb einer Stunde abfragbar. Nimm 50.000 Events/Sek. im Peak an, mit Clients, die offline gehen und retryen.
Clients bündeln Events über ein SDK und posten an einen Collector-Service, der sie gegen ein Schema-Registry validiert und in einen Stream (Kafka oder Managed-Äquivalent) schreibt. Ein Consumer landet Rohdaten im Object Storage, partitioniert nach Stunde, in einem spaltenorientierten Format wie Parquet. Downstream-Jobs lesen von dort.
Retries bedeuten Duplikate, daher trägt jedes Event eine clientgenerierte UUID und der Landing-Job dedupliziert innerhalb eines Fensters. Schemaänderungen laufen über die Registry mit Kompatibilitätsprüfungen – eine Mobile-App in alter Version sendet monatelang die alte Form.
Ein Event mit Timestamp von vor drei Tagen landet nach Ankunftszeit, behält seine Event-Zeit als Spalte und lässt Downstream entscheiden. Schlechte Events gehen auf einen Dead-Letter-Pfad und werden nie stillschweigend gedroppt.
29. Entwirf ein Streaming-ETL-System
Streaming-ETL transformiert Events bei Ankunft, joint sie mit Referenzdaten und schreibt Ergebnisse innerhalb von Sekunden in einen Serving-Store.
Ein Stream-Prozessor liest vom Ingestion-Topic, appliziert Transformationen und reichert mit Referenzdaten an, die im Speicher geladen und periodisch aktualisiert werden. State (für Fenster-Joins oder Aggregationen) checkpointet in dauerhaften Storage, damit ein abgestürzter Job ohne Reprocessing vom Anfang fortsetzen kann.
Der gewünschte Trade-off: Exactly-once vs. At-least-once. Exactly-once ist Ende-zu-Ende erreichbar, wenn der Sink Transaktionen oder idempotente Writes unterstützt – kostet aber Latenz und Komplexität. At-least-once mit idempotenten Sinks bringt den Großteil des Nutzens.
Spätdaten handhabst du mit Watermarks und einer definierten Grace-Periode – danach geht es in eine Late-Arrivals-Tabelle.
Referenzdaten, die sich mitten im Stream ändern, sollten versioniert sein – gejoint wird auf die zum Eventzeitpunkt gültige Version. Ein Backfill sechs Monate nach einem Logikfix spielt Rohdaten im Batch neu ab – nicht durch den Stream.
30. Entwirf ein Data Warehouse und den Modellierungsansatz
Ein Warehouse muss Analysten und Dashboards konsistente Metriken über Sales-, Marketing- und Produktdaten liefern – mit Historie.
Rohdaten unverändert in Bronze landen, in Silver bereinigen und konform machen, in Gold geschäftsnahe Tabellen bauen. Gold als Star-Schema modellieren: Faktentabellen in feinster sinnvoller Körnung (z. B. eine Zeile pro Order-Position) und Dimensionstabellen für Kunden, Produkte, Datum. Slowly Changing Dimensions wo wichtig als Type 2, damit ein Regionswechsel eines Kunden den Umsatz des Vorjahres nicht überschreibt.
Große Faktentabellen nach Datum partitionieren, nach häufigen Filterspalten clustern und Transformationen in Versionskontrolle (dbt o. Ä.) mit Tests halten.
Wenn zwei Teams „aktiver Kunde“ unterschiedlich definieren, setzt eine Metrics-Layer mit einer verbindlichen Definition dem ein Ende. Ein spät eintreffender Fakt, der auf einen noch fehlenden Dimensionsschlüssel verweist, bekommt eine Platzhalter-Dimension, die später nachgezogen wird.
31. Entwirf einen Feature Store
Ein Feature Store berechnet Features einmal und nutzt sie für Training und Online-Prediction – ohne Training/Serving-Skew. Es sind zwei Stores mit einer Definition: Der Offline-Store (Warehouse oder Lake) hält Feature-Historie für Trainingssätze, der Online-Store (Redis, DynamoDB) den neuesten Wert pro Entität für Low-Latency-Lookups zur Prediction-Zeit.
Eine einzige Feature-Definition treibt beide an, und ein Job materialisiert regelmäßig von Offline nach Online.
Kritisch ist Point-in-Time-Korrektheit. Beim Erstellen eines Trainingssatzes muss jede Zeile Feature-Werte zum Timestamp der Zeile verwenden – nicht die aktuellen. Sonst lernt dein Modell aus der Zukunft und glänzt nur bis zum Go-Live.
Ein Feature, das in Echtzeit teuer ist, wird vorab mit etwas Staleness berechnet oder beim Write berechnet. Um zu wissen, dass Online- und Offline-Werte übereinstimmen, stichproben und vergleichen – und logge die tatsächlich servierten Features.
32. Entwirf eine Schicht für Datenqualität und -lineage
Eine Datenqualitäts- und Lineage-Schicht erkennt kaputte Daten, bevor Dashboards es tun, und beantwortet „Woher kommt diese Spalte?“ ohne Code zu lesen.
Qualitätschecks laufen als Pipeline-Schritte: Zeilenzahlen in erwarteten Bereichen, Nullraten, Freshness (ist die Partition pünktlich gelandet) und einige Business-Checks (Umsatz nie negativ). Fehler blockieren Downstream-Jobs und alarmieren den Owner. Check-Ergebnisse werden über die Zeit gespeichert, damit du Drift siehst – nicht nur das heutige Pass/Fail.
Lineage wird aus dem Transformationscode erfasst (SQL-Parsing oder Metadaten des Orchestrators) und als Graph gespeichert: Tabelle→Tabelle, wo möglich Spalte→Spalte. Dieser Graph treibt Impact-Analysen, wenn jemand eine Spalte droppen will.
Wenn Checks länger dauern als die Pipeline, stichprobe oder führe schwere Checks asynchron aus und alarme statt zu blockieren. Lineage über inkompatible Tools hinweg heißt OpenLineage oder manuelle Annotationen – mit dokumentierten Lücken.
System-Design-Fragen für Frontend/Full-Stack
Client-Performance, State-Management, Caching und wie der Browser mit der API spricht. Sicherheitsbasics tauchen hier ebenfalls auf.
33. Entwirf die Architektur für eine stark frequentierte Web-App
Hier: inhaltslastige Seite mit Millionen täglichen Besuchern, schneller First Paint und personalisierten Bereichen für eingeloggte Nutzer.
Statische Assets auf ein CDN mit langen Cache-Lebenszeiten und gehashten Dateinamen. Seiten, die für alle gleich sind, werden serverseitig gerendert und am Edge gecacht; personalisierte Teile laden clientseitig nach dem Shell-Paint. Dieses Hybrid hält die Time-to-First-Byte niedrig, ohne persönliche Daten stale auszuliefern.
API-Calls vom Client gehen durchs Gateway mit kurzlebigen Tokens. Setze Cache-Header bewusst:
Cache-Controlmitstale-while-revalidatefür Inhalte, die ein paar Sekunden alt sein dürfen,no-storefür alles Persönliche.Für ein Dashboard hinter Login ist Client-Side-Rendering meist okay, da SSR ohne SEO wenig bringt. Und ein Cache-Key, der versehentlich das Session-Cookie enthält, gibt jedem seine eigene Kopie – die Hit-Rate bricht ein.
34. Entwirf Offline-First-Sync
Offline-First-Sync meint eine Notiz- oder Felddaten-App, die ohne Verbindung funktioniert und bei Rückkehr synchronisiert – ohne Bearbeitungen zu verlieren.
Jeder Write geht zuerst in einen lokalen Store (IndexedDB, auf Mobile SQLite) und in eine Queue ausstehenden Mutationen. Wenn die Verbindung zurück ist, pusht der Client die Queue in Reihenfolge und pullt Änderungen seit seinem letzten Sync-Token. Jede Mutation trägt Client-ID und Sequenznummer, damit der Server deduplizieren kann.
Konflikte sind das Hauptproblem. Last-Write-Wins ist simpel und verliert Daten. Field-Level-Merging löst die meisten Fälle.
CRDTs ermöglichen automatische Merges für Text und Listen, kosten aber Komplexität – nur, wenn kollaboratives Editieren wirklich verlangt ist.
Bearbeitet ein Nutzer offline auf zwei Geräten und bringt beide zurück, werden beide Edits angewandt, der Konflikt markiert und im UI gezeigt. Eine Pending-Queue, die auf 10.000 Mutationen wächst, sollte kompaktiert werden – zehn Edits an einem Feld werden zu einem.
35. Entwirf Echtzeit-UI-Updates
Echtzeit-UI-Updates bedeuten ein Dashboard oder Chat, das serverseitige Änderungen binnen einer Sekunde an Tausende gleichzeitige Nutzer ausliefert.
Wähle den Transport nach Richtung: Server-Sent Events, wenn Daten nur Server→Client fließen (Live-Scores, Notifications); WebSockets, wenn der Client viel sendet (Chat, kollaboratives Editieren). Long Polling als Fallback für Netzwerke, die beides blocken.
Serverseitig fächert eine Pub/Sub-Schicht Änderungen an den Connection-Server aus, der den Nutzer hält. Clientseitig: Reconnect mit Backoff und Resume ab der letzten Event-ID, damit ein Drop kein Updateverlust ist. Rendering drosseln: 50 Updates/Sek. für ein Chart werden gebatcht – nicht 50 Repaints.
100.000 Nutzer, die ein Live-Event schauen, bedeuten serverseitigen Fan-out – ggf. über ein CDN mit Streaming-Support. WebSocket-Auth: Token im initialen Handshake, periodisch revalidiert.
36. Entwirf einen Client-Performance-Plan für Dashboards
Ziel: Ein Analytics-Dashboard mit 20 Charts lädt in unter drei Sekunden und bleibt beim Filtern reaktionsschnell.
Nicht 20 Charts auf einmal laden. Sichtbare zuerst, den Rest lazy on Scroll, Skeletons statt Spinnern. Serverseitig voraggregieren, damit der Client pro Chart nur ein paar Hundert Zeilen erhält – niemals Rohereignisse.
Query-Ergebnisse im Speicher nach Filterzustand cachen, damit ein Filter-Toggle nicht neu lädt.
Tabellen mit Tausenden Zeilen brauchen Virtualisierung (nur Sichtbares rendern). Schwere Berechnungen in einen Web Worker auslagern, damit der Main Thread frei bleibt.
Wenn die API langsam ist und du sie nicht ändern kannst, cache aggressiv, zeige veraltete Daten mit Zeitstempel und refreshe im Hintergrund. CORS-Fehler beim Aufruf einer neuen API bedeuten: Die API muss die Origin des Dashboards erlauben – und du solltest Preflight Requests erklären können.
Szenario-basierte System-Design-Interviewfragen
Hier zählt Urteilsvermögen mehr als Architektur. Anforderungen ändern sich, Produktion bricht, und es geht darum, wie du triagierst.
37. Traffic verzehnfacht sich über Nacht. Was änderst du zuerst?
Starte mit dem, was zuerst bricht – selten die zustandslose Schicht. Autoscaling fängt Webserver ab; Datenbank, Cache und Third-Party-Rate-Limits sind die typischen Kippunkte.
Sofort: Sättigungsmetriken (Connections, CPU, Queue-Tiefe) für DB und Cache prüfen, das Autoscaler-Limit erhöhen und Lastabwurf einschalten – nicht kritische Features droppen oder gecachte Seiten serven. Innerhalb eines Tages Read-Replikas hinzufügen, die Cache-Hit-Rate tunen und die dominanten Queries finden. Langfristig die Sharding- und Queueing-Arbeiten angehen, die du aufgeschoben hast.
Echtes Wachstum vs. Bot erkennst du an Requestmustern, User Agents und daran, ob Conversions mitziehen.
38. Du stößt an DB-Read-Grenzen. Cache, Replikas oder Sharding?
In dieser Reihenfolge, meist. Ein Cache vor den heißesten Reads ist günstig und halbiert die DB-Last oft binnen eines Tages – prüfe Hit-Rate und Query-Log, ob Reads wirklich repetitiv sind.
Read-Replikas kommen als Nächstes, wenn die Read-Last breit statt heiß ist. Sie bringen Lag mit – jeder Read-after-Write-Pfad (User speichert und will es sofort sehen) muss zum Primary. Sharding löst eher Write-Grenzen als Read-Grenzen und kostet Cross-Shard-Queries und Migration – also zuletzt, wenn die ersten zwei ausgeschöpft sind.
Verursacht ein einzelner Großkunde die Last auf einer Tabelle, isoliere diesen Tenant oder partitioniere nach Kunden-ID.
39. Eine kritische Downstream-Abhängigkeit ist flaky. Retries, Timeouts, Circuit Breaker?
Alle – in der richtigen Reihenfolge. Zuerst ein Timeout, denn ein Call ohne Timeout macht eine langsame Abhängigkeit zu deinem eigenen Ausfall, wenn Threads sich stauen. Dann Retries mit Exponential Backoff und Jitter – aber nur für idempotente Calls und nur wenige Male, sonst verstärkst du die Last auf einen ohnehin strauchelnden Service.
Dann ein Circuit Breaker: Nach einem Fehler-Schwellwert rufst du eine Zeitlang nicht an und lieferst ein Fallback (Cache, degradierte Antwort, freundlicher Fehler). Überwache den Breaker-State – ein offen hängender Breaker ist ein eigener Incident.
Ist der flaky Dependency dein Payment-Provider, gibt es kein Fallback für den Charge selbst; stelle die Order als „pending“ in die Queue und verarbeite später.
40. Latenz ist nach einem Launch schlechter. Wie gehst du vor?
Zuerst verifizieren und einschränken: Welches Perzentil (p50 oder nur p99), welche Endpunkte, welche Region. Mit dem Deploy-Timeline vergleichen; passt der Anstieg zu einem Release, erst zurückrollen, dann untersuchen.
Wenn Rollback nicht hilft, folge der Anfrage. Traces zeigen, welcher Span wuchs. Häufige Übeltäter: neue Query ohne Index, ein N+1-Muster durch ein neues Feld, ein geänderter Cache-Key, der die Hit-Rate fallen ließ, oder ein Downstream-Call, der früher asynchron war und nun im Requestpfad liegt.
Wenn nur p99 gestiegen ist und Rollback nicht half, prüfe Garbage-Collection-Pausen, einen noisy neighbor oder einen Lock.
41. Ein Dateninkonsistenz-Bug taucht auf. Was prüfst du, was rollst du zurück?
Begrenze den Schaden, bevor du etwas änderst. Welche Tabellen oder Datensätze widersprechen sich, seit wann, und passiert es noch? Das „seit wann“ zeigt meist auf ein Deploy oder einen Joblauf.
Prüfe den Write-Pfad der betroffenen Datensätze: jüngste Migrationen, ein Job, der doppelt lief, ein Retry ohne Idempotenz, ein Race zwischen zwei Schreibern. Stoppe die Blutung, indem du den schuldigen Job pausierst oder Code zurückrollst, und repariere aus einer Source of Truth (Raw-Event-Log, Ledger, Backup) statt Zeilen von Hand zu editieren. Halte fest, was du warum geändert hast.
Ohne Source of Truth rekonstruierst du, was geht, markierst den Rest und führst das Outbox-Pattern ein, damit es nicht erneut passiert.
Häufige Fehler in System-Design-Interviews
Die meisten scheitern an denselben wenigen Gründen. Keiner hat mit „Wissen“ zu tun.
So bereitest du dich auf System-Design-Interviews vor
Vorbereitung wirkt, wenn sie wiederholbar ist. Hier ein Prozess, dem ich wirklich folgen würde.
Fazit
Jede Frage in dieser Liste stammt aus einem System, das jemand bauen und dann um 3 Uhr morgens am Leben halten musste. Je mehr du davon tust, desto weniger fühlt sich das Interview wie Theater an – und desto mehr wie die Beschreibung deines Dienstags. Starte ein Side Project mit echter Queue, geh in die Rufbereitschaft, bitte darum, bei einem Design-Review dabei zu sein – auch wenn es nicht dein Design ist.
Und wenn du bis zum nächsten Loop strukturiert Land gewinnen willst, diese vertiefen die Bausteine, auf die sich die Antworten hier stützen: