Вопросы по проектированию систем встречаются на собеседованиях чаще, чем можно подумать. Очевидно — в бэкенде. Но также в инфраструктуре, дата-инжиниринге и даже в продуктовых ролях, где от вас вовсе не ждут, что вы напишете ни строчки кода в процессе.
Так что же на самом деле проверяет интервьюер? Не то, знаете ли вы «правильную» архитектуру — её не существует. Им важно увидеть структурное мышление, честный разбор компромиссов и способность продолжать рассуждать, когда ограничения расплывчаты, а время идёт.
Ожидания сильно зависят от уровня. Джуниор, который задаёт хорошие уточняющие вопросы и набрасывает аккуратную схему из нескольких блоков, — уже молодец. Сеньор, который делает только это, — в беде, потому что на этом уровне ждут цифры, сценарии отказов и мнение о том, с чего начинать реализацию.
Роль тоже важна. Дата-инженера будут продавливать по пайплайнам и бэкфиллам, фронтендера — по кэшированию и состоянию, инфраструктурщика — по выкатываниям и радиусу поражения. Навык общий, словарь разный.
Почему это важно: большинство списков вопросов игнорируют обе оси и просто вываливают на вас 50 промптов. Здесь всё организовано сначала по уровню, затем по роли, с сценарными вопросами в конце. Если в ответах по хранилищам вы чувствуете неуверенность, наш курс по проектированию баз данных (Database Design) покрывает основы.
Как подходить к собеседованию по системному дизайну
Одна и та же структура каждый раз, примерно 45 минут:
- Уточнение (5 мин). Кто пользователи, что система должна уметь, что вне рамок и как выглядит «хорошо».
- Оценка чисел (2 мин). Пользователи, запросы в секунду, доля чтений/записей, прирост хранилища в год. Грубо — можно, молчать — нельзя.
- Высокоуровневый набросок (10 мин). Клиенты, слой API, хранилище, кэш, очередь. Пять–шесть блоков, не больше.
- Модель данных (5 мин). Таблицы или коллекции, ключи и паттерны доступа, которые они обслуживают.
- Глубокое погружение в один компонент (10 мин). Пусть интервьюер выберет, или предложите участок, который вам интересен.
- Сценарии отказов и компромиссы (оставшееся время). Что ломается, что бы вы мониторили, и что строили бы в первую очередь, будь это реальным проектом.
Проговаривайте вслух весь ход мысли. Интервьюер не может оценить молчаливое мышление.
Вопросы для начинающих по системному дизайну
Здесь проверяют базу: уточнение требований до любых схем, простой архитектурный набросок и разумный выбор хранилища. Консенсусные алгоритмы никто не ждёт.
1. Спроектируйте сокращатель URL
Сокращатель превращает длинный URL в короткий код и делает редирект при переходе, так что сначала нужно выяснить, истекают ли ссылки и сколько их будет. Разумная оценка — 100 миллионов новых ссылок в месяц, при этом чтений примерно в 100 раз больше, чем записей.
Такой перекос в сторону чтения определяет дизайн: сервер API, база данных и кэш перед ней. Для короткого кода либо кодируйте автоинкрементный ID в base62 (семь символов дают порядка 3,5 трлн комбинаций), либо генерируйте случайную строку и проверяйте коллизии.
Хватает одной таблицы: short_code как первичный ключ, long_url, created_at, expires_at и необязательный user_id. Горячие коды держите в Redis, чтобы база видела только промахи. Используйте редирект 302, если хотите аналитику кликов, потому что браузеры кэшируют 301, и второй визит вы не увидите.
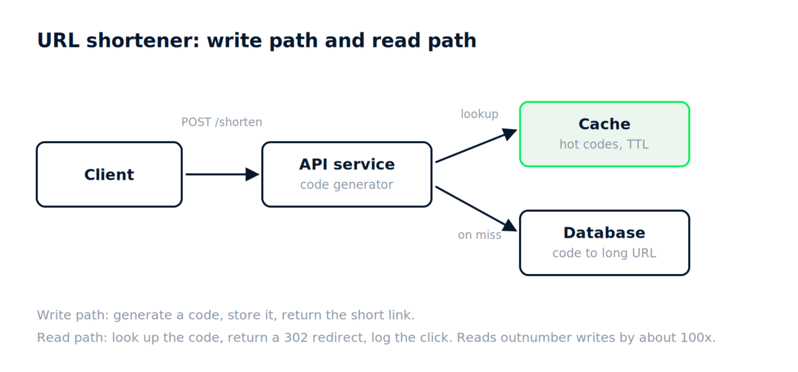
На 10 миллиардах ссылок вы шардируете по коду, а генератор ID становится узким местом; если люди начнут подбирать коды, переходите с последовательных на случайные и добавляйте ограничение частоты запросов.
2. Спроектируйте базовый ограничитель скорости
Ограничитель скорости позволяет N запросов на пользователя в минуту и возвращает 429 сверх этого. Сначала уточните, лимит — на пользователя, IP или API-ключ, потому что от этого зависит ключ в кэше.
Три алгоритма покрывают большинство ответов. Фиксированное окно считает запросы в каждой минутной корзине — просто, но у границы окна допускает двукратное превышение. Скользящее окно (лог) хранит каждый таймстемп — точно, но прожорливо по памяти. «Ведро токенов» пополняется с постоянной скоростью и пропускает небольшие всплески — именно поэтому его используют многие шлюзы.
Запускайте ограничитель как middleware в API-шлюзе с счётчиками в Redis под TTL; INCR плюс EXPIRE покрывают вариант с фиксированным окном.
С десятью инстансами шлюза либо делите счётчики Redis, либо миритесь с небольшим переучётом при локальных; и решите заранее, что делать, если Redis упадёт: «fail open» и риск злоупотреблений или «fail closed» и блокировка всех.
3. Спроектируйте простой key-value store
Key-value хранилищу нужны get, put и delete, и для начального уровня держите всё на одном узле. Операции обслуживает хэш-таблица в памяти. Для надёжности каждый запись апендится в лог на диск до подтверждения, а периодические снэпшоты избавляют от необходимости проигрывать всю историю при восстановлении.
Интервьюеру важно услышать, что вы отделили быстрый путь в памяти от надёжного пути на диск и понимаете, почему сначала идёт лог.
Если данных больше, чем памяти, ответ — LSM-дерево, примерно как в RocksDB и Cassandra. Если нужен второй узел, мастер реплицирует лог на фолловер, а при дальнейшем масштабировании подключается консистентное хеширование.
4. Спроектируйте кэш (концептуально)
Кэш стоит между приложением и более медленным хранилищем; базовый паттерн — cache-aside. Приложение проверяет кэш, при промахе читает базу и записывает результат обратно с TTL. Просто, но логика инвалидации на вас.
Вытеснение обычно LRU, иногда LFU для скошенных нагрузок. Главная метрика — коэффициент попаданий; ниже примерно 80% стоит спросить, помогает ли кэш вообще.
Где начинаются сложности: устаревание. Если база изменилась, а копия в кэше — нет, пользователи видят старые данные до истечения TTL. Короткие TTL уменьшают окно, но увеличивают нагрузку на базу.
Когда популярный ключ истекает и 10 000 запросов одновременно бьют в базу, либо коалесцируйте эти запросы, либо обновляйте ключ заранее. Про write-through и write-back: write-through сохраняет корректность кэша ценой более медленных записей; write-back быстрый, но теряет недавние записи, если кэш умрёт до сброса.
5. Спроектируйте базовый сервис уведомлений
Сервис уведомлений отправляет email, SMS и пуши и ретраит при сбое провайдера. До дизайна уточните объёмы и важен ли порядок доставки — обычно нет.
Сердце дизайна — очередь. Продюсеры пишут в неё событие уведомления, воркер на каждый канал читает события и вызывает провайдера вроде SendGrid или Twilio. Такое разделение оставляет принятие решения «уведомлять» отдельно от фактической отправки, так что медленный SMS-провайдер не блокирует приложение.
Храните каждое уведомление со статусом (pending, sent, failed) и ключом идемпотентности, чтобы повторная попытка не привела к двойной отправке.
Пользователи, желающие отключить маркетинг, но оставить безопасность, требуют таблицы предпочтений, проверяемой до постановки в очередь, а провайдер с лимитом 100 сообщений в секунду — поканальной регулировки скорости в воркере.
6. Спроектируйте простой файловый сервис
Подумайте о Dropbox в миниатюре. Пользователи загружают файл, получают ссылку, скачивают позже. Уточните максимальный размер файла и важен ли шаринг.
Метаданные (владелец, имя файла, размер, контрольная сумма, дата создания) — в реляционной базе. Байты — в объектном хранилище вроде S3, никогда не в базе. Для загрузок API возвращает предварительно подписанный URL, чтобы клиент писал напрямую в объектное хранилище, а ваши серверы не касались файла.
Дедупликация двух пользователей, загружающих один и тот же 2 ГБ файл, решается хешированием содержимого, а файлы свыше 5 ГБ требуют multipart-загрузки с checksum на каждый чанк.
7. Спроектируйте игровую таблицу лидеров
Лидерборду нужно уметь обновлять счёт игрока, возвращать топ-10 и ранг конкретного игрока. Сначала спросите, сколько игроков и как часто меняются счета.
Реляционная таблица с индексом по счёту работает до поры, но «какой у меня ранг» превращается в COUNT по всем выше вас. Redis sorted sets решают это: ZADD для обновления, ZREVRANGE для топ-N, ZREVRANK для одного игрока — всё за логарифмическое время.
Ежедневные и «за всё время» доски — по одному отсортированному множеству на период, ключи вида lb:2026-09-14. Если 50 миллионов игроков слишком раздувают память Redis, храните там только топ-100k, а остальных — в базе.
Вопросы среднего уровня по системному дизайну
На этом уровне предполагается, что вы строили и эксплуатировали реальные системы. Появляются очереди, масштабирование чтения/записи и баланс между задержкой, стоимостью и согласованностью.
8. Спроектируйте новостную ленту
Лента должна позволять публиковать, подписываться и читать записи тех, на кого подписаны, в обратном хронологическом или ранжированном порядке. Предположим 10 миллионов дневных активных пользователей, открывающих её пять раз в день — это примерно 600 чтений в секунду в среднем и гораздо больше на пике.
Ключевой выбор — когда собирать ленту. Fan-out on write пушит каждый новый пост в предвычисленную ленту каждого подписчика — быстрые чтения, дорогие записи. Fan-out on read собирает при запросе — наоборот. Большинство реальных систем смешивают подходы: фан-аут при записи для обычных аккаунтов и при чтении — для аккаунтов с миллионами подписчиков.
Модель данных — это posts, follows и персональный список ленты в Redis с ID постов. Пагинация — курсором по ID поста, а не смещением.
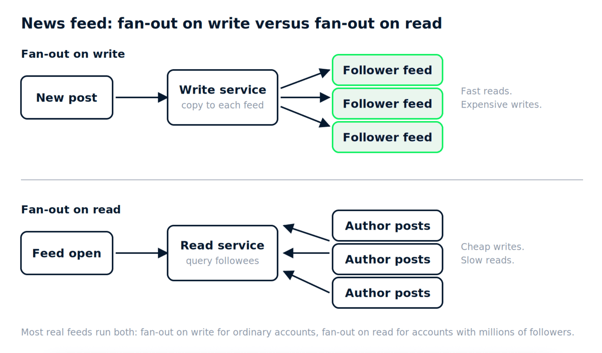
Добавление ранжирования позже не требует всё перестраивать; вы просто скорите кандидатные ID из списка ленты при чтении.
9. Спроектируйте чат с синхронизацией между устройствами
Чат с мультиустройственной синхронизацией — это личные и групповые сообщения, доставка на все устройства пользователя и история, переживающая смену телефона. Предположим 50 миллионов дневных пользователей, по ~40 сообщений каждый — 2 миллиарда в день, то есть около 23 000 записей в секунду в среднем и кратно больше на региональных пиках.
Каждый клиент держит WebSocket к серверу чата, который пишет сообщения в хранилище, разделённое по ID беседы, с возрастающим порядковым номером на беседу. Каждое устройство помнит последний увиденный номер и при переподключении запрашивает всё новее — так работает синхронизация между устройствами.
Хранилищу нужны высокая пропускная способность на запись и диапазонные чтения по беседе, поэтому обычно выбирают ширококолонковые базы вроде Cassandra. События доставки и прочтения — это мелкие события по тому же пути обратно.
Когда два друга подключены к разным серверам чата, либо pub/sub между серверами, либо роутинг-сервис, который сопоставляет пользователей серверам, доставляет сообщения. Группы на 500 участников разносятся на стороне сервера, а гарантии порядка становится сложнее выдерживать.
10. Спроектируйте сервис подбора поездок (райдшеринга)
Держите это проще, чем на старшем уровне. Водители шлют координаты каждые несколько секунд, пассажиры запрашивают поездку, и сервис должен вернуть ближайшего водителя за пару секунд.
Обновления геопозиции — это проблема объёма: 200 000 активных водителей при апдейте раз в 4 секунды — это 50 000 записей в секунду. Храните текущие координаты в памяти с индексом по geohash или ячейкам H3, а не в реляционной таблице. Матчинг — это «найти водителей в моей ячейке и соседних», ранжировать по ETA и залочить одного водителя, чтобы двое пассажиров не получили одну машину.
Если водитель принял заказ и потерял связь, лок истекает, и пассажиру подбирают другого. Горячая ячейка в центре города дробится на более мелкие — именно это дают иерархические индексы вроде H3.
11. Спроектируйте систему сбора метрик
Система метрик принимает несколько сотен метрик каждые 10 секунд с тысяч серверов и позволяет инженерам делать по ним запросы в дашбордах.
Агенты батчат метрики и пушат в слой приёма, который пишет в СУБД временных рядов (или в Kafka с консюмерами, пишущими туда). Хранение — тировое: сырое разрешение на день-два, минутные агрегации на месяц, часовое — на год. Даунсэмплинг крутится фоново.
Запросы идут к свёртке, соответствующей запрошенному диапазону, чтобы график за 30 дней не сканировал сырьё. Высокая кардинальность тегов (например, user ID как лейбл) «убьёт» базу — проговорите это вслух.
Про push против pull: Prometheus тянет сам, но push лучше проходит через фаерволы и для короткоживущих задач. Агент, шлющий метрики с запаздывающими таймстемпами, принимается в пределах окна допустимой задержки и отвергается за его пределами, с счётчиком отказов, чтобы «сломанные часы» было видно.
12. Спроектируйте автодополнение поиска
Автодополнение возвращает топ-5 завершений примерно за 100 миллисекунд на каждое нажатие клавиши. Уточните, глобальные ли подсказки или персонализированные — персонализация меняет всё.
Ответ — предвычисление. Оффлайн-пайплайн агрегирует логи запросов, считает частоты и строит trie (или таблицу «префикс → топ-k»), где каждый узел уже хранит свои лучшие завершения. Слой отдачи делает один лукап на нажатие, а вся структура помещается в память на нескольких репликах.
Обновления — батчами, скажем, ежечасно: перестроили структуру и подменили. Трендовые запросы можно держать в небольшом оверлее в реальном времени и мёрджить при запросе.
Префикс вроде «a» затрагивает огромное поддерево — поэтому вы храните топ-k в каждом узле, а не проходите по дереву. Опечатки требуют отдельного нечеткого индекса, либо вы принимаете промах.
13. Спроектируйте распределённый планировщик заданий
Распределённый планировщик — это cron для всей компании: определить задачу и расписание, запускать вовремя и не более одного раза за тик, ретраить при сбое и показывать результаты.
Определения задач и расписания хранятся в базе. Сервис-планировщик считает время следующего запуска для каждой задачи и кладёт «созревшие» задачи в очередь; пулы воркеров вытягивают и исполняют. Сложность — запустить ровно один инстанс планировщика на задачу без SPOF, обычно это лидер-елекция (лок в ZooKeeper, etcd или строка в базе с арендой).
Записывайте каждый запуск со статусом, временем начала и конца и ссылкой на логи. Именно эта таблица становится самой востребованной.
Задача, работающая дольше своего интервала, должна либо пропускаться, либо ставиться в очередь, либо пересекаться — и это должно настраиваться. Когда задача B зависит от A, зависимости образуют DAG, и планировщик ставит в очередь только после успеха апстрима.
Продвинутые вопросы по системному дизайну
Уровень сеньора. Огромные масштабы, мультирегион, цели по надёжности в числах и цена каждого решения. Интервьюер ожидает, что вы сами озвучите режимы отказов до того, как спросят.
14. Спроектируйте платформу видеостриминга наподобие YouTube
Видеостриминг — это две системы под одним названием. При загрузке пользователь отправляет сырой файл, пайплайн транскодирует его в несколько разрешений и битрейтов, нарезает на чанки по несколько секунд и кладёт чанки в объектное хранилище. При воспроизведении CDN отдаёт эти чанки, а плеер переключает битрейт под пропускную способность пользователя — адаптивный стриминг через HLS или DASH.
Назовите масштаб: сотни часов загрузок в минуту, миллиарды просмотров в день, хранение — экзабайты. Транскодирование идеально параллелится, поэтому большая ферма воркеров тянет задания из очереди. Метаданные вроде заголовка, владельца и счётчиков просмотров — в шардингованной базе с плотным кэшированием, потому что главная страница постоянно их читает. Объектное хранилище и узлы CDN реплицированы по регионам, важная SLO — время старта воспроизведения, метрика, которую чувствуют пользователи, — коэффициент ребуферинга.
Счётчики просмотров на вирусном видео — приблизительные, агрегируются батчами, а не инкремент базы на каждый просмотр; проверка авторских прав — это отпечатки в том же пайплайне загрузки.
15. Спроектируйте распределённую платформу логирования
Платформа логирования принимает логи от всех сервисов, делает их доступными для поиска в течение секунд и хранит 30 дней «горячо» и год «холодно».
Агенты читают файлы логов и отправляют в надёжный буфер вроде Kafka, который сглаживает всплески и позволяет индексаторам отставать без потери данных. Индексаторы пишут в поисковый кластер с одним индексом в день на сервис, а старые индексы сворачиваются в сжатые файлы в объектном хранилище.
Главное ограничение — стоимость, поэтому индексируйте структурированные поля и держите сырой текст дешёвым. Давайте каждому сервису квоту, мониторьте лаг индекса и вычищайте PII на входе.
Сервис, логирующий в 100 раз больше обычного, по порядку: ограничивается квотой, сэмплируется, отбрасывается и алертится. Кросс-регионные запросы — федеративный поиск, каждый регион хранит свои данные.
16. Спроектируйте систему аналитики в реальном времени
Реалтайм-аналитика — это дашборды с агрегатами за последние минуты, обновляемые в течение секунд, поверх потока, возможно, в миллион событий в секунду.
Потоковый процессор вроде Flink держит оконные агрегаты — например, поминутные счётчики по измерениям — и пишет их в быстрое хранилище для чтения, такое как ClickHouse или Druid. Дашборды ходят туда, а не в сырой поток.
Озвучьте компромиссы: точные подсчёты против HyperLogLog для уникальных пользователей, бьющиеся (tumbling) против скользящих окон и водяные метки (watermarks) для опоздавших событий. Задайте SLO по свежести и мониторьте лаг процессора относительно него.
Высокая кардинальность измерения вроде user ID раздует таблицу агрегатов — для него спрашивайте сырые события. Бэкфилл после бага — это реплей из потока с сохранёнными оффсетами.
17. Спроектируйте платёжную систему
Платежи — единственный дизайн, где корректность важнее масштаба. Система должна списать, записать, никогда не задвоить списание, ничего не потерять и ежедневно сверяться с банком.
Идемпотентность закрывает большую часть: у каждого запроса есть ключ, сервис хранит результат под ним и возвращает тот же при ретраях. Деньги двигаются через добавочный двусторонний бухучёт, где суммы проводок транзакции равны нулю, в реляционной базе с изоляцией serializable. Это тот случай, когда eventual consistency — неправильный ответ.
Вызовы к карточным сетям могут таймаутиться двусмысленно, поэтому списания получают статус pending, а задача сверки расставляет точки над i. Мультирегион — это «домашний» регион на аккаунт, никогда не active-active записи по одному балансу.
Мультивалюта — целые суммы в минорных единицах с кодом валюты, а возврат, пришедший до финализации списания, обрабатывается машиной состояний с явными переходами.
18. Спроектируйте масштабируемую систему обмена сообщениями
Масштабируемая система сообщений позволяет продюсерам публиковать, консюмерам подписываться, переживает рестарты брокеров и сохраняет порядок там, где это важно, при миллионах сообщений в секунду.
Разделяйте топики на партиции, чтобы сообщения с одним ключом попадали в одну партицию — это даёт порядок по ключу без глобального порядка. Каждая партиция — добавочный лог, реплицированный на несколько брокеров, а консюмеры коммитят свой оффсет после обработки.
По умолчанию — доставка как минимум один раз с идемпотентными консюмерами. Ретраи идут через retry-топик с бэкоффом, «ядовитые» сообщения — в dead-letter очередь. Лаг консюмера — ключевой сигнал для SLO, а между регионами — один регион владеет записями по ключу, иначе два региона перемешают порядок друг друга.
Консюмер, упавший после обработки, но до коммита, произведёт дубликат — вот почему важна идемпотентность. «Шторма» ребалансировки гасятся липкими назначениями и кооперативной ребалансировкой.
Вопросы по системному дизайну для бэкенд-инженеров
Фокус на API, моделях данных и границах сервисов. Ждите уточняющих вопросов о консистентности, кэшировании и логировании.
19. Спроектируйте сервис аутентификации и авторизации
Аутентификация отвечает «кто вы», авторизация — «что вам можно», и интервьюеры любят, когда кандидаты держат это разделение.
Используйте OAuth 2.0 и OpenID Connect, а не изобретайте протокол. Выдавайте короткоживущие access-токены и более долгие refresh-токены, хранимые на стороне сервера, чтобы их можно было отозвать. Права — в модели ролей, проверяемой небольшой библиотекой или policy-сервисом. Логируйте каждую попытку входа, обновление токена и отказ с IP и устройством, и никогда не логируйте сами токены.
JWT избавляет от лукапа на каждый запрос, но досрочный отзыв требует denylist, что возвращает лукап обратно. Credential stuffing замедляют лимиты по IP и аккаунту, задержки после повторных неудач и второй фактор при подозрительных входах.
20. Спроектируйте API-шлюз
API-шлюз — это единая точка входа перед вашими сервисами, берущая на себя сквозные задачи: роутинг по пути и версии, TLS-терминация, аутентификация, лимитирование и логирование запросов.
Сам шлюз должен быть статeless и масштабироваться горизонтально за балансировщиком. Конфигурация маршрутов живёт в control plane и пушится на инстансы шлюза — вы не деплоите шлюз заново, чтобы добавить маршрут. Токены аутентификации валидируются один раз на краю, а шлюз прокидывает идентичность пользователя в заголовке.
Озвучьте «радиус поражения». Шлюз на пути каждого запроса, поэтому неудачный пуш конфигурации может уронить всё; валидируйте конфиги, выкатывайте постепенно и держите логику шлюза тонкой.
Версионирование без поломки мобильных клиентов, которые вы не можете обновить, — это версия в пути или заголовке с поддержкой старых. И шлюз не должен агрегировать ответы нескольких сервисов; это задача слоя backend-for-frontend.
21. Спроектируйте систему заказов для e-commerce
Система заказов создаёт заказ, резервирует склад, принимает оплату, отгружает и показывает статус клиенту. Заказы — это машина состояний (created, paid, packed, shipped, delivered, cancelled), и допустимые переходы должны быть явными.
Создание заказа — это POST с ключом идемпотентности, чтобы двойной клик не создавал два заказа. Резервирование склада и оплата — это внешние сервисы, поэтому используйте сагу: каждый шаг публикует событие, а сбои запускают компенсирующие действия (освобождение склада, возврат). Пишите событие в outbox-таблицу в той же транзакции, что и обновление заказа, чтобы база и шина сообщений никогда не расходились.
На чтение — таблица заказов плюс order_items, с материализованным суммарным представлением в кэше для страницы «мои заказы».
Одновременная покупка последней единицы двумя клиентами решается блокировкой строки или атомарным декрементом на складе — один получит «нет в наличии». Мониторить стоит заказы, застрявшие в состоянии дольше нормы.
22. Спроектируйте сервис фича-флагов
Сервис фича-флагов переключает возможности по окружениям, таргетирует по атрибутам пользователя или процентам и переворачивает флаг глобально за секунды, когда что-то ломается.
Определения флагов и правила таргетинга живут в небольшой базе за админским API. Приложения встраивают SDK, который при старте забирает все флаги, кэширует их локально и оценивает правила в процессе, так что проверка флага ничего не стоит в момент запроса. Обновления распространяются через стриминг-соединение или частый опрос, а SDK держит последнее известное состояние при недоступности сервиса флагов.
Процентные раскатки оценивайте стабильным хешем из user ID и ключа флага, чтобы один и тот же пользователь всегда оказывался на той же стороне.
Залежалые флаги находите по таймстемпам последней оценки и напоминайте владельцам, а при недоступности сервиса флагов на старте приложение падает на дефолты, зашитые в код.
23. Спроектируйте API выдачи рекомендаций
API рекомендаций возвращает 20 элементов для пользователя менее чем за 100 миллисекунд при нескольких тысячах запросов в секунду, и для его дизайна не нужна глубокая ML.
Разделите оффлайн и онлайн. Оффлайн-джоб считает списки кандидатов по пользователям и кладёт их в низколатентное key-value хранилище. Онлайн-API их забирает, переранжирует по паре свежих фич вроде наличия на складе, фильтрует уже купленное и возвращает список. Держите запасной вариант — популярное по категориям — и логируйте каждый отданный список с request ID, чтобы потом связать с кликами.
Новому пользователю отдавайте запасной вариант до первых взаимодействий. 100 миллисекунд грубо делятся на 10 на выборку, 30 на переранжирование, 10 на сериализацию и 50 — запас.
Вопросы по системному дизайну для инфраструктуры / DevOps
Надёжность, деплой, автоматизация и наблюдаемость. Сквозная тема: как безопасно вносить изменения и быстро узнавать, когда ошиблись.
24. Спроектируйте CI/CD-пайплайн для микросервисов
CI/CD для микросервисов должен обслуживать десятки независимо разворачиваемых сервисов с тестами, проверками безопасности и путём до продакшена, не требующим человека в 3 часа ночи.
Собирайте один раз, разворачивайте один и тот же артефакт везде. Пайплайн линтит, гоняет юнит-тесты, собирает контейнерный образ с тэгом из SHA коммита, сканирует его и пушит в реестр. Деплой продвигает этот образ по окружениям (dev, staging, production) через конфигурацию, без пересборки.
Продакшен-выкатка должна быть прогрессивной: канарейка на несколько процентов трафика, наблюдение за ошибками и латентностью заданное окно, затем продолжение или автоматический откат. Откат — это развёртывание предыдущего тега образа, что быстро именно потому, что вы ничего не пересобирали.
Когда изменение сервиса A ломает контракт сервиса B, решение — контрактные тесты в CI и обратносовместимые изменения API. Монорепа против множества реп — менее важно, чем кажется, если пайплайн строит только то, что изменилось.
25. Спроектируйте централизованный мониторинг и алертинг
Централизованный мониторинг сводит метрики, логи и трейсы всех сервисов в одно место, с алертами, которые будят людей только когда страдают пользователи.
Метрики текут в хранилище временных рядов, логи — в платформу из вопроса 15, трейсы — в бэкенд трассировки, всё коррелировано общим request ID. Ключевое решение — по чему алертить. Алерты по симптомам (уровень ошибок, перцентили латентности, насыщение), привязанным к SLO, а не по причинам вроде «CPU 80%».
Усталость от пейджинга разрушает дежурства, поэтому у каждого пейджа должен быть ранбук и разбор. Всё, что зазвонило дважды за неделю без понятного действия, понижается до тикета.
SLO для нового сервиса появляется после пары недель измерений и установки цели чуть лучше текущего. А когда сам мониторинг лежит, внешние синтетические проверки и «dead-man's switch» — то, что вас предупредит.
26. Спроектируйте подход к управлению секретами
Управление секретами делает пароли к БД, API-ключи и сертификаты доступными сервисам во время выполнения, никогда — в исходниках, с регулярной ротацией и аудитом.
Централизованное хранилище секретов (HashiCorp Vault, менеджер секретов облачного провайдера) держит всё. Сервисы аутентифицируются в него своей рабочей идентичностью (Kubernetes service account, IAM-роль), а не долгоживущим токеном, и забирают секреты при старте или по требованию. Где возможно, используйте динамические секреты: хранилище генерирует учётные данные к базе, действительные час, и ротация происходит «бесплатно».
Аудируйте каждый доступ на чтение. И задокументируйте аварийный путь (break-glass) на случай, когда само хранилище секретов недоступно — это случится.
Ключ, который разработчик случайно закоммитил, будет пойман сканированием в CI, немедленно ротирован и в любом случае будет считаться скомпрометированным. Секреты в переменных окружения распространены, но утекают через дампы при сбоях и дочерние процессы, поэтому монтируйте их как файлы или получайте в процессе выполнения.
27. Спроектируйте автоскейлинг и стратегию выката
Автоскейлинг и выкат вместе должны позволять сервису справляться с дневными колебаниями трафика в 5 раз без ручного вмешательства, пока релизы выходят несколько раз в день.
Масштабируйтесь по сигналу, отражающему боль пользователя — обычно это скорость запросов или задержка на инстанс, а не только CPU. Задайте минимальное число реплик, чтобы холодный старт не пришёлся на пик, и максимальное — чтобы баг не разорил вас. Масштабируйтесь вверх быстро, вниз — медленно.
Для выката используйте blue/green, когда нужен мгновенный переключатель и откат, и canary — когда хотите сначала понаблюдать за реальным трафиком на малой доле. Аккуратно сочетайте канарейку с автоскейлером: если канарейка масштабируется независимо, сравнение может исказиться.
Если масштабирование запаздывает на внезапный всплеск на две минуты, предиктивное масштабирование по расписанию или более высокий минимум перекроют разрыв. А 50 новых инстансов, которые исчерпывают соединения с базой, — это причина, по которой пул соединений должен быть в прокси-слое.
Вопросы системного дизайна для интервью с дата-инженером
Конвейеры, форматы хранения, пакетная обработка против потоковой и то, можно ли доверять данным. Та же схема, что и раньше, но режимы отказа — про потерянные, дублированные или запоздавшие данные, а не про потерянные запросы.
28. Спроектируйте конвейер приёма событий
Конвейер приёма событий получает поведенческие события от веб- и мобильных клиентов и делает их пригодными для запросов в течение часа. Предположим пик 50 000 событий в секунду, при этом клиенты периодически офлайн и выполняют повторы.
Клиенты пакетируют события через SDK и отправляют их на сервис-сборщик, который валидирует их по реестру схем и пишет в поток (Kafka или управляемый аналог). Консьюмер складывает «сырые» события в объектное хранилище, разбитое на разделы по часам, в колоночном формате вроде Parquet. Дальнейшие задания читают оттуда.
Повторы ведут к дублям, поэтому каждое событие несёт сгенерированный клиентом UUID, а задача приземления выполняет дедупликацию в пределах окна. Изменения схем проходят через реестр с проверками совместимости, потому что мобильное приложение на старой версии будет отправлять старую форму месяцами.
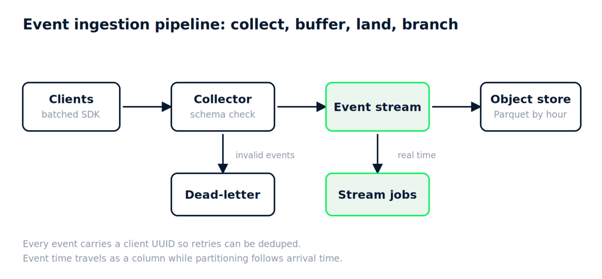
Событие с меткой времени трёхдневной давности приземляется по времени поступления, сохраняет «время события» в колонке и позволяет решать downstream-этапам. Плохие события попадают в путь карантина (dead-letter) и никогда не отбрасываются молча.
29. Спроектируйте потоковую ETL-систему
Потоковая ETL преобразует события по мере поступления, соединяет их со справочными данными и записывает результаты в витрину за секунды.
Потоковый процессор читает из топика приёма, применяет трансформации и обогащает справочными данными, загруженными в память и периодически обновляемыми. Состояние (для оконных объединений или агрегатов) чекпойнтится в надёжное хранилище, чтобы аварийная задача возобновлялась без перепроцессинга с начала.
Компромисс, который ждут услышать интервьюеры: exactly-once против at-least-once. Exactly-once достижимо сквозным образом, если приёмник поддерживает транзакции или идемпотентные записи, но это стоит задержки и сложности. At-least-once с идемпотентными приёмниками даёт большую часть выгоды.
Поздние данные обрабатываются водяными метками и заданным периодом «благодати», после которого они идут в таблицу поздних поступлений.
Справочные данные, которые меняются на лету, должны версионироваться; соединение — по версии, актуальной во «время события». Бэкфилл через полгода после исправления логики воспроизводится пакетно из сырого хранилища, а не через стрим.
30. Спроектируйте хранилище данных и подход к моделированию
Хранилище должно давать аналитикам и дашбордам согласованные метрики по данным продаж, маркетинга и продукта, с сохранением истории.
Складывайте сырые данные без изменений в «бронзу», очищайте и унифицируйте их в «серебре», а бизнес-ориентированные таблицы стройте в «золоте». Моделируйте «золото» как звёздную схему: фактовые таблицы на максимально полезном уровне детализации (например, одна строка на позицию заказа) и таблицы измерений для клиентов, продуктов, дат. Медленно меняющиеся измерения используйте по типу 2 там, где важна история, чтобы изменение региона клиента не переписало выручку прошлого года.
Крупные фактовые таблицы партиционируйте по дате, кластеризуйте по колонкам, по которым фильтруют, а трансформации держите в системе контроля версий (dbt или эквивалент) с тестами.
Когда две команды по-разному определяют «активного клиента», слой метрик с одной закреплённой дефиницией решает вопрос. Факт, пришедший с опозданием и ссылающийся на ещё не существующий ключ измерения, получает заглушку-строку в измерении, которая затем бэкфилится.
31. Спроектируйте feature store
Feature store вычисляет признаки один раз и переиспользует их и для обучения модели, и для онлайн-предсказаний — без рассинхронизации между обучением и продом; здесь остаёмся на высоком уровне. Это два хранилища с одним описанием: офлайн-хранилище (warehouse или lake) содержит историю признаков для построения обучающих выборок, а онлайн-хранилище (Redis, DynamoDB) хранит актуальное значение на сущность для быстрого чтения при предсказании.
Единое определение признака управляет обоими, а задание по расписанию материализует данные из офлайна в онлайн.
Критическая концепция — корректность на момент времени. При построении обучающего набора каждая строка должна использовать значения признаков такими, какими они были на её метку времени, а не текущие. Иначе модель «учится из будущего» и показывает блестящие результаты до релиза.
Признак, дорогой в реальном времени, либо предвычисляется с некоторой устарелостью, либо считается при записи. Чтобы убедиться, что онлайн- и офлайн-значения совпадают, делайте выборочное сравнение и логируйте фактически отданные признаки.
32. Спроектируйте слой качества данных и линий происхождения
Слой качества данных и линий происхождения (lineage) обнаруживает поломанные данные до того, как это увидят дашборды, и отвечает на вопрос «откуда взялась эта колонка» без чтения кода.
Проверки качества запускаются как шаги конвейера: количество строк в ожидаемых диапазонах, доля null, свежесть (приземлился ли раздел вовремя) и несколько бизнес-утверждений (выручка никогда не отрицательная). Сбои блокируют downstream-задачи и оповещают владельца. Храните результаты проверок во времени, чтобы видеть дрейф, а не только сегодняшнее «пройдено/не пройдено».
Lineage извлекается из кода трансформаций (парсинг SQL или метаданные оркестратора) и хранится как граф: таблица к таблице, по возможности колонка к колонке. Этот граф питает анализ влияния, когда кто-то хочет удалить колонку.
Если проверки занимают дольше, чем конвейер, берите выборку или запускайте тяжёлые проверки асинхронно и оповещайте вместо блокировки. Lineage между инструментами, которые не интегрируются, требует OpenLineage или ручных аннотаций, с документированными пробелами.
Вопросы по системному дизайну для фронтенд-/фуллстек-интервью
Производительность клиента, управление состоянием, кэширование и как браузер общается с API. Здесь тоже встречаются основы безопасности.
33. Спроектируйте архитектуру высоконагруженного веб‑приложения
Под высоконагруженным веб‑приложением здесь понимается контент‑насыщенный сайт с миллионами ежедневных посетителей, быстрым первым отображением и персонализированными разделами для авторизованных пользователей.
Статические ассеты размещайте на CDN с большим временем кэширования и хешированными именами файлов. Страницы, одинаковые для всех, рендерьте на сервере и кэшируйте на краю; персонализированные части загружайте на клиенте после отрисовки оболочки. Такой гибрид даёт низкий TTFB без раздачи устаревших персональных данных.
Вызовы API с клиента идут через шлюз с короткоживущими токенами. Настраивайте заголовки кэша осознанно: Cache-Control с stale-while-revalidate для контента, который может быть на несколько секунд старым, и no-store — для всего персонального.
Для дашборда за логином клиентский рендеринг обычно достаточен, так как SSR немного даёт без SEO. А ключ кэша, в который по ошибке попадает cookie сессии, выдаёт каждому собственную копию, и hit rate рушится.
34. Спроектируйте офлайн‑первую синхронизацию
Офлайн‑первая синхронизация — это приложение для заметок или полевых данных, которое работает без соединения и синхронизируется при его появлении, не теряя ничьих правок.
Каждая запись сначала уходит в локальное хранилище (IndexedDB, SQLite на мобильных) и в очередь ожидающих мутаций. Когда связь возвращается, клиент отправляет очередь по порядку и подтягивает изменения с момента последнего sync token. Каждая мутация несёт ID клиента и порядковый номер, чтобы сервер мог дедуплицировать.
Конфликты — это вся суть проблемы. Last-write-wins прост и теряет данные. Слияние на уровне полей покрывает большинство случаев.
CRDT дают автоматические слияния для текста и списков ценой сложности, и к ним стоит обращаться только если совместное редактирование — реальное требование.
Пользователь, который редактирует на двух устройствах в офлайне и возвращает оба, получает применение обеих правок, фиксацию конфликта и его отображение в интерфейсе. Очередь, выросшая до 10 000 мутаций, должна компактизироваться: десять правок одного поля превращаются в одну.
35. Спроектируйте обновления UI в реальном времени
Обновления UI в реальном времени — это дашборд или чат, который отражает изменения на сервере в течение секунды для тысяч одновременных пользователей.
Выбирайте транспорт по направлению. Server-Sent Events — когда данные идут только с сервера на клиента (живые счёты, уведомления); WebSocket — когда клиент тоже много отправляет (чат, совместное редактирование). Long polling — как запасной вариант для сетей, блокирующих оба.
На сервере слой pub/sub раздаёт изменения тому серверу соединений, где находится пользователь. На клиенте обрабатывайте переподключение с бэкофом и возобновляйте с последнего ID события, чтобы обрыв соединения не приводил к потере обновлений. Ограничивайте отрисовку: 50 обновлений в секунду для графика должны батчиться в несколько перерисовок, а не 50.
100 000 пользователей, смотрящих одно живое событие, — это серверный фан-аут, возможно, через CDN с поддержкой стриминга. Аутентификация WebSocket — токен при первоначальном рукопожатии, с периодической переПроверкой.
36. Спроектируйте план производительности на клиенте для дашбордов
Цель — аналитический дашборд с 20 графиками, который загружается менее чем за три секунды и остаётся отзывчивым при фильтрации.
Не запрашивайте 20 графиков сразу. Загружайте сперва видимые, остальные — лениво при прокрутке, и показывайте скелетоны, а не спиннеры. Предагрегируйте на сервере, чтобы клиент получал по нескольку сотен строк на график, никогда — сырые события.
Кэшируйте результаты запросов в памяти с ключом по состоянию фильтров, чтобы переключение туда‑обратно не приводило к повторной загрузке.
Таблицам с тысячами строк нужна виртуализация (рендер только видимой области). Тяжёлые вычисления отправляйте в web worker, чтобы главный поток оставался свободным для взаимодействия.
Если API медленный и вы не можете его изменить, кэшируйте агрессивно, показывайте устаревшие данные с меткой времени и обновляйте в фоне. Ошибки CORS при обращении дашборда к новому API означают, что API должен разрешить origin дашборда, и вы должны уметь объяснить предварительные запросы (preflight).
Ситуационные вопросы по системному дизайну
Они проверяют суждение, а не архитектуру. Требования меняются, прод ломается, и интервьюеру важно увидеть, как вы расставляете приоритеты.
37. Трафик вырос в 10 раз за ночь. Что меняете в первую очередь?
Начните с того, что ломается первым — и это редко без状態ный слой. Веб‑серверы прикрывает автоскейлинг; база данных, кэш и лимиты сторонних сервисов — вот где всё падает.
Сразу проверьте метрики насыщения (соединения, CPU, глубина очередей) для базы и кэша, поднимите потолок автоскейлера и включите любой отбор нагрузки, что у вас есть — например, отключение некритичных функций или раздачу закэшированных страниц. В течение дня добавьте реплики для чтения, подтяните hit ratio кэша и найдите доминирующие запросы. В долгосрочной перспективе сделайте шардирование и очереди, которые откладывали.
Отличить реальный рост от ботов помогает рисунок запросов, user agent’ы и то, изменились ли конверсии.
38. Упираетесь в лимиты чтения базы. Кэш, реплики или шардирование?
Обычно в таком порядке. Кэш перед самыми горячими чтениями стоит дёшево и может снизить нагрузку на базу вдвое за день; проверьте hit ratio и лог запросов, чтобы подтвердить, что чтения действительно повторяются.
Далее — реплики для чтения, когда смесь чтений широкая, а не узкая. Они добавляют лаг репликации, поэтому любой путь read-after-write (пользователь сохраняет и сразу видит изменения) должен идти на primary. Шардирование решает лимиты записи больше, чем чтения, и стоит кросс‑шардовых запросов и миграции — это в последнюю очередь и только когда первые два исчерпаны.
Если нагрузку создаёт один огромный клиент в одной таблице, изолируйте этого арендатора или партиционируйте по ID клиента.
39. Критическая внешняя зависимость «флапает». Повторы, тайм-ауты, автоматический выключатель (circuit breaker)?
Всё вместе и в правильном порядке. Сначала тайм-аут, потому что вызов без тайм-аута превращает медленную зависимость в вашу собственную аварию по мере накопления потоков. Затем повторы с экспоненциальным бэкофом и джиттером, но только для идемпотентных вызовов и всего пару раз — иначе вы усиливаете нагрузку на уже страдающий сервис.
Затем circuit breaker: после порога ошибок перестаньте вызывать на время и отдавайте запасной вариант (кэшированные данные, деградировавший ответ, вежливую ошибку). Мониторьте состояние брейкера; брейкер, застрявший в открытом состоянии, — отдельный инцидент.
Когда «флапает» платёжный провайдер, запаса по самому списанию нет; поставьте заказ в очередь как ожидающий и обработайте позже.
40. Задержка выросла после релиза. Как диагностировать?
Сначала подтвердите реальность и область: какая персентиль сдвинулась (p50 или только p99), какие эндпоинты, какой регион. Сравните с таймлайном деплоя; если регресс совпадает с релизом, сначала откатите, потом расследуйте.
Если откат не помогает, пройдите по запросу. Трейсы покажут, какой спан вырос. Частые причины: новый запрос без индекса, паттерн N+1 из‑за нового поля, изменение ключа кэша, уронившее hit ratio, или нисходящий вызов, который раньше был асинхронным, а теперь встраивается в путь запроса.
Если сдвинулась только p99 и откат не помог, ищите паузы GC, «шумного соседа» или блокировку.
41. Появилась несогласованность данных. Что проверяете, что откатываете?
Оцените масштаб до любых действий. Какие таблицы или записи расходятся, с какого момента и продолжается ли это сейчас? Ответ «с какого момента» обычно указывает на деплой или запуск задачи.
Проверьте путь записи для затронутых записей: недавние миграции, задача, запущенная дважды, повтор без идемпотентности, гонка между двумя писателями. Остановите «кровотечение», приостановив проблемную задачу или откатив код, затем восстановите из источника истины (сырой лог событий, книга учёта, бэкап), а не редактируйте строки вручную. Зафиксируйте, что и почему вы изменили.
Если источника истины для восстановления нет, реконструируйте, что возможно, остальное пометьте, и добавьте паттерн outbox, чтобы это не повторилось.
Распространённые ошибки на интервью по системному дизайну
Большинство кандидатов спотыкаются о одни и те же причины. Ни одна из них не о том, что вы «знаете меньше».
- Пропуск уточняющих вопросов. Сразу прыгнуть к «коробкам» — значит 40 минут решать не ту задачу.
- Без цифр. «Должно масштабироваться» ни о чём не говорит. 5 000 записей в секунду и 2 ТБ в год — это о чём-то, и это меняет дизайн.
- Одна идеальная архитектура. Интервьюеры хотят слышать: «Я выбрал X, потому что Y, а цена — Z». Один уверенный ответ без компромиссов звучит заученно.
- Слишком ранние микросервисы. Монолит с хорошими границами — отличный ответ для большинства базовых и средних вопросов. Разделение на 12 сервисов на доске добавляет режимы отказа, которые теперь нужно защищать.
- Игнорирование эксплуатации. Как это деплоится, что вы мониторите, что происходит при падении узла. Старшие обязательно спросят, а джуны получат бонусы, если скажут сами.
- Забыв про модель данных. Коробки и стрелки без представления, что в таблицах. Особенно болезненно для дата‑ролей.
- Уход в тишину. Две минуты молчаливых раздумий — вечность для интервьюера. Озвучивайте ход мыслей, даже если это «взвешиваю два варианта».
Как готовиться к интервью по системному дизайну
Подготовка работает, когда она повторяема. Вот процесс, которому действительно стоит следовать.
- Используйте одну и ту же структуру каждый раз. Шесть шагов с начала этой статьи, в этом порядке, на каждом тренировочном вопросе. Запишите их на карточке и репетируйте, пока последовательность не станет автоматической и вы перестанете тратить внимание на «что дальше».
- Делайте пробные интервью с таймером. Найдите друга, коллегу или хотя бы диктофон и прогоните 45 минут вслух, с перебиваниями уточняющими вопросами. Первые попытки будут шероховатыми — в этом и смысл.
- Соберите шаблон дизайна. Одностраничную «шпаргалку» с паттернами, к которым вы чаще всего обращаетесь: cache-aside, очереди для развязки, pub/sub для фан-аута, CQRS при различии чтений и записей, шардирование по ключу, outbox для согласованности между базой и шиной. Просматривайте её перед каждой сессией.
- Практикуйтесь объяснять компромиссы, а не только рисовать. Для каждого паттерна в списке уметь в одном предложении сказать, что он даёт и чего стоит. Это предложение отделяет «пройдено» от «сильно пройдено».
- Ориентируйтесь на уровень и роль. Выберите пять вопросов вашего уровня и четыре вашей роли из этого списка и отрепетируйте их как следует, а не пробегайте все 41. Если вопросы про конвейеры данных показались непривычными, наши Introduction to Data Engineering и Streaming Concepts курсы покрывают словарь, на котором держатся эти ответы.
Заключение
Каждый вопрос из этого списка родился из системы, которую кому-то пришлось построить, а потом поддерживать живой в 3 часа ночи, так что чем больше у вас такого опыта, тем меньше интервью похоже на выступление и тем больше — на рассказ о вашем обычном вторнике. Запустите пет‑проект с реальной очередью, запишитесь в очередь на дежурства, попроситесь на дизайн‑ревью, даже если дизайн не ваш.
А если вам нужен структурированный материал, который можно пройти между сейчас и следующим циклом интервью, эти ресурсы глубже разбирают компоненты, на которые опираются ответы:
- NoSQL Concepts помогает разобраться, когда key-value, документные, колоночные и графовые хранилища заслуживают своё место — это основа большей части рассуждений о хранении выше.
- Understanding Modern Data Architecture рассматривает приём, витрины, управление и оркестрацию как единую картину, а не набор отдельных инструментов.
- Professional Data Engineer in Python — более длительное обязательство, по итогам которого вы не просто читали про конвейеры, а действительно их строили.
- How to Learn Data Engineering From Scratch показывает весь путь, если вы ещё решаете, на что тратить время.
Вопросы по проектированию систем встречаются на собеседованиях чаще, чем можно подумать. Очевидно — в бэкенде. Но также в инфраструктуре, дата-инжиниринге и даже в продуктовых ролях, где от вас вовсе не ждут, что вы напишете ни строчки кода в процессе.
Так что же на самом деле проверяет интервьюер? Не то, знаете ли вы «правильную» архитектуру — её не существует. Им важно увидеть структурное мышление, честный разбор компромиссов и способность продолжать рассуждать, когда ограничения расплывчаты, а время идёт.
Ожидания сильно зависят от уровня. Джуниор, который задаёт хорошие уточняющие вопросы и набрасывает аккуратную схему из нескольких блоков, — уже молодец. Сеньор, который делает только это, — в беде, потому что на этом уровне ждут цифры, сценарии отказов и мнение о том, с чего начинать реализацию.
Роль тоже важна. Дата-инженера будут продавливать по пайплайнам и бэкфиллам, фронтендера — по кэшированию и состоянию, инфраструктурщика — по выкатываниям и радиусу поражения. Навык общий, словарь разный.
Почему это важно: большинство списков вопросов игнорируют обе оси и просто вываливают на вас 50 промптов. Здесь всё организовано сначала по уровню, затем по роли, с сценарными вопросами в конце. Если в ответах по хранилищам вы чувствуете неуверенность, наш курс по проектированию баз данных (Database Design) покрывает основы.
Как подходить к собеседованию по системному дизайну
Одна и та же структура каждый раз, примерно 45 минут:
Проговаривайте вслух весь ход мысли. Интервьюер не может оценить молчаливое мышление.
Вопросы для начинающих по системному дизайну
Здесь проверяют базу: уточнение требований до любых схем, простой архитектурный набросок и разумный выбор хранилища. Консенсусные алгоритмы никто не ждёт.
1. Спроектируйте сокращатель URL
Сокращатель превращает длинный URL в короткий код и делает редирект при переходе, так что сначала нужно выяснить, истекают ли ссылки и сколько их будет. Разумная оценка — 100 миллионов новых ссылок в месяц, при этом чтений примерно в 100 раз больше, чем записей.
Такой перекос в сторону чтения определяет дизайн: сервер API, база данных и кэш перед ней. Для короткого кода либо кодируйте автоинкрементный ID в base62 (семь символов дают порядка 3,5 трлн комбинаций), либо генерируйте случайную строку и проверяйте коллизии.
Хватает одной таблицы:
short_codeкак первичный ключ,long_url,created_at,expires_atи необязательныйuser_id. Горячие коды держите в Redis, чтобы база видела только промахи. Используйте редирект 302, если хотите аналитику кликов, потому что браузеры кэшируют 301, и второй визит вы не увидите.На 10 миллиардах ссылок вы шардируете по коду, а генератор ID становится узким местом; если люди начнут подбирать коды, переходите с последовательных на случайные и добавляйте ограничение частоты запросов.
2. Спроектируйте базовый ограничитель скорости
Ограничитель скорости позволяет N запросов на пользователя в минуту и возвращает 429 сверх этого. Сначала уточните, лимит — на пользователя, IP или API-ключ, потому что от этого зависит ключ в кэше.
Три алгоритма покрывают большинство ответов. Фиксированное окно считает запросы в каждой минутной корзине — просто, но у границы окна допускает двукратное превышение. Скользящее окно (лог) хранит каждый таймстемп — точно, но прожорливо по памяти. «Ведро токенов» пополняется с постоянной скоростью и пропускает небольшие всплески — именно поэтому его используют многие шлюзы.
Запускайте ограничитель как middleware в API-шлюзе с счётчиками в Redis под TTL; INCR плюс EXPIRE покрывают вариант с фиксированным окном.
С десятью инстансами шлюза либо делите счётчики Redis, либо миритесь с небольшим переучётом при локальных; и решите заранее, что делать, если Redis упадёт: «fail open» и риск злоупотреблений или «fail closed» и блокировка всех.
3. Спроектируйте простой key-value store
Key-value хранилищу нужны get, put и delete, и для начального уровня держите всё на одном узле. Операции обслуживает хэш-таблица в памяти. Для надёжности каждый запись апендится в лог на диск до подтверждения, а периодические снэпшоты избавляют от необходимости проигрывать всю историю при восстановлении.
Интервьюеру важно услышать, что вы отделили быстрый путь в памяти от надёжного пути на диск и понимаете, почему сначала идёт лог.
Если данных больше, чем памяти, ответ — LSM-дерево, примерно как в RocksDB и Cassandra. Если нужен второй узел, мастер реплицирует лог на фолловер, а при дальнейшем масштабировании подключается консистентное хеширование.
4. Спроектируйте кэш (концептуально)
Кэш стоит между приложением и более медленным хранилищем; базовый паттерн — cache-aside. Приложение проверяет кэш, при промахе читает базу и записывает результат обратно с TTL. Просто, но логика инвалидации на вас.
Вытеснение обычно LRU, иногда LFU для скошенных нагрузок. Главная метрика — коэффициент попаданий; ниже примерно 80% стоит спросить, помогает ли кэш вообще.
Где начинаются сложности: устаревание. Если база изменилась, а копия в кэше — нет, пользователи видят старые данные до истечения TTL. Короткие TTL уменьшают окно, но увеличивают нагрузку на базу.
Когда популярный ключ истекает и 10 000 запросов одновременно бьют в базу, либо коалесцируйте эти запросы, либо обновляйте ключ заранее. Про write-through и write-back: write-through сохраняет корректность кэша ценой более медленных записей; write-back быстрый, но теряет недавние записи, если кэш умрёт до сброса.
5. Спроектируйте базовый сервис уведомлений
Сервис уведомлений отправляет email, SMS и пуши и ретраит при сбое провайдера. До дизайна уточните объёмы и важен ли порядок доставки — обычно нет.
Сердце дизайна — очередь. Продюсеры пишут в неё событие уведомления, воркер на каждый канал читает события и вызывает провайдера вроде SendGrid или Twilio. Такое разделение оставляет принятие решения «уведомлять» отдельно от фактической отправки, так что медленный SMS-провайдер не блокирует приложение.
Храните каждое уведомление со статусом (pending, sent, failed) и ключом идемпотентности, чтобы повторная попытка не привела к двойной отправке.
Пользователи, желающие отключить маркетинг, но оставить безопасность, требуют таблицы предпочтений, проверяемой до постановки в очередь, а провайдер с лимитом 100 сообщений в секунду — поканальной регулировки скорости в воркере.
6. Спроектируйте простой файловый сервис
Подумайте о Dropbox в миниатюре. Пользователи загружают файл, получают ссылку, скачивают позже. Уточните максимальный размер файла и важен ли шаринг.
Метаданные (владелец, имя файла, размер, контрольная сумма, дата создания) — в реляционной базе. Байты — в объектном хранилище вроде S3, никогда не в базе. Для загрузок API возвращает предварительно подписанный URL, чтобы клиент писал напрямую в объектное хранилище, а ваши серверы не касались файла.
Дедупликация двух пользователей, загружающих один и тот же 2 ГБ файл, решается хешированием содержимого, а файлы свыше 5 ГБ требуют multipart-загрузки с checksum на каждый чанк.
7. Спроектируйте игровую таблицу лидеров
Лидерборду нужно уметь обновлять счёт игрока, возвращать топ-10 и ранг конкретного игрока. Сначала спросите, сколько игроков и как часто меняются счета.
Реляционная таблица с индексом по счёту работает до поры, но «какой у меня ранг» превращается в
COUNTпо всем выше вас. Redis sorted sets решают это:ZADDдля обновления,ZREVRANGEдля топ-N,ZREVRANKдля одного игрока — всё за логарифмическое время.Ежедневные и «за всё время» доски — по одному отсортированному множеству на период, ключи вида
lb:2026-09-14. Если 50 миллионов игроков слишком раздувают память Redis, храните там только топ-100k, а остальных — в базе.Вопросы среднего уровня по системному дизайну
На этом уровне предполагается, что вы строили и эксплуатировали реальные системы. Появляются очереди, масштабирование чтения/записи и баланс между задержкой, стоимостью и согласованностью.
8. Спроектируйте новостную ленту
Лента должна позволять публиковать, подписываться и читать записи тех, на кого подписаны, в обратном хронологическом или ранжированном порядке. Предположим 10 миллионов дневных активных пользователей, открывающих её пять раз в день — это примерно 600 чтений в секунду в среднем и гораздо больше на пике.
Ключевой выбор — когда собирать ленту. Fan-out on write пушит каждый новый пост в предвычисленную ленту каждого подписчика — быстрые чтения, дорогие записи. Fan-out on read собирает при запросе — наоборот. Большинство реальных систем смешивают подходы: фан-аут при записи для обычных аккаунтов и при чтении — для аккаунтов с миллионами подписчиков.
Модель данных — это
posts,followsи персональный список ленты в Redis с ID постов. Пагинация — курсором по ID поста, а не смещением.Добавление ранжирования позже не требует всё перестраивать; вы просто скорите кандидатные ID из списка ленты при чтении.
9. Спроектируйте чат с синхронизацией между устройствами
Чат с мультиустройственной синхронизацией — это личные и групповые сообщения, доставка на все устройства пользователя и история, переживающая смену телефона. Предположим 50 миллионов дневных пользователей, по ~40 сообщений каждый — 2 миллиарда в день, то есть около 23 000 записей в секунду в среднем и кратно больше на региональных пиках.
Каждый клиент держит WebSocket к серверу чата, который пишет сообщения в хранилище, разделённое по ID беседы, с возрастающим порядковым номером на беседу. Каждое устройство помнит последний увиденный номер и при переподключении запрашивает всё новее — так работает синхронизация между устройствами.
Хранилищу нужны высокая пропускная способность на запись и диапазонные чтения по беседе, поэтому обычно выбирают ширококолонковые базы вроде Cassandra. События доставки и прочтения — это мелкие события по тому же пути обратно.
Когда два друга подключены к разным серверам чата, либо pub/sub между серверами, либо роутинг-сервис, который сопоставляет пользователей серверам, доставляет сообщения. Группы на 500 участников разносятся на стороне сервера, а гарантии порядка становится сложнее выдерживать.
10. Спроектируйте сервис подбора поездок (райдшеринга)
Держите это проще, чем на старшем уровне. Водители шлют координаты каждые несколько секунд, пассажиры запрашивают поездку, и сервис должен вернуть ближайшего водителя за пару секунд.
Обновления геопозиции — это проблема объёма: 200 000 активных водителей при апдейте раз в 4 секунды — это 50 000 записей в секунду. Храните текущие координаты в памяти с индексом по geohash или ячейкам H3, а не в реляционной таблице. Матчинг — это «найти водителей в моей ячейке и соседних», ранжировать по ETA и залочить одного водителя, чтобы двое пассажиров не получили одну машину.
Если водитель принял заказ и потерял связь, лок истекает, и пассажиру подбирают другого. Горячая ячейка в центре города дробится на более мелкие — именно это дают иерархические индексы вроде H3.
11. Спроектируйте систему сбора метрик
Система метрик принимает несколько сотен метрик каждые 10 секунд с тысяч серверов и позволяет инженерам делать по ним запросы в дашбордах.
Агенты батчат метрики и пушат в слой приёма, который пишет в СУБД временных рядов (или в Kafka с консюмерами, пишущими туда). Хранение — тировое: сырое разрешение на день-два, минутные агрегации на месяц, часовое — на год. Даунсэмплинг крутится фоново.
Запросы идут к свёртке, соответствующей запрошенному диапазону, чтобы график за 30 дней не сканировал сырьё. Высокая кардинальность тегов (например, user ID как лейбл) «убьёт» базу — проговорите это вслух.
Про push против pull: Prometheus тянет сам, но push лучше проходит через фаерволы и для короткоживущих задач. Агент, шлющий метрики с запаздывающими таймстемпами, принимается в пределах окна допустимой задержки и отвергается за его пределами, с счётчиком отказов, чтобы «сломанные часы» было видно.
12. Спроектируйте автодополнение поиска
Автодополнение возвращает топ-5 завершений примерно за 100 миллисекунд на каждое нажатие клавиши. Уточните, глобальные ли подсказки или персонализированные — персонализация меняет всё.
Ответ — предвычисление. Оффлайн-пайплайн агрегирует логи запросов, считает частоты и строит trie (или таблицу «префикс → топ-k»), где каждый узел уже хранит свои лучшие завершения. Слой отдачи делает один лукап на нажатие, а вся структура помещается в память на нескольких репликах.
Обновления — батчами, скажем, ежечасно: перестроили структуру и подменили. Трендовые запросы можно держать в небольшом оверлее в реальном времени и мёрджить при запросе.
Префикс вроде «a» затрагивает огромное поддерево — поэтому вы храните топ-k в каждом узле, а не проходите по дереву. Опечатки требуют отдельного нечеткого индекса, либо вы принимаете промах.
13. Спроектируйте распределённый планировщик заданий
Распределённый планировщик — это cron для всей компании: определить задачу и расписание, запускать вовремя и не более одного раза за тик, ретраить при сбое и показывать результаты.
Определения задач и расписания хранятся в базе. Сервис-планировщик считает время следующего запуска для каждой задачи и кладёт «созревшие» задачи в очередь; пулы воркеров вытягивают и исполняют. Сложность — запустить ровно один инстанс планировщика на задачу без SPOF, обычно это лидер-елекция (лок в ZooKeeper, etcd или строка в базе с арендой).
Записывайте каждый запуск со статусом, временем начала и конца и ссылкой на логи. Именно эта таблица становится самой востребованной.
Задача, работающая дольше своего интервала, должна либо пропускаться, либо ставиться в очередь, либо пересекаться — и это должно настраиваться. Когда задача B зависит от A, зависимости образуют DAG, и планировщик ставит в очередь только после успеха апстрима.
Продвинутые вопросы по системному дизайну
Уровень сеньора. Огромные масштабы, мультирегион, цели по надёжности в числах и цена каждого решения. Интервьюер ожидает, что вы сами озвучите режимы отказов до того, как спросят.
14. Спроектируйте платформу видеостриминга наподобие YouTube
Видеостриминг — это две системы под одним названием. При загрузке пользователь отправляет сырой файл, пайплайн транскодирует его в несколько разрешений и битрейтов, нарезает на чанки по несколько секунд и кладёт чанки в объектное хранилище. При воспроизведении CDN отдаёт эти чанки, а плеер переключает битрейт под пропускную способность пользователя — адаптивный стриминг через HLS или DASH.
Назовите масштаб: сотни часов загрузок в минуту, миллиарды просмотров в день, хранение — экзабайты. Транскодирование идеально параллелится, поэтому большая ферма воркеров тянет задания из очереди. Метаданные вроде заголовка, владельца и счётчиков просмотров — в шардингованной базе с плотным кэшированием, потому что главная страница постоянно их читает. Объектное хранилище и узлы CDN реплицированы по регионам, важная SLO — время старта воспроизведения, метрика, которую чувствуют пользователи, — коэффициент ребуферинга.
Счётчики просмотров на вирусном видео — приблизительные, агрегируются батчами, а не инкремент базы на каждый просмотр; проверка авторских прав — это отпечатки в том же пайплайне загрузки.
15. Спроектируйте распределённую платформу логирования
Платформа логирования принимает логи от всех сервисов, делает их доступными для поиска в течение секунд и хранит 30 дней «горячо» и год «холодно».
Агенты читают файлы логов и отправляют в надёжный буфер вроде Kafka, который сглаживает всплески и позволяет индексаторам отставать без потери данных. Индексаторы пишут в поисковый кластер с одним индексом в день на сервис, а старые индексы сворачиваются в сжатые файлы в объектном хранилище.
Главное ограничение — стоимость, поэтому индексируйте структурированные поля и держите сырой текст дешёвым. Давайте каждому сервису квоту, мониторьте лаг индекса и вычищайте PII на входе.
Сервис, логирующий в 100 раз больше обычного, по порядку: ограничивается квотой, сэмплируется, отбрасывается и алертится. Кросс-регионные запросы — федеративный поиск, каждый регион хранит свои данные.
16. Спроектируйте систему аналитики в реальном времени
Реалтайм-аналитика — это дашборды с агрегатами за последние минуты, обновляемые в течение секунд, поверх потока, возможно, в миллион событий в секунду.
Потоковый процессор вроде Flink держит оконные агрегаты — например, поминутные счётчики по измерениям — и пишет их в быстрое хранилище для чтения, такое как ClickHouse или Druid. Дашборды ходят туда, а не в сырой поток.
Озвучьте компромиссы: точные подсчёты против HyperLogLog для уникальных пользователей, бьющиеся (tumbling) против скользящих окон и водяные метки (watermarks) для опоздавших событий. Задайте SLO по свежести и мониторьте лаг процессора относительно него.
Высокая кардинальность измерения вроде user ID раздует таблицу агрегатов — для него спрашивайте сырые события. Бэкфилл после бага — это реплей из потока с сохранёнными оффсетами.
17. Спроектируйте платёжную систему
Платежи — единственный дизайн, где корректность важнее масштаба. Система должна списать, записать, никогда не задвоить списание, ничего не потерять и ежедневно сверяться с банком.
Идемпотентность закрывает большую часть: у каждого запроса есть ключ, сервис хранит результат под ним и возвращает тот же при ретраях. Деньги двигаются через добавочный двусторонний бухучёт, где суммы проводок транзакции равны нулю, в реляционной базе с изоляцией serializable. Это тот случай, когда eventual consistency — неправильный ответ.
Вызовы к карточным сетям могут таймаутиться двусмысленно, поэтому списания получают статус pending, а задача сверки расставляет точки над i. Мультирегион — это «домашний» регион на аккаунт, никогда не active-active записи по одному балансу.
Мультивалюта — целые суммы в минорных единицах с кодом валюты, а возврат, пришедший до финализации списания, обрабатывается машиной состояний с явными переходами.
18. Спроектируйте масштабируемую систему обмена сообщениями
Масштабируемая система сообщений позволяет продюсерам публиковать, консюмерам подписываться, переживает рестарты брокеров и сохраняет порядок там, где это важно, при миллионах сообщений в секунду.
Разделяйте топики на партиции, чтобы сообщения с одним ключом попадали в одну партицию — это даёт порядок по ключу без глобального порядка. Каждая партиция — добавочный лог, реплицированный на несколько брокеров, а консюмеры коммитят свой оффсет после обработки.
По умолчанию — доставка как минимум один раз с идемпотентными консюмерами. Ретраи идут через retry-топик с бэкоффом, «ядовитые» сообщения — в dead-letter очередь. Лаг консюмера — ключевой сигнал для SLO, а между регионами — один регион владеет записями по ключу, иначе два региона перемешают порядок друг друга.
Консюмер, упавший после обработки, но до коммита, произведёт дубликат — вот почему важна идемпотентность. «Шторма» ребалансировки гасятся липкими назначениями и кооперативной ребалансировкой.
Вопросы по системному дизайну для бэкенд-инженеров
Фокус на API, моделях данных и границах сервисов. Ждите уточняющих вопросов о консистентности, кэшировании и логировании.
19. Спроектируйте сервис аутентификации и авторизации
Аутентификация отвечает «кто вы», авторизация — «что вам можно», и интервьюеры любят, когда кандидаты держат это разделение.
Используйте OAuth 2.0 и OpenID Connect, а не изобретайте протокол. Выдавайте короткоживущие access-токены и более долгие refresh-токены, хранимые на стороне сервера, чтобы их можно было отозвать. Права — в модели ролей, проверяемой небольшой библиотекой или policy-сервисом. Логируйте каждую попытку входа, обновление токена и отказ с IP и устройством, и никогда не логируйте сами токены.
JWT избавляет от лукапа на каждый запрос, но досрочный отзыв требует denylist, что возвращает лукап обратно. Credential stuffing замедляют лимиты по IP и аккаунту, задержки после повторных неудач и второй фактор при подозрительных входах.
20. Спроектируйте API-шлюз
API-шлюз — это единая точка входа перед вашими сервисами, берущая на себя сквозные задачи: роутинг по пути и версии, TLS-терминация, аутентификация, лимитирование и логирование запросов.
Сам шлюз должен быть статeless и масштабироваться горизонтально за балансировщиком. Конфигурация маршрутов живёт в control plane и пушится на инстансы шлюза — вы не деплоите шлюз заново, чтобы добавить маршрут. Токены аутентификации валидируются один раз на краю, а шлюз прокидывает идентичность пользователя в заголовке.
Озвучьте «радиус поражения». Шлюз на пути каждого запроса, поэтому неудачный пуш конфигурации может уронить всё; валидируйте конфиги, выкатывайте постепенно и держите логику шлюза тонкой.
Версионирование без поломки мобильных клиентов, которые вы не можете обновить, — это версия в пути или заголовке с поддержкой старых. И шлюз не должен агрегировать ответы нескольких сервисов; это задача слоя backend-for-frontend.
21. Спроектируйте систему заказов для e-commerce
Система заказов создаёт заказ, резервирует склад, принимает оплату, отгружает и показывает статус клиенту. Заказы — это машина состояний (
created,paid,packed,shipped,delivered,cancelled), и допустимые переходы должны быть явными.Создание заказа — это
POSTс ключом идемпотентности, чтобы двойной клик не создавал два заказа. Резервирование склада и оплата — это внешние сервисы, поэтому используйте сагу: каждый шаг публикует событие, а сбои запускают компенсирующие действия (освобождение склада, возврат). Пишите событие в outbox-таблицу в той же транзакции, что и обновление заказа, чтобы база и шина сообщений никогда не расходились.На чтение — таблица заказов плюс
order_items, с материализованным суммарным представлением в кэше для страницы «мои заказы».Одновременная покупка последней единицы двумя клиентами решается блокировкой строки или атомарным декрементом на складе — один получит «нет в наличии». Мониторить стоит заказы, застрявшие в состоянии дольше нормы.
22. Спроектируйте сервис фича-флагов
Сервис фича-флагов переключает возможности по окружениям, таргетирует по атрибутам пользователя или процентам и переворачивает флаг глобально за секунды, когда что-то ломается.
Определения флагов и правила таргетинга живут в небольшой базе за админским API. Приложения встраивают SDK, который при старте забирает все флаги, кэширует их локально и оценивает правила в процессе, так что проверка флага ничего не стоит в момент запроса. Обновления распространяются через стриминг-соединение или частый опрос, а SDK держит последнее известное состояние при недоступности сервиса флагов.
Процентные раскатки оценивайте стабильным хешем из user ID и ключа флага, чтобы один и тот же пользователь всегда оказывался на той же стороне.
Залежалые флаги находите по таймстемпам последней оценки и напоминайте владельцам, а при недоступности сервиса флагов на старте приложение падает на дефолты, зашитые в код.
23. Спроектируйте API выдачи рекомендаций
API рекомендаций возвращает 20 элементов для пользователя менее чем за 100 миллисекунд при нескольких тысячах запросов в секунду, и для его дизайна не нужна глубокая ML.
Разделите оффлайн и онлайн. Оффлайн-джоб считает списки кандидатов по пользователям и кладёт их в низколатентное key-value хранилище. Онлайн-API их забирает, переранжирует по паре свежих фич вроде наличия на складе, фильтрует уже купленное и возвращает список. Держите запасной вариант — популярное по категориям — и логируйте каждый отданный список с request ID, чтобы потом связать с кликами.
Новому пользователю отдавайте запасной вариант до первых взаимодействий. 100 миллисекунд грубо делятся на 10 на выборку, 30 на переранжирование, 10 на сериализацию и 50 — запас.
Вопросы по системному дизайну для инфраструктуры / DevOps
Надёжность, деплой, автоматизация и наблюдаемость. Сквозная тема: как безопасно вносить изменения и быстро узнавать, когда ошиблись.
24. Спроектируйте CI/CD-пайплайн для микросервисов
CI/CD для микросервисов должен обслуживать десятки независимо разворачиваемых сервисов с тестами, проверками безопасности и путём до продакшена, не требующим человека в 3 часа ночи.
Собирайте один раз, разворачивайте один и тот же артефакт везде. Пайплайн линтит, гоняет юнит-тесты, собирает контейнерный образ с тэгом из SHA коммита, сканирует его и пушит в реестр. Деплой продвигает этот образ по окружениям (dev, staging, production) через конфигурацию, без пересборки.
Продакшен-выкатка должна быть прогрессивной: канарейка на несколько процентов трафика, наблюдение за ошибками и латентностью заданное окно, затем продолжение или автоматический откат. Откат — это развёртывание предыдущего тега образа, что быстро именно потому, что вы ничего не пересобирали.
Когда изменение сервиса A ломает контракт сервиса B, решение — контрактные тесты в CI и обратносовместимые изменения API. Монорепа против множества реп — менее важно, чем кажется, если пайплайн строит только то, что изменилось.
25. Спроектируйте централизованный мониторинг и алертинг
Централизованный мониторинг сводит метрики, логи и трейсы всех сервисов в одно место, с алертами, которые будят людей только когда страдают пользователи.
Метрики текут в хранилище временных рядов, логи — в платформу из вопроса 15, трейсы — в бэкенд трассировки, всё коррелировано общим request ID. Ключевое решение — по чему алертить. Алерты по симптомам (уровень ошибок, перцентили латентности, насыщение), привязанным к SLO, а не по причинам вроде «CPU 80%».
Усталость от пейджинга разрушает дежурства, поэтому у каждого пейджа должен быть ранбук и разбор. Всё, что зазвонило дважды за неделю без понятного действия, понижается до тикета.
SLO для нового сервиса появляется после пары недель измерений и установки цели чуть лучше текущего. А когда сам мониторинг лежит, внешние синтетические проверки и «dead-man's switch» — то, что вас предупредит.
26. Спроектируйте подход к управлению секретами
Управление секретами делает пароли к БД, API-ключи и сертификаты доступными сервисам во время выполнения, никогда — в исходниках, с регулярной ротацией и аудитом.
Централизованное хранилище секретов (HashiCorp Vault, менеджер секретов облачного провайдера) держит всё. Сервисы аутентифицируются в него своей рабочей идентичностью (Kubernetes service account, IAM-роль), а не долгоживущим токеном, и забирают секреты при старте или по требованию. Где возможно, используйте динамические секреты: хранилище генерирует учётные данные к базе, действительные час, и ротация происходит «бесплатно».
Аудируйте каждый доступ на чтение. И задокументируйте аварийный путь (break-glass) на случай, когда само хранилище секретов недоступно — это случится.
Ключ, который разработчик случайно закоммитил, будет пойман сканированием в CI, немедленно ротирован и в любом случае будет считаться скомпрометированным. Секреты в переменных окружения распространены, но утекают через дампы при сбоях и дочерние процессы, поэтому монтируйте их как файлы или получайте в процессе выполнения.
27. Спроектируйте автоскейлинг и стратегию выката
Автоскейлинг и выкат вместе должны позволять сервису справляться с дневными колебаниями трафика в 5 раз без ручного вмешательства, пока релизы выходят несколько раз в день.
Масштабируйтесь по сигналу, отражающему боль пользователя — обычно это скорость запросов или задержка на инстанс, а не только CPU. Задайте минимальное число реплик, чтобы холодный старт не пришёлся на пик, и максимальное — чтобы баг не разорил вас. Масштабируйтесь вверх быстро, вниз — медленно.
Для выката используйте blue/green, когда нужен мгновенный переключатель и откат, и canary — когда хотите сначала понаблюдать за реальным трафиком на малой доле. Аккуратно сочетайте канарейку с автоскейлером: если канарейка масштабируется независимо, сравнение может исказиться.
Если масштабирование запаздывает на внезапный всплеск на две минуты, предиктивное масштабирование по расписанию или более высокий минимум перекроют разрыв. А 50 новых инстансов, которые исчерпывают соединения с базой, — это причина, по которой пул соединений должен быть в прокси-слое.
Вопросы системного дизайна для интервью с дата-инженером
Конвейеры, форматы хранения, пакетная обработка против потоковой и то, можно ли доверять данным. Та же схема, что и раньше, но режимы отказа — про потерянные, дублированные или запоздавшие данные, а не про потерянные запросы.
28. Спроектируйте конвейер приёма событий
Конвейер приёма событий получает поведенческие события от веб- и мобильных клиентов и делает их пригодными для запросов в течение часа. Предположим пик 50 000 событий в секунду, при этом клиенты периодически офлайн и выполняют повторы.
Клиенты пакетируют события через SDK и отправляют их на сервис-сборщик, который валидирует их по реестру схем и пишет в поток (Kafka или управляемый аналог). Консьюмер складывает «сырые» события в объектное хранилище, разбитое на разделы по часам, в колоночном формате вроде Parquet. Дальнейшие задания читают оттуда.
Повторы ведут к дублям, поэтому каждое событие несёт сгенерированный клиентом UUID, а задача приземления выполняет дедупликацию в пределах окна. Изменения схем проходят через реестр с проверками совместимости, потому что мобильное приложение на старой версии будет отправлять старую форму месяцами.
Событие с меткой времени трёхдневной давности приземляется по времени поступления, сохраняет «время события» в колонке и позволяет решать downstream-этапам. Плохие события попадают в путь карантина (dead-letter) и никогда не отбрасываются молча.
29. Спроектируйте потоковую ETL-систему
Потоковая ETL преобразует события по мере поступления, соединяет их со справочными данными и записывает результаты в витрину за секунды.
Потоковый процессор читает из топика приёма, применяет трансформации и обогащает справочными данными, загруженными в память и периодически обновляемыми. Состояние (для оконных объединений или агрегатов) чекпойнтится в надёжное хранилище, чтобы аварийная задача возобновлялась без перепроцессинга с начала.
Компромисс, который ждут услышать интервьюеры: exactly-once против at-least-once. Exactly-once достижимо сквозным образом, если приёмник поддерживает транзакции или идемпотентные записи, но это стоит задержки и сложности. At-least-once с идемпотентными приёмниками даёт большую часть выгоды.
Поздние данные обрабатываются водяными метками и заданным периодом «благодати», после которого они идут в таблицу поздних поступлений.
Справочные данные, которые меняются на лету, должны версионироваться; соединение — по версии, актуальной во «время события». Бэкфилл через полгода после исправления логики воспроизводится пакетно из сырого хранилища, а не через стрим.
30. Спроектируйте хранилище данных и подход к моделированию
Хранилище должно давать аналитикам и дашбордам согласованные метрики по данным продаж, маркетинга и продукта, с сохранением истории.
Складывайте сырые данные без изменений в «бронзу», очищайте и унифицируйте их в «серебре», а бизнес-ориентированные таблицы стройте в «золоте». Моделируйте «золото» как звёздную схему: фактовые таблицы на максимально полезном уровне детализации (например, одна строка на позицию заказа) и таблицы измерений для клиентов, продуктов, дат. Медленно меняющиеся измерения используйте по типу 2 там, где важна история, чтобы изменение региона клиента не переписало выручку прошлого года.
Крупные фактовые таблицы партиционируйте по дате, кластеризуйте по колонкам, по которым фильтруют, а трансформации держите в системе контроля версий (dbt или эквивалент) с тестами.
Когда две команды по-разному определяют «активного клиента», слой метрик с одной закреплённой дефиницией решает вопрос. Факт, пришедший с опозданием и ссылающийся на ещё не существующий ключ измерения, получает заглушку-строку в измерении, которая затем бэкфилится.
31. Спроектируйте feature store
Feature store вычисляет признаки один раз и переиспользует их и для обучения модели, и для онлайн-предсказаний — без рассинхронизации между обучением и продом; здесь остаёмся на высоком уровне. Это два хранилища с одним описанием: офлайн-хранилище (warehouse или lake) содержит историю признаков для построения обучающих выборок, а онлайн-хранилище (Redis, DynamoDB) хранит актуальное значение на сущность для быстрого чтения при предсказании.
Единое определение признака управляет обоими, а задание по расписанию материализует данные из офлайна в онлайн.
Критическая концепция — корректность на момент времени. При построении обучающего набора каждая строка должна использовать значения признаков такими, какими они были на её метку времени, а не текущие. Иначе модель «учится из будущего» и показывает блестящие результаты до релиза.
Признак, дорогой в реальном времени, либо предвычисляется с некоторой устарелостью, либо считается при записи. Чтобы убедиться, что онлайн- и офлайн-значения совпадают, делайте выборочное сравнение и логируйте фактически отданные признаки.
32. Спроектируйте слой качества данных и линий происхождения
Слой качества данных и линий происхождения (lineage) обнаруживает поломанные данные до того, как это увидят дашборды, и отвечает на вопрос «откуда взялась эта колонка» без чтения кода.
Проверки качества запускаются как шаги конвейера: количество строк в ожидаемых диапазонах, доля null, свежесть (приземлился ли раздел вовремя) и несколько бизнес-утверждений (выручка никогда не отрицательная). Сбои блокируют downstream-задачи и оповещают владельца. Храните результаты проверок во времени, чтобы видеть дрейф, а не только сегодняшнее «пройдено/не пройдено».
Lineage извлекается из кода трансформаций (парсинг SQL или метаданные оркестратора) и хранится как граф: таблица к таблице, по возможности колонка к колонке. Этот граф питает анализ влияния, когда кто-то хочет удалить колонку.
Если проверки занимают дольше, чем конвейер, берите выборку или запускайте тяжёлые проверки асинхронно и оповещайте вместо блокировки. Lineage между инструментами, которые не интегрируются, требует OpenLineage или ручных аннотаций, с документированными пробелами.
Вопросы по системному дизайну для фронтенд-/фуллстек-интервью
Производительность клиента, управление состоянием, кэширование и как браузер общается с API. Здесь тоже встречаются основы безопасности.
33. Спроектируйте архитектуру высоконагруженного веб‑приложения
Под высоконагруженным веб‑приложением здесь понимается контент‑насыщенный сайт с миллионами ежедневных посетителей, быстрым первым отображением и персонализированными разделами для авторизованных пользователей.
Статические ассеты размещайте на CDN с большим временем кэширования и хешированными именами файлов. Страницы, одинаковые для всех, рендерьте на сервере и кэшируйте на краю; персонализированные части загружайте на клиенте после отрисовки оболочки. Такой гибрид даёт низкий TTFB без раздачи устаревших персональных данных.
Вызовы API с клиента идут через шлюз с короткоживущими токенами. Настраивайте заголовки кэша осознанно:
Cache-Controlсstale-while-revalidateдля контента, который может быть на несколько секунд старым, иno-store— для всего персонального.Для дашборда за логином клиентский рендеринг обычно достаточен, так как SSR немного даёт без SEO. А ключ кэша, в который по ошибке попадает cookie сессии, выдаёт каждому собственную копию, и hit rate рушится.
34. Спроектируйте офлайн‑первую синхронизацию
Офлайн‑первая синхронизация — это приложение для заметок или полевых данных, которое работает без соединения и синхронизируется при его появлении, не теряя ничьих правок.
Каждая запись сначала уходит в локальное хранилище (IndexedDB, SQLite на мобильных) и в очередь ожидающих мутаций. Когда связь возвращается, клиент отправляет очередь по порядку и подтягивает изменения с момента последнего sync token. Каждая мутация несёт ID клиента и порядковый номер, чтобы сервер мог дедуплицировать.
Конфликты — это вся суть проблемы. Last-write-wins прост и теряет данные. Слияние на уровне полей покрывает большинство случаев.
CRDT дают автоматические слияния для текста и списков ценой сложности, и к ним стоит обращаться только если совместное редактирование — реальное требование.
Пользователь, который редактирует на двух устройствах в офлайне и возвращает оба, получает применение обеих правок, фиксацию конфликта и его отображение в интерфейсе. Очередь, выросшая до 10 000 мутаций, должна компактизироваться: десять правок одного поля превращаются в одну.
35. Спроектируйте обновления UI в реальном времени
Обновления UI в реальном времени — это дашборд или чат, который отражает изменения на сервере в течение секунды для тысяч одновременных пользователей.
Выбирайте транспорт по направлению. Server-Sent Events — когда данные идут только с сервера на клиента (живые счёты, уведомления); WebSocket — когда клиент тоже много отправляет (чат, совместное редактирование). Long polling — как запасной вариант для сетей, блокирующих оба.
На сервере слой pub/sub раздаёт изменения тому серверу соединений, где находится пользователь. На клиенте обрабатывайте переподключение с бэкофом и возобновляйте с последнего ID события, чтобы обрыв соединения не приводил к потере обновлений. Ограничивайте отрисовку: 50 обновлений в секунду для графика должны батчиться в несколько перерисовок, а не 50.
100 000 пользователей, смотрящих одно живое событие, — это серверный фан-аут, возможно, через CDN с поддержкой стриминга. Аутентификация WebSocket — токен при первоначальном рукопожатии, с периодической переПроверкой.
36. Спроектируйте план производительности на клиенте для дашбордов
Цель — аналитический дашборд с 20 графиками, который загружается менее чем за три секунды и остаётся отзывчивым при фильтрации.
Не запрашивайте 20 графиков сразу. Загружайте сперва видимые, остальные — лениво при прокрутке, и показывайте скелетоны, а не спиннеры. Предагрегируйте на сервере, чтобы клиент получал по нескольку сотен строк на график, никогда — сырые события.
Кэшируйте результаты запросов в памяти с ключом по состоянию фильтров, чтобы переключение туда‑обратно не приводило к повторной загрузке.
Таблицам с тысячами строк нужна виртуализация (рендер только видимой области). Тяжёлые вычисления отправляйте в web worker, чтобы главный поток оставался свободным для взаимодействия.
Если API медленный и вы не можете его изменить, кэшируйте агрессивно, показывайте устаревшие данные с меткой времени и обновляйте в фоне. Ошибки CORS при обращении дашборда к новому API означают, что API должен разрешить origin дашборда, и вы должны уметь объяснить предварительные запросы (preflight).
Ситуационные вопросы по системному дизайну
Они проверяют суждение, а не архитектуру. Требования меняются, прод ломается, и интервьюеру важно увидеть, как вы расставляете приоритеты.
37. Трафик вырос в 10 раз за ночь. Что меняете в первую очередь?
Начните с того, что ломается первым — и это редко без状態ный слой. Веб‑серверы прикрывает автоскейлинг; база данных, кэш и лимиты сторонних сервисов — вот где всё падает.
Сразу проверьте метрики насыщения (соединения, CPU, глубина очередей) для базы и кэша, поднимите потолок автоскейлера и включите любой отбор нагрузки, что у вас есть — например, отключение некритичных функций или раздачу закэшированных страниц. В течение дня добавьте реплики для чтения, подтяните hit ratio кэша и найдите доминирующие запросы. В долгосрочной перспективе сделайте шардирование и очереди, которые откладывали.
Отличить реальный рост от ботов помогает рисунок запросов, user agent’ы и то, изменились ли конверсии.
38. Упираетесь в лимиты чтения базы. Кэш, реплики или шардирование?
Обычно в таком порядке. Кэш перед самыми горячими чтениями стоит дёшево и может снизить нагрузку на базу вдвое за день; проверьте hit ratio и лог запросов, чтобы подтвердить, что чтения действительно повторяются.
Далее — реплики для чтения, когда смесь чтений широкая, а не узкая. Они добавляют лаг репликации, поэтому любой путь read-after-write (пользователь сохраняет и сразу видит изменения) должен идти на primary. Шардирование решает лимиты записи больше, чем чтения, и стоит кросс‑шардовых запросов и миграции — это в последнюю очередь и только когда первые два исчерпаны.
Если нагрузку создаёт один огромный клиент в одной таблице, изолируйте этого арендатора или партиционируйте по ID клиента.
39. Критическая внешняя зависимость «флапает». Повторы, тайм-ауты, автоматический выключатель (circuit breaker)?
Всё вместе и в правильном порядке. Сначала тайм-аут, потому что вызов без тайм-аута превращает медленную зависимость в вашу собственную аварию по мере накопления потоков. Затем повторы с экспоненциальным бэкофом и джиттером, но только для идемпотентных вызовов и всего пару раз — иначе вы усиливаете нагрузку на уже страдающий сервис.
Затем circuit breaker: после порога ошибок перестаньте вызывать на время и отдавайте запасной вариант (кэшированные данные, деградировавший ответ, вежливую ошибку). Мониторьте состояние брейкера; брейкер, застрявший в открытом состоянии, — отдельный инцидент.
Когда «флапает» платёжный провайдер, запаса по самому списанию нет; поставьте заказ в очередь как ожидающий и обработайте позже.
40. Задержка выросла после релиза. Как диагностировать?
Сначала подтвердите реальность и область: какая персентиль сдвинулась (p50 или только p99), какие эндпоинты, какой регион. Сравните с таймлайном деплоя; если регресс совпадает с релизом, сначала откатите, потом расследуйте.
Если откат не помогает, пройдите по запросу. Трейсы покажут, какой спан вырос. Частые причины: новый запрос без индекса, паттерн N+1 из‑за нового поля, изменение ключа кэша, уронившее hit ratio, или нисходящий вызов, который раньше был асинхронным, а теперь встраивается в путь запроса.
Если сдвинулась только p99 и откат не помог, ищите паузы GC, «шумного соседа» или блокировку.
41. Появилась несогласованность данных. Что проверяете, что откатываете?
Оцените масштаб до любых действий. Какие таблицы или записи расходятся, с какого момента и продолжается ли это сейчас? Ответ «с какого момента» обычно указывает на деплой или запуск задачи.
Проверьте путь записи для затронутых записей: недавние миграции, задача, запущенная дважды, повтор без идемпотентности, гонка между двумя писателями. Остановите «кровотечение», приостановив проблемную задачу или откатив код, затем восстановите из источника истины (сырой лог событий, книга учёта, бэкап), а не редактируйте строки вручную. Зафиксируйте, что и почему вы изменили.
Если источника истины для восстановления нет, реконструируйте, что возможно, остальное пометьте, и добавьте паттерн outbox, чтобы это не повторилось.
Распространённые ошибки на интервью по системному дизайну
Большинство кандидатов спотыкаются о одни и те же причины. Ни одна из них не о том, что вы «знаете меньше».
Как готовиться к интервью по системному дизайну
Подготовка работает, когда она повторяема. Вот процесс, которому действительно стоит следовать.
Заключение
Каждый вопрос из этого списка родился из системы, которую кому-то пришлось построить, а потом поддерживать живой в 3 часа ночи, так что чем больше у вас такого опыта, тем меньше интервью похоже на выступление и тем больше — на рассказ о вашем обычном вторнике. Запустите пет‑проект с реальной очередью, запишитесь в очередь на дежурства, попроситесь на дизайн‑ревью, даже если дизайн не ваш.
А если вам нужен структурированный материал, который можно пройти между сейчас и следующим циклом интервью, эти ресурсы глубже разбирают компоненты, на которые опираются ответы: