Perguntas de system design aparecem em mais entrevistas do que você imagina. Funções de backend, claro. Mas também em infraestrutura, engenharia de dados e até posições com foco em produto em que ninguém espera que você escreva uma linha de código durante o loop.
Então, o que o entrevistador realmente está testando? Não é se você sabe a arquitetura "correta", porque ela não existe. Eles querem ver pensamento estruturado, trade-offs honestos e se você consegue continuar raciocinando quando as restrições são vagas e o relógio está correndo.
As expectativas mudam bastante por nível. Um candidato júnior que faz boas perguntas de esclarecimento e rabisca um diagrama limpo com meia dúzia de caixas está indo muito bem. Um candidato sênior que faz só isso está em apuros, porque nesse nível esperam números, modos de falha e uma opinião sobre o que construir primeiro.
A função também pesa. Um data engineer é pressionado sobre pipelines e backfills, um desenvolvedor frontend sobre cache e estado, alguém de infra sobre rollouts e blast radius. Mesma habilidade de base, vocabulário diferente.
Estou destacando isso porque a maioria das listas ignora essas duas dimensões e só despeja 50 prompts em você. Aqui, organizamos por nível primeiro, depois por função, com perguntas de cenário no fim. Se a parte de storage nas respostas parecer frágil, nosso Database Design cobre os fundamentos.
Como encarar uma entrevista de system design
Mesma estrutura sempre, cerca de 45 minutos:
- Esclareça (5 min). Quem usa, o que precisa fazer, o que está fora de escopo e como é o "bom".
- Coloque números (2 min). Usuários, requisições por segundo, mix de leitura/escrita, crescimento de storage por ano. Chute é ok, silêncio não.
- Desenhe o alto nível (10 min). Clientes, camada de API, storage, cache, fila. Cinco ou seis caixas, no máximo.
- Mostre o modelo de dados (5 min). Tabelas ou coleções, chaves e os padrões de acesso que elas atendem.
- Aprofunde uma parte (10 min). Deixe o entrevistador escolher, ou ofereça a parte que você acha mais interessante.
- Falhas e trade-offs (restante). O que quebra, o que você monitoraria, o que construiria primeiro se fosse real.
Nar re tudo em voz alta. Entrevistador não consegue avaliar pensamento silencioso.
Perguntas de system design para iniciantes
Aqui o foco é nos fundamentos: esclarecer requisitos antes de desenhar, produzir um diagrama simples de arquitetura e fazer escolhas sensatas de storage. Ninguém espera algoritmos de consenso aqui.
1. Projete um encurtador de URL
Um encurtador transforma uma URL longa em um código curto e faz o redirecionamento na visita, então as primeiras decisões são se os links expiram e quantos você espera. Uma suposição razoável: 100 milhões de novos links por mês, com leituras cerca de 100x as escritas.
Esse mix intenso de leitura molda o design: um servidor de API, um banco de dados e um cache na frente. Para o código curto, ou faça base62 de um ID auto-incremental (sete caracteres dão cerca de 3,5 trilhões de combinações) ou gere uma string aleatória e verifique colisões.
Uma única tabela resolve: short_code como chave primária, long_url, created_at, expires_at e um user_id opcional. Códigos quentes vivem no Redis, então o banco só vê os misses. Use 302 se quiser analytics de clique, porque navegadores fazem cache de 301 e você não vê a segunda visita.
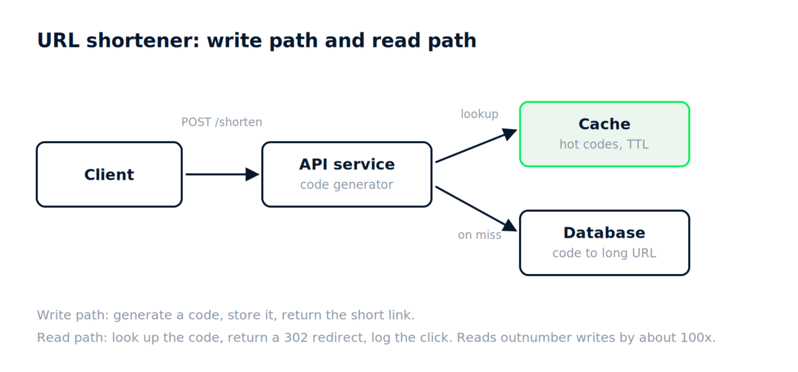
Com 10 bilhões de links você faz sharding por código e o gerador de ID vira gargalo; se começarem a adivinhar códigos, troque de sequencial para aleatório e adicione rate limiting.
2. Projete um rate limiter básico
Um rate limiter permite N requisições por usuário por minuto e retorna 429 além disso. Primeiro, esclareça se o limite é por usuário, por IP ou por chave de API, porque isso define a chave do cache.
Três algoritmos cobrem a maioria das respostas. Janela fixa conta as requisições por minuto, é simples mas permite o dobro no limite entre janelas. Janela deslizante com log armazena cada timestamp, é exata mas consome memória. Token bucket reabastece a uma taxa constante e deixa pequenos bursts passarem — por isso muitos gateways usam.
Rode o limiter como middleware no API gateway com contadores no Redis sob um TTL; INCR mais EXPIRE cobrem a versão de janela fixa.
Com dez instâncias do gateway, você ou compartilha os contadores no Redis ou aceita leve sobrecontagem com contadores locais, e deve decidir de antemão o que acontece se o Redis cair: fail open e arriscar abuso, ou fail closed e bloquear todo mundo.
3. Projete um key-value store simples
Um KV store precisa de get, put e delete e, para iniciantes, mantenha em um único nó. Um hash map em memória atende às operações. Para durabilidade, acrescente toda escrita a um log em disco antes de reconhecer, e tire snapshots periódicos para a recuperação não reprocessar o histórico inteiro.
O que o entrevistador quer ouvir é que você separou o caminho rápido em memória do caminho durável em disco e entende por que o log vem primeiro.
Se os dados crescerem além da memória, a resposta é uma LSM tree, que é basicamente como RocksDB e Cassandra funcionam. Se precisar de um segundo nó, o primário replica o log para um seguidor, e consistent hashing entra quando você passar disso.
4. Projete um cache (conceitual)
Um cache fica entre seu app e um store mais lento, e o padrão básico é cache-aside. O app verifica o cache, dá miss, lê do banco e escreve o resultado de volta com um TTL. Simples, mas a invalidação fica com você.
Evicção geralmente é LRU, às vezes LFU para workloads enviesadas. A métrica que importa é hit ratio; abaixo de 80% vale questionar se o cache ajuda.
Onde fica interessante: desatualização. Se o banco muda e a cópia no cache não, usuários veem dado antigo até o TTL expirar. TTLs curtos reduzem essa janela mas aumentam a carga no banco.
Quando uma chave popular expira e 10.000 requisições batem no banco de uma vez, ou você consolida essas requisições ou renova a chave antes de expirar. Em write-through versus write-back, write-through mantém o cache correto com custo de escritas mais lentas, enquanto write-back é rápido mas perde escritas recentes se o cache morrer antes de flush.
5. Projete um serviço básico de notificações
Um serviço de notificações envia email, SMS e push e tenta de novo quando um provedor falha. Antes de desenhar, pergunte sobre volume e se a ordem de entrega importa — quase sempre não.
O coração do design é uma fila. Produtores escrevem um evento de notificação nela, e um worker por canal puxa eventos e chama um provedor como SendGrid ou Twilio. Essa separação mantém a decisão de notificar apartada do envio em si, então um provedor de SMS lento não bloqueia o app.
Armazene cada notificação com um status (pending, sent, failed) e uma chave de idempotência para um retry não enviar duas vezes.
Usuários que querem desligar marketing mas manter alertas de segurança precisam de uma tabela de preferências consultada antes de enfileirar, e um provedor que limita a 100 mensagens/segundo exige throttling por canal no worker.
6. Projete um serviço simples de armazenamento de arquivos
Pense em um Dropbox em escala pequena. Usuários fazem upload de um arquivo, recebem um link e baixam depois. Esclareça o tamanho máximo e se compartilhamento importa.
Metadados (dono, nome, tamanho, checksum, data de criação) vão para um banco relacional. Os bytes vão para object storage como S3, nunca para o banco. Para upload, a API retorna uma URL pré-assinada para o cliente gravar direto no object storage — seus servidores não tocam no arquivo.
Dois usuários subindo o mesmo arquivo de 2 GB é dedupe resolvida por hashing do conteúdo, e arquivos acima de 5 GB precisam de upload multipart com checksum por chunk.
7. Projete um ranking (leaderboard) de jogo
Um leaderboard precisa atualizar a pontuação, retornar o top 10 e a posição de um jogador; primeiro, pergunte quantos jogadores existem e com que frequência a pontuação muda.
Uma tabela relacional com índice em score funciona até certo ponto, mas "qual é minha posição" vira um COUNT sobre todos acima de você. Sorted sets do Redis resolvem: ZADD para atualizar, ZREVRANGE para o top N, ZREVRANK para um jogador, tudo em tempo logarítmico.
Rankings diário e all-time são um sorted set por período, com chave tipo lb:2026-09-14. Se 50 milhões de jogadores estourarem a memória do Redis, mantenha só o top 100k lá e o resto no banco.
Perguntas de system design intermediárias
Nesse nível, o entrevistador assume que você já construiu e operou sistemas reais. As perguntas trazem filas, escala de leitura/escrita e a tensão entre latência, custo e consistência.
8. Projete um feed de notícias
Um feed precisa permitir postar, seguir e ler o que as pessoas que você segue escreveram, em ordem reversa ou ranqueada. Assuma 10 milhões de usuários diários abrindo 5 vezes ao dia, o que dá algo como 600 leituras por segundo em média e muito mais no pico.
A escolha central é quando montar o feed. Fan-out on write empurra cada novo post para o feed pré-computado de cada seguidor, dando leituras rápidas a custo de escritas caras. Fan-out on read monta sob demanda e inverte o trade-off. A maioria mistura: fan-out on write para usuários normais e on read para contas com milhões de seguidores.
O modelo de dados é posts, follows e uma lista de feed por usuário no Redis com IDs de posts. Faça paginação por cursor no ID do post, não por offset.
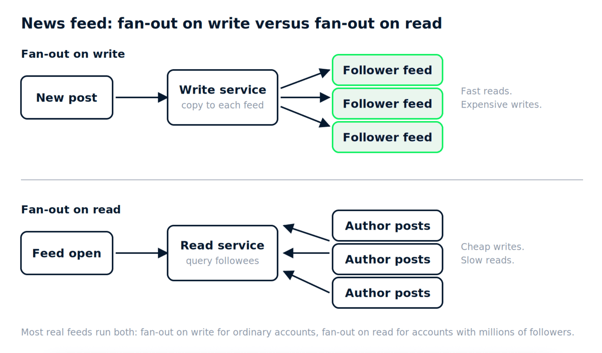
Adicionar ranking depois não exige reconstruir nada disso; você pontua os IDs candidatos da lista do feed na leitura.
Chat com sync multi-dispositivo inclui mensagens 1:1 e em grupo, entrega a todos os dispositivos do usuário e histórico que sobrevive à troca de celular. Assuma 50 milhões de usuários diários enviando ~40 mensagens cada: 2 bilhões/dia, cerca de 23.000 escritas/s em média e várias vezes isso nos picos regionais.
Cada cliente mantém um WebSocket com um servidor de chat, que grava mensagens em um store particionado por ID de conversa com um número de sequência crescente por conversa. Cada dispositivo lembra o último sequence visto e pede o que for mais novo ao reconectar — isso viabiliza o sync multi-dispositivo.
O store precisa de alta taxa de escrita e leituras por faixa por conversa, então bancos wide-column como Cassandra são comuns. Confirmações de entrega e leitura são eventos pequenos no mesmo caminho.
Quando dois amigos estão conectados a servidores diferentes, pub/sub entre servidores ou um serviço de roteamento que mapeia usuários para servidores faz a mensagem chegar. Grupos de 500 fazem fan-out no servidor, e garantir ordenação fica mais difícil.
10. Projete um serviço de matching de caronas
Mantenha mais leve que a versão sênior. Motoristas enviam localização a cada poucos segundos, passageiros pedem corrida e o serviço precisa retornar um motorista próximo em alguns segundos.
Atualizações de localização são o problema de volume: 200.000 motoristas ativos a um update a cada 4 segundos dá 50.000 escritas/s. Armazene localizações em memória indexadas por geohash ou célula H3, não em tabela relacional. Matching vira "ache motoristas na minha célula e vizinhas", ranqueie por ETA e faça lock em um motorista para dois passageiros não pegarem o mesmo carro.
Se o motorista aceita e perde conectividade, o lock expira e o passageiro é rematchado. Uma célula quente no centro da cidade ganha células mais finas — exatamente o que índices hierárquicos como H3 oferecem.
11. Projete um sistema de coleta de métricas
Um sistema de métricas recebe algumas centenas de métricas a cada 10 segundos de milhares de servidores e permite consultas em dashboards.
Agentes fazem batch e enviam para uma camada de ingestão, que grava em um banco de séries temporais (ou Kafka com consumidores escrevendo nele). Storage é em camadas: resolução bruta por um ou dois dias, agregações de 1 minuto por um mês, de hora por um ano. Downsampling roda em background.
Consultas batem na agregação que combina com o intervalo pedido, evitando que um gráfico de 30 dias leia dado bruto. Cardinalidade de tags (por exemplo, user ID como label) derruba o banco — fale isso explicitamente.
Sobre push vs pull, Prometheus puxa, mas push funciona melhor através de firewalls e para jobs de curta duração. Um agente reportando timestamps fora de ordem é aceito dentro de uma janela de tolerância e rejeitado além dela, com contador de rejeições para um clock quebrado aparecer.
12. Projete um sistema de autocomplete de busca
Autocomplete retorna as cinco melhores conclusões em ~100 ms por tecla. Esclareça se as sugestões são globais ou personalizadas, porque personalização muda tudo.
A resposta é pré-computar. Um pipeline offline agrega logs de consulta, conta frequências e constrói uma trie (ou tabela prefixo→top-k) onde cada nó já guarda seus melhores completions. A camada de serving então faz um único lookup por tecla, e a estrutura toda cabe em memória em algumas réplicas.
Atualizações acontecem em batch, talvez de hora em hora, reconstruindo a estrutura e trocando. Queries em alta podem ter um overlay em tempo real mesclado na requisição.
Um prefixo como “a” bateria numa subárvore enorme, por isso você armazena top-k em cada nó em vez de percorrer. Typos exigem um índice fuzzy separado — ou você aceita o miss.
13. Projete um escalonador de jobs distribuído
Um scheduler distribuído é um cron da empresa toda: definir job e agenda, rodar na hora certa e no máximo uma vez por tick, retentar em falha e mostrar o que aconteceu.
Guarde definições e agendas em um banco. Um serviço de scheduling calcula o próximo horário de cada job e empurra jobs devidos para uma fila; pools de workers puxam e executam. O ponto difícil é rodar exatamente uma instância de scheduler por job sem single point of failure, o que geralmente significa eleição de líder (um lock no ZooKeeper, etcd, ou uma linha no banco com lease).
Registre toda execução com status, início, fim e localização dos logs. Essa tabela vira o que as pessoas realmente consultam.
Um job que roda mais que seu intervalo deve pular, enfileirar ou sobrepor, e isso deve ser configurável. Quando o job B depende do A, dependências viram um DAG, e o scheduler só enfileira quando upstream teve sucesso.
Perguntas de system design avançadas
Nível sênior. Escala enorme, multi-região, metas de confiabilidade ditas em números e custo de cada decisão. O entrevistador espera que você antecipe modos de falha antes de ser perguntado.
Streaming de vídeo são dois sistemas sob um nome. No upload, o usuário envia o arquivo bruto e um pipeline transcodifica em várias resoluções e bitrates, fatia em chunks de poucos segundos e guarda em object storage. Na reprodução, um CDN serve os chunks e o player troca o bitrate conforme a banda do usuário — streaming adaptativo via HLS ou DASH.
Diga a escala: centenas de horas enviadas por minuto, bilhões de views por dia, storage em exabytes. Transcodificação é massivamente paralela, então um grande fleet de workers puxa jobs de uma fila. Metadados como título, dono e contagem de views vivem em um banco shardeado com cache pesado, porque a home lê o tempo todo. Object storage e bordas do CDN replicam entre regiões, e o SLO que importa é tempo para iniciar a reprodução, com taxa de rebuffering como a métrica que o usuário sente.
Contagem de views em um viral são contadores aproximados agregados em batch — nunca um incremento por view no banco — e matching de copyright é fingerprinting no mesmo pipeline de upload.
Uma plataforma de logs recebe logs de todo serviço, deixa pesquisável em segundos e mantém 30 dias quentes e um ano frios.
Agentes leem arquivos e enviam a um buffer durável como Kafka, que absorve picos e permite indexadores atrasarem sem perda. Indexadores escrevem em um cluster de busca com um índice por dia por serviço, e índices antigos descem para arquivos comprimidos em object storage.
Custo é a restrição real, então indexe campos estruturados e mantenha texto bruto barato. Dê cota por serviço, monitore o atraso de indexação e remova PII na ingestão.
Um serviço logando 100x o volume normal recebe cota, amostragem, descarte e alerta — nessa ordem. Consultas cross-region significam busca federada, com cada região dona do próprio dado.
16. Projete um sistema de analytics em tempo real
Analytics em tempo real significa dashboards com agregados dos últimos minutos, atualizados em segundos, em cima de um fluxo de talvez um milhão de eventos por segundo.
Um processador de stream como Flink mantém agregados em janelas (por exemplo, contagens por minuto por dimensão) e escreve em um store de leitura rápida como ClickHouse ou Druid. Dashboards consultam esse store, nunca o stream bruto.
Nomeie os trade-offs: contagens exatas versus HyperLogLog para distintos, janelas tumbling versus sliding, e watermarks para eventos atrasados. Defina um SLO de frescor e monitore o lag do processador.
Uma dimensão de alta cardinalidade como user ID explode a tabela de agregados, então consulte eventos brutos nesse caso. Backfill após um bug significa reprocessar do stream com offsets retidos.
17. Projete um sistema de pagamentos
Pagamentos são o caso em que correção supera escala. O sistema precisa cobrar, registrar, nunca cobrar em dobro, nunca perder um registro e conciliar com o banco diariamente.
Idempotência carrega grande parte disso: toda requisição tem uma chave, e o serviço guarda o resultado atrelado a ela e retorna o mesmo em retries. O dinheiro passa por um ledger de dupla entrada somente-apêndice em que as entradas de cada transação somam zero, em um banco relacional com isolamento serializável. Aqui eventual consistency é a resposta errada.
Chamadas à rede de cartões podem expirar de forma ambígua, então cobranças ficam pending e um job de reconciliação as liquida. Multi-região significa uma região “dona” por conta — nunca active-active escrevendo no mesmo saldo.
Multi-moeda significa valores inteiros em unidades menores com código da moeda, e um estorno que chega antes da liquidação da cobrança é tratado por uma máquina de estados com transições explícitas.
18. Projete um sistema de mensagens em larga escala
Um sistema de mensagens em larga escala permite publicar/assinar, sobrevive a reinícios de brokers e preserva ordem onde importa, a milhões de mensagens por segundo.
Particione cada tópico para mensagens com a mesma chave caírem na mesma partição, dando ordenação por chave sem ordenação global. Cada partição é um log somente-apêndice replicado para alguns brokers, e consumidores commitam seu offset após processar.
Padrão é at-least-once com consumidores idempotentes. Retries passam por um tópico de retry com backoff e mensagens envenenadas vão para uma dead-letter queue. Consumer lag é o sinal para SLO, e entre regiões, uma região é dona das escritas por chave ou haverá reordenação.
Um consumidor que cai após processar mas antes do commit gera duplicata — por isso idempotência importa. Tempestades de rebalanço são domadas com sticky assignment e cooperative rebalancing.
Perguntas de system design para backend engineers
Aqui o foco é em APIs, modelos de dados e fronteiras entre serviços. Espere follow-ups sobre consistência, cache e o que você logaria.
19. Projete um serviço de autenticação e autorização
Autenticação responde “quem é você” e autorização responde “o que você pode fazer”, e entrevistadores gostam de quem mantém isso separado.
Use OAuth 2.0 e OpenID Connect em vez de inventar protocolo. Emita access tokens curtos e refresh tokens mais longos guardados no servidor para você poder revogar. Permissões vivem em um modelo de papéis, verificadas por uma biblioteca leve ou serviço de políticas. Logue cada tentativa de login, refresh e negação com IP e dispositivo, e nunca logue os tokens em si.
JWTs evitam um lookup por requisição, mas revogar antes do vencimento exige denylist — o lookup volta. Credential stuffing é mitigado por rate limiting por IP e conta, delays após falhas repetidas e segundo fator em acessos suspeitos.
20. Projete um API gateway
Um API gateway é a porta única na frente dos serviços que cuida do trabalho transversal: roteamento por path e versão, terminação TLS, autenticação, rate limiting e logging de requisições.
O gateway deve ser stateless e escalar horizontalmente atrás de um load balancer. Configuração de rotas vive em um control plane e é empurrada para as instâncias — nada de redeploy para adicionar rota. Tokens são validados na borda e o gateway encaminha a identidade do usuário em um header.
Blast radius é o ponto-chave. O gateway está em todo caminho de requisição, então uma configuração ruim derruba tudo; valide configs, faça rollout gradual e mantenha a lógica do gateway enxuta.
Versionar sem quebrar apps mobile que você não atualiza significa versão no path ou no header com versões antigas ativas. E o gateway não deve agregar respostas de vários serviços; isso é função de um backend-for-frontend.
21. Projete um sistema de pedidos para e-commerce
Um sistema de pedidos cria o pedido, reserva estoque, cobra, envia e permite ver status. Pedidos são uma máquina de estados (created, paid, packed, shipped, delivered, cancelled), com transições explícitas.
Criação do pedido é um POST com chave de idempotência para um duplo clique não gerar dois pedidos. Reserva de estoque e pagamento envolvem outros serviços, então use uma saga: cada etapa publica um evento, e falhas disparam ações compensatórias (liberar estoque, reembolsar). Escreva o evento em uma outbox table na mesma transação da atualização do pedido para banco e bus nunca divergirem.
No lado de leitura, uma tabela de pedidos mais order_items, com um resumo materializado em cache para a página "meus pedidos".
Dois clientes comprando a última unidade ao mesmo tempo se resolve com lock de linha ou decremento atômico no estoque, e um deles recebe fora de estoque. Monitore pedidos presos em um estado além do esperado.
22. Projete um serviço de feature flags
Um serviço de feature flags alterna recursos por ambiente, direciona por atributos de usuário ou porcentagem e vira um flag global em segundos quando algo quebra.
Definições e regras vivem em um banco pequeno atrás de uma API de admin. Apps incorporam um SDK que busca todos os flags na inicialização, faz cache local e avalia regras no processo — checar flag não custa nada na requisição. Atualizações propagam por conexão de streaming ou short polling, e o SDK mantém o último estado se o serviço cair.
Rollouts por porcentagem usam um hash estável de user ID e chave do flag, para o mesmo usuário cair sempre no mesmo lado.
Flags obsoletos são achados rastreando o último uso e cobrando os donos, e se o serviço de flags estiver fora no startup o app volta aos defaults no código.
23. Projete uma API de recomendação
Uma API de recomendação retorna 20 itens por usuário em menos de 100 ms com alguns milhares de RPS — sem precisar de ML pesado no desenho.
Separe offline e online. Um job offline calcula listas de candidatos por usuário em um KV store de baixa latência. A API online busca isso, reranqueia com alguns atributos frescos como disponibilidade em estoque, filtra o que o usuário já comprou e retorna a lista. Tenha um fallback de populares por categoria e logue cada lista servida com um request ID para cruzar com cliques depois.
Usuário novo recebe fallback até entrarem algumas interações. Os 100 ms se dividem em ~10 para busca, 30 para rerank, 10 para serialização e 50 de folga.
Perguntas de system design para Infra/DevOps
Confiabilidade, deploy, automação e observabilidade. Tema recorrente: como mudar com segurança e saber rápido quando deu ruim.
24. Projete um pipeline de CI/CD para microservices
Um pipeline de CI/CD para microservices precisa lidar com dezenas de serviços implantáveis de forma independente com testes, checagens de segurança e caminho para produção sem precisar de alguém às 3 da manhã.
Build uma vez, implante o mesmo artefato em todo lugar. O pipeline linta, roda unit tests, constrói imagem de container tagueada com o SHA do commit, escaneia e envia para o registry. O deploy então promove essa imagem por ambientes (dev, staging, produção) via configuração, sem rebuild.
Rollout em produção deve ser progressivo: canário para poucos % do tráfego, observar taxa de erro e latência por uma janela definida, depois continuar ou rollback automático. Rollback é redeploy da tag anterior, rápido justamente porque você não rebuilda.
Quando a mudança do serviço A quebra o contrato do B, a solução são contract tests no CI e mudanças de API retrocompatíveis. Monorepo vs multi-repo importa menos do que parece, desde que o pipeline só construa o que mudou.
25. Projete monitoramento e alertas centralizados
Monitoramento centralizado reúne métricas, logs e traces de todo serviço num lugar, com alertas que só acordam alguém quando o usuário é afetado.
Métricas vão para um store de séries temporais, logs para a plataforma da pergunta 15, traces para um backend de tracing — tudo correlacionado por um request ID comum. A decisão chave é no que alertar. Alerta em sintomas (taxa de erro, percentis de latência, saturação) atrelados a SLOs, não em causas como "CPU a 80%".
Fadiga de pager destrói o plantão, então toda página precisa de runbook e revisão. Qualquer coisa que pague duas vezes na semana sem ação clara vira ticket.
Um SLO para serviço novo vem de medir por algumas semanas e definir uma meta um pouco melhor que a atual. E quando o próprio monitoramento cai, checks sintéticos externos e um dead-man’s switch avisam.
26. Projete uma abordagem de gestão de segredos
Gestão de segredos disponibiliza senhas de banco, chaves de API e certificados para serviços em runtime, nunca no código-fonte, com rotação regular e auditoria.
Um store central (HashiCorp Vault, secrets manager do cloud) guarda tudo. Serviços se autenticam via identidade do workload (service account do Kubernetes, papel de IAM), nunca token de longa duração, e buscam segredos no start ou sob demanda. Prefira segredos dinâmicos: o store gera credencial de banco válida por uma hora, e a rotação vem de graça.
Audite toda leitura. E tenha um caminho de break-glass documentado para quando o store cair — porque vai cair.
Uma chave que um dev cometeu por engano é pega por scan no CI, rotacionada imediatamente e tratada como comprometida. Segredos em variáveis de ambiente são comuns mas vazam por dumps e processos-filho; monte como arquivos ou busque em processo.
27. Projete autoscaling e estratégia de rollout
Autoscaling e rollout juntos precisam permitir lidar com variações diárias de 5x sem intervenção manual, enquanto deploys saem várias vezes ao dia.
Escale por um sinal que reflita dor do usuário, geralmente taxa de requisição ou latência por instância, não só CPU. Defina réplicas mínimas para um cold start não pegar um pico e máximas para um bug não falir você. Escale para cima rápido e para baixo devagar.
Para rollout, use blue/green quando precisa trocar/voltar instantaneamente, e canário quando quer observar tráfego real em uma fatia pequena primeiro. Combine canário e autoscaler com cuidado, porque um canário escalando isolado pode enviesar a comparação.
Se o scaling atrasar 2 minutos num pico repentino, scaling preditivo por agenda ou mínimo maior cobre a lacuna. E 50 novas instâncias esgotando conexões de banco é por que pooling deve ficar numa camada de proxy.
Perguntas de system design para Data Engineers
Pipelines, formatos de storage, batch vs streaming e se dá para confiar nos dados. Mesmo framework de antes, mas os modos de falha são sobre dados perdidos, duplicados ou atrasados — não requisições perdidas.
28. Projete um pipeline de ingestão de eventos
Um pipeline de ingestão recebe eventos comportamentais de web e mobile e os torna consultáveis em até uma hora. Assuma 50.000 eventos/s no pico, com clientes offline que fazem retry.
Clientes fazem batch via SDK e postam para um coletor que valida contra um registry de schemas e escreve em um stream (Kafka ou gerenciado). Um consumidor aterra eventos brutos em object storage particionado por hora, em formato colunar como Parquet. Jobs downstream leem dali.
Retries geram duplicatas, então todo evento carrega um UUID gerado no cliente e o job de landing deduplica dentro de uma janela. Mudanças de schema passam pelo registry com checagem de compatibilidade, porque apps antigos continuarão enviando o formato antigo por meses.
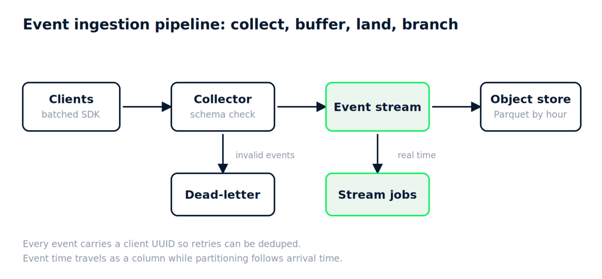
Um evento com timestamp de três dias atrás aterrissa por hora de chegada, mantém o event time como coluna e deixa downstream decidir. Eventos ruins vão para um caminho de dead-letter e nunca são descartados silenciosamente.
29. Projete um sistema de ETL em streaming
ETL em streaming transforma eventos na chegada, faz join com dados de referência e escreve resultados em um store de serving em segundos.
Um processador de stream lê do tópico de ingestão, aplica transformações e enriquece com dados de referência carregados em memória e atualizados periodicamente. Estado (para joins/aggregações com janelas) faz checkpoint em storage durável para um job cair e voltar sem reprocessar tudo.
O trade-off esperado: exactly-once versus at-least-once. Exactly-once é viável fim a fim se o sink suporta transações ou escritas idempotentes, mas custa latência e complexidade. At-least-once com sinks idempotentes entrega quase todo benefício.
Dados atrasados são tratados com watermarks e uma janela de graça definida; depois disso vão para uma tabela de late arrivals.
Dados de referência que mudam no meio do stream devem ser versionados, com o join na versão válida no event time. Um backfill seis meses depois de corrigir lógica reprocessa do storage bruto em batch, não pelo stream.
30. Projete um data warehouse e a modelagem
Um warehouse precisa oferecer métricas consistentes para analistas e dashboards em dados de vendas, marketing e produto, com histórico preservado.
Aterre dados brutos intactos na camada bronze, limpe e conforme na silver e construa tabelas de negócio na gold. Modele a gold como star schema: tabelas fato no grão mais útil (uma linha por item do pedido, por exemplo) e dimensões para clientes, produtos, datas. Dimensões lentamente mutáveis recebem Type 2 onde o histórico importa — a troca de região do cliente não reescreve a receita do ano passado.
Particione fatos grandes por data, clusterize pelas colunas mais filtradas e mantenha transformações em version control (dbt ou equivalente) com testes.
Quando duas equipes definem “cliente ativo” diferente, uma camada de métricas com definição única resolve. Um fato que chega tarde referenciando uma chave de dimensão ainda ausente recebe uma dimensão placeholder, backfilleada depois.
31. Projete um feature store
Um feature store computa features uma vez e as reutiliza para treino e predição online, sem skew entre treinamento e serving, e aqui fica no alto nível. São dois stores com uma definição: o offline (warehouse/lake) guarda histórico para treinos, e o online (Redis, DynamoDB) guarda o valor mais recente por entidade para lookup de baixa latência em predição.
Uma definição única dirige ambos, e um job materializa do offline para o online em agenda.
O conceito crítico é point-in-time correctness. No treinamento, cada linha deve usar features como existiam no timestamp dela, não as atuais. Senão o modelo aprende do futuro, parece ótimo e quebra em produção.
Uma feature cara de computar em tempo real é pré-computada com alguma desatualização ou calculada na escrita. Para assegurar que online e offline batem, amostre e compare, e logue as features realmente servidas.
32. Projete uma camada de qualidade e linhagem de dados
Uma camada de qualidade e linhagem detecta dados quebrados antes dos dashboards e responde “de onde veio esta coluna” sem ler código.
Checagens rodam como etapas do pipeline: contagem de linhas em faixas esperadas, taxas de nulos, frescor (partição chegou no horário) e algumas asserções de negócio (receita nunca negativa). Falhas bloqueiam jobs downstream e alertam o dono. Guarde resultados ao longo do tempo para ver drift, não só o hoje.
Linhagem é capturada do próprio código de transformação (parse de SQL ou metadados do orquestrador) e armazenada como grafo: de tabela para tabela e, quando possível, de coluna para coluna. Esse grafo alimenta análise de impacto quando alguém quer dropar uma coluna.
Se as checagens demoram mais que o pipeline, amostre, ou rode as pesadas de forma assíncrona e alerte em vez de bloquear. Linhagem entre ferramentas que não conversam pede OpenLineage ou anotações manuais, com as lacunas documentadas.
Perguntas de system design para Frontend/Full-stack
Performance no cliente, gestão de estado, cache e como o navegador fala com a API. Noções de segurança também aparecem.
33. Projete a arquitetura de um web app de alto tráfego
Aqui, um web app de alto tráfego é um site rico em conteúdo com milhões de visitas diárias, first paint rápido e seções personalizadas para logados.
Assets estáticos vão para um CDN com cache longo e nomes com hash. Páginas iguais para todos são renderizadas no servidor e cacheadas na borda; partes personalizadas carregam no cliente após o shell. Esse híbrido mantém TTFB baixo sem servir dados pessoais velhos.
Chamadas de API do cliente passam pelo gateway com tokens de curta duração. Defina headers de cache com cuidado: Cache-Control com stale-while-revalidate para conteúdo que pode ter alguns segundos, no-store para qualquer coisa pessoal.
Para um dashboard atrás de login, renderização no cliente costuma bastar, já que SSR pouco ajuda sem SEO. E uma chave de cache que inclui o cookie de sessão por engano dá uma cópia por usuário e derruba o hit rate.
34. Projete sync offline-first
Offline-first é um app de notas ou coleta em campo que funciona sem conexão e sincroniza depois — sem perder edições de ninguém.
Toda escrita vai para um store local primeiro (IndexedDB, SQLite no mobile) e para uma fila de mutações pendentes. Quando volta a conectividade, o cliente envia a fila em ordem e puxa mudanças desde seu último token de sync. Cada mutação carrega um client ID e um número de sequência para o servidor deduplicar.
Conflitos são o problema. Last-write-wins é simples e perde dados. Merge em nível de campo resolve a maioria.
CRDTs permitem merges automáticos para texto e listas com custo de complexidade — eu só usaria se edição colaborativa for mesmo requisito.
Usuário que edita offline em dois dispositivos e volta com ambos tem as duas edições aplicadas, conflito marcado e a UI mostrando. Uma fila pendente que cresce a 10.000 mutações deve ser compactada — dez edições do mesmo campo viram uma.
35. Projete atualizações de UI em tempo real
Atualizações em tempo real significam dashboard ou chat refletindo mudanças do servidor em até um segundo para milhares de usuários simultâneos.
Escolha o transporte pela direção. Server-Sent Events quando o fluxo é só servidor→cliente (placar ao vivo, notificações); WebSockets quando o cliente também envia bastante (chat, edição colaborativa). Long polling como fallback em redes que bloqueiam ambos.
No servidor, uma camada de pub/sub faz fan-out para o server de conexão do usuário. No cliente, trate reconexão com backoff e retome do último event ID para queda de conexão não virar perda de update. Faça throttling do render: 50 updates/segundo em um gráfico viram poucos repaints, não 50.
100.000 usuários assistindo um evento ao vivo exigem fan-out no servidor, possivelmente via CDN com suporte a streaming. Autenticar WebSocket significa token no handshake inicial, revalidado periodicamente.
A meta é um dashboard analítico com 20 gráficos que carrega em menos de três segundos e segue responsivo ao filtrar.
Não busque 20 gráficos de uma vez. Carregue os visíveis primeiro, lazy-load o resto ao rolar e mostre skeletons em vez de spinners. Pré-agregue no servidor para o cliente receber poucas centenas de linhas por gráfico, nunca eventos brutos.
Faça cache de resultados em memória com chave pelo estado de filtros, para alternar um filtro não refazer fetch.
Tabelas com milhares de linhas precisam de virtualização (renderize só o que está na tela). Cálculos pesados vão para um web worker para deixar a thread principal livre.
Se a API é lenta e você não pode mudá-la, faça cache agressivo, mostre dados “velhos” com timestamp e atualize em background. Erros de CORS quando o dashboard chama uma API nova significam que a API precisa permitir a origem do dashboard, e você deve saber explicar preflight.
Perguntas de system design baseadas em cenários
Aqui se testa julgamento, não arquitetura. Requisitos mudam, produção quebra, e o entrevistador quer ver como você faz triagem.
37. O tráfego subiu 10x da noite para o dia. O que muda primeiro?
Comece pelo que quebra primeiro — raramente a camada stateless. Autoscaling cuida dos web servers; banco, cache e limites de terceiros são onde cai.
Imediatamente, cheque saturação (conexões, CPU, profundidade de fila) do banco e cache, eleve o teto do autoscaler e ligue qualquer load shedding disponível, como derrubar features não críticas ou servir páginas cacheadas. Em um dia, adicione réplicas de leitura, ajuste hit ratio do cache e encontre queries dominantes. No longo prazo, faça o sharding e as filas que você vinha adiando.
Distinguir crescimento real de bot depende de padrões de requisição, user agents e se conversões mudaram.
38. Você está batendo limites de leitura no banco. Cache, réplicas ou sharding?
Nessa ordem, geralmente. Um cache na frente das leituras mais quentes é barato e corta carga pela metade em um dia; confira o hit ratio e o log de queries para saber se são repetitivas.
Réplicas atendem quando o mix de leitura é amplo, não só quente. Elas adicionam lag de replicação, então qualquer read-after-write (usuário salva e já vê) precisa ir ao primário. Sharding resolve mais limites de escrita que de leitura e custa queries cross-shard e migração — é por último, e só quando as duas primeiras se esgotarem.
Se um cliente enorme numa única tabela causa a carga, isole esse tenant ou particione por ID de cliente.
39. Uma dependência crítica está instável. Retries, timeouts, circuit breakers?
Todos, e na ordem certa. Primeiro timeout — chamada sem timeout transforma dependência lenta em seu outage conforme threads empilham. Depois retries com backoff exponencial e jitter, só para chamadas idempotentes e poucas vezes, senão você amplia a carga em quem já está sofrendo.
Depois circuit breaker: após um limiar de falhas, pare de chamar por um tempo e sirva um fallback (cache, resposta degradada, erro amigável). Monitore o estado do breaker; breaker travado aberto é incidente por si só.
Quando a dependência instável é o provedor de pagamento, não há fallback para a cobrança; enfileire o pedido como pendente e processe depois.
40. A latência piorou após um lançamento. Como diagnosticar?
Primeiro confirme e delimite: qual percentil (p50 ou só p99), quais endpoints, qual região. Compare com a linha do tempo de deploy; se alinhou com um release, faça rollback primeiro e investigue depois.
Se rollback não resolve, siga a requisição. Traces mostram qual span cresceu. Culpados comuns: query nova sem índice, padrão N+1 por um campo novo, mudança na chave de cache que derrubou hit ratio, ou chamada downstream que era assíncrona e virou síncrona.
Se só o p99 subiu e rollback não ajudou, procure pausas de GC, vizinho barulhento ou lock.
41. Apareceu um bug de inconsistência de dados. O que checar, o que reverter?
Dimensione o dano antes de tocar em algo. Quais tabelas ou registros divergem, desde quando e ainda está acontecendo? O “desde quando” normalmente aponta para um deploy ou job.
Cheque o caminho de escrita desses registros: migrações recentes, job que rodou duas vezes, retry sem idempotência, corrida entre dois escritores. Estanque o sangramento pausando o job culpado ou revertendo o código, depois repare a partir de uma fonte de verdade (evento bruto, ledger, backup), não editando linha manualmente. Registre o que mudou e por quê.
Sem fonte de verdade para reparar, reconstrua o que der, sinalize o resto e adote o padrão de outbox para não repetir.
Erros comuns em entrevistas de system design
A maioria reprova pelos mesmos poucos motivos. Nenhum é sobre “saber menos”.
- Pular perguntas de esclarecimento. Ir direto às caixas pode te fazer resolver o problema errado por 40 minutos.
- Sem números. "Precisa escalar" não diz nada. 5.000 escritas/s e 2 TB/ano dizem — e mudam o design.
- Uma arquitetura perfeita. Entrevistadores querem ouvir "eu escolheria X por Y, custando Z". Uma resposta confiante sem trade-offs soa decorada.
- Microservices cedo demais. Um monólito com bons limites é ótima resposta para a maioria das perguntas básicas e intermediárias. Dividir em 12 serviços no quadro adiciona falhas que você terá de defender.
- Ignorar operações. Como faz deploy, o que monitorar, o que acontece quando um nó cai. Entrevistadores sênior vão perguntar, e juniores ganham pontos extras se se anteciparem.
- Esquecer o modelo de dados. Caixas e setas sem ideia do que há nas tabelas. Isso custa caro especialmente em vagas de dados.
- Ficar em silêncio. Pensar quieto por dois minutos parece uma eternidade. Narre, nem que seja "estou pesando duas opções".
Como se preparar para entrevistas de system design
Preparação funciona quando é repetível. Eis um processo que eu realmente seguiria.
- Use a mesma estrutura sempre. Os seis passos do topo deste artigo, nessa ordem, em toda pergunta que você praticar. Escreva num cartão e repita até a sequência ficar automática e você pare de gastar atenção no “o que vem agora”.
- Faça mocks cronometrados. Chame um amigo, colega ou só um gravador, e faça 45 minutos em voz alta com alguém te interrompendo com follow-ups. Os primeiros serão ruins — esse é o objetivo.
- Monte um template de design. Uma página com os padrões que você sempre usa: cache-aside, filas para desacoplar, pub/sub para fan-out, CQRS quando leitura e escrita divergem, sharding por chave, outbox para consistência entre banco e bus. Revise antes de cada sessão.
- Pratique explicar trade-offs, não só desenhar. Para cada padrão no seu sheet, diga em uma frase o que ele entrega e o que custa. Essa frase separa um “passou” de um “mandou muito bem”.
- Vá por nível e função. Escolha cinco perguntas do seu nível e quatro da sua função nesta lista e treine de verdade, em vez de folhear as 41. Se as perguntas de pipeline pareceram novas, nossos Introduction to Data Engineering e Streaming Concepts cobrem o vocabulário em que aquelas respostas se apoiam.
Conclusão
Cada pergunta desta lista veio de um sistema que alguém precisou construir e manter vivo às 3 da manhã; quanto mais você faz isso, menos a entrevista parece um palco e mais parece descrever sua terça-feira. Toque um side project com uma fila de verdade, entre no plantão, peça para assistir uma design review mesmo quando o design não é seu.
E se você quer uma trilha estruturada até seu próximo loop, estes mergulham mais fundo nas peças em que estas respostas se apoiam:







Perguntas de system design aparecem em mais entrevistas do que você imagina. Funções de backend, claro. Mas também em infraestrutura, engenharia de dados e até posições com foco em produto em que ninguém espera que você escreva uma linha de código durante o loop.
Então, o que o entrevistador realmente está testando? Não é se você sabe a arquitetura "correta", porque ela não existe. Eles querem ver pensamento estruturado, trade-offs honestos e se você consegue continuar raciocinando quando as restrições são vagas e o relógio está correndo.
As expectativas mudam bastante por nível. Um candidato júnior que faz boas perguntas de esclarecimento e rabisca um diagrama limpo com meia dúzia de caixas está indo muito bem. Um candidato sênior que faz só isso está em apuros, porque nesse nível esperam números, modos de falha e uma opinião sobre o que construir primeiro.
A função também pesa. Um data engineer é pressionado sobre pipelines e backfills, um desenvolvedor frontend sobre cache e estado, alguém de infra sobre rollouts e blast radius. Mesma habilidade de base, vocabulário diferente.
Estou destacando isso porque a maioria das listas ignora essas duas dimensões e só despeja 50 prompts em você. Aqui, organizamos por nível primeiro, depois por função, com perguntas de cenário no fim. Se a parte de storage nas respostas parecer frágil, nosso Database Design cobre os fundamentos.
Como encarar uma entrevista de system design
Mesma estrutura sempre, cerca de 45 minutos:
Nar re tudo em voz alta. Entrevistador não consegue avaliar pensamento silencioso.
Perguntas de system design para iniciantes
Aqui o foco é nos fundamentos: esclarecer requisitos antes de desenhar, produzir um diagrama simples de arquitetura e fazer escolhas sensatas de storage. Ninguém espera algoritmos de consenso aqui.
1. Projete um encurtador de URL
Um encurtador transforma uma URL longa em um código curto e faz o redirecionamento na visita, então as primeiras decisões são se os links expiram e quantos você espera. Uma suposição razoável: 100 milhões de novos links por mês, com leituras cerca de 100x as escritas.
Esse mix intenso de leitura molda o design: um servidor de API, um banco de dados e um cache na frente. Para o código curto, ou faça base62 de um ID auto-incremental (sete caracteres dão cerca de 3,5 trilhões de combinações) ou gere uma string aleatória e verifique colisões.
Uma única tabela resolve:
short_codecomo chave primária,long_url,created_at,expires_ate umuser_idopcional. Códigos quentes vivem no Redis, então o banco só vê os misses. Use 302 se quiser analytics de clique, porque navegadores fazem cache de 301 e você não vê a segunda visita.Com 10 bilhões de links você faz sharding por código e o gerador de ID vira gargalo; se começarem a adivinhar códigos, troque de sequencial para aleatório e adicione rate limiting.
2. Projete um rate limiter básico
Um rate limiter permite N requisições por usuário por minuto e retorna 429 além disso. Primeiro, esclareça se o limite é por usuário, por IP ou por chave de API, porque isso define a chave do cache.
Três algoritmos cobrem a maioria das respostas. Janela fixa conta as requisições por minuto, é simples mas permite o dobro no limite entre janelas. Janela deslizante com log armazena cada timestamp, é exata mas consome memória. Token bucket reabastece a uma taxa constante e deixa pequenos bursts passarem — por isso muitos gateways usam.
Rode o limiter como middleware no API gateway com contadores no Redis sob um TTL; INCR mais EXPIRE cobrem a versão de janela fixa.
Com dez instâncias do gateway, você ou compartilha os contadores no Redis ou aceita leve sobrecontagem com contadores locais, e deve decidir de antemão o que acontece se o Redis cair: fail open e arriscar abuso, ou fail closed e bloquear todo mundo.
3. Projete um key-value store simples
Um KV store precisa de get, put e delete e, para iniciantes, mantenha em um único nó. Um hash map em memória atende às operações. Para durabilidade, acrescente toda escrita a um log em disco antes de reconhecer, e tire snapshots periódicos para a recuperação não reprocessar o histórico inteiro.
O que o entrevistador quer ouvir é que você separou o caminho rápido em memória do caminho durável em disco e entende por que o log vem primeiro.
Se os dados crescerem além da memória, a resposta é uma LSM tree, que é basicamente como RocksDB e Cassandra funcionam. Se precisar de um segundo nó, o primário replica o log para um seguidor, e consistent hashing entra quando você passar disso.
4. Projete um cache (conceitual)
Um cache fica entre seu app e um store mais lento, e o padrão básico é cache-aside. O app verifica o cache, dá miss, lê do banco e escreve o resultado de volta com um TTL. Simples, mas a invalidação fica com você.
Evicção geralmente é LRU, às vezes LFU para workloads enviesadas. A métrica que importa é hit ratio; abaixo de 80% vale questionar se o cache ajuda.
Onde fica interessante: desatualização. Se o banco muda e a cópia no cache não, usuários veem dado antigo até o TTL expirar. TTLs curtos reduzem essa janela mas aumentam a carga no banco.
Quando uma chave popular expira e 10.000 requisições batem no banco de uma vez, ou você consolida essas requisições ou renova a chave antes de expirar. Em write-through versus write-back, write-through mantém o cache correto com custo de escritas mais lentas, enquanto write-back é rápido mas perde escritas recentes se o cache morrer antes de flush.
5. Projete um serviço básico de notificações
Um serviço de notificações envia email, SMS e push e tenta de novo quando um provedor falha. Antes de desenhar, pergunte sobre volume e se a ordem de entrega importa — quase sempre não.
O coração do design é uma fila. Produtores escrevem um evento de notificação nela, e um worker por canal puxa eventos e chama um provedor como SendGrid ou Twilio. Essa separação mantém a decisão de notificar apartada do envio em si, então um provedor de SMS lento não bloqueia o app.
Armazene cada notificação com um status (pending, sent, failed) e uma chave de idempotência para um retry não enviar duas vezes.
Usuários que querem desligar marketing mas manter alertas de segurança precisam de uma tabela de preferências consultada antes de enfileirar, e um provedor que limita a 100 mensagens/segundo exige throttling por canal no worker.
6. Projete um serviço simples de armazenamento de arquivos
Pense em um Dropbox em escala pequena. Usuários fazem upload de um arquivo, recebem um link e baixam depois. Esclareça o tamanho máximo e se compartilhamento importa.
Metadados (dono, nome, tamanho, checksum, data de criação) vão para um banco relacional. Os bytes vão para object storage como S3, nunca para o banco. Para upload, a API retorna uma URL pré-assinada para o cliente gravar direto no object storage — seus servidores não tocam no arquivo.
Dois usuários subindo o mesmo arquivo de 2 GB é dedupe resolvida por hashing do conteúdo, e arquivos acima de 5 GB precisam de upload multipart com checksum por chunk.
7. Projete um ranking (leaderboard) de jogo
Um leaderboard precisa atualizar a pontuação, retornar o top 10 e a posição de um jogador; primeiro, pergunte quantos jogadores existem e com que frequência a pontuação muda.
Uma tabela relacional com índice em score funciona até certo ponto, mas "qual é minha posição" vira um
COUNTsobre todos acima de você. Sorted sets do Redis resolvem:ZADDpara atualizar,ZREVRANGEpara o top N,ZREVRANKpara um jogador, tudo em tempo logarítmico.Rankings diário e all-time são um sorted set por período, com chave tipo
lb:2026-09-14. Se 50 milhões de jogadores estourarem a memória do Redis, mantenha só o top 100k lá e o resto no banco.Perguntas de system design intermediárias
Nesse nível, o entrevistador assume que você já construiu e operou sistemas reais. As perguntas trazem filas, escala de leitura/escrita e a tensão entre latência, custo e consistência.
8. Projete um feed de notícias
Um feed precisa permitir postar, seguir e ler o que as pessoas que você segue escreveram, em ordem reversa ou ranqueada. Assuma 10 milhões de usuários diários abrindo 5 vezes ao dia, o que dá algo como 600 leituras por segundo em média e muito mais no pico.
A escolha central é quando montar o feed. Fan-out on write empurra cada novo post para o feed pré-computado de cada seguidor, dando leituras rápidas a custo de escritas caras. Fan-out on read monta sob demanda e inverte o trade-off. A maioria mistura: fan-out on write para usuários normais e on read para contas com milhões de seguidores.
O modelo de dados é
posts,followse uma lista de feed por usuário no Redis com IDs de posts. Faça paginação por cursor no ID do post, não por offset.Adicionar ranking depois não exige reconstruir nada disso; você pontua os IDs candidatos da lista do feed na leitura.
9. Projete um sistema de chat com sync em múltiplos dispositivos
Chat com sync multi-dispositivo inclui mensagens 1:1 e em grupo, entrega a todos os dispositivos do usuário e histórico que sobrevive à troca de celular. Assuma 50 milhões de usuários diários enviando ~40 mensagens cada: 2 bilhões/dia, cerca de 23.000 escritas/s em média e várias vezes isso nos picos regionais.
Cada cliente mantém um WebSocket com um servidor de chat, que grava mensagens em um store particionado por ID de conversa com um número de sequência crescente por conversa. Cada dispositivo lembra o último sequence visto e pede o que for mais novo ao reconectar — isso viabiliza o sync multi-dispositivo.
O store precisa de alta taxa de escrita e leituras por faixa por conversa, então bancos wide-column como Cassandra são comuns. Confirmações de entrega e leitura são eventos pequenos no mesmo caminho.
Quando dois amigos estão conectados a servidores diferentes, pub/sub entre servidores ou um serviço de roteamento que mapeia usuários para servidores faz a mensagem chegar. Grupos de 500 fazem fan-out no servidor, e garantir ordenação fica mais difícil.
10. Projete um serviço de matching de caronas
Mantenha mais leve que a versão sênior. Motoristas enviam localização a cada poucos segundos, passageiros pedem corrida e o serviço precisa retornar um motorista próximo em alguns segundos.
Atualizações de localização são o problema de volume: 200.000 motoristas ativos a um update a cada 4 segundos dá 50.000 escritas/s. Armazene localizações em memória indexadas por geohash ou célula H3, não em tabela relacional. Matching vira "ache motoristas na minha célula e vizinhas", ranqueie por ETA e faça lock em um motorista para dois passageiros não pegarem o mesmo carro.
Se o motorista aceita e perde conectividade, o lock expira e o passageiro é rematchado. Uma célula quente no centro da cidade ganha células mais finas — exatamente o que índices hierárquicos como H3 oferecem.
11. Projete um sistema de coleta de métricas
Um sistema de métricas recebe algumas centenas de métricas a cada 10 segundos de milhares de servidores e permite consultas em dashboards.
Agentes fazem batch e enviam para uma camada de ingestão, que grava em um banco de séries temporais (ou Kafka com consumidores escrevendo nele). Storage é em camadas: resolução bruta por um ou dois dias, agregações de 1 minuto por um mês, de hora por um ano. Downsampling roda em background.
Consultas batem na agregação que combina com o intervalo pedido, evitando que um gráfico de 30 dias leia dado bruto. Cardinalidade de tags (por exemplo, user ID como label) derruba o banco — fale isso explicitamente.
Sobre push vs pull, Prometheus puxa, mas push funciona melhor através de firewalls e para jobs de curta duração. Um agente reportando timestamps fora de ordem é aceito dentro de uma janela de tolerância e rejeitado além dela, com contador de rejeições para um clock quebrado aparecer.
12. Projete um sistema de autocomplete de busca
Autocomplete retorna as cinco melhores conclusões em ~100 ms por tecla. Esclareça se as sugestões são globais ou personalizadas, porque personalização muda tudo.
A resposta é pré-computar. Um pipeline offline agrega logs de consulta, conta frequências e constrói uma trie (ou tabela prefixo→top-k) onde cada nó já guarda seus melhores completions. A camada de serving então faz um único lookup por tecla, e a estrutura toda cabe em memória em algumas réplicas.
Atualizações acontecem em batch, talvez de hora em hora, reconstruindo a estrutura e trocando. Queries em alta podem ter um overlay em tempo real mesclado na requisição.
Um prefixo como “a” bateria numa subárvore enorme, por isso você armazena top-k em cada nó em vez de percorrer. Typos exigem um índice fuzzy separado — ou você aceita o miss.
13. Projete um escalonador de jobs distribuído
Um scheduler distribuído é um cron da empresa toda: definir job e agenda, rodar na hora certa e no máximo uma vez por tick, retentar em falha e mostrar o que aconteceu.
Guarde definições e agendas em um banco. Um serviço de scheduling calcula o próximo horário de cada job e empurra jobs devidos para uma fila; pools de workers puxam e executam. O ponto difícil é rodar exatamente uma instância de scheduler por job sem single point of failure, o que geralmente significa eleição de líder (um lock no ZooKeeper, etcd, ou uma linha no banco com lease).
Registre toda execução com status, início, fim e localização dos logs. Essa tabela vira o que as pessoas realmente consultam.
Um job que roda mais que seu intervalo deve pular, enfileirar ou sobrepor, e isso deve ser configurável. Quando o job B depende do A, dependências viram um DAG, e o scheduler só enfileira quando upstream teve sucesso.
Perguntas de system design avançadas
Nível sênior. Escala enorme, multi-região, metas de confiabilidade ditas em números e custo de cada decisão. O entrevistador espera que você antecipe modos de falha antes de ser perguntado.
14. Projete uma plataforma de streaming de vídeo como o YouTube
Streaming de vídeo são dois sistemas sob um nome. No upload, o usuário envia o arquivo bruto e um pipeline transcodifica em várias resoluções e bitrates, fatia em chunks de poucos segundos e guarda em object storage. Na reprodução, um CDN serve os chunks e o player troca o bitrate conforme a banda do usuário — streaming adaptativo via HLS ou DASH.
Diga a escala: centenas de horas enviadas por minuto, bilhões de views por dia, storage em exabytes. Transcodificação é massivamente paralela, então um grande fleet de workers puxa jobs de uma fila. Metadados como título, dono e contagem de views vivem em um banco shardeado com cache pesado, porque a home lê o tempo todo. Object storage e bordas do CDN replicam entre regiões, e o SLO que importa é tempo para iniciar a reprodução, com taxa de rebuffering como a métrica que o usuário sente.
Contagem de views em um viral são contadores aproximados agregados em batch — nunca um incremento por view no banco — e matching de copyright é fingerprinting no mesmo pipeline de upload.
15. Projete uma plataforma de logs distribuída
Uma plataforma de logs recebe logs de todo serviço, deixa pesquisável em segundos e mantém 30 dias quentes e um ano frios.
Agentes leem arquivos e enviam a um buffer durável como Kafka, que absorve picos e permite indexadores atrasarem sem perda. Indexadores escrevem em um cluster de busca com um índice por dia por serviço, e índices antigos descem para arquivos comprimidos em object storage.
Custo é a restrição real, então indexe campos estruturados e mantenha texto bruto barato. Dê cota por serviço, monitore o atraso de indexação e remova PII na ingestão.
Um serviço logando 100x o volume normal recebe cota, amostragem, descarte e alerta — nessa ordem. Consultas cross-region significam busca federada, com cada região dona do próprio dado.
16. Projete um sistema de analytics em tempo real
Analytics em tempo real significa dashboards com agregados dos últimos minutos, atualizados em segundos, em cima de um fluxo de talvez um milhão de eventos por segundo.
Um processador de stream como Flink mantém agregados em janelas (por exemplo, contagens por minuto por dimensão) e escreve em um store de leitura rápida como ClickHouse ou Druid. Dashboards consultam esse store, nunca o stream bruto.
Nomeie os trade-offs: contagens exatas versus HyperLogLog para distintos, janelas tumbling versus sliding, e watermarks para eventos atrasados. Defina um SLO de frescor e monitore o lag do processador.
Uma dimensão de alta cardinalidade como user ID explode a tabela de agregados, então consulte eventos brutos nesse caso. Backfill após um bug significa reprocessar do stream com offsets retidos.
17. Projete um sistema de pagamentos
Pagamentos são o caso em que correção supera escala. O sistema precisa cobrar, registrar, nunca cobrar em dobro, nunca perder um registro e conciliar com o banco diariamente.
Idempotência carrega grande parte disso: toda requisição tem uma chave, e o serviço guarda o resultado atrelado a ela e retorna o mesmo em retries. O dinheiro passa por um ledger de dupla entrada somente-apêndice em que as entradas de cada transação somam zero, em um banco relacional com isolamento serializável. Aqui eventual consistency é a resposta errada.
Chamadas à rede de cartões podem expirar de forma ambígua, então cobranças ficam pending e um job de reconciliação as liquida. Multi-região significa uma região “dona” por conta — nunca active-active escrevendo no mesmo saldo.
Multi-moeda significa valores inteiros em unidades menores com código da moeda, e um estorno que chega antes da liquidação da cobrança é tratado por uma máquina de estados com transições explícitas.
18. Projete um sistema de mensagens em larga escala
Um sistema de mensagens em larga escala permite publicar/assinar, sobrevive a reinícios de brokers e preserva ordem onde importa, a milhões de mensagens por segundo.
Particione cada tópico para mensagens com a mesma chave caírem na mesma partição, dando ordenação por chave sem ordenação global. Cada partição é um log somente-apêndice replicado para alguns brokers, e consumidores commitam seu offset após processar.
Padrão é at-least-once com consumidores idempotentes. Retries passam por um tópico de retry com backoff e mensagens envenenadas vão para uma dead-letter queue. Consumer lag é o sinal para SLO, e entre regiões, uma região é dona das escritas por chave ou haverá reordenação.
Um consumidor que cai após processar mas antes do commit gera duplicata — por isso idempotência importa. Tempestades de rebalanço são domadas com sticky assignment e cooperative rebalancing.
Perguntas de system design para backend engineers
Aqui o foco é em APIs, modelos de dados e fronteiras entre serviços. Espere follow-ups sobre consistência, cache e o que você logaria.
19. Projete um serviço de autenticação e autorização
Autenticação responde “quem é você” e autorização responde “o que você pode fazer”, e entrevistadores gostam de quem mantém isso separado.
Use OAuth 2.0 e OpenID Connect em vez de inventar protocolo. Emita access tokens curtos e refresh tokens mais longos guardados no servidor para você poder revogar. Permissões vivem em um modelo de papéis, verificadas por uma biblioteca leve ou serviço de políticas. Logue cada tentativa de login, refresh e negação com IP e dispositivo, e nunca logue os tokens em si.
JWTs evitam um lookup por requisição, mas revogar antes do vencimento exige denylist — o lookup volta. Credential stuffing é mitigado por rate limiting por IP e conta, delays após falhas repetidas e segundo fator em acessos suspeitos.
20. Projete um API gateway
Um API gateway é a porta única na frente dos serviços que cuida do trabalho transversal: roteamento por path e versão, terminação TLS, autenticação, rate limiting e logging de requisições.
O gateway deve ser stateless e escalar horizontalmente atrás de um load balancer. Configuração de rotas vive em um control plane e é empurrada para as instâncias — nada de redeploy para adicionar rota. Tokens são validados na borda e o gateway encaminha a identidade do usuário em um header.
Blast radius é o ponto-chave. O gateway está em todo caminho de requisição, então uma configuração ruim derruba tudo; valide configs, faça rollout gradual e mantenha a lógica do gateway enxuta.
Versionar sem quebrar apps mobile que você não atualiza significa versão no path ou no header com versões antigas ativas. E o gateway não deve agregar respostas de vários serviços; isso é função de um backend-for-frontend.
21. Projete um sistema de pedidos para e-commerce
Um sistema de pedidos cria o pedido, reserva estoque, cobra, envia e permite ver status. Pedidos são uma máquina de estados (
created,paid,packed,shipped,delivered,cancelled), com transições explícitas.Criação do pedido é um
POSTcom chave de idempotência para um duplo clique não gerar dois pedidos. Reserva de estoque e pagamento envolvem outros serviços, então use uma saga: cada etapa publica um evento, e falhas disparam ações compensatórias (liberar estoque, reembolsar). Escreva o evento em uma outbox table na mesma transação da atualização do pedido para banco e bus nunca divergirem.No lado de leitura, uma tabela de pedidos mais
order_items, com um resumo materializado em cache para a página "meus pedidos".Dois clientes comprando a última unidade ao mesmo tempo se resolve com lock de linha ou decremento atômico no estoque, e um deles recebe fora de estoque. Monitore pedidos presos em um estado além do esperado.
22. Projete um serviço de feature flags
Um serviço de feature flags alterna recursos por ambiente, direciona por atributos de usuário ou porcentagem e vira um flag global em segundos quando algo quebra.
Definições e regras vivem em um banco pequeno atrás de uma API de admin. Apps incorporam um SDK que busca todos os flags na inicialização, faz cache local e avalia regras no processo — checar flag não custa nada na requisição. Atualizações propagam por conexão de streaming ou short polling, e o SDK mantém o último estado se o serviço cair.
Rollouts por porcentagem usam um hash estável de user ID e chave do flag, para o mesmo usuário cair sempre no mesmo lado.
Flags obsoletos são achados rastreando o último uso e cobrando os donos, e se o serviço de flags estiver fora no startup o app volta aos defaults no código.
23. Projete uma API de recomendação
Uma API de recomendação retorna 20 itens por usuário em menos de 100 ms com alguns milhares de RPS — sem precisar de ML pesado no desenho.
Separe offline e online. Um job offline calcula listas de candidatos por usuário em um KV store de baixa latência. A API online busca isso, reranqueia com alguns atributos frescos como disponibilidade em estoque, filtra o que o usuário já comprou e retorna a lista. Tenha um fallback de populares por categoria e logue cada lista servida com um request ID para cruzar com cliques depois.
Usuário novo recebe fallback até entrarem algumas interações. Os 100 ms se dividem em ~10 para busca, 30 para rerank, 10 para serialização e 50 de folga.
Perguntas de system design para Infra/DevOps
Confiabilidade, deploy, automação e observabilidade. Tema recorrente: como mudar com segurança e saber rápido quando deu ruim.
24. Projete um pipeline de CI/CD para microservices
Um pipeline de CI/CD para microservices precisa lidar com dezenas de serviços implantáveis de forma independente com testes, checagens de segurança e caminho para produção sem precisar de alguém às 3 da manhã.
Build uma vez, implante o mesmo artefato em todo lugar. O pipeline linta, roda unit tests, constrói imagem de container tagueada com o SHA do commit, escaneia e envia para o registry. O deploy então promove essa imagem por ambientes (dev, staging, produção) via configuração, sem rebuild.
Rollout em produção deve ser progressivo: canário para poucos % do tráfego, observar taxa de erro e latência por uma janela definida, depois continuar ou rollback automático. Rollback é redeploy da tag anterior, rápido justamente porque você não rebuilda.
Quando a mudança do serviço A quebra o contrato do B, a solução são contract tests no CI e mudanças de API retrocompatíveis. Monorepo vs multi-repo importa menos do que parece, desde que o pipeline só construa o que mudou.
25. Projete monitoramento e alertas centralizados
Monitoramento centralizado reúne métricas, logs e traces de todo serviço num lugar, com alertas que só acordam alguém quando o usuário é afetado.
Métricas vão para um store de séries temporais, logs para a plataforma da pergunta 15, traces para um backend de tracing — tudo correlacionado por um request ID comum. A decisão chave é no que alertar. Alerta em sintomas (taxa de erro, percentis de latência, saturação) atrelados a SLOs, não em causas como "CPU a 80%".
Fadiga de pager destrói o plantão, então toda página precisa de runbook e revisão. Qualquer coisa que pague duas vezes na semana sem ação clara vira ticket.
Um SLO para serviço novo vem de medir por algumas semanas e definir uma meta um pouco melhor que a atual. E quando o próprio monitoramento cai, checks sintéticos externos e um dead-man’s switch avisam.
26. Projete uma abordagem de gestão de segredos
Gestão de segredos disponibiliza senhas de banco, chaves de API e certificados para serviços em runtime, nunca no código-fonte, com rotação regular e auditoria.
Um store central (HashiCorp Vault, secrets manager do cloud) guarda tudo. Serviços se autenticam via identidade do workload (service account do Kubernetes, papel de IAM), nunca token de longa duração, e buscam segredos no start ou sob demanda. Prefira segredos dinâmicos: o store gera credencial de banco válida por uma hora, e a rotação vem de graça.
Audite toda leitura. E tenha um caminho de break-glass documentado para quando o store cair — porque vai cair.
Uma chave que um dev cometeu por engano é pega por scan no CI, rotacionada imediatamente e tratada como comprometida. Segredos em variáveis de ambiente são comuns mas vazam por dumps e processos-filho; monte como arquivos ou busque em processo.
27. Projete autoscaling e estratégia de rollout
Autoscaling e rollout juntos precisam permitir lidar com variações diárias de 5x sem intervenção manual, enquanto deploys saem várias vezes ao dia.
Escale por um sinal que reflita dor do usuário, geralmente taxa de requisição ou latência por instância, não só CPU. Defina réplicas mínimas para um cold start não pegar um pico e máximas para um bug não falir você. Escale para cima rápido e para baixo devagar.
Para rollout, use blue/green quando precisa trocar/voltar instantaneamente, e canário quando quer observar tráfego real em uma fatia pequena primeiro. Combine canário e autoscaler com cuidado, porque um canário escalando isolado pode enviesar a comparação.
Se o scaling atrasar 2 minutos num pico repentino, scaling preditivo por agenda ou mínimo maior cobre a lacuna. E 50 novas instâncias esgotando conexões de banco é por que pooling deve ficar numa camada de proxy.
Perguntas de system design para Data Engineers
Pipelines, formatos de storage, batch vs streaming e se dá para confiar nos dados. Mesmo framework de antes, mas os modos de falha são sobre dados perdidos, duplicados ou atrasados — não requisições perdidas.
28. Projete um pipeline de ingestão de eventos
Um pipeline de ingestão recebe eventos comportamentais de web e mobile e os torna consultáveis em até uma hora. Assuma 50.000 eventos/s no pico, com clientes offline que fazem retry.
Clientes fazem batch via SDK e postam para um coletor que valida contra um registry de schemas e escreve em um stream (Kafka ou gerenciado). Um consumidor aterra eventos brutos em object storage particionado por hora, em formato colunar como Parquet. Jobs downstream leem dali.
Retries geram duplicatas, então todo evento carrega um UUID gerado no cliente e o job de landing deduplica dentro de uma janela. Mudanças de schema passam pelo registry com checagem de compatibilidade, porque apps antigos continuarão enviando o formato antigo por meses.
Um evento com timestamp de três dias atrás aterrissa por hora de chegada, mantém o event time como coluna e deixa downstream decidir. Eventos ruins vão para um caminho de dead-letter e nunca são descartados silenciosamente.
29. Projete um sistema de ETL em streaming
ETL em streaming transforma eventos na chegada, faz join com dados de referência e escreve resultados em um store de serving em segundos.
Um processador de stream lê do tópico de ingestão, aplica transformações e enriquece com dados de referência carregados em memória e atualizados periodicamente. Estado (para joins/aggregações com janelas) faz checkpoint em storage durável para um job cair e voltar sem reprocessar tudo.
O trade-off esperado: exactly-once versus at-least-once. Exactly-once é viável fim a fim se o sink suporta transações ou escritas idempotentes, mas custa latência e complexidade. At-least-once com sinks idempotentes entrega quase todo benefício.
Dados atrasados são tratados com watermarks e uma janela de graça definida; depois disso vão para uma tabela de late arrivals.
Dados de referência que mudam no meio do stream devem ser versionados, com o join na versão válida no event time. Um backfill seis meses depois de corrigir lógica reprocessa do storage bruto em batch, não pelo stream.
30. Projete um data warehouse e a modelagem
Um warehouse precisa oferecer métricas consistentes para analistas e dashboards em dados de vendas, marketing e produto, com histórico preservado.
Aterre dados brutos intactos na camada bronze, limpe e conforme na silver e construa tabelas de negócio na gold. Modele a gold como star schema: tabelas fato no grão mais útil (uma linha por item do pedido, por exemplo) e dimensões para clientes, produtos, datas. Dimensões lentamente mutáveis recebem Type 2 onde o histórico importa — a troca de região do cliente não reescreve a receita do ano passado.
Particione fatos grandes por data, clusterize pelas colunas mais filtradas e mantenha transformações em version control (dbt ou equivalente) com testes.
Quando duas equipes definem “cliente ativo” diferente, uma camada de métricas com definição única resolve. Um fato que chega tarde referenciando uma chave de dimensão ainda ausente recebe uma dimensão placeholder, backfilleada depois.
31. Projete um feature store
Um feature store computa features uma vez e as reutiliza para treino e predição online, sem skew entre treinamento e serving, e aqui fica no alto nível. São dois stores com uma definição: o offline (warehouse/lake) guarda histórico para treinos, e o online (Redis, DynamoDB) guarda o valor mais recente por entidade para lookup de baixa latência em predição.
Uma definição única dirige ambos, e um job materializa do offline para o online em agenda.
O conceito crítico é point-in-time correctness. No treinamento, cada linha deve usar features como existiam no timestamp dela, não as atuais. Senão o modelo aprende do futuro, parece ótimo e quebra em produção.
Uma feature cara de computar em tempo real é pré-computada com alguma desatualização ou calculada na escrita. Para assegurar que online e offline batem, amostre e compare, e logue as features realmente servidas.
32. Projete uma camada de qualidade e linhagem de dados
Uma camada de qualidade e linhagem detecta dados quebrados antes dos dashboards e responde “de onde veio esta coluna” sem ler código.
Checagens rodam como etapas do pipeline: contagem de linhas em faixas esperadas, taxas de nulos, frescor (partição chegou no horário) e algumas asserções de negócio (receita nunca negativa). Falhas bloqueiam jobs downstream e alertam o dono. Guarde resultados ao longo do tempo para ver drift, não só o hoje.
Linhagem é capturada do próprio código de transformação (parse de SQL ou metadados do orquestrador) e armazenada como grafo: de tabela para tabela e, quando possível, de coluna para coluna. Esse grafo alimenta análise de impacto quando alguém quer dropar uma coluna.
Se as checagens demoram mais que o pipeline, amostre, ou rode as pesadas de forma assíncrona e alerte em vez de bloquear. Linhagem entre ferramentas que não conversam pede OpenLineage ou anotações manuais, com as lacunas documentadas.
Perguntas de system design para Frontend/Full-stack
Performance no cliente, gestão de estado, cache e como o navegador fala com a API. Noções de segurança também aparecem.
33. Projete a arquitetura de um web app de alto tráfego
Aqui, um web app de alto tráfego é um site rico em conteúdo com milhões de visitas diárias, first paint rápido e seções personalizadas para logados.
Assets estáticos vão para um CDN com cache longo e nomes com hash. Páginas iguais para todos são renderizadas no servidor e cacheadas na borda; partes personalizadas carregam no cliente após o shell. Esse híbrido mantém TTFB baixo sem servir dados pessoais velhos.
Chamadas de API do cliente passam pelo gateway com tokens de curta duração. Defina headers de cache com cuidado:
Cache-Controlcomstale-while-revalidatepara conteúdo que pode ter alguns segundos,no-storepara qualquer coisa pessoal.Para um dashboard atrás de login, renderização no cliente costuma bastar, já que SSR pouco ajuda sem SEO. E uma chave de cache que inclui o cookie de sessão por engano dá uma cópia por usuário e derruba o hit rate.
34. Projete sync offline-first
Offline-first é um app de notas ou coleta em campo que funciona sem conexão e sincroniza depois — sem perder edições de ninguém.
Toda escrita vai para um store local primeiro (IndexedDB, SQLite no mobile) e para uma fila de mutações pendentes. Quando volta a conectividade, o cliente envia a fila em ordem e puxa mudanças desde seu último token de sync. Cada mutação carrega um client ID e um número de sequência para o servidor deduplicar.
Conflitos são o problema. Last-write-wins é simples e perde dados. Merge em nível de campo resolve a maioria.
CRDTs permitem merges automáticos para texto e listas com custo de complexidade — eu só usaria se edição colaborativa for mesmo requisito.
Usuário que edita offline em dois dispositivos e volta com ambos tem as duas edições aplicadas, conflito marcado e a UI mostrando. Uma fila pendente que cresce a 10.000 mutações deve ser compactada — dez edições do mesmo campo viram uma.
35. Projete atualizações de UI em tempo real
Atualizações em tempo real significam dashboard ou chat refletindo mudanças do servidor em até um segundo para milhares de usuários simultâneos.
Escolha o transporte pela direção. Server-Sent Events quando o fluxo é só servidor→cliente (placar ao vivo, notificações); WebSockets quando o cliente também envia bastante (chat, edição colaborativa). Long polling como fallback em redes que bloqueiam ambos.
No servidor, uma camada de pub/sub faz fan-out para o server de conexão do usuário. No cliente, trate reconexão com backoff e retome do último event ID para queda de conexão não virar perda de update. Faça throttling do render: 50 updates/segundo em um gráfico viram poucos repaints, não 50.
100.000 usuários assistindo um evento ao vivo exigem fan-out no servidor, possivelmente via CDN com suporte a streaming. Autenticar WebSocket significa token no handshake inicial, revalidado periodicamente.
36. Projete um plano de performance no cliente para dashboards
A meta é um dashboard analítico com 20 gráficos que carrega em menos de três segundos e segue responsivo ao filtrar.
Não busque 20 gráficos de uma vez. Carregue os visíveis primeiro, lazy-load o resto ao rolar e mostre skeletons em vez de spinners. Pré-agregue no servidor para o cliente receber poucas centenas de linhas por gráfico, nunca eventos brutos.
Faça cache de resultados em memória com chave pelo estado de filtros, para alternar um filtro não refazer fetch.
Tabelas com milhares de linhas precisam de virtualização (renderize só o que está na tela). Cálculos pesados vão para um web worker para deixar a thread principal livre.
Se a API é lenta e você não pode mudá-la, faça cache agressivo, mostre dados “velhos” com timestamp e atualize em background. Erros de CORS quando o dashboard chama uma API nova significam que a API precisa permitir a origem do dashboard, e você deve saber explicar preflight.
Perguntas de system design baseadas em cenários
Aqui se testa julgamento, não arquitetura. Requisitos mudam, produção quebra, e o entrevistador quer ver como você faz triagem.
37. O tráfego subiu 10x da noite para o dia. O que muda primeiro?
Comece pelo que quebra primeiro — raramente a camada stateless. Autoscaling cuida dos web servers; banco, cache e limites de terceiros são onde cai.
Imediatamente, cheque saturação (conexões, CPU, profundidade de fila) do banco e cache, eleve o teto do autoscaler e ligue qualquer load shedding disponível, como derrubar features não críticas ou servir páginas cacheadas. Em um dia, adicione réplicas de leitura, ajuste hit ratio do cache e encontre queries dominantes. No longo prazo, faça o sharding e as filas que você vinha adiando.
Distinguir crescimento real de bot depende de padrões de requisição, user agents e se conversões mudaram.
38. Você está batendo limites de leitura no banco. Cache, réplicas ou sharding?
Nessa ordem, geralmente. Um cache na frente das leituras mais quentes é barato e corta carga pela metade em um dia; confira o hit ratio e o log de queries para saber se são repetitivas.
Réplicas atendem quando o mix de leitura é amplo, não só quente. Elas adicionam lag de replicação, então qualquer read-after-write (usuário salva e já vê) precisa ir ao primário. Sharding resolve mais limites de escrita que de leitura e custa queries cross-shard e migração — é por último, e só quando as duas primeiras se esgotarem.
Se um cliente enorme numa única tabela causa a carga, isole esse tenant ou particione por ID de cliente.
39. Uma dependência crítica está instável. Retries, timeouts, circuit breakers?
Todos, e na ordem certa. Primeiro timeout — chamada sem timeout transforma dependência lenta em seu outage conforme threads empilham. Depois retries com backoff exponencial e jitter, só para chamadas idempotentes e poucas vezes, senão você amplia a carga em quem já está sofrendo.
Depois circuit breaker: após um limiar de falhas, pare de chamar por um tempo e sirva um fallback (cache, resposta degradada, erro amigável). Monitore o estado do breaker; breaker travado aberto é incidente por si só.
Quando a dependência instável é o provedor de pagamento, não há fallback para a cobrança; enfileire o pedido como pendente e processe depois.
40. A latência piorou após um lançamento. Como diagnosticar?
Primeiro confirme e delimite: qual percentil (p50 ou só p99), quais endpoints, qual região. Compare com a linha do tempo de deploy; se alinhou com um release, faça rollback primeiro e investigue depois.
Se rollback não resolve, siga a requisição. Traces mostram qual span cresceu. Culpados comuns: query nova sem índice, padrão N+1 por um campo novo, mudança na chave de cache que derrubou hit ratio, ou chamada downstream que era assíncrona e virou síncrona.
Se só o p99 subiu e rollback não ajudou, procure pausas de GC, vizinho barulhento ou lock.
41. Apareceu um bug de inconsistência de dados. O que checar, o que reverter?
Dimensione o dano antes de tocar em algo. Quais tabelas ou registros divergem, desde quando e ainda está acontecendo? O “desde quando” normalmente aponta para um deploy ou job.
Cheque o caminho de escrita desses registros: migrações recentes, job que rodou duas vezes, retry sem idempotência, corrida entre dois escritores. Estanque o sangramento pausando o job culpado ou revertendo o código, depois repare a partir de uma fonte de verdade (evento bruto, ledger, backup), não editando linha manualmente. Registre o que mudou e por quê.
Sem fonte de verdade para reparar, reconstrua o que der, sinalize o resto e adote o padrão de outbox para não repetir.
Erros comuns em entrevistas de system design
A maioria reprova pelos mesmos poucos motivos. Nenhum é sobre “saber menos”.
Como se preparar para entrevistas de system design
Preparação funciona quando é repetível. Eis um processo que eu realmente seguiria.
Conclusão
Cada pergunta desta lista veio de um sistema que alguém precisou construir e manter vivo às 3 da manhã; quanto mais você faz isso, menos a entrevista parece um palco e mais parece descrever sua terça-feira. Toque um side project com uma fila de verdade, entre no plantão, peça para assistir uma design review mesmo quando o design não é seu.
E se você quer uma trilha estruturada até seu próximo loop, estes mergulham mais fundo nas peças em que estas respostas se apoiam: