Câu hỏi system design xuất hiện trong nhiều buổi phỏng vấn hơn bạn nghĩ. Rõ ràng là các vị trí backend. Nhưng cũng cả hạ tầng, kỹ sư dữ liệu, và thậm chí những vị trí nặng về sản phẩm nơi chẳng ai mong bạn viết một dòng code nào trong cả vòng phỏng vấn.
Vậy thực ra người phỏng vấn đang kiểm tra điều gì? Không phải xem bạn biết kiến trúc “đúng” hay không, vì chẳng có kiến trúc nào là duy nhất đúng cả. Họ muốn thấy tư duy có cấu trúc, đánh đổi thẳng thắn, và liệu bạn có thể tiếp tục lý luận khi ràng buộc còn mơ hồ và thời gian đang trôi.
Kỳ vọng thay đổi rất nhiều theo cấp độ. Ứng viên junior đặt câu hỏi làm rõ tốt và phác thảo sơ đồ gọn gàng với vài ô là làm rất ổn. Ứng viên senior mà chỉ làm thế thì rắc rối đấy, vì ở cấp đó người ta kỳ vọng có con số, các chế độ lỗi, và quan điểm về việc nên xây phần nào trước.
Vai trò cũng quan trọng. Kỹ sư dữ liệu bị xoáy sâu vào pipeline và backfill, frontend vào cache và state, người làm infra vào rollout và phạm vi ảnh hưởng. Cùng một kỹ năng nền tảng, nhưng khác “từ vựng”.
Tôi nhấn mạnh điều này vì hầu hết danh sách câu hỏi bỏ qua cả hai chiều và chỉ đổ ra 50 đề mục. Danh sách này được tổ chức theo cấp độ trước, rồi theo vai trò, với các câu hỏi kịch bản ở cuối. Nếu phần lưu trữ trong các lời giải này còn lung lay, khóa học Database Design của chúng tôi bao quát các nền tảng cốt lõi.
Cách tiếp cận phỏng vấn System Design
Cùng một khung mỗi lần, khoảng 45 phút:
- Làm rõ (5 phút). Ai dùng, cần làm được gì, ngoài phạm vi là gì, và “tốt” trông như thế nào.
- Đưa con số (2 phút). Người dùng, số request mỗi giây, tỷ lệ đọc/ghi, tăng trưởng lưu trữ mỗi năm. Ước lượng thô thì được, im lặng là không.
- Phác thảo mức cao (10 phút). Client, lớp API, lưu trữ, cache, queue. Năm hoặc sáu ô, không hơn.
- Trình bày mô hình dữ liệu (5 phút). Bảng hoặc collection, khóa, và các pattern truy cập chúng phục vụ.
- Đào sâu một phần (10 phút). Để người phỏng vấn chọn, hoặc đề xuất phần bạn thấy thú vị nhất.
- Chế độ lỗi và đánh đổi (phần còn lại). Cái gì sẽ hỏng, bạn sẽ giám sát gì, và nếu đây là dự án thật bạn sẽ xây gì trước.
Hãy tường thuật to rõ toàn bộ. Người phỏng vấn không thể chấm điểm suy nghĩ thầm lặng.
Câu hỏi phỏng vấn System Design cho người mới bắt đầu
Những câu này kiểm tra nền tảng: làm rõ yêu cầu trước khi vẽ, tạo sơ đồ kiến trúc đơn giản, và đưa ra lựa chọn lưu trữ hợp lý. Không ai mong chờ thuật toán đồng thuận ở đây.
1. Thiết kế trình rút gọn URL
Trình rút gọn biến một URL dài thành mã ngắn và chuyển hướng khi truy cập, nên điều đầu cần chốt là liên kết có hết hạn không và bạn kỳ vọng bao nhiêu. Giả định hợp lý là 100 triệu liên kết mới mỗi tháng, với lượt đọc khoảng gấp 100 lần lượt ghi.
Tỷ lệ đọc cao định hình thiết kế: một máy chủ API, một cơ sở dữ liệu, và một cache phía trước. Với mã ngắn, hoặc mã hóa base62 một ID tự tăng (bảy ký tự cho khoảng 3,5 nghìn tỷ tổ hợp) hoặc tạo chuỗi ngẫu nhiên và kiểm tra va chạm.
Một bảng là đủ: short_code làm khóa chính, long_url, created_at, expires_at, và user_id tùy chọn. Các mã “nóng” nằm trong Redis để cơ sở dữ liệu chỉ xử lý miss. Dùng chuyển hướng 302 nếu bạn muốn phân tích lượt nhấp, vì trình duyệt sẽ cache 301 và bạn sẽ không thấy lượt truy cập lần hai.
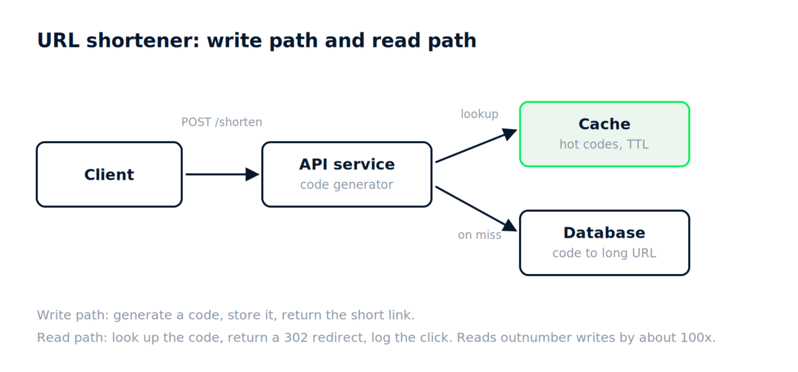
Ở mức 10 tỷ liên kết bạn shard theo mã và bộ tạo ID trở thành nút thắt cổ chai, và nếu người dùng bắt đầu đoán mã bạn chuyển từ tuần tự sang ngẫu nhiên và thêm giới hạn tốc độ.
2. Thiết kế bộ giới hạn tốc độ cơ bản
Bộ giới hạn tốc độ cho phép N request mỗi người dùng mỗi phút và trả về 429 sau ngưỡng đó. Điều đầu cần làm rõ là giới hạn theo người dùng, theo IP hay theo khóa API, vì điều đó quyết định khóa cache của bạn.
Ba thuật toán bao phủ hầu hết câu trả lời. Cửa sổ cố định đếm request trong mỗi “xô” phút, đơn giản nhưng cho phép vượt gấp đôi ở ranh giới. Cửa sổ trượt theo log lưu từng dấu thời gian, chính xác nhưng tốn bộ nhớ. Token bucket nạp đều đặn và cho phép các đợt ngắn, vì vậy nhiều gateway dùng nó.
Chạy limiter như middleware trong API gateway với bộ đếm trong Redis kèm TTL; INCR cộng EXPIRE đủ cho phiên bản cửa sổ cố định.
Với mười instance gateway bạn hoặc chia sẻ bộ đếm Redis hoặc chấp nhận đếm thừa nhẹ với bộ đếm cục bộ, và bạn nên quyết định từ đầu chuyện gì xảy ra nếu Redis chết: mở khóa và chấp nhận lạm dụng, hay đóng và chặn tất cả.
3. Thiết kế khoá trị-giá trị đơn giản
Khoá trị-giá trị cần get, put, và delete, và với câu hỏi cho người mới bắt đầu, bạn nên giữ ở một node duy nhất. Bản đồ băm trong bộ nhớ xử lý các thao tác. Để bền vững, ghi bổ sung mọi lần ghi vào log trên đĩa trước khi phản hồi, và chụp snapshot định kỳ để khi khôi phục không phải phát lại toàn bộ lịch sử.
Điều người phỏng vấn muốn nghe là bạn đã tách đường đi nhanh trong bộ nhớ khỏi đường bền trên đĩa, và bạn hiểu vì sao phải ghi log trước.
Nếu dữ liệu vượt quá bộ nhớ, câu trả lời là cây LSM, đại khái là cách RocksDB và Cassandra vận hành. Nếu cần node thứ hai, primary sao chép log sang follower, và hashing nhất quán xuất hiện khi bạn đi xa hơn nữa.
4. Thiết kế cache (khái niệm)
Cache nằm giữa ứng dụng và kho chậm hơn, và pattern cơ bản là cache-aside. Ứng dụng kiểm tra cache, miss, đọc cơ sở dữ liệu, ghi kết quả lại với TTL. Đơn giản, nhưng bạn phải tự chịu trách nhiệm logic vô hiệu hóa.
Thu hồi thường là LRU, đôi khi LFU cho tải lệch. Chỉ số quan trọng là tỷ lệ hit; dưới khoảng 80% bạn nên hỏi liệu cache có đang giúp gì không.
Điểm thú vị: dữ liệu cũ. Nếu cơ sở dữ liệu thay đổi còn bản cache thì không, người dùng sẽ thấy dữ liệu cũ cho đến khi TTL hết hạn. TTL ngắn giảm khoảng thời gian đó nhưng tăng tải lên cơ sở dữ liệu.
Khi một khóa phổ biến hết hạn và 10.000 request cùng đánh vào cơ sở dữ liệu, bạn hoặc gộp những request đó hoặc làm mới khóa trước khi nó hết hạn. Về ghi xuyên (write-through) so với ghi trả sau (write-back), write-through giữ cache đúng với cái giá là ghi chậm hơn, còn write-back nhanh nhưng mất ghi gần đây nếu cache chết trước khi flush.
5. Thiết kế dịch vụ thông báo cơ bản
Dịch vụ thông báo gửi email, SMS, và push và thử lại khi nhà cung cấp lỗi. Trước khi thiết kế, hãy hỏi về lưu lượng và liệu thứ tự giao có quan trọng không, thường là không.
Cốt lõi là một hàng đợi. Bên gửi ghi sự kiện thông báo vào đó, và một worker cho mỗi kênh kéo sự kiện và gọi nhà cung cấp như SendGrid hoặc Twilio. Cách tách này giữ phần quyết định gửi tách khỏi phần thực sự gửi, nên một nhà cung cấp SMS chậm sẽ không chặn ứng dụng.
Lưu mỗi thông báo với trạng thái (đang chờ, đã gửi, lỗi) và một khóa idempotency để sự kiện thử lại không gửi hai lần.
Người dùng muốn tắt marketing nhưng bật cảnh báo bảo mật cần một bảng tùy chọn được kiểm tra trước khi đưa vào hàng đợi, và một nhà cung cấp giới hạn 100 tin/giây cần throttling theo kênh trong worker.
6. Thiết kế dịch vụ lưu trữ tệp đơn giản
Hãy nghĩ Dropbox ở quy mô nhỏ. Người dùng tải tệp lên, nhận liên kết, tải về sau đó. Làm rõ kích thước tệp tối đa và liệu chia sẻ có quan trọng không.
Metadata (chủ sở hữu, tên tệp, kích thước, checksum, ngày tạo) lưu trong cơ sở dữ liệu quan hệ. Phần byte nằm trong lưu trữ đối tượng như S3, không bao giờ đặt trong cơ sở dữ liệu. Với upload, API trả về URL ký sẵn để client ghi trực tiếp vào lưu trữ đối tượng và máy chủ của bạn không chạm vào tệp.
Hai người dùng tải lên cùng một tệp 2 GB là bài toán khử trùng lặp giải bằng cách băm nội dung, và các tệp trên 5 GB cần upload đa phần với checksum cho từng chunk.
7. Thiết kế bảng xếp hạng trò chơi
Bảng xếp hạng phải cập nhật điểm của người chơi, trả về top 10, và trả về thứ hạng của một người chơi, và điều đầu cần hỏi là có bao nhiêu người chơi và điểm thay đổi thường xuyên cỡ nào.
Bảng quan hệ với chỉ mục trên điểm hoạt động đến một mức nào đó, nhưng “thứ hạng của tôi là bao nhiêu” trở thành một COUNT trên tất cả người ở trên bạn. Redis sorted set giải quyết điều này: ZADD để cập nhật, ZREVRANGE để lấy top N, ZREVRANK cho một người chơi, tất cả trong thời gian logarit.
Bảng theo ngày và mọi thời đại là một sorted set mỗi kỳ, đặt khóa như lb:2026-09-14. Nếu 50 triệu người chơi đẩy bộ nhớ Redis quá xa, chỉ giữ top 100k ở đó và phần còn lại trong cơ sở dữ liệu.
Câu hỏi phỏng vấn System Design mức trung cấp
Ở mức này, người phỏng vấn giả định bạn đã xây và vận hành hệ thống thực. Câu hỏi đưa vào hàng đợi, mở rộng đọc/ghi, và căng thẳng giữa độ trễ, chi phí, và tính nhất quán.
8. Thiết kế nguồn tin (news feed)
Feed cần người dùng đăng bài, theo dõi người khác, và đọc những gì họ theo dõi đã viết, theo thứ tự thời gian đảo ngược hoặc xếp hạng. Giả sử 10 triệu người dùng hoạt động hàng ngày mở nó năm lần một ngày, tương đương khoảng 600 lượt đọc mỗi giây trung bình và cao hơn nhiều ở giờ cao điểm.
Lựa chọn trung tâm là khi nào lắp ráp feed. Fan-out khi ghi đẩy mỗi bài mới vào feed được tính sẵn của từng người theo dõi, cho đọc nhanh với cái giá là ghi đắt. Fan-out khi đọc lắp ráp lúc yêu cầu, đảo ngược đánh đổi đó. Đa số hệ thống thực kết hợp: fan-out khi ghi cho người dùng thường và khi đọc cho tài khoản có hàng triệu người theo dõi.
Mô hình dữ liệu gồm posts, follows, và một danh sách feed theo người dùng trong Redis chứa ID bài viết. Phân trang bằng con trỏ trên ID bài viết thay vì offset.
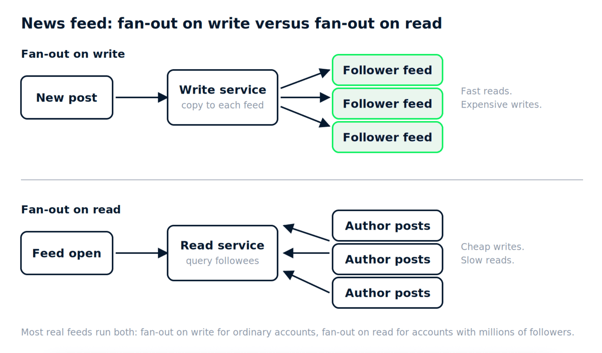
Thêm xếp hạng sau này không có nghĩa phải xây lại tất cả; bạn chấm điểm các ID ứng viên từ danh sách feed lúc đọc.
9. Thiết kế hệ thống chat đồng bộ đa thiết bị
Chat với đồng bộ đa thiết bị bao gồm nhắn tin 1-1 và nhóm, gửi đến mọi thiết bị người dùng sở hữu, và lịch sử tồn tại khi đổi điện thoại. Giả sử 50 triệu người dùng hàng ngày gửi khoảng 40 tin mỗi người, tức 2 tỷ mỗi ngày, hay khoảng 23.000 lượt ghi mỗi giây trung bình và gấp nhiều lần ở đỉnh khu vực.
Mỗi client giữ một WebSocket đến máy chủ chat, máy chủ ghi tin vào kho được phân vùng theo ID cuộc trò chuyện với số thứ tự tăng dần theo từng cuộc trò chuyện. Mỗi thiết bị nhớ số thứ tự cuối cùng đã thấy và yêu cầu mọi thứ mới hơn khi kết nối lại, đó là điều làm đồng bộ đa thiết bị hoạt động.
Kho cần thông lượng ghi cao và đọc theo phạm vi theo cuộc trò chuyện, nên cơ sở dữ liệu cột rộng như Cassandra thường là câu trả lời. Xác nhận gửi và đã đọc là các sự kiện nhỏ chảy ngược cùng đường.
Khi hai người bạn kết nối với các máy chủ chat khác nhau, hoặc pub/sub giữa các máy chủ hoặc dịch vụ định tuyến ánh xạ người dùng đến máy chủ sẽ chuyển tin. Nhóm 500 người fan-out ở phía máy chủ, và đảm bảo thứ tự trở nên khó giữ hơn.
10. Thiết kế dịch vụ ghép đôi cho gọi xe
Giữ nhẹ hơn phiên bản cho senior. Tài xế gửi vị trí vài giây một lần, hành khách yêu cầu chuyến, và dịch vụ phải trả về tài xế gần đó trong vài giây.
Cập nhật vị trí là vấn đề lưu lượng: 200.000 tài xế hoạt động, mỗi 4 giây một cập nhật tức 50.000 ghi mỗi giây. Lưu vị trí hiện tại trong bộ nhớ được đánh chỉ mục theo geohash hoặc ô H3, không phải trong bảng quan hệ. Ghép đôi nghĩa là “tìm tài xế trong ô của tôi và các ô lân cận”, xếp hạng theo ETA, và khóa một tài xế để hai hành khách không nhận cùng một xe.
Nếu tài xế nhận chuyến rồi mất kết nối, khóa sẽ hết hạn và hành khách được ghép lại. Một ô nóng ở trung tâm thành phố được chia nhỏ hơn ở khu vực dày đặc, đúng như cách chỉ mục phân cấp như H3 cung cấp.
11. Thiết kế hệ thống thu thập metrics
Hệ thống metrics nhận vài trăm chỉ số mỗi 10 giây từ hàng nghìn máy chủ và cho phép kỹ sư truy vấn trên dashboard.
Agent gom metrics theo lô và đẩy vào lớp tiếp nhận, lớp này ghi vào cơ sở dữ liệu chuỗi thời gian (hoặc một chủ đề Kafka với consumer ghi vào đó). Lưu trữ theo tầng: độ phân giải thô trong một hai ngày, tổng hợp theo phút trong một tháng, theo giờ trong một năm. Downsampling chạy như job nền.
Truy vấn đánh vào lớp tổng hợp khớp khoảng thời gian yêu cầu, giúp một biểu đồ 30 ngày không phải quét dữ liệu thô. Độ phân biệt thẻ cao (ví dụ user ID làm nhãn) sẽ “giết” cơ sở dữ liệu, nên hãy nói rõ điều đó.
Về đẩy so với kéo, Prometheus kéo, nhưng đẩy hoạt động tốt hơn qua tường lửa và cho job sống ngắn. Agent báo timestamp lạc thứ tự được chấp nhận trong một cửa sổ trễ giới hạn và bị từ chối nếu vượt, kèm bộ đếm số lần từ chối để đồng hồ lỗi hiện ra.
12. Thiết kế hệ thống gợi ý hoàn tất tìm kiếm
Autocomplete trả về top năm gợi ý trong khoảng 100 mili giây sau mỗi lần gõ phím. Làm rõ gợi ý là toàn cục hay cá nhân hóa, vì cá nhân hóa thay đổi mọi thứ.
Câu trả lời là tiền tính toán. Một pipeline offline tổng hợp log truy vấn, đếm tần suất, và xây trie (hoặc bảng tiền tố đến top-k) trong đó mỗi nút đã lưu sẵn các gợi ý tốt nhất. Lớp phục vụ sau đó chỉ cần một lần tra cứu mỗi lần gõ, và toàn bộ cấu trúc nằm gọn trong bộ nhớ qua vài bản sao.
Cập nhật diễn ra theo lô, có thể theo giờ, bằng cách xây lại cấu trúc và hoán đổi vào. Truy vấn thịnh hành có thể có một lớp “ghép chồng” thời gian thực nhỏ được trộn khi yêu cầu.
Một tiền tố như “a” sẽ chạm vào cây con khổng lồ, đó là lý do bạn lưu top-k tại mỗi nút thay vì duyệt. Lỗi gõ cần chỉ mục mờ riêng, hoặc bạn chấp nhận bỏ lỡ.
13. Thiết kế bộ lập lịch job phân tán
Bộ lập lịch job phân tán là cron cho cả công ty: định nghĩa job và lịch, chạy đúng thời điểm và nhiều nhất một lần mỗi nhịp, thử lại khi lỗi, và hiển thị đã xảy ra điều gì.
Lưu định nghĩa job và lịch trong cơ sở dữ liệu. Một dịch vụ lập lịch tính lần chạy tiếp theo cho mỗi job và đẩy job đến hạn vào hàng đợi; nhóm worker kéo và thực thi. Điểm khó là chạy đúng một instance lập lịch mỗi job mà không có điểm lỗi đơn, thường nghĩa là bầu leader (một khóa trong ZooKeeper, etcd, hoặc một hàng trong cơ sở dữ liệu có lease).
Ghi nhận mọi lần thực thi với trạng thái, thời gian bắt đầu, kết thúc, và vị trí log. Bảng đó trở thành thứ mọi người thực sự nhìn vào.
Một job chạy lâu hơn khoảng thời gian của nó nên bỏ qua, xếp hàng, hay chồng lấn, và điều đó nên cấu hình được. Khi job B phụ thuộc job A, phụ thuộc trở thành DAG, và bộ lập lịch chỉ đưa vào hàng đợi khi upstream đã thành công.
Câu hỏi phỏng vấn System Design nâng cao
Lĩnh vực cấp senior. Quy mô khổng lồ, đa vùng, mục tiêu độ tin cậy bạn có thể nêu thành con số, và chi phí của mọi quyết định. Người phỏng vấn kỳ vọng bạn chủ động nêu chế độ lỗi trước khi bị hỏi.
14. Thiết kế nền tảng phát video như YouTube
Phát video là hai hệ thống dưới một cái tên. Khi tải lên, người dùng đẩy tệp thô và pipeline chuyển mã nó thành nhiều độ phân giải và bitrate, chia thành các đoạn vài giây, và lưu các đoạn trong lưu trữ đối tượng. Khi phát, CDN phục vụ các đoạn đó và trình phát chuyển bitrate để khớp băng thông của người dùng, tức streaming thích ứng qua HLS hoặc DASH.
Nêu quy mô: hàng trăm giờ tải lên mỗi phút, hàng tỷ lượt xem mỗi ngày, lưu trữ tính bằng exabyte. Chuyển mã là bài toán song song “đáng xấu hổ”, nên một đội worker lớn kéo job từ hàng đợi. Metadata như tiêu đề, chủ sở hữu, và lượt xem nằm trong cơ sở dữ liệu sharding kèm cache nặng vì trang chủ đọc nó liên tục. Lưu trữ đối tượng và CDN edge sao chép qua nhiều vùng, và SLO quan trọng là thời gian bắt đầu phát, với tỷ lệ rebuffer là thước đo người dùng cảm nhận.
Lượt xem trên video viral là bộ đếm xấp xỉ được gom theo lô, không bao giờ là tăng trong cơ sở dữ liệu mỗi lượt xem, và đối sánh bản quyền là job fingerprint trong cùng pipeline tải lên.
15. Thiết kế nền tảng logging phân tán
Nền tảng logging nhận log từ mọi dịch vụ, cho phép tìm kiếm trong vài giây, và giữ 30 ngày nóng và một năm lạnh.
Agent theo dõi file log và chuyển đến bộ đệm bền như Kafka, thứ hấp thụ đột biến và cho phép indexer chậm lại mà không mất dữ liệu. Indexer ghi vào cụm tìm kiếm với một index mỗi ngày mỗi dịch vụ, và index cũ chuyển xuống file nén trong lưu trữ đối tượng.
Chi phí là ràng buộc thực sự, nên lập chỉ mục các trường có cấu trúc và giữ văn bản thô ở dạng rẻ. Cấp hạn ngạch cho mỗi dịch vụ, giám sát độ trễ lập chỉ mục, và loại bỏ PII ở khâu tiếp nhận.
Một dịch vụ log ở mức 100x bình thường sẽ lần lượt bị áp hạn ngạch, lấy mẫu, loại bỏ, và cảnh báo. Truy vấn xuyên vùng nghĩa là tìm kiếm liên kết, với mỗi vùng sở hữu dữ liệu của chính nó.
16. Thiết kế hệ thống phân tích thời gian thực
Phân tích thời gian thực nghĩa là dashboard hiển thị tổng hợp trong vài phút gần nhất, cập nhật trong vòng vài giây, trên dòng sự kiện có thể lên đến hàng triệu sự kiện mỗi giây.
Bộ xử lý dòng như Flink duy trì các tổng hợp theo cửa sổ, ví dụ đếm theo phút theo chiều, và ghi chúng vào kho đọc nhanh như ClickHouse hoặc Druid. Dashboard truy vấn kho đó, không bao giờ là dòng thô.
Nêu các đánh đổi: đếm chính xác so với HyperLogLog cho người dùng duy nhất, cửa sổ “rơi tự do” (tumbling) so với trượt (sliding), và watermark cho sự kiện đến muộn. Đặt SLO về độ “tươi” và giám sát độ trễ bộ xử lý so với nó.
Một chiều có độ phân biệt cao như user ID sẽ làm nổ bảng tổng hợp, nên hãy truy vấn sự kiện thô cho chiều đó. Backfill sau lỗi nghĩa là phát lại từ dòng với offset được giữ lại.
17. Thiết kế hệ thống thanh toán
Thanh toán là thiết kế mà tính đúng đắn vượt trên quy mô. Hệ thống phải thu tiền khách, ghi nhận, không bao giờ thu hai lần, không bao giờ mất bản ghi, và đối soát với ngân hàng hằng ngày.
Idempotency gánh phần lớn điều đó: mọi yêu cầu có một khóa, và dịch vụ lưu kết quả gắn với nó và trả cùng kết quả khi thử lại. Dòng tiền di chuyển qua sổ cái bút toán kép chỉ-ghi nơi các bút toán của mỗi giao dịch có tổng bằng không, trong cơ sở dữ liệu quan hệ với mức cô lập serializable. Đây là chỗ mà “nhất quán cuối cùng” là câu trả lời sai.
Gọi mạng thẻ có thể timeout mơ hồ, nên các khoản thu có trạng thái chờ và job đối soát sẽ quyết toán chúng. Đa vùng nghĩa là một vùng nhà cho mỗi tài khoản, không bao giờ active-active ghi trên cùng số dư.
Đa tiền tệ nghĩa là số nguyên theo đơn vị nhỏ kèm mã tiền tệ, và hoàn tiền đến trước khi khoản thu được quyết toán được xử lý bởi máy trạng thái với chuyển tiếp rõ ràng.
18. Thiết kế hệ thống nhắn tin quy mô lớn
Hệ thống nhắn tin quy mô lớn cho phép producer xuất bản và consumer đăng ký, sống sót qua việc broker khởi động lại, và giữ thứ tự nơi cần, ở mức hàng triệu thông điệp mỗi giây.
Phân vùng mỗi chủ đề để thông điệp có cùng khóa rơi vào cùng phân vùng, điều đó cho thứ tự theo khóa mà không cần thứ tự toàn cục. Mỗi phân vùng là log chỉ-ghi được sao chép sang vài broker, và consumer cam kết offset sau khi xử lý.
Mặc định giao hàng ít nhất một lần với consumer idempotent. Thử lại đi qua chủ đề retry với backoff và thông điệp độc hại đến dead-letter queue. Độ trễ consumer là tín hiệu để đặt SLO, và xuyên vùng, một vùng sở hữu quyền ghi theo khóa nếu không hai vùng sẽ làm đảo lộn thứ tự của nhau.
Một consumer crash sau khi xử lý nhưng trước khi cam kết sẽ tạo bản trùng, đó là lý do idempotency quan trọng. Bão tái phân bổ được thuần hóa bằng gán “bám dính” và tái phân bổ hợp tác.
Câu hỏi phỏng vấn System Design cho Kỹ sư Backend
Tập trung vào API, mô hình dữ liệu, và ranh giới dịch vụ. Hãy chờ các câu hỏi mở rộng về tính nhất quán, cache, và bạn sẽ log những gì.
19. Thiết kế dịch vụ xác thực và phân quyền
Authentication trả lời “bạn là ai” và authorization trả lời “bạn được làm gì,” và người phỏng vấn thích ứng viên tách bạch hai thứ đó.
Dùng OAuth 2.0 và OpenID Connect thay vì tự nghĩ ra giao thức. Cấp token truy cập ngắn hạn và token làm mới dài hạn được lưu phía máy chủ để bạn có thể thu hồi. Quyền nằm trong mô hình vai trò được kiểm tra bởi thư viện nhỏ hoặc dịch vụ policy. Log mọi lần đăng nhập, làm mới, và từ chối kèm IP và thiết bị, và không bao giờ log bản thân token.
JWT tránh tra cứu mỗi request, nhưng thu hồi sớm nghĩa là danh sách chặn, điều này lại đưa tra cứu quay về. Credential stuffing được làm chậm bằng giới hạn tốc độ theo IP và theo tài khoản, trì hoãn sau nhiều lần thất bại, và yếu tố thứ hai cho đăng nhập đáng ngờ.
20. Thiết kế API gateway
API gateway là điểm vào duy nhất trước các dịch vụ của bạn xử lý công việc cắt ngang để mỗi dịch vụ không phải làm: định tuyến theo đường dẫn và phiên bản, chấm dứt TLS, xác thực, giới hạn tốc độ, và log request.
Bản thân gateway nên stateless và mở rộng ngang sau load balancer. Cấu hình định tuyến sống trong control plane và được đẩy đến các instance gateway, để bạn không bao giờ phải redeploy gateway chỉ để thêm một route. Token xác thực được kiểm tra một lần ở rìa và gateway chuyển tiếp danh tính người dùng như một header.
Phạm vi ảnh hưởng là điều cần nói rõ. Gateway nằm trên mọi đường request, nên một lần đẩy cấu hình tệ có thể hạ gục tất cả; hãy kiểm tra hợp lệ cấu hình, rollout dần dần, và giữ logic của chính gateway thật mỏng.
Versioning mà không làm hỏng ứng dụng di động bạn không thể cập nhật nghĩa là versioning theo đường dẫn hoặc header với phiên bản cũ được giữ sống. Và gateway không nên tổng hợp phản hồi từ nhiều dịch vụ; việc đó thuộc lớp backend-for-frontend.
21. Thiết kế hệ thống đơn hàng cho trang thương mại điện tử
Hệ thống đơn hàng tạo đơn, giữ chỗ tồn kho, thu tiền, giao hàng, và cho khách xem trạng thái. Đơn hàng là một máy trạng thái (created, paid, packed, shipped, delivered, cancelled), và các chuyển tiếp được phép nên được nêu rõ.
Tạo đơn là một POST với khóa idempotency để nhấp đúp không tạo hai đơn. Giữ chỗ tồn kho và thanh toán liên quan các dịch vụ khác, nên dùng saga: mỗi bước phát một sự kiện, và thất bại kích hoạt hành động bù (nhả tồn kho, hoàn tiền). Ghi sự kiện vào bảng outbox trong cùng giao dịch với cập nhật đơn để cơ sở dữ liệu và bus thông điệp không bao giờ bất đồng.
Ở phía đọc, một bảng orders cộng bảng order_items, với tổng hợp đơn được vật hóa và cache cho trang “đơn hàng của tôi”.
Hai khách cùng mua đơn vị cuối cùng cùng lúc được giải quyết bằng khóa hàng hoặc giảm tồn kho nguyên tử, với một người nhận thông báo hết hàng. Thứ cần giám sát là đơn hàng kẹt ở một trạng thái lâu hơn kỳ vọng.
22. Thiết kế dịch vụ cờ tính năng (feature flag)
Dịch vụ cờ tính năng bật/tắt tính năng theo môi trường, nhắm mục tiêu theo thuộc tính người dùng hoặc theo phần trăm, và lật cờ toàn cầu trong vài giây khi có sự cố.
Định nghĩa cờ và luật nhắm mục tiêu nằm trong cơ sở dữ liệu nhỏ phía sau admin API. Ứng dụng nhúng SDK tải tất cả cờ khi khởi động, cache cục bộ, và đánh giá luật trong tiến trình, nên kiểm tra cờ không tốn gì lúc request. Cập nhật được truyền qua kết nối streaming hoặc thăm dò ngắn, và SDK giữ trạng thái cuối cùng biết được nếu dịch vụ cờ sập.
Đánh giá rollout theo phần trăm bằng băm ổn định của user ID và khóa cờ, để cùng một người dùng luôn rơi về cùng một phía.
Cờ lỗi thời được phát hiện bằng cách theo dõi timestamp lần đánh giá gần nhất và nhắc chủ sở hữu, và nếu dịch vụ cờ sập khi khởi động, ứng dụng quay về mặc định đóng gói trong code.
23. Thiết kế API phục vụ gợi ý (recommendation)
API gợi ý trả về 20 mục cho một người dùng trong dưới 100 mili giây ở vài nghìn request mỗi giây, và không cần ML chuyên sâu để thiết kế.
Tách offline và online. Job offline tính danh sách ứng viên theo người dùng vào kho khóa-giá trị độ trễ thấp. API online lấy các danh sách đó, xếp hạng lại với vài đặc trưng mới như tình trạng còn hàng, lọc những gì người dùng đã mua, và trả về danh sách. Giữ phương án dự phòng là các mục phổ biến theo danh mục, và log mọi danh sách đã phục vụ với ID request để sau này ghép với lượt nhấp.
Người dùng mới nhận phương án dự phòng cho đến khi có vài tương tác. 100 mili giây chia đại khái thành 10 cho truy xuất, 30 cho xếp hạng lại, 10 cho tuần tự hóa, và 50 dự phòng.
Câu hỏi phỏng vấn System Design cho Hạ tầng / DevOps
Độ tin cậy, triển khai, tự động hóa, và khả năng quan sát. Chủ đề lặp lại: bạn thay đổi an toàn thế nào và biết nhanh khi mình sai.
24. Thiết kế pipeline CI/CD cho microservices
Pipeline CI/CD cho microservices phải xử lý hàng chục dịch vụ triển khai độc lập với test, kiểm tra bảo mật, và con đường lên production không cần người dậy lúc 3 giờ sáng.
Build một lần, triển khai cùng artifact ở mọi nơi. Pipeline lint, chạy unit test, build ảnh container gắn thẻ bằng commit SHA, quét bảo mật, và đẩy vào registry. Triển khai sau đó thăng cấp ảnh qua các môi trường (dev, staging, production) dùng cấu hình thay vì build lại.
Triển khai production nên tiến triển: canary cho vài phần trăm lưu lượng, theo dõi tỷ lệ lỗi và độ trễ trong cửa sổ xác định, rồi tiếp tục hoặc rollback tự động. Rollback nghĩa là triển khai lại thẻ ảnh trước đó, nhanh vì bạn không bao giờ build lại.
Khi thay đổi của dịch vụ A phá vỡ hợp đồng của dịch vụ B, cách khắc phục là test hợp đồng trong CI và thay đổi API tương thích ngược. Monorepo so với nhiều repo ít quan trọng hơn mọi người nghĩ, miễn pipeline chỉ build phần thay đổi.
25. Thiết kế giám sát và cảnh báo tập trung
Giám sát tập trung đưa metrics, logs, và traces từ mọi dịch vụ vào một nơi, với cảnh báo chỉ đánh thức người khi người dùng bị ảnh hưởng.
Metrics chảy vào kho chuỗi thời gian, logs vào nền tảng ở câu 15, traces vào backend tracing, tất cả được liên kết bởi một request ID chung. Quyết định thiết kế quan trọng là bạn cảnh báo về điều gì. Cảnh báo về triệu chứng (tỷ lệ lỗi, bách phân vị độ trễ, độ bão hòa) gắn với SLO, không phải về nguyên nhân như “CPU 80%”.
Mệt mỏi vì bị gọi trực đêm giết chết ca trực, nên mỗi cảnh báo cần runbook và rà soát. Bất cứ thứ gì gọi hai lần trong một tuần mà không có hành động rõ ràng sẽ bị hạ xuống thành ticket.
SLO cho dịch vụ hoàn toàn mới đến từ đo lường vài tuần rồi đặt mục tiêu tốt hơn hiện tại đôi chút. Và khi chính hệ thống giám sát sập, kiểm tra tổng hợp bên ngoài và cảnh báo “người chết” là thứ cho bạn biết.
26. Thiết kế phương án quản lý bí mật
Quản lý bí mật giúp mật khẩu cơ sở dữ liệu, khóa API, và chứng chỉ sẵn sàng cho dịch vụ lúc chạy, không bao giờ nằm trong mã nguồn, được xoay vòng thường xuyên, và có nhật ký kiểm tra.
Kho bí mật trung tâm (HashiCorp Vault, secrets manager của nhà cung cấp đám mây) giữ mọi thứ. Dịch vụ xác thực với nó bằng danh tính workload của mình (tài khoản dịch vụ Kubernetes, vai trò IAM), không bao giờ bằng token sống lâu, và lấy bí mật khi khởi động hoặc theo yêu cầu. Ưu tiên bí mật động khi có thể: kho tạo thông tin xác thực cơ sở dữ liệu hợp lệ trong một giờ, và việc xoay vòng diễn ra “miễn phí”.
Ghi log kiểm toán mọi lần đọc. Và luôn có một lối thoát khẩn cấp được lập thành tài liệu khi chính kho bí mật gặp sự cố, vì điều đó sẽ xảy ra.
Một khóa mà nhà phát triển vô tình commit sẽ bị phát hiện bởi quá trình quét trong CI, được xoay vòng ngay lập tức và vẫn được coi là đã bị lộ. Bí mật trong biến môi trường thì phổ biến nhưng có thể rò rỉ qua crash dump và tiến trình con, vì vậy hãy mount chúng dưới dạng tệp hoặc truy xuất trong tiến trình.
27. Thiết kế autoscaling và chiến lược rollout
Autoscaling và rollout kết hợp phải giúp một dịch vụ xử lý biến động lưu lượng hằng ngày gấp 5 lần mà không cần can thiệp thủ công, trong khi vẫn triển khai vài lần mỗi ngày.
Scale dựa trên tín hiệu phản ánh đau đớn của người dùng, thường là tốc độ yêu cầu hoặc độ trễ trên mỗi instance, thay vì chỉ CPU. Đặt số bản sao tối thiểu để khởi động lạnh không gặp ngay đột biến, và số tối đa để một lỗi không khiến bạn phá sản. Scale lên nhanh và scale xuống từ tốn.
Với rollout, dùng blue/green khi bạn cần chuyển đổi tức thì và rollback tức thì, và canary khi bạn muốn quan sát lưu lượng thực trên một phần nhỏ trước. Kết hợp canary với autoscaler một cách thận trọng, vì một canary scale độc lập có thể làm sai lệch phép so sánh.
Nếu scale chậm hơn đột biến bất ngờ hai phút, thì scale dự đoán theo lịch hoặc mức tối thiểu cao hơn sẽ bù khoảng trống đó. Và 50 instance mới làm cạn kiệt kết nối cơ sở dữ liệu là lý do pooling kết nối nên nằm ở lớp proxy.
Câu hỏi phỏng vấn thiết kế hệ thống cho Data Engineer
Pipeline, định dạng lưu trữ, batch so với streaming, và liệu dữ liệu có đáng tin cậy hay không. Khung tư duy như trước, nhưng kịch bản lỗi là mất, trùng lặp hoặc dữ liệu đến muộn thay vì mất yêu cầu.
28. Thiết kế pipeline thu nhận sự kiện
Một pipeline thu nhận sự kiện lấy các sự kiện hành vi từ khách hàng web và di động và biến chúng thành truy vấn được trong vòng một giờ. Giả định 50.000 sự kiện mỗi giây ở đỉnh, với client có thể ngoại tuyến và retry.
Client gom sự kiện qua một SDK và post tới dịch vụ collector, nơi xác thực theo một registry schema và ghi vào stream (Kafka hoặc dịch vụ quản lý tương đương). Một consumer đổ sự kiện thô vào object storage được phân vùng theo giờ, ở định dạng cột như Parquet. Các job downstream đọc từ đó.
Retry dẫn đến trùng lặp, nên mỗi sự kiện mang một UUID do client tạo và job đổ dữ liệu sẽ khử trùng trong một cửa sổ. Thay đổi schema phải đi qua registry với kiểm tra tương thích, vì ứng dụng di động phiên bản cũ sẽ tiếp tục gửi dữ liệu theo cấu trúc cũ trong nhiều tháng.
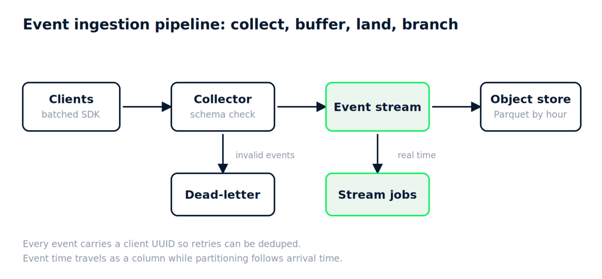
Một sự kiện có timestamp từ ba ngày trước sẽ được ghi theo thời gian đến, giữ thời gian sự kiện như một cột, và để downstream quyết định. Sự kiện lỗi đi vào đường dead-letter và không bao giờ bị bỏ qua trong im lặng.
29. Thiết kế hệ thống ETL streaming
Streaming ETL biến đổi sự kiện ngay khi chúng đến, join với dữ liệu tham chiếu, và ghi kết quả vào kho phục vụ trong vài giây.
Một bộ xử lý stream đọc từ topic thu nhận, áp dụng biến đổi, và làm giàu với dữ liệu tham chiếu được nạp vào bộ nhớ và làm mới định kỳ. State (cho join theo cửa sổ hoặc tổng hợp) checkpoint tới lưu trữ bền vững để job bị crash có thể tiếp tục mà không phải xử lý lại từ đầu.
Sự đánh đổi mà nhà phỏng vấn muốn nghe: exactly-once so với at-least-once. Exactly-once có thể đạt được end-to-end nếu sink hỗ trợ giao dịch hoặc ghi idempotent, nhưng phải trả giá bằng độ trễ và độ phức tạp. At-least-once với sink idempotent mang lại phần lớn lợi ích.
Dữ liệu đến muộn được xử lý bằng watermark và một khoảng ân hạn xác định, sau đó đưa vào bảng late-arrivals.
Dữ liệu tham chiếu thay đổi giữa dòng nên được version hóa, với join dựa trên phiên bản hợp lệ tại thời điểm sự kiện. Một lần backfill sau sáu tháng khi sửa logic sẽ phát lại từ lưu trữ thô theo batch, không đi qua luồng stream.
30. Thiết kế kho dữ liệu và phương pháp modeling
Một warehouse phải mang đến cho nhà phân tích và dashboard các chỉ số nhất quán trên dữ liệu bán hàng, marketing và sản phẩm, đồng thời bảo toàn lịch sử.
Đưa dữ liệu thô nguyên vẹn vào lớp bronze, làm sạch và chuẩn hóa ở lớp silver, và xây dựng các bảng phục vụ nghiệp vụ ở lớp gold. Mô hình hóa lớp gold theo star schema: bảng fact ở mức hạt mịn hữu ích nhất (ví dụ một dòng cho mỗi dòng đơn hàng) và bảng dimension cho khách hàng, sản phẩm, ngày tháng. Dimension thay đổi chậm nhận xử lý Type 2 khi lịch sử quan trọng, để việc thay đổi vùng của khách hàng không ghi đè doanh thu năm ngoái.
Partition các bảng fact lớn theo ngày, cluster theo các cột thường được lọc, và giữ các biến đổi trong version control (dbt hoặc tương đương) kèm kiểm thử.
Khi hai nhóm định nghĩa “khách hàng hoạt động” khác nhau, một lớp metrics với một định nghĩa bắt buộc duy nhất sẽ giải quyết. Một fact đến muộn tham chiếu tới khóa dimension chưa có sẽ nhận một dòng dimension tạm và được backfill sau.
31. Thiết kế feature store
Một feature store tính toán feature một lần và tái sử dụng cho cả huấn luyện mô hình lẫn dự đoán online, tránh lệch giữa huấn luyện/phục vụ, và phần này giữ ở mức cao. Nó là hai kho với một định nghĩa: kho offline (warehouse hoặc lake) giữ lịch sử feature để xây tập huấn luyện, và kho online (Redis, DynamoDB) giữ giá trị mới nhất trên mỗi thực thể cho tra cứu độ trễ thấp lúc dự đoán.
Một định nghĩa feature duy nhất điều khiển cả hai, và một job materialize từ offline sang online theo lịch.
Khái niệm then chốt là tính đúng theo thời điểm. Khi bạn xây tập huấn luyện, mỗi dòng phải dùng giá trị feature như chúng tồn tại tại timestamp của dòng đó, không phải giá trị hiện tại. Nếu không, mô hình của bạn học từ tương lai và trông tuyệt cho đến khi đưa vào sản xuất.
Một feature tốn kém để tính theo thời gian thực sẽ được tính trước với chút độ cũ hoặc tính khi ghi. Để biết giá trị online và offline khớp nhau, hãy lấy mẫu và so sánh, và log các feature bạn thực sự đã phục vụ.
32. Thiết kế lớp chất lượng dữ liệu và truy xuất nguồn gốc
Một lớp chất lượng dữ liệu và truy xuất nguồn gốc phát hiện dữ liệu hỏng trước khi dashboard làm vậy và trả lời “cột này đến từ đâu” mà không cần đọc code.
Các kiểm tra chất lượng chạy như những bước trong pipeline: đếm số dòng so với phạm vi kỳ vọng, tỷ lệ null, độ tươi (phân vùng có hạ cánh đúng giờ không), và một vài ràng buộc nghiệp vụ (doanh thu không bao giờ âm). Lỗi sẽ chặn các job downstream và cảnh báo chủ sở hữu. Lưu kết quả kiểm tra theo thời gian để bạn thấy được trôi dạt, không chỉ là đạt hay trượt hôm nay.
Nguồn gốc được ghi nhận từ chính mã biến đổi (phân tích SQL, hoặc metadata của công cụ điều phối) và lưu dưới dạng đồ thị: bảng đến bảng, cột đến cột nếu có thể. Đồ thị đó cung cấp phân tích tác động khi ai đó muốn bỏ một cột.
Nếu kiểm tra lâu hơn pipeline, hãy lấy mẫu, hoặc chạy các kiểm tra nặng theo cách bất đồng bộ và cảnh báo thay vì chặn. Truy xuất nguồn gốc giữa các công cụ không nói chuyện với nhau nghĩa là dùng OpenLineage hoặc chú giải thủ công, với các lỗ hổng được ghi tài liệu.
Câu hỏi phỏng vấn thiết kế hệ thống cho Frontend / Full-Stack
Hiệu năng phía client, quản lý trạng thái, caching, và cách trình duyệt nói chuyện với API. Những kiến thức bảo mật cơ bản cũng xuất hiện ở đây.
33. Thiết kế kiến trúc cho web app lưu lượng cao
Web app lưu lượng cao ở đây nghĩa là một trang nặng nội dung với hàng triệu lượt truy cập mỗi ngày, first paint nhanh, và các phần cá nhân hóa cho người dùng đăng nhập.
Tài sản tĩnh đưa lên CDN với thời gian cache dài và tên tệp băm. Các trang giống nhau với mọi người được render phía server và cache ở edge; các phần cá nhân hóa tải phía client sau khi shell hiển thị. Cách lai này giữ TTFB thấp mà không phục vụ dữ liệu cá nhân cũ.
Các cuộc gọi API từ client đi qua gateway với token sống ngắn. Đặt header cache một cách có chủ đích: Cache-Control với stale-while-revalidate cho nội dung có thể cũ vài giây, no-store cho bất kỳ thứ gì cá nhân.
Với một dashboard phía sau đăng nhập, render phía client thường là ổn, vì SSR không mang lại nhiều nếu không có SEO. Và một khóa cache vô tình bao gồm cookie phiên sẽ khiến mọi người có bản riêng của họ, làm tỷ lệ hit sụt giảm.
34. Thiết kế đồng bộ ưu tiên ngoại tuyến (offline-first)
Offline-first sync nghĩa là một ứng dụng ghi chú hoặc thu thập dữ liệu hiện trường hoạt động không cần kết nối và đồng bộ khi trở lại, mà không mất chỉnh sửa của ai.
Mọi ghi sẽ vào kho cục bộ trước (IndexedDB, SQLite trên di động) và vào một hàng đợi mutation đang chờ. Khi kết nối trở lại, client đẩy hàng đợi theo thứ tự và kéo các thay đổi kể từ token đồng bộ cuối. Mỗi mutation mang ID client và số thứ tự để server có thể khử trùng lặp.
Xung đột là toàn bộ vấn đề. Last-write-wins thì đơn giản nhưng làm mất dữ liệu. Gộp ở mức trường xử lý được hầu hết trường hợp.
CRDT cung cấp tự động hợp nhất cho văn bản và danh sách với cái giá là độ phức tạp, và tôi chỉ dùng khi cộng tác thời gian thực là yêu cầu thật sự.
Một người dùng chỉnh sửa trên hai thiết bị khi ngoại tuyến và đưa cả hai trở lại sẽ có cả hai chỉnh sửa được áp dụng, xung đột được gắn cờ, và UI hiển thị điều đó. Một hàng đợi chờ lên tới 10.000 mutation nên được nén gọn, để mười lần sửa một trường thành một.
35. Thiết kế cập nhật UI thời gian thực
Cập nhật UI thời gian thực nghĩa là một dashboard hoặc khung chat phản ánh thay đổi phía server trong vòng một giây cho hàng nghìn người dùng đồng thời.
Chọn kênh truyền theo hướng dữ liệu. Server-Sent Events khi dữ liệu chỉ chảy từ server tới client (tỉ số trực tiếp, thông báo); WebSocket khi client cũng gửi nhiều (chat, cộng tác biên tập). Long polling là phương án dự phòng khi mạng chặn cả hai.
Trên server, một lớp pub/sub phân tán thay đổi đến máy chủ kết nối nào đang giữ người dùng. Trên client, xử lý kết nối lại với backoff và tiếp tục từ ID sự kiện cuối để việc rơi kết nối không làm mất cập nhật. Tiết chế việc render: 50 cập nhật mỗi giây cho một biểu đồ nên gộp thành vài lần vẽ lại, không phải 50.
100.000 người dùng theo dõi một sự kiện trực tiếp là fan-out phía server, có thể qua một CDN hỗ trợ streaming. Xác thực một WebSocket nghĩa là dùng token trong bắt tay ban đầu, được xác thực lại định kỳ.
36. Thiết kế kế hoạch hiệu năng phía client cho dashboard
Mục tiêu là một dashboard phân tích với 20 biểu đồ tải dưới ba giây và vẫn mượt khi lọc.
Đừng fetch 20 biểu đồ cùng lúc. Tải những biểu đồ đang hiển thị trước, lazy-load phần còn lại khi cuộn, và hiển thị skeleton thay vì spinner. Tổng hợp trước trên server để client chỉ nhận vài trăm dòng mỗi biểu đồ, không bao giờ là sự kiện thô.
Cache kết quả truy vấn trong bộ nhớ với khóa theo trạng thái bộ lọc, để bật tắt bộ lọc qua lại không phải refetch.
Bảng có hàng nghìn dòng cần virtual hóa (chỉ render phần đang hiển thị). Các tính toán nặng chuyển sang web worker để main thread rảnh cho tương tác.
Nếu API chậm và bạn không thể thay đổi nó, hãy cache tích cực, hiển thị dữ liệu cũ với timestamp, và làm mới ở nền. Lỗi CORS khi dashboard gọi một API mới nghĩa là API phải cho phép origin của dashboard, và bạn nên có thể giải thích các preflight request.
Câu hỏi phỏng vấn thiết kế hệ thống theo kịch bản
Những câu này kiểm tra phán đoán hơn là kiến trúc. Yêu cầu thay đổi, sản xuất gặp sự cố, và người phỏng vấn muốn xem bạn xử lý ưu tiên thế nào.
37. Lưu lượng tăng 10 lần qua đêm. Thay đổi gì đầu tiên?
Bắt đầu với thứ vỡ đầu tiên, và hiếm khi là tầng stateless. Autoscaling xử lý web server; cơ sở dữ liệu, cache, và bất kỳ giới hạn tốc độ từ bên thứ ba nào mới là nơi sập.
Ngay lập tức, kiểm tra các chỉ số bão hòa (kết nối, CPU, độ sâu hàng đợi) cho cơ sở dữ liệu và cache, nâng trần autoscaler, và bật mọi cơ chế giảm tải bạn có, như bỏ các tính năng không quan trọng hoặc phục vụ trang đã cache. Trong một ngày, thêm bản sao đọc, tinh chỉnh tỷ lệ hit cache, và tìm các truy vấn chi phối. Dài hạn, làm công việc sharding và xếp hàng mà bạn đã trì hoãn.
Phân biệt tăng trưởng thực với bot dựa vào mẫu yêu cầu, user agent, và liệu chuyển đổi có tăng không.
38. Bạn chạm giới hạn đọc của cơ sở dữ liệu. Cache, replica, hay sharding?
Theo thứ tự đó, thường là vậy. Một cache trước các lượt đọc nóng nhất rẻ và có thể giảm tải cơ sở dữ liệu một nửa trong một ngày; kiểm tra tỷ lệ hit và log truy vấn để xác nhận các lượt đọc thực sự lặp lại.
Replica đọc là bước tiếp theo khi tập đọc rộng thay vì nóng. Chúng thêm độ trễ sao chép, nên mọi đường đọc-sau-ghi (người dùng lưu và thấy thay đổi ngay) cần đi tới primary. Sharding giải quyết giới hạn ghi hơn là giới hạn đọc và khiến bạn phải trả giá bằng truy vấn xuyên shard và một cuộc di trú, nên để cuối, và chỉ khi hai cách đầu đã cạn.
Nếu một khách hàng khổng lồ trên một bảng đơn gây tải, hãy cô lập tenant đó hoặc partition theo ID khách hàng.
39. Một phụ thuộc downstream quan trọng chập chờn. Retry, timeout, circuit breaker?
Tất cả, và theo đúng thứ tự. Đầu tiên là timeout, vì một lời gọi không có timeout biến một phụ thuộc chậm thành sự cố của chính bạn khi luồng tích lại. Sau đó retry với exponential backoff và jitter, nhưng chỉ cho lời gọi idempotent và chỉ vài lần, nếu không bạn khuếch đại tải lên một dịch vụ vốn đã vật lộn.
Tiếp theo là circuit breaker: sau một ngưỡng lỗi, dừng gọi một thời gian và phục vụ phương án thay thế (dữ liệu đã cache, phản hồi suy giảm, lỗi thân thiện). Giám sát trạng thái breaker; một breaker kẹt ở trạng thái mở cũng là một sự cố.
Khi phụ thuộc chập chờn là nhà cung cấp thanh toán của bạn, không có phương án thay thế cho thao tác trừ tiền; hãy xếp hàng đơn hàng ở trạng thái chờ và xử lý sau.
40. Độ trễ tăng sau khi ra mắt. Bạn chẩn đoán thế nào?
Trước hết, xác nhận nó là thật và phạm vi: phần trăm nào tăng (p50 hay chỉ p99), endpoint nào, vùng nào. So sánh với timeline triển khai; nếu trùng với bản phát hành, rollback trước và điều tra sau.
Nếu rollback không phải câu trả lời, theo dõi yêu cầu. Trace cho thấy span nào dài ra. Thủ phạm thường gặp: truy vấn mới thiếu index, mẫu N+1 do một field mới, khóa cache thay đổi làm tụt tỷ lệ hit, hoặc một lời gọi downstream trước đây là async nay nằm trên đường yêu cầu.
Nếu chỉ p99 tăng và rollback không giúp, hãy tìm pause do garbage collection, noisy neighbor, hoặc khóa.
41. Xuất hiện lỗi bất nhất dữ liệu. Bạn kiểm tra gì, rollback gì?
Khoanh vùng thiệt hại trước khi động vào bất cứ thứ gì. Bảng hay bản ghi nào bất đồng, từ khi nào, và có còn xảy ra không? Câu trả lời “từ khi nào” thường trỏ tới một lần deploy hoặc một job đã chạy.
Kiểm tra đường ghi của các bản ghi bị ảnh hưởng: migration gần đây, một job chạy hai lần, retry không idempotent, cuộc đua giữa hai bên ghi. Chặn chảy máu bằng cách tạm dừng job gây lỗi hoặc rollback code, rồi sửa từ nguồn sự thật (log sự kiện thô, sổ cái, bản sao lưu) thay vì chỉnh tay các dòng. Ghi lại những gì bạn đã thay đổi và lý do.
Khi không có nguồn sự thật để sửa, hãy khôi phục những gì có thể, gắn cờ phần còn lại, và thêm mẫu outbox để tránh lặp lại.
Lỗi thường gặp trong phỏng vấn thiết kế hệ thống
Hầu hết ứng viên thất bại vì cùng một vài lý do. Không lý do nào là do biết ít hơn.
- Bỏ qua câu hỏi làm rõ. Nhảy thẳng vào vẽ hộp nghĩa là bạn có thể giải sai vấn đề trong 40 phút.
- Không có con số. "Cần phải scale" không có ý nghĩa. 5.000 lượt ghi mỗi giây và 2 TB một năm thì có, và nó thay đổi thiết kế.
- Một kiến trúc hoàn hảo duy nhất. Người phỏng vấn muốn nghe "Tôi chọn X vì Y, và cái giá là Z." Một câu trả lời tự tin duy nhất không có đánh đổi nghe như học thuộc.
- Microservices quá sớm. Một monolith với ranh giới tốt là câu trả lời ổn cho hầu hết câu hỏi cơ bản và trung cấp. Tách thành 12 dịch vụ trên bảng vẽ thêm các chế độ lỗi mà giờ bạn phải bảo vệ.
- Bỏ qua vận hành. Triển khai thế nào, bạn giám sát gì, điều gì xảy ra khi một node chết. Người phỏng vấn senior sẽ hỏi, và junior được cộng điểm nếu chủ động nêu ra.
- Quên mô hình dữ liệu. Hộp và mũi tên mà không biết trong bảng có gì. Cái này đặc biệt đắt với vai trò dữ liệu.
- Im lặng. Nghĩ thầm hai phút là cả một thế kỷ với người phỏng vấn. Hãy tường thuật, dù chỉ là "Tôi đang cân nhắc hai phương án ở đây."
Cách chuẩn bị cho phỏng vấn thiết kế hệ thống
Chuẩn bị hiệu quả khi có thể lặp lại. Đây là một quy trình mà tôi thực sự sẽ làm theo.
- Dùng cùng một cấu trúc mỗi lần. Sáu bước từ đầu bài viết này, theo đúng thứ tự, cho mọi câu hỏi bạn luyện tập. Viết chúng lên thẻ và tập đến khi trình tự trở nên tự động và bạn không tốn sự tập trung cho “bước tiếp theo là gì”.
- Làm phỏng vấn thử có bấm giờ. Rủ một người bạn, đồng nghiệp, hoặc chỉ là máy ghi âm, và chạy 45 phút nói to với ai đó ngắt lời bạn bằng câu hỏi phụ. Vài lần đầu sẽ gập ghềnh, và đó là mục đích.
- Xây một mẫu thiết kế. Một tờ cheat sheet liệt kê các mẫu bạn hay dùng: cache-aside, hàng đợi để tách rời, pub/sub cho fan-out, CQRS khi đọc và ghi khác biệt, sharding theo khóa, outbox để đảm bảo nhất quán giữa cơ sở dữ liệu và bus. Ôn nó trước mỗi buổi.
- Luyện giải thích đánh đổi, không chỉ vẽ. Với mỗi mẫu trên tờ đó, hãy có thể nói trong một câu nó mang lại gì và cái giá là gì. Câu đó phân biệt giữa đạt và đạt xuất sắc.
- Theo cấp độ và vai trò. Chọn năm câu hỏi theo cấp của bạn và bốn câu theo vai trò của bạn trong danh sách này, và luyện chúng đàng hoàng thay vì lướt cả 41 câu. Nếu các câu hỏi về pipeline dữ liệu còn lạ lẫm, Introduction to Data Engineering và Streaming Concepts sẽ bao quát hệ thuật ngữ mà các câu trả lời đó dựa vào.
Kết luận
Mỗi câu hỏi trong danh sách này đến từ một hệ thống mà ai đó đã phải xây và rồi giữ nó sống lúc 3 giờ sáng, nên bạn làm việc đó càng nhiều, buổi phỏng vấn càng bớt giống một màn trình diễn và càng giống việc mô tả ngày thứ Ba của bạn. Chạy một dự án phụ có hàng đợi thật, tình nguyện trực on-call, xin dự một buổi review thiết kế ngay cả khi thiết kế không phải của bạn.
Và nếu bạn muốn có phạm vi học có cấu trúc từ giờ đến vòng phỏng vấn tiếp theo, những nội dung này đi sâu hơn vào các mảnh ghép mà các câu trả lời dựa vào:



Câu hỏi system design xuất hiện trong nhiều buổi phỏng vấn hơn bạn nghĩ. Rõ ràng là các vị trí backend. Nhưng cũng cả hạ tầng, kỹ sư dữ liệu, và thậm chí những vị trí nặng về sản phẩm nơi chẳng ai mong bạn viết một dòng code nào trong cả vòng phỏng vấn.
Vậy thực ra người phỏng vấn đang kiểm tra điều gì? Không phải xem bạn biết kiến trúc “đúng” hay không, vì chẳng có kiến trúc nào là duy nhất đúng cả. Họ muốn thấy tư duy có cấu trúc, đánh đổi thẳng thắn, và liệu bạn có thể tiếp tục lý luận khi ràng buộc còn mơ hồ và thời gian đang trôi.
Kỳ vọng thay đổi rất nhiều theo cấp độ. Ứng viên junior đặt câu hỏi làm rõ tốt và phác thảo sơ đồ gọn gàng với vài ô là làm rất ổn. Ứng viên senior mà chỉ làm thế thì rắc rối đấy, vì ở cấp đó người ta kỳ vọng có con số, các chế độ lỗi, và quan điểm về việc nên xây phần nào trước.
Vai trò cũng quan trọng. Kỹ sư dữ liệu bị xoáy sâu vào pipeline và backfill, frontend vào cache và state, người làm infra vào rollout và phạm vi ảnh hưởng. Cùng một kỹ năng nền tảng, nhưng khác “từ vựng”.
Tôi nhấn mạnh điều này vì hầu hết danh sách câu hỏi bỏ qua cả hai chiều và chỉ đổ ra 50 đề mục. Danh sách này được tổ chức theo cấp độ trước, rồi theo vai trò, với các câu hỏi kịch bản ở cuối. Nếu phần lưu trữ trong các lời giải này còn lung lay, khóa học Database Design của chúng tôi bao quát các nền tảng cốt lõi.
Cách tiếp cận phỏng vấn System Design
Cùng một khung mỗi lần, khoảng 45 phút:
Hãy tường thuật to rõ toàn bộ. Người phỏng vấn không thể chấm điểm suy nghĩ thầm lặng.
Câu hỏi phỏng vấn System Design cho người mới bắt đầu
Những câu này kiểm tra nền tảng: làm rõ yêu cầu trước khi vẽ, tạo sơ đồ kiến trúc đơn giản, và đưa ra lựa chọn lưu trữ hợp lý. Không ai mong chờ thuật toán đồng thuận ở đây.
1. Thiết kế trình rút gọn URL
Trình rút gọn biến một URL dài thành mã ngắn và chuyển hướng khi truy cập, nên điều đầu cần chốt là liên kết có hết hạn không và bạn kỳ vọng bao nhiêu. Giả định hợp lý là 100 triệu liên kết mới mỗi tháng, với lượt đọc khoảng gấp 100 lần lượt ghi.
Tỷ lệ đọc cao định hình thiết kế: một máy chủ API, một cơ sở dữ liệu, và một cache phía trước. Với mã ngắn, hoặc mã hóa base62 một ID tự tăng (bảy ký tự cho khoảng 3,5 nghìn tỷ tổ hợp) hoặc tạo chuỗi ngẫu nhiên và kiểm tra va chạm.
Một bảng là đủ:
short_codelàm khóa chính,long_url,created_at,expires_at, vàuser_idtùy chọn. Các mã “nóng” nằm trong Redis để cơ sở dữ liệu chỉ xử lý miss. Dùng chuyển hướng 302 nếu bạn muốn phân tích lượt nhấp, vì trình duyệt sẽ cache 301 và bạn sẽ không thấy lượt truy cập lần hai.Ở mức 10 tỷ liên kết bạn shard theo mã và bộ tạo ID trở thành nút thắt cổ chai, và nếu người dùng bắt đầu đoán mã bạn chuyển từ tuần tự sang ngẫu nhiên và thêm giới hạn tốc độ.
2. Thiết kế bộ giới hạn tốc độ cơ bản
Bộ giới hạn tốc độ cho phép N request mỗi người dùng mỗi phút và trả về 429 sau ngưỡng đó. Điều đầu cần làm rõ là giới hạn theo người dùng, theo IP hay theo khóa API, vì điều đó quyết định khóa cache của bạn.
Ba thuật toán bao phủ hầu hết câu trả lời. Cửa sổ cố định đếm request trong mỗi “xô” phút, đơn giản nhưng cho phép vượt gấp đôi ở ranh giới. Cửa sổ trượt theo log lưu từng dấu thời gian, chính xác nhưng tốn bộ nhớ. Token bucket nạp đều đặn và cho phép các đợt ngắn, vì vậy nhiều gateway dùng nó.
Chạy limiter như middleware trong API gateway với bộ đếm trong Redis kèm TTL; INCR cộng EXPIRE đủ cho phiên bản cửa sổ cố định.
Với mười instance gateway bạn hoặc chia sẻ bộ đếm Redis hoặc chấp nhận đếm thừa nhẹ với bộ đếm cục bộ, và bạn nên quyết định từ đầu chuyện gì xảy ra nếu Redis chết: mở khóa và chấp nhận lạm dụng, hay đóng và chặn tất cả.
3. Thiết kế khoá trị-giá trị đơn giản
Khoá trị-giá trị cần get, put, và delete, và với câu hỏi cho người mới bắt đầu, bạn nên giữ ở một node duy nhất. Bản đồ băm trong bộ nhớ xử lý các thao tác. Để bền vững, ghi bổ sung mọi lần ghi vào log trên đĩa trước khi phản hồi, và chụp snapshot định kỳ để khi khôi phục không phải phát lại toàn bộ lịch sử.
Điều người phỏng vấn muốn nghe là bạn đã tách đường đi nhanh trong bộ nhớ khỏi đường bền trên đĩa, và bạn hiểu vì sao phải ghi log trước.
Nếu dữ liệu vượt quá bộ nhớ, câu trả lời là cây LSM, đại khái là cách RocksDB và Cassandra vận hành. Nếu cần node thứ hai, primary sao chép log sang follower, và hashing nhất quán xuất hiện khi bạn đi xa hơn nữa.
4. Thiết kế cache (khái niệm)
Cache nằm giữa ứng dụng và kho chậm hơn, và pattern cơ bản là cache-aside. Ứng dụng kiểm tra cache, miss, đọc cơ sở dữ liệu, ghi kết quả lại với TTL. Đơn giản, nhưng bạn phải tự chịu trách nhiệm logic vô hiệu hóa.
Thu hồi thường là LRU, đôi khi LFU cho tải lệch. Chỉ số quan trọng là tỷ lệ hit; dưới khoảng 80% bạn nên hỏi liệu cache có đang giúp gì không.
Điểm thú vị: dữ liệu cũ. Nếu cơ sở dữ liệu thay đổi còn bản cache thì không, người dùng sẽ thấy dữ liệu cũ cho đến khi TTL hết hạn. TTL ngắn giảm khoảng thời gian đó nhưng tăng tải lên cơ sở dữ liệu.
Khi một khóa phổ biến hết hạn và 10.000 request cùng đánh vào cơ sở dữ liệu, bạn hoặc gộp những request đó hoặc làm mới khóa trước khi nó hết hạn. Về ghi xuyên (write-through) so với ghi trả sau (write-back), write-through giữ cache đúng với cái giá là ghi chậm hơn, còn write-back nhanh nhưng mất ghi gần đây nếu cache chết trước khi flush.
5. Thiết kế dịch vụ thông báo cơ bản
Dịch vụ thông báo gửi email, SMS, và push và thử lại khi nhà cung cấp lỗi. Trước khi thiết kế, hãy hỏi về lưu lượng và liệu thứ tự giao có quan trọng không, thường là không.
Cốt lõi là một hàng đợi. Bên gửi ghi sự kiện thông báo vào đó, và một worker cho mỗi kênh kéo sự kiện và gọi nhà cung cấp như SendGrid hoặc Twilio. Cách tách này giữ phần quyết định gửi tách khỏi phần thực sự gửi, nên một nhà cung cấp SMS chậm sẽ không chặn ứng dụng.
Lưu mỗi thông báo với trạng thái (đang chờ, đã gửi, lỗi) và một khóa idempotency để sự kiện thử lại không gửi hai lần.
Người dùng muốn tắt marketing nhưng bật cảnh báo bảo mật cần một bảng tùy chọn được kiểm tra trước khi đưa vào hàng đợi, và một nhà cung cấp giới hạn 100 tin/giây cần throttling theo kênh trong worker.
6. Thiết kế dịch vụ lưu trữ tệp đơn giản
Hãy nghĩ Dropbox ở quy mô nhỏ. Người dùng tải tệp lên, nhận liên kết, tải về sau đó. Làm rõ kích thước tệp tối đa và liệu chia sẻ có quan trọng không.
Metadata (chủ sở hữu, tên tệp, kích thước, checksum, ngày tạo) lưu trong cơ sở dữ liệu quan hệ. Phần byte nằm trong lưu trữ đối tượng như S3, không bao giờ đặt trong cơ sở dữ liệu. Với upload, API trả về URL ký sẵn để client ghi trực tiếp vào lưu trữ đối tượng và máy chủ của bạn không chạm vào tệp.
Hai người dùng tải lên cùng một tệp 2 GB là bài toán khử trùng lặp giải bằng cách băm nội dung, và các tệp trên 5 GB cần upload đa phần với checksum cho từng chunk.
7. Thiết kế bảng xếp hạng trò chơi
Bảng xếp hạng phải cập nhật điểm của người chơi, trả về top 10, và trả về thứ hạng của một người chơi, và điều đầu cần hỏi là có bao nhiêu người chơi và điểm thay đổi thường xuyên cỡ nào.
Bảng quan hệ với chỉ mục trên điểm hoạt động đến một mức nào đó, nhưng “thứ hạng của tôi là bao nhiêu” trở thành một
COUNTtrên tất cả người ở trên bạn. Redis sorted set giải quyết điều này:ZADDđể cập nhật,ZREVRANGEđể lấy top N,ZREVRANKcho một người chơi, tất cả trong thời gian logarit.Bảng theo ngày và mọi thời đại là một sorted set mỗi kỳ, đặt khóa như
lb:2026-09-14. Nếu 50 triệu người chơi đẩy bộ nhớ Redis quá xa, chỉ giữ top 100k ở đó và phần còn lại trong cơ sở dữ liệu.Câu hỏi phỏng vấn System Design mức trung cấp
Ở mức này, người phỏng vấn giả định bạn đã xây và vận hành hệ thống thực. Câu hỏi đưa vào hàng đợi, mở rộng đọc/ghi, và căng thẳng giữa độ trễ, chi phí, và tính nhất quán.
8. Thiết kế nguồn tin (news feed)
Feed cần người dùng đăng bài, theo dõi người khác, và đọc những gì họ theo dõi đã viết, theo thứ tự thời gian đảo ngược hoặc xếp hạng. Giả sử 10 triệu người dùng hoạt động hàng ngày mở nó năm lần một ngày, tương đương khoảng 600 lượt đọc mỗi giây trung bình và cao hơn nhiều ở giờ cao điểm.
Lựa chọn trung tâm là khi nào lắp ráp feed. Fan-out khi ghi đẩy mỗi bài mới vào feed được tính sẵn của từng người theo dõi, cho đọc nhanh với cái giá là ghi đắt. Fan-out khi đọc lắp ráp lúc yêu cầu, đảo ngược đánh đổi đó. Đa số hệ thống thực kết hợp: fan-out khi ghi cho người dùng thường và khi đọc cho tài khoản có hàng triệu người theo dõi.
Mô hình dữ liệu gồm
posts,follows, và một danh sách feed theo người dùng trong Redis chứa ID bài viết. Phân trang bằng con trỏ trên ID bài viết thay vì offset.Thêm xếp hạng sau này không có nghĩa phải xây lại tất cả; bạn chấm điểm các ID ứng viên từ danh sách feed lúc đọc.
9. Thiết kế hệ thống chat đồng bộ đa thiết bị
Chat với đồng bộ đa thiết bị bao gồm nhắn tin 1-1 và nhóm, gửi đến mọi thiết bị người dùng sở hữu, và lịch sử tồn tại khi đổi điện thoại. Giả sử 50 triệu người dùng hàng ngày gửi khoảng 40 tin mỗi người, tức 2 tỷ mỗi ngày, hay khoảng 23.000 lượt ghi mỗi giây trung bình và gấp nhiều lần ở đỉnh khu vực.
Mỗi client giữ một WebSocket đến máy chủ chat, máy chủ ghi tin vào kho được phân vùng theo ID cuộc trò chuyện với số thứ tự tăng dần theo từng cuộc trò chuyện. Mỗi thiết bị nhớ số thứ tự cuối cùng đã thấy và yêu cầu mọi thứ mới hơn khi kết nối lại, đó là điều làm đồng bộ đa thiết bị hoạt động.
Kho cần thông lượng ghi cao và đọc theo phạm vi theo cuộc trò chuyện, nên cơ sở dữ liệu cột rộng như Cassandra thường là câu trả lời. Xác nhận gửi và đã đọc là các sự kiện nhỏ chảy ngược cùng đường.
Khi hai người bạn kết nối với các máy chủ chat khác nhau, hoặc pub/sub giữa các máy chủ hoặc dịch vụ định tuyến ánh xạ người dùng đến máy chủ sẽ chuyển tin. Nhóm 500 người fan-out ở phía máy chủ, và đảm bảo thứ tự trở nên khó giữ hơn.
10. Thiết kế dịch vụ ghép đôi cho gọi xe
Giữ nhẹ hơn phiên bản cho senior. Tài xế gửi vị trí vài giây một lần, hành khách yêu cầu chuyến, và dịch vụ phải trả về tài xế gần đó trong vài giây.
Cập nhật vị trí là vấn đề lưu lượng: 200.000 tài xế hoạt động, mỗi 4 giây một cập nhật tức 50.000 ghi mỗi giây. Lưu vị trí hiện tại trong bộ nhớ được đánh chỉ mục theo geohash hoặc ô H3, không phải trong bảng quan hệ. Ghép đôi nghĩa là “tìm tài xế trong ô của tôi và các ô lân cận”, xếp hạng theo ETA, và khóa một tài xế để hai hành khách không nhận cùng một xe.
Nếu tài xế nhận chuyến rồi mất kết nối, khóa sẽ hết hạn và hành khách được ghép lại. Một ô nóng ở trung tâm thành phố được chia nhỏ hơn ở khu vực dày đặc, đúng như cách chỉ mục phân cấp như H3 cung cấp.
11. Thiết kế hệ thống thu thập metrics
Hệ thống metrics nhận vài trăm chỉ số mỗi 10 giây từ hàng nghìn máy chủ và cho phép kỹ sư truy vấn trên dashboard.
Agent gom metrics theo lô và đẩy vào lớp tiếp nhận, lớp này ghi vào cơ sở dữ liệu chuỗi thời gian (hoặc một chủ đề Kafka với consumer ghi vào đó). Lưu trữ theo tầng: độ phân giải thô trong một hai ngày, tổng hợp theo phút trong một tháng, theo giờ trong một năm. Downsampling chạy như job nền.
Truy vấn đánh vào lớp tổng hợp khớp khoảng thời gian yêu cầu, giúp một biểu đồ 30 ngày không phải quét dữ liệu thô. Độ phân biệt thẻ cao (ví dụ user ID làm nhãn) sẽ “giết” cơ sở dữ liệu, nên hãy nói rõ điều đó.
Về đẩy so với kéo, Prometheus kéo, nhưng đẩy hoạt động tốt hơn qua tường lửa và cho job sống ngắn. Agent báo timestamp lạc thứ tự được chấp nhận trong một cửa sổ trễ giới hạn và bị từ chối nếu vượt, kèm bộ đếm số lần từ chối để đồng hồ lỗi hiện ra.
12. Thiết kế hệ thống gợi ý hoàn tất tìm kiếm
Autocomplete trả về top năm gợi ý trong khoảng 100 mili giây sau mỗi lần gõ phím. Làm rõ gợi ý là toàn cục hay cá nhân hóa, vì cá nhân hóa thay đổi mọi thứ.
Câu trả lời là tiền tính toán. Một pipeline offline tổng hợp log truy vấn, đếm tần suất, và xây trie (hoặc bảng tiền tố đến top-k) trong đó mỗi nút đã lưu sẵn các gợi ý tốt nhất. Lớp phục vụ sau đó chỉ cần một lần tra cứu mỗi lần gõ, và toàn bộ cấu trúc nằm gọn trong bộ nhớ qua vài bản sao.
Cập nhật diễn ra theo lô, có thể theo giờ, bằng cách xây lại cấu trúc và hoán đổi vào. Truy vấn thịnh hành có thể có một lớp “ghép chồng” thời gian thực nhỏ được trộn khi yêu cầu.
Một tiền tố như “a” sẽ chạm vào cây con khổng lồ, đó là lý do bạn lưu top-k tại mỗi nút thay vì duyệt. Lỗi gõ cần chỉ mục mờ riêng, hoặc bạn chấp nhận bỏ lỡ.
13. Thiết kế bộ lập lịch job phân tán
Bộ lập lịch job phân tán là cron cho cả công ty: định nghĩa job và lịch, chạy đúng thời điểm và nhiều nhất một lần mỗi nhịp, thử lại khi lỗi, và hiển thị đã xảy ra điều gì.
Lưu định nghĩa job và lịch trong cơ sở dữ liệu. Một dịch vụ lập lịch tính lần chạy tiếp theo cho mỗi job và đẩy job đến hạn vào hàng đợi; nhóm worker kéo và thực thi. Điểm khó là chạy đúng một instance lập lịch mỗi job mà không có điểm lỗi đơn, thường nghĩa là bầu leader (một khóa trong ZooKeeper, etcd, hoặc một hàng trong cơ sở dữ liệu có lease).
Ghi nhận mọi lần thực thi với trạng thái, thời gian bắt đầu, kết thúc, và vị trí log. Bảng đó trở thành thứ mọi người thực sự nhìn vào.
Một job chạy lâu hơn khoảng thời gian của nó nên bỏ qua, xếp hàng, hay chồng lấn, và điều đó nên cấu hình được. Khi job B phụ thuộc job A, phụ thuộc trở thành DAG, và bộ lập lịch chỉ đưa vào hàng đợi khi upstream đã thành công.
Câu hỏi phỏng vấn System Design nâng cao
Lĩnh vực cấp senior. Quy mô khổng lồ, đa vùng, mục tiêu độ tin cậy bạn có thể nêu thành con số, và chi phí của mọi quyết định. Người phỏng vấn kỳ vọng bạn chủ động nêu chế độ lỗi trước khi bị hỏi.
14. Thiết kế nền tảng phát video như YouTube
Phát video là hai hệ thống dưới một cái tên. Khi tải lên, người dùng đẩy tệp thô và pipeline chuyển mã nó thành nhiều độ phân giải và bitrate, chia thành các đoạn vài giây, và lưu các đoạn trong lưu trữ đối tượng. Khi phát, CDN phục vụ các đoạn đó và trình phát chuyển bitrate để khớp băng thông của người dùng, tức streaming thích ứng qua HLS hoặc DASH.
Nêu quy mô: hàng trăm giờ tải lên mỗi phút, hàng tỷ lượt xem mỗi ngày, lưu trữ tính bằng exabyte. Chuyển mã là bài toán song song “đáng xấu hổ”, nên một đội worker lớn kéo job từ hàng đợi. Metadata như tiêu đề, chủ sở hữu, và lượt xem nằm trong cơ sở dữ liệu sharding kèm cache nặng vì trang chủ đọc nó liên tục. Lưu trữ đối tượng và CDN edge sao chép qua nhiều vùng, và SLO quan trọng là thời gian bắt đầu phát, với tỷ lệ rebuffer là thước đo người dùng cảm nhận.
Lượt xem trên video viral là bộ đếm xấp xỉ được gom theo lô, không bao giờ là tăng trong cơ sở dữ liệu mỗi lượt xem, và đối sánh bản quyền là job fingerprint trong cùng pipeline tải lên.
15. Thiết kế nền tảng logging phân tán
Nền tảng logging nhận log từ mọi dịch vụ, cho phép tìm kiếm trong vài giây, và giữ 30 ngày nóng và một năm lạnh.
Agent theo dõi file log và chuyển đến bộ đệm bền như Kafka, thứ hấp thụ đột biến và cho phép indexer chậm lại mà không mất dữ liệu. Indexer ghi vào cụm tìm kiếm với một index mỗi ngày mỗi dịch vụ, và index cũ chuyển xuống file nén trong lưu trữ đối tượng.
Chi phí là ràng buộc thực sự, nên lập chỉ mục các trường có cấu trúc và giữ văn bản thô ở dạng rẻ. Cấp hạn ngạch cho mỗi dịch vụ, giám sát độ trễ lập chỉ mục, và loại bỏ PII ở khâu tiếp nhận.
Một dịch vụ log ở mức 100x bình thường sẽ lần lượt bị áp hạn ngạch, lấy mẫu, loại bỏ, và cảnh báo. Truy vấn xuyên vùng nghĩa là tìm kiếm liên kết, với mỗi vùng sở hữu dữ liệu của chính nó.
16. Thiết kế hệ thống phân tích thời gian thực
Phân tích thời gian thực nghĩa là dashboard hiển thị tổng hợp trong vài phút gần nhất, cập nhật trong vòng vài giây, trên dòng sự kiện có thể lên đến hàng triệu sự kiện mỗi giây.
Bộ xử lý dòng như Flink duy trì các tổng hợp theo cửa sổ, ví dụ đếm theo phút theo chiều, và ghi chúng vào kho đọc nhanh như ClickHouse hoặc Druid. Dashboard truy vấn kho đó, không bao giờ là dòng thô.
Nêu các đánh đổi: đếm chính xác so với HyperLogLog cho người dùng duy nhất, cửa sổ “rơi tự do” (tumbling) so với trượt (sliding), và watermark cho sự kiện đến muộn. Đặt SLO về độ “tươi” và giám sát độ trễ bộ xử lý so với nó.
Một chiều có độ phân biệt cao như user ID sẽ làm nổ bảng tổng hợp, nên hãy truy vấn sự kiện thô cho chiều đó. Backfill sau lỗi nghĩa là phát lại từ dòng với offset được giữ lại.
17. Thiết kế hệ thống thanh toán
Thanh toán là thiết kế mà tính đúng đắn vượt trên quy mô. Hệ thống phải thu tiền khách, ghi nhận, không bao giờ thu hai lần, không bao giờ mất bản ghi, và đối soát với ngân hàng hằng ngày.
Idempotency gánh phần lớn điều đó: mọi yêu cầu có một khóa, và dịch vụ lưu kết quả gắn với nó và trả cùng kết quả khi thử lại. Dòng tiền di chuyển qua sổ cái bút toán kép chỉ-ghi nơi các bút toán của mỗi giao dịch có tổng bằng không, trong cơ sở dữ liệu quan hệ với mức cô lập serializable. Đây là chỗ mà “nhất quán cuối cùng” là câu trả lời sai.
Gọi mạng thẻ có thể timeout mơ hồ, nên các khoản thu có trạng thái chờ và job đối soát sẽ quyết toán chúng. Đa vùng nghĩa là một vùng nhà cho mỗi tài khoản, không bao giờ active-active ghi trên cùng số dư.
Đa tiền tệ nghĩa là số nguyên theo đơn vị nhỏ kèm mã tiền tệ, và hoàn tiền đến trước khi khoản thu được quyết toán được xử lý bởi máy trạng thái với chuyển tiếp rõ ràng.
18. Thiết kế hệ thống nhắn tin quy mô lớn
Hệ thống nhắn tin quy mô lớn cho phép producer xuất bản và consumer đăng ký, sống sót qua việc broker khởi động lại, và giữ thứ tự nơi cần, ở mức hàng triệu thông điệp mỗi giây.
Phân vùng mỗi chủ đề để thông điệp có cùng khóa rơi vào cùng phân vùng, điều đó cho thứ tự theo khóa mà không cần thứ tự toàn cục. Mỗi phân vùng là log chỉ-ghi được sao chép sang vài broker, và consumer cam kết offset sau khi xử lý.
Mặc định giao hàng ít nhất một lần với consumer idempotent. Thử lại đi qua chủ đề retry với backoff và thông điệp độc hại đến dead-letter queue. Độ trễ consumer là tín hiệu để đặt SLO, và xuyên vùng, một vùng sở hữu quyền ghi theo khóa nếu không hai vùng sẽ làm đảo lộn thứ tự của nhau.
Một consumer crash sau khi xử lý nhưng trước khi cam kết sẽ tạo bản trùng, đó là lý do idempotency quan trọng. Bão tái phân bổ được thuần hóa bằng gán “bám dính” và tái phân bổ hợp tác.
Câu hỏi phỏng vấn System Design cho Kỹ sư Backend
Tập trung vào API, mô hình dữ liệu, và ranh giới dịch vụ. Hãy chờ các câu hỏi mở rộng về tính nhất quán, cache, và bạn sẽ log những gì.
19. Thiết kế dịch vụ xác thực và phân quyền
Authentication trả lời “bạn là ai” và authorization trả lời “bạn được làm gì,” và người phỏng vấn thích ứng viên tách bạch hai thứ đó.
Dùng OAuth 2.0 và OpenID Connect thay vì tự nghĩ ra giao thức. Cấp token truy cập ngắn hạn và token làm mới dài hạn được lưu phía máy chủ để bạn có thể thu hồi. Quyền nằm trong mô hình vai trò được kiểm tra bởi thư viện nhỏ hoặc dịch vụ policy. Log mọi lần đăng nhập, làm mới, và từ chối kèm IP và thiết bị, và không bao giờ log bản thân token.
JWT tránh tra cứu mỗi request, nhưng thu hồi sớm nghĩa là danh sách chặn, điều này lại đưa tra cứu quay về. Credential stuffing được làm chậm bằng giới hạn tốc độ theo IP và theo tài khoản, trì hoãn sau nhiều lần thất bại, và yếu tố thứ hai cho đăng nhập đáng ngờ.
20. Thiết kế API gateway
API gateway là điểm vào duy nhất trước các dịch vụ của bạn xử lý công việc cắt ngang để mỗi dịch vụ không phải làm: định tuyến theo đường dẫn và phiên bản, chấm dứt TLS, xác thực, giới hạn tốc độ, và log request.
Bản thân gateway nên stateless và mở rộng ngang sau load balancer. Cấu hình định tuyến sống trong control plane và được đẩy đến các instance gateway, để bạn không bao giờ phải redeploy gateway chỉ để thêm một route. Token xác thực được kiểm tra một lần ở rìa và gateway chuyển tiếp danh tính người dùng như một header.
Phạm vi ảnh hưởng là điều cần nói rõ. Gateway nằm trên mọi đường request, nên một lần đẩy cấu hình tệ có thể hạ gục tất cả; hãy kiểm tra hợp lệ cấu hình, rollout dần dần, và giữ logic của chính gateway thật mỏng.
Versioning mà không làm hỏng ứng dụng di động bạn không thể cập nhật nghĩa là versioning theo đường dẫn hoặc header với phiên bản cũ được giữ sống. Và gateway không nên tổng hợp phản hồi từ nhiều dịch vụ; việc đó thuộc lớp backend-for-frontend.
21. Thiết kế hệ thống đơn hàng cho trang thương mại điện tử
Hệ thống đơn hàng tạo đơn, giữ chỗ tồn kho, thu tiền, giao hàng, và cho khách xem trạng thái. Đơn hàng là một máy trạng thái (
created,paid,packed,shipped,delivered,cancelled), và các chuyển tiếp được phép nên được nêu rõ.Tạo đơn là một
POSTvới khóa idempotency để nhấp đúp không tạo hai đơn. Giữ chỗ tồn kho và thanh toán liên quan các dịch vụ khác, nên dùng saga: mỗi bước phát một sự kiện, và thất bại kích hoạt hành động bù (nhả tồn kho, hoàn tiền). Ghi sự kiện vào bảng outbox trong cùng giao dịch với cập nhật đơn để cơ sở dữ liệu và bus thông điệp không bao giờ bất đồng.Ở phía đọc, một bảng orders cộng bảng
order_items, với tổng hợp đơn được vật hóa và cache cho trang “đơn hàng của tôi”.Hai khách cùng mua đơn vị cuối cùng cùng lúc được giải quyết bằng khóa hàng hoặc giảm tồn kho nguyên tử, với một người nhận thông báo hết hàng. Thứ cần giám sát là đơn hàng kẹt ở một trạng thái lâu hơn kỳ vọng.
22. Thiết kế dịch vụ cờ tính năng (feature flag)
Dịch vụ cờ tính năng bật/tắt tính năng theo môi trường, nhắm mục tiêu theo thuộc tính người dùng hoặc theo phần trăm, và lật cờ toàn cầu trong vài giây khi có sự cố.
Định nghĩa cờ và luật nhắm mục tiêu nằm trong cơ sở dữ liệu nhỏ phía sau admin API. Ứng dụng nhúng SDK tải tất cả cờ khi khởi động, cache cục bộ, và đánh giá luật trong tiến trình, nên kiểm tra cờ không tốn gì lúc request. Cập nhật được truyền qua kết nối streaming hoặc thăm dò ngắn, và SDK giữ trạng thái cuối cùng biết được nếu dịch vụ cờ sập.
Đánh giá rollout theo phần trăm bằng băm ổn định của user ID và khóa cờ, để cùng một người dùng luôn rơi về cùng một phía.
Cờ lỗi thời được phát hiện bằng cách theo dõi timestamp lần đánh giá gần nhất và nhắc chủ sở hữu, và nếu dịch vụ cờ sập khi khởi động, ứng dụng quay về mặc định đóng gói trong code.
23. Thiết kế API phục vụ gợi ý (recommendation)
API gợi ý trả về 20 mục cho một người dùng trong dưới 100 mili giây ở vài nghìn request mỗi giây, và không cần ML chuyên sâu để thiết kế.
Tách offline và online. Job offline tính danh sách ứng viên theo người dùng vào kho khóa-giá trị độ trễ thấp. API online lấy các danh sách đó, xếp hạng lại với vài đặc trưng mới như tình trạng còn hàng, lọc những gì người dùng đã mua, và trả về danh sách. Giữ phương án dự phòng là các mục phổ biến theo danh mục, và log mọi danh sách đã phục vụ với ID request để sau này ghép với lượt nhấp.
Người dùng mới nhận phương án dự phòng cho đến khi có vài tương tác. 100 mili giây chia đại khái thành 10 cho truy xuất, 30 cho xếp hạng lại, 10 cho tuần tự hóa, và 50 dự phòng.
Câu hỏi phỏng vấn System Design cho Hạ tầng / DevOps
Độ tin cậy, triển khai, tự động hóa, và khả năng quan sát. Chủ đề lặp lại: bạn thay đổi an toàn thế nào và biết nhanh khi mình sai.
24. Thiết kế pipeline CI/CD cho microservices
Pipeline CI/CD cho microservices phải xử lý hàng chục dịch vụ triển khai độc lập với test, kiểm tra bảo mật, và con đường lên production không cần người dậy lúc 3 giờ sáng.
Build một lần, triển khai cùng artifact ở mọi nơi. Pipeline lint, chạy unit test, build ảnh container gắn thẻ bằng commit SHA, quét bảo mật, và đẩy vào registry. Triển khai sau đó thăng cấp ảnh qua các môi trường (dev, staging, production) dùng cấu hình thay vì build lại.
Triển khai production nên tiến triển: canary cho vài phần trăm lưu lượng, theo dõi tỷ lệ lỗi và độ trễ trong cửa sổ xác định, rồi tiếp tục hoặc rollback tự động. Rollback nghĩa là triển khai lại thẻ ảnh trước đó, nhanh vì bạn không bao giờ build lại.
Khi thay đổi của dịch vụ A phá vỡ hợp đồng của dịch vụ B, cách khắc phục là test hợp đồng trong CI và thay đổi API tương thích ngược. Monorepo so với nhiều repo ít quan trọng hơn mọi người nghĩ, miễn pipeline chỉ build phần thay đổi.
25. Thiết kế giám sát và cảnh báo tập trung
Giám sát tập trung đưa metrics, logs, và traces từ mọi dịch vụ vào một nơi, với cảnh báo chỉ đánh thức người khi người dùng bị ảnh hưởng.
Metrics chảy vào kho chuỗi thời gian, logs vào nền tảng ở câu 15, traces vào backend tracing, tất cả được liên kết bởi một request ID chung. Quyết định thiết kế quan trọng là bạn cảnh báo về điều gì. Cảnh báo về triệu chứng (tỷ lệ lỗi, bách phân vị độ trễ, độ bão hòa) gắn với SLO, không phải về nguyên nhân như “CPU 80%”.
Mệt mỏi vì bị gọi trực đêm giết chết ca trực, nên mỗi cảnh báo cần runbook và rà soát. Bất cứ thứ gì gọi hai lần trong một tuần mà không có hành động rõ ràng sẽ bị hạ xuống thành ticket.
SLO cho dịch vụ hoàn toàn mới đến từ đo lường vài tuần rồi đặt mục tiêu tốt hơn hiện tại đôi chút. Và khi chính hệ thống giám sát sập, kiểm tra tổng hợp bên ngoài và cảnh báo “người chết” là thứ cho bạn biết.
26. Thiết kế phương án quản lý bí mật
Quản lý bí mật giúp mật khẩu cơ sở dữ liệu, khóa API, và chứng chỉ sẵn sàng cho dịch vụ lúc chạy, không bao giờ nằm trong mã nguồn, được xoay vòng thường xuyên, và có nhật ký kiểm tra.
Kho bí mật trung tâm (HashiCorp Vault, secrets manager của nhà cung cấp đám mây) giữ mọi thứ. Dịch vụ xác thực với nó bằng danh tính workload của mình (tài khoản dịch vụ Kubernetes, vai trò IAM), không bao giờ bằng token sống lâu, và lấy bí mật khi khởi động hoặc theo yêu cầu. Ưu tiên bí mật động khi có thể: kho tạo thông tin xác thực cơ sở dữ liệu hợp lệ trong một giờ, và việc xoay vòng diễn ra “miễn phí”.
Ghi log kiểm toán mọi lần đọc. Và luôn có một lối thoát khẩn cấp được lập thành tài liệu khi chính kho bí mật gặp sự cố, vì điều đó sẽ xảy ra.
Một khóa mà nhà phát triển vô tình commit sẽ bị phát hiện bởi quá trình quét trong CI, được xoay vòng ngay lập tức và vẫn được coi là đã bị lộ. Bí mật trong biến môi trường thì phổ biến nhưng có thể rò rỉ qua crash dump và tiến trình con, vì vậy hãy mount chúng dưới dạng tệp hoặc truy xuất trong tiến trình.
27. Thiết kế autoscaling và chiến lược rollout
Autoscaling và rollout kết hợp phải giúp một dịch vụ xử lý biến động lưu lượng hằng ngày gấp 5 lần mà không cần can thiệp thủ công, trong khi vẫn triển khai vài lần mỗi ngày.
Scale dựa trên tín hiệu phản ánh đau đớn của người dùng, thường là tốc độ yêu cầu hoặc độ trễ trên mỗi instance, thay vì chỉ CPU. Đặt số bản sao tối thiểu để khởi động lạnh không gặp ngay đột biến, và số tối đa để một lỗi không khiến bạn phá sản. Scale lên nhanh và scale xuống từ tốn.
Với rollout, dùng blue/green khi bạn cần chuyển đổi tức thì và rollback tức thì, và canary khi bạn muốn quan sát lưu lượng thực trên một phần nhỏ trước. Kết hợp canary với autoscaler một cách thận trọng, vì một canary scale độc lập có thể làm sai lệch phép so sánh.
Nếu scale chậm hơn đột biến bất ngờ hai phút, thì scale dự đoán theo lịch hoặc mức tối thiểu cao hơn sẽ bù khoảng trống đó. Và 50 instance mới làm cạn kiệt kết nối cơ sở dữ liệu là lý do pooling kết nối nên nằm ở lớp proxy.
Câu hỏi phỏng vấn thiết kế hệ thống cho Data Engineer
Pipeline, định dạng lưu trữ, batch so với streaming, và liệu dữ liệu có đáng tin cậy hay không. Khung tư duy như trước, nhưng kịch bản lỗi là mất, trùng lặp hoặc dữ liệu đến muộn thay vì mất yêu cầu.
28. Thiết kế pipeline thu nhận sự kiện
Một pipeline thu nhận sự kiện lấy các sự kiện hành vi từ khách hàng web và di động và biến chúng thành truy vấn được trong vòng một giờ. Giả định 50.000 sự kiện mỗi giây ở đỉnh, với client có thể ngoại tuyến và retry.
Client gom sự kiện qua một SDK và post tới dịch vụ collector, nơi xác thực theo một registry schema và ghi vào stream (Kafka hoặc dịch vụ quản lý tương đương). Một consumer đổ sự kiện thô vào object storage được phân vùng theo giờ, ở định dạng cột như Parquet. Các job downstream đọc từ đó.
Retry dẫn đến trùng lặp, nên mỗi sự kiện mang một UUID do client tạo và job đổ dữ liệu sẽ khử trùng trong một cửa sổ. Thay đổi schema phải đi qua registry với kiểm tra tương thích, vì ứng dụng di động phiên bản cũ sẽ tiếp tục gửi dữ liệu theo cấu trúc cũ trong nhiều tháng.
Một sự kiện có timestamp từ ba ngày trước sẽ được ghi theo thời gian đến, giữ thời gian sự kiện như một cột, và để downstream quyết định. Sự kiện lỗi đi vào đường dead-letter và không bao giờ bị bỏ qua trong im lặng.
29. Thiết kế hệ thống ETL streaming
Streaming ETL biến đổi sự kiện ngay khi chúng đến, join với dữ liệu tham chiếu, và ghi kết quả vào kho phục vụ trong vài giây.
Một bộ xử lý stream đọc từ topic thu nhận, áp dụng biến đổi, và làm giàu với dữ liệu tham chiếu được nạp vào bộ nhớ và làm mới định kỳ. State (cho join theo cửa sổ hoặc tổng hợp) checkpoint tới lưu trữ bền vững để job bị crash có thể tiếp tục mà không phải xử lý lại từ đầu.
Sự đánh đổi mà nhà phỏng vấn muốn nghe: exactly-once so với at-least-once. Exactly-once có thể đạt được end-to-end nếu sink hỗ trợ giao dịch hoặc ghi idempotent, nhưng phải trả giá bằng độ trễ và độ phức tạp. At-least-once với sink idempotent mang lại phần lớn lợi ích.
Dữ liệu đến muộn được xử lý bằng watermark và một khoảng ân hạn xác định, sau đó đưa vào bảng late-arrivals.
Dữ liệu tham chiếu thay đổi giữa dòng nên được version hóa, với join dựa trên phiên bản hợp lệ tại thời điểm sự kiện. Một lần backfill sau sáu tháng khi sửa logic sẽ phát lại từ lưu trữ thô theo batch, không đi qua luồng stream.
30. Thiết kế kho dữ liệu và phương pháp modeling
Một warehouse phải mang đến cho nhà phân tích và dashboard các chỉ số nhất quán trên dữ liệu bán hàng, marketing và sản phẩm, đồng thời bảo toàn lịch sử.
Đưa dữ liệu thô nguyên vẹn vào lớp bronze, làm sạch và chuẩn hóa ở lớp silver, và xây dựng các bảng phục vụ nghiệp vụ ở lớp gold. Mô hình hóa lớp gold theo star schema: bảng fact ở mức hạt mịn hữu ích nhất (ví dụ một dòng cho mỗi dòng đơn hàng) và bảng dimension cho khách hàng, sản phẩm, ngày tháng. Dimension thay đổi chậm nhận xử lý Type 2 khi lịch sử quan trọng, để việc thay đổi vùng của khách hàng không ghi đè doanh thu năm ngoái.
Partition các bảng fact lớn theo ngày, cluster theo các cột thường được lọc, và giữ các biến đổi trong version control (dbt hoặc tương đương) kèm kiểm thử.
Khi hai nhóm định nghĩa “khách hàng hoạt động” khác nhau, một lớp metrics với một định nghĩa bắt buộc duy nhất sẽ giải quyết. Một fact đến muộn tham chiếu tới khóa dimension chưa có sẽ nhận một dòng dimension tạm và được backfill sau.
31. Thiết kế feature store
Một feature store tính toán feature một lần và tái sử dụng cho cả huấn luyện mô hình lẫn dự đoán online, tránh lệch giữa huấn luyện/phục vụ, và phần này giữ ở mức cao. Nó là hai kho với một định nghĩa: kho offline (warehouse hoặc lake) giữ lịch sử feature để xây tập huấn luyện, và kho online (Redis, DynamoDB) giữ giá trị mới nhất trên mỗi thực thể cho tra cứu độ trễ thấp lúc dự đoán.
Một định nghĩa feature duy nhất điều khiển cả hai, và một job materialize từ offline sang online theo lịch.
Khái niệm then chốt là tính đúng theo thời điểm. Khi bạn xây tập huấn luyện, mỗi dòng phải dùng giá trị feature như chúng tồn tại tại timestamp của dòng đó, không phải giá trị hiện tại. Nếu không, mô hình của bạn học từ tương lai và trông tuyệt cho đến khi đưa vào sản xuất.
Một feature tốn kém để tính theo thời gian thực sẽ được tính trước với chút độ cũ hoặc tính khi ghi. Để biết giá trị online và offline khớp nhau, hãy lấy mẫu và so sánh, và log các feature bạn thực sự đã phục vụ.
32. Thiết kế lớp chất lượng dữ liệu và truy xuất nguồn gốc
Một lớp chất lượng dữ liệu và truy xuất nguồn gốc phát hiện dữ liệu hỏng trước khi dashboard làm vậy và trả lời “cột này đến từ đâu” mà không cần đọc code.
Các kiểm tra chất lượng chạy như những bước trong pipeline: đếm số dòng so với phạm vi kỳ vọng, tỷ lệ null, độ tươi (phân vùng có hạ cánh đúng giờ không), và một vài ràng buộc nghiệp vụ (doanh thu không bao giờ âm). Lỗi sẽ chặn các job downstream và cảnh báo chủ sở hữu. Lưu kết quả kiểm tra theo thời gian để bạn thấy được trôi dạt, không chỉ là đạt hay trượt hôm nay.
Nguồn gốc được ghi nhận từ chính mã biến đổi (phân tích SQL, hoặc metadata của công cụ điều phối) và lưu dưới dạng đồ thị: bảng đến bảng, cột đến cột nếu có thể. Đồ thị đó cung cấp phân tích tác động khi ai đó muốn bỏ một cột.
Nếu kiểm tra lâu hơn pipeline, hãy lấy mẫu, hoặc chạy các kiểm tra nặng theo cách bất đồng bộ và cảnh báo thay vì chặn. Truy xuất nguồn gốc giữa các công cụ không nói chuyện với nhau nghĩa là dùng OpenLineage hoặc chú giải thủ công, với các lỗ hổng được ghi tài liệu.
Câu hỏi phỏng vấn thiết kế hệ thống cho Frontend / Full-Stack
Hiệu năng phía client, quản lý trạng thái, caching, và cách trình duyệt nói chuyện với API. Những kiến thức bảo mật cơ bản cũng xuất hiện ở đây.
33. Thiết kế kiến trúc cho web app lưu lượng cao
Web app lưu lượng cao ở đây nghĩa là một trang nặng nội dung với hàng triệu lượt truy cập mỗi ngày, first paint nhanh, và các phần cá nhân hóa cho người dùng đăng nhập.
Tài sản tĩnh đưa lên CDN với thời gian cache dài và tên tệp băm. Các trang giống nhau với mọi người được render phía server và cache ở edge; các phần cá nhân hóa tải phía client sau khi shell hiển thị. Cách lai này giữ TTFB thấp mà không phục vụ dữ liệu cá nhân cũ.
Các cuộc gọi API từ client đi qua gateway với token sống ngắn. Đặt header cache một cách có chủ đích:
Cache-Controlvớistale-while-revalidatecho nội dung có thể cũ vài giây,no-storecho bất kỳ thứ gì cá nhân.Với một dashboard phía sau đăng nhập, render phía client thường là ổn, vì SSR không mang lại nhiều nếu không có SEO. Và một khóa cache vô tình bao gồm cookie phiên sẽ khiến mọi người có bản riêng của họ, làm tỷ lệ hit sụt giảm.
34. Thiết kế đồng bộ ưu tiên ngoại tuyến (offline-first)
Offline-first sync nghĩa là một ứng dụng ghi chú hoặc thu thập dữ liệu hiện trường hoạt động không cần kết nối và đồng bộ khi trở lại, mà không mất chỉnh sửa của ai.
Mọi ghi sẽ vào kho cục bộ trước (IndexedDB, SQLite trên di động) và vào một hàng đợi mutation đang chờ. Khi kết nối trở lại, client đẩy hàng đợi theo thứ tự và kéo các thay đổi kể từ token đồng bộ cuối. Mỗi mutation mang ID client và số thứ tự để server có thể khử trùng lặp.
Xung đột là toàn bộ vấn đề. Last-write-wins thì đơn giản nhưng làm mất dữ liệu. Gộp ở mức trường xử lý được hầu hết trường hợp.
CRDT cung cấp tự động hợp nhất cho văn bản và danh sách với cái giá là độ phức tạp, và tôi chỉ dùng khi cộng tác thời gian thực là yêu cầu thật sự.
Một người dùng chỉnh sửa trên hai thiết bị khi ngoại tuyến và đưa cả hai trở lại sẽ có cả hai chỉnh sửa được áp dụng, xung đột được gắn cờ, và UI hiển thị điều đó. Một hàng đợi chờ lên tới 10.000 mutation nên được nén gọn, để mười lần sửa một trường thành một.
35. Thiết kế cập nhật UI thời gian thực
Cập nhật UI thời gian thực nghĩa là một dashboard hoặc khung chat phản ánh thay đổi phía server trong vòng một giây cho hàng nghìn người dùng đồng thời.
Chọn kênh truyền theo hướng dữ liệu. Server-Sent Events khi dữ liệu chỉ chảy từ server tới client (tỉ số trực tiếp, thông báo); WebSocket khi client cũng gửi nhiều (chat, cộng tác biên tập). Long polling là phương án dự phòng khi mạng chặn cả hai.
Trên server, một lớp pub/sub phân tán thay đổi đến máy chủ kết nối nào đang giữ người dùng. Trên client, xử lý kết nối lại với backoff và tiếp tục từ ID sự kiện cuối để việc rơi kết nối không làm mất cập nhật. Tiết chế việc render: 50 cập nhật mỗi giây cho một biểu đồ nên gộp thành vài lần vẽ lại, không phải 50.
100.000 người dùng theo dõi một sự kiện trực tiếp là fan-out phía server, có thể qua một CDN hỗ trợ streaming. Xác thực một WebSocket nghĩa là dùng token trong bắt tay ban đầu, được xác thực lại định kỳ.
36. Thiết kế kế hoạch hiệu năng phía client cho dashboard
Mục tiêu là một dashboard phân tích với 20 biểu đồ tải dưới ba giây và vẫn mượt khi lọc.
Đừng fetch 20 biểu đồ cùng lúc. Tải những biểu đồ đang hiển thị trước, lazy-load phần còn lại khi cuộn, và hiển thị skeleton thay vì spinner. Tổng hợp trước trên server để client chỉ nhận vài trăm dòng mỗi biểu đồ, không bao giờ là sự kiện thô.
Cache kết quả truy vấn trong bộ nhớ với khóa theo trạng thái bộ lọc, để bật tắt bộ lọc qua lại không phải refetch.
Bảng có hàng nghìn dòng cần virtual hóa (chỉ render phần đang hiển thị). Các tính toán nặng chuyển sang web worker để main thread rảnh cho tương tác.
Nếu API chậm và bạn không thể thay đổi nó, hãy cache tích cực, hiển thị dữ liệu cũ với timestamp, và làm mới ở nền. Lỗi CORS khi dashboard gọi một API mới nghĩa là API phải cho phép origin của dashboard, và bạn nên có thể giải thích các preflight request.
Câu hỏi phỏng vấn thiết kế hệ thống theo kịch bản
Những câu này kiểm tra phán đoán hơn là kiến trúc. Yêu cầu thay đổi, sản xuất gặp sự cố, và người phỏng vấn muốn xem bạn xử lý ưu tiên thế nào.
37. Lưu lượng tăng 10 lần qua đêm. Thay đổi gì đầu tiên?
Bắt đầu với thứ vỡ đầu tiên, và hiếm khi là tầng stateless. Autoscaling xử lý web server; cơ sở dữ liệu, cache, và bất kỳ giới hạn tốc độ từ bên thứ ba nào mới là nơi sập.
Ngay lập tức, kiểm tra các chỉ số bão hòa (kết nối, CPU, độ sâu hàng đợi) cho cơ sở dữ liệu và cache, nâng trần autoscaler, và bật mọi cơ chế giảm tải bạn có, như bỏ các tính năng không quan trọng hoặc phục vụ trang đã cache. Trong một ngày, thêm bản sao đọc, tinh chỉnh tỷ lệ hit cache, và tìm các truy vấn chi phối. Dài hạn, làm công việc sharding và xếp hàng mà bạn đã trì hoãn.
Phân biệt tăng trưởng thực với bot dựa vào mẫu yêu cầu, user agent, và liệu chuyển đổi có tăng không.
38. Bạn chạm giới hạn đọc của cơ sở dữ liệu. Cache, replica, hay sharding?
Theo thứ tự đó, thường là vậy. Một cache trước các lượt đọc nóng nhất rẻ và có thể giảm tải cơ sở dữ liệu một nửa trong một ngày; kiểm tra tỷ lệ hit và log truy vấn để xác nhận các lượt đọc thực sự lặp lại.
Replica đọc là bước tiếp theo khi tập đọc rộng thay vì nóng. Chúng thêm độ trễ sao chép, nên mọi đường đọc-sau-ghi (người dùng lưu và thấy thay đổi ngay) cần đi tới primary. Sharding giải quyết giới hạn ghi hơn là giới hạn đọc và khiến bạn phải trả giá bằng truy vấn xuyên shard và một cuộc di trú, nên để cuối, và chỉ khi hai cách đầu đã cạn.
Nếu một khách hàng khổng lồ trên một bảng đơn gây tải, hãy cô lập tenant đó hoặc partition theo ID khách hàng.
39. Một phụ thuộc downstream quan trọng chập chờn. Retry, timeout, circuit breaker?
Tất cả, và theo đúng thứ tự. Đầu tiên là timeout, vì một lời gọi không có timeout biến một phụ thuộc chậm thành sự cố của chính bạn khi luồng tích lại. Sau đó retry với exponential backoff và jitter, nhưng chỉ cho lời gọi idempotent và chỉ vài lần, nếu không bạn khuếch đại tải lên một dịch vụ vốn đã vật lộn.
Tiếp theo là circuit breaker: sau một ngưỡng lỗi, dừng gọi một thời gian và phục vụ phương án thay thế (dữ liệu đã cache, phản hồi suy giảm, lỗi thân thiện). Giám sát trạng thái breaker; một breaker kẹt ở trạng thái mở cũng là một sự cố.
Khi phụ thuộc chập chờn là nhà cung cấp thanh toán của bạn, không có phương án thay thế cho thao tác trừ tiền; hãy xếp hàng đơn hàng ở trạng thái chờ và xử lý sau.
40. Độ trễ tăng sau khi ra mắt. Bạn chẩn đoán thế nào?
Trước hết, xác nhận nó là thật và phạm vi: phần trăm nào tăng (p50 hay chỉ p99), endpoint nào, vùng nào. So sánh với timeline triển khai; nếu trùng với bản phát hành, rollback trước và điều tra sau.
Nếu rollback không phải câu trả lời, theo dõi yêu cầu. Trace cho thấy span nào dài ra. Thủ phạm thường gặp: truy vấn mới thiếu index, mẫu N+1 do một field mới, khóa cache thay đổi làm tụt tỷ lệ hit, hoặc một lời gọi downstream trước đây là async nay nằm trên đường yêu cầu.
Nếu chỉ p99 tăng và rollback không giúp, hãy tìm pause do garbage collection, noisy neighbor, hoặc khóa.
41. Xuất hiện lỗi bất nhất dữ liệu. Bạn kiểm tra gì, rollback gì?
Khoanh vùng thiệt hại trước khi động vào bất cứ thứ gì. Bảng hay bản ghi nào bất đồng, từ khi nào, và có còn xảy ra không? Câu trả lời “từ khi nào” thường trỏ tới một lần deploy hoặc một job đã chạy.
Kiểm tra đường ghi của các bản ghi bị ảnh hưởng: migration gần đây, một job chạy hai lần, retry không idempotent, cuộc đua giữa hai bên ghi. Chặn chảy máu bằng cách tạm dừng job gây lỗi hoặc rollback code, rồi sửa từ nguồn sự thật (log sự kiện thô, sổ cái, bản sao lưu) thay vì chỉnh tay các dòng. Ghi lại những gì bạn đã thay đổi và lý do.
Khi không có nguồn sự thật để sửa, hãy khôi phục những gì có thể, gắn cờ phần còn lại, và thêm mẫu outbox để tránh lặp lại.
Lỗi thường gặp trong phỏng vấn thiết kế hệ thống
Hầu hết ứng viên thất bại vì cùng một vài lý do. Không lý do nào là do biết ít hơn.
Cách chuẩn bị cho phỏng vấn thiết kế hệ thống
Chuẩn bị hiệu quả khi có thể lặp lại. Đây là một quy trình mà tôi thực sự sẽ làm theo.
Kết luận
Mỗi câu hỏi trong danh sách này đến từ một hệ thống mà ai đó đã phải xây và rồi giữ nó sống lúc 3 giờ sáng, nên bạn làm việc đó càng nhiều, buổi phỏng vấn càng bớt giống một màn trình diễn và càng giống việc mô tả ngày thứ Ba của bạn. Chạy một dự án phụ có hàng đợi thật, tình nguyện trực on-call, xin dự một buổi review thiết kế ngay cả khi thiết kế không phải của bạn.
Và nếu bạn muốn có phạm vi học có cấu trúc từ giờ đến vòng phỏng vấn tiếp theo, những nội dung này đi sâu hơn vào các mảnh ghép mà các câu trả lời dựa vào: