course
Förstå modern dataarkitektur
2 timmar
23.9K
De flesta samtal om datakvalitet fokuserar på att rätta felaktig källdata. Men olika datateam kan bygga fem helt olika instrumentpaneler från samma källsystem, med olika intäktssiffror för samma kvartal. Källdatan är inte nödvändigtvis problemet här. Varje konsument kan städa, slå samman, filtrera och definiera datan oberoende av varandra, utan någon gemensam standard för vad ”ren” betyder.
Medallion-arkitekturen löser detta genom att ge datateam tydliga gränser för att förbättra datakvaliteten utan att förlora rådatan de utgick från. Låt oss titta på vad det är, hur det fungerar och varför det är ett så viktigt begrepp inom data engineering och MLOps.
Vår Understanding Modern Data Architecture-kurs tar upp var lakehouses och lagerindelade pipelines passar in i den bredare datastacken. Och vår Data Engineer-karriärväg bygger de bredare pipelines-färdigheter som gör dessa lager hanterbara när de väl är i produktion.
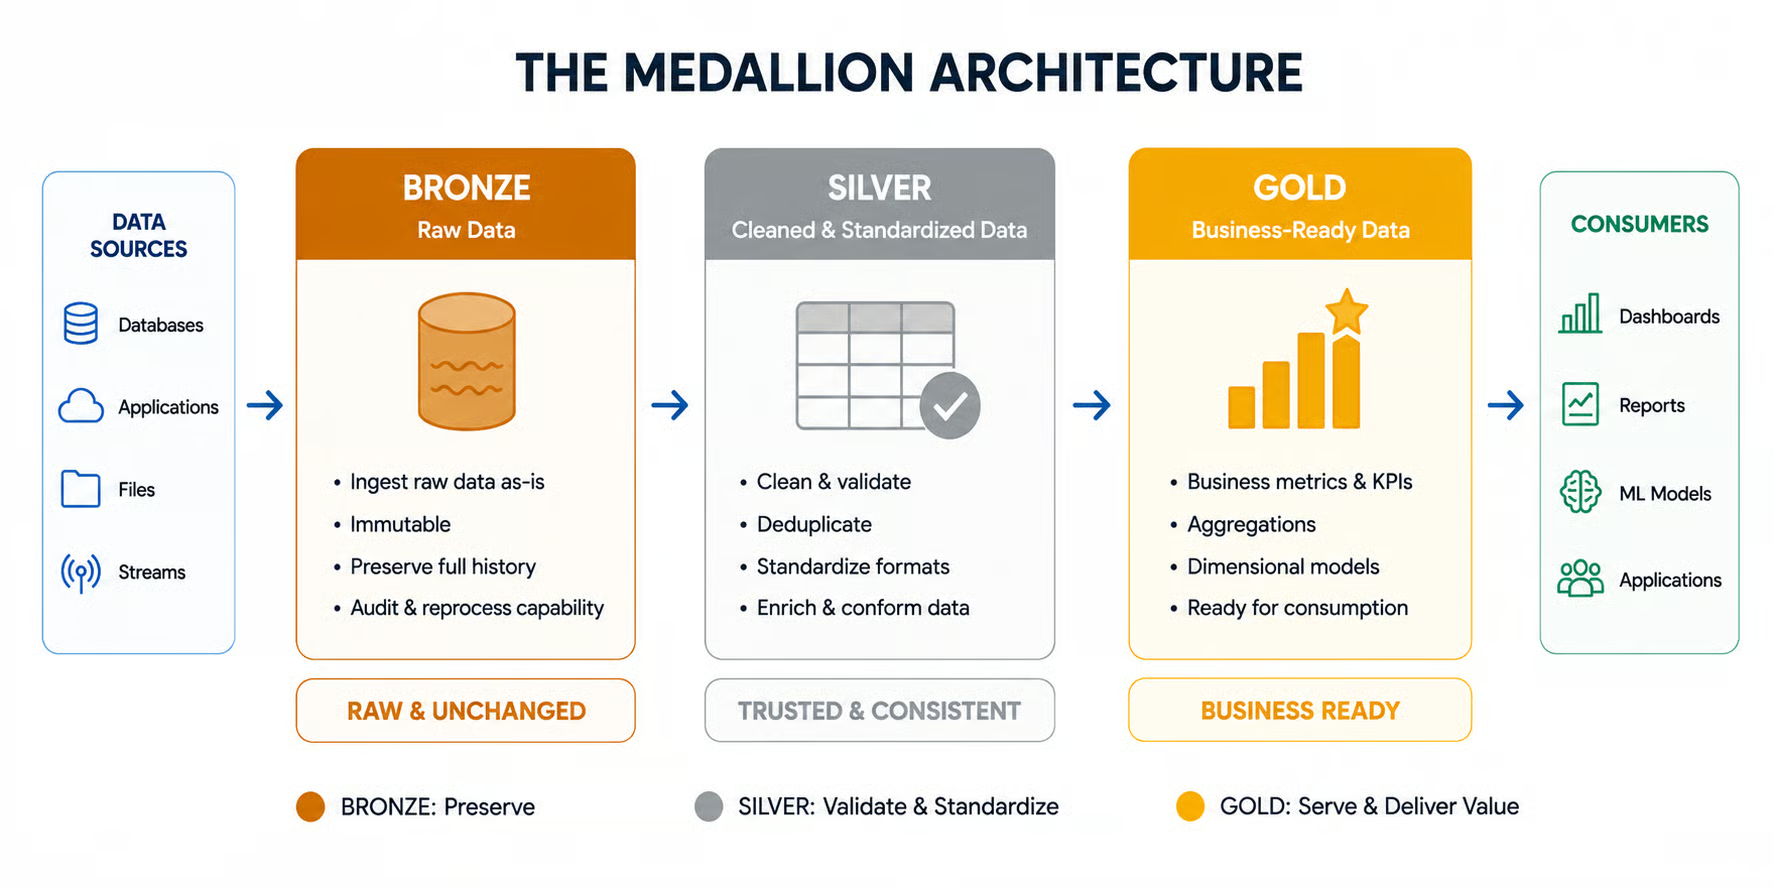
Medallion-arkitekturen är ett datadesignmönster för att logiskt organisera data i ett data lakehouse. Den definierar tre lager där datakvalitet och struktur förbättras i takt med att data passerar genom dem:
I data warehouse-miljöer med traditionella extract-transform-load (ETL)-pipelines måste du definiera datats schema i förväg. Om ditt dataformat eller schema ändras kommer systemet att fallera om du inte justerar det manuellt.
I en medallion-baserad extract-load-transform (ELT)-arkitektur sparar du först datan i dess råa form, snarare än att transformera den i farten och lagra den slutliga datan. Denna skillnad gör medallion-baserade arkitekturer både robusta och flexibla: du kan lagra rådata som den är och bestämma hur du vill använda den senare.
För en fullständig jämförelse av de två koncepten rekommenderar jag att läsa vår guide om ETL vs ELT.
En annan fördel med medallion-arkitekturen är dess plattformsoavhängiga natur. Bronze, Silver och Gold är logiska steg, inte teknologier bundna till en specifik leverantör. Du kan implementera mönstret med olika lagringssystem, bearbetningsmotorer och tabellformat, beroende på din dataplattform och arbetslastkrav.
|
Funktion |
Medallion (ELT) |
Traditionell ETL |
|
Rådata |
Bevaras |
Borta |
|
Schema |
Bestäm senare, upprätthålls i Silver |
Definieras i förväg vid målet |
|
Reprocessning |
Kör om från bevarad rådata |
Kan kräva återextrahering av källdata |
|
Transformations-timing |
Efter inläsning |
Före inläsning |
|
Dataförädling |
Successiv över lager |
Främst innan data når målet |
De tre medallion-lagren följer logiskt, där varje lager bygger på det föregående.
Här landar rådatan som den är, oavsett om det är relationsdatabaser, SaaS-appar som Salesforce, Kafka-ämnen som bär realtidshändelser, REST-API:er, CSV-exporter eller IoT-enhetsströmmar. Ingestion hanteras vanligtvis av verktyg som Fivetran för change data capture eller Databricks Auto Loader för filer som landar i objektlagring.
Bronze-data innehåller vanligtvis en hel del fel, inkonsekvenser och dubbletter, så den bör aldrig användas direkt för affärsändamål. Med det sagt är lagret mycket värdefullt som en återställningspunkt från vilken du kan återskapa Silver- eller Gold-data.
Vikten av lagret ligger i dess avtryck: det registrerar och loggar varje ingest-händelse eller transaktion. Det innehåller ofta värdefull metadata, såsom inläsningstidsstämplar, datakällor och olika typer av identifierare. Målet är att lagra datan så rå och komplett som möjligt, så att du kan spela upp nedströms pipelines med samma källdata för att felsöka eventuella buggar.
Silver-lagret transformerar rådata till ren, strukturerad data. Några exempel på viktiga städande transformationer som sker mellan Bronze- och Silver-nivåerna:
Detta lager innehåller också schema-efterlevnad, vilket säkerställer att datan uppfyller en fördefinierad struktur och stödjer schemaevolution.
Här hanterar du också datakvalitetskontroller. Till exempel kan du lägga till regler för att flagga eller avvisa misslyckade affärstransaktioner eller avvikare. Detta är första steget för att förbättra datakvaliteten när datan passerar genom stegen.
Eftersom detta steg innebär datamodifiering är det' viktigt att använda data lineage-verktyg som dbt för att spåra hur data transformeras från Bronze till Silver. Kvalitetskontroller implementeras typiskt med dbt-tester, Great Expectations eller Soda, medan styrning upprätthålls via en datakatalog som Databricks Unity Catalog eller Collibra.
Om du vill lära dig hur du förvandlar rörig data till ordentliga silver-dataset rekommenderar jag att börja med vår kurs Cleaning Data in Python.
Det sista lagret i arkitekturen lagrar data med högsta möjliga kvalitet. Denna högförädlade data används för affärsrapportering i Power BI, Tableau eller Looker, konsumeras av nedströms analytiska applikationer eller serveras till maskininlärningsmodeller via en feature store som Feast eller Databricks Feature Store.
Eftersom datan redan är städad fokuserar detta steg på att göra den till en värdefull affärstillgång. Beroende på det specifika användningsfallet (tänk finansiella rapporter, marknadsföringsdashboards, varningssystem, ML-träning, …), säkerställer transformationerna efter Silver att Gold innehåller exakt den information som behövs för uppgiften.
Här skapar du KPI:er, tillämpar anpassade affärsformler eller aggregerar till veckovisa, månatliga eller kvartalsvisa data för schemalagd rapportering. Medan Bronze- och Silver-operationer ofta är gemensamma är Gold-lagrets operationer mer flexibla och anpassade efter hur du vill använda denna data.
Att bevara rådata i Bronze lönar sig bara om du faktiskt kan använda den, och det sker när något uppströms eller nedströms ändras. Kostnaden för en ändring beror på hur långt längs kedjan den sitter.
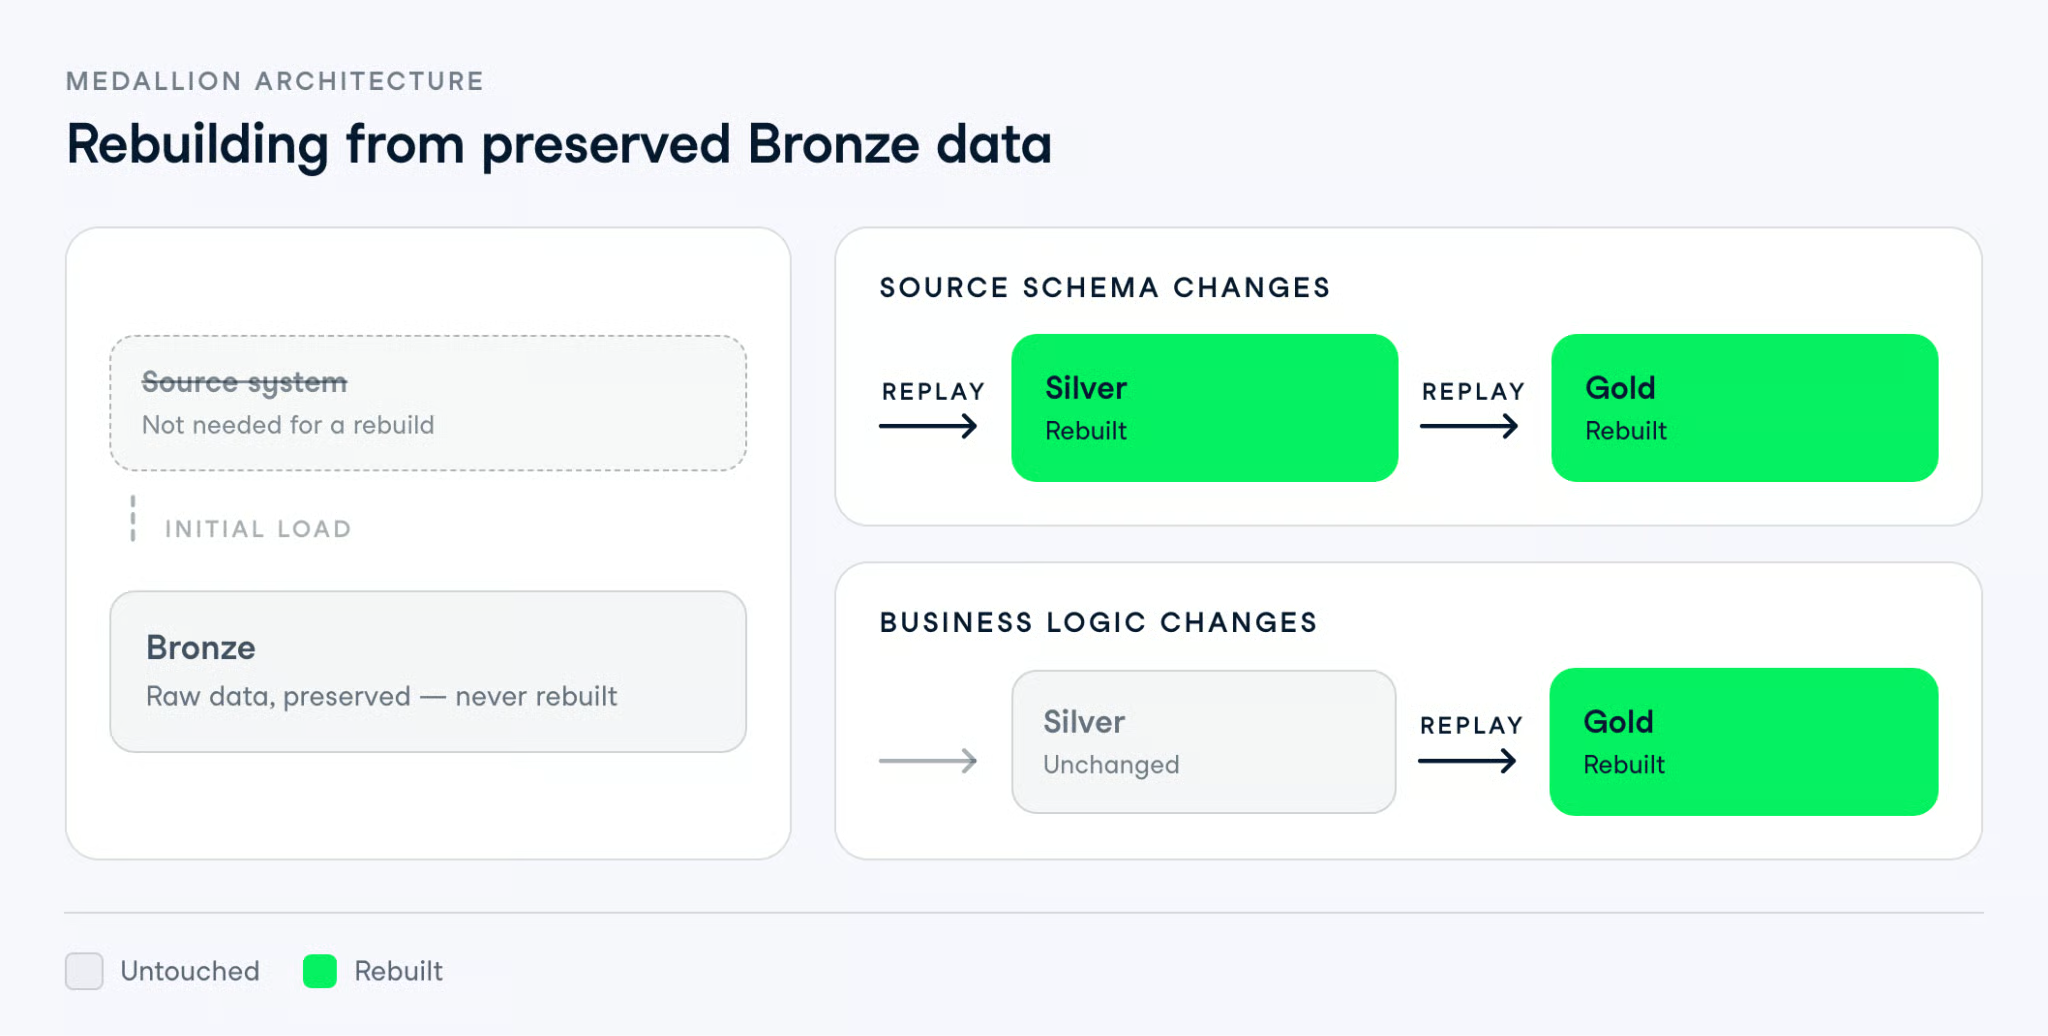
I inget av fallen går du tillbaka till källsystemet. Det är det som gör historiska rättelser möjliga överhuvudtaget, eftersom källan kanske inte längre innehåller datan i den form du ursprungligen läste in den.
Det betyder också att du kan ändra en metric-definition utan att köra om ingestion, vilket är den praktiska anledningen till att team med många Gold-konsumenter håller lagren åtskilda.
Ett data lakehouse ger dig billig objektlagring som ett datalake med de transaktionella garantierna från ett lager. Det säger inget om hur du ordnar tabellerna inuti. Det är luckan som medallion fyller: lakehouse är lagringssubstratet, och Bronze, Silver och Gold är hur du delar upp det i kataloger, scheman och tabeller med olika kvalitetsgarantier.
I praktiken är den uppdelningen oftast fysisk. På Databricks kan du ha tre scheman i en Unity Catalog-katalog, och i Microsoft Fabric ett lakehouse med Bronze- och Silver-tabeller som matar ett Gold-warehouse. Samma mönster, olika rördragning.
Öppna tabellformat är det som får lagren att hålla för samtidiga läsningar och skrivningar. Delta Lake, Apache Iceberg och Apache Hudi erbjuder vart och ett någon kombination av:
Versioneringen är viktigast för det uppspelningsbeteende vi just gick igenom. Råa Parquet-filer bevarar din källdata bra, men de ger dig ingen transaktionshistorik att rulla tillbaka till, så en dålig Silver-körning skriver över den bra, och du har inget att jämföra med. Delta Lake spårar förändringar i en transaktionslogg, medan Apache Iceberg representerar tabelltillstånd som snapshots.
Inget av detta är obligatoriskt. Medallion är ett logiskt mönster, och många team kör det på Postgres-scheman eller vanliga S3-prefix med dbt ovanpå. Du förlorar bara den billiga rollbacken.
Dessa två jämförs ofta, vanligtvis för att man antar att de konkurrerar. De besvarar olika frågor: data mesh avgör vem som äger data, och medallion-arkitekturen avgör hur den ägaren förädlar den.
Data mesh lägger ansvaret för data hos domänteam som sälj, finans eller supply chain, som publicerar sin data som produkter och äger dess kvalitet, upptäckbarhet, härledning och styrning. Två saker håller det samman: självbetjäningsinfrastruktur som ger varje domän samma verktyg, och federerad styrning som sätter organisationstäckande standarder utan att ta ifrån domänerna ägarskapet.
Medallion-arkitektur är vad ett domänteam kör inom sin egen del. Ett supply chain-team som äger leveransdata behåller råa leveranshändelser i Bronze, validerade poster i Silver och publicerar analysklara leveransdataset i Gold för andra domäner att konsumera. Mesh definierar kontraktet vid Gold-gränsen; allt uppströms om den är det teamets ensak.
En brasklapp innan du kombinerar dem: domänvisa Bronze-lager betyder att varje domän bär sin egen ingest- och lagringskostnad, och delade dimensioner som kund eller produkt tenderar att bli återuppbyggda på tre ställen. Mesh-förespråkare skulle säga att det är priset för ägarskap. Det är fortfarande en verklig kostnad, och värd att prissätta innan du förbinder dig.
Medallion ger dig återanvändning och återställningsbarhet, och tar betalt i form av lagring, latens och antal pipelines. Om den byteshandeln lönar sig beror nästan helt på hur många konsumenter du har.
Latensen är den lättaste att underskatta. Varje lager är vanligtvis sitt eget schemalagda jobb, så en trelagers batch-pipeline som körs varje timme kan lämna Gold två timmar efter källsystemet. Det är okej för en veckovis intäktsrapport och inte okej för en operativ varning, vilket är varför team ofta låter varningar läsa Silver direkt istället för att vänta på Gold.
Lagring är den kostnad folk tar upp först, och den är oftast det mindre problemet. Bronze ligger i billig objektlagring, och dupliceringen är verklig men begränsad. Antalet pipelines är det som faktiskt gör ont: tre lager över tjugo källtabeller är sextio saker som potentiellt kan fallera klockan tre på morgonen.
Ställt mot det har dålig datakvalitet sin egen nota. IBM rapporterade 2026 att 43% av COO:er angav datakvalitet som sin viktigaste dataprioritet, baserat på 2025 års forskning från dess Institute for Business Value. Mer än en fjärdedel av organisationerna i den studien rapporterade årliga förluster från dålig datakvalitet som översteg 5 miljoner dollar.
Så frågan är inte om implementering av en medallion-arkitektur kostar mer än en enda pipeline, för det gör den. Frågan är om du redan betalar för alternativet i avstämningsmöten och instrumentpaneler som ingen litar på.
Medallion lönar sig när samma rensade data tjänar mer än en konsument. Det är den enskilt bästa indikatorn, före datavolymer, teamstorlek eller hur många källor du hämtar från.
Använd medallion-arkitektur när:
Hoppa över när:
Diagrammet med tre lager är ett standardläge, inte ett krav. Med ett enda affärsanvändningsfall är Bronze plus ett kombinerat lager ofta rätt val: bevara rådata för uppspelning och gör sedan städning och affärslogik i ett steg.
Välj den form som matchar dina konsumenter. Det du inte bör slå ihop är Bronze, eftersom det är lagret du inte kan återskapa.
Så om du är mitt emellan och ärligt talat inte kan avgöra, är det en bra väg att bygga två lager och lägga till det tredje när en andra konsument dyker upp. Att lägga till Gold senare är mycket billigare än att i efterhand försöka få till Bronze efter att du skrivit över din rådata i sex månader.
De flesta medallion-problem är inte arkitektoniska. De är små kompromisser under tidspress som tyst tar bort anledningen till att du byggde lagren från första början.
Hela uppspelningsargumentet vilar på att Bronze håller något som ligger nära det källan faktiskt skickade. Tillämpa affärslogik innan du landar den, och du har förlorat ursprungstillståndet, vilket betyder ingen reprocessning och inget revisionsspår.
Detta händer oftast av goda skäl. Någon tar bort en kolumn som ingen använder för att spara utrymme, eller tvingar ett stökigt tidsstämpelsfält vid ingestion eftersom det bryter nästa jobb. Sex månader senare visar det sig att den oanvända kolumnen spelar roll, och de ursprungliga värdena är borta. Håll Bronze så nära källan som du praktiskt kan, och lägg fixarna i Silver.
Silver städar och standardiserar. Gold besvarar affärsfrågor. När metric-logik läcker in i Silver ärver varje Gold-dataset en definition som det inte bett om, och du är tillbaka i problemet som medallion var tänkt att lösa.
Testet är enkelt: om en affärsanvändare argumenterar om siffran hör den hemma i Gold. Avdubblering är en Silver-fråga. Vad som räknas som en aktiv kund är det inte.
Medallion-arkitektur är ett logiskt designmönster, inte ett krav på att varje pipeline ska innehålla exakt tre fysiska lager. Bronze, Silver och Gold representerar logiska steg av dataförädling, och varje lager kan implementeras olika beroende på arbetslast.
Till exempel kan ett lager använda materialiserade tabeller, vyer eller andra lämpliga abstraktioner istället för att kräva en separat fysisk kopia av datan. Poängen är att skapa meningsfulla gränser när data rör sig från sitt råa tillstånd mot något som verksamheten kan lita på och använda, snarare än att exakt reproducera det klassiska trelagersdiagrammet.
Detta är det jag ser mest, och det diskuteras minst. Gold-dataset är billiga att skapa, och ingen raderar dem någonsin, så efter ett år kan du ha fyrtio tabeller, elva av dem varianter på månadsintäkter, och ingen minns vilken CFO:n faktiskt tittar på.
Silver har naturlig disciplin eftersom dess uppdrag är definierat. Gold har det inte, så det behöver en ägare per dataset och en vilja att radera. Utan det slutar du med flera konkurrerande versioner av samma metric, vilket är ett av problemen som lagren var tänkta att förhindra.
Vad medallion faktiskt ger dig är en plats att peka på när någon frågar var en siffra kom ifrån, och en kopia av den ursprungliga datan att gå tillbaka till när svaret visar sig vara fel. Det är värt den extra lagringen och de extra jobben när flera team läser samma data. När bara ett team gör det kan två lager vara den bättre lösningen och spara dig underhåll.
Om du vill ha den bredare kontexten kring var detta mönster hör hemma täcker vår kurs Understanding Modern Data Architecture plattformarna och teknikerna bakom moderna datastackar. Vår Data Engineer-karriärväg går längre in på att bygga och underhålla produktionspipelines.
Lär dig data engineering med DataCamp!
course
course
track