course
Understanding Modern Data Architecture
2 घंटा
23.9K
अधिकांश चर्चाएँ डेटा गुणवत्ता पर खराब सोर्स डेटा को ठीक करने पर केंद्रित रहती हैं। लेकिन अलग-अलग डेटा टीमें एक ही सोर्स सिस्टम से पाँच बिल्कुल अलग डैशबोर्ड बना सकती हैं—एक ही तिमाही के लिए अलग-अलग राजस्व संख्याओं के साथ। यहाँ समस्या जरूरी नहीं कि सोर्स डेटा हो। हर उपभोक्ता डेटा को अपने-अपने हिसाब से साफ़, जोड़, फ़िल्टर और परिभाषित कर रहा हो सकता है—इस बात पर कोई साझा मानक नहीं कि “साफ़” का अर्थ क्या है।
मेडेलियन आर्किटेक्चर इस समस्या को इस तरह सुलझाता है कि यह डेटा टीमों को डेटा गुणवत्ता सुधारने के स्पष्ट दायरे देता है—बिना उस कच्चे डेटा को खोए जिससे वे शुरू हुए थे। आइए देखें यह क्या है, कैसे काम करता है, और डेटा इंजीनियरिंग व MLOps में यह इतना महत्वपूर्ण सिद्धांत क्यों है।
हमारा Understanding Modern Data Architecture कोर्स दिखाता है कि लेकहाउस और लेयर्ड पाइपलाइन्स व्यापक डेटा स्टैक में कहाँ फिट होते हैं। और हमारा Data Engineer करियर ट्रैक वे व्यापक पाइपलाइन कौशल सिखाता है जो इन परतों को प्रोडक्शन में टिकाऊ बनाते हैं।
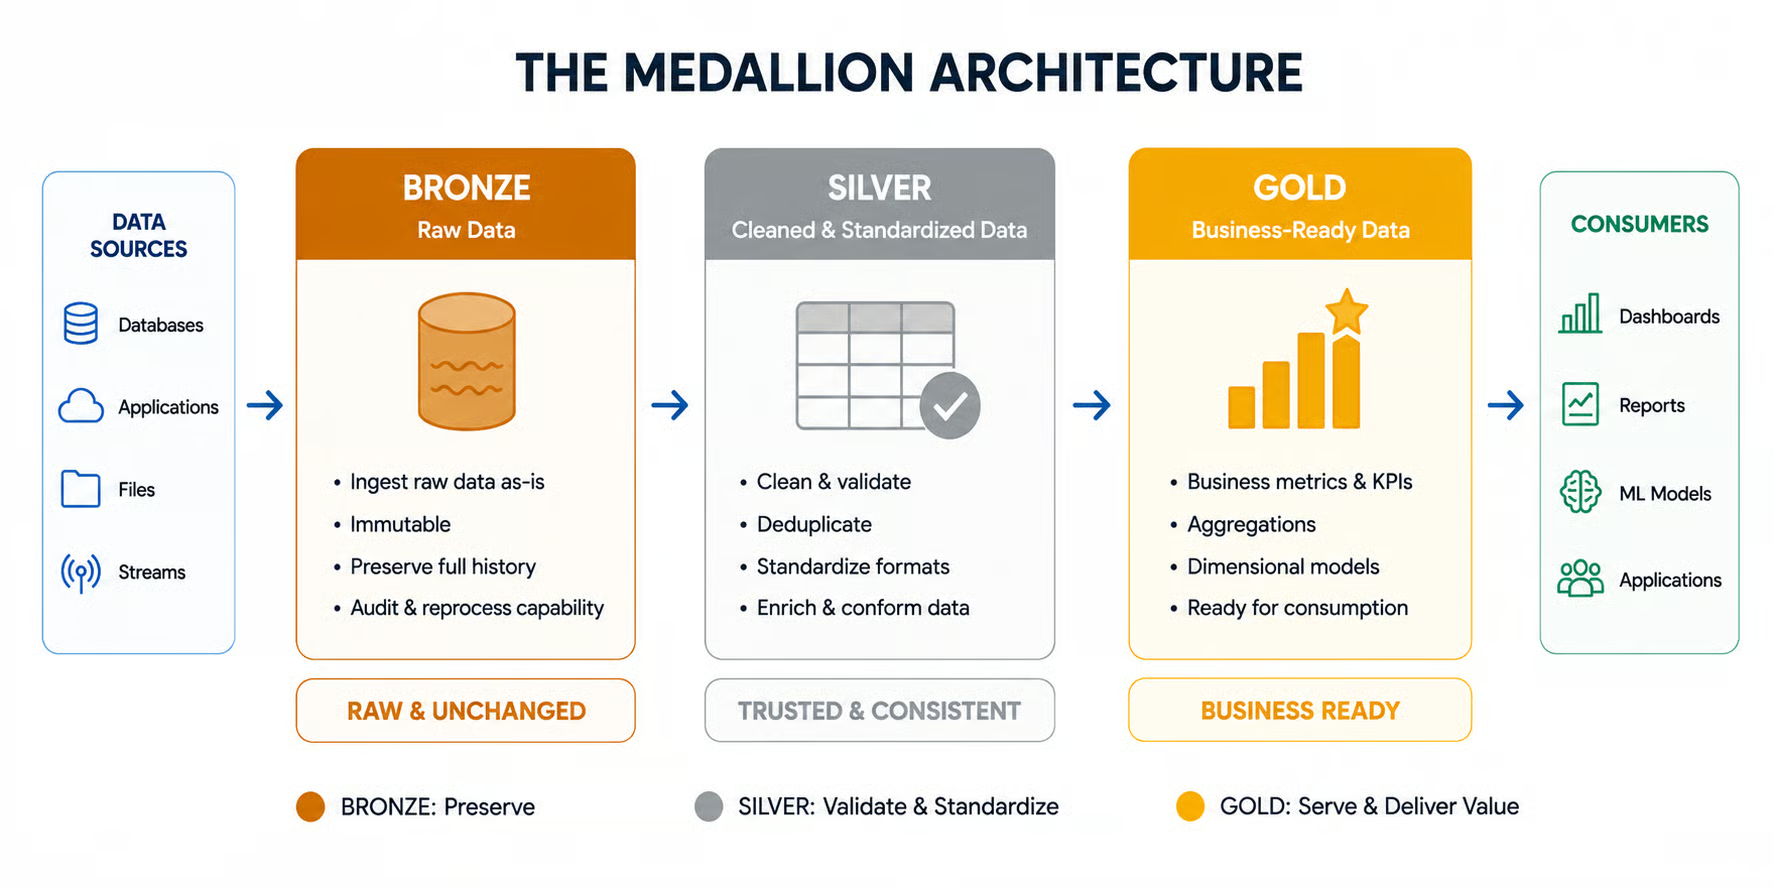
मेडेलियन आर्किटेक्चर एक डेटा डिज़ाइन पैटर्न है जो डेटा लेकहाउस में डेटा को तार्किक रूप से व्यवस्थित करता है। यह 3 परतों का एक सेट परिभाषित करता है, जहाँ डेटा गुणवत्ता और संरचना इन परतों से गुजरते समय बेहतर होती जाती है:
पारंपरिक एक्सट्रैक्ट-ट्रांसफ़ॉर्म-लोड (ETL) पाइपलाइन्स वाले डेटा वेयरहाउस में, आपको अपने डेटा की स्कीमा पहले से तय करनी पड़ती है। यदि आपके डेटा का फ़ॉर्मैट या स्कीमा बदलता है, तो जब तक आप सिस्टम को मैन्युअल रूप से समायोजित नहीं करते, वह असफल हो जाएगा।
मेडेलियन-आधारित एक्सट्रैक्ट-लोड-ट्रांसफ़ॉर्म (ELT) आर्किटेक्चर में, आप डेटा को पहले उसकी कच्ची अवस्था में सहेजते हैं, बजाय इसके कि चलते-फिरते ट्रांसफ़ॉर्म कर अंतिम डेटा ही स्टोर करें। यह अंतर मेडेलियन-आधारित आर्किटेक्चर्स को मज़बूत और लचीला बनाता है: आप कच्चा डेटा वैसा-का-वैसा स्टोर कर सकते हैं और बाद में तय कर सकते हैं कि उसका इस्तेमाल कैसे करना है।
दोनों अवधारणाओं की पूरी तुलना के लिए, मैं हमारी ETL बनाम ELT गाइड पढ़ने की सलाह देता/देती हूँ।
मेडेलियन आर्किटेक्चर का एक और लाभ इसकी प्लेटफ़ॉर्म-एग्नॉस्टिक प्रकृति है। ब्रॉन्ज़, सिल्वर और गोल्ड तार्किक चरण हैं—किसी विशिष्ट विक्रेता की तकनीक नहीं। आप अपने डेटा प्लेटफ़ॉर्म और वर्कलोड आवश्यकताओं के अनुसार अलग-अलग स्टोरेज सिस्टम, प्रोसेसिंग इंजन और टेबल फ़ॉर्मैट के साथ इस पैटर्न को लागू कर सकते हैं।
|
फ़ीचर |
मेडेलियन (ELT) |
पारंपरिक ETL |
|
कच्चा डेटा |
सुरक्षित रहता है |
हट जाता है |
|
स्कीमा |
बाद में तय, सिल्वर में लागू |
लक्ष्य पर पहले से परिभाषित |
|
रीप्रोसेसिंग |
सुरक्षित कच्चे डेटा से पुन:प्रक्रिया |
सोर्स डेटा को फिर निकालना पड़ सकता है |
|
ट्रांसफ़ॉर्म का समय |
लोड के बाद |
लोड से पहले |
|
डेटा परिष्करण |
परतों में क्रमिक |
मुख्यतः लक्ष्य तक पहुँचने से पहले |
तीनों मेडेलियन परतें तार्किक क्रम में आती हैं, जहाँ हर अगली परत पिछली पर बनती है।
यहीं कच्चा डेटा जस-का-तस उतरता है—चाहे वह रिलेशनल डेटाबेस हों, Salesforce जैसे SaaS एप्लिकेशन, रियल-टाइम इवेंट ले जाने वाले Kafka टॉपिक्स, REST APIs, CSV एक्सपोर्ट्स या IoT डिवाइस स्ट्रीम्स। इनजेशन आम तौर पर ऐसे टूल्स से संभाला जाता है जैसे Fivetran (चेंज डेटा कैप्चर के लिए) या Databricks Auto Loader (ऑब्जेक्ट स्टोरेज में आने वाली फ़ाइलों के लिए)।
ब्रॉन्ज़ डेटा में अक्सर काफी त्रुटियाँ, असंगतियाँ और डुप्लीकेट होते हैं, इसलिए इसे कभी भी सीधे व्यावसायिक उद्देश्यों के लिए इस्तेमाल नहीं करना चाहिए। फिर भी, यह परत एक रिकवरी प्वाइंट के रूप में बहुत मूल्यवान है, जहाँ से आप सिल्वर या गोल्ड डेटा फिर से बना सकते हैं।
इस परत का महत्व उसके फ़ुटप्रिंट में है: यह हर इनजेशन इवेंट या ट्रांज़ैक्शन को रिकॉर्ड और लॉग करती है। इसमें अक्सर मूल्यवान मेटाडेटा होता है—जैसे इनजेशन टाइमस्टैम्प, डेटा के स्रोत और तरह-तरह के आइडेंटिफ़ायर्स। लक्ष्य है डेटा को यथासंभव कच्चे और पूर्ण रूप में सहेजना, ताकि आप वही सोर्स डेटा इस्तेमाल कर डाउनस्ट्रीम पाइपलाइन्स को फिर से चला सकें और बग्स को डिबग कर सकें।
सिल्वर परत कच्चे डेटा को साफ़, संरचित डेटा में रूपांतरित करती है। ब्रॉन्ज़ और सिल्वर के बीच होने वाले कुछ महत्वपूर्ण क्लीनिंग ट्रांसफ़ॉर्मेशन्स के उदाहरण:
यह परत स्कीमा एन्फोर्समेंट भी शामिल करती है, जो सुनिश्चित करता है कि डेटा पूर्व-परिभाषित संरचना का पालन करे और स्कीमा इवोल्यूशन का समर्थन करे।
यहीं आप डेटा क्वालिटी चेक भी संभालते हैं। उदाहरण के लिए, असफल बिज़नेस ट्रांज़ैक्शन्स या आउटलायर्स को फ़्लैग या रिजेक्ट करने के नियम जोड़ें। जैसे-जैसे डेटा चरणों से गुजरता है, यह गुणवत्ता सुधार का पहला कदम होता है।
क्योंकि इस चरण में डेटा संशोधित होता है, यह महत्वपूर्ण है कि डेटा लिनिएज टूल्स जैसे dbt का उपयोग करके ट्रैक करें कि डेटा ब्रॉन्ज़ से सिल्वर में कैसे बदला। क्वालिटी चेक आमतौर पर dbt टेस्ट्स, Great Expectations या Soda से लागू किए जाते हैं, जबकि गवर्नेंस को डेटा कैटलॉग जैसे Databricks Unity Catalog या Collibra के माध्यम से लागू किया जाता है।
यदि आप सीखना चाहते हैं कि बिखरे-उलझे डेटा को सही सिल्वर डेटासेट्स में कैसे बदलें, तो मैं हमारे Cleaning Data in Python कोर्स से शुरू करने की सलाह देता/देती हूँ।
आर्किटेक्चर की अंतिम परत डेटा को संभवतः सर्वोच्च गुणवत्ता पर संग्रहीत करती है। यह अत्यधिक परिष्कृत डेटा बिज़नेस रिपोर्टिंग में Power BI, Tableau या Looker में उपयोग होता है, डाउनस्ट्रीम एनालिटिकल एप्लिकेशन्स द्वारा उपभोग किया जाता है, या Feast या Databricks Feature Store जैसे फ़ीचर स्टोर के माध्यम से मशीन लर्निंग मॉडलों को उपलब्ध कराया जाता है।
क्योंकि डेटा पहले से ही साफ़ है, यह चरण उसे मूल्यवान व्यावसायिक संपत्ति में बदलने पर केंद्रित है। विशिष्ट उपयोग-प्रकरण के अनुसार (जैसे वित्तीय रिपोर्ट्स, मार्केटिंग डैशबोर्ड, अलर्ट सिस्टम्स, ML मॉडल प्रशिक्षण, …), सिल्वर के बाद होने वाले ट्रांसफ़ॉर्म सुनिश्चित करते हैं कि गोल्ड में ठीक वही जानकारी हो जो मौजूदा कार्य के लिए चाहिए।
यहीं आप KPIs बनाते हैं, कस्टम बिज़नेस फ़ॉर्मूलाज़ लागू करते हैं, या निर्धारित रिपोर्टिंग के लिए साप्ताहिक, मासिक, या त्रैमासिक स्तर पर एग्रीगेट करते हैं। जहाँ ब्रॉन्ज़ और सिल्वर के ऑपरेशन्स अक्सर सामान्य होते हैं, वहीं गोल्ड परत के ऑपरेशन्स ज़्यादा लचीले और आपके उपयोग के अनुरूप कस्टम होते हैं।
ब्रॉन्ज़ में कच्चा डेटा सहेजना तभी कारगर है जब आप वास्तव में उसका उपयोग कर सकें—और ऐसा तब होता है जब अपस्ट्रीम या डाउनस्ट्रीम कुछ बदलता है। बदलाव की लागत इस पर निर्भर करती है कि वह श्रृंखला में कितनी आगे बैठा है।
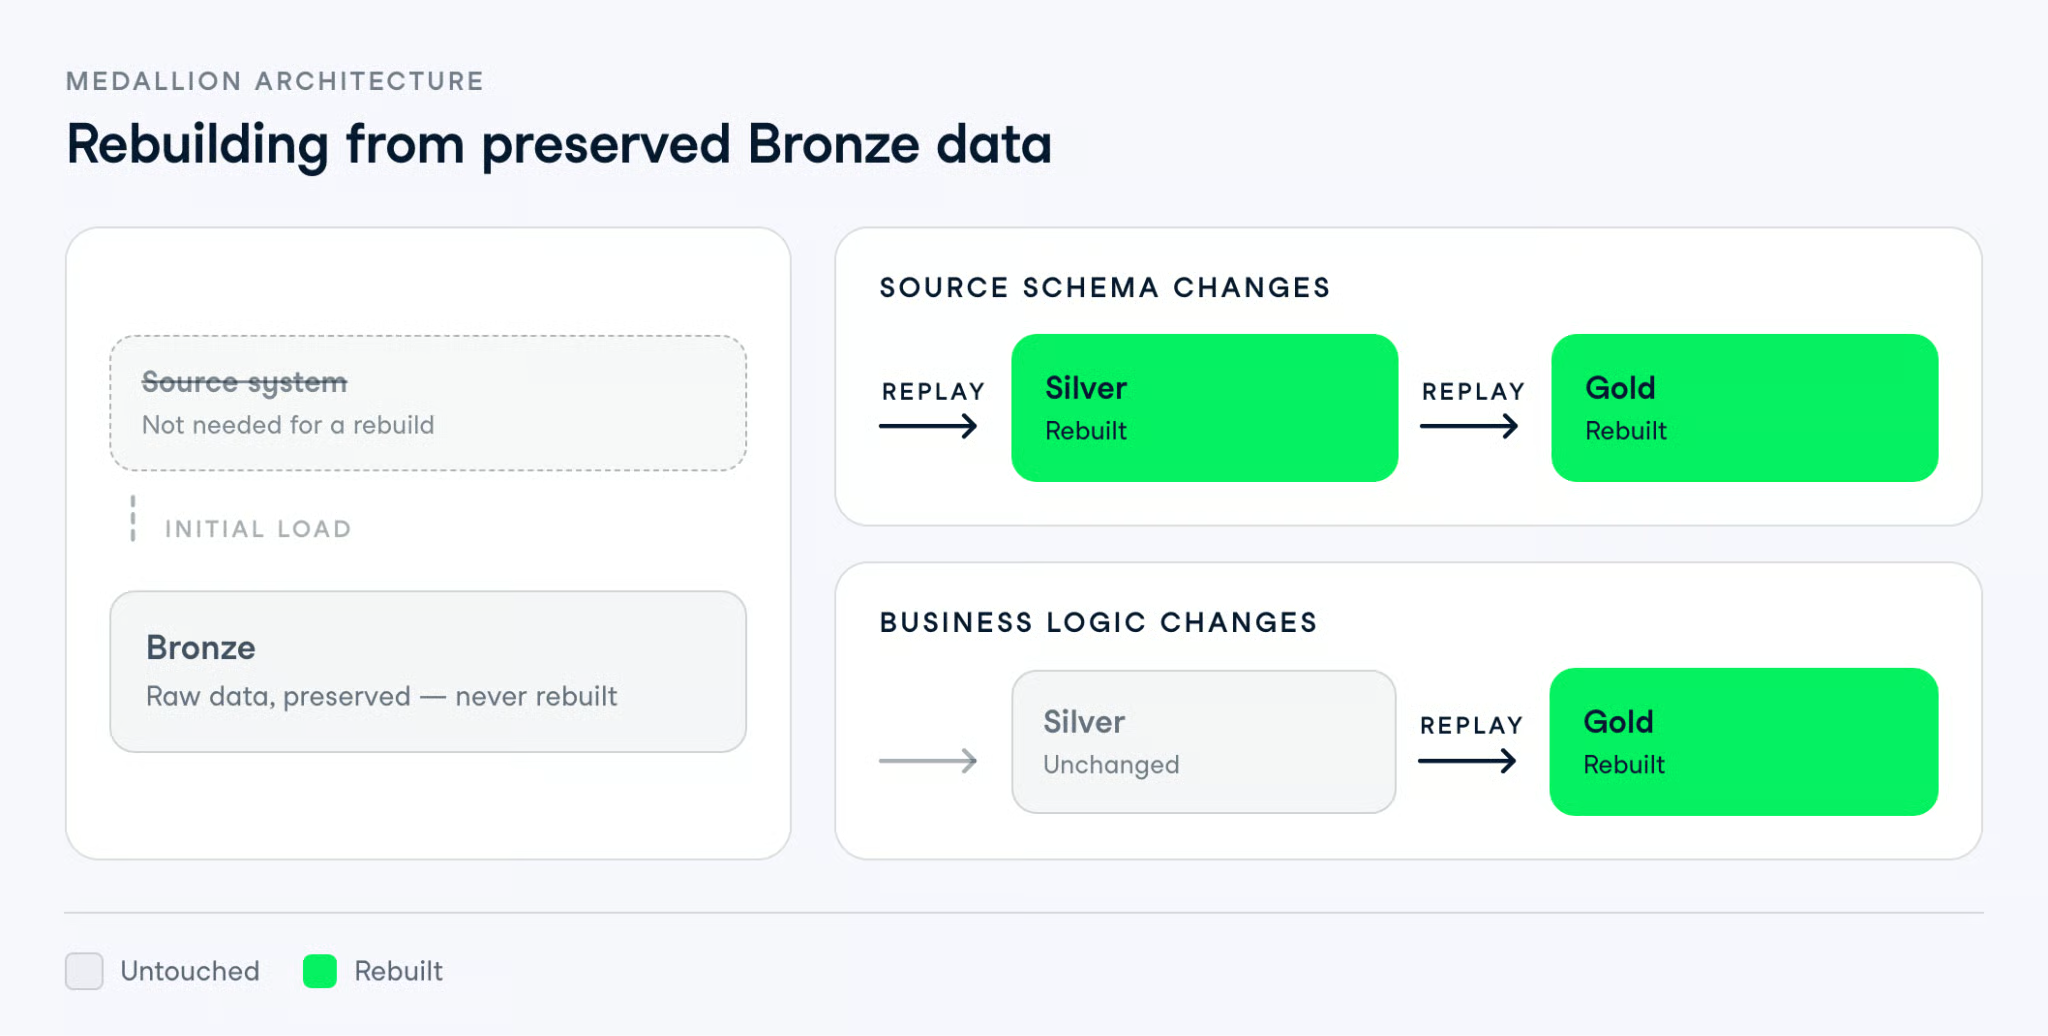
किसी भी स्थिति में आप सोर्स सिस्टम पर वापस नहीं जाते। यही ऐतिहासिक सुधारों को संभव बनाता है, क्योंकि सोर्स में डेटा अब उस रूप में मौजूद न हो सकता है जैसा आपने मूल रूप से इनजेस्ट किया था।
इसका यह भी मतलब है कि आप किसी मीट्रिक की परिभाषा बदल सकते हैं—बिना इनजेशन को फिर चलाए—जो व्यावहारिक कारण है कि जिन टीमों के पास कई गोल्ड उपभोक्ता होते हैं वे परतों को अलग रखती हैं।
एक डेटा लेकहाउस आपको डेटा लेक का सस्ता ऑब्जेक्ट स्टोरेज और वेयरहाउस की ट्रांज़ैक्शनल गारंटियाँ देता है। यह इस बारे में कुछ नहीं कहता कि उसके अंदर टेबल्स कैसे व्यवस्थित हों। यही गैप मेडेलियन भरता है: लेकहाउस स्टोरेज सब्सट्रेट है, और ब्रॉन्ज़, सिल्वर, गोल्ड वे तरीके हैं जिनसे आप उसे अलग-अलग गुणवत्ता गारंटियों वाले कैटलॉग्स, स्कीमाज़ और टेबल्स में बाँटते हैं।
व्यवहार में, यह बँटवारा आमतौर पर भौतिक होता है। Databricks पर, आपके पास Unity Catalog के भीतर तीन स्कीमाज़ हो सकती हैं, और Microsoft Fabric में, एक लेकहाउस जिसमें ब्रॉन्ज़ और सिल्वर टेबल्स गोल्ड वेयरहाउस को फ़ीड कर रही हों। पैटर्न वही है, पाइपलाइन अलग।
ओपन टेबल फ़ॉर्मैट्स ही हैं जो एक साथ रीड्स और राइट्स के दौरान परतों को टिकाए रखते हैं। Delta Lake, Apache Iceberg और Apache Hudi प्रत्येक निम्नलिखित का कुछ संयोजन देते हैं:
वर्ज़निंग का महत्व सबसे ज़्यादा उसी रीप्ले व्यवहार के लिए है जिसकी हम अभी चर्चा कर चुके हैं। साधारण Parquet फ़ाइलें आपका सोर्स डेटा तो बचा लेती हैं, लेकिन वे कोई ट्रांज़ैक्शनल हिस्ट्री नहीं देतीं—ताकि आप रोल बैक कर सकें। नतीजा यह कि कोई खराब सिल्वर रन अच्छे वाले को ओवरराइट कर देता है और तुलना के लिए कुछ नहीं बचता। Delta Lake एक ट्रांज़ैक्शन लॉग में बदलाव ट्रैक करता है, जबकि Apache Iceberg टेबल स्टेट्स को स्नैपशॉट्स के रूप में दर्शाता है।
इनमें से कुछ भी अनिवार्य नहीं है। मेडेलियन एक तार्किक पैटर्न है, और कई टीमें इसे Postgres स्कीमाज़ या साधारण S3 प्रीफ़िक्सेज़ पर dbt के साथ चलाती हैं। बस सस्ता रोलबैक खो जाता है।
इन दोनों की अक्सर तुलना होती है, आमतौर पर इसलिए कि लोग मान लेते हैं कि ये प्रतिस्पर्धी हैं। ये अलग सवालों का जवाब देते हैं: डेटा मेष तैय करता है कौन डेटा का मालिक है, और मेडेलियन आर्किटेक्चर तय करता है कैसे वह मालिक उसे परिष्कृत करता है।
डेटा मेष बिक्री, वित्त या सप्लाई चेन जैसी डोमेन टीमों को डेटा की ज़िम्मेदारी देता है—जो अपने डेटा को प्रोडक्ट्स की तरह प्रकाशित करती हैं और उसकी गुणवत्ता, डिस्कवरैबिलिटी, लिनिएज और गवर्नेंस की मालिक होती हैं। इसे दो बातें साधती हैं: सेल्फ़-सर्विस इंफ्रास्ट्रक्चर जो हर डोमेन को एक जैसा टूलिंग देता है, और फ़ेडरेटेड गवर्नेंस जो संगठन-व्यापी मानक तय करता है—बिना डोमेन्स से स्वामित्व छीने।
मेडेलियन आर्किटेक्चर वह है जो कोई डोमेन टीम अपनी सीमा के भीतर चलाती है। शिपमेंट डेटा की मालिक सप्लाई चेन टीम ब्रॉन्ज़ में कच्चे शिपमेंट इवेंट्स रखती है, सिल्वर में वैलिडेटेड रिकॉर्ड्स, और गोल्ड में एनालिटिक्स-रेडी शिपमेंट डेटासेट्स प्रकाशित करती है ताकि अन्य डोमेन्स उन्हें उपभोग कर सकें। मेष गोल्ड की सीमा पर कॉन्ट्रैक्ट तय करता है; उसके अपस्ट्रीम सब कुछ उस टीम का मामला है।
उन्हें मिलाने से पहले एक चेतावनी: प्रति-डोमेन ब्रॉन्ज़ परतों का मतलब है कि हर डोमेन अपना इनजेशन और स्टोरेज ख़र्च उठाता है, और कस्टमर या प्रोडक्ट जैसी साझा डाइमेंशन्स तीन-तीन जगह फिर से बनती रहती हैं। मेष समर्थक कहेंगे यह स्वामित्व की क़ीमत है। यह फिर भी वास्तविक लागत है—कमिट करने से पहले इसकी कीमत लगाना चाहिए।
मेडेलियन आपको पुन:उपयोग और रिकवर करने की क्षमता देता है, और बदले में स्टोरेज, लैटेंसी और पाइपलाइन गिनती की कीमत लेता है। यह सौदा फायदे का है या नहीं—यह लगभग पूरी तरह इस पर निर्भर करता है कि आपके पास कितने उपभोक्ता हैं।
लैटेंसी वाला पहलू सबसे आसानी से कम आंका जाता है। हर परत आमतौर पर अपना अलग शेड्यूल्ड जॉब होती है, तो एक तीन-परती बैच पाइपलाइन जो प्रति घंटा चलती है, गोल्ड को सोर्स सिस्टम से दो घंटे पीछे छोड़ सकती है। यह साप्ताहिक रेवेन्यू रिपोर्ट के लिए ठीक है, लेकिन ऑपरेशनल अलर्ट के लिए ठीक नहीं—इसीलिए टीमें अक्सर अलर्टिंग को गोल्ड का इंतज़ार करने के बजाय सीधे सिल्वर से पढ़ने देती हैं।
लोग सबसे पहले स्टोरेज लागत उठाते हैं, और यह आम तौर पर छोटा मुद्दा होता है। ब्रॉन्ज़ सस्ते ऑब्जेक्ट स्टोरेज में रहता है, और डुप्लीकेशन वास्तविक है पर सीमित। असल चोट पाइपलाइन काउंट से लगती है: बीस सोर्स टेबल्स पर तीन परतें—यानी साठ चीज़ें जो रात 3 बजे फेल हो सकती हैं।
इसके बरअक्स, खराब डेटा गुणवत्ता की अपनी कीमत होती है। IBM ने 2026 में रिपोर्ट किया कि 43% COOs ने डेटा गुणवत्ता को अपनी सबसे महत्वपूर्ण डेटा प्राथमिकता बताया, अपने Institute for Business Value के 2025 के शोध पर आधारित। उस अध्ययन में एक चौथाई से अधिक संगठनों ने बताया कि खराब डेटा गुणवत्ता से उनकी वार्षिक हानियाँ $5 मिलियन से अधिक रहीं।
तो सवाल यह नहीं है कि मेडेलियन आर्किटेक्चर लागू करना एक अकेली पाइपलाइन से ज़्यादा खर्चीला है या नहीं—क्योंकि है। सवाल यह है कि क्या आप पहले से ही विकल्प की कीमत चुका रहे हैं—रिकंसिलिएशन मीटिंग्स और ऐसे डैशबोर्ड्स में जिन पर कोई भरोसा नहीं करता।
मेडेलियन तब अपना मूल्य सिद्ध करता है जब वही साफ़ किया गया डेटा एक से अधिक उपभोक्ताओं की सेवा करता है। यही सबसे अच्छा सूचक है—डेटा वॉल्यूम, टीम साइज़ या आप कितने सोर्सेज़ से खींचते हैं—इन सबसे पहले।
इन स्थितियों में मेडेलियन आर्किटेक्चर अपनाएँ:
इनमें छोड़ दें:
तीन-परतों वाला आरेख डिफ़ॉल्ट है, नियम नहीं। एक अकेले व्यावसायिक उपयोग-प्रकरण में, ब्रॉन्ज़ + एक संयुक्त परत अक्सर सही विकल्प है: रीप्ले के लिए कच्चा डेटा सुरक्षित रखें, फिर एक ही चरण में साफ़-सफ़ाई और बिज़नेस लॉजिक करें।
वह आकार चुनें जो आपके उपभोक्ताओं से मेल खाता हो। जिसे आपको नहीं समेटना चाहिए, वह है ब्रॉन्ज़—क्योंकि वही परत है जिसे आप दोबारा नहीं बना सकते।
इसलिए यदि आप बीच में हैं और ईमानदारी से तय नहीं कर पा रहे, तो दो परतें बनाना और तीसरी तब जोड़ना जब दूसरा उपभोक्ता आए—अच्छा रास्ता है। बाद में गोल्ड जोड़ना, छह महीने तक कच्चे डेटा को ओवरराइट करने के बाद ब्रॉन्ज़ को रेट्रोफ़िट करने से कहीं सस्ता है।
अधिकांश मेडेलियन समस्याएँ आर्किटेक्चरल नहीं होतीं। वे छोटी-छोटी रियायतें होती हैं—डेडलाइन के दबाव में—जो चुपचाप वही वजह हटा देती हैं जिसके लिए आपने परतें बनाईं थीं।
पूरा रीप्ले तर्क इस पर टिका है कि ब्रॉन्ज़ में वह कुछ हो जो सोर्स ने वास्तव में भेजा था। उसे लैंड कराने से पहले बिज़नेस लॉजिक लगा देंगे, तो आपने मूल स्टेट खो दी—मतलब न रीप्रोसेसिंग होगी, न ऑडिट ट्रेल।
यह आमतौर पर सही कारणों से होता है। कोई अनयूज़्ड कॉलम जगह बचाने के लिए हटा देता है, या इनजेशन पर गड़बड़ टाइमस्टैम्प फ़ील्ड को बाध्य करता है क्योंकि वह अगला जॉब बिगाड़ती है। छह महीने बाद, वही “अनयूज़्ड” कॉलम महत्वपूर्ण निकलता है—और मूल मान गायब। ब्रॉन्ज़ को जितना हो सके सोर्स के क़रीब रखें, और सुधार सिल्वर में करें।
सिल्वर साफ़ करता है और मानकीकृत करता है। गोल्ड व्यावसायिक प्रश्नों का उत्तर देता है। जब मीट्रिक लॉजिक सिल्वर में रिसने लगता है, तो हर गोल्ड डेटासेट एक ऐसी परिभाषा विरासत में ले लेता है जिसकी उसे माँग नहीं थी—और आप फिर उसी समस्या पर लौट आते हैं जिसे मेडेलियन सुलझाने आया था।
कसौटी सरल है: यदि कोई बिज़नेस यूज़र संख्या पर बहस करता है, तो वह गोल्ड में होनी चाहिए। डीडुप्लीकेशन—सिल्वर की चिंता है। “सक्रिय ग्राहक” किसे गिनें—यह नहीं।
मेडेलियन आर्किटेक्चर एक तार्किक डिज़ाइन पैटर्न है—यह अनिवार्य नहीं कि हर पाइपलाइन में ठीक तीन भौतिक परतें हों। ब्रॉन्ज़, सिल्वर और गोल्ड डेटा परिष्करण के तार्किक चरण हैं, और हर परत को वर्कलोड के अनुसार अलग ढंग से लागू किया जा सकता है।
उदाहरण के लिए, कोई परत अलग भौतिक प्रतिलिपि की माँग किए बिना मटीरियलाइज़्ड टेबल्स, व्यूज़ या अन्य उपयुक्त एब्स्ट्रैक्शन्स का उपयोग कर सकती है। बात यह है कि डेटा को उसकी कच्ची अवस्था से उस रूप तक ले जाते हुए अर्थपूर्ण सीमाएँ बनाई जाएँ जिस पर व्यवसाय भरोसा कर सके और उपयोग कर सके—न कि हर हाल में क्लासिक तीन-परतों वाले आरेख की हूबहू नकल की जाए।
यह सबसे ज़्यादा दिखता है—और सबसे कम चर्चा होती है। गोल्ड डेटासेट्स बनाना सस्ता है—और कोई उन्हें कभी हटाता नहीं—तो एक साल बाद आपके पास चालीस टेबल्स हो सकती हैं, जिनमें ग्यारह “मंथली रेवेन्यू” के अलग-अलग रूप, और किसी को याद नहीं कि CFO वास्तव में किसे देखता है।
सिल्वर में स्वाभाविक अनुशासन होता है—क्योंकि उसका काम परिभाषित है। गोल्ड में नहीं—इसलिए उसे प्रति डेटासेट एक मालिक और हटाने की इच्छाशक्ति चाहिए। बिना इसके, आप एक ही मीट्रिक के कई प्रतिस्पर्धी संस्करणों के साथ रह जाते हैं—और यह वही समस्या है जिसे परतें रोकने आई थीं।
मेडेलियन वस्तुतः आपको वह जगह देता है जहाँ आप इशारा कर सकें—जब कोई पूछे कि कोई संख्या कहाँ से आई—और मूल डेटा की एक प्रति जहाँ आप लौट सकें—जब जवाब ग़लत निकले। जब कई टीमें एक ही डेटा पढ़ती हैं, तो यह अतिरिक्त स्टोरेज और अतिरिक्त जॉब्स के काबिल है। जब केवल एक टीम पढ़ती है, तो दो परतें बेहतर समाधान हो सकती हैं—और कुछ मेंटेनेंस बचा सकती हैं।
यदि आप जानना चाहते हैं कि यह पैटर्न व्यापक परिदृश्य में कहाँ बैठता है, तो हमारा Understanding Modern Data Architecture कोर्स आधुनिक डेटा स्टैक्स के प्लेटफ़ॉर्म्स और तकनीकों को कवर करता है। हमारा Data Engineer करियर ट्रैक प्रोडक्शन पाइपलाइन्स बनाने और बनाए रखने पर और आगे जाता है।
DataCamp के साथ डेटा इंजीनियरिंग सीखें!
course
course
Track