Courses
現代のデータアーキテクチャを理解する
2時間
23.9K
データ品質の議論では、悪いソースデータの修正に焦点が当たりがちです。しかし、同じソースシステムから、異なるデータチームが5つのまったく異なるダッシュボードを作成し、同じ四半期の売上がそれぞれ違う数値になることもあります。ここで問題なのはソースデータとは限りません。利用者ごとに、クレンジング、結合、フィルタリング、定義づけを独自に行い、「クリーン」の基準を共有していないのです。
メダリオンアーキテクチャは、開始時点の生データを失わずにデータ品質を高めるための明確な境界をデータチームに与えることで、この問題に対処します。ここでは、その概要、仕組み、そしてデータエンジニアリングやMLOpsでなぜ重要な概念なのかを見ていきます。
当社のUnderstanding Modern Data Architectureコースでは、レイクハウスやレイヤードパイプラインがデータスタック全体の中でどのように位置づけられるかを解説しています。また、Data Engineerキャリアトラックでは、これらのレイヤーを本番で運用し続けられるようにするためのパイプライン構築スキルを幅広く習得できます。
メダリオンアーキテクチャは、データレイクハウス内のデータを論理的に整理するためのデザインパターンです。データが通過するにつれてデータ品質と構造が向上するように、3つのレイヤーを定義します。
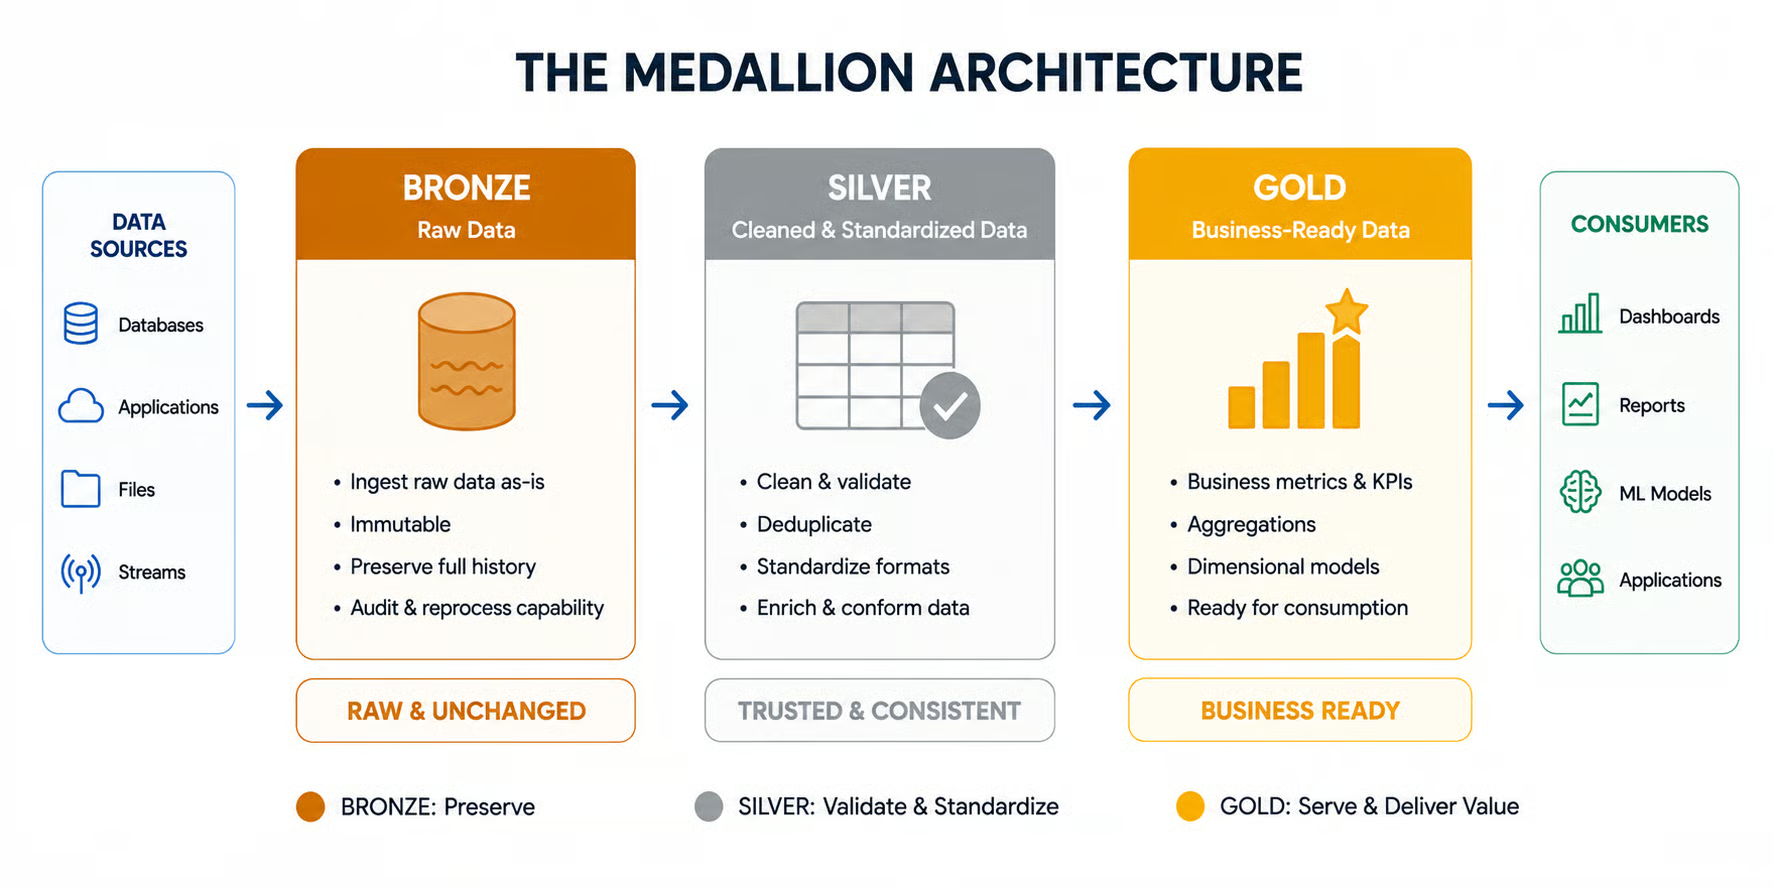
従来のデータウェアハウスにおける抽出・変換・ロード(ETL)パイプラインでは、あらかじめデータのスキーマを定義する必要があります。データ形式やスキーマが変わると、手動で調整しない限りシステムは失敗します。
メダリオンベースの抽出・ロード・変換(ELT)アーキテクチャでは、その場で変換して最終データを保存するのではなく、まず生の形式のままデータを保存します。この違いにより、メダリオンベースのアーキテクチャは堅牢かつ柔軟になります。 生データをそのまま保持し、後から使い方を決められるのです。
2つの概念を詳しく比較するには、当社のETL vs ELT ガイドをお読みください。
メダリオンアーキテクチャのもう一つの利点は、そのプラットフォーム非依存な特性です。Bronze、Silver、Goldは論理的なステージであり、特定ベンダーの技術に結びついたものではありません。データプラットフォームやワークロード要件に応じて、さまざまなストレージシステム、処理エンジン、テーブル形式でこのパターンを実装できます。
|
特徴 |
メダリオン(ELT) |
従来のETL |
|
生データ |
保持 |
消失 |
|
スキーマ |
後で決定、Silverで適用 |
ターゲット側で事前定義 |
|
再処理 |
保持された生データから再処理 |
ソースデータの再抽出が必要な場合あり |
|
変換のタイミング |
ロード後 |
ロード前 |
|
データの精緻化 |
レイヤーをまたいで段階的に実施 |
主にターゲット到達前に実施 |
3つのメダリオンレイヤーは論理的な順序で並び、各レイヤーが前段を基盤として構築されます。
ここには、リレーショナルデータベース、SalesforceのようなSaaSアプリケーション、リアルタイムのイベントを運ぶKafkaトピック、REST API、CSVエクスポート、IoTデバイスストリームなど、生のデータがそのまま着地します。取り込みは一般に、変更データキャプチャ用のFivetranや、オブジェクトストレージに着地するファイル向けのDatabricks Auto Loaderといったツールで処理されます。
Bronzeデータには多くのエラー、不整合、重複が含まれるのが普通で、ビジネス目的に直接使うべきではありません。とはいえ、このレイヤーは復旧点として非常に価値があり、ここからSilverやGoldのデータを再生成できます。
このレイヤーの重要性はフットプリントにあります。すべての取り込みイベントやトランザクションを記録・ログ化します。取り込みタイムスタンプ、データの出所、各種IDなどの有用なメタデータを含むことも多いです。目的は、生の完全な形でデータを保存し、同一ソースデータで下流パイプラインをリプレイしてバグをデバッグできるようにすることです。
Silverレイヤーでは、生データをクリーンで構造化されたデータに変換します。BronzeからSilverへの間で行われる代表的なクレンジング変換の例:
このレイヤーにはスキーマ適用も含まれ、あらかじめ定義した構造に合致させ、スキーマ進化をサポートします。
データ品質チェックもここで行います。例えば、失敗したビジネストランザクションや外れ値にフラグを立てたり、拒否したりするルールを追加します。これは、データがステージを通過する中で品質を高める最初のステップです。
この段階ではデータの変更が行われるため、はデータリネージツール(dbtなど)を用いて、BronzeからSilverへの変換過程を追跡することが重要です。品質チェックは通常、dbtのテスト、Great Expectations、Sodaで実装し、ガバナンスはデータカタログ(Databricks Unity CatalogやCollibraなど)で担保します。
乱雑なデータを適切なSilverデータセットに変える方法を学ぶには、当社のCleaning Data in Pythonコースから始めることをおすすめします。
アーキテクチャの最終レイヤーには、可能な限り最高品質のデータが格納されます。この高度に精緻化されたデータは、 Power BI、Tableau、またはLookerによるビジネスレポーティング、下流の分析アプリケーションでの利用、あるいはFeastやDatabricks Feature Storeのようなフィーチャーストア経由で機械学習モデルに提供されます。
データはすでにクレンジング済みのため、この段階ではそれを価値あるビジネス資産に変えることに注力します。想定される具体的なユースケース(財務レポート、マーケティングダッシュボード、アラートシステム、機械学習モデルの学習など)に応じて、Silver以降の変換で、Goldには目的に必要な情報のみが確実に含まれるようにします。
ここではKPIを作成し、独自の業務計算式を適用したり、集計して週次・月次・四半期単位のデータにして定期レポートに備えます。BronzeやSilverの処理は共通化されることが多い一方で、Goldレイヤーの処理はこのデータをどう使いたいかに応じて、より柔軟でカスタムになります。
Bronzeに生データを保持する価値が生まれるのは、それを実際に使えるときです。それは、上流または下流に変更が生じたときに起こります。変更のコストは、チェーンのどの位置にあるかによって変わります。
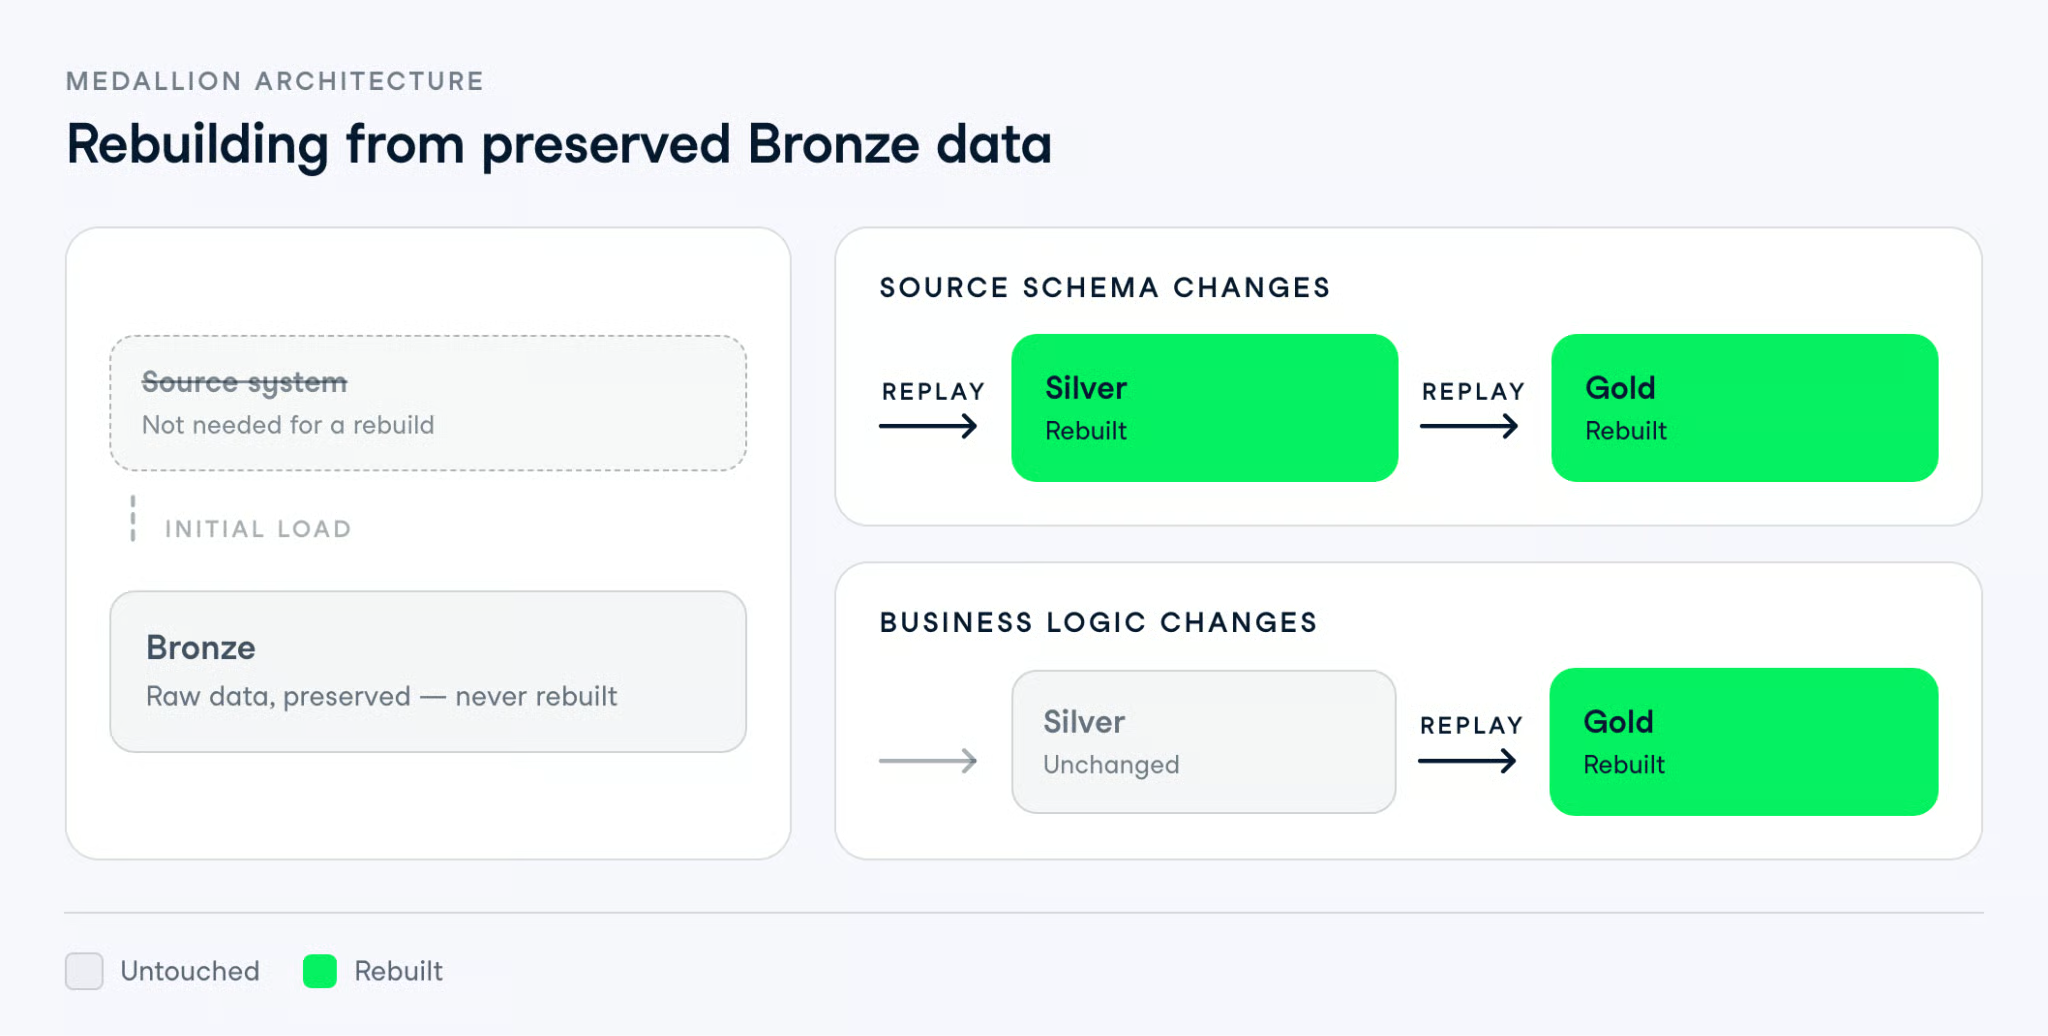
いずれの場合も、ソースシステムに戻ることはありません。これは、履歴の修正をそもそも可能にする要因であり、ソースが取り込み当時の形でデータを保持していない場合もあるからです。
また、メトリクスの定義を変更しても取り込み処理を再実行する必要がないことも意味します。Goldの利用者が多いチームがレイヤーを分けておく実務的な理由です。
データレイクハウスは、データレイクの安価なオブジェクトストレージと、ウェアハウスのトランザクション保証を兼ね備えています。しかし、その中のテーブルをどう配置するかまでは規定していません。そこを埋めるのがメダリオンです。レイクハウスはストレージの基盤であり、Bronze、Silver、Goldは品質保証の異なるカタログ、スキーマ、テーブルにどのように分割するかを示します。
実務では、その分割は物理的であることが多いです。DatabricksではUnity Catalog内に3つのスキーマを置くかもしれませんし、Microsoft Fabricでは、BronzeとSilverのテーブルがGoldウェアハウスに供給するレイクハウスを使うでしょう。パターンは同じでも、配管は異なります。
オープンなテーブル形式は、同時読み書きのもとでもレイヤーを成立させる鍵です。Delta Lake、Apache Iceberg、Apache Hudiはいずれも、次のような機能を組み合わせて提供します。
このうち、先ほど説明したリプレイ動作に最も効くのがバージョニングです。生のParquetファイルでもソースデータ自体は保持できますが、ロールバック用のトランザクション履歴がないため、Silverの不良実行が良好な実行を上書きしてしまい、比較対象がなくなります。Delta Lakeはトランザクションログで変更を追跡し、Apache Icebergはスナップショットとしてテーブル状態を表現します。
いずれも必須ではありません。メダリオンは論理パターンであり、多くのチームがPostgresのスキーマや素のS3プレフィックス上でdbtを用いて運用しています。ただし、安価なロールバック機能は失われます。
この2つはしばしば比較されますが、競合すると想定されるからです。両者は異なる問いに答えます:データメッシュは誰がデータを所有するかを定め、メダリオンアーキテクチャはその所有者がどのようにデータを精緻化するかを定めます。
データメッシュは、営業、財務、サプライチェーンといったドメインチームにデータの責任を委ね、彼らがデータをプロダクトとして公開し、その品質、発見容易性、リネージ、ガバナンスを所有します。それを支えるのは、全ドメインに同じツールを提供するセルフサービス型インフラと、所有権を奪うことなく全社標準を定める連合型ガバナンスの2つです。
メダリオンアーキテクチャは、各ドメインチームが自分たちの領域内で実行するものです。出荷データを所有するサプライチェーンチームは、生の出荷イベントをBronzeに、検証済みレコードをSilverに保持し、分析に使える出荷データセットをGoldで公開して他ドメインが利用できるようにします。メッシュはGoldの境界における契約を定め、それより上流はそのチームの裁量です。
併用時の注意点が1つあります。ドメインごとにBronzeを持つと、各ドメインが自前の取り込みとストレージコストを負担し、顧客や製品のような共有ディメンションが3か所で再構築されがちです。メッシュの提唱者は、それが所有の対価だと言うでしょう。とはいえ実コストであり、導入前に見積もる価値はあります。
メダリオンは再利用性と復旧性をもたらす一方で、ストレージ、レイテンシ、パイプライン数にコストがかかります。そのトレードオフが見合うかは、ほぼ消費者(利用側)の数に依存します。
レイテンシは過小評価されがちです。各レイヤーは通常それぞれスケジュールされたジョブであるため、毎時実行の3層バッチパイプラインでは、Goldがソースに対して2時間遅れることがあります。週次の売上レポートなら問題ありませんが、運用アラートでは許容できません。そのため、アラートはGoldを待たずにSilverを直接参照することがよくあります。
ストレージはまず指摘されるコストですが、たいていは小さな問題です。Bronzeは安価なオブジェクトストレージにあり、重複は現実的ですが上限があります。実際に痛いのはパイプライン数です。20のソーステーブルに3レイヤーを適用すると、午前3時に故障しうるものが60個になります。
それに対し、低品質データにもコストがあります。IBMは2026年、COOの43%が最優先のデータ課題としてデータ品質を挙げたと報告しており、これは同社のInstitute for Business Valueによる2025年の調査に基づくものです。その研究では、4分の1超の組織が低品質データによる年間損失が500万ドルを超えると報告しています。
したがって、問いは「メダリオンアーキテクチャの実装が単一パイプラインよりコスト高か」ではありません。答えは「はい」です。問いはむしろ、突合作業や信頼されないダッシュボードによって、代替案のコストをすでに支払っていないかどうかです。
同じクレンジング済みデータが複数の消費者に提供されるとき、メダリオンの真価が発揮されます。これは、データ量、チーム規模、ソース数よりも有力な予測因子です。
メダリオンアーキテクチャを使うべき状況:
以下の場合はスキップ:
3レイヤーの図はデフォルトであり、必須条件ではありません。ビジネスユースケースが単一なら、Bronzeに加えて統合レイヤー1つという選択がしばしば正解です。リプレイ用に生データを保持し、その後のクレンジングと業務ロジックは1ステップで実行します。
消費者に合った形を選んでください。統合してはいけないのはBronzeです。これは再現不能なレイヤーだからです。
判断に迷うなら、まず2レイヤーで構築し、2つ目の消費者が現れたら3つ目を追加する方法が有効です。Goldを後から追加するコストは、6か月間生データを上書きしてきた後にBronzeを後付けするより、はるかに安く済みます。
メダリオンの問題の多くはアーキテクチャに起因しません。締切のプレッシャー下での小さな妥協が、いつの間にかレイヤーを作った理由を失わせてしまうのです。
リプレイの論拠は、Bronzeがソースから実際に送られてきたものに近い形を保持していることにあります。着地前に業務ロジックを適用すると、元の状態を失い、再処理も監査証跡も不可能になります。
これは善意で起こりがちです。誰も使わない列をスペース節約のために落としたり、次のジョブが壊れるからという理由で取り込み時に乱れたタイムスタンプフィールドを強制変換したりします。半年後、その不要とされた列が重要だと判明し、元の値は失われています。Bronzeは可能な限りソースに近く保ち、修正はSilverで行いましょう。
Silverはクリーン化と標準化、Goldはビジネスの問いに答える役割です。メトリクスのロジックがSilverに漏れ込むと、すべてのGoldデータセットが頼んでもいない定義を引き継ぐことになり、メダリオンが解決すべきだった問題に逆戻りします。
判定は簡単です。ビジネスユーザーが数値に異議を唱えるなら、それはGoldの領分です。重複排除はSilverの関心事ですが、「アクティブ顧客」の定義はそうではありません。
メダリオンアーキテクチャは論理的なデザインパターンであり、すべてのパイプラインが厳密に3つの物理レイヤーを持つことを要求するものではありません。Bronze、Silver、Goldはデータの精緻化における論理的ステージを表し、ワークロードに応じて各レイヤーの実装は異なり得ます。
たとえば、レイヤーは物理的な別コピーを必須とせず、マテリアライズドテーブル、ビュー、その他適切な抽象化を使う場合もあります。重要なのは、データが生の状態からビジネスが信頼して使えるものへと進む際に、意味のある境界を設けることです。古典的な3層図を厳密に再現することではありません。
これは最もよく目にするのに、あまり議論されない問題です。Goldデータセットは作るのが容易で、誰も削除しません。1年後、テーブルが40個、うち11個は月次売上のバリエーションで、CFOがどれを見ているのか誰も覚えていない、という状況になり得ます。
Silverは役割が明確なため規律が自然に生まれますが、Goldにはそれがないため、データセットごとのオーナーと削除への躊躇のなさが必要です。そうでないと、同じメトリクスの競合バージョンが並立し、レイヤーが防ぐはずだった問題を招きます。
メダリオンが実際に提供するのは、ある数値の出所を問われたときに指し示せる場所と、答えが誤っていたと判明したときに戻れる元データのコピーです。複数チームが同じデータを読む場合、そのための追加ストレージと追加ジョブは十分見合います。1チームだけなら、2レイヤーの方が適切で、保守負荷も抑えられるかもしれません。
このパターンの位置づけの広い文脈を知りたい場合は、Understanding Modern Data Architectureコースで、モダンデータスタックを支えるプラットフォームや技術を取り上げています。Data Engineerキャリアトラックでは、本番パイプラインの構築と運用についてさらに深く学べます。
DataCampでデータエンジニアリングを学ぼう!
Courses
Courses
Tracks