
Corso
Comprendere la data architecture moderna
2 h
23.9K
La maggior parte delle conversazioni sulla qualità dei dati si concentra sulla correzione dei dati sorgente errati. Ma team di data diversi potrebbero costruire cinque dashboard completamente differenti partendo dallo stesso sistema sorgente, con numeri di ricavi diversi per lo stesso trimestre. I dati sorgente non sono necessariamente il problema qui. Ogni utilizzatore potrebbe pulire, unire, filtrare e definire quei dati in modo indipendente, senza uno standard condiviso su cosa significhi "pulito".
L’architettura medallion affronta questo problema fornendo ai team data confini espliciti per migliorare la qualità dei dati senza perdere i dati grezzi di partenza. Vediamo cos’è, come funziona e perché è un concetto così importante nel data engineering e nell’MLOps.
Il nostro corso Understanding Modern Data Architecture spiega come lakehouse e pipeline a strati si inseriscono nel più ampio data stack. E il nostro percorso di carriera Data Engineer sviluppa le competenze di pipeline più ampie che rendono questi livelli manutenibili una volta in produzione.
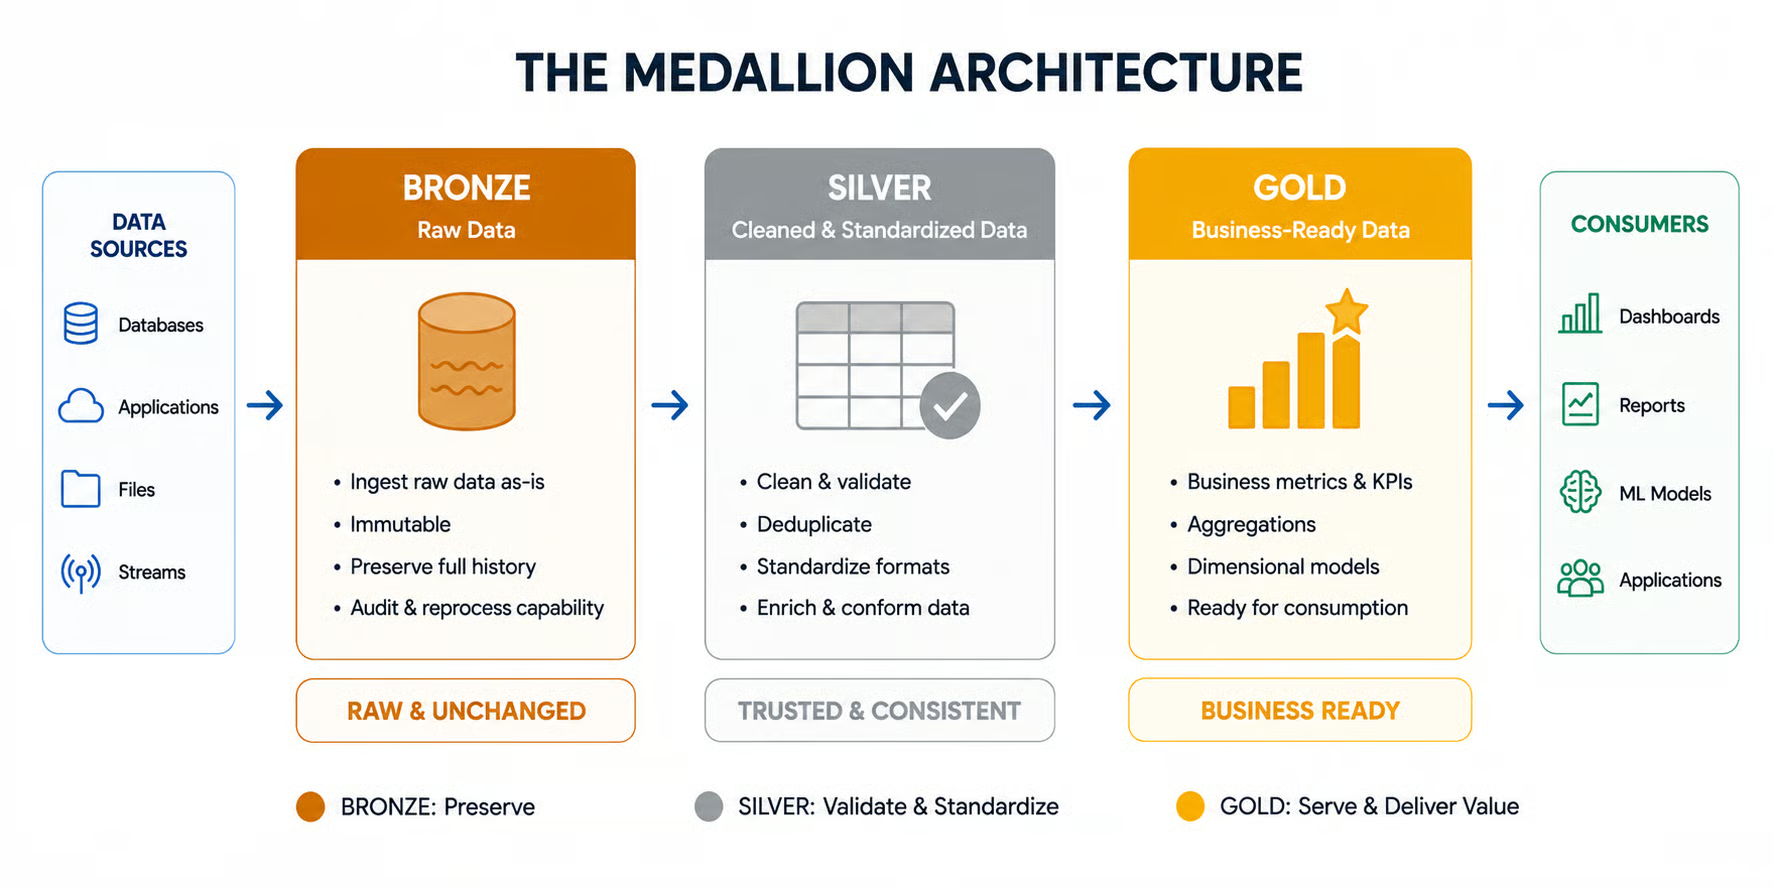
L’architettura medallion è un pattern di progettazione dei dati per organizzare logicamente i dati in un data lakehouse. Definisce un insieme di 3 livelli in cui la qualità e la struttura dei dati migliorano man mano che i dati li attraversano:
Nei data warehouse con pipeline extract-transform-load (ETL) tradizionali, devi definire lo schema dei tuoi dati in anticipo. Se il formato o lo schema dei dati cambia, il sistema fallirà a meno che tu non lo adatti manualmente.
In un’architettura extract-load-transform (ELT) basata su medallion, salvi prima i dati nella loro forma grezza, invece di trasformarli al volo e memorizzare i dati finali. Questa differenza rende le architetture basate su medallion sia robuste sia flessibili: puoi archiviare i dati grezzi così come sono e decidere in seguito come usarli.
Per un confronto completo tra i due concetti, ti consiglio di leggere la nostra guida ETL vs ELT.
Un altro vantaggio dell’architettura medallion è la sua natura piattaforma-agnostica. Bronze, Silver e Gold sono stadi logici, non tecnologie legate a un fornitore specifico. Puoi implementare il pattern con diversi sistemi di archiviazione, motori di elaborazione e formati di tabella, a seconda della tua piattaforma dati e dei requisiti di carico di lavoro.
|
Caratteristica |
Medallion (ELT) |
ETL tradizionale |
|
Dati grezzi |
Preservati |
Persi |
|
Schema |
Si decide dopo, applicato in Silver |
Si definisce a priori sul target |
|
Rielaborazione |
Da dati grezzi preservati |
Può richiedere una nuova estrazione dal sorgente |
|
Momento della trasformazione |
Dopo il caricamento |
Prima del caricamento |
|
Raffinamento dei dati |
Progressivo tra i livelli |
Principalmente prima che i dati raggiungano il target |
I tre livelli medallion seguono una logica, ciascuno costruendosi sul precedente.
Qui approdano i dati grezzi così come sono, che si tratti di database relazionali, applicazioni SaaS come Salesforce, topic Kafka che trasportano eventi in tempo reale, API REST, esportazioni CSV o stream di dispositivi IoT. L’ingestione è di solito gestita da strumenti come Fivetran per il change data capture o Databricks Auto Loader per i file che arrivano nello storage a oggetti.
I dati Bronze in genere contengono parecchi errori, incoerenze e duplicati, quindi non andrebbero mai usati direttamente per scopi di business. Detto questo, il livello è molto prezioso come punto di ripristino da cui rigenerare i dati Silver o Gold.
L’importanza del livello sta nella sua traccia: registra e logga ogni evento o transazione di ingestione. Spesso contiene metadati preziosi, come timestamp di ingestione, origine dei dati e vari tipi di identificatori. L’obiettivo è memorizzare i dati nel modo più grezzo e completo possibile, così da poter rigiocare le pipeline a valle usando gli stessi dati sorgente per effettuare il debug di eventuali bug.
Il livello Silver trasforma i dati grezzi in dati puliti e strutturati. Alcuni esempi delle principali trasformazioni di pulizia che avvengono tra Bronze e Silver:
Questo livello include anche l’applicazione dello schema, garantendo che i dati rispettino una struttura predefinita e supportando l’evoluzione dello schema.
Qui gestisci anche i controlli di qualità dei dati. Ad esempio, aggiungi regole per segnalare o rifiutare transazioni di business non riuscite o outlier. È il primo passo per migliorare la qualità dei dati man mano che attraversano gli stadi.
Dal momento che questo stadio comporta la modifica dei dati, è importante usare strumenti di data lineage come dbt per tracciare come i dati vengono trasformati da Bronze a Silver. I controlli di qualità sono in genere implementati con i test di dbt, Great Expectations o Soda, mentre la governance è applicata tramite un data catalog come Databricks Unity Catalog o Collibra.
Se vuoi imparare a trasformare dati disordinati in dataset Silver corretti, ti consiglio di iniziare dal nostro corso Cleaning Data in Python.
Il livello finale dell’architettura memorizza i dati alla massima qualità possibile. Questi dati altamente raffinati sono utilizzati per la reportistica in Power BI, Tableau o Looker, consumati da applicazioni analitiche a valle o serviti a modelli di machine learning tramite un feature store come Feast o Databricks Feature Store.
Poiché i dati sono già puliti, questo stadio si concentra sul trasformarli in un asset di business di valore. A seconda dello specifico caso d’uso in mente (pensa a report finanziari, dashboard marketing, sistemi di alerting, training di modelli ML, …), le trasformazioni dopo Silver assicurano che Gold contenga esattamente le informazioni necessarie per il compito.
Qui crei KPI, applichi formule di business personalizzate o agregazioni settimanali, mensili o trimestrali per report pianificati. Mentre le operazioni Bronze e Silver sono spesso comuni, quelle del livello Gold sono più flessibili e personalizzate in base a come vuoi usare questi dati.
Preservare i dati grezzi in Bronze paga solo se puoi effettivamente usarli, e questo accade ogni volta che qualcosa a monte o a valle cambia. Il costo di un cambiamento dipende da quanto è avanti nella catena.
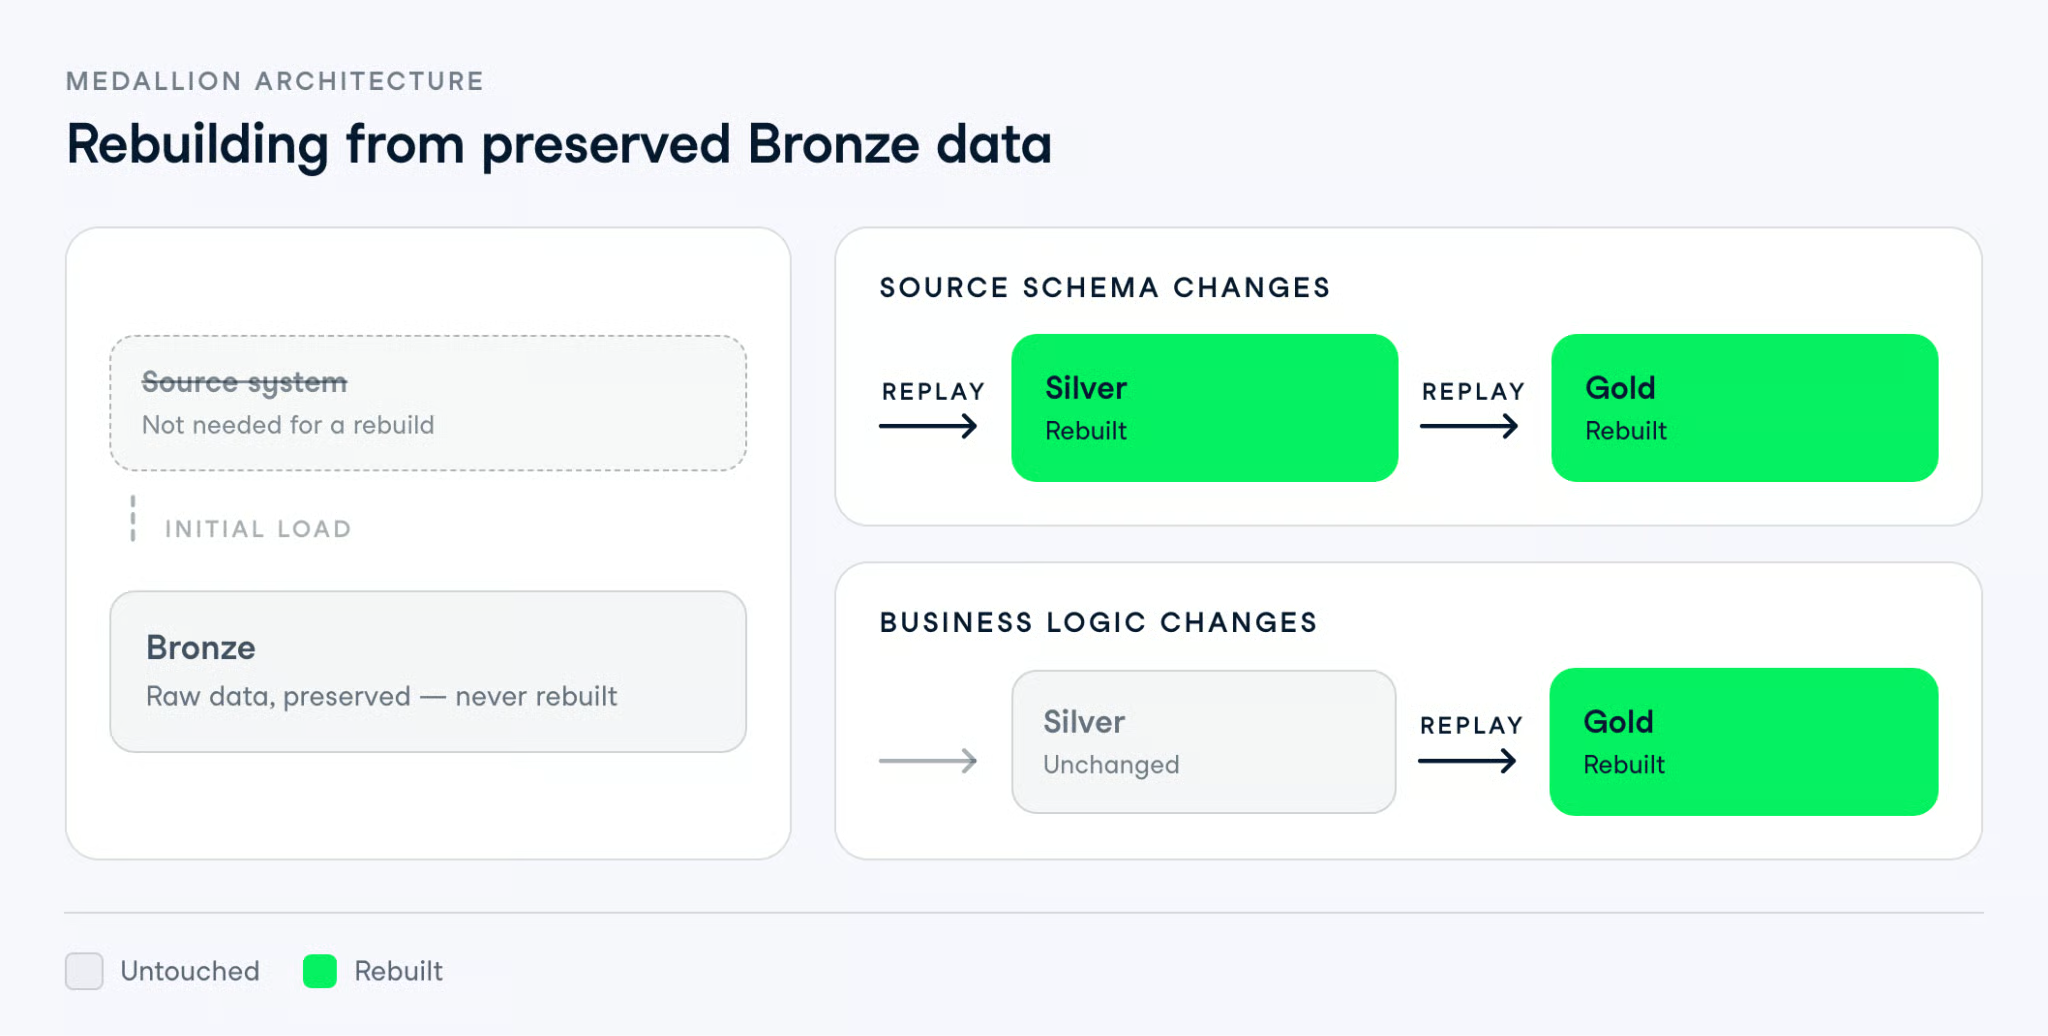
In nessuno dei due casi torni al sistema sorgente. È questo che rende possibili le correzioni storiche, dato che il sorgente potrebbe non conservare più i dati nella forma in cui li avevi originariamente ingestiti.
Significa anche che puoi cambiare la definizione di una metrica senza ri-eseguire l’ingestione, che è il motivo pratico per cui i team con molti consumatori Gold mantengono i livelli separati.
Un data lakehouse ti offre l’object storage economico di un data lake con le garanzie transazionali di un warehouse. Non dice nulla su come disporre le tabelle al suo interno. È qui che interviene il medallion: il lakehouse è il substrato di archiviazione, e Bronze, Silver e Gold sono il modo in cui lo dividi in cataloghi, schemi e tabelle con diverse garanzie di qualità.
In pratica, questa divisione è di solito fisica. Su Databricks, potresti avere tre schemi in un catalogo di Unity Catalog, e in Microsoft Fabric, un lakehouse con tabelle Bronze e Silver che alimentano un warehouse Gold. Stesso pattern, impianti diversi.
I formati di tabella aperti sono ciò che fa reggere i livelli sotto letture e scritture concorrenti. Delta Lake, Apache Iceberg e Apache Hudi offrono ciascuno una combinazione di:
Il versionamento conta soprattutto per il comportamento di replay che abbiamo appena visto. I file Parquet grezzi preservano bene i tuoi dati sorgente, ma non forniscono una cronologia transazionale a cui tornare, quindi un’esecuzione Silver errata sovrascrive quella buona e non hai nulla con cui confrontare. Delta Lake traccia le modifiche in un transaction log, mentre Apache Iceberg rappresenta gli stati della tabella come snapshot.
Nulla di tutto ciò è obbligatorio. Medallion è un pattern logico, e molti team lo eseguono su schemi Postgres o semplici prefissi S3 con dbt sopra. Perdi solo il rollback economico.
I due vengono spesso confrontati, di solito perché si presume che competano. Rispondono a domande differenti: il data mesh decide chi possiede i dati, e l’architettura medallion decide come quel proprietario li affina.
Il data mesh affida la responsabilità dei dati a team di dominio come vendite, finanza o supply chain, che pubblicano i loro dati come prodotti e ne possiedono qualità, reperibilità, lineage e governance. Due cose tengono insieme il tutto: un’infrastruttura self-service che fornisce a ogni dominio gli stessi strumenti, e una governance federata che stabilisce standard a livello organizzativo senza togliere la proprietà ai domini.
L’architettura medallion è ciò che un team di dominio esegue all’interno della propria fetta. Un team di supply chain che possiede i dati delle spedizioni mantiene gli eventi di spedizione grezzi in Bronze, i record validati in Silver e pubblica dataset di spedizioni pronti per l’analisi in Gold, per essere consumati da altri domini. Il mesh definisce il contratto al confine Gold; tutto ciò che sta a monte è affare di quel team.
Una nota prima di combinarli: livelli Bronze per dominio significano che ogni dominio si fa carico dei propri costi di ingestione e storage, e dimensioni condivise come cliente o prodotto tendono a essere ricostruite in tre posti. I sostenitori del mesh direbbero che è il prezzo della proprietà. Resta comunque un costo reale, da stimare prima di impegnarti.
Medallion ti offre riuso e ripristinabilità, e ti addebita storage, latenza e numero di pipeline. Se lo scambio conviene dipende quasi interamente da quanti consumatori hai.
La latenza è la voce che è più facile sottovalutare. Ogni livello è di solito un job pianificato a sé, quindi una pipeline batch a tre livelli eseguita ogni ora può lasciare Gold due ore indietro rispetto al sistema sorgente. Va bene per un report settimanale dei ricavi e non va bene per un alert operativo, motivo per cui spesso i team lasciano che l’alerting legga direttamente Silver invece di aspettare Gold.
Lo storage è il costo che le persone sollevano per primo, ed è di solito il problema minore. Bronze risiede in object storage economico, e la duplicazione è reale ma limitata. Il vero dolore è il numero di pipeline: tre livelli su venti tabelle sorgente fanno sessanta cose che possono potenzialmente fallire alle 3 del mattino.
A fronte di ciò, la scarsa qualità dei dati presenta un suo conto. IBM ha riportato nel 2026 che il 43% dei COO ha indicato la qualità dei dati come la priorità più significativa, basandosi su ricerche del 2025 del suo Institute for Business Value. Più di un quarto delle organizzazioni in quello studio ha riportato perdite annuali per la scarsa qualità dei dati superiori a 5 milioni di dollari.
Quindi la domanda non è se implementare un’architettura medallion costi più di una singola pipeline, perché è così. La domanda è se stai già pagando l’alternativa in riunioni di riconciliazione e dashboard di cui nessuno si fida.
Medallion si ripaga quando gli stessi dati puliti servono più di un consumatore. È il miglior predittore, più del volume dei dati, della dimensione del team o del numero di sorgenti da cui estrai.
Usa l’architettura medallion quando:
Evitala quando:
Lo schema a tre livelli è un’impostazione predefinita, non un requisito. Con un singolo caso d’uso di business, Bronze più un livello combinato è spesso la scelta giusta: preserva i dati grezzi per il replay, poi esegui pulizia e logica di business in un unico passaggio.
Scegli la forma che corrisponde ai tuoi consumatori. Quello che non dovresti comprimere è Bronze, perché è il livello che non puoi ricreare.
Quindi, se sei nel mezzo e onestamente non sai decidere, costruire due livelli e aggiungere il terzo quando compare un secondo consumatore è una buona strada. Aggiungere Gold in seguito costa molto meno che retrofitare Bronze dopo che hai sovrascritto i tuoi dati grezzi negli ultimi sei mesi.
La maggior parte dei problemi medallion non sono architetturali. Sono piccoli compromessi presi sotto pressione di scadenze che, silenziosamente, eliminano il motivo per cui hai costruito i livelli in primo luogo.
Tutto l’argomento del replay si basa sul fatto che Bronze contenga qualcosa di vicino a ciò che la sorgente ha effettivamente inviato. Se applichi logica di business prima di metterli a terra, hai perso lo stato originale, il che significa niente rielaborazione e nessuna audit trail.
Questo di solito accade per buone ragioni. Qualcuno elimina una colonna che nessuno usa per risparmiare spazio, oppure forza un campo timestamp disordinato in ingestione perché rompe il job successivo. Sei mesi dopo, la colonna “inutile” si rivela importante e i valori originali sono spariti. Tieni Bronze il più vicino possibile alla sorgente, per quanto praticamente gestibile, e metti le correzioni in Silver.
Silver pulisce e standardizza. Gold risponde a domande di business. Quando la logica delle metriche filtra in Silver, ogni dataset Gold eredita una definizione che non ha richiesto, e torni al problema che medallion doveva risolvere.
Il test è semplice: se un utente business discute il numero, appartiene a Gold. La deduplicazione è un tema Silver. Cosa conta come cliente attivo no.
L’architettura medallion è un pattern di progettazione logico, non un requisito per cui ogni pipeline debba contenere esattamente tre livelli fisici. Bronze, Silver e Gold rappresentano stadi logici di raffinamento dei dati, e ogni livello può essere implementato in modo diverso a seconda del carico di lavoro.
Ad esempio, un livello può usare tabelle materializzate, viste o altre astrazioni appropriate invece di richiedere una copia fisica separata dei dati. L’obiettivo è creare confini significativi man mano che i dati si spostano dal loro stato grezzo verso qualcosa che il business può fidarsi e usare, piuttosto che riprodurre esattamente il classico schema a tre livelli.
Questo è quello che vedo più spesso, e di cui si parla meno. I dataset Gold sono economici da creare, e nessuno li cancella mai, così dopo un anno potresti avere quaranta tabelle, undici delle quali variazioni sui ricavi mensili, e nessuno ricorda quale guarda davvero il CFO.
Silver ha una disciplina naturale perché il suo lavoro è definito. Gold no, quindi serve un owner per dataset e la volontà di cancellare. Senza questo, finisci con diverse versioni concorrenti della stessa metrica, che è proprio uno dei problemi che i livelli avrebbero dovuto prevenire.
Quello che medallion ti dà davvero è un posto da indicare quando qualcuno chiede da dove provenga un numero, e una copia dei dati originali a cui tornare quando la risposta si rivela sbagliata. Vale lo storage extra e i job extra quando più team leggono gli stessi dati. Quando c’è un solo team, due livelli potrebbero essere la soluzione migliore e farti risparmiare manutenzione.
Se vuoi il contesto più ampio su dove si posiziona questo pattern, il nostro corso Understanding Modern Data Architecture copre le piattaforme e le tecnologie dietro i moderni data stack. Il nostro percorso di carriera Data Engineer va oltre, nella costruzione e manutenzione di pipeline di produzione.
Impara il Data Engineering con DataCamp!
Corso
Corso
Programma