

Curso
Comprender la arquitectura de datos moderna
2 h
24.4K
La mayoría de conversaciones sobre calidad de datos se centran en arreglar malas fuentes. Pero distintos equipos de datos podrían crear cinco paneles completamente distintos a partir del mismo sistema de origen, con cifras de ingresos diferentes para el mismo trimestre. La fuente no tiene por qué ser el problema. Cada usuario puede estar limpiando, uniendo, filtrando y definiendo esos datos por su cuenta, sin un estándar compartido de qué significa "limpio".
La arquitectura medallion aborda este problema marcando límites claros para que los equipos mejoren la calidad de los datos sin perder los datos en bruto con los que empezaron. Veamos qué es, cómo funciona y por qué es un concepto tan importante en ingeniería de datos y MLOps.
Nuestro curso Understanding Modern Data Architecture explica dónde encajan los lakehouses y los pipelines por capas dentro del stack de datos. Y el itinerario de aprendizaje Data Engineer desarrolla las competencias de pipeline necesarias para mantener estas capas una vez en producción.
La arquitectura medallion es un patrón de diseño para organizar lógicamente los datos en un data lakehouse. Define 3 capas en las que la calidad y estructura de los datos mejoran a medida que avanzan:
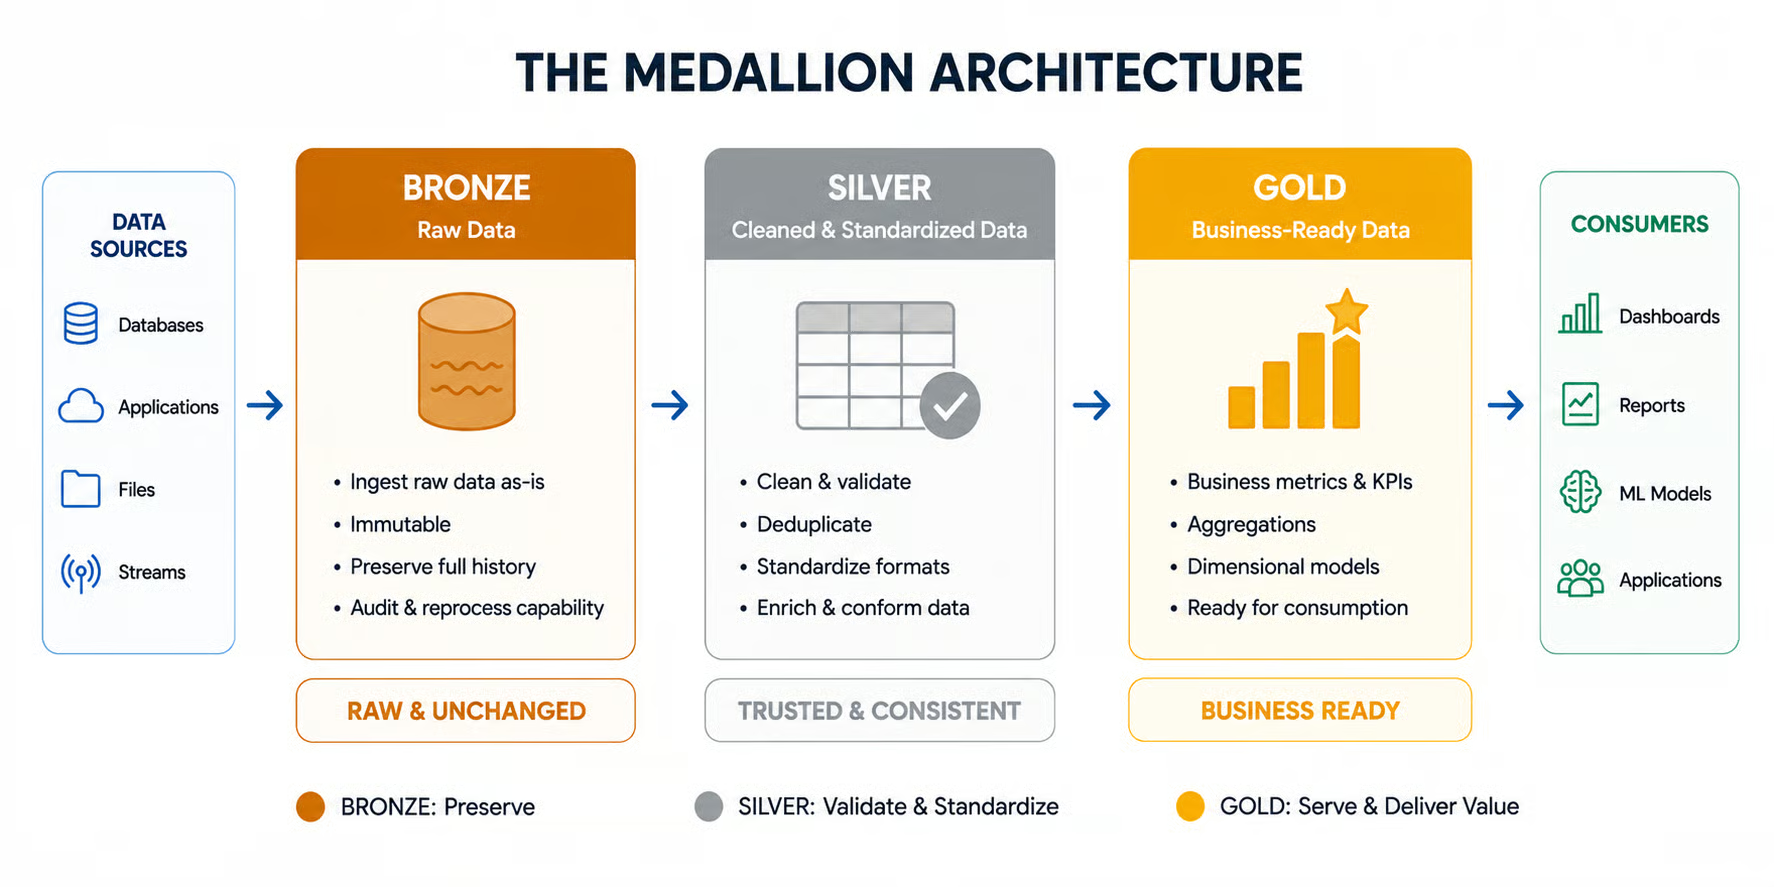
En data warehouses con pipelines tradicionales de extracción-transformación-carga (ETL), tienes que definir el esquema por adelantado. Si el formato o el esquema cambia, el sistema falla salvo que lo ajustes manualmente.
En una arquitectura de extracción-carga-transformación (ELT) basada en medallion, primero guardas los datos en su forma bruta, en lugar de transformarlos al vuelo y almacenar el resultado final. Esta diferencia hace que las arquitecturas medallion sean robustas y flexibles: puedes almacenar los datos tal cual y decidir más tarde cómo usarlos.
Para una comparación completa entre ambos enfoques, te recomiendo leer nuestra guía ETL vs ELT.
Otra ventaja de la arquitectura medallion es su independencia de la plataforma. Bronze, Silver y Gold son etapas lógicas, no tecnologías ligadas a un proveedor concreto. Puedes implementar el patrón con distintos sistemas de almacenamiento, motores de proceso y formatos de tabla, según tu plataforma de datos y los requisitos de carga de trabajo.
|
Característica |
Medallion (ELT) |
ETL tradicional |
|
Datos en bruto |
Se preservan |
Se pierden |
|
Esquema |
Se decide después; se aplica en Silver |
Se define por adelantado en el destino |
|
Reprocesado |
Se reprocesa desde los datos en bruto preservados |
Puede requerir reextraer la fuente |
|
Momento de la transformación |
Después de cargar |
Antes de cargar |
|
Refinamiento de datos |
Progresivo a lo largo de las capas |
Principalmente antes de que los datos lleguen al destino |
Las tres capas siguen un orden lógico: cada una construye sobre la anterior.
Aquí aterrizan los datos tal cual llegan: bases de datos relacionales, aplicaciones SaaS como Salesforce, tópicos de Kafka con eventos en tiempo real, APIs REST, exportaciones CSV o flujos de dispositivos IoT. La ingesta suele gestionarse con herramientas como Fivetran para change data capture o Databricks Auto Loader para archivos en object storage.
El dato en Bronze suele contener bastantes errores, inconsistencias y duplicados, así que nunca debería usarse directamente con fines de negocio. Aun así, esta capa es muy valiosa como punto de recuperación desde el que regenerar datos Silver o Gold.
La importancia de la capa está en su huella: registra y deja trazas de cada evento de ingesta o transacción. Suele incluir metadatos útiles como marcas de tiempo de ingesta, orígenes y diversos identificadores. El objetivo es almacenar los datos lo más brutos y completos posible, para poder reejecutar los pipelines aguas abajo con la misma fuente y depurar errores.
La capa Silver transforma los datos en bruto en datos limpios y estructurados. Algunos ejemplos de transformaciones de limpieza que ocurren entre Bronze y Silver:
Esta capa también aplica validación de esquemas, garantizando que los datos cumplen una estructura definida y permitiendo la evolución del esquema.
Aquí también se realizan controles de calidad de datos. Por ejemplo, añadir reglas que marquen o rechacen transacciones fallidas u outliers. Es el primer paso para mejorar la calidad a medida que los datos pasan por las etapas.
Como en esta fase se modifican datos, es importante usar herramientas de linaje de datos como dbt para rastrear cómo se transforman desde Bronze a Silver. Los controles de calidad suelen implementarse con pruebas de dbt, Great Expectations o Soda, mientras que el gobierno del dato se refuerza con un catálogo de datos como Databricks Unity Catalog o Collibra.
Si quieres aprender a convertir datos desordenados en buenos datasets Silver, te recomiendo empezar con nuestro curso Cleaning Data in Python.
La capa final almacena los datos con la mayor calidad posible. Estos datos refinados se usan para informes de negocio en Power BI, Tableau o Looker, los consumen aplicaciones analíticas aguas abajo o se sirven a modelos de machine learning mediante un feature store como Feast o Databricks Feature Store.
Como los datos ya están limpios, aquí el foco está en convertirlos en un activo de negocio valioso. Según el caso de uso concreto (piensa en informes financieros, paneles de marketing, sistemas de alertas, entrenamiento de modelos de ML, …), las transformaciones posteriores a Silver garantizan que Gold contenga exactamente la información necesaria para la tarea.
Aquí creas KPIs, aplicas fórmulas de negocio personalizadas o agregas a datos semanales, mensuales o trimestrales para informes periódicos. Mientras que Bronze y Silver suelen tener operaciones comunes, las de Gold son más flexibles y se adaptan al uso que quieras dar a los datos.
Preservar los datos en bruto en Bronze solo compensa si realmente puedes utilizarlos, y eso ocurre cuando algo cambia aguas arriba o abajo. El coste del cambio depende de lo lejos que esté en la cadena.
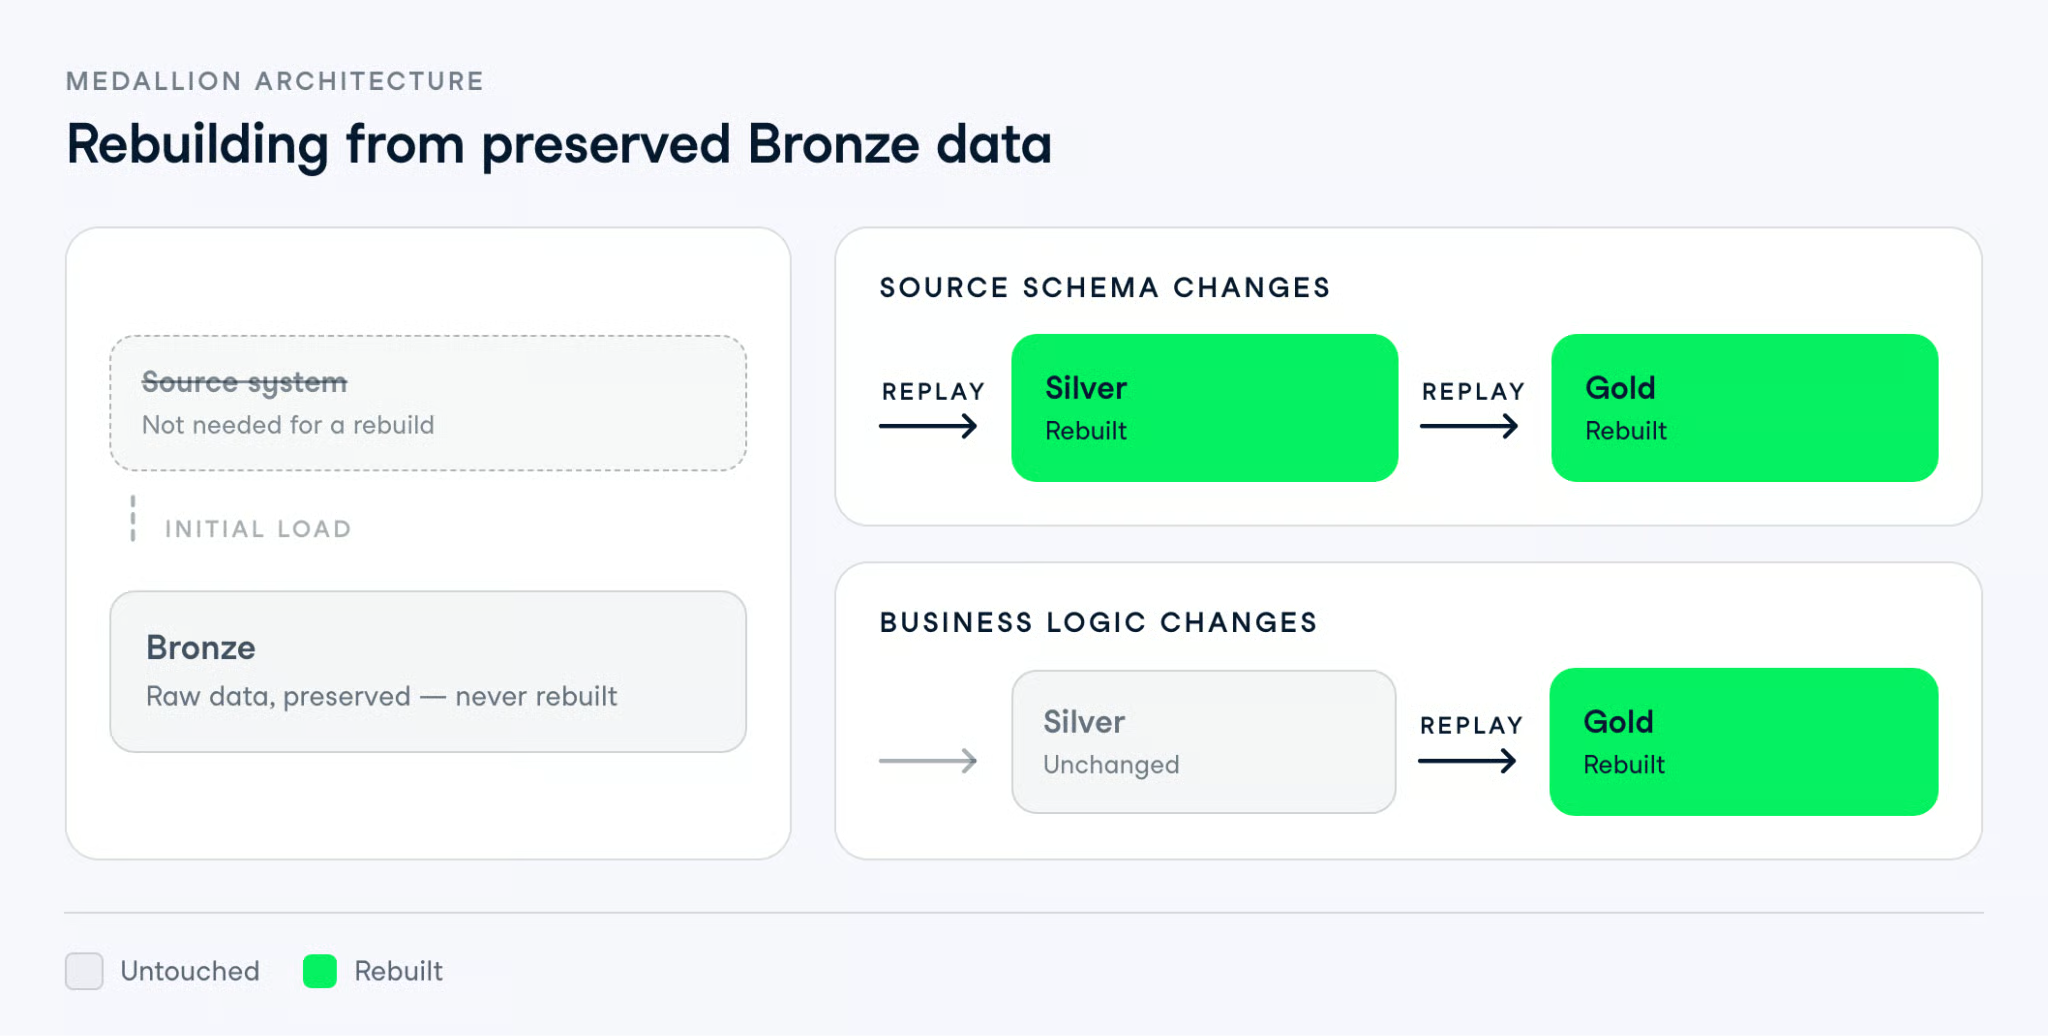
En ningún caso vuelves al sistema fuente. Eso es lo que hace posibles las correcciones históricas, ya que la fuente puede no conservar los datos tal como los ingeriste originalmente.
También significa que puedes cambiar la definición de una métrica sin reejecutar la ingesta, que es la razón práctica por la que los equipos con muchos consumidores de Gold mantienen separadas las capas.
Un data lakehouse te da el almacenamiento económico de un data lake con las garantías transaccionales de un warehouse. No dice nada sobre cómo organizar las tablas dentro. Ahí entra medallion: el lakehouse es el sustrato de almacenamiento y Bronze, Silver y Gold son cómo lo divides en catálogos, esquemas y tablas con diferentes garantías de calidad.
En la práctica, esa división suele ser física. En Databricks, podrías tener tres esquemas en un catálogo de Unity Catalog; en Microsoft Fabric, un lakehouse con tablas Bronze y Silver que alimentan un warehouse Gold. Mismo patrón, distinta fontanería.
Los formatos de tabla abiertos son los que permiten que las capas resistan lecturas y escrituras concurrentes. Delta Lake, Apache Iceberg y Apache Hudi ofrecen en distinta combinación:
El versionado es clave para el reprocesado del que acabamos de hablar. Archivos Parquet en bruto preservan bien la fuente, pero no te dan historial transaccional para deshacer: una mala ejecución en Silver sobrescribe la buena y no tienes con qué comparar. Delta Lake rastrea cambios en un log de transacciones, mientras que Apache Iceberg representa estados de tabla como instantáneas.
Nada de esto es obligatorio. Medallion es un patrón lógico, y muchos equipos lo ejecutan en esquemas de Postgres o prefijos S3 planos con dbt encima. Solo pierdes la facilidad de revertir barato.
Se comparan mucho, normalmente porque se asume que compiten. Responden a preguntas distintas: data mesh decide quién es dueño de los datos, y la arquitectura medallion decide cómo los refina ese dueño.
Data mesh entrega la responsabilidad a equipos de dominio como ventas, finanzas o supply chain, que publican sus datos como productos y se responsabilizan de su calidad, descubribilidad, linaje y gobierno. Dos cosas lo sostienen: una infraestructura de autoservicio que da a cada dominio las mismas herramientas, y un gobierno federado que fija estándares de organización sin quitar la titularidad a los dominios.
La arquitectura medallion es lo que ejecuta cada dominio dentro de su parte. Un equipo de supply chain con datos de envíos guarda los eventos en bruto en Bronze, los registros validados en Silver y publica en Gold datasets de envíos listos para análisis para que otros dominios los consuman. El mesh define el contrato en el límite Gold; todo lo anterior es competencia del equipo.
Un aviso antes de combinarlos: capas Bronze por dominio implican que cada dominio asume su propio coste de ingesta y almacenamiento, y dimensiones compartidas como cliente o producto tienden a reconstruirse en tres sitios. Los defensores del mesh dirían que es el precio de la propiedad. Aun así es un coste real, y conviene estimarlo antes de comprometerte.
Medallion te da reutilización y recuperabilidad, y te cobra en almacenamiento, latencia y número de pipelines. Que compense depende casi por completo de cuántos consumidores tengas.
La latencia es lo más fácil de subestimar. Cada capa suele ser su propio job programado, así que un pipeline por lotes de tres capas, ejecutado cada hora, puede dejar Gold con dos horas de retraso respecto a la fuente. Perfecto para un informe semanal de ingresos, no tanto para una alerta operativa; por eso, a menudo se permite que las alertas lean directamente de Silver en lugar de esperar a Gold.
El almacenamiento es el coste que se menciona primero, y suele ser el menor problema. Bronze está en almacenamiento de objetos barato y la duplicación es real pero acotada. Lo que duele de verdad es el número de pipelines: tres capas por veinte tablas de origen son sesenta cosas que pueden fallar a las 3 de la mañana.
Frente a eso, la mala calidad de datos también pasa factura. IBM informó en 2026 de que el 43% de los COOs señalaban la calidad de los datos como su prioridad más importante, basándose en investigación de 2025 de su Institute for Business Value. Más de una cuarta parte de las organizaciones de ese estudio reportaron pérdidas anuales por mala calidad de datos superiores a 5 millones de dólares.
Así que la pregunta no es si implementar una arquitectura medallion cuesta más que un solo pipeline, porque sí. La pregunta es si ya estás pagando la alternativa en reuniones de conciliación y paneles que nadie se cree.
Medallion sale a cuenta cuando los mismos datos limpios sirven a más de un consumidor. Es el mejor predictor, por encima del volumen, el tamaño del equipo o cuántas fuentes tienes.
Usa arquitectura medallion cuando:
Sáltatela cuando:
El diagrama de tres capas es el valor por defecto, no una obligación. Con un único caso de uso de negocio, a menudo lo mejor es Bronze más una capa combinada: preserva los datos en bruto para reejecutar y realiza limpieza y lógica de negocio en un solo paso.
Elige la forma que mejor encaje con tus consumidores. Lo que no deberías colapsar es Bronze, porque es la única capa que no puedes recrear.
Si estás en el punto medio y no lo ves claro, construir dos capas y añadir la tercera cuando aparezca un segundo consumidor es una buena jugada. Añadir Gold más adelante es mucho más barato que incorporar Bronze después de seis meses sobrescribiendo tus datos en bruto.
La mayoría de problemas no son arquitectónicos. Son pequeñas concesiones por la presión de los plazos que, sin hacer ruido, anulan el motivo de crear las capas.
Todo el argumento del reprocesado se sostiene en que Bronze conserva algo muy parecido a lo que envió la fuente. Si aplicas lógica de negocio antes de aterrizarlo, pierdes el estado original, lo que significa que no podrás reprocesar ni auditar.
Suele hacerse por buenas razones. Alguien elimina una columna que "nadie" usa para ahorrar espacio, o convierte un timestamp problemático en la ingesta porque rompe el siguiente job. Seis meses después, esa columna sí importa y los valores originales ya no existen. Mantén Bronze lo más fiel posible a la fuente y pon las correcciones en Silver.
Silver limpia y estandariza. Gold responde preguntas de negocio. Cuando la lógica de métricas se cuela en Silver, cada dataset Gold hereda una definición que no pidió y vuelves al problema que medallion buscaba resolver.
La prueba es sencilla: si una persona de negocio discute el número, pertenece a Gold. La deduplicación es asunto de Silver. Qué cuenta como cliente activo, no.
La arquitectura medallion es un patrón lógico, no un requisito de que cada pipeline tenga exactamente tres capas físicas. Bronze, Silver y Gold representan etapas lógicas de refinamiento, y cada capa puede implementarse de forma diferente según la carga de trabajo.
Por ejemplo, una capa puede usar tablas materializadas, vistas u otras abstracciones adecuadas sin exigir una copia física separada. La clave es crear límites significativos a medida que los datos pasan de su estado bruto a algo en lo que el negocio pueda confiar y usar, no replicar a rajatabla el diagrama clásico de tres capas.
Este es el que más veo y del que menos se habla. Crear datasets Gold es barato y nadie los borra, así que al año puedes tener cuarenta tablas, once de ellas variaciones de ingresos mensuales, y nadie recuerda cuál mira realmente el CFO.
Silver tiene disciplina natural porque su función está clara. Gold no, así que necesita una persona responsable por dataset y voluntad de borrar. Sin eso, acabas con varias versiones en competencia de la misma métrica, justo lo que las capas pretendían evitar.
Lo que realmente te da medallion es un sitio al que señalar cuando alguien pregunte de dónde salió un número, y una copia de los datos originales a la que volver cuando la respuesta sea errónea. Merece la pena el almacenamiento y los jobs extra cuando varios equipos leen los mismos datos. Si solo lo hace uno, dos capas pueden ser la mejor opción y ahorrarte mantenimiento.
Si quieres el contexto más amplio de dónde encaja este patrón, nuestro curso Understanding Modern Data Architecture cubre las plataformas y tecnologías detrás de los stacks modernos de datos. Nuestro itinerario Data Engineer va más allá en la construcción y mantenimiento de pipelines en producción.
¡Aprende ingeniería de datos con DataCamp!
Curso
Curso
Programa