
Kurs
Moderne Datenarchitekturen verstehen
2 Std.
23.9K
In den meisten Diskussionen über Datenqualität geht es darum, schlechte Quelldaten zu reparieren. Doch verschiedene Datenteams könnten aus demselben Quellsystem fünf völlig unterschiedliche Dashboards bauen – mit unterschiedlichen Umsatzzahlen für dasselbe Quartal. Die Quelle ist hier nicht zwingend das Problem. Jede Verbraucherin und jeder Verbraucher bereinigt, verknüpft, filtert und definiert diese Daten womöglich eigenständig – ohne gemeinsame Definition, was "sauber" bedeutet.
Die Medallion-Architektur adressiert dieses Problem, indem sie Datenteams klare Grenzen dafür setzt, wie sich Datenqualität verbessern lässt, ohne die ursprünglichen Rohdaten zu verlieren. Schauen wir uns an, was sie ist, wie sie funktioniert und warum sie in Data Engineering und MLOps so wichtig ist.
Unser Understanding Modern Data Architecture-Kurs zeigt, wo Lakehouses und geschichtete Pipelines in den modernen Datenstack passen. Und unser Data Engineer-Karrierelernpfad vermittelt die Pipeline-Kompetenzen, die diese Ebenen im produktiven Betrieb wartbar machen.
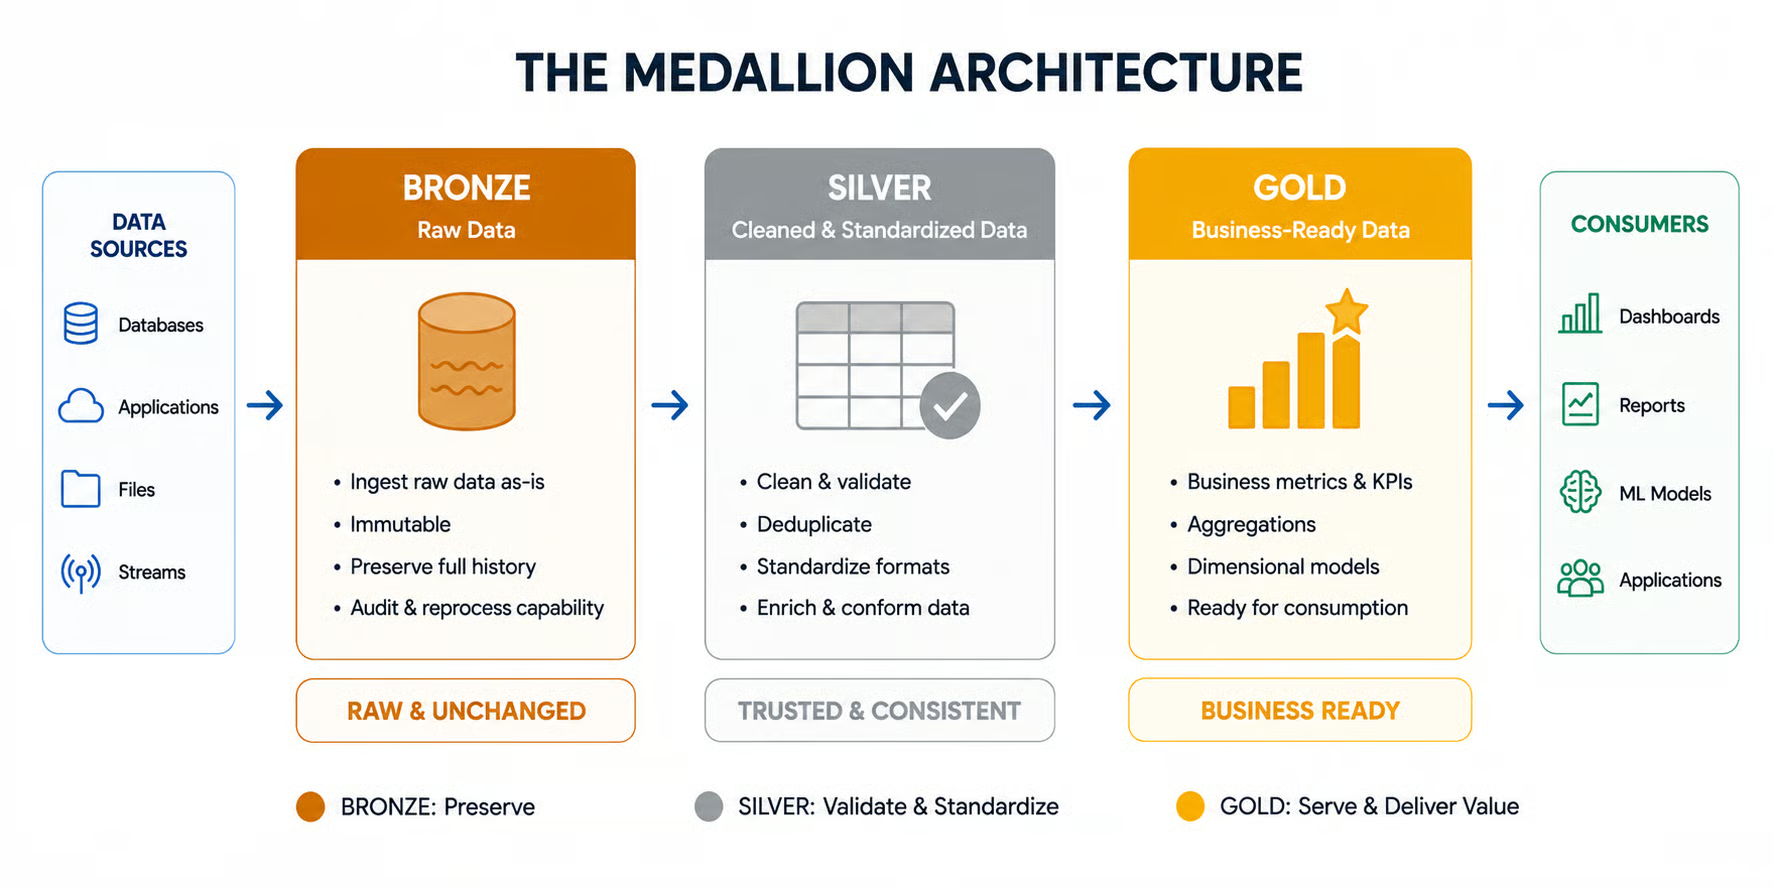
Die Medallion-Architektur ist ein Daten-Designmuster zur logischen Organisation von Daten in einem Data Lakehouse. Sie definiert drei Ebenen, sodass Datenqualität und Struktur zunehmen, während Daten diese Ebenen durchlaufen:
In Data Warehouses mit traditionellen Extract-Transform-Load-(ETL)-Pipelines musst du das Schema deiner Daten im Voraus festlegen. Ändern sich Datenformat oder Schema, schlägt das System fehl, sofern du es nicht manuell anpasst.
In einer medallion-basierten Extract-Load-Transform-(ELT)-architektur speicherst du die Daten zuerst in ihrer Rohform, statt sie on the fly zu transformieren und nur das Endergebnis abzulegen. Dieser Unterschied macht Medallion-Architekturen robust und flexibel: Du kannst Rohdaten unverändert speichern und später entscheiden, wie du sie nutzt.
Für einen vollständigen Vergleich der beiden Konzepte empfehle ich unseren ETL-vs.-ELT-Guide.
Ein weiterer Vorteil der Medallion-Architektur ist ihre Plattformunabhängigkeit. Bronze, Silber und Gold sind logische Stufen, keine Technologien eines bestimmten Anbieters. Du kannst das Muster mit verschiedenen Speichersystemen, Verarbeitungsebenen und Tabellenformaten umsetzen – je nach Datenplattform und Workload-Anforderungen.
|
Merkmal |
Medallion (ELT) |
Traditionelles ETL |
|
Rohdaten |
Bewahrt |
Weg |
|
Schema |
Später entscheiden, in Silber durchgesetzt |
Am Ziel vorab definieren |
|
Reprocessing |
Neuaufbau aus bewahrten Rohdaten |
Erfordert evtl. erneute Extraktion der Quelle |
|
Zeitpunkt der Transformation |
Nach dem Laden |
Vor dem Laden |
|
Datenveredelung |
Schrittweise über Ebenen |
Primär, bevor Daten das Ziel erreichen |
Die drei Medallion-Ebenen bauen logisch aufeinander auf.
Hier landen die Rohdaten unverändert – ob aus relationalen Datenbanken, SaaS-Anwendungen wie Salesforce, Kafka-Themen mit Echtzeit-Events, REST-APIs, CSV-Exports oder IoT-Streams. Die Aufnahme (Ingestion) übernehmen meist Tools wie Fivetran für Change Data Capture oder Databricks Auto Loader für Dateien in Objektspeichern.
Bronze-Daten enthalten typischerweise viele Fehler, Inkonsistenzen und Duplikate und sollten daher nie direkt geschäftlich genutzt werden. Dennoch ist die Ebene als Wiederherstellungspunkt sehr wertvoll, von dem aus du Silber- oder Gold-Daten neu erzeugen kannst.
Die Bedeutung der Ebene liegt in ihrem Fußabdruck: Sie protokolliert jedes Ingestion-Ereignis oder jede Transaktion. Sie enthält oft wertvolle Metadaten wie Aufnahmezeitstempel, Datenherkunft und diverse Kennungen. Ziel ist es, die Daten möglichst roh und vollständig zu speichern, damit du nachgelagerte Pipelines mit denselben Quelldaten erneut abspielen und Fehler sauber debuggen kannst.
Die Silber-Ebene verwandelt Rohdaten in saubere, strukturierte Daten. Beispiele für wichtige Bereinigungsschritte zwischen Bronze und Silber:
Diese Ebene erzwingt außerdem Schemastrenge und unterstützt Schema-Evolution.
Auch Datenqualitätsprüfungen finden hier statt. Zum Beispiel Regeln hinzufügen, die fehlgeschlagene Geschäftsvorfälle oder Ausreißer markieren oder ablehnen. Das ist der erste Schritt zur Qualitätssteigerung, während die Daten die Stufen durchlaufen.
Da in dieser Stufe Daten verändert werden, ist es wichtig, Data-Lineage-Tools wie dbt zu nutzen, um zu verfolgen, wie Daten von Bronze zu Silber transformiert werden. Qualitätsprüfungen werden typischerweise mit dbt-Tests, Great Expectations oder Soda umgesetzt, während Governance über einen Data Catalog wie den Databricks Unity Catalog oder Collibra durchgesetzt wird.
Wenn du lernen willst, wie du unordentliche Daten in saubere Silber-Datensätze verwandelst, starte mit unserem Kurs Cleaning Data in Python.
Die letzte Ebene speichert Daten in möglichst höchster Qualität. Diese stark veredelten Daten werden für Geschäftsberichte in Power BI, Tableau oder Looker genutzt, von nachgelagerten Analyseanwendungen konsumiert oder über einen Feature Store wie Feast oder den Databricks Feature Store ML-Modellen bereitgestellt.
Da die Daten bereits bereinigt sind, geht es hier darum, sie in einen echten Geschäftswert zu übersetzen. Abhängig vom konkreten Use Case (etwa Finanzberichte, Marketing-Dashboards, Alarmsysteme, ML-Training …) sorgen die Transformationen nach Silber dafür, dass Gold exakt die Informationen enthält, die für die Aufgabe nötig sind.
Hier definierst du KPIs, wendest individuelle Geschäftsformeln an oder aggregierst auf Wochen-, Monats- oder Quartalsdaten für geplantes Reporting. Während Bronze- und Silber-Operationen oft ähnlich sind, sind Gold-Operationen flexibler und stärker an deinen Einsatzzweck angepasst.
Das Bewahren von Rohdaten in Bronze zahlt sich nur aus, wenn du sie auch nutzen kannst – nämlich immer dann, wenn sich etwas vor- oder nachgelagert ändert. Die Kosten einer Änderung hängen davon ab, wo sie in der Kette auftritt.
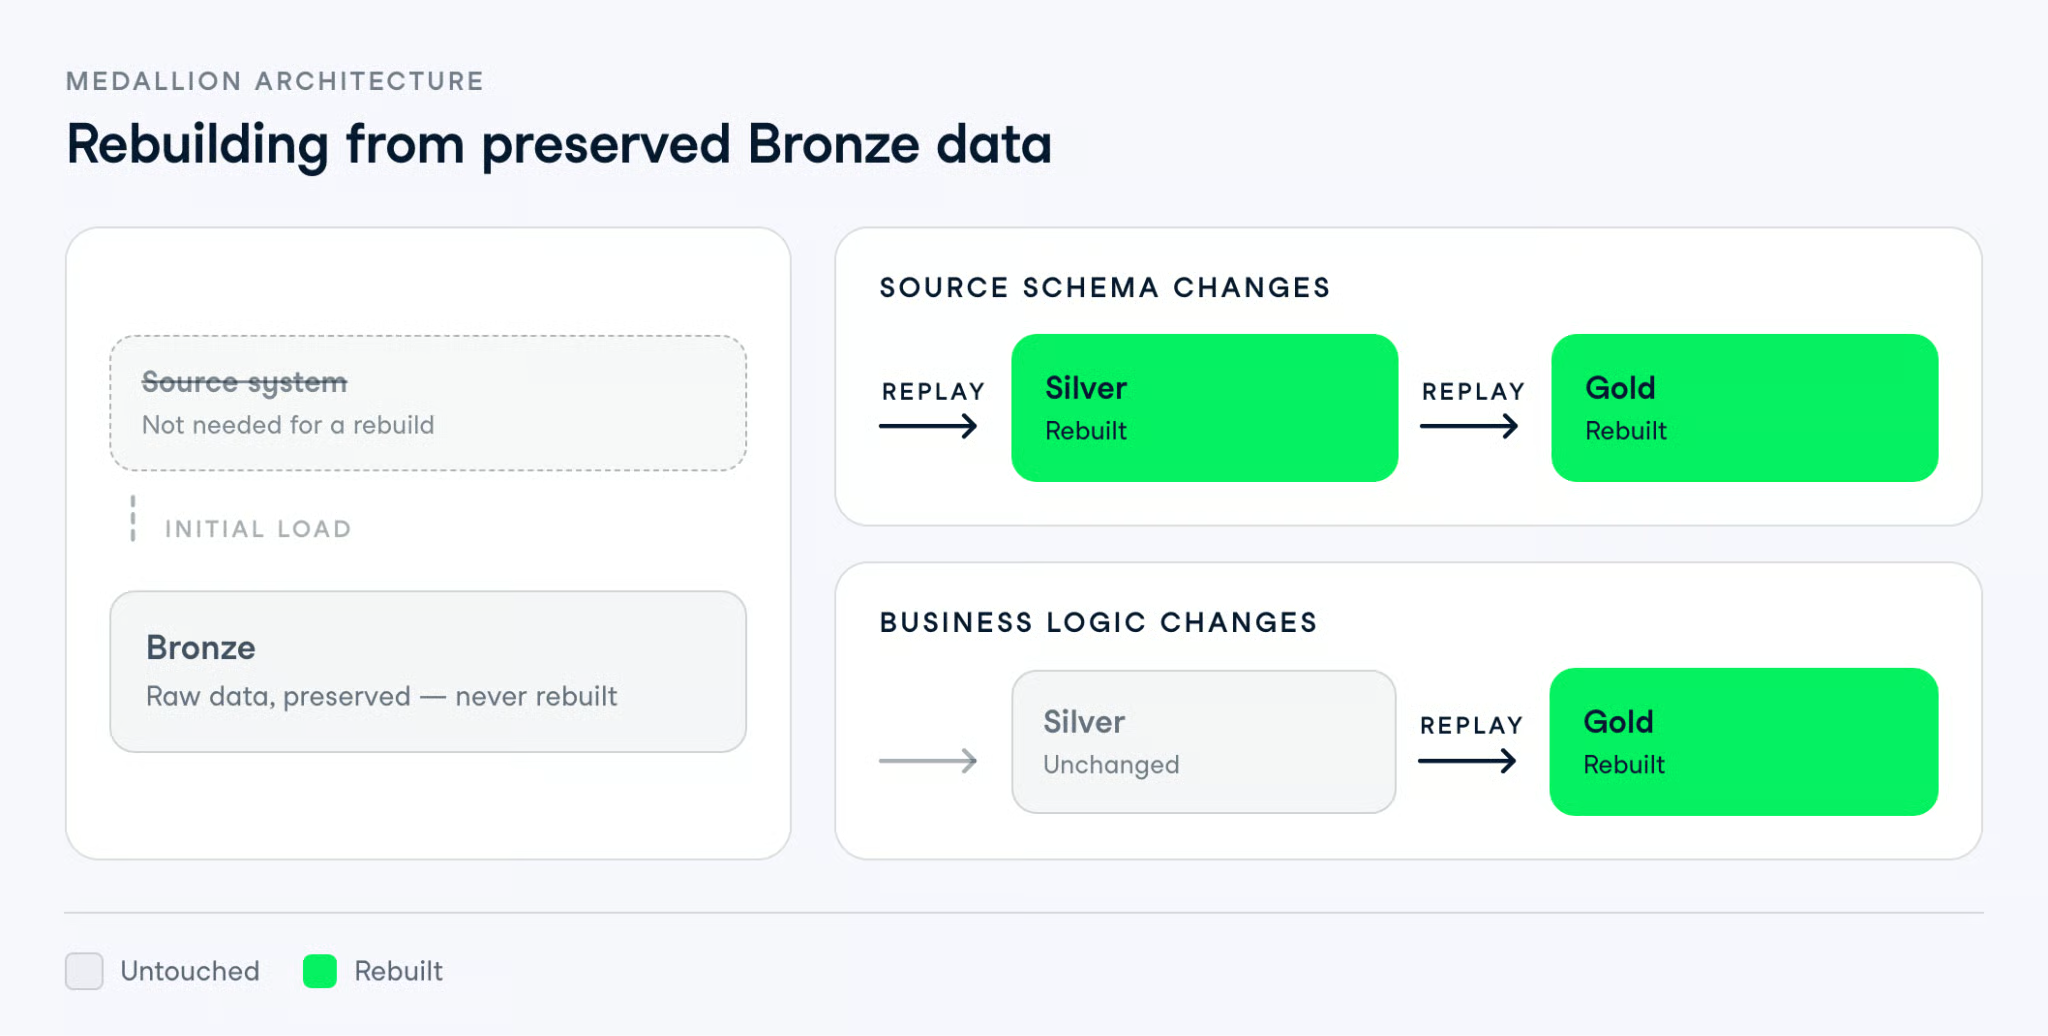
In keinem der beiden Fälle gehst du zurück ins Quellsystem. Genau das macht historische Korrekturen überhaupt erst möglich, denn die Quelle hält die Daten möglicherweise nicht mehr in der ursprünglich aufgenommenen Form.
Außerdem kannst du so eine Metrikdefinition ändern, ohne die Ingestion neu zu fahren – der praktische Grund, warum Teams mit vielen Gold-Verbrauchern die Ebenen trennen.
Ein Data Lakehouse vereint günstigen Objektspeicher eines Data Lakes mit den Transaktionsgarantien eines Warehouses. Es sagt jedoch nichts darüber aus, wie du die Tabellen darin anordnest. Diese Lücke schließt Medallion: Das Lakehouse ist das Speichersubstrat, und Bronze, Silber und Gold sind die Art, wie du es in Kataloge, Schemas und Tabellen mit unterschiedlichen Qualitätsgarantien aufteilst.
In der Praxis ist diese Trennung meist physisch. Auf Databricks hast du etwa drei Schemas in einem Unity-Catalog-Katalog, und in Microsoft Fabric ein Lakehouse mit Bronze- und Silber-Tabellen, die ein Gold-Warehouse speisen. Dasselbe Muster, andere Leitungen.
Offene Tabellenformate sorgen dafür, dass die Ebenen gleichzeitige Lese- und Schreibvorgänge aushalten. Delta Lake, Apache Iceberg und Apache Hudi bieten jeweils Kombinationen aus:
Die Versionierung ist für das soeben beschriebene Replay-Verhalten am wichtigsten. Reine Parquet-Dateien bewahren deine Quelldaten zwar, bieten aber keine Transaktionshistorie zum Zurückrollen – ein fehlerhafter Silber-Lauf überschreibt den guten, und dir fehlt der Vergleich. Delta Lake verfolgt Änderungen in einem Transaktionslog, während Apache Iceberg Tabellenzustände als Snapshots abbildet.
All das ist nicht zwingend. Medallion ist ein logisches Muster, und viele Teams betreiben es auf Postgres-Schemas oder simplen S3-Prefixen mit dbt obendrauf. Du verlierst nur das günstige Rollback.
Beide werden oft verglichen, meist weil man annimmt, sie konkurrierten. Sie beantworten jedoch unterschiedliche Fragen: Data Mesh entscheidet, wer Daten besitzt, und die Medallion-Architektur entscheidet, wie dieser Eigentümer sie veredelt.
Data Mesh überträgt die Verantwortung für Daten an Domänenteams wie Sales, Finance oder Supply Chain. Diese veröffentlichen ihre Daten als Produkte und verantworten Qualität, Auffindbarkeit, Lineage und Governance. Zwei Dinge halten das zusammen: Self-Service-Infrastruktur, die jeder Domäne dieselben Tools gibt, und föderierte Governance, die Standards unternehmensweit setzt, ohne Domänen die Verantwortung zu entziehen.
Medallion-Architektur ist das, was ein Domänenteam in seinem eigenen Bereich betreibt. Ein Supply-Chain-Team mit Versanddaten hält Roh-Events in Bronze, validierte Datensätze in Silber und veröffentlicht analysefertige Versanddaten in Gold für andere Domänen. Das Mesh definiert den Vertrag an der Gold-Grenze; alles davor ist Sache des Teams.
Ein Hinweis, bevor du beides kombinierst: Bronze pro Domäne bedeutet, dass jede Domäne ihre eigenen Ingestions- und Speicherkosten trägt und gemeinsame Dimensionen wie Kunde oder Produkt tendenziell mehrfach aufgebaut werden. Mesh-Befürworter sagen, das ist der Preis für Ownership. Es bleibt ein realer Kostenfaktor und sollte vorab kalkuliert werden.
Medallion bringt Wiederverwendung und Wiederherstellbarkeit – und kostet Speicher, Latenz und mehr Pipelines. Ob sich der Tausch lohnt, hängt fast ausschließlich davon ab, wie viele Verbraucher du hast.
Die Latenz unterschätzt man am leichtesten. Jede Ebene ist meist ein eigener Scheduled Job, daher kann eine dreistufige Batch-Pipeline im Stundentakt dazu führen, dass Gold zwei Stunden hinter der Quelle liegt. Das ist für einen wöchentlichen Umsatzbericht okay, für einen operativen Alarm nicht – darum lesen Teams fürs Alerting häufig direkt aus Silber statt auf Gold zu warten.
Speicher wird zuerst genannt, ist aber meist das kleinere Problem. Bronze liegt in günstigem Objektspeicher, die Duplizierung ist real, aber begrenzt. Was wirklich schmerzt, ist die Zahl der Pipelines: Drei Ebenen über zwanzig Quelltabellen sind sechzig Dinge, die möglichst nicht um 3 Uhr morgens ausfallen sollten.
Dem gegenüber stellt schlechte Datenqualität ihre eigene Rechnung. IBM berichtete 2026, dass 43% der COOs Datenqualität als höchste Datenpriorität nannten – basierend auf Forschungen von 2025 aus dem Institute for Business Value. Mehr als ein Viertel der Organisationen gab jährliche Verluste durch schlechte Datenqualität von über 5 Millionen US-Dollar an.
Die Frage ist also nicht, ob Medallion mehr kostet als eine einzelne Pipeline – das tut es. Sondern ob du für die Alternative ohnehin schon zahlst: mit Abstimmungsmeetings und Dashboards, denen niemand traut.
Medallion spielt seine Stärken aus, wenn dieselben bereinigten Daten mehr als einem Verbraucher dienen. Das ist der beste Indikator – wichtiger als Datenvolumen, Teamgröße oder Anzahl der Quellen.
Setze die Medallion-Architektur ein, wenn:
Lass es bleiben, wenn:
Das Drei-Ebenen-Diagramm ist Standard, kein Muss. Mit einem einzigen Business-Use-Case ist Bronze plus eine kombinierte Ebene oft die richtige Wahl: Rohdaten für Replays bewahren, dann Bereinigung und Geschäftslogik in einem Schritt.
Wähle die Form, die zu deinen Verbraucherinnen und Verbrauchern passt. Was du nicht zusammenklappen solltest, ist Bronze – diese Ebene lässt sich nicht nachträglich rekonstruieren.
Wenn du unschlüssig bist, bau zwei Ebenen und füge die dritte hinzu, sobald ein zweiter Verbraucher auftaucht. Gold später anzuflanschen ist deutlich günstiger, als Bronze nachzurüsten, nachdem du sechs Monate lang deine Rohdaten überschrieben hast.
Die meisten Medallion-Probleme sind nicht architektonisch. Es sind kleine Kompromisse unter Zeitdruck, die unbemerkt den Grund zerstören, warum du die Ebenen überhaupt gebaut hast.
Das gesamte Replay-Argument beruht darauf, dass Bronze etwas nahe am tatsächlich gelieferten Quellzustand hält. Wendest du Geschäftslogik vor der Landung an, ist der Originalzustand weg – kein Reprocessing, kein Audit-Trail.
Oft geschieht das aus nachvollziehbaren Gründen: Jemand wirft eine scheinbar ungenutzte Spalte zur Platzersparnis raus oder coerct ein chaotisches Zeitstempelfeld bei der Ingestion, weil der nächste Job sonst bricht. Sechs Monate später ist die Spalte doch wichtig – die Originalwerte sind weg. Halte Bronze so quellnah wie praktikabel und verschiebe Fixes nach Silber.
Silber bereinigt und standardisiert. Gold beantwortet Geschäftsfragen. Wenn Metriklogik in Silber durchsickert, erbt jeder Gold-Datensatz eine Definition, die er nicht bestellt hat – und du bist zurück beim Problem, das Medallion lösen sollte.
Der Test ist simpel: Wenn eine Business-Userin oder ein Business-User über die Zahl diskutiert, gehört sie in Gold. Deduplizierung ist ein Silber-Thema. Was als aktiver Kunde zählt, nicht.
Die Medallion-Architektur ist ein logisches Designmuster, keine Vorschrift, dass jede Pipeline exakt drei physische Ebenen haben muss. Bronze, Silber und Gold stehen für logische Stufen der Datenveredelung, und jede Ebene kann je nach Workload anders umgesetzt werden.
So kann eine Ebene z. B. mit materialisierten Tabellen, Views oder anderen geeigneten Abstraktionen arbeiten, statt zwingend eine separate physische Kopie der Daten vorzuhalten. Entscheidend ist, sinnvolle Grenzen zu schaffen, während sich Daten vom Rohzustand hin zu etwas bewegen, dem das Business vertrauen und das es nutzen kann – nicht, das klassische Dreischichten-Diagramm sklavisch zu reproduzieren.
Das sehe ich am häufigsten – und es wird am wenigsten besprochen. Gold-Datensätze sind schnell erstellt, und niemand löscht sie. Nach einem Jahr hast du womöglich vierzig Tabellen, elf davon Varianten der Monatsumsätze – und niemand weiß, welche die CFO wirklich nutzt.
Silber hat natürliche Disziplin, weil der Auftrag klar ist. Gold hat das nicht – also braucht jeder Datensatz eine klare Ownerin oder einen Owner und die Bereitschaft zu löschen. Ohne das endest du mit mehreren konkurrierenden Versionen derselben Metrik – genau das, was die Ebenen verhindern sollten.
Was Medallion dir eigentlich gibt: einen klaren Bezugspunkt, wenn jemand fragt, wo eine Zahl herkommt – und eine Kopie der Originaldaten, zu denen du zurückkehren kannst, wenn die Antwort sich als falsch erweist. Das ist den zusätzlichen Speicher und die zusätzlichen Jobs wert, wenn mehrere Teams dieselben Daten nutzen. Wenn nur ein Team sie nutzt, sind zwei Ebenen oft die bessere, wartungsärmere Lösung.
Wenn du den größeren Kontext suchst, unser Kurs Understanding Modern Data Architecture deckt die Plattformen und Technologien moderner Datenstacks ab. Unser Data Engineer-Lernpfad geht tiefer ins Bauen und Betreiben produktiver Pipelines.
Lerne Data Engineering mit DataCamp!
Kurs
Kurs
Lernpfad