Courses
ทำความเข้าใจสถาปัตยกรรมข้อมูลสมัยใหม่
2 ชม.
23.9K
บทสนทนาเรื่องคุณภาพข้อมูลมักโฟกัสที่การแก้ไขข้อมูลต้นทางที่ไม่ดี แต่ทีมข้อมูลต่างกันอาจสร้างแดชบอร์ดที่แตกต่างกันอย่างสิ้นเชิงจากระบบต้นทางเดียวกัน โดยให้ตัวเลขรายได้ไตรมาสเดียวกันไม่ตรงกัน ปัญหาอาจไม่ใช่ข้อมูลต้นทาง ผู้ใช้งานแต่ละรายอาจทำการทำความสะอาด เชื่อม รวม กรอง และนิยามข้อมูลเอง โดยไม่มีมาตรฐานร่วมกันว่าคำว่า "สะอาด" หมายถึงอะไร
สถาปัตยกรรม medallion แก้ปัญหานี้ด้วยการกำหนดขอบเขตที่ชัดเจนในการยกระดับคุณภาพข้อมูล โดยไม่ทำให้ข้อมูลดิบที่เริ่มต้นหายไป มาดูกันว่ามันคืออะไร ทำงานอย่างไร และทำไมจึงเป็นแนวคิดสำคัญในวิศวกรรมข้อมูลและ MLOps
คอร์ส Understanding Modern Data Architecture ของเราอธิบายว่า lakehouse และไปป์ไลน์แบบแบ่งชั้นอยู่ตรงไหนในสแตกข้อมูลโดยรวม และเส้นทางอาชีพ Data Engineer ของเราจะช่วยสร้างทักษะไปป์ไลน์ในภาพรวมเพื่อให้เลเยอร์เหล่านี้ดูแลง่ายเมื่อนำไปใช้จริง
สถาปัตยกรรม medallion คือรูปแบบการออกแบบข้อมูลเพื่อจัดระเบียบข้อมูลในdata lakehouse เชิงตรรกะ โดยกำหนด 3 เลเยอร์ที่ทำให้คุณภาพและโครงสร้างข้อมูลดีขึ้นเมื่อข้อมูลไหลผ่าน:
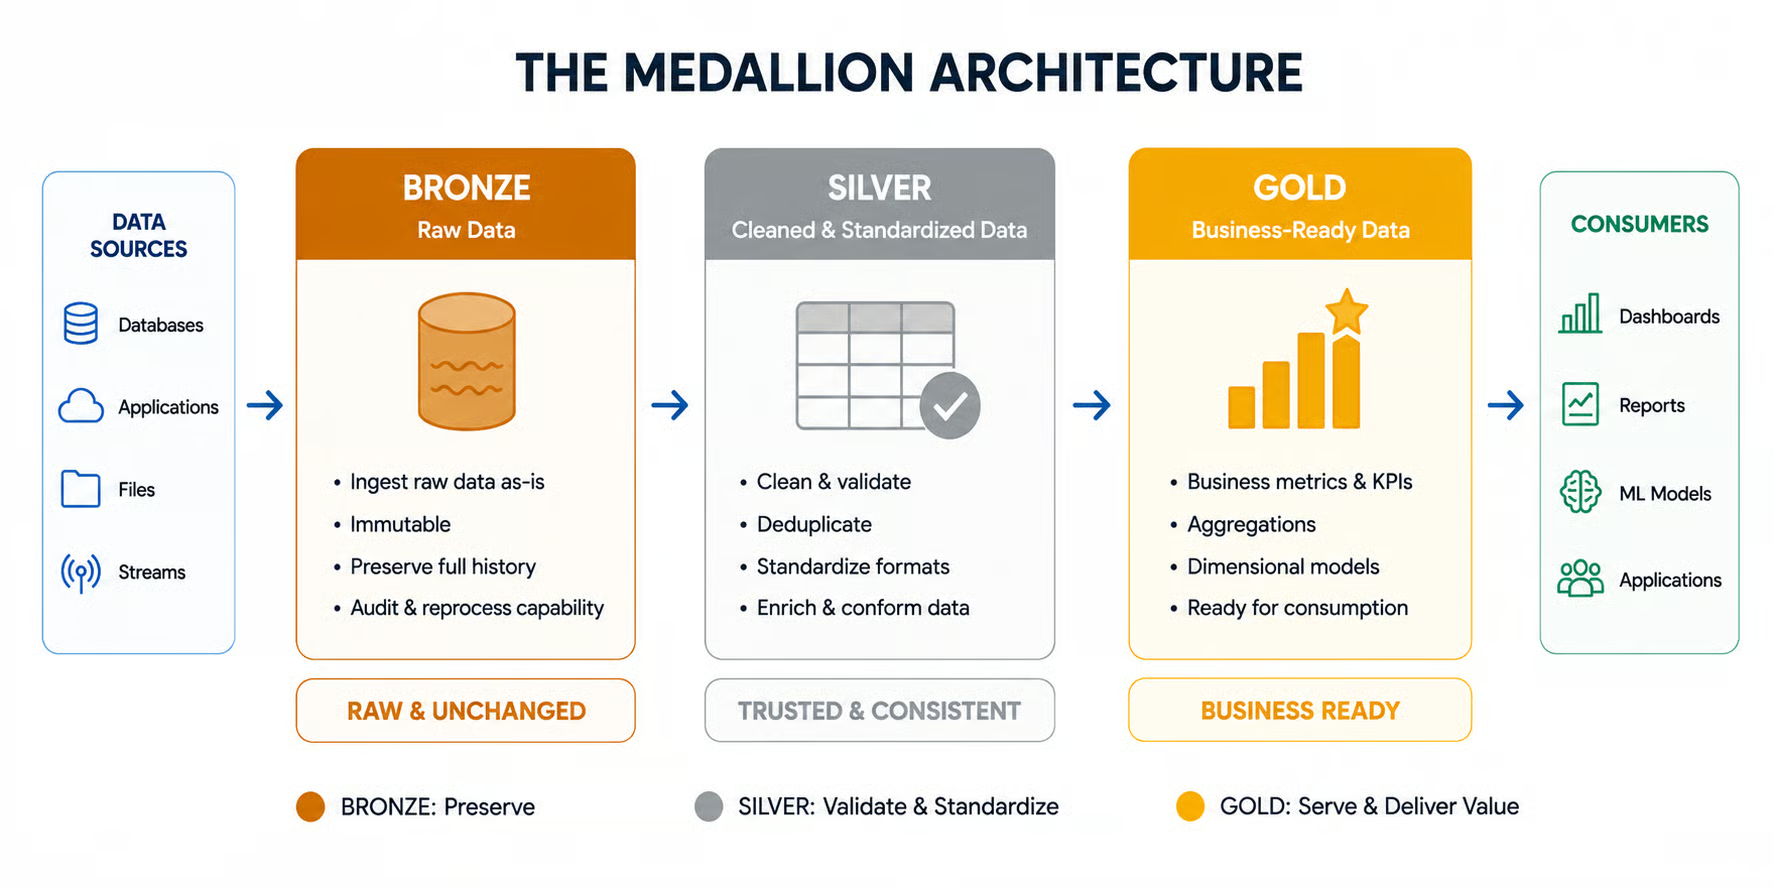
ในคลังข้อมูลที่ใช้ไปป์ไลน์ extract-transform-load (ETL) แบบดั้งเดิม จำเป็นต้องกำหนดสคีมาของข้อมูลล่วงหน้า หากรูปแบบหรือสคีมาของข้อมูลเปลี่ยน ระบบจะล้มเหลวหากไม่ปรับแก้ด้วยตนเอง
ในสถาปัตยกรรม ELT ที่ยึดตาม medallion extract-load-transform (ELT) จะบันทึกข้อมูลในรูปแบบดิบก่อน แทนที่จะเปลี่ยนแปลงทันทีแล้วจัดเก็บข้อมูลสุดท้าย ความแตกต่างนี้ทำให้สถาปัตยกรรมแบบ medallion ทั้งทนทานและยืดหยุ่น: สามารถเก็บข้อมูลดิบตามจริงไว้ แล้วค่อยตัดสินใจภายหลังว่าจะใช้อย่างไร
สำหรับการเปรียบเทียบแบบเต็ม แนะนำให้อ่าน คู่มือ ETL vs ELT ของเรา
ข้อดีอีกอย่างของ medallion คือความเป็นกลางด้านแพลตฟอร์ม Bronze, Silver และ Gold เป็นขั้นตอนเชิงตรรกะ ไม่ผูกติดกับเทคโนโลยีของผู้ขายรายใด สามารถนำรูปแบบนี้ไปใช้กับระบบจัดเก็บ เครื่องประมวลผล และรูปแบบตารางที่แตกต่างกันได้ ตามแพลตฟอร์มข้อมูลและความต้องการงานโหลด
|
คุณลักษณะ |
Medallion (ELT) |
ETL แบบดั้งเดิม |
|
ข้อมูลดิบ |
เก็บรักษาไว้ |
หายไป |
|
สคีมา |
ตัดสินใจภายหลัง บังคับใช้ใน Silver |
กำหนดล่วงหน้าที่ปลายทาง |
|
การประมวลผลซ้ำ |
ประมวลผลใหม่จากข้อมูลดิบที่เก็บไว้ |
อาจต้องดึงข้อมูลจากแหล่งใหม่อีกครั้ง |
|
จังหวะการแปลง |
หลังการโหลด |
ก่อนการโหลด |
|
การปรับแต่งข้อมูล |
ค่อยๆ ดีขึ้นตามแต่ละเลเยอร์ |
ส่วนใหญ่ทำก่อนที่ข้อมูลจะถึงปลายทาง |
ทั้งสามเลเยอร์ต่อกันอย่างมีเหตุผล โดยแต่ละเลเยอร์สร้างต่อยอดจากเลเยอร์ก่อนหน้า
นี่คือที่ที่ข้อมูลดิบถูกนำมาลงตามจริง ไม่ว่าจะมาจากฐานข้อมูลเชิงสัมพันธ์ แอป SaaS อย่าง Salesforce ท็อปปิก Kafka ที่นำส่งเหตุการณ์แบบเรียลไทม์ REST APIs, ไฟล์ CSV หรือ สตรีมจากอุปกรณ์ IoT การรับเข้ามักทำด้วยเครื่องมืออย่าง Fivetran สำหรับ change data capture หรือ Databricks Auto Loader สำหรับไฟล์ที่ลงใน object storage
ข้อมูล Bronze มักมีข้อผิดพลาด ความไม่สอดคล้อง และข้อมูลซ้ำจำนวนมาก จึงไม่ควรถูกใช้โดยตรงเพื่อวัตถุประสงค์ทางธุรกิจ อย่างไรก็ดี เลเยอร์นี้มีคุณค่าอย่างมากในฐานะจุดกู้คืน ซึ่งสามารถสร้างข้อมูล Silver หรือ Gold ขึ้นมาใหม่ได้
ความสำคัญของเลเยอร์อยู่ที่ร่องรอย: บันทึกและล็อกทุกเหตุการณ์การรับเข้าหรือทรานแซกชัน มักมีเมทาดาทาค่ามาก เช่น เวลาในการรับเข้า แหล่งที่มาของข้อมูล และตัวระบุหลากหลายประเภท เป้าหมายคือเก็บข้อมูลให้ดิบและครบถ้วนที่สุด เพื่อให้สามารถเล่นซ้ำไปป์ไลน์ปลายน้ำด้วยข้อมูลต้นฉบับเดียวกันเพื่อดีบักปัญหาได้
เลเยอร์ Silver แปลงข้อมูลดิบให้เป็นข้อมูลที่สะอาดและมีโครงสร้าง ตัวอย่างการทำความสะอาดที่สำคัญระหว่าง Bronze กับ Silver ได้แก่:
เลเยอร์นี้ยังมีการบังคับใช้สคีมา เพื่อให้ข้อมูลตรงตามโครงสร้างที่กำหนดไว้ล่วงหน้าและรองรับการวิวัฒน์ของสคีมา
ที่นี่จะทำการตรวจสอบคุณภาพข้อมูลด้วย เช่น เพิ่มกฎเพื่อทำธงหรือปฏิเสธทรานแซกชันทางธุรกิจที่ล้มเหลวหรือค่าผิดปกติ นี่คือก้าวแรกในการยกระดับคุณภาพข้อมูลเมื่อข้อมูลผ่านแต่ละขั้น
เนื่องจากขั้นตอนนี้มีการแก้ไขข้อมูล จึงสำคัญที่จะใช้เครื่องมือ data lineage อย่าง dbt เพื่อติดตามว่าข้อมูลถูกแปลงจาก Bronze เป็น Silver อย่างไร การตรวจคุณภาพมักทำด้วย dbt tests, Great Expectations หรือ Soda ขณะที่การกำกับดูแลจะบังคับใช้ผ่าน data catalog เช่น Databricks Unity Catalog หรือ Collibra
หากต้องการเรียนรู้การเปลี่ยนข้อมูลรกให้เป็นชุดข้อมูล Silver ที่ถูกต้อง แนะนำเริ่มจากคอร์ส Cleaning Data in Python
เลเยอร์สุดท้ายเก็บข้อมูลที่มีคุณภาพสูงสุด ข้อมูลที่ผ่านการกลั่นอย่างดีนี้ใช้สำหรับการรายงานทางธุรกิจใน Power BI, Tableau หรือ Looker ถูกใช้งานโดยแอปวิเคราะห์ปลายน้ำ หรือเสิร์ฟให้โมเดลแมชชีนเลิร์นนิงผ่าน feature store เช่น Feast หรือ Databricks Feature Store
เมื่อข้อมูลถูกทำความสะอาดแล้ว ขั้นตอนนี้โฟกัสที่การเปลี่ยนให้เป็นทรัพย์สินทางธุรกิจที่มีมูลค่า โดยขึ้นกับกรณีใช้งานเฉพาะ (เช่น รายงานการเงิน แดชบอร์ดการตลาด ระบบแจ้งเตือน การฝึกโมเดล ML ฯลฯ) การแปลงหลัง Silver จะทำให้ Gold มีข้อมูลที่ต้องการตรงกับงาน
ที่นี่จะสร้าง KPI ใช้สูตรธุรกิจแบบกำหนดเอง หรือรวมระดับเป็นรายสัปดาห์ รายเดือน หรือรายไตรมาสสำหรับรายงานตามรอบงาน ขณะที่งานใน Bronze และ Silver มักจะเหมือนกัน งานใน Gold จะยืดหยุ่นและปรับตามการใช้งานข้อมูลมากกว่า
การเก็บข้อมูลดิบใน Bronze จะคุ้มค่าก็ต่อเมื่อสามารถนำมาใช้ได้จริง ซึ่งเกิดขึ้นเมื่อมีการเปลี่ยนแปลงทั้งต้นน้ำหรือปลายน้ำ ต้นทุนของการเปลี่ยนขึ้นอยู่กับว่าอยู่ไกลจากต้นทางแค่ไหน
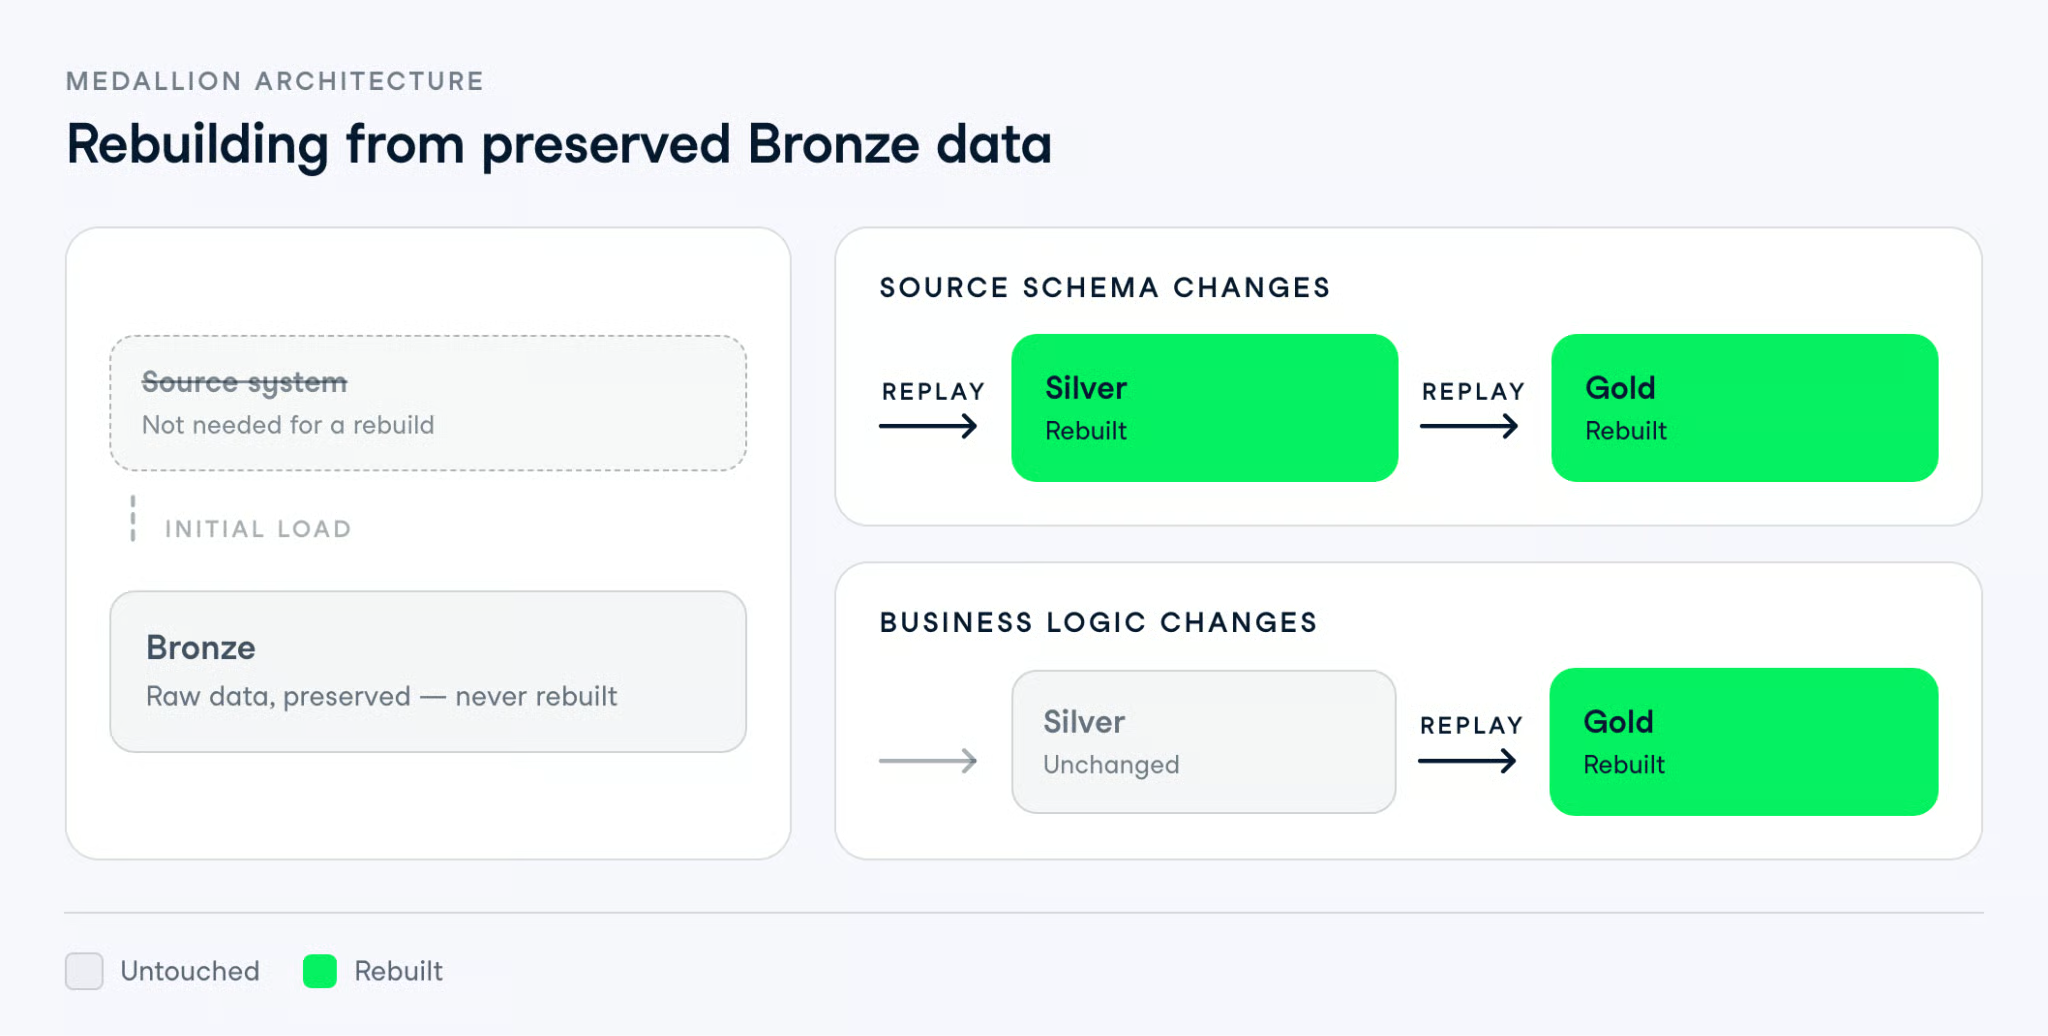
ทั้งสองกรณีไม่ต้องย้อนกลับไปที่ระบบต้นทาง นี่คือสิ่งที่ทำให้การแก้ไขย้อนหลังเป็นไปได้ เพราะแหล่งต้นทางอาจไม่ได้เก็บข้อมูลในรูปแบบเดิมที่รับเข้ามาแล้ว
ยังหมายความว่าสามารถเปลี่ยนนิยามเมตริกได้โดยไม่ต้องรันการรับเข้าใหม่ ซึ่งเป็นเหตุผลเชิงปฏิบัติที่ทีมซึ่งมีผู้ใช้ Gold จำนวนมาก แยกเลเยอร์ออกจากกัน
a data lakehouse ให้พื้นที่จัดเก็บแบบอ็อบเจ็กต์ราคาถูกเหมือน data lake พร้อมการรับประกันเชิงทรานแซกชันแบบคลังข้อมูล โดยตัวมันเองไม่ได้บอกว่าจะจัดตารางภายในอย่างไร ช่องว่างนี้คือสิ่งที่ medallion เติมเต็ม: lakehouse คือฐานจัดเก็บ และ Bronze, Silver, Gold คือแนวทางแบ่งเป็นแคตตาล็อก สคีมา และตารางที่มีการรับประกันคุณภาพต่างกัน
ในทางปฏิบัติ การแบ่งนั้นมักเป็นเชิงกายภาพ บน Databricks อาจมีสามสคีมาในแคตตาล็อกของ Unity Catalog และใน Microsoft Fabric อาจเป็น lakehouse ที่มีตาราง Bronze และ Silver ป้อนให้คลังข้อมูล Gold ลวดลายเดียวกัน ต่างกันที่งานเดินท่อ
รูปแบบตารางแบบเปิดคือสิ่งที่ทำให้เลเยอร์ต่างๆ ทำงานได้แม้มีการอ่านและเขียนพร้อมกัน Delta Lake, Apache Iceberg และ Apache Hudi มีความสามารถผสมผสานกัน เช่น:
การมีเวอร์ชันสำคัญที่สุดสำหรับพฤติกรรมการเล่นซ้ำที่เพิ่งกล่าวถึง ไฟล์ Parquet ดิบเก็บข้อมูลต้นทางได้ดี แต่ไม่มีประวัติทรานแซกชันให้ย้อนกลับ ดังนั้นการรัน Silver ที่ผิดพลาดจะเขียนทับของดี และไม่มีอะไรให้เปรียบเทียบ Delta Lake ติดตามการเปลี่ยนแปลงในบันทึกทรานแซกชัน ขณะที่ Apache Iceberg แทนสถานะตารางเป็นสแน็ปชอต
ทั้งนี้ไม่ได้บังคับใช้ Medallion เป็นรูปแบบตรรกะ และหลายทีมก็รันบนสคีมา Postgres หรือเพียงพรีฟิกซ์ใน S3 ธรรมดา โดยมี dbt ครอบไว้ แค่จะเสียความสะดวกในการย้อนกลับราคาถูก
สองสิ่งนี้มักถูกเปรียบเทียบ เพราะมักเข้าใจว่าชนกัน ทั้งที่ตอบคำถามคนละอย่าง: data mesh ตัดสินใจว่าใครเป็นเจ้าของข้อมูล ส่วน medallion ตัดสินใจว่าอย่างไรที่เจ้าของนั้นจะปรับแต่งข้อมูล
Data mesh มอบความรับผิดชอบด้านข้อมูลให้ทีมตามโดเมน เช่น การขาย การเงิน หรือซัพพลายเชน ซึ่งเผยแพร่ข้อมูลเป็นผลิตภัณฑ์และเป็นเจ้าของคุณภาพ การค้นหา lineage และการกำกับดูแล สองสิ่งที่ยึดทั้งหมดไว้คือ โครงสร้างพื้นฐานแบบ self-service ที่ให้ทุกโดเมนใช้เครื่องมือเดียวกัน และการกำกับดูแลแบบสหพันธ์ที่ตั้งมาตรฐานระดับองค์กรโดยไม่ดึงการเป็นเจ้าของออกจากโดเมน
Medallion architecture คือสิ่งที่ทีมโดเมนรันภายในส่วนของตัวเอง ทีมซัพพลายเชนที่เป็นเจ้าของข้อมูลการขนส่งจะเก็บเหตุการณ์การขนส่งดิบไว้ใน Bronze ระเบียนที่ตรวจสอบแล้วใน Silver และเผยแพร่ชุดข้อมูลการขนส่งพร้อมวิเคราะห์ใน Gold ให้โดเมนอื่นนำไปใช้ Mesh กำหนดสัญญาที่ขอบเขต Gold ส่วนทุกอย่างก่อนหน้านั้นเป็นเรื่องของทีมนั้น
ข้อควรระวังก่อนผสานสองแนวคิด: Bronze รายโดเมนหมายความว่าแต่ละโดเมนต้องรับต้นทุนการรับเข้าและจัดเก็บเอง และมิติเชิงร่วม เช่น ลูกค้า หรือสินค้า มักถูกสร้างซ้ำในสามที่ ผู้สนับสนุน mesh จะบอกว่านั่นคือราคาของความเป็นเจ้าของ แต่มันก็เป็นต้นทุนจริง ควรประเมินก่อนตัดสินใจ
Medallion ให้การนำกลับมาใช้ซ้ำและการกู้คืน แลกกับต้นทุนด้านพื้นที่เก็บ ความหน่วง และจำนวนไปป์ไลน์ ว่าคุ้มไหมขึ้นกับจำนวนผู้บริโภคข้อมูลเป็นหลัก
ประเด็นความหน่วงมักประเมินต่ำไป แต่ละเลเยอร์มักเป็นงานตามตารางของตัวเอง ไปป์ไลน์แบบแบตช์สามเลเยอร์ที่รันรายชั่วโมงอาจทำให้ Gold ล้าหลังระบบต้นทางสองชั่วโมง ซึ่งใช้ได้กับรายงานรายได้รายสัปดาห์ แต่ไม่เหมาะกับการแจ้งเตือนปฏิบัติการ จึงมักให้ระบบแจ้งเตือนอ่านจาก Silver โดยตรงแทนการรอ Gold
ต้นทุนพื้นที่เก็บมักถูกหยิบยกก่อน และโดยทั่วไปเป็นปัญหาที่เล็กกว่า Bronze อยู่ใน object storage ราคาถูก และการซ้ำซ้อนมีจริงแต่จำกัด สิ่งที่เจ็บจริงคือจำนวนไปป์ไลน์: สามเลเยอร์คูณยี่สิบตารางต้นทาง เท่ากับหกสิบสิ่งที่อาจล้มเหลวตอนตีสาม
เมื่อเทียบกันแล้ว คุณภาพข้อมูลที่แย่ก็มีต้นทุนของมันเอง IBM รายงานในปี 2026 ว่า 43% ของ COO ระบุคุณภาพข้อมูลเป็นลำดับความสำคัญสูงสุดด้านข้อมูล โดยอ้างอิงงานวิจัยปี 2025 จากสถาบัน Institute for Business Value มากกว่าหนึ่งในสี่ขององค์กรในงานศึกษานั้นรายงานความสูญเสียต่อปีจากคุณภาพข้อมูลที่ย่ำแย่เกิน 5 ล้านดอลลาร์
ดังนั้นคำถามจึงไม่ใช่ว่าทำ medallion มีต้นทุนมากกว่าไปป์ไลน์เดี่ยวหรือไม่ เพราะมีแน่ คำถามคือจ่ายอยู่แล้วหรือยังกับทางเลือกนั้น ผ่านการประชุมไกล่เกลี่ยตัวเลขและแดชบอร์ดที่ไม่มีใครเชื่อถือ
Medallion คุ้มค่าเมื่อข้อมูลที่ทำความสะอาดเดียวกันถูกใช้โดยผู้บริโภคมากกว่าหนึ่งราย นี่คือตัวทำนายที่ดีที่สุด เหนือกว่าปริมาณข้อมูล ขนาดทีม หรือจำนวนแหล่งข้อมูลที่ดึง
ใช้ medallion เมื่อ:
ข้ามเมื่อ:
ไดอะแกรมสามชั้นเป็นค่าเริ่มต้น ไม่ใช่ข้อบังคับ หากมีกรณีใช้งานธุรกิจเดียว มักใช้ Bronze บวกอีกหนึ่งเลเยอร์รวมจะเหมาะกว่า: เก็บข้อมูลดิบไว้สำหรับเล่นซ้ำ แล้วทำความสะอาดและตรรกะธุรกิจในขั้นตอนเดียว
เลือกโครงให้ตรงกับผู้ใช้ปลายทาง สิ่งที่ไม่ควรยุบคือ Bronze เพราะเป็นเลเยอร์ที่สร้างใหม่ไม่ได้
ดังนั้นหากยังไม่แน่ใจ การสร้างสองเลเยอร์ก่อน และเพิ่มเลเยอร์ที่สามเมื่อมีผู้ใช้รายที่สอง เป็นทางเลือกที่ดี การเพิ่ม Gold ภายหลังถูกกว่ามากเมื่อเทียบกับการยัด Bronze ย้อนหลังหลังจากเขียนทับข้อมูลดิบมาหกเดือน
ปัญหา medallion ส่วนใหญ่ไม่ใช่เรื่องสถาปัตยกรรม แต่เป็นการประนีประนอมเล็กๆ ภายใต้เดดไลน์ที่ค่อยๆ ลบเหตุผลที่สร้างเลเยอร์ขึ้นมาตั้งแต่แรก
เหตุผลทั้งหมดของการเล่นซ้ำตั้งอยู่บนฐานที่ว่า Bronze เก็บสิ่งที่ใกล้เคียงกับสิ่งที่ต้นทางส่งมา หากใช้ตรรกะธุรกิจก่อนลง คุณจะสูญเสียสถานะดั้งเดิม หมายถึงไม่มีการประมวลผลซ้ำและไม่มีร่องรอยตรวจสอบ
สิ่งนี้มักเกิดด้วยเหตุผลที่ดูดี เช่น ตัดคอลัมน์ที่ไม่มีใครใช้เพื่อประหยัดพื้นที่ หรือแปลงช่องเวลาแบบรกตั้งแต่รับเข้าเพราะทำให้งานถัดไปพัง หกเดือนต่อมา คอลัมน์ที่คิดว่าไม่ใช้กลับสำคัญ แต่ค่าดั้งเดิมหายไป เก็บ Bronze ให้ใกล้ต้นทางที่สุดเท่าที่ทำได้ และเอาไปแก้ใน Silver
Silver ทำความสะอาดและทำมาตรฐาน Gold ตอบคำถามธุรกิจ เมื่อโลจิกเมตริกไหลเข้าไปใน Silver ชุดข้อมูล Gold ทั้งหมดจะสืบทอดนิยามที่ไม่ได้ร้องขอ กลับไปสู่ปัญหาที่ medallion ตั้งใจจะแก้
บททดสอบง่ายๆ: ถ้าผู้ใช้ธุรกิจโต้เถียงกับตัวเลข แปลว่ามันควรอยู่ใน Gold การลบข้อมูลซ้ำเป็นเรื่องของ Silver ส่วนอะไรที่นับเป็นลูกค้าที่แอ็กทีฟ ไม่ใช่
Medallion เป็นรูปแบบการออกแบบเชิงตรรกะ ไม่ใช่ข้อกำหนดว่าทุกไปป์ไลน์ต้องมีสามเลเยอร์ทางกายภาพพอดี Bronze, Silver และ Gold คือขั้นตอนเชิงตรรกะของการปรับแต่งข้อมูล และแต่ละเลเยอร์อาจถูกทำให้เป็นจริงต่างกันตามงาน
ตัวอย่างเช่น เลเยอร์หนึ่งอาจใช้ตาราง materialized, มุมมอง (views) หรือ abstraction อื่น แทนที่จะต้องมีชุดข้อมูลสำเนาแยก จุดสำคัญคือการสร้างขอบเขตที่มีความหมายในขณะที่ข้อมูลเคลื่อนจากสถานะดิบไปสู่สิ่งที่ธุรกิจเชื่อถือและใช้ได้ ไม่ใช่การทำซ้ำไดอะแกรมสามชั้นแบบคลาสสิกเป๊ะๆ
นี่คือสิ่งที่เห็นบ่อยสุดแต่พูดถึงน้อย ชุดข้อมูล Gold สร้างได้ง่าย และแทบไม่มีใครลบ ท้ายปีอาจมีสี่สิบตาราง สิบเอ็ดตารางเป็นเวอร์ชันต่างๆ ของรายได้รายเดือน และไม่มีใครจำได้ว่า CFO ดูตารางไหนจริง
Silver มีวินัยโดยธรรมชาติ เพราะหน้าที่ชัดเจน Gold ไม่มี จึงต้องมีเจ้าของต่อชุดข้อมูลและความกล้าที่จะลบ ไม่เช่นนั้นจะลงเอยด้วยหลายเวอร์ชันของเมตริกเดียวกัน ซึ่งเป็นหนึ่งในปัญหาที่เลเยอร์ตั้งใจจะป้องกัน
สิ่งที่ medallion ให้จริงๆ คือจุดที่ชี้ได้ว่าเลขตัวนี้มาจากไหน และสำเนาข้อมูลดิบให้ย้อนกลับไปเมื่อคำตอบนั้นผิดพลาด คุ้มกับพื้นที่เก็บและงานที่เพิ่มขึ้นเมื่อมีหลายทีมอ่านข้อมูลเดียวกัน หากมีทีมเดียว สองเลเยอร์อาจเป็นทางเลือกที่ดีกว่าและประหยัดงานดูแล
หากต้องการบริบทกว้างขึ้นว่าแพตเทิร์นนี้อยู่ตรงไหน คอร์ส Understanding Modern Data Architecture ของเราครอบคลุมแพลตฟอร์มและเทคโนโลยีเบื้องหลังสแตกข้อมูลยุคใหม่ เส้นทางอาชีพ Data Engineer ของเราจะลงลึกในการสร้างและดูแลไปป์ไลน์ใช้งานจริง
เรียน Data Engineering กับ DataCamp!
Courses
Courses
Tracks