
Curso
Entendendo a Arquitetura de Dados Moderna
2 h
23.9K
A maior parte das conversas sobre qualidade de dados foca em consertar dados ruins na origem. Mas times diferentes conseguem construir cinco dashboards completamente distintos a partir do mesmo sistema-fonte, com números de receita diferentes para o mesmo trimestre. A fonte não é necessariamente o problema aqui. Cada consumidor pode estar limpando, unindo, filtrando e definindo esses dados de forma independente, sem um padrão comum do que significa "limpo".
A arquitetura Medallion resolve esse problema ao dar aos times de dados limites explícitos para melhorar a qualidade sem perder os dados brutos de partida. Vamos ver o que é, como funciona e por que é um conceito tão importante em engenharia de dados e MLOps.
Nosso curso Understanding Modern Data Architecture mostra onde lakehouses e pipelines em camadas se encaixam no stack de dados moderno. E nossa trilha de carreira Data Engineer desenvolve as competências de pipeline necessárias para manter essas camadas em produção.
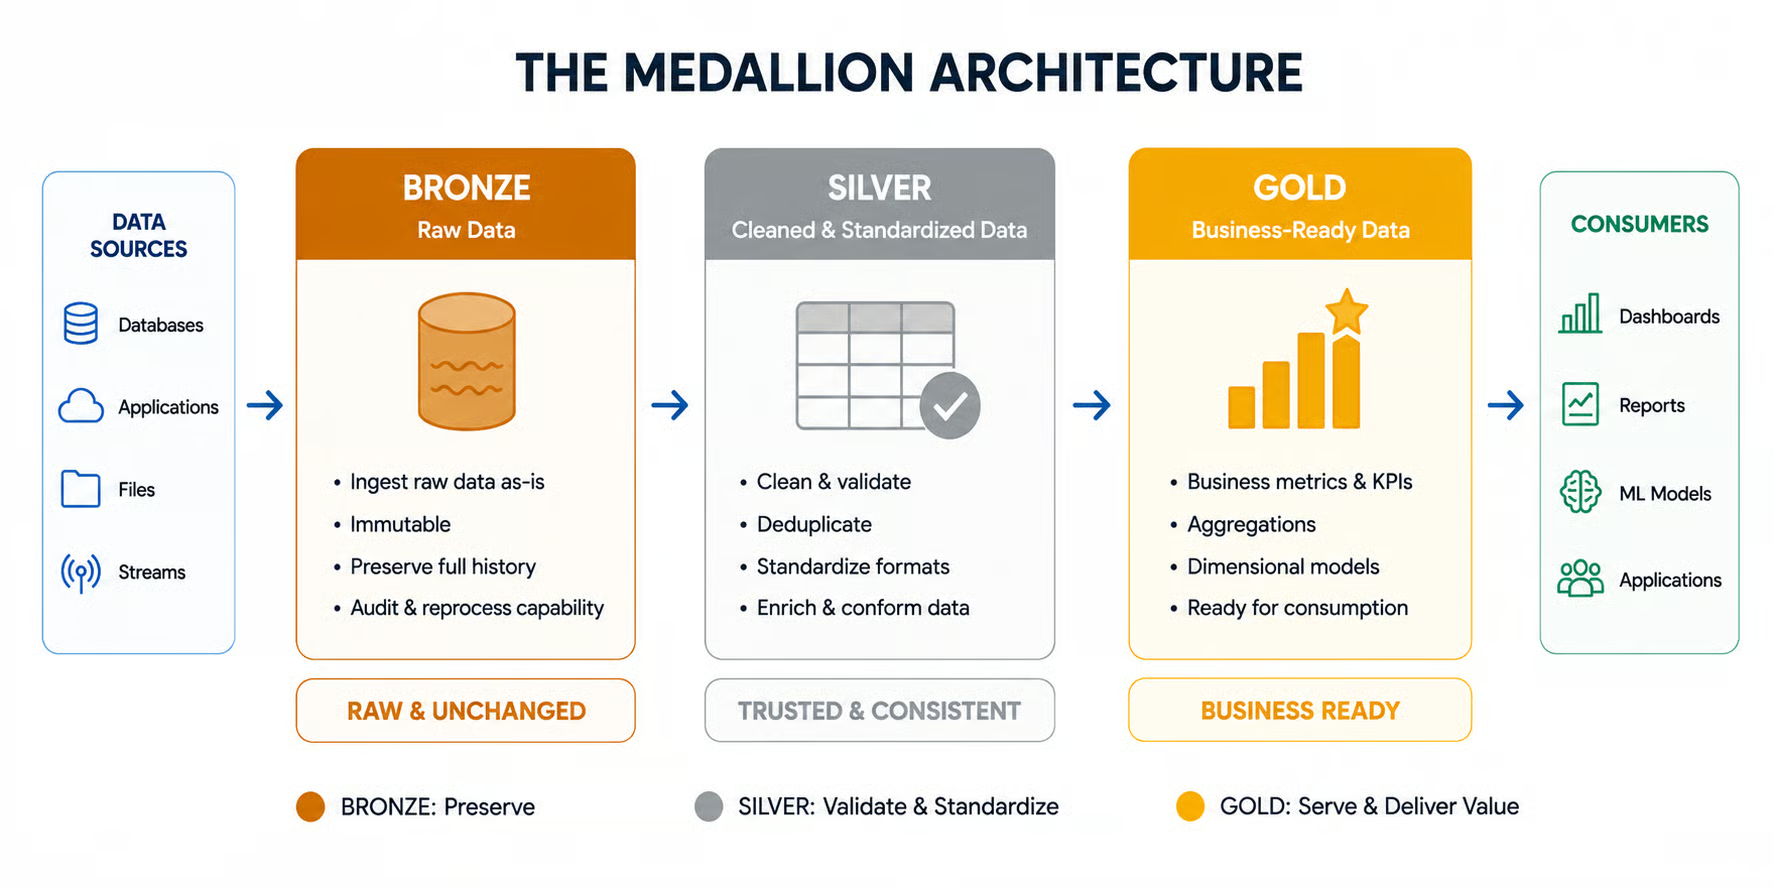
A arquitetura Medallion é um padrão de design de dados para organizar logicamente os dados em um data lakehouse. Ela define 3 camadas nas quais a qualidade e a estrutura dos dados evoluem conforme eles avançam:
Em data warehouses com pipelines tradicionais de extract-transform-load (ETL), você precisa definir o esquema dos dados antecipadamente. Se o formato ou o esquema mudam, o sistema falha a menos que você ajuste tudo manualmente.
Em uma arquitetura de extract-load-transform (ELT) baseada em Medallion, você salva os dados primeiro na forma bruta, em vez de transformá-los no caminho e armazenar apenas o resultado final. Essa diferença torna arquiteturas Medallion robustas e flexíveis: você pode guardar os dados como estão e decidir depois como usá-los.
Para uma comparação completa entre os dois conceitos, recomendo a leitura do nosso guia ETL vs. ELT.
Outra vantagem da arquitetura Medallion é sua natureza agnóstica de plataforma. Bronze, Silver e Gold são estágios lógicos, não tecnologias atreladas a um fornecedor. Você pode implementar o padrão com diferentes sistemas de armazenamento, motores de processamento e formatos de tabela, dependendo da sua plataforma de dados e dos requisitos de carga de trabalho.
|
Recurso |
Medallion (ELT) |
ETL tradicional |
|
Dados brutos |
Preservados |
Perdidos |
|
Esquema |
Decide depois; aplicado no Silver |
Define antecipadamente no destino |
|
Reprocessamento |
Reprocessa a partir dos dados brutos preservados |
Pode exigir reextrair a fonte |
|
Momento da transformação |
Após o carregamento |
Antes do carregamento |
|
Refino dos dados |
Progressivo entre camadas |
Principalmente antes de chegar ao destino |
As três camadas seguem uma lógica, cada uma construindo sobre a anterior.
Aqui é onde os dados brutos chegam como são, seja de bancos relacionais, aplicativos SaaS como Salesforce, tópicos do Kafka com eventos em tempo real, APIs REST, exports em CSV ou fluxos de dispositivos IoT. A ingestão geralmente é feita por ferramentas como Fivetran para captura de alterações (CDC) ou Databricks Auto Loader para arquivos em storage de objetos.
Dados Bronze costumam conter muitos erros, inconsistências e duplicidades, então nunca devem ser usados diretamente para fins de negócio. Dito isso, a camada é valiosíssima como ponto de recuperação a partir do qual você pode regenerar dados Silver ou Gold.
A importância dessa camada está em seu rastro: ela registra e loga cada evento de ingestão ou transação. Frequentemente contém metadados valiosos, como timestamps de ingestão, origem dos dados e vários identificadores. O objetivo é armazenar os dados o mais brutos e completos possível, para que você possa reexecutar pipelines a jusante com a mesma fonte e depurar qualquer erro.
A camada Silver transforma dados brutos em dados limpos e estruturados. Alguns exemplos de transformações de limpeza importantes que ocorrem entre Bronze e Silver:
Esta camada também faz a aplicação de esquema (schema enforcement), garantindo que os dados atendam a uma estrutura predefinida e suportando evolução de esquema.
Aqui também entram os checks de qualidade. Por exemplo, adicionar regras para sinalizar ou rejeitar transações de negócio com falha ou outliers. Este é o primeiro passo para elevar a qualidade conforme os dados avançam pelas etapas.
Como esta etapa envolve modificação de dados, é importante usar ferramentas de linhagem de dados como o dbt para rastrear como os dados são transformados de Bronze para Silver. Checks de qualidade são normalmente implementados com testes do dbt, Great Expectations ou Soda, enquanto a governança é aplicada via um catálogo de dados como o Databricks Unity Catalog ou o Collibra.
Se você quer aprender a transformar dados bagunçados em conjuntos Silver de verdade, recomendo começar pelo nosso curso Cleaning Data in Python.
A camada final armazena os dados no nível mais alto de qualidade. Esses dados super refinados são usados para reportes de negócio no Power BI, Tableau ou Looker, consumidos por aplicações analíticas a jusante ou servidos a modelos de machine learning via um feature store como o Feast ou o Databricks Feature Store.
Como os dados já estão limpos, esta etapa foca em transformá-los em um ativo de negócio valioso. Dependendo do caso de uso específico (pense em relatórios financeiros, dashboards de marketing, sistemas de alerta, treino de modelos de ML, …), as transformações após Silver garantem que Gold contenha exatamente a informação necessária para a tarefa.
Aqui você cria KPIs, aplica fórmulas de negócio personalizadas ou agrega por semana, mês ou trimestre para relatórios programados. Enquanto operações nas camadas Bronze e Silver costumam ser comuns, as da Gold são mais flexíveis e customizadas ao uso dos dados.
Preservar dados brutos em Bronze só compensa se você realmente conseguir usá-los, e isso acontece sempre que algo a montante ou a jusante muda. O custo da mudança depende de quão adiante ela está na cadeia.
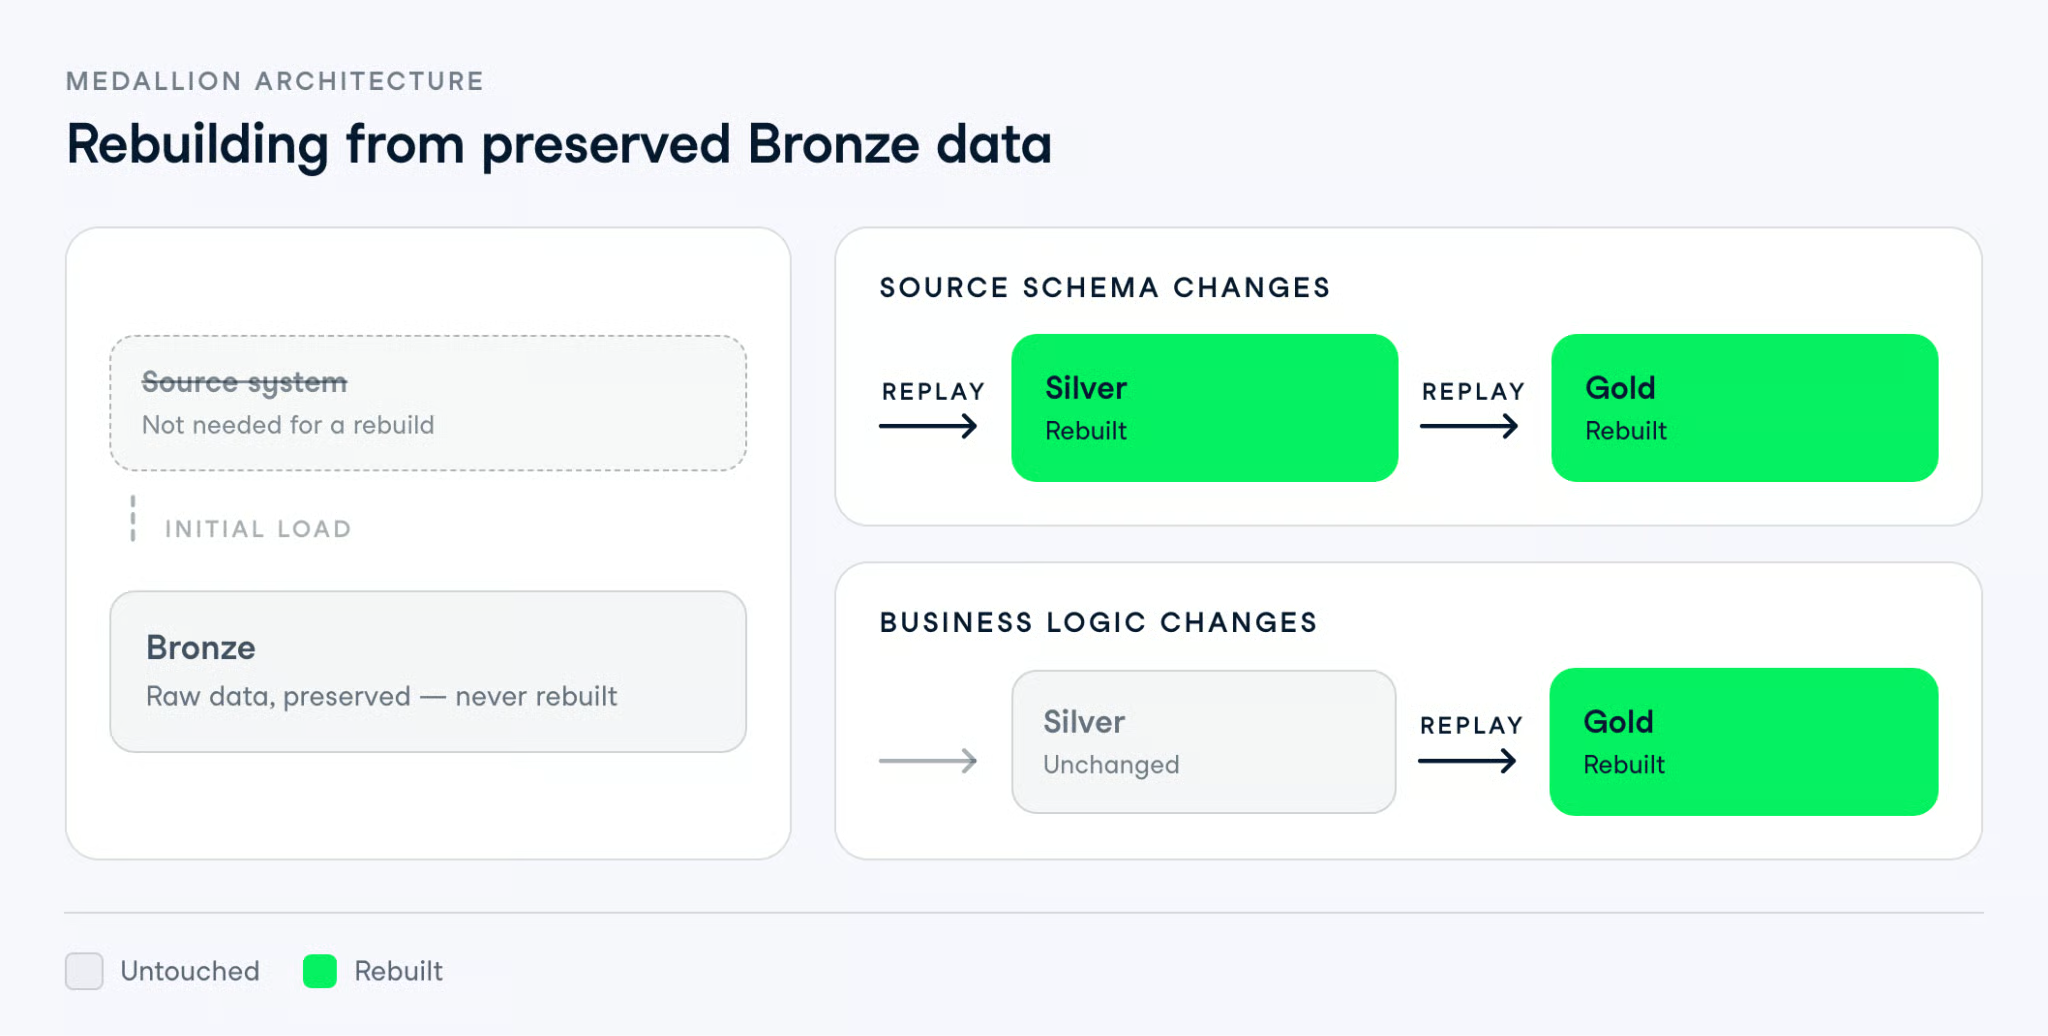
Em nenhum dos casos você volta ao sistema-fonte. É isso que torna possíveis correções históricas, já que a fonte pode não manter mais os dados no formato originalmente ingerido.
Também significa que você pode mudar a definição de uma métrica sem reexecutar a ingestão — motivo prático pelo qual times com muitos consumidores Gold mantêm as camadas separadas.
Um data lakehouse combina o armazenamento barato em objetos de um data lake com garantias transacionais de um warehouse. Ele não diz nada sobre como organizar as tabelas dentro dele. É aí que a Medallion entra: o lakehouse é o substrato de armazenamento, e Bronze, Silver e Gold são como você o divide em catálogos, esquemas e tabelas com diferentes garantias de qualidade.
Na prática, essa divisão costuma ser física. No Databricks, você pode ter três esquemas em um catálogo do Unity Catalog; no Microsoft Fabric, um lakehouse com tabelas Bronze e Silver alimentando um warehouse Gold. Mesmo padrão, encanamentos diferentes.
Formatos de tabela abertos são o que fazem as camadas aguentarem leituras e escritas concorrentes. Delta Lake, Apache Iceberg e Apache Hudi oferecem algum conjunto de:
A versionagem é crucial para o comportamento de replay que acabamos de discutir. Arquivos Parquet brutos preservam bem a fonte, mas não fornecem histórico transacional para desfazer mudanças, então uma execução Silver ruim sobrescreve a boa e você fica sem referência. O Delta Lake rastreia mudanças em um transaction log, enquanto o Apache Iceberg representa estados da tabela como snapshots.
Nada disso é obrigatório. Medallion é um padrão lógico, e muitos times o rodam em esquemas Postgres ou prefixos simples no S3 com dbt por cima. Você só perde o rollback barato.
Os dois são muito comparados, geralmente porque assumem que competem. Eles respondem a perguntas diferentes: data mesh define quem é dono dos dados, e a arquitetura Medallion decide como esse dono os refina.
Data mesh entrega a responsabilidade dos dados a times de domínio como vendas, finanças ou supply chain, que publicam seus dados como produtos e são donos de sua qualidade, descobribilidade, linhagem e governança. Duas coisas sustentam isso: uma infraestrutura self-service que dá as mesmas ferramentas a todos os domínios e uma governança federada que define padrões organizacionais sem tirar a autonomia dos domínios.
Arquitetura Medallion é o que um time de domínio roda dentro do seu escopo. Um time de supply chain dono dos dados de embarque mantém eventos brutos em Bronze, registros validados em Silver e publica conjuntos de dados de embarque prontos para análise em Gold, para outros domínios consumirem. O mesh define o contrato na fronteira Gold; tudo a montante é responsabilidade desse time.
Um aviso antes de combiná-los: camadas Bronze por domínio significam que cada domínio arca com seu custo de ingestão e armazenamento, e dimensões compartilhadas como cliente ou produto tendem a ser reconstruídas em três lugares. Defensores do mesh diriam que esse é o preço da propriedade. Ainda assim, é um custo real — vale estimar antes de decidir.
Medallion traz reaproveitamento e capacidade de recuperação, e cobra por armazenamento, latência e quantidade de pipelines. Se a troca compensa depende quase inteiramente de quantos consumidores você tem.
A latência é a mais fácil de subestimar. Cada camada costuma ser um job com agenda própria, então um pipeline em lote de três camadas rodando de hora em hora pode deixar a Gold duas horas atrás do sistema-fonte. Tudo bem para um relatório semanal de receita; não serve para um alerta operacional — por isso muitos times deixam alertas lerem Silver diretamente em vez de esperar pela Gold.
Armazenamento é o custo que aparece primeiro, e geralmente é o menor problema. Bronze fica em storage de objetos barato, e a duplicação é real, mas limitada. O que realmente dói é a contagem de pipelines: três camadas em vinte tabelas-fonte viram sessenta pontos que podem falhar às 3 da manhã.
Colocado contra isso, a má qualidade de dados tem sua própria conta. A IBM reportou em 2026 que 43% dos COOs citaram qualidade de dados como a maior prioridade, com base em pesquisa de 2025 do seu Institute for Business Value. Mais de um quarto das organizações nesse estudo relataram perdas anuais acima de US$ 5 milhões devido à baixa qualidade de dados.
Então a questão não é se implementar uma arquitetura Medallion custa mais do que um único pipeline — custa. A questão é se você já não está pagando pela alternativa em reuniões de reconciliação e dashboards que ninguém confia.
Medallion mostra seu valor quando os mesmos dados limpos atendem a mais de um consumidor. Esse é o melhor preditor, à frente de volume, tamanho do time ou quantidade de fontes.
Use a arquitetura Medallion quando:
Pule quando:
O diagrama de três camadas é o padrão, não uma obrigação. Com um único caso de uso de negócio, Bronze mais uma camada combinada costuma ser a melhor escolha: preserve os dados brutos para replay e faça limpeza e lógica de negócio em um passo.
Escolha o formato que melhor atende seus consumidores. O que não deve ser colapsado é Bronze, porque é a única camada que você não consegue recriar.
Então, se você está no meio do caminho e sinceramente não sabe, construir duas camadas e adicionar a terceira quando surgir um segundo consumidor é uma boa estratégia. Adicionar Gold depois é muito mais barato do que adaptar Bronze se você passou os últimos seis meses sobrescrevendo os dados brutos.
A maioria dos problemas com Medallion não é arquitetural. São pequenos atalhos sob pressão de prazo que, silenciosamente, removem o motivo de ter criado as camadas.
Todo o argumento do replay depende de Bronze guardar algo próximo do que a fonte realmente enviou. Aplique lógica de negócio antes de aterrissar e você perde o estado original — sem reprocessamento e sem trilha de auditoria.
Isso geralmente acontece por bons motivos. Alguém remove uma coluna que ninguém usa para economizar espaço, ou força um campo de timestamp bagunçado na ingestão porque quebra o próximo job. Seis meses depois, a coluna "inútil" era importante — e os valores originais se foram. Mantenha Bronze o mais próximo possível da fonte e deixe os consertos para Silver.
Silver limpa e padroniza. Gold responde perguntas de negócio. Quando a lógica de métrica vaza para Silver, todo dataset Gold herda uma definição que não pediu — e você volta ao problema que a Medallion deveria resolver.
O teste é simples: se um usuário de negócio pode discutir o número, ele pertence à Gold. Deduplicação é assunto da Silver. O que conta como cliente ativo não é.
A arquitetura Medallion é um padrão lógico de design, não uma exigência de que todo pipeline tenha exatamente três camadas físicas. Bronze, Silver e Gold representam estágios lógicos de refino, e cada camada pode ser implementada de forma diferente conforme a carga de trabalho.
Por exemplo, uma camada pode usar tabelas materializadas, views ou outras abstrações adequadas, em vez de exigir uma cópia física separada. O ponto é criar fronteiras significativas à medida que os dados evoluem do estado bruto para algo que o negócio pode confiar e usar, não reproduzir exatamente o diagrama clássico.
Este é o que mais vejo e o menos discutido. Datasets Gold são baratos de criar e ninguém os apaga. Depois de um ano, você pode ter quarenta tabelas, onze variações de receita mensal, e ninguém lembra qual a CFO realmente usa.
Silver tem disciplina natural porque sua função é bem definida. Gold não — então precisa de um dono por dataset e disposição para apagar. Sem isso, você termina com várias versões concorrentes da mesma métrica, o que é justamente um problema que as camadas deveriam evitar.
O que a Medallion realmente entrega é um lugar para apontar quando alguém pergunta de onde veio um número — e uma cópia dos dados originais para voltar quando a resposta estiver errada. Vale o armazenamento extra e os jobs a mais quando vários times leem os mesmos dados. Quando só um time lê, duas camadas podem ser a melhor opção e poupar manutenção.
Se você quer o contexto mais amplo de onde esse padrão se encaixa, nosso curso Understanding Modern Data Architecture aborda as plataformas e tecnologias por trás dos data stacks modernos. Nossa trilha de carreira Data Engineer vai mais fundo na construção e manutenção de pipelines de produção.
Aprenda engenharia de dados com a DataCamp!
Curso
Curso
Programa