
Cours
Comprendre les architectures de données modernes
2 h
23.9K
La plupart des discussions sur la qualité des données portent sur la correction de données sources erronées. Pourtant, différentes équipes données peuvent construire cinq tableaux de bord totalement différents à partir du même système source, avec des chiffres de chiffre d’affaires divergents pour le même trimestre. La source n’est pas forcément en cause. Chaque consommateur nettoie, joint, filtre et définit les données de son côté, sans standard partagé de ce que signifie « propre ».
L’architecture medallion répond à ce problème en donnant aux équipes des frontières explicites pour améliorer la qualité sans perdre les données brutes d’origine. Voyons ce que c’est, comment cela fonctionne et pourquoi c’est un concept clé en ingénierie des données et en MLOps.
Notre cours Understanding Modern Data Architecture explique où les lakehouses et les pipelines en couches s’inscrivent dans la pile de données. Et notre Data Engineer career track développe les compétences de pipeline qui rendent ces couches maintenables en production.
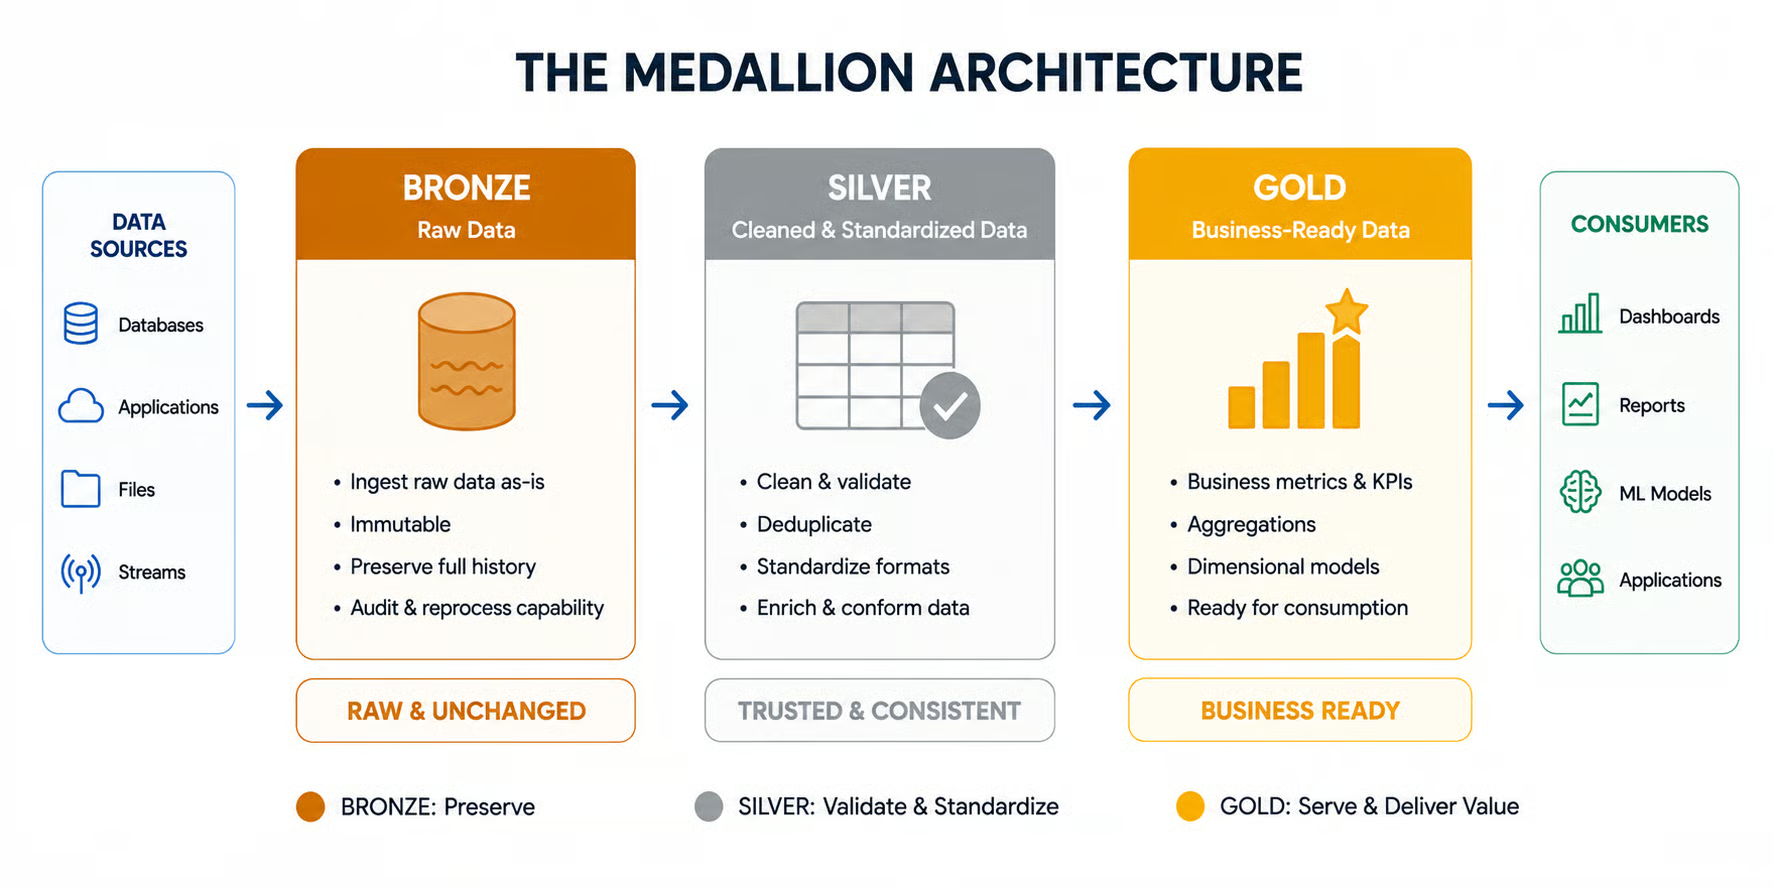
L’architecture medallion est un modèle de conception pour organiser logiquement les données dans un data lakehouse. Elle définit 3 couches où la qualité et la structure s’améliorent au fil du parcours des données :
Dans un entrepôt de données avec des pipelines d’extract-transform-load (ETL) classiques, vous devez définir le schéma des données en amont. Si le format ou le schéma évolue, le système échoue sauf ajustement manuel.
Dans une architecture extract-load-transform (ELT) basée sur medallion, vous stockez d’abord les données brutes, au lieu de les transformer à la volée et d’enregistrer uniquement le résultat final. Cette différence rend l’approche medallion à la fois robuste et flexible : vous pouvez conserver les données brutes telles quelles et décider plus tard comment les utiliser.
Pour une comparaison détaillée des deux concepts, nous vous recommandons de lire notre guide ETL vs ELT.
Autre atout : la nature agnostique de l’architecture medallion. Bronze, Silver et Gold sont des étapes logiques, pas des technologies liées à un éditeur. Vous pouvez l’implémenter avec différents systèmes de stockage, moteurs de traitement et formats de table, selon votre plateforme et vos exigences de charge.
|
Caractéristique |
Medallion (ELT) |
ETL traditionnel |
|
Données brutes |
Conservées |
Perdues |
|
Schéma |
Décidé plus tard, appliqué en Silver |
Défini en amont sur la cible |
|
Re-traitement |
À partir des données brutes conservées |
Peut exiger une ré-extraction de la source |
|
Moment des transformations |
Après le chargement |
Avant le chargement |
|
Affinage des données |
Progressif entre les couches |
Majoritairement avant l’arrivée sur la cible |
Les trois couches s’enchaînent logiquement, chacune s’appuyant sur la précédente.
C’est là que les données brutes atterrissent telles quelles : bases relationnelles, applications SaaS comme Salesforce, topics Kafka d’événements en temps réel, API REST, exports CSV ou flux d’objets connectés. L’ingestion est souvent gérée par des outils comme Fivetran pour la capture des changements ou Databricks Auto Loader pour les fichiers déposés dans un stockage objet.
Les données Bronze contiennent généralement des erreurs, incohérences et doublons ; elles ne doivent donc jamais être utilisées directement à des fins métier. Cela dit, cette couche est très précieuse comme point de reprise à partir duquel régénérer Silver ou Gold.
L’importance de cette couche tient à son empreinte : elle enregistre chaque événement ou transaction d’ingestion. Elle contient souvent des métadonnées utiles, telles que les horodatages d’ingestion, l’origine des données et divers identifiants. L’objectif est de stocker les données aussi brutes et complètes que possible, afin de rejouer les pipelines aval avec la même source pour diagnostiquer les anomalies.
La couche Silver transforme les données brutes en données propres et structurées. Exemples de transformations de nettoyage essentielles entre Bronze et Silver :
Cette couche applique aussi une contrainte de schéma, garantissant le respect d’une structure prédéfinie et l’évolution du schéma.
C’est également ici que vous mettez en place des contrôles de qualité. Par exemple, des règles pour signaler ou rejeter des transactions métier en échec ou des valeurs aberrantes. C’est la première étape d’amélioration de la qualité au fil des étapes.
Comme cette étape modifie les données, il est essentiel d’utiliser des outils de traçabilité comme dbt pour suivre les transformations de Bronze à Silver. Les contrôles qualité s’implémentent souvent avec des tests dbt, Great Expectations ou Soda, tandis que la gouvernance est assurée via un catalogue de données tel que Databricks Unity Catalog ou Collibra.
Pour apprendre à transformer des données « sales » en jeux Silver conformes, nous vous conseillons notre cours Cleaning Data in Python.
La couche finale stocke des données au niveau de qualité maximal. Ces données très affinées servent au reporting dans Power BI, Tableau ou Looker, sont consommées par des applications analytiques aval, ou alimentent des modèles de machine learning via un feature store comme Feast ou Databricks Feature Store.
Puisque les données sont déjà nettoyées, on se concentre ici sur leur transformation en véritable actif métier. Selon le cas d’usage (rapports financiers, tableaux de bord marketing, systèmes d’alerte, entraînement ML, …), les transformations après Silver garantissent que Gold contient exactement l’information nécessaire.
C’est ici que vous créez des KPI, appliquez des formules métier spécifiques, ou agrégez en hebdomadaire, mensuel ou trimestriel pour un reporting planifié. Alors que Bronze et Silver restent souvent communs, les opérations en Gold sont plus souples et adaptées à l’usage visé.
Conserver les données brutes en Bronze ne paie que si vous pouvez effectivement les réutiliser, ce qui arrive dès qu’un élément en amont ou en aval change. Le coût d’un changement dépend de sa position dans la chaîne.
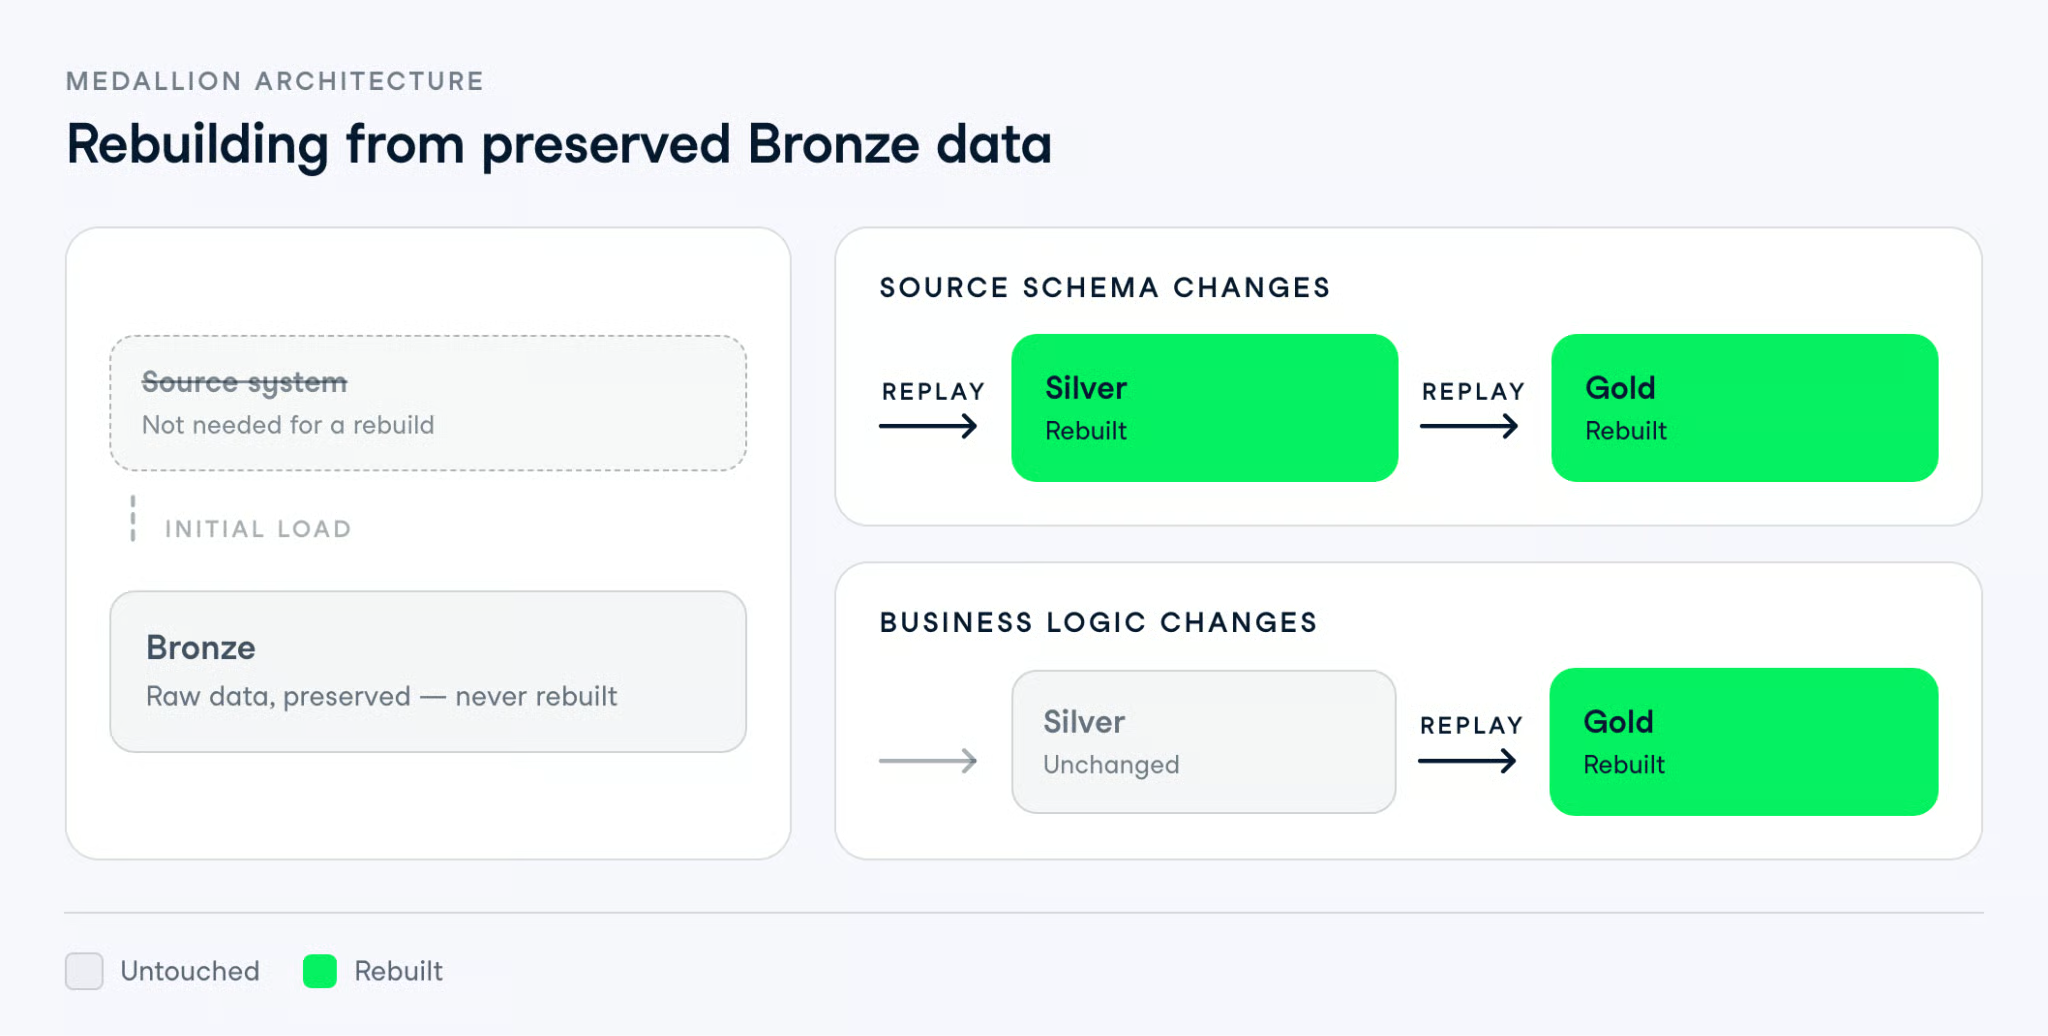
Dans aucun des cas vous ne retournez au système source. C’est ce qui rend possibles les corrections historiques, la source ne détenant plus nécessairement les données dans l’état d’origine.
Cela signifie aussi que vous pouvez changer une définition de métrique sans relancer l’ingestion, raison pratique pour laquelle les équipes avec de nombreux consommateurs Gold maintiennent des couches séparées.
Un data lakehouse offre le stockage objet économique d’un lac et les garanties transactionnelles d’un entrepôt. Il ne dit rien de l’agencement interne des tables. C’est là que medallion intervient : le lakehouse est le substrat de stockage, et Bronze, Silver et Gold sont la manière de le diviser en catalogues, schémas et tables assortis de garanties de qualité différentes.
En pratique, cette division est souvent physique. Sur Databricks, vous pouvez avoir trois schémas dans un catalogue Unity Catalog, et sur Microsoft Fabric, un lakehouse avec des tables Bronze et Silver alimentant un entrepôt Gold. Même modèle, plomberie différente.
Les formats de table ouverts garantissent la tenue des couches face aux lectures/écritures concurrentes. Delta Lake, Apache Iceberg et Apache Hudi offrent notamment :
Le versionnage est crucial pour le comportement de relecture évoqué ci-dessus. De simples fichiers Parquet conservent la source, mais sans historique transactionnel pour revenir en arrière : un mauvais run Silver écrase le bon, sans point de comparaison. Delta Lake suit les changements via un journal des transactions, tandis qu’Apache Iceberg représente l’état des tables par snapshots.
Rien de tout cela n’est obligatoire. Medallion est un modèle logique, et nombre d’équipes l’exécutent sur des schémas Postgres ou de simples préfixes S3 avec dbt par-dessus. Vous perdez juste le retour arrière à moindre coût.
On les compare souvent à tort, en pensant qu’elles se concurrencent. Elles répondent à des questions différentes : data mesh décide qui possède les données, et l’architecture medallion décide comment ce propriétaire les affine.
Data mesh confie la responsabilité des données aux équipes de domaine (ventes, finance, supply chain…), qui publient des données comme des produits et en assurent qualité, découvrabilité, traçabilité et gouvernance. Deux éléments cimentent le tout : une infrastructure en libre-service donnant les mêmes outils à chaque domaine, et une gouvernance fédérée fixant des standards à l’échelle de l’entreprise sans retirer la propriété aux domaines.
L’architecture medallion est ce qu’une équipe de domaine exécute dans son périmètre. Une équipe supply chain propriétaire des données d’expédition garde les événements bruts en Bronze, les enregistrements validés en Silver, et publie en Gold des jeux prêts pour l’analyse, consommables par d’autres domaines. Le mesh définit le contrat à la frontière Gold ; tout l’amont relève de l’équipe.
Un bémol : des couches Bronze par domaine signifient que chaque domaine porte ses coûts d’ingestion et de stockage, et que des dimensions partagées (client, produit…) se reconstruisent souvent à plusieurs endroits. Les partisans du mesh diront que c’est le prix de la propriété. C’est un coût réel, à chiffrer avant de s’engager.
Medallion vous apporte la réutilisation et la récupérabilité, au prix d’un surcoût de stockage, de latence et de nombre de pipelines. L’intérêt de ce compromis dépend presque entièrement du nombre de consommateurs.
La latence est le point le plus souvent sous-estimé. Chaque couche correspond généralement à un job planifié : un pipeline batch en trois couches exécuté toutes les heures peut laisser Gold avec deux heures de retard sur la source. Acceptable pour un rapport hebdomadaire de revenus, insuffisant pour une alerte opérationnelle : d’où le fait que l’alerte lise souvent directement en Silver sans attendre Gold.
Le stockage est la première crainte évoquée, mais c’est souvent le moindre problème. Bronze vit dans un stockage objet bon marché, et la duplication est réelle mais contenue. Le nombre de pipelines est ce qui fait mal : trois couches pour vingt tables sources, ce sont soixante éléments susceptibles d’échouer à 3 h du matin.
Face à cela, la mauvaise qualité des données a sa propre facture. IBM rapportait en 2026 que 43 % des COO citaient la qualité des données comme priorité n°1, sur la base de recherches de 2025 de son Institute for Business Value. Plus d’un quart des organisations de cette étude signalaient des pertes annuelles liées à la qualité dépassant 5 millions de dollars.
La question n’est donc pas de savoir si une architecture medallion coûte plus cher qu’un pipeline unique — c’est le cas. La question est de savoir si vous ne payez pas déjà l’alternative en réunions de réconciliation et en tableaux de bord auxquels personne ne fait confiance.
Medallion est rentable quand les mêmes données nettoyées servent plusieurs consommateurs. C’est le meilleur prédicteur, devant le volume, la taille de l’équipe ou le nombre de sources.
Utilisez l’architecture medallion lorsque :
Évitez si :
Le schéma en trois couches est un défaut utile, pas une obligation. Avec un seul cas d’usage métier, Bronze + une couche combinée est souvent le bon choix : préserver le brut pour rejouer, puis faire nettoyage et logique métier en une étape.
Choisissez la forme qui correspond à vos consommateurs. Ce qu’il ne faut pas fusionner, c’est Bronze, car cette couche est irréplicable.
Si vous hésitez, bâtir deux couches et ajouter la troisième quand un deuxième consommateur arrive est une bonne voie. Ajouter Gold plus tard coûte bien moins cher que rétro-installer Bronze après six mois d’écrasement des données brutes.
La plupart des problèmes ne sont pas architecturaux. Ce sont de petits compromis pris sous la pression des délais qui sapent la raison d’être des couches.
L’argument du rejouement repose sur une Bronze proche de ce qu’a réellement émis la source. Si vous appliquez une logique métier avant l’atterrissage, vous perdez l’état d’origine : plus de re-traitement possible, ni de piste d’audit.
Cela arrive souvent pour de bonnes raisons. On supprime une colonne jugée inutile pour économiser de la place, ou on force un champ d’horodatage brouillon à l’ingestion parce qu’il casse l’étape suivante. Six mois plus tard, la colonne « inutile » devient clé et les valeurs d’origine ont disparu. Gardez Bronze au plus près de la source, et mettez les correctifs en Silver.
Silver nettoie et standardise. Gold répond aux questions métier. Quand la logique des métriques fuit en Silver, chaque jeu Gold hérite d’une définition non souhaitée, et vous revenez au problème que medallion devait résoudre.
Le test est simple : si un utilisateur métier conteste un chiffre, cela relève de Gold. La déduplication est un sujet Silver. La définition d’un client actif ne l’est pas.
L’architecture medallion est un modèle logique, pas l’exigence que chaque pipeline comporte exactement trois couches physiques. Bronze, Silver et Gold représentent des stades logiques d’affinage, et chaque couche peut être mise en œuvre différemment selon la charge.
Par exemple, une couche peut s’appuyer sur des tables matérialisées, des vues ou d’autres abstractions, plutôt que d’imposer une copie physique distincte. L’objectif est de créer des frontières utiles au fil du passage de l’état brut à un actif fiable pour le métier, pas de reproduire à l’identique le diagramme en trois couches.
C’est l’écueil le plus fréquent et le moins évoqué. Créer des jeux Gold coûte peu, et personne ne les supprime. Au bout d’un an, vous pouvez vous retrouver avec quarante tables, dont onze variantes du revenu mensuel, sans que l’on sache laquelle regarde le CFO.
Silver a une discipline naturelle car sa mission est claire. Gold non : il faut donc un propriétaire par jeu et l’acceptation de supprimer. Sans cela, vous finissez avec plusieurs versions concurrentes d’une même métrique — précisément ce que les couches devaient éviter.
Ce que medallion vous donne vraiment, c’est un endroit à montrer quand on vous demande d’où vient un chiffre, et une copie des données d’origine quand la réponse s’avère erronée. Cela vaut le stockage et les jobs supplémentaires quand plusieurs équipes lisent les mêmes données. Quand une seule équipe est concernée, deux couches peuvent être plus adaptées et alléger la maintenance.
Pour replacer ce modèle dans son contexte, notre cours Understanding Modern Data Architecture couvre les plateformes et technologies des data stacks modernes. Notre Data Engineer career track va plus loin sur la construction et la maintenance de pipelines de production.
Apprenez l’ingénierie des données avec DataCamp !
Cours
Cours
Cursus