
Cursus
Moderne data-architectuur begrijpen
2 Hr
23.9K
De meeste gesprekken over datakwaliteit gaan over het repareren van slechte brondata. Maar verschillende datateams kunnen vijf totaal verschillende dashboards bouwen vanuit hetzelfde bronsysteem, met verschillende omzetcijfers voor hetzelfde kwartaal. De brondata is hier niet per se het probleem. Elke afnemer kan die data zelfstandig opschonen, joinen, filteren en definiëren, zonder gedeelde standaard voor wat "schoon" betekent.
De medallion-architectuur pakt dit probleem aan door datateams duidelijke grenzen te geven om de datakwaliteit te verbeteren zonder de ruwe data te verliezen waarmee ze begonnen. Laten we kijken wat het is, hoe het werkt en waarom het zo'n belangrijk concept is in data engineering en MLOps.
Onze Understanding Modern Data Architecture-cursus behandelt waar lakehouses en gelaagde pipelines passen binnen de bredere datastack. En onze Data Engineer-carrièreroute bouwt de bredere pipelineskills die deze lagen onderhoudbaar maken zodra ze in productie staan.
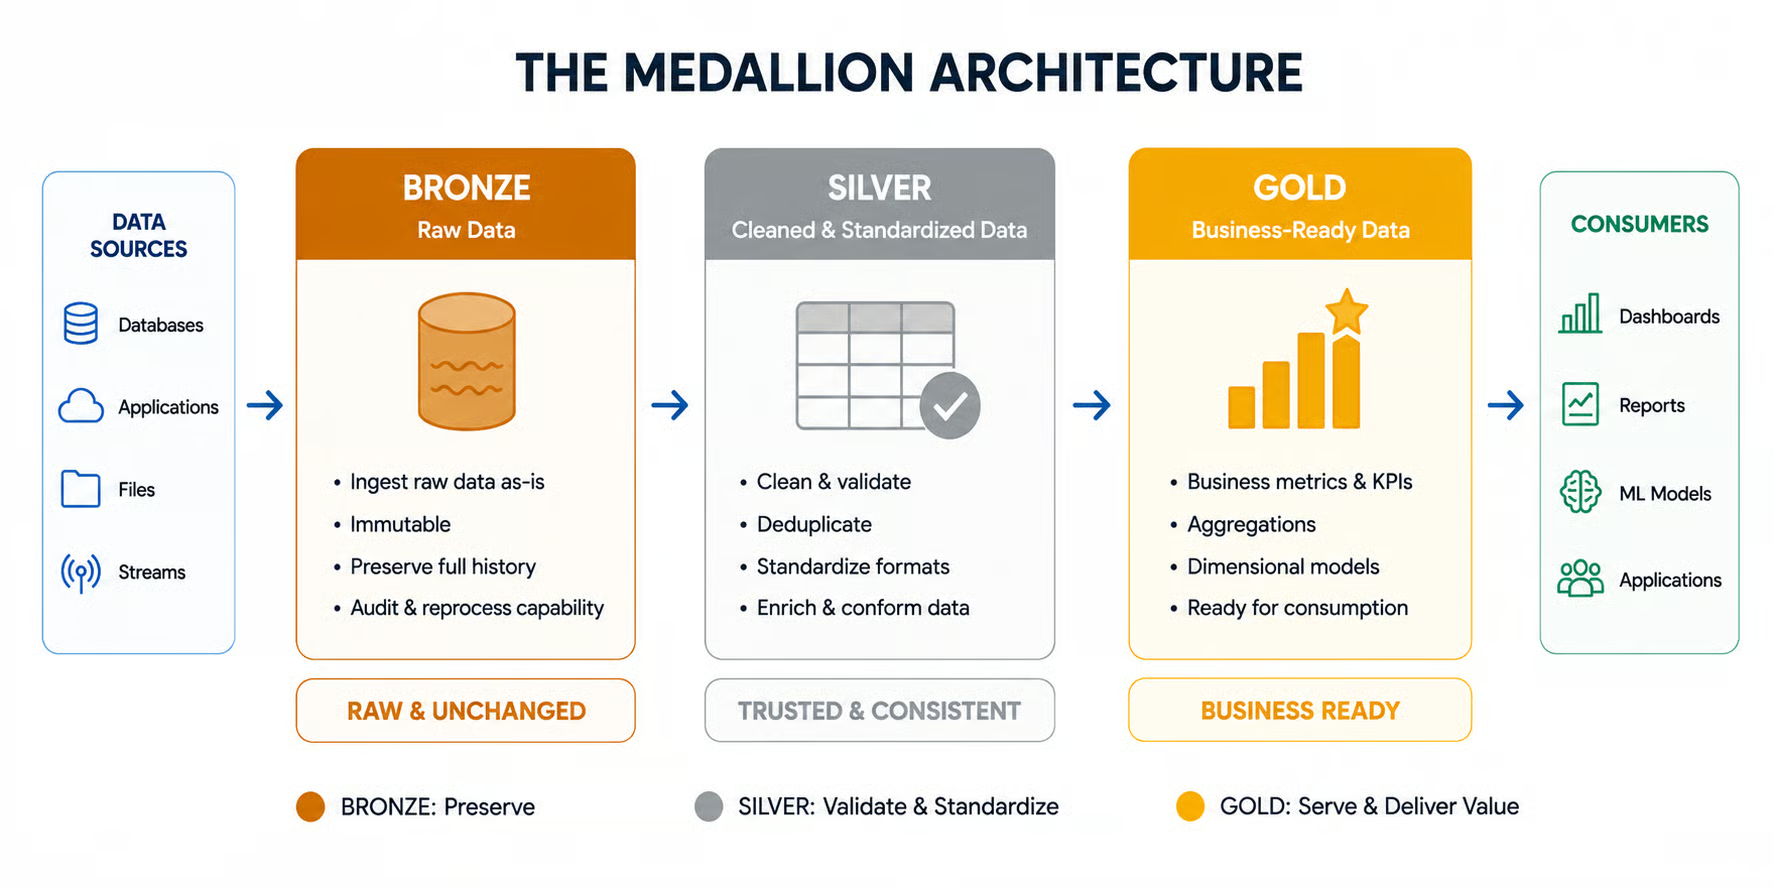
De medallion-architectuur is een datapatroon om data logisch te organiseren in een data lakehouse. Het definieert 3 lagen waarbij datakwaliteit en -structuur verbeteren naarmate data ze doorloopt:
In datawarehouses met traditionele extract-transform-load (ETL)-pipelines moet je het schema van je data vooraf definiëren. Als je dataformaat of -schema verandert, faalt het systeem tenzij je het handmatig aanpast.
In een medallion-gebaseerde extract-load-transform (ELT)-architectuur sla je de data eerst in ruwe vorm op, in plaats van deze on the fly te transformeren en de einddata op te slaan. Dit verschil maakt medallion-gebaseerde architecturen zowel robuust als flexibel: je kunt ruwe data as is opslaan en later bepalen hoe je die gebruikt.
Voor een volledige vergelijking van de twee concepten raad ik aan onze ETL vs ELT-gids te lezen.
Een ander voordeel van de medallion-architectuur is het platformagnostische karakter. Bronze, Silver en Gold zijn logische stadia, geen technologieën die aan een specifieke leverancier zijn gekoppeld. Je kunt het patroon implementeren met verschillende opslagsystemen, verwerkingsengines en tabelindelingen, afhankelijk van je dataplatform en werkloadeisen.
|
Kenmerk |
Medallion (ELT) |
Traditionele ETL |
|
Ruwe data |
Behouden |
Weg |
|
Schema |
Later beslissen, afgedwongen in Silver |
Vooraf definiëren aan de targetzijde |
|
Reprocessing |
Opnieuw verwerken vanuit behouden ruwe data |
Kan her-extractie van brondata vereisen |
|
Transformatietiming |
Na het laden |
Voor het laden |
|
Data-verfijning |
Geleidelijk over lagen heen |
Voornamelijk vóór data de target bereikt |
De drie medallionlagen volgen logisch op elkaar, waarbij elke laag voortbouwt op de vorige.
Hier landt de ruwe data zoals die is, of dat nu relationele databases zijn, SaaS-apps zoals Salesforce, Kafka-topics met realtime events, REST API's, CSV-exports of IoT-apparaatstromen. Inslikken wordt meestal afgehandeld door tools szoals Fivetran voor change data capture of Databricks Auto Loader voor bestanden die landen in objectopslag.
Bronze-data bevat doorgaans de nodige fouten, inconsistenties en duplicaten, dus het mag nooit direct voor zakelijke doeleinden worden gebruikt. Dat gezegd hebbende, de laag is zeer waardevol als herstelpunt vanwaar je Silver- of Gold-data kunt regenereren.
Het belang van de laag zit in de footprint: hij registreert en logt elk inslik- of transactiemoment. Vaak bevat hij waardevolle metadata, zoals ingestietijdstempels, herkomst van de data en allerlei soorten identifiers. Het doel is om de data zo rauw en compleet mogelijk op te slaan, zodat je downstream-pipelines opnieuw kunt afspelen met dezelfde brondata om bugs te debuggen.
De Silver-laag transformeert ruwe data naar schone, gestructureerde data. Enkele voorbeelden van belangrijke opschoontransformaties die plaatsvinden tussen Bronze en Silver:
Deze laag bevat ook schemahandhaving, zodat de data voldoet aan een vooraf gedefinieerde structuur en schema-evolutie ondersteunt.
Hier voer je ook datakwaliteitscontroles uit. Voeg bijvoorbeeld regels toe om mislukte zakelijke transacties of uitschieters te markeren of af te wijzen. Dit is de eerste stap om de datakwaliteit te verbeteren terwijl de data door de stadia gaat.
Omdat dit stadium datamodificatie omvat, is het belangrijk om data lineage-tools zoals dbt te gebruiken om te volgen hoe data van Bronze naar Silver wordt getransformeerd. Kwaliteitscontroles worden meestal geïmplementeerd met dbt-tests, Great Expectations of Soda, terwijl governance wordt afgedwongen via een datacatalogus zoals Databricks Unity Catalog of Collibra.
Wil je leren hoe je rommelige data omzet in degelijke Silver-datasets, begin dan met onze cursus Cleaning Data in Python.
De laatste laag van de architectuur slaat de data op met de hoogst mogelijke kwaliteit. Deze sterk verfijnde data wordt gebruikt voor zakelijke rapportering in Power BI, Tableau of Looker, wordt verbruikt door downstream analytische applicaties of bedient machinelearningmodellen via een feature store zoals Feast of Databricks Feature Store.
Omdat de data al is opgeschoond, richt dit stadium zich op het omzetten ervan in een waardevol bedrijfsasset. Afhankelijk van de specifieke usecase (denk aan financiële rapporten, marketingdashboards, alertsystemen, ML-modeltraining, …), zorgen de transformaties na Silver ervoor dat Gold precies de informatie bevat die nodig is voor de taak.
Hier maak je KPI's, pas je aangepaste bedrijfsformules toe of aggregeer je naar wekelijkse, maandelijkse of kwartaaldata voor geplande rapportage. Terwijl de Bronze- en Silver-bewerkingen vaak gemeenschappelijk zijn, zijn Gold-bewerkingen flexibeler en meer afgestemd op hoe je deze data wilt gebruiken.
Ruwe data in Bronze behouden loont alleen als je die ook echt kunt gebruiken, en dat gebeurt telkens wanneer er iets upstream of downstream verandert. De kosten van een wijziging hangen af van hoe ver in de keten die zit.
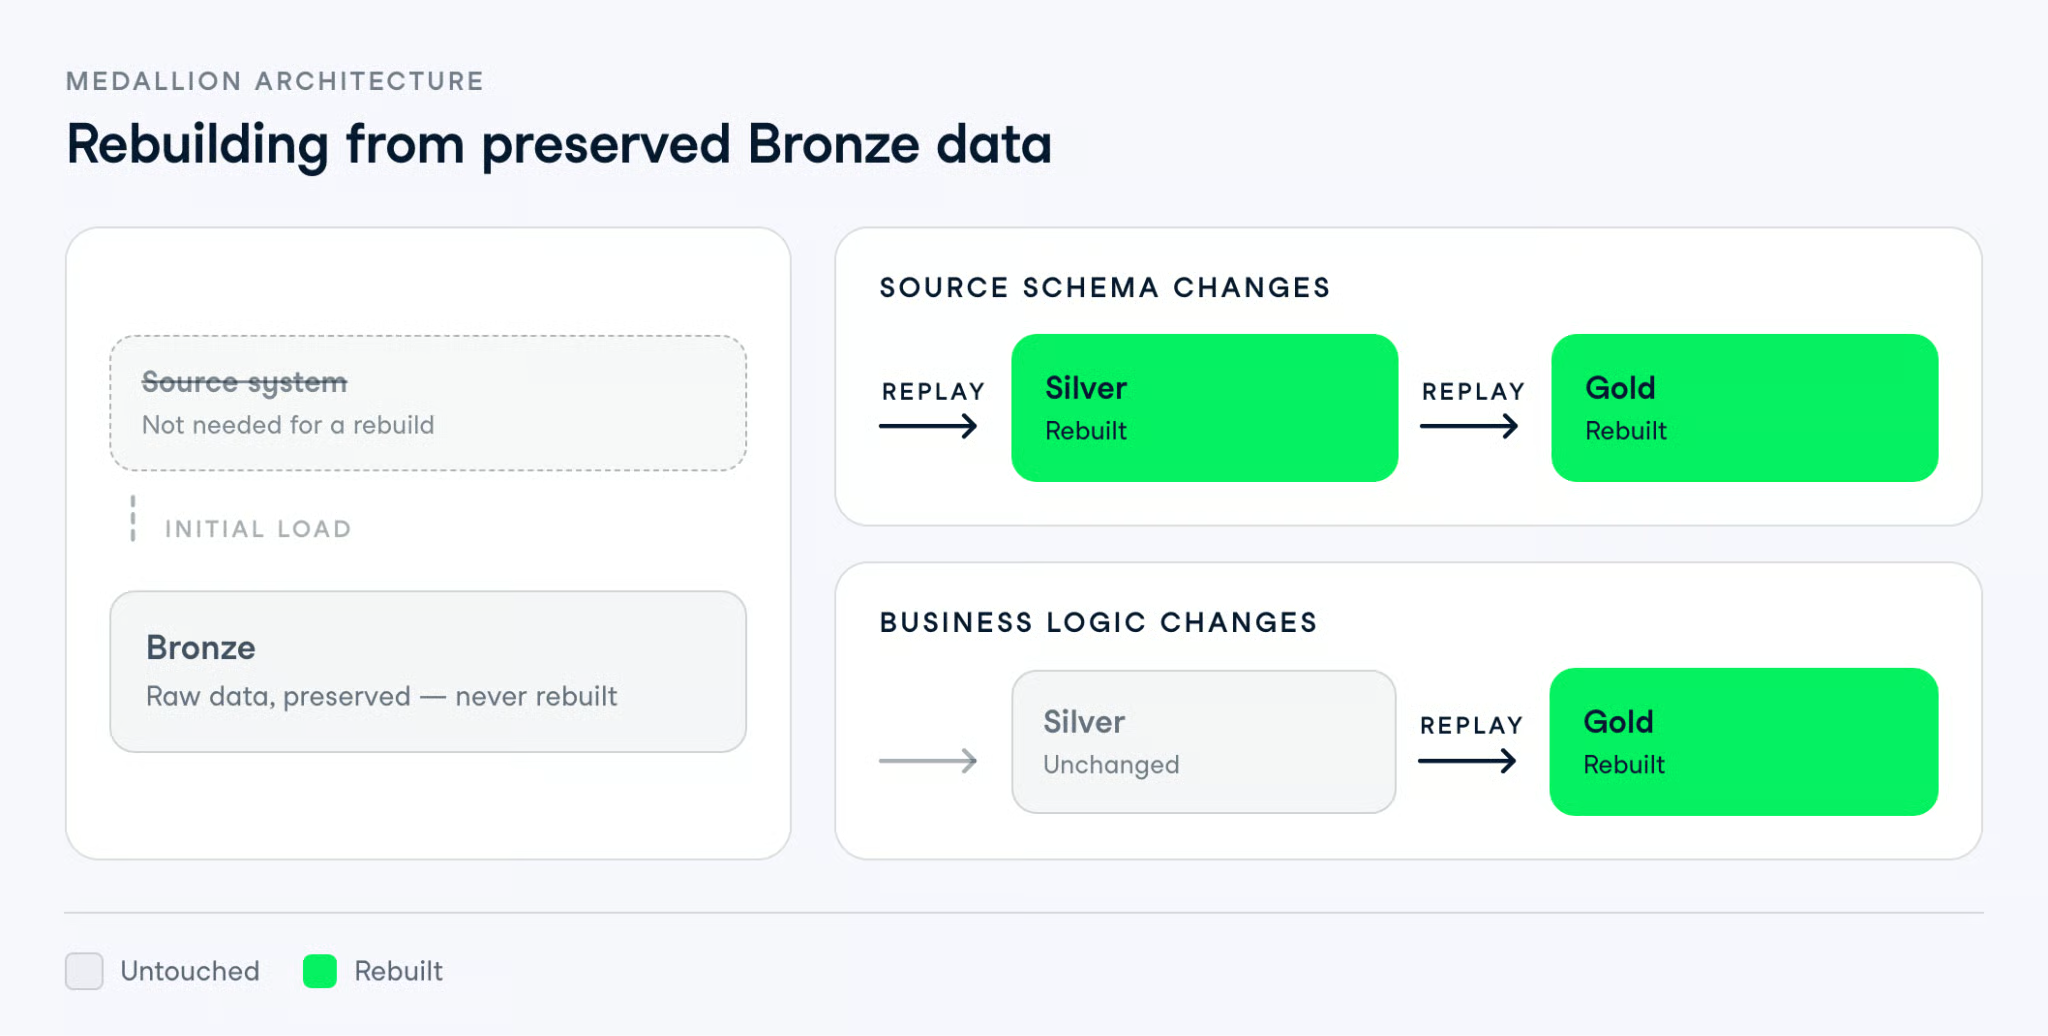
In geen van beide gevallen ga je terug naar het bronsysteem. Dat maakt historische correcties überhaupt mogelijk, aangezien de bron de data mogelijk niet meer bevat in de vorm waarin je die oorspronkelijk hebt ingeslikt.
Het betekent ook dat je een metricdefinitie kunt wijzigen zonder inslikken opnieuw uit te voeren, wat de praktische reden is dat teams met veel Gold-consumenten de lagen gescheiden houden.
Een data lakehouse geeft je de goedkope objectopslag van een datalake met de transactionele garanties van een warehouse. Het zegt niets over hoe je de tabellen daarbinnen rangschikt. Dat is het gat dat medallion vult: het lakehouse is het opslagsubstraat, en Bronze, Silver en Gold zijn hoe je het opdeelt in catalogs, schema's en tabellen met verschillende kwaliteitsgaranties.
In de praktijk is die verdeling meestal fysiek. Op Databricks heb je mogelijk drie schema's in een Unity Catalog-catalogus, en in Microsoft Fabric een lakehouse met Bronze- en Silver-tabellen die een Gold-warehouse voeden. Zelfde patroon, andere infrastructuur.
Open tabelindelingen zijn wat de lagen overeind houden bij gelijktijdig lezen en schrijven. Delta Lake, Apache Iceberg en Apache Hudi bieden elk een combinatie van:
Versiebeheer is vooral belangrijk voor het replay-gedrag dat we zojuist bespraken. Ruwe Parquet-bestanden behouden je brondata prima, maar geven je geen transactionele geschiedenis om naar terug te draaien, dus een mislukte Silver-run overschrijft de goede, en je hebt niets om mee te vergelijken. Delta Lake volgt wijzigingen in een transactielog, terwijl Apache Iceberg tabeltoestanden als snapshots representeert.
Niets hiervan is verplicht. Medallion is een logisch patroon, en veel teams draaien het op Postgres-schema's of platte S3-prefixes met dbt erbovenop. Je verliest alleen de goedkope rollback.
Deze twee worden vaak vergeleken, meestal omdat men aanneemt dat ze concurreren. Ze beantwoorden verschillende vragen: data mesh beslist wie data bezit, en de medallion-architectuur beslist hoe die eigenaar die data verfijnt.
Data mesh geeft domeinteams zoals sales, finance of supply chain de verantwoordelijkheid voor data; zij publiceren hun data als producten en bezitten de kwaliteit, vindbaarheid, lineage en governance ervan. Twee dingen houden dat bij elkaar: selfservice-infrastructuur die elk domein dezelfde tooling geeft, en gefedereerde governance die organisatiebrede standaarden vastlegt zonder eigenaarschap bij de domeinen weg te nemen.
Medallion-architectuur is wat een domeinteam intern draait. Een supplychainteam dat verzenddata bezit, bewaart ruwe zendingsevents in Bronze, gevalideerde records in Silver, en publiceert analytics-ready zendingdatasets in Gold voor andere domeinen. De mesh definieert het contract aan de Gold-grens; alles wat daarvoor ligt, is de zaak van dat team.
Eén kanttekening voordat je ze combineert: Bronze-lagen per domein betekenen dat elk domein zijn eigen inslik- en opslagkosten draagt, en gedeelde dimensies zoals klant of product vaak op drie plekken opnieuw worden opgebouwd. Mesh-voorstanders zouden zeggen dat dat de prijs van eigenaarschap is. Het blijft een echte kost, en het is de moeite waard om die te begroten voordat je je vastlegt.
Medallion levert hergebruik en herstelbaarheid op, en rekent je af op opslag, latentie en het aantal pipelines. Of die trade-off uitpakt, hangt bijna volledig af van hoeveel afnemers je hebt.
Latentie is het makkelijkst te onderschatten. Elke laag is meestal een eigen geplande job, dus een batchpipeline met drie lagen die elk uur draait kan ertoe leiden dat Gold twee uur achterloopt op het bronsysteem. Dat is prima voor een wekelijkse omzetrapportage en niet oké voor een operationele alert, en daarom laten teams alerts vaak direct Silver lezen in plaats van op Gold te wachten.
Opslag is de kost die mensen als eerste noemen, en die is meestal het kleinere probleem. Bronze staat in goedkope objectopslag, en de duplicatie is echt maar begrensd. Het aantal pipelines is wat echt pijn doet: drie lagen over twintig brontabellen is zestig dingen die potentieel om 3 uur 's nachts kunnen falen.
Daartegenover staat dat slechte datakwaliteit zijn eigen rekening heeft. IBM meldde in 2026 dat 43% van de COO's datakwaliteit hun belangrijkste dataprioriteit noemde, gebaseerd op onderzoek uit 2025 van het Institute for Business Value. Meer dan een kwart van de organisaties in dat onderzoek rapporteerde jaarlijkse verliezen door slechte datakwaliteit van meer dan $5 miljoen.
Dus de vraag is niet of het implementeren van een medallion-architectuur meer kost dan één enkele pipeline, want dat doet het. De vraag is of je niet nu al betaalt voor het alternatief in afstemmingsvergaderingen en dashboards die niemand vertrouwt.
Medallion bewijst zijn waarde wanneer dezelfde opgeschoonde data meer dan één afnemer bedient. Dat is de beste voorspeller, belangrijker dan datavolume, teamgrootte of het aantal bronnen waar je uit trekt.
Gebruik medallion-architectuur wanneer:
Sla het over wanneer:
Het diagram met drie lagen is een default, geen vereiste. Bij één zakelijke usecase is Bronze plus één gecombineerde laag vaak de juiste keuze: bewaar ruwe data voor replay, en doe opschoning en businesslogica in één stap.
Kies de vorm die past bij je afnemers. Wat je niet zou moeten samenvoegen is Bronze, want dat is de laag die je niet kunt reproduceren.
Dus als je ertussenin zit en het eerlijk gezegd niet weet, is twee lagen bouwen en de derde toevoegen wanneer er een tweede afnemer verschijnt een goede aanpak. Gold later toevoegen is veel goedkoper dan Bronze achteraf aanbrengen nadat je de afgelopen zes maanden je ruwe data hebt overschreven.
De meeste medallionproblemen zijn niet architectonisch. Het zijn kleine concessies onder deadline-druk die stilletjes de reden wegnemen waarom je de lagen überhaupt hebt gebouwd.
Het hele replay-argument rust erop dat Bronze iets vasthoudt dat dicht in de buurt komt van wat de bron daadwerkelijk heeft verstuurd. Pas je businesslogica toe vóórdat je de data landt, dan ben je de originele staat kwijt, wat betekent: geen reprocessing en geen auditrail.
Dit gebeurt meestal om goede redenen. Iemand laat een kolom vallen die niemand gebruikt om ruimte te besparen, of dwingt een rommelig timestampveld af bij inslikken omdat het de volgende job breekt. Zes maanden later blijkt de ongebruikte kolom belangrijk, en de oorspronkelijke waarden zijn weg. Houd Bronze zo dicht mogelijk bij de bron als praktisch haalbaar, en zet de fixes in Silver.
Silver maakt schoon en standaardiseert. Gold beantwoordt zakelijke vragen. Wanneer metriclogica in Silver lekt, erft elke Gold-dataset een definitie waar hij niet om heeft gevraagd, en ben je terug bij het probleem dat medallion moest oplossen.
De test is simpel: als een businessgebruiker over het getal discussieert, hoort het in Gold. Deduplicatie is een Silver-zorg. Wat telt als een actieve klant niet.
Medallion-architectuur is een logisch ontwerp-patroon, geen eis dat elke pipeline exact drie fysieke lagen bevat. Bronze, Silver en Gold vertegenwoordigen logische stadia van dataverfijning, en elke laag kan verschillend worden geïmplementeerd afhankelijk van de workload.
Zo kan een laag gebruikmaken van gematerialiseerde tabellen, views of andere passende abstracties in plaats van een aparte fysieke kopie van de data te vereisen. Het punt is om zinvolle grenzen te creëren terwijl data beweegt van ruwe staat naar iets waar het bedrijf op kan vertrouwen en gebruiken, in plaats van het klassieke diagram met drie lagen exact te reproduceren.
Dit zie ik het vaakst, en het wordt het minst besproken. Gold-datasets zijn goedkoop te maken, en niemand verwijdert ze ooit, dus na een jaar heb je misschien veertig tabellen, waarvan er elf variaties zijn op maandelijkse omzet, en niemand weet nog welke de CFO daadwerkelijk bekijkt.
Silver heeft natuurlijke discipline omdat de taak gedefinieerd is. Gold niet, dus daar is een eigenaar per dataset nodig en de bereidheid om te verwijderen. Zonder dat eindig je met meerdere concurrerende versies van dezelfde metric, wat juist een probleem was dat de lagen moesten voorkomen.
Wat medallion je eigenlijk geeft, is een plek om naar te wijzen wanneer iemand vraagt waar een getal vandaan komt, en een kopie van de originele data om naar terug te gaan wanneer het antwoord fout blijkt. Dat is de extra opslag en extra jobs waard wanneer meerdere teams dezelfde data lezen. Als maar één team dat doet, zijn twee lagen misschien de betere oplossing en besparen ze je onderhoud.
Wil je de bredere context van waar dit patroon thuishoort, onze Understanding Modern Data Architecture-cursus behandelt de platformen en technologieën achter moderne datastacks. Onze Data Engineer-carrièreroute gaat dieper in op het bouwen en onderhouden van productie-pipelines.
Leer Data Engineering met DataCamp!
Cursus
Cursus
Leerpad