Giới thiệu về khoa học dữ liệu trong marketing
Bạn đã bao giờ mua hàng trên một nền tảng mua sắm trực tuyến rồi sau đó liên tục thấy tràn ngập quảng cáo về các sản phẩm tương tự mỗi khi lướt web chưa? Đó là một ứng dụng của khoa học dữ liệu trong marketing.
Phần lớn dữ liệu của thế giới chỉ mới được tạo ra trong vòng hai năm qua, và các công ty giờ có khả năng thu thập và lưu trữ dữ liệu khách hàng ở quy mô lớn hơn bao giờ hết. Mỗi lần người dùng tương tác với website, trang mạng xã hội, hoặc hệ thống POS của một tổ chức, những điểm dữ liệu mới lại được tạo ra.
Dữ liệu này sau đó được dùng để xây dựng những insight về hành vi người dùng và gửi cho họ các quảng cáo được chọn lọc, gợi ý sản phẩm cá nhân hóa, cùng các khuyến mãi đặc biệt.
Hầu hết chúng ta tương tác với các ứng dụng khoa học dữ liệu trong marketing hằng ngày và vô thức đưa ra quyết định dựa trên chúng.
Trong bài viết này, chúng ta sẽ cùng điểm qua 5 cách sử dụng khoa học dữ liệu trong marketing. Sau đó, chúng ta sẽ khám phá một dự án cá nhân bạn có thể thêm vào portfolio khoa học dữ liệu cho mỗi trường hợp sử dụng. Cuối cùng, chúng ta sẽ đề cập đến lý do bạn nên trở thành một nhà khoa học dữ liệu marketing và cách để tìm được công việc trong lĩnh vực này.
5 trường hợp sử dụng khoa học dữ liệu trong marketing
1. Hệ thống gợi ý
Các công ty như Netflix, Spotify và Amazon sử dụng hệ thống gợi ý để cung cấp cho người dùng các đề xuất nội dung cá nhân hóa dựa trên cách họ tương tác với nền tảng.
Chẳng hạn, nếu bạn xem một bộ phim trên Netflix và đánh giá tích cực, lần tiếp theo mở ứng dụng, bạn sẽ được gợi ý những bộ phim cùng thể loại, nội dung và dàn diễn viên.
Đây là một ví dụ đơn giản về cách chúng ta tương tác với các công cụ gợi ý trong cuộc sống hàng ngày.
Hệ thống gợi ý trở nên mạnh mẽ hơn theo thời gian khi người dùng tiếp tục tương tác với chúng.
Ví dụ, nếu bạn mới dùng Spotify, các gợi ý âm nhạc ban đầu sẽ khá chung chung. Ứng dụng sẽ gợi ý nhiều thể loại thu hút số đông vì thuật toán chưa có đủ dữ liệu để hiểu sở thích của bạn.
Khi bạn dành nhiều thời gian hơn trên nền tảng, công cụ gợi ý sẽ học được nhiều hơn về điều bạn thích và không thích, và đề xuất sẽ được điều chỉnh theo gu của bạn. Thuật toán thậm chí có thể dự đoán loại nhạc bạn có thể thích vào các mùa khác nhau hoặc vào những thời điểm khác nhau trong ngày.
Các loại hệ thống gợi ý
Hệ thống gợi ý có thể được phân loại rộng thành hai loại - hệ thống gợi ý dựa trên nội dung và hệ thống gợi ý dựa trên lọc cộng tác.
1. Hệ thống gợi ý dựa trên nội dung:
Hình ảnh do tác giả cung cấp
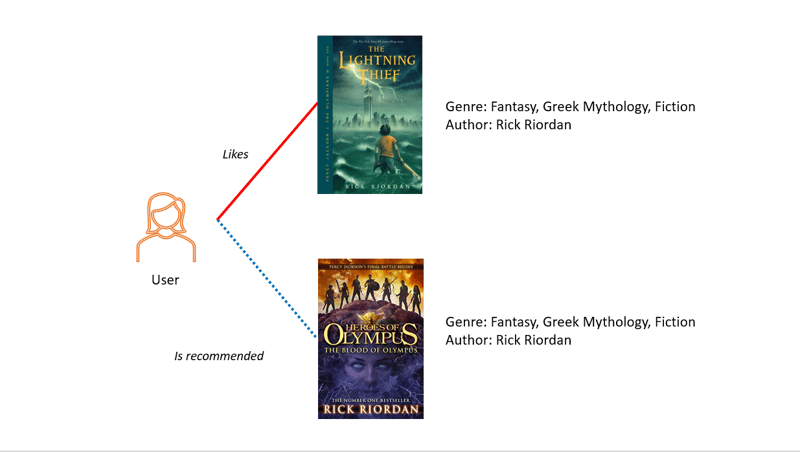
Hệ thống gợi ý dựa trên nội dung đưa ra đề xuất chỉ dựa vào nội dung của sản phẩm.
Ví dụ, nếu bạn thích đọc các tiểu thuyết trong sê-ri Percy Jackson, bạn có thể được gợi ý Heroes of Olympus, cùng tác giả và thể loại tương tự.
Tuy nhiên, một bất lợi của thuật toán này là bạn sẽ không được gợi ý những cuốn sách khác biệt so với những gì bạn đã đọc. Nếu bạn thích Percy Jackson, bạn sẽ chỉ được gợi ý sách phiêu lưu và giả tưởng, dù có thể bạn cũng sẽ thích một cuốn phi hư cấu hoặc trinh thám.
Bạn có thể khắc phục nhược điểm này của hệ thống gợi ý dựa trên nội dung bằng hệ thống gợi ý dựa trên lọc cộng tác, chúng tôi sẽ giải thích sau trong bài viết.
Ý tưởng dự án hệ thống gợi ý dựa trên nội dung
Nếu bạn là người mới với ít hoặc chưa có kinh nghiệm xây dựng hệ thống gợi ý, Kaggle Movie Dataset là nơi khởi đầu tuyệt vời. Bộ dữ liệu này chứa metadata của 45.000 bộ phim, gồm poster, ngày phát hành, thể loại và doanh thu.
Bạn có thể lập trình theo hướng dẫn trong tutorial Recommender Systems in Python trên Datacamp để xây dựng một hệ thống gợi ý dựa trên nội dung sử dụng thông tin phim có trong bộ dữ liệu.
Nếu bạn muốn có thêm định hướng khi xây dựng hệ thống gợi ý phim, hãy đăng ký một buổi đào tạo code-along trực tiếp trên Datacamp. Đây là workshop có hướng dẫn do chuyên gia dẫn dắt, dạy bạn cách tạo hệ thống gợi ý bằng R trong 1,5 giờ, và bạn có thể hỏi giảng viên để làm rõ nếu gặp khó khăn trong quá trình thực hiện.
2. Hệ thống gợi ý dựa trên lọc cộng tác
Các mô hình dựa trên lọc cộng tác được dùng để tạo gợi ý dựa trên hành vi trong quá khứ của người dùng. Chúng có thể được chia nhỏ hơn thành lọc cộng tác dựa trên người dùng và dựa trên sản phẩm.
Đúng như tên gọi, lọc cộng tác dựa trên người dùng nhóm những khách hàng có hành vi tương tự lại với nhau.
Thuật toán này sau đó cung cấp gợi ý sản phẩm dựa trên sở thích chung của các phân khúc khách hàng này, như thể hiện trong sơ đồ dưới đây:

Hình ảnh do tác giả cung cấp
Ngược lại, lọc cộng tác dựa trên sản phẩm nhóm các sản phẩm tương tự lại với nhau dựa trên sở thích của người dùng, như minh họa trong hình này:

Hình ảnh do tác giả cung cấp
Để tìm hiểu thêm về các loại hệ thống gợi ý khác nhau và cách triển khai, hãy học khóa Build Recommendation Engines in Python của Datacamp.
Ý tưởng dự án lọc cộng tác
Bạn có thể xây dựng một hệ thống gợi ý dựa trên lọc cộng tác bằng cách sử dụng Book Recommender System Dataset trên Kaggle. Bộ dữ liệu này chỉ chứa ba biến - ID người dùng, mã ISBN của sách và đánh giá của người dùng cho mỗi cuốn sách.
Tutorial recommendation system này có thể giúp bạn bắt đầu nếu bạn chưa quen với cách hoạt động của lọc cộng tác.
2. Phân tích cảm xúc
Hình ảnh từ KDNuggets
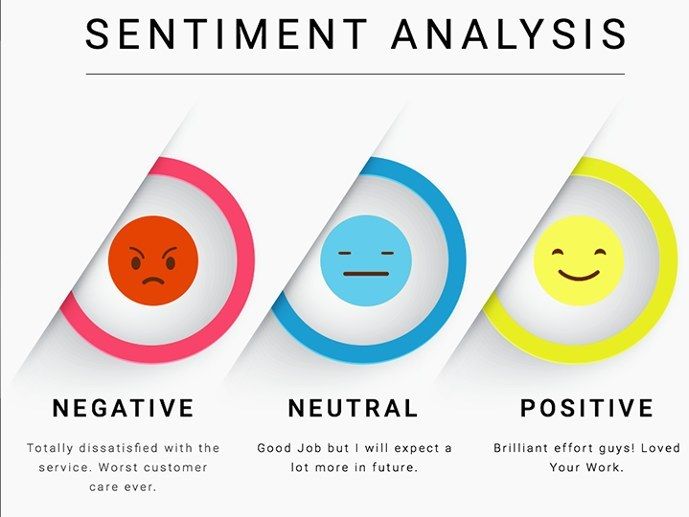
Phân tích cảm xúc, còn gọi là khai thác ý kiến, là quá trình xác định cảm xúc ẩn sau một đoạn văn bản, và là một ứng dụng phổ biến khác của khoa học dữ liệu trong marketing.
Dưới đây là ví dụ về cách phân tích cảm xúc mang lại giá trị kinh doanh cho các tổ chức:
Một ngân hàng ở Nam Phi chứng kiến tỷ lệ khách hàng rời bỏ cao hơn bình thường. Nhiều người dùng bắt đầu chuyển sang các tổ chức cạnh tranh và không còn muốn giao dịch với họ nữa. Ngân hàng đã cố gắng xác định vấn đề với sự hỗ trợ của phân tích cảm xúc.
Họ thu thập hơn 2 triệu điểm dữ liệu trên mạng xã hội để phân tích khách hàng đang nói gì về họ và huấn luyện một mô hình phân tích cảm xúc trên dữ liệu này.
Dựa trên phân tích, tổ chức nhận ra rằng hầu hết bình luận tiêu cực đến từ người dùng không hài lòng vì ngân hàng có quá ít giao dịch viên vào giờ nghỉ trưa, dẫn đến thời gian chờ đợi lâu.
Ngân hàng sau đó khắc phục tình hình bằng cách bố trí thêm giao dịch viên vào khung giờ cao điểm, giúp giảm tỷ lệ khách hàng rời bỏ.
Ví dụ trên cho thấy phân tích cảm xúc hữu ích thế nào trong việc giúp các công ty cải thiện sản phẩm và vượt qua đối thủ. Các ứng dụng khác của phân tích cảm xúc gồm phân tích sản phẩm, nghiên cứu thị trường và khai thác đánh giá người dùng.
Để tìm hiểu thêm về các mô hình phân tích cảm xúc và cách xây dựng từ đầu, hãy học khóa Sentiment Analysis in Python trên Datacamp.
Ý tưởng dự án phân tích cảm xúc
Bạn có thể bắt đầu bằng cách tạo một mô hình Phân tích Cảm xúc Bài đánh giá Phim sử dụng bộ dữ liệu có sẵn trong thư viện NLTK. NLTK là một gói Python cung cấp bộ thuật toán đa dạng cho Xử lý Ngôn ngữ Tự nhiên.
Trong dự án này, bạn có thể dùng một bộ dữ liệu đánh giá phim được tích hợp sẵn trong thư viện, có thể import chỉ bằng một dòng lệnh. Sau đó, bạn cần xây dựng một thuật toán phân loại dữ liệu đánh giá phim thành cảm xúc tích cực và tiêu cực.
Lập trình theo tutorial Python Sentiment Analysis trên Datacamp nếu bạn cần hướng dẫn để bắt đầu.
3. Dự đoán khách hàng rời bỏ (churn)
Hình ảnh từ DeepNote
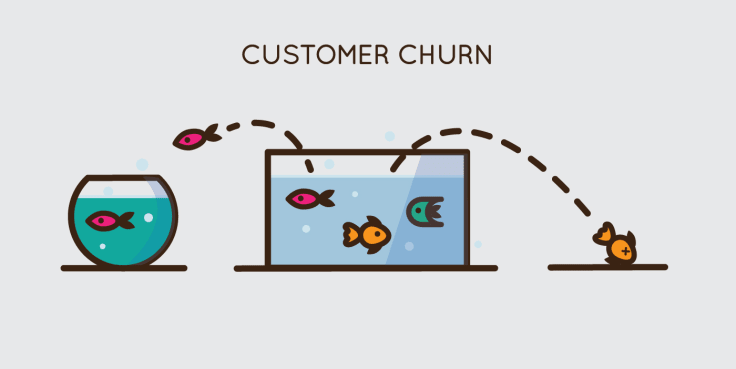
Khách hàng rời bỏ (churn) là hiện tượng xảy ra khi người dùng ngừng giao dịch với một doanh nghiệp. Ví dụ, nếu bạn là người dùng Netflix và quyết định hủy đăng ký, bạn là một khách hàng đã rời bỏ.
Đối với các công ty, thay thế một khách hàng đã rời bỏ tốn kém hơn nhiều so với giữ chân khách hàng hiện tại. Vì vậy, nhiều tổ chức thuê nhà khoa học dữ liệu để xác định những người dùng sắp rời bỏ nhằm ngăn chặn điều này xảy ra.
Dưới đây là ví dụ về cách một mô hình dự đoán churn có thể giúp công ty giữ chân người dùng:
Bạn đăng ký dùng một nhà cung cấp dịch vụ Internet và gần đây thường xuyên gặp tình trạng tốc độ kết nối chậm. Bạn đã gửi vài khiếu nại và cố liên hệ đội hỗ trợ khách hàng, nhưng vấn đề vẫn tồn tại. Vì vậy, bạn đã thử bật tắt router và kết nối lại mạng nhiều lần.
Cuối cùng, bạn quyết định chuyển sang thương hiệu đối thủ vì trải nghiệm với nhà mạng này quá tệ.
Đội khoa học dữ liệu của nhà mạng thu thập dữ liệu hành vi khách hàng, theo dõi hoạt động khi người dùng kết nối mạng và tập hợp thông tin khiếu nại. Sau khi hợp nhất dữ liệu, đội nhận ra bạn có nguy cơ rời bỏ cao.
Họ lập tức cảnh báo các đội marketing và sản phẩm rằng bạn có khả năng sẽ ngừng giao dịch với họ.
Đội marketing của công ty sau đó liên hệ với bạn bằng các khuyến mãi cá nhân hóa và gói WiFi giảm giá, thậm chí đề nghị nâng cấp gói hiện tại miễn phí. Sau khi nâng cấp, bạn nhận thấy tốc độ nhanh hơn nhiều và trải nghiệm tổng thể với nhà mạng dễ chịu hơn. Bạn quyết định tiếp tục đăng ký thay vì chuyển sang thương hiệu đối thủ.
Ví dụ trên cho thấy mô hình churn hữu ích thế nào trong việc giữ chân người dùng hiện có của tổ chức. Ứng dụng này mang lại giá trị kinh doanh trực tiếp và thường được dùng bởi các nền tảng đăng ký như Netflix và Spotify, vốn phụ thuộc vào việc gia hạn của người dùng làm nguồn doanh thu chính.
Ý tưởng dự án dự đoán churn
Bạn có thể dùng bộ dữ liệu Telecom Customer Churn trên DataCamp để tạo dự án dự đoán churn đầu tiên.
Bộ dữ liệu này chứa thông tin về người dùng đăng ký một công ty viễn thông Iran, như độ tuổi, hành vi sử dụng, thời gian đăng ký và khiếu nại. Hãy dùng dữ liệu này để dự đoán liệu một khách hàng có khả năng rời bỏ hay không.
Nếu bạn chưa biết bắt đầu từ đâu, hãy lập trình theo tutorial Customer Churn Rate Prediction để xây dựng mô hình. Bạn cũng có thể xem khóa học Predicting Customer Churn in Python của chúng tôi.
4. Phân khúc khách hàng
Hình ảnh từ Madlytics
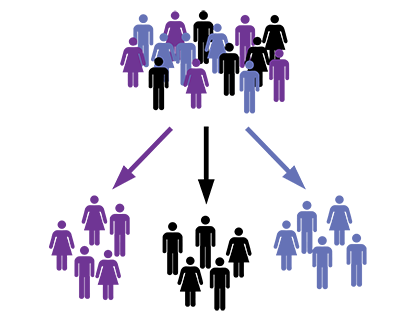
Phân khúc khách hàng là quá trình chia người dùng thành các nhóm nhỏ dựa trên những đặc điểm chung. Mỗi phân khúc sau đó được nhắm mục tiêu bằng những khuyến mãi và sản phẩm khác nhau dựa trên hành vi của họ.
Dưới đây là ví dụ về cách phân khúc khách hàng có thể mang lại giá trị cho tổ chức:
Một công ty thương mại điện tử xây dựng mô hình phân khúc khách hàng để nhắm mục tiêu người dùng khác nhau bằng các khuyến mãi cá nhân hóa.
Nếu một người dùng thường xuyên duyệt nền tảng nhưng chỉ mua khi có giảm giá, họ được phân loại là “Thợ săn khuyến mãi”. Tất cả khách hàng trong phân khúc này sẽ ngay lập tức nhận email thông báo mỗi khi có chương trình giảm giá vì họ có khả năng mua sắm nhiều hơn trong thời gian này.
Ở chiều ngược lại, có những người mua sắm theo món đồ cụ thể và sẵn sàng mua bất kể giá cả vì họ coi trọng chất lượng hơn là giá rẻ. Những khách hàng này được nhắm mục tiêu theo cách khác, và đội marketing của công ty chỉ quảng bá sản phẩm cao cấp cho nhóm này dựa trên các mặt hàng họ đã thể hiện sự quan tâm.
Bằng cách này, khách hàng có sức mua cao sẽ được hiển thị các sản phẩm đắt tiền phù hợp với sở thích, khuyến khích họ chi tiêu nhiều hơn. Những người coi trọng tính tiết kiệm sẽ bị thu hút bởi các sản phẩm giá rẻ trong thời gian khuyến mãi.
Ví dụ trên tuy đơn giản nhưng cho thấy phân khúc khách hàng giúp công ty tối đa hóa lợi nhuận thu được từ mỗi người dùng như thế nào.
Một trong những ứng dụng phổ biến nhất của mô hình phân khúc khách hàng là xây dựng nhóm quảng cáo trong các chiến dịch tiếp thị.
Chẳng hạn, Facebook thu thập dữ liệu nhân khẩu học và hành vi của người dùng và cho phép các công ty chạy quảng cáo nhắm đến nhóm đối tượng tùy chỉnh dựa trên thông tin này. Người dùng có thể được phân khúc theo các đặc điểm cụ thể như vị trí, tuổi, giới tính, thương hiệu họ yêu thích và những người họ có liên hệ.
Phân khúc khách hàng thường được thực hiện bằng cách xây dựng các mô hình học máy không giám sát như K-Means clustering.
Nếu bạn muốn tìm hiểu thêm về phân khúc khách hàng và cách xây dựng các thuật toán như K-Means, hãy học khóa Customer Segmentation in Python của chúng tôi.
Ý tưởng dự án phân khúc khách hàng
Bạn có thể sử dụng E-Commerce Dataset của Datacamp để xây dựng một dự án portfolio về phân khúc khách hàng.
Bộ dữ liệu này gồm chi tiết các đơn hàng thực hiện trên một nền tảng thương mại điện tử tại Vương quốc Anh.
Thông tin mua sắm của khách hàng như mặt hàng đã đặt, giá sản phẩm và ngày hóa đơn được ghi nhận, và bạn có thể dùng dữ liệu này để phân khúc người dùng dựa trên hoạt động của họ trên nền tảng.
5. Phân tích giỏ hàng
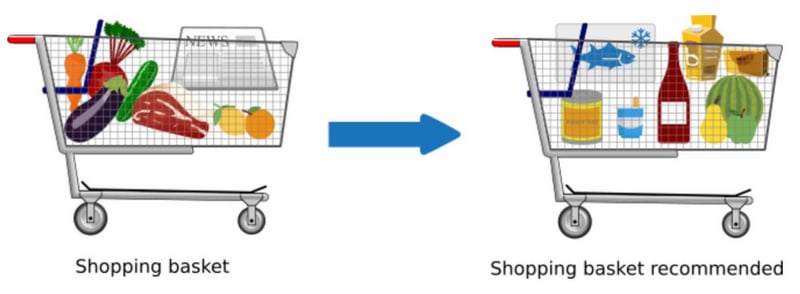
Hình ảnh từ Analytics Vidhya
Phân tích giỏ hàng, còn gọi là khai phá luật kết hợp, là kỹ thuật dùng để phân tích những mặt hàng thường được mua cùng nhau. Điều này được thực hiện bằng cách xử lý dữ liệu mua hàng lịch sử để xác định các tổ hợp sản phẩm thường xuất hiện cùng nhau trong giao dịch.
Các phát hiện từ phân tích này có thể được nhà bán lẻ sử dụng để cải thiện cách bày trí cửa hàng và khuyến khích khách hàng mua nhiều mặt hàng hơn trong một lần thanh toán.
Ví dụ, người mua sữa bột cho em bé cũng có khả năng mua tã, vì vậy các cửa hàng thường đặt các mặt hàng này gần nhau để người dùng dễ tiếp cận.
Tuy nhiên, các mẫu hành vi mua không phải lúc nào cũng hiển nhiên. Tùy vào khu vực, ảnh hưởng văn hóa và các yếu tố nhân khẩu học, khách hàng có xu hướng mua cùng lúc những mặt hàng không thuộc cùng một danh mục. Nhiều mối liên hệ như vậy không thể được phát hiện bằng mắt thường, đó là lý do các tổ chức dựa vào kỹ thuật khoa học dữ liệu như phân tích giỏ hàng.
Dưới đây là ví dụ về cách phân tích giỏ hàng có thể xác định các mối liên hệ mà con người bỏ sót:
Ví dụ được trích dẫn nhiều nhất về phân tích giỏ hàng là nghiên cứu “bia và tã”. Theo nghiên cứu này, một chuỗi siêu thị vùng Trung Tây đã sử dụng kỹ thuật khai phá dữ liệu để xác định những mặt hàng thường được mua cùng nhau.
Phân tích cho thấy khách hàng thường mua bia và tã vào tối thứ Sáu. Mối liên hệ này có vẻ chỉ là trùng hợp, nhưng đây là một kịch bản có thể đã gây ra điều đó:
Một ông bố trẻ ghé siêu thị tối thứ Sáu để mua vài lon bia sau một tuần làm việc dài. Vợ anh ấy biết chuyện và nhờ mua thêm tã cho em bé mới sinh. Hành vi này trở thành thói quen, và các ông bố đi làm bắt đầu mua bia và tã cùng nhau trước khi về nhà vào tối thứ Sáu.
Sau phát hiện này, cửa hàng bắt đầu đặt bia và tã ở cùng một lối đi và ngay lập tức chứng kiến doanh số tăng.
Câu chuyện này lần đầu được đưa tin vào giữa thập niên 90 và tính xác thực đã bị nghi ngờ theo thời gian. Dù là hư cấu hay không, trường hợp sử dụng này nhắc nhở chúng ta về sức mạnh của thống kê trong việc khám phá những mối liên hệ ẩn mà mắt người không nhận ra.
Phân tích giỏ hàng không chỉ giới hạn ở cửa hàng bán lẻ truyền thống. Các nền tảng thương mại điện tử cũng hiển thị các sản phẩm có mức độ tương quan cao trên cùng một trang, đảm bảo chúng nằm trong tầm mắt của người dùng.
Nếu bạn mua quần jeans đen trực tuyến, chẳng hạn, bạn có thể thấy giày phù hợp được hiển thị ở cuối trang, khuyến khích bạn mua một gói sản phẩm thay vì chỉ một món. Một lần nữa, điều này dẫn đến tăng doanh số trực tiếp vì khách hàng mua nhiều hơn dự định ban đầu.
Để tìm hiểu thêm về phân tích giỏ hàng và cách thực hiện bằng kỹ thuật học máy, hãy học lộ trình Market Basket Analysis in Python. Nếu bạn thích dùng R, hãy học khóa Market Basket Analysis in R.
Ý tưởng dự án phân tích giỏ hàng
Để bắt đầu với phân tích giỏ hàng, bạn có thể sử dụng cùng E-Commerce Dataset như đã đề cập trong phần phân khúc khách hàng ở trên. Lưu ý đây là phiên bản rút gọn của bộ dữ liệu có trên UCI Machine Learning Repository và chỉ chứa 2.500 dòng. Bạn có thể tải bộ dữ liệu lớn hơn nếu muốn có nhiều dữ liệu để làm việc.
Như giải thích ở phần trước, E-Commerce Dataset chứa dữ liệu giao dịch của khách hàng như số hóa đơn và sản phẩm đã mua. Bạn có thể dùng thông tin này để xác định các mặt hàng mà khách thường mua cùng nhau trong cùng một giao dịch.
Bạn có thể tham khảo tutorial Market Basket Analysis in R để triển khai dự án này. Nếu Python là ngôn ngữ ưa thích, chúng tôi có khóa Market Basket Analysis in Python.
Khoa học dữ liệu trong marketing - Bước tiếp theo:
Tại sao bạn nên cân nhắc trở thành nhà khoa học dữ liệu marketing?
Khoa học dữ liệu có nhiều ứng dụng trong lĩnh vực marketing, nhiều trong số đó chúng ta đã bàn ở trên. Những trường hợp sử dụng này mang lại giá trị trực tiếp cho tổ chức bằng cách cải thiện doanh số, giải quyết điểm đau của khách hàng và khuyến khích người mua tiêu dùng nhiều hơn.
Trước đây, khi các tổ chức chưa có quyền truy cập vào lượng dữ liệu khách hàng lớn, các chuyên gia marketing sẽ tự thực hiện nhiều ứng dụng nói trên. Phân tích cảm xúc và nghiên cứu thị trường được tiến hành bằng cách gửi khảo sát. Marketer gửi quảng cáo nhắm mục tiêu cho người dùng dựa trên hiểu biết của họ về hành vi khách hàng, và đó là một quy trình thiên về trực giác hơn là dựa trên dữ liệu.
Ngày nay, khi lượng dữ liệu mà các tổ chức thu thập và lưu trữ tăng đột biến, các công ty bắt đầu tiếp cận marketing dựa trên dữ liệu.
Tuy nhiên, chỉ thuê nhà khoa học dữ liệu để làm các bài toán marketing là chưa đủ.
Mặc dù nhà khoa học dữ liệu có thể xử lý bộ dữ liệu phức tạp, xây dựng mô hình dự đoán chính xác cao và thực hiện phân tích thống kê, những kỹ năng này thôi là chưa đủ để rút ra insight giá trị từ dữ liệu. Họ thiếu kiến thức chuyên môn về marketing và thường không thể liên hệ dữ liệu sẵn có với bài toán kinh doanh.
Ngược lại, chuyên gia marketing hiểu hành vi khách hàng, biết cách hình thành bài toán và có thể định hướng quyết định marketing. Họ thiếu chuyên môn kỹ thuật để xử lý bộ dữ liệu lớn.
Một nhà khoa học dữ liệu chuyên về lĩnh vực marketing sở hữu bộ kỹ năng kết hợp của cả hai vai trò, điều vô giá đối với tổ chức. Những người này có thể thu hẹp khoảng cách giữa khoa học dữ liệu và marketing và đưa ra các quyết định dựa trên dữ liệu mang lại lợi nhuận cho công ty.
Cách trở thành nhà khoa học dữ liệu marketing
Để trở thành nhà khoa học dữ liệu marketing, bạn cần có năng lực kỹ thuật và phân tích mạnh, kiến thức chuyên môn marketing và các kỹ năng mềm:
1. Kỹ năng kỹ thuật
- SQL để trích xuất, làm sạch và thao tác dữ liệu trong cơ sở dữ liệu. Học khóa Introduction to SQL để nắm cơ bản về thao tác cơ sở dữ liệu.
- Thành thạo thống kê và hiểu biết về các kỹ thuật học máy có giám sát và không giám sát. Học khóa Introduction to Statistics để tìm hiểu nền tảng phân tích thống kê.
- Biết ít nhất một ngôn ngữ lập trình (R, Python, Java, v.v.). Nếu bạn chưa biết lập trình, hãy học lộ trình kỹ năng Python Programming của Datacamp hoặc lựa chọn R.
- Khả năng thực hiện thử nghiệm A/B.
- Khả năng trực quan hóa dữ liệu và xây dựng dashboard bằng các công cụ như Tableau, PowerBI và Excel.
- Hiểu cách chạy và tối ưu chiến dịch quảng cáo trên các nền tảng như Facebook và Google Display Network.
- Khả năng thiết kế thí nghiệm và mô hình phân bổ (attribution).
Lưu ý rằng các yêu cầu trên sẽ khác nhau tùy tổ chức và đội ngũ bạn tham gia. Ví dụ, một đội tập trung hiển thị gợi ý sản phẩm cho người dùng sẽ không làm tối ưu quảng cáo, cũng như không thực hiện các tác vụ như mô hình phân bổ.
Nếu bạn chưa có kiến thức chuyên môn về marketing và muốn học cách thực hiện A/B test, trực quan hóa chỉ số marketing và phân tích chuyển đổi, hãy học khóa Introduction to Pandas for Marketing trên Datacamp.
2. Kỹ năng mềm
- Kỹ năng giao tiếp tốt.
- Khả năng diễn giải các khái niệm kỹ thuật phức tạp cho lãnh đạo cấp cao và hỗ trợ ra quyết định.
- Khả năng xây dựng các giải pháp dựa trên dữ liệu để giải quyết vấn đề kinh doanh.
Để hình dung rõ hơn các công ty tìm kiếm gì ở một nhà khoa học dữ liệu marketing, dưới đây là yêu cầu cho vai trò này của Uber:
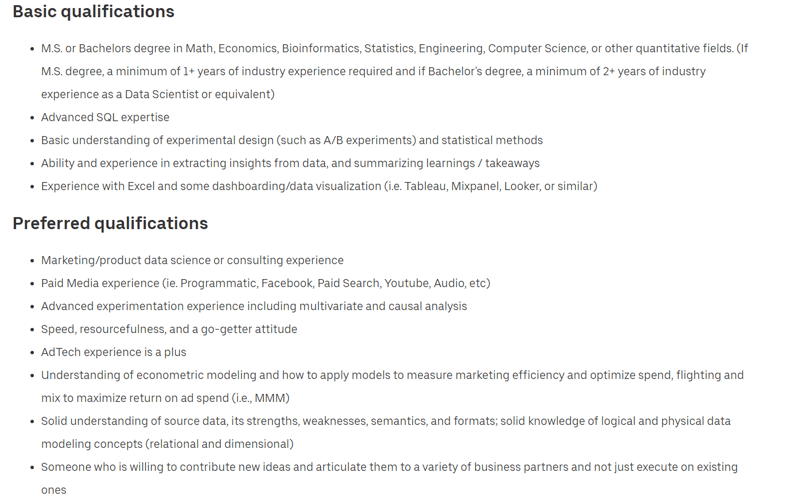
Nếu bạn chưa có kinh nghiệm trong lĩnh vực khoa học dữ liệu marketing, cách tốt nhất để thể hiện kỹ năng là tạo các dự án giải quyết vấn đề kinh doanh thực tế.
Chúng tôi đã liệt kê các dự án phù hợp cho mỗi ứng dụng được giải thích trong bài viết này, và việc đưa một số dự án vào hồ sơ là ý tưởng hay để cho nhà tuyển dụng thấy bạn có thể tạo ra giá trị kinh doanh bằng các kỹ thuật khoa học dữ liệu.
Cuối cùng, nếu bạn muốn lấp đầy khoảng trống kiến thức hiện có và học cách áp dụng phương pháp khoa học dữ liệu vào marketing, bạn có thể học khóa Machine Learning for Marketing in Python của Datacamp, hoặc phiên bản R.


 Matt Crabtree · 10 min
Giới thiệu về khoa học dữ liệu trong marketing
Bạn đã bao giờ mua hàng trên một nền tảng mua sắm trực tuyến rồi sau đó liên tục thấy tràn ngập quảng cáo về các sản phẩm tương tự mỗi khi lướt web chưa? Đó là một ứng dụng của khoa học dữ liệu trong marketing.
Phần lớn dữ liệu của thế giới chỉ mới được tạo ra trong vòng hai năm qua, và các công ty giờ có khả năng thu thập và lưu trữ dữ liệu khách hàng ở quy mô lớn hơn bao giờ hết. Mỗi lần người dùng tương tác với website, trang mạng xã hội, hoặc hệ thống POS của một tổ chức, những điểm dữ liệu mới lại được tạo ra.
Dữ liệu này sau đó được dùng để xây dựng những insight về hành vi người dùng và gửi cho họ các quảng cáo được chọn lọc, gợi ý sản phẩm cá nhân hóa, cùng các khuyến mãi đặc biệt.
Hầu hết chúng ta tương tác với các ứng dụng khoa học dữ liệu trong marketing hằng ngày và vô thức đưa ra quyết định dựa trên chúng.
Trong bài viết này, chúng ta sẽ cùng điểm qua 5 cách sử dụng khoa học dữ liệu trong marketing. Sau đó, chúng ta sẽ khám phá một dự án cá nhân bạn có thể thêm vào portfolio khoa học dữ liệu cho mỗi trường hợp sử dụng. Cuối cùng, chúng ta sẽ đề cập đến lý do bạn nên trở thành một nhà khoa học dữ liệu marketing và cách để tìm được công việc trong lĩnh vực này.
5 trường hợp sử dụng khoa học dữ liệu trong marketing
1. Hệ thống gợi ý
Các công ty như Netflix, Spotify và Amazon sử dụng hệ thống gợi ý để cung cấp cho người dùng các đề xuất nội dung cá nhân hóa dựa trên cách họ tương tác với nền tảng.
Chẳng hạn, nếu bạn xem một bộ phim trên Netflix và đánh giá tích cực, lần tiếp theo mở ứng dụng, bạn sẽ được gợi ý những bộ phim cùng thể loại, nội dung và dàn diễn viên.
Đây là một ví dụ đơn giản về cách chúng ta tương tác với các công cụ gợi ý trong cuộc sống hàng ngày.
Hệ thống gợi ý trở nên mạnh mẽ hơn theo thời gian khi người dùng tiếp tục tương tác với chúng.
Ví dụ, nếu bạn mới dùng Spotify, các gợi ý âm nhạc ban đầu sẽ khá chung chung. Ứng dụng sẽ gợi ý nhiều thể loại thu hút số đông vì thuật toán chưa có đủ dữ liệu để hiểu sở thích của bạn.
Khi bạn dành nhiều thời gian hơn trên nền tảng, công cụ gợi ý sẽ học được nhiều hơn về điều bạn thích và không thích, và đề xuất sẽ được điều chỉnh theo gu của bạn. Thuật toán thậm chí có thể dự đoán loại nhạc bạn có thể thích vào các mùa khác nhau hoặc vào những thời điểm khác nhau trong ngày.
Các loại hệ thống gợi ý
Hệ thống gợi ý có thể được phân loại rộng thành hai loại - hệ thống gợi ý dựa trên nội dung và hệ thống gợi ý dựa trên lọc cộng tác.
1. Hệ thống gợi ý dựa trên nội dung:
Hình ảnh do tác giả cung cấp
Hệ thống gợi ý dựa trên nội dung đưa ra đề xuất chỉ dựa vào nội dung của sản phẩm.
Ví dụ, nếu bạn thích đọc các tiểu thuyết trong sê-ri Percy Jackson, bạn có thể được gợi ý Heroes of Olympus, cùng tác giả và thể loại tương tự.
Tuy nhiên, một bất lợi của thuật toán này là bạn sẽ không được gợi ý những cuốn sách khác biệt so với những gì bạn đã đọc. Nếu bạn thích Percy Jackson, bạn sẽ chỉ được gợi ý sách phiêu lưu và giả tưởng, dù có thể bạn cũng sẽ thích một cuốn phi hư cấu hoặc trinh thám.
Bạn có thể khắc phục nhược điểm này của hệ thống gợi ý dựa trên nội dung bằng hệ thống gợi ý dựa trên lọc cộng tác, chúng tôi sẽ giải thích sau trong bài viết.
Ý tưởng dự án hệ thống gợi ý dựa trên nội dung
Nếu bạn là người mới với ít hoặc chưa có kinh nghiệm xây dựng hệ thống gợi ý, Kaggle Movie Dataset là nơi khởi đầu tuyệt vời. Bộ dữ liệu này chứa metadata của 45.000 bộ phim, gồm poster, ngày phát hành, thể loại và doanh thu.
Bạn có thể lập trình theo hướng dẫn trong tutorial Recommender Systems in Python trên Datacamp để xây dựng một hệ thống gợi ý dựa trên nội dung sử dụng thông tin phim có trong bộ dữ liệu.
Nếu bạn muốn có thêm định hướng khi xây dựng hệ thống gợi ý phim, hãy đăng ký một buổi đào tạo code-along trực tiếp trên Datacamp. Đây là workshop có hướng dẫn do chuyên gia dẫn dắt, dạy bạn cách tạo hệ thống gợi ý bằng R trong 1,5 giờ, và bạn có thể hỏi giảng viên để làm rõ nếu gặp khó khăn trong quá trình thực hiện.
2. Hệ thống gợi ý dựa trên lọc cộng tác
Các mô hình dựa trên lọc cộng tác được dùng để tạo gợi ý dựa trên hành vi trong quá khứ của người dùng. Chúng có thể được chia nhỏ hơn thành lọc cộng tác dựa trên người dùng và dựa trên sản phẩm.
Đúng như tên gọi, lọc cộng tác dựa trên người dùng nhóm những khách hàng có hành vi tương tự lại với nhau.
Thuật toán này sau đó cung cấp gợi ý sản phẩm dựa trên sở thích chung của các phân khúc khách hàng này, như thể hiện trong sơ đồ dưới đây:
Hình ảnh do tác giả cung cấp
Ngược lại, lọc cộng tác dựa trên sản phẩm nhóm các sản phẩm tương tự lại với nhau dựa trên sở thích của người dùng, như minh họa trong hình này:
Hình ảnh do tác giả cung cấp
Để tìm hiểu thêm về các loại hệ thống gợi ý khác nhau và cách triển khai, hãy học khóa Build Recommendation Engines in Python của Datacamp.
Ý tưởng dự án lọc cộng tác
Bạn có thể xây dựng một hệ thống gợi ý dựa trên lọc cộng tác bằng cách sử dụng Book Recommender System Dataset trên Kaggle. Bộ dữ liệu này chỉ chứa ba biến - ID người dùng, mã ISBN của sách và đánh giá của người dùng cho mỗi cuốn sách.
Tutorial recommendation system này có thể giúp bạn bắt đầu nếu bạn chưa quen với cách hoạt động của lọc cộng tác.
2. Phân tích cảm xúc
Hình ảnh từ KDNuggets
Phân tích cảm xúc, còn gọi là khai thác ý kiến, là quá trình xác định cảm xúc ẩn sau một đoạn văn bản, và là một ứng dụng phổ biến khác của khoa học dữ liệu trong marketing.
Dưới đây là ví dụ về cách phân tích cảm xúc mang lại giá trị kinh doanh cho các tổ chức:
Một ngân hàng ở Nam Phi chứng kiến tỷ lệ khách hàng rời bỏ cao hơn bình thường. Nhiều người dùng bắt đầu chuyển sang các tổ chức cạnh tranh và không còn muốn giao dịch với họ nữa. Ngân hàng đã cố gắng xác định vấn đề với sự hỗ trợ của phân tích cảm xúc.
Họ thu thập hơn 2 triệu điểm dữ liệu trên mạng xã hội để phân tích khách hàng đang nói gì về họ và huấn luyện một mô hình phân tích cảm xúc trên dữ liệu này.
Dựa trên phân tích, tổ chức nhận ra rằng hầu hết bình luận tiêu cực đến từ người dùng không hài lòng vì ngân hàng có quá ít giao dịch viên vào giờ nghỉ trưa, dẫn đến thời gian chờ đợi lâu.
Ngân hàng sau đó khắc phục tình hình bằng cách bố trí thêm giao dịch viên vào khung giờ cao điểm, giúp giảm tỷ lệ khách hàng rời bỏ.
Ví dụ trên cho thấy phân tích cảm xúc hữu ích thế nào trong việc giúp các công ty cải thiện sản phẩm và vượt qua đối thủ. Các ứng dụng khác của phân tích cảm xúc gồm phân tích sản phẩm, nghiên cứu thị trường và khai thác đánh giá người dùng.
Để tìm hiểu thêm về các mô hình phân tích cảm xúc và cách xây dựng từ đầu, hãy học khóa Sentiment Analysis in Python trên Datacamp.
Ý tưởng dự án phân tích cảm xúc
Bạn có thể bắt đầu bằng cách tạo một mô hình Phân tích Cảm xúc Bài đánh giá Phim sử dụng bộ dữ liệu có sẵn trong thư viện NLTK. NLTK là một gói Python cung cấp bộ thuật toán đa dạng cho Xử lý Ngôn ngữ Tự nhiên.
Trong dự án này, bạn có thể dùng một bộ dữ liệu đánh giá phim được tích hợp sẵn trong thư viện, có thể import chỉ bằng một dòng lệnh. Sau đó, bạn cần xây dựng một thuật toán phân loại dữ liệu đánh giá phim thành cảm xúc tích cực và tiêu cực.
Lập trình theo tutorial Python Sentiment Analysis trên Datacamp nếu bạn cần hướng dẫn để bắt đầu.
3. Dự đoán khách hàng rời bỏ (churn)
Hình ảnh từ DeepNote
Khách hàng rời bỏ (churn) là hiện tượng xảy ra khi người dùng ngừng giao dịch với một doanh nghiệp. Ví dụ, nếu bạn là người dùng Netflix và quyết định hủy đăng ký, bạn là một khách hàng đã rời bỏ.
Đối với các công ty, thay thế một khách hàng đã rời bỏ tốn kém hơn nhiều so với giữ chân khách hàng hiện tại. Vì vậy, nhiều tổ chức thuê nhà khoa học dữ liệu để xác định những người dùng sắp rời bỏ nhằm ngăn chặn điều này xảy ra.
Dưới đây là ví dụ về cách một mô hình dự đoán churn có thể giúp công ty giữ chân người dùng:
Bạn đăng ký dùng một nhà cung cấp dịch vụ Internet và gần đây thường xuyên gặp tình trạng tốc độ kết nối chậm. Bạn đã gửi vài khiếu nại và cố liên hệ đội hỗ trợ khách hàng, nhưng vấn đề vẫn tồn tại. Vì vậy, bạn đã thử bật tắt router và kết nối lại mạng nhiều lần.
Cuối cùng, bạn quyết định chuyển sang thương hiệu đối thủ vì trải nghiệm với nhà mạng này quá tệ.
Đội khoa học dữ liệu của nhà mạng thu thập dữ liệu hành vi khách hàng, theo dõi hoạt động khi người dùng kết nối mạng và tập hợp thông tin khiếu nại. Sau khi hợp nhất dữ liệu, đội nhận ra bạn có nguy cơ rời bỏ cao.
Họ lập tức cảnh báo các đội marketing và sản phẩm rằng bạn có khả năng sẽ ngừng giao dịch với họ.
Đội marketing của công ty sau đó liên hệ với bạn bằng các khuyến mãi cá nhân hóa và gói WiFi giảm giá, thậm chí đề nghị nâng cấp gói hiện tại miễn phí. Sau khi nâng cấp, bạn nhận thấy tốc độ nhanh hơn nhiều và trải nghiệm tổng thể với nhà mạng dễ chịu hơn. Bạn quyết định tiếp tục đăng ký thay vì chuyển sang thương hiệu đối thủ.
Ví dụ trên cho thấy mô hình churn hữu ích thế nào trong việc giữ chân người dùng hiện có của tổ chức. Ứng dụng này mang lại giá trị kinh doanh trực tiếp và thường được dùng bởi các nền tảng đăng ký như Netflix và Spotify, vốn phụ thuộc vào việc gia hạn của người dùng làm nguồn doanh thu chính.
Ý tưởng dự án dự đoán churn
Bạn có thể dùng bộ dữ liệu Telecom Customer Churn trên DataCamp để tạo dự án dự đoán churn đầu tiên.
Bộ dữ liệu này chứa thông tin về người dùng đăng ký một công ty viễn thông Iran, như độ tuổi, hành vi sử dụng, thời gian đăng ký và khiếu nại. Hãy dùng dữ liệu này để dự đoán liệu một khách hàng có khả năng rời bỏ hay không.
Nếu bạn chưa biết bắt đầu từ đâu, hãy lập trình theo tutorial Customer Churn Rate Prediction để xây dựng mô hình. Bạn cũng có thể xem khóa học Predicting Customer Churn in Python của chúng tôi.
4. Phân khúc khách hàng
Hình ảnh từ Madlytics
Phân khúc khách hàng là quá trình chia người dùng thành các nhóm nhỏ dựa trên những đặc điểm chung. Mỗi phân khúc sau đó được nhắm mục tiêu bằng những khuyến mãi và sản phẩm khác nhau dựa trên hành vi của họ.
Dưới đây là ví dụ về cách phân khúc khách hàng có thể mang lại giá trị cho tổ chức:
Một công ty thương mại điện tử xây dựng mô hình phân khúc khách hàng để nhắm mục tiêu người dùng khác nhau bằng các khuyến mãi cá nhân hóa.
Nếu một người dùng thường xuyên duyệt nền tảng nhưng chỉ mua khi có giảm giá, họ được phân loại là “Thợ săn khuyến mãi”. Tất cả khách hàng trong phân khúc này sẽ ngay lập tức nhận email thông báo mỗi khi có chương trình giảm giá vì họ có khả năng mua sắm nhiều hơn trong thời gian này.
Ở chiều ngược lại, có những người mua sắm theo món đồ cụ thể và sẵn sàng mua bất kể giá cả vì họ coi trọng chất lượng hơn là giá rẻ. Những khách hàng này được nhắm mục tiêu theo cách khác, và đội marketing của công ty chỉ quảng bá sản phẩm cao cấp cho nhóm này dựa trên các mặt hàng họ đã thể hiện sự quan tâm.
Bằng cách này, khách hàng có sức mua cao sẽ được hiển thị các sản phẩm đắt tiền phù hợp với sở thích, khuyến khích họ chi tiêu nhiều hơn. Những người coi trọng tính tiết kiệm sẽ bị thu hút bởi các sản phẩm giá rẻ trong thời gian khuyến mãi.
Ví dụ trên tuy đơn giản nhưng cho thấy phân khúc khách hàng giúp công ty tối đa hóa lợi nhuận thu được từ mỗi người dùng như thế nào.
Một trong những ứng dụng phổ biến nhất của mô hình phân khúc khách hàng là xây dựng nhóm quảng cáo trong các chiến dịch tiếp thị.
Chẳng hạn, Facebook thu thập dữ liệu nhân khẩu học và hành vi của người dùng và cho phép các công ty chạy quảng cáo nhắm đến nhóm đối tượng tùy chỉnh dựa trên thông tin này. Người dùng có thể được phân khúc theo các đặc điểm cụ thể như vị trí, tuổi, giới tính, thương hiệu họ yêu thích và những người họ có liên hệ.
Phân khúc khách hàng thường được thực hiện bằng cách xây dựng các mô hình học máy không giám sát như K-Means clustering.
Nếu bạn muốn tìm hiểu thêm về phân khúc khách hàng và cách xây dựng các thuật toán như K-Means, hãy học khóa Customer Segmentation in Python của chúng tôi.
Ý tưởng dự án phân khúc khách hàng
Bạn có thể sử dụng E-Commerce Dataset của Datacamp để xây dựng một dự án portfolio về phân khúc khách hàng.
Bộ dữ liệu này gồm chi tiết các đơn hàng thực hiện trên một nền tảng thương mại điện tử tại Vương quốc Anh.
Thông tin mua sắm của khách hàng như mặt hàng đã đặt, giá sản phẩm và ngày hóa đơn được ghi nhận, và bạn có thể dùng dữ liệu này để phân khúc người dùng dựa trên hoạt động của họ trên nền tảng.
5. Phân tích giỏ hàng
Hình ảnh từ Analytics Vidhya
Phân tích giỏ hàng, còn gọi là khai phá luật kết hợp, là kỹ thuật dùng để phân tích những mặt hàng thường được mua cùng nhau. Điều này được thực hiện bằng cách xử lý dữ liệu mua hàng lịch sử để xác định các tổ hợp sản phẩm thường xuất hiện cùng nhau trong giao dịch.
Các phát hiện từ phân tích này có thể được nhà bán lẻ sử dụng để cải thiện cách bày trí cửa hàng và khuyến khích khách hàng mua nhiều mặt hàng hơn trong một lần thanh toán.
Ví dụ, người mua sữa bột cho em bé cũng có khả năng mua tã, vì vậy các cửa hàng thường đặt các mặt hàng này gần nhau để người dùng dễ tiếp cận.
Tuy nhiên, các mẫu hành vi mua không phải lúc nào cũng hiển nhiên. Tùy vào khu vực, ảnh hưởng văn hóa và các yếu tố nhân khẩu học, khách hàng có xu hướng mua cùng lúc những mặt hàng không thuộc cùng một danh mục. Nhiều mối liên hệ như vậy không thể được phát hiện bằng mắt thường, đó là lý do các tổ chức dựa vào kỹ thuật khoa học dữ liệu như phân tích giỏ hàng.
Dưới đây là ví dụ về cách phân tích giỏ hàng có thể xác định các mối liên hệ mà con người bỏ sót:
Ví dụ được trích dẫn nhiều nhất về phân tích giỏ hàng là nghiên cứu “bia và tã”. Theo nghiên cứu này, một chuỗi siêu thị vùng Trung Tây đã sử dụng kỹ thuật khai phá dữ liệu để xác định những mặt hàng thường được mua cùng nhau.
Phân tích cho thấy khách hàng thường mua bia và tã vào tối thứ Sáu. Mối liên hệ này có vẻ chỉ là trùng hợp, nhưng đây là một kịch bản có thể đã gây ra điều đó:
Một ông bố trẻ ghé siêu thị tối thứ Sáu để mua vài lon bia sau một tuần làm việc dài. Vợ anh ấy biết chuyện và nhờ mua thêm tã cho em bé mới sinh. Hành vi này trở thành thói quen, và các ông bố đi làm bắt đầu mua bia và tã cùng nhau trước khi về nhà vào tối thứ Sáu.
Sau phát hiện này, cửa hàng bắt đầu đặt bia và tã ở cùng một lối đi và ngay lập tức chứng kiến doanh số tăng.
Câu chuyện này lần đầu được đưa tin vào giữa thập niên 90 và tính xác thực đã bị nghi ngờ theo thời gian. Dù là hư cấu hay không, trường hợp sử dụng này nhắc nhở chúng ta về sức mạnh của thống kê trong việc khám phá những mối liên hệ ẩn mà mắt người không nhận ra.
Phân tích giỏ hàng không chỉ giới hạn ở cửa hàng bán lẻ truyền thống. Các nền tảng thương mại điện tử cũng hiển thị các sản phẩm có mức độ tương quan cao trên cùng một trang, đảm bảo chúng nằm trong tầm mắt của người dùng.
Nếu bạn mua quần jeans đen trực tuyến, chẳng hạn, bạn có thể thấy giày phù hợp được hiển thị ở cuối trang, khuyến khích bạn mua một gói sản phẩm thay vì chỉ một món. Một lần nữa, điều này dẫn đến tăng doanh số trực tiếp vì khách hàng mua nhiều hơn dự định ban đầu.
Để tìm hiểu thêm về phân tích giỏ hàng và cách thực hiện bằng kỹ thuật học máy, hãy học lộ trình Market Basket Analysis in Python. Nếu bạn thích dùng R, hãy học khóa Market Basket Analysis in R.
Ý tưởng dự án phân tích giỏ hàng
Để bắt đầu với phân tích giỏ hàng, bạn có thể sử dụng cùng E-Commerce Dataset như đã đề cập trong phần phân khúc khách hàng ở trên. Lưu ý đây là phiên bản rút gọn của bộ dữ liệu có trên UCI Machine Learning Repository và chỉ chứa 2.500 dòng. Bạn có thể tải bộ dữ liệu lớn hơn nếu muốn có nhiều dữ liệu để làm việc.
Như giải thích ở phần trước, E-Commerce Dataset chứa dữ liệu giao dịch của khách hàng như số hóa đơn và sản phẩm đã mua. Bạn có thể dùng thông tin này để xác định các mặt hàng mà khách thường mua cùng nhau trong cùng một giao dịch.
Bạn có thể tham khảo tutorial Market Basket Analysis in R để triển khai dự án này. Nếu Python là ngôn ngữ ưa thích, chúng tôi có khóa Market Basket Analysis in Python.
Khoa học dữ liệu trong marketing - Bước tiếp theo:
Tại sao bạn nên cân nhắc trở thành nhà khoa học dữ liệu marketing?
Khoa học dữ liệu có nhiều ứng dụng trong lĩnh vực marketing, nhiều trong số đó chúng ta đã bàn ở trên. Những trường hợp sử dụng này mang lại giá trị trực tiếp cho tổ chức bằng cách cải thiện doanh số, giải quyết điểm đau của khách hàng và khuyến khích người mua tiêu dùng nhiều hơn.
Trước đây, khi các tổ chức chưa có quyền truy cập vào lượng dữ liệu khách hàng lớn, các chuyên gia marketing sẽ tự thực hiện nhiều ứng dụng nói trên. Phân tích cảm xúc và nghiên cứu thị trường được tiến hành bằng cách gửi khảo sát. Marketer gửi quảng cáo nhắm mục tiêu cho người dùng dựa trên hiểu biết của họ về hành vi khách hàng, và đó là một quy trình thiên về trực giác hơn là dựa trên dữ liệu.
Ngày nay, khi lượng dữ liệu mà các tổ chức thu thập và lưu trữ tăng đột biến, các công ty bắt đầu tiếp cận marketing dựa trên dữ liệu.
Tuy nhiên, chỉ thuê nhà khoa học dữ liệu để làm các bài toán marketing là chưa đủ.
Mặc dù nhà khoa học dữ liệu có thể xử lý bộ dữ liệu phức tạp, xây dựng mô hình dự đoán chính xác cao và thực hiện phân tích thống kê, những kỹ năng này thôi là chưa đủ để rút ra insight giá trị từ dữ liệu. Họ thiếu kiến thức chuyên môn về marketing và thường không thể liên hệ dữ liệu sẵn có với bài toán kinh doanh.
Ngược lại, chuyên gia marketing hiểu hành vi khách hàng, biết cách hình thành bài toán và có thể định hướng quyết định marketing. Họ thiếu chuyên môn kỹ thuật để xử lý bộ dữ liệu lớn.
Một nhà khoa học dữ liệu chuyên về lĩnh vực marketing sở hữu bộ kỹ năng kết hợp của cả hai vai trò, điều vô giá đối với tổ chức. Những người này có thể thu hẹp khoảng cách giữa khoa học dữ liệu và marketing và đưa ra các quyết định dựa trên dữ liệu mang lại lợi nhuận cho công ty.
Cách trở thành nhà khoa học dữ liệu marketing
Để trở thành nhà khoa học dữ liệu marketing, bạn cần có năng lực kỹ thuật và phân tích mạnh, kiến thức chuyên môn marketing và các kỹ năng mềm:
1. Kỹ năng kỹ thuật
Lưu ý rằng các yêu cầu trên sẽ khác nhau tùy tổ chức và đội ngũ bạn tham gia. Ví dụ, một đội tập trung hiển thị gợi ý sản phẩm cho người dùng sẽ không làm tối ưu quảng cáo, cũng như không thực hiện các tác vụ như mô hình phân bổ.
Nếu bạn chưa có kiến thức chuyên môn về marketing và muốn học cách thực hiện A/B test, trực quan hóa chỉ số marketing và phân tích chuyển đổi, hãy học khóa Introduction to Pandas for Marketing trên Datacamp.
2. Kỹ năng mềm
Để hình dung rõ hơn các công ty tìm kiếm gì ở một nhà khoa học dữ liệu marketing, dưới đây là yêu cầu cho vai trò này của Uber:
Nếu bạn chưa có kinh nghiệm trong lĩnh vực khoa học dữ liệu marketing, cách tốt nhất để thể hiện kỹ năng là tạo các dự án giải quyết vấn đề kinh doanh thực tế.
Chúng tôi đã liệt kê các dự án phù hợp cho mỗi ứng dụng được giải thích trong bài viết này, và việc đưa một số dự án vào hồ sơ là ý tưởng hay để cho nhà tuyển dụng thấy bạn có thể tạo ra giá trị kinh doanh bằng các kỹ thuật khoa học dữ liệu.
Cuối cùng, nếu bạn muốn lấp đầy khoảng trống kiến thức hiện có và học cách áp dụng phương pháp khoa học dữ liệu vào marketing, bạn có thể học khóa Machine Learning for Marketing in Python của Datacamp, hoặc phiên bản R.