Khóa học
Khai thác đặc trưng cho NLP bằng Python
4 giờ
29.8K
Lời hứa hẹn của học máy đã cho thấy nhiều kết quả ấn tượng trong vô số lĩnh vực. Xử lý ngôn ngữ tự nhiên cũng không ngoại lệ, và đây là một trong những lĩnh vực mà học máy có thể thể hiện phần nào trí tuệ nhân tạo tổng quát (không hoàn toàn nhưng ít nhất là một phần), đạt được những kết quả xuất sắc cho các tác vụ thực sự phức tạp.
Giờ đây, NLP (xử lý ngôn ngữ tự nhiên) không phải là lĩnh vực mới, học máy cũng vậy. Nhưng sự kết hợp của cả hai lại khá hiện đại và hứa hẹn sẽ tiếp tục tiến bộ. Đây là một trong những ứng dụng lai mà hầu như ai (chỉ với một chiếc điện thoại thông minh tầm trung) cũng gặp mỗi ngày. Ví dụ, hãy nghĩ đến "gợi ý từ trên bàn phím" hoặc tự động hoàn thành thông minh; tất cả đều là sản phẩm phụ của sự hòa trộn giữa NLP và Học máy, và một cách tự nhiên, chúng đã trở thành phần không thể tách rời trong cuộc sống của chúng ta.
Phân tích cảm xúc là một chủ đề trọng yếu trong lĩnh vực NLP. Nó nhanh chóng trở thành một trong những chủ đề nóng nhất nhờ tính ứng dụng và số lượng bài toán kinh doanh mà nó giải quyết được. Trong hướng dẫn này, bạn sẽ tìm hiểu chủ đề không hề đơn giản này theo một cách đơn giản. Bạn sẽ bóc tách những phần toán học nhỏ phía sau, và nghiên cứu chúng. Ở cuối bài, bạn cũng sẽ xây dựng một bộ phân loại cảm xúc đơn giản. Cụ thể, bạn sẽ tìm hiểu:
Bắt đầu nhé.
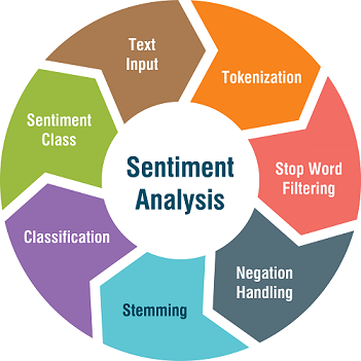
Về cơ bản, phân tích hay phân loại cảm xúc thuộc nhóm các tác vụ phân loại văn bản, nơi bạn nhận được một cụm từ hoặc danh sách các cụm từ và bộ phân loại của bạn phải cho biết cảm xúc đằng sau đó là tích cực, tiêu cực hay trung tính. Đôi khi, thuộc tính thứ ba không được sử dụng để giữ bài toán dạng nhị phân. Gần đây còn có các mức như "hơi tích cực" và "hơi tiêu cực". Hãy hiểu bằng một ví dụ.
Xem các cụm từ sau:
Các cụm từ này tương ứng với những đánh giá phim ngắn, và mỗi câu truyền tải cảm xúc khác nhau. Ví dụ, câu đầu thể hiện cảm xúc tích cực về bộ phim Titanic, trong khi câu thứ hai cho rằng phim không hay lắm (cảm xúc tiêu cực). Hãy xem kỹ câu thứ ba. Không có từ nào trong câu đó cho bạn biết điều gì về cảm xúc được truyền tải. Do đó, đó là một ví dụ về cảm xúc trung tính.
Xét từ góc nhìn học máy nghiêm ngặt, tác vụ này chẳng qua là một tác vụ học có giám sát. Bạn sẽ cung cấp một loạt cụm từ (kèm nhãn cảm xúc tương ứng) cho mô hình học máy, và bạn sẽ kiểm tra mô hình trên các cụm từ chưa có nhãn.
Để giới thiệu sơ lược về phân tích cảm xúc như vậy là ổn, nhưng để có thể xây dựng một mô hình phân loại cảm xúc, bạn cần thêm vài thứ nữa. Cùng tiếp tục.
 Nguồn: SlideShare
Trước khi hiểu phát biểu bài toán của một tác vụ phân loại cảm xúc, bạn cần nắm rõ bài toán phân loại văn bản nói chung. Hãy định nghĩa chính thức bài toán phân loại văn bản tổng quát.
Thuật ngữ tài liệu ở đây là tương đối trong thế giới phân loại văn bản. Theo đó, tài liệu có thể là tweet, cụm từ, đoạn báo, cả bài báo, một bài viết đầy đủ, sổ tay sản phẩm, truyện, v.v. Lý do cho cách gọi này là từ là thực thể nhỏ và nguyên tử trong ngữ cảnh này. Vì vậy, để chỉ chuỗi từ dài, thuật ngữ tài liệu được dùng chung. Tweet nghĩa là tài liệu ngắn, còn bài báo là tài liệu dài.
Vậy, một tập huấn luyện gồm n tài liệu có nhãn trông như: (d1,c1), (d2,c2),...,(dn,cn) và đầu ra cuối cùng là một bộ phân loại đã học.
Bạn đang đi đúng hướng! Nhưng lúc này hẳn bạn có câu hỏi: đặc trưng của các tài liệu ở đâu? Câu hỏi rất chính đáng! Bạn sẽ gặp lại ngay sau đây.
Bây giờ, hãy tiếp tục với việc hình thành bài toán và từ từ xây dựng trực giác đằng sau phân loại cảm xúc.
Một điểm quan trọng cần nhớ khi làm phân tích cảm xúc là không phải tất cả từ trong một cụm từ đều truyền tải cảm xúc của cụm đó. Những từ như "Tôi", "Là", v.v. không giúp truyền đạt cảm xúc nên chúng không liên quan trong ngữ cảnh phân loại cảm xúc. Hãy coi đây là bài toán chọn đặc trưng. Trong chọn đặc trưng, bạn cố gắng tìm ra các đặc trưng liên quan nhất với nhãn lớp. Ý tưởng đó áp dụng ở đây. Do đó, chỉ một số ít từ trong cụm tham gia truyền tải cảm xúc; việc nhận diện và trích xuất chúng là những nhiệm vụ thách thức. Nhưng đừng lo, bạn sẽ đến phần đó.
Xem bài đánh giá phim sau để hiểu rõ hơn:
"Tôi yêu bộ phim này! Nó ngọt ngào, nhưng có sự hài hước trào phúng. Các đoạn hội thoại thì tuyệt và những cảnh phiêu lưu rất vui. Phim vừa lãng mạn vừa ngẫu hứng trong khi vẫn cười cợt vào các khuôn sáo của thể loại cổ tích. Tôi sẽ giới thiệu nó cho hầu như bất kỳ ai. Tôi đã xem vài lần và lúc nào cũng vui khi xem lại......."
Đúng vậy, đây chắc chắn là một bài đánh giá mang cảm xúc tích cực về một bộ phim cụ thể. Nhưng những từ cụ thể nào tạo nên sự tích cực này?
Hãy nhìn lại bài đánh giá.
"Tôi yêu bộ phim này! Nó ngọt ngào, nhưng có sự hài hước trào phúng. Các đoạn hội thoại thì tuyệt và những cảnh phiêu lưu rất vui. Phim vừa lãng mạn vừa ngẫu hứng trong khi vẫn cười cợt vào các khuôn sáo của thể loại cổ tích. Tôi sẽ giới thiệu nó cho hầu như bất kỳ ai. Tôi đã xem vài lần và lúc nào cũng vui khi xem lại......."
Giờ thì bạn đã thấy rõ. Những từ in đậm ở đoạn trên là những từ quan trọng nhất cấu thành bản chất tích cực của cảm xúc được truyền tải.
Làm gì với những từ này? Bước tiếp theo hợp lý là tạo một biểu diễn như sau:

Vậy biểu diễn trên làm gì? Chắc bạn đã đoán ra. Mỗi hàng chứa một từ và tần suất xuất hiện của nó trong tài liệu (từ giờ gọi là tài liệu). Bạn cũng có thể thắc mắc từ "yêu" chỉ xuất hiện một lần nhưng vì sao tần suất là 2? Đây chỉ là một phần của toàn bộ bài đánh giá. Hãy coi biểu diễn này là cho cả bài đánh giá.
Khi xây dựng phát biểu bài toán phân loại cảm xúc, bạn đã hiểu biểu diễn "Túi từ" và biểu diễn trên chính là một biểu diễn Bag-of-words. Đây có lẽ là khái niệm nền tảng nhất trong NLP và là bước đầu tiên khi giải bất kỳ bài toán phân loại văn bản nào. Vì vậy, hãy chắc chắn bạn nắm vững nó.
Một biểu diễn bag-of-words của tài liệu không chỉ chứa một số từ cụ thể mà là tất cả các từ duy nhất trong tài liệu và tần suất xuất hiện của chúng. Bag ở đây là một tập hợp theo nghĩa toán học, nên theo định nghĩa tập hợp, bag không chứa từ trùng lặp.
Nhưng cho ứng dụng này, bạn chỉ quan tâm đến các từ in đậm như đã nói, vì vậy bag-of-words cho tài liệu này sẽ chỉ chứa các từ đó.
Các tài liệu không được viết lộn xộn. Đúng chứ? Thứ tự từ trong tài liệu rất quan trọng. Nhưng trong bối cảnh phân loại cảm xúc, thứ tự không quá quan trọng. Điều quan trọng hơn, hay quan trọng nhất ở đây, là sự hiện diện của các từ đó.
Những từ bạn tìm thấy trong bag-of-words giờ sẽ tạo thành tập đặc trưng của tài liệu. Vậy, giả sử bạn có một tập hợp nhiều bài đánh giá phim (tài liệu), và bạn đã tạo bag-of-words cho mỗi bài và giữ lại nhãn của chúng (tức cảm xúc - tích cực hoặc tiêu cực trong trường hợp này). Tập huấn luyện của bạn sẽ trông như sau:

Biểu diễn này còn được gọi là Corpus.
Tập huấn luyện này khá dễ hiểu -
Mọi hàng là các vector đặc trưng độc lập chứa thông tin về một tài liệu cụ thể (đánh giá phim), các từ nhất định và cảm xúc của nó. Lưu ý, nhãn cảm xúc thường được ký hiệu là (+, -) hoặc (+ve, -ve). Ngoài ra, các đặc trưng w1, w2, w3, 34, ..., wn được sinh ra từ một túi từ, và không nhất thiết tất cả tài liệu đều chứa mỗi đặc trưng/từ này.
Bạn sẽ đưa các vector đặc trưng này vào bộ phân loại. Giờ hãy học tiếp - mô hình phân loại Naive Bayes cho phân loại cảm xúc.
Phân loại Naive Bayes thực chất là áp dụng quy tắc Bayes để tạo xác suất phân loại. Trong phần này, bạn sẽ học bộ phân loại Naive Bayes trong bối cảnh phân loại cảm xúc. Rất khuyến nghị bạn tìm hiểu nhập môn về Naive Bayes và quy tắc Bayes. Nguồn tham khảo:
Nhưng tại sao lại là Naive Bayes trong thế giới của k-NN, Cây quyết định và nhiều thuật toán khác? Bạn sẽ biết sau.
Trước hết, hãy xây dựng khái niệm các thuật ngữ chung trong bộ phân loại Naive Bayes theo bối cảnh phân loại cảm xúc. Bắt đầu bằng cách xem quy tắc Bayes:

Trong trường hợp này, lớp gồm hai cảm xúc: tích cực và tiêu cực.
Hãy phân tích từng hạng tử trong hình trên theo bối cảnh này.
Vậy Thông tin tiên nghiệm (Prior) và Khả năng (Likelihood) là gì? Còn P(d) (xác suất của một tài liệu); nghe vô lý? Câu hỏi rất hay! Cùng tìm câu trả lời!
Chưa phải là chi tiết tinh vi nhất! Nhưng hãy kiên nhẫn. Bạn sẽ khám phá thêm. Nhớ rằng bạn vẫn đang xây dựng trực giác để liên hệ quy tắc Bayes trong bối cảnh phân loại cảm xúc.
Hãy đi sâu hơn để xem chính xác quy tắc Bayes đang làm gì ở đây. Hình sau trình bày các bước chi tiết hơn của quy tắc Bayes:

Nhiều thuật ngữ lạ. Hãy từ từ.
Bắt đầu với cMAP ở vế phải. Nó biểu thị mục tiêu chính của quy tắc Bayes ở đây, tức tìm ước lượng hậu nghiệm cực đại về khả năng một tài liệu thuộc một lớp cụ thể. MAP là viết tắt của Max A Posteriori.
argmax là gì? Sao không dùng max!
argmax trả về chỉ mục. Giả sử P(+|d) > P(-|d), với + và - lần lượt là tích cực và tiêu cực. Các P(+|d), P(-|d) trả về xác suất dạng số. Nhưng bạn không quan tâm giá trị xác suất, bạn cần biết lớp nào có P cao hơn, và argmax trả về điều đó. Với P(+|d) > P(-|d), argmax sẽ trả về +.Và đúng vậy, bạn có thể bỏ mẫu số P(d). Tùy cách triển khai.
Nhưng làm sao tính $P(d|c)$ và $P(c)$? Đây chính là lúc bag of words phát huy tác dụng. Bằng cách nào?
Đọc tiếp!
Bạn đã biết cách chuyển một tài liệu thành biểu diễn bag-of-words. Quan trọng hơn, bạn có thể biểu diễn tài liệu như một tập đặc trưng. Vậy giờ, về cơ bản hạng tử cMAP có thể viết (bỏ qua mẫu số P(d)):

Nhưng tính các xác suất này như thế nào? Bắt đầu với $P(c)$ trước.
P(c) về cơ bản trả lời câu hỏi: "Lớp này xuất hiện thường xuyên thế nào?" Giả sử tập tài liệu của bạn chứa 60% cảm xúc tích cực và 40% tiêu cực. Vậy $P(+) = 0.6$ và $P(-) = 0.4$.
Giờ, bạn diễn giải P(x1, x2,...,xn | c) thế nào?
Nghĩ theo cách này - xác suất xuất hiện của những từ (đặc trưng) này khi biết lớp c là gì. Ví dụ, bạn có 1000 tài liệu, và trong corpus chỉ có hai từ - "good" và "awesome". Trong 1000 tài liệu đó, 500 tài liệu được gán nhãn tích cực, 500 còn lại tiêu cực. Bạn cũng thấy rằng trong 500 tài liệu tích cực, có 200 tài liệu chứa cả "good" và "awesome" (lưu ý P(x1,x2) nghĩa là P(x1 và x2)). Vậy xác suất P(good,awesome | +) = 200 / 1000 = 1/5.
Một điểm quan trọng: nếu kích thước vốn từ của bạn là $X$ thì bạn có thể xây dựng Xn xác suất likelihood (như P(good,awesome | +)) miễn là tài liệu của bạn có n từ.
Nhớ rằng bạn phải tính likelihood cho cả hai lớp. Vậy tổng số tổ hợp trong kịch bản có 2000 từ tất cả và mỗi tài liệu có trung bình 20 từ sẽ là (2000)20. Con số này cực kỳ lớn! Và nếu kích thước corpus lên đến hàng triệu (điều này xảy ra trong thực tế) thì sao?
Đây gọi là Bộ phân loại Bayes. Nhưng nó không khả thi vì số phép tính quá lớn. Bây giờ, bạn sẽ học một số giả định để biến bộ phân loại Bayes thành Naive Bayes.
Các giả định bạn sắp học gọi là Giả định độc lập của Naive Bayes. Cụ thể:
- Giả định bag-of-words: Giả sử vị trí không quan trọng. Giả sử một từ xuất hiện ở vị trí 10 và 20, nhưng theo giả định này, bạn chỉ quan tâm tần suất xuất hiện là 2. Hai số 10 và 12 là không liên quan.
- Giả định độc lập có điều kiện: Đây là giả định quan trọng khiến bộ phân loại Bayes trở thành Naive Bayes. Nó phát biểu rằng "giả sử các xác suất đặc trưng P(xi|cj)". Xem kỹ phát biểu. Nghĩa là P(x1|cj), P(x2|cj)... độc lập với nhau. (Điều này không có nghĩa P(x1), P(x2)... độc lập với nhau). Khi đó, P(x1, x2,...,xn | c) có thể biểu diễn như sau: 
Vì vậy, một cách tự nhiên, số tổ hợp Xn giảm xuống còn Xn, nhỏ đi theo hàm mũ (nếu vốn từ là $X$ và tài liệu chứa n từ). Viết toán học, bộ phân loại Bayes khi rút gọn thành Naive Bayes sẽ như sau:

Naive Bayes có hai ưu điểm:
Khi cơ chế phân loại Naive Bayes được áp dụng cho bài toán phân loại văn bản, nó được gọi là "Multinomial Naive Bayes".
Giờ bạn đã khá vững về cơ chế của bộ phân loại Naive Bayes, đặc biệt cho bài toán phân loại cảm xúc. Đã đến lúc triển khai một bộ phân loại cảm xúc.
Bạn sẽ làm điều đó bằng Python! Bắt đầu với nghiên cứu tình huống.
Trong nghiên cứu tình huống này, bạn sẽ dùng một corpus đánh giá phim ngoại tuyến như trong sách NLTK và có thể tải từ đây. nltk cung cấp một phiên bản của bộ dữ liệu. Bộ dữ liệu phân loại mỗi bài đánh giá là tích cực hoặc tiêu cực. Trước tiên bạn cần tải về như sau:
python -m nltk.downloader all
Không khuyến nghị chạy từ Jupyter Notebook. Hãy chạy từ command prompt (nếu dùng Windows). Sẽ mất chút thời gian. Hãy kiên nhẫn.
Để biết thêm về các bộ dữ liệu NLTK, hãy truy cập liên kết này.
Bạn sẽ triển khai Naive Bayes hay nói cụ thể là Multinomial Naive Bayes bằng NLTK (Natural Language Toolkit). Đây là thư viện dành cho các tác vụ liên quan NLP và NLU, với tài liệu rất tốt. Nó bao phủ nhiều kỹ thuật và cung cấp miễn phí dữ liệu để thực nghiệm.
Đây là trang chính thức của NLTK. Hãy xem qua vì có nhiều hướng dẫn NLP được viết rất hay, bao quát các khái niệm khác nhau.
Sau khi tải xong dữ liệu, bạn sẽ bắt đầu bằng cách import bộ dữ liệu đánh giá phim với from nltk.corpus import movie_reviews. Sau đó, bạn sẽ tạo danh sách tài liệu, gắn nhãn với danh mục phù hợp.
# Load and prepare the dataset
import nltk
from nltk.corpus import movie_reviews
import random

documents = [(list(movie_reviews.words(fileid)), category)
              for category in movie_reviews.categories()
              for fileid in movie_reviews.fileids(category)]

random.shuffle(documents)
Tiếp theo, bạn sẽ định nghĩa một bộ trích xuất đặc trưng cho tài liệu, để bộ phân loại biết cần chú ý đến khía cạnh nào của dữ liệu. "Trong trường hợp này, bạn có thể định nghĩa một đặc trưng cho mỗi từ, biểu thị việc tài liệu có chứa từ đó hay không. Để giới hạn số đặc trưng mà bộ phân loại cần xử lý, bạn bắt đầu bằng cách tạo danh sách 2000 từ xuất hiện thường xuyên nhất trong toàn bộ corpus" Nguồn. Sau đó bạn có thể định nghĩa một bộ trích xuất đặc trưng chỉ đơn giản là kiểm tra xem mỗi từ này có xuất hiện trong tài liệu cho trước hay không.
# Define the feature extractor

all_words = nltk.FreqDist(w.lower() for w in movie_reviews.words())
word_features = list(all_words)[:2000]

def document_features(document):
    document_words = set(document)
    features = {}
    for word in word_features:
        features['contains({})'.format(word)] = (word in document_words)
    return features
"Lý do bạn tạo tập tất cả từ trong một tài liệu document_words = set(document) thay vì chỉ kiểm tra từ có trong tài liệu hay không là vì việc kiểm tra một từ có trong một set nhanh hơn nhiều so với kiểm tra trong một list" - Nguồn.
Bạn đã định nghĩa bộ trích xuất đặc trưng. Giờ bạn có thể dùng nó để huấn luyện một bộ phân loại Naive Bayes nhằm dự đoán cảm xúc của các bài đánh giá phim mới. Để kiểm tra hiệu năng, bạn sẽ tính độ chính xác trên tập kiểm tra. NLTK cung cấp show_most_informative_features() để xem các đặc trưng mà bộ phân loại cho là giàu thông tin nhất.
# Train Naive Bayes classifier
featuresets = [(document_features(d), c) for (d,c) in documents]
train_set, test_set = featuresets[100:], featuresets[:100]
classifier = nltk.NaiveBayesClassifier.train(train_set)
# Test the classifier
print(nltk.classify.accuracy(classifier, test_set))
0.71
Wow! Bộ phân loại đạt độ chính xác 71% mà không cần tinh chỉnh tham số nào. Khởi đầu như vậy là rất ổn!
# Show the most important features as interpreted by Naive Bayes
classifier.show_most_informative_features(5)
Most Informative Features
       contains(winslet) = True              pos : neg    =      8.4 : 1.0
     contains(illogical) = True              neg : pos    =      7.6 : 1.0
      contains(captures) = True              pos : neg    =      7.0 : 1.0
        contains(turkey) = True              neg : pos    =      6.5 : 1.0
        contains(doubts) = True              pos : neg    =      5.8 : 1.0
"Trong bộ dữ liệu, một bài đánh giá nhắc đến "Illogical" có khả năng gần 8 lần cao hơn là tiêu cực so với tích cực, trong khi một bài nhắc đến "Captures" có khả năng khoảng 6 lần cao hơn là tích cực" - Nguồn.
Giờ đến câu hỏi - vì sao là Naive Bayes?
Hạn chế chính của Naive Bayes là giả định các biến dự báo độc lập. Trong thực tế, gần như không thể có một tập biến dự báo hoàn toàn độc lập.
Phân tích cảm xúc giải quyết nhiều bài toán kinh doanh thực sự:
Chúc mừng! Bạn đã đi đến cuối. NLP là một chủ đề rất rộng và thú vị, giải quyết nhiều vấn đề thách thức. Đặc biệt, giao thoa giữa NLP và Học sâu đã khai sinh nhiều sản phẩm tuyệt vời. Nó đã cách mạng hóa cách chatbot tương tác. Danh sách này là vô tận.
Hy vọng hướng dẫn này cho bạn một khởi đầu trong một phân ngành quan trọng của NLP, tức Phân tích Cảm xúc. Bạn đã tìm hiểu một trong những chủ đề nền tảng nhất của NLP - Bag of Words và sau đó nghiên cứu chi tiết Naive Bayes Classifier. Bạn cũng xem xét những điểm yếu của nó. Bạn dùng nltk, một trong những thư viện Python phổ biến nhất cho các tác vụ NLP và NLU. Bạn đã triển khai một bộ phân loại Naive Bayes đơn giản với corpus phim mà nltk cung cấp. Tự thưởng cho mình một tràng pháo tay. Bạn xứng đáng!
Dưới đây là một số liên kết tài nguyên tuyệt vời nếu bạn muốn đi xa hơn từ khởi đầu khiêm tốn này:
Các tài liệu tham khảo sau đã được dùng để tạo hướng dẫn này:
Nếu bạn quan tâm học các kiến thức cơ bản về NLP và áp dụng vào bộ dữ liệu thực tế, bạn có thể học khóa "Những điều cơ bản về Xử lý Ngôn ngữ Tự nhiên trong Python" của DataCamp.
Các khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
