Gần đây tôi vừa hoàn thành một hợp đồng với một công ty AI. Ngoài nhiều việc khác, họ hỗ trợ các nhà nghiên cứu hậu huấn luyện LLM. Là một tiến sĩ Toán học, tôi đã tạo ra các đề bài toán học có thể làm khó các mô hình AI tuyến đầu. Những đề mẹo đánh đố thì không được tính; đề phải phơi bày lỗi suy luận.
Trong quá trình đó, tôi nghe nhắc đi nhắc lại về "Humanity’s Last Exam". Tôi biết rằng đó là một thước đo AI được thiết kế để kiểm tra suy luận ở nhiều lĩnh vực học thuật. Sự tò mò khiến tôi tìm hiểu sâu hơn HLE là gì và nó nói gì về những giới hạn hiện tại của suy luận AI.
Nếu bạn mới làm quen với AI và các thước đo đánh giá, tôi khuyến nghị theo học lộ trình kỹ năng AI Fundamentals.
“Humanity’s Last Exam” là gì?
Khi các LLM phát triển, các nhà nghiên cứu dựa vào tập hợp các câu hỏi đánh giá, gọi là benchmarks, để so sánh hiệu năng và theo dõi tiến bộ. Humanity's Last Exam (HLE) là một thước đo được thiết kế để đo lường năng lực suy luận của LLM, không chỉ là khả năng khớp mẫu. Nó hướng tới đánh giá mức độ một mô hình xử lý các bài toán cấp chuyên gia trên nhiều lĩnh vực học thuật.
Vì sao chúng ta cần một “Kỳ thi cuối cùng”?
Với rất nhiều thước đo đã tồn tại, tại sao lại cần thêm một cái nữa? Những thước đo từng làm khó LLM, như MMLU, nay đã bão hòa, các mô hình thường đạt trên 90%. Ở thời điểm này, các thước đo đó không còn đo được khác biệt có ý nghĩa giữa các mô hình nữa.
HLE là thước đo thế hệ mới, nâng độ khó bằng cách tập hợp các câu hỏi do chuyên gia biên soạn đòi hỏi suy luận nhiều bước, không chỉ đơn thuần là nhớ lại dựa trên khớp mẫu bề mặt.
HLE được xây dựng như thế nào?
Cuối năm 2024, Trung tâm An toàn AI (Centre for AI Safety), một tổ chức phi lợi nhuận về an toàn AI, đã hợp tác với Scale AI, một công ty dữ liệu, để phát triển một thước đo AI khó hơn. Dan Hendrycks dẫn dắt dự án.
Nhóm đã huy động cộng đồng đóng góp các câu hỏi trình độ sau đại học từ nhiều ngành học và đưa ra giải thưởng đáng kể: 50 người đóng góp đứng đầu mỗi người nhận 5.000 USD, và 500 người tiếp theo nhận 500 USD.
Kết quả là một kho câu hỏi cấp chuyên gia lớn trên nhiều môn, như toán học, khoa học máy tính, văn học, phân tích âm nhạc và lịch sử.
Humanity's Last Exam bao gồm những gì?
Bài báo về HLE mô tả thước đo này là "...thước đo đóng có đáp án cuối cùng cho kỹ năng học thuật rộng." Các câu hỏi yêu cầu suy luận nhiều bước, giúp ngăn mô hình đoán mò hay ghi nhớ đáp án.
HLE gồm 2.500 câu hỏi công khai và khoảng 500 câu hỏi bổ sung trong bộ giữ lại riêng tư.
Mỗi câu hỏi phải nguyên gốc, có một đáp án đúng duy nhất và không dễ dàng bị tìm ra bằng một tra cứu web hay cơ sở dữ liệu đơn giản. Khoảng 76% câu hỏi dùng định dạng câu trả lời khớp chính xác, 24% còn lại là trắc nghiệm. Xấp xỉ 14% câu hỏi là đa phương thức, gồm cả văn bản và hình ảnh.
Nhóm HLE áp dụng quy trình thẩm định nghiêm ngặt cho các câu hỏi.
- Để được chấp nhận, câu hỏi phải làm khó một LLM tuyến đầu. Khoảng bảy mươi nghìn câu hỏi đáp ứng tiêu chí này.
- Các phản biện chuyên gia đã tinh chỉnh và lọc xuống còn mười ba nghìn câu hỏi.
- Ban tổ chức và phản biện chuyên gia phê duyệt thủ công sáu nghìn câu hỏi trong số đó.
- Các nhà nghiên cứu chia kho câu hỏi này thành bộ công khai gồm 2.500 câu và bộ giữ lại khoảng 500 câu.
Những phê bình về Humanity’s Last Exam
Kết quả ban đầu cho thấy các mô hình tuyến đầu đạt điểm thấp với các câu hỏi, nhưng lại thể hiện mức tự tin cao. Khoảng cách này cho thấy hiện tượng ảo giác.
Các nhóm độc lập cũng nêu quan ngại. Future House, một phòng thí nghiệm nghiên cứu phi lợi nhuận, đã đăng một blog, "Khoảng 30% câu trả lời hóa học/sinh học của Humanity’s Last Exam có khả năng sai."
Phân tích của họ tập trung vào quy trình phản biện. Người ra đề đưa ra đáp án đúng, nhưng người phản biện chỉ được chỉ dẫn dành năm phút để kiểm tra tính đúng đắn của đáp án. Họ cho rằng quy trình này khiến các đáp án quá phức tạp, gượng ép hoặc mơ hồ lọt qua, thường mâu thuẫn với tài liệu khoa học.
Những người duy trì HLE đã phản hồi bằng cách ủy nhiệm một đợt phản biện ba chuyên gia cho tập con bị tranh cãi. Tính đến ngày 16 tháng 9 năm 2025, họ dự kiến công bố quy trình rà soát cuốn chiếu cho HLE.
Bức tranh các thước đo AI
HLE nằm trong một hệ sinh thái rộng các thước đo kiểm tra những khía cạnh khác nhau của năng lực LLM.
Kiến thức và suy luận
Các thước đo này đánh giá kiến thức học thuật và suy luận.
- Massive Multitask Language Understanding (MMLU). MMLU kiểm tra hiệu năng zero-shot trên 57 môn khác nhau.
- MMLU-Pro/MMLU Pro+. Tăng độ phức tạp của câu hỏi và tập trung vào suy luận bậc cao.
- Google Proof Q&A (GPQA) Một thước đo STEM trình độ sau đại học chống tra Google với 448 câu hỏi trắc nghiệm.
- Humanity's Last Exam (HLE). HLE dùng các bài toán do chuyên gia tuyển chọn, nhấn mạnh suy luận hơn là ghi nhớ.
Hiểu biết đa phương thức
Các thước đo này đo lường suy luận liên quan cả văn bản và hình ảnh.
Kỹ thuật phần mềm và sử dụng công cụ
Những thước đo khác tập trung riêng vào kỹ thuật phần mềm và sử dụng công cụ.
- SWE-bench. Xây dựng từ các issue GitHub thực tế của mười hai kho Python. Mô hình đọc mã nguồn, diễn giải mô tả vấn đề và đề xuất bản vá.
- SWE-bench Verified. Phiên bản cải tiến của SWE-bench khắc phục các kiểm thử quá đặc thù, làm rõ mô tả vấn đề mơ hồ và ổn định thiết lập môi trường.
- SWE-bench-Live. Phiên bản có thể mở rộng, cập nhật liên tục với 1319 tác vụ trên 93 kho.
Khung đánh giá tổng thể, đa chỉ số
Trung tâm Nghiên cứu về Mô hình Nền tảng (CRFM) của Stanford phát triển Holistic Evaluation of Language Models (HELM) để hỗ trợ đánh giá AI có trách nhiệm.
HELM đánh giá các mô hình trên một loạt kịch bản chuẩn hóa, như hỏi đáp, tóm tắt, truy vấn quan trọng về an toàn và nội dung xã hội/đạo đức. Các kịch bản này được chấm theo nhiều chiều, không chỉ độ chính xác mà còn hiệu chuẩn, độ bền vững và độc hại.
HELM đã phát triển thành một họ khung liên quan.
- HEML Capabilities. Bảng xếp hạng mục đích chung để đánh giá LM.
- Audio. Đánh giá cho các tác vụ liên quan âm thanh và giọng nói.
- HELM Lite. Tập con nhỏ hơn, nhanh hơn để so sánh nhanh.
- HELM Finance. HELM điều chỉnh cho các tác vụ tài chính.
- MedHELM. Đánh giá cho suy luận và an toàn liên quan y tế.
Đánh giá an toàn và năng lực nguy hiểm
Các khung an toàn đo lường rủi ro hơn là năng lực trí tuệ.
- Model Evaluation & Threat Research (METR) là một tổ chức nghiên cứu phi lợi nhuận đánh giá các năng lực tiềm ẩn nguy hiểm, như tấn công mạng, cố gắng né tắt/bị tắt, hoặc khả năng tự động hóa R&D AI. Sứ mệnh của họ là phát hiện sớm các rủi ro thảm họa.
- Khung An toàn Frontier của Google DeepMind. Xác định các mức năng lực trọng yếu (CCL), theo dõi liệu các mô hình tuyến đầu có tiến gần chúng hay không và triển khai kế hoạch giảm thiểu khi có.
Các mô hình AI hiện tại đạt điểm thế nào trên các thước đo?
Nhiều bảng xếp hạng công khai theo dõi hiệu năng LLM trên nhiều chỉ số.
Bảng xếp hạng
Dưới đây là một số điểm số tính đến thời điểm viết bài vào tháng 12 năm 2025.
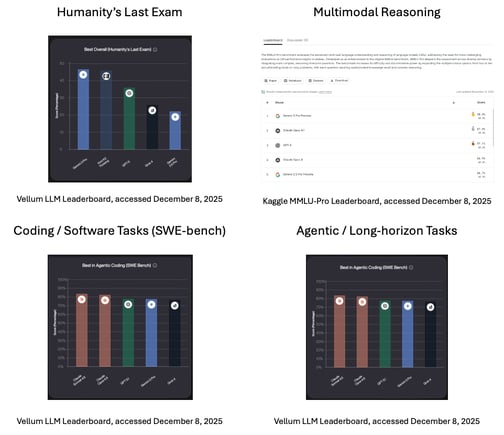
- Humanity's Last Exam. Theo bảng xếp hạng Vellum, dẫn đầu hiện tại (tính đến lúc viết) là Gemini 3 Pro, mô hình AI đa phương thức sinh tổng quát chủ lực của Google.
- Suy luận đa phương thức. Gemini 3 Pro, được thiết kế để hợp nhất các phương thức trong một hệ thống, dẫn đầu về suy luận đa phương thức theo bảng xếp hạng Kaggle MMLU-Pro.
- Lập trình / Tác vụ phần mềm (SWE-bench). Claude Sonnet 4.5 của Anthropic, ưu tiên suy luận cẩn trọng, đứng đầu ở lập trình và tác vụ phần mềm thực tế theo bảng xếp hạng Vellum.
- Tác vụ đại lý / tầm xa. Claude Sonnet 4.5 cũng dẫn đầu ở các tác vụ mang tính đại lý và tầm xa theo bảng xếp hạng Vellum.
An toàn/năng lực nguy hiểm
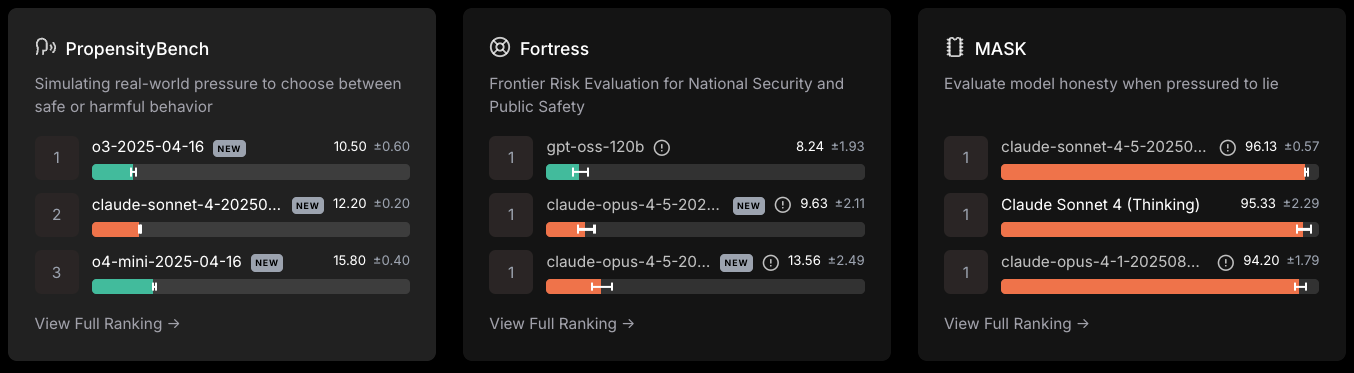
Scale LLM Safety Leaderboard, truy cập ngày 8 tháng 12, 2025
- o3-2024-04-18 của OpenAI dẫn đầu ở PropensityBench, thước đo lựa chọn giữa hành vi an toàn hoặc gây hại.
- GPT-oss-120b dẫn đầu ở Đánh giá Rủi ro Tuyến đầu cho An ninh Quốc gia và An toàn Công cộng.
- Claude Sonnet-4.5 chống chịu áp lực nói dối tốt nhất.
Cách sử dụng Humanity’s Last Exam
Đến đây, tôi đã phác thảo HLE là gì và nó được phát triển ra sao. Giờ hãy xem bài kiểm tra này được dùng như thế nào trên thực tế.
Đối với các nhóm nghiên cứu
HLE cung cấp phương pháp đánh giá tiêu chuẩn hóa trên các lĩnh vực. Nó làm nổi bật điểm mạnh và điểm yếu của mô hình. Nó cho thấy khoảng cách giữa mô hình và hiệu suất của chuyên gia con người. Các nhóm có thể dùng các mẫu hình này để định hướng phát triển mô hình và hậu huấn luyện tập trung.
Đối với nhà hoạch định chính sách
HLE cung cấp một chỉ số công khai, toàn cầu về tiến bộ suy luận của AI. Nó tạo điểm tham chiếu chung giữa các quốc gia và cơ quan quản lý, có thể neo thảo luận về ngưỡng, giám sát và quản trị vào thực tế, không phải thổi phồng.
Kết luận
Các thước đo AI định hình cách chúng ta đo lường tiến bộ AI. Khi các thước đo trước đây đã bão hòa, nhu cầu về một thước đo mới, tập trung vào suy luận chứ không chỉ ghi nhớ hay khớp mẫu, trở nên rõ ràng.
Humanity's Last Exam cố gắng lấp khoảng trống đó bằng cách huy động cộng đồng chuyên gia toàn cầu đóng góp các câu hỏi trình độ sau đại học để phơi bày những hạn chế của LLM. Đây không phải là lời phán quyết cuối cùng, nhưng nó làm rõ vị thế hiện tại của AI so với suy luận của chuyên gia con người.
Để biết thêm về LLM và cách chúng hoạt động, tôi khuyến nghị các tài nguyên sau:


Gần đây tôi vừa hoàn thành một hợp đồng với một công ty AI. Ngoài nhiều việc khác, họ hỗ trợ các nhà nghiên cứu hậu huấn luyện LLM. Là một tiến sĩ Toán học, tôi đã tạo ra các đề bài toán học có thể làm khó các mô hình AI tuyến đầu. Những đề mẹo đánh đố thì không được tính; đề phải phơi bày lỗi suy luận.
Trong quá trình đó, tôi nghe nhắc đi nhắc lại về "Humanity’s Last Exam". Tôi biết rằng đó là một thước đo AI được thiết kế để kiểm tra suy luận ở nhiều lĩnh vực học thuật. Sự tò mò khiến tôi tìm hiểu sâu hơn HLE là gì và nó nói gì về những giới hạn hiện tại của suy luận AI.
Nếu bạn mới làm quen với AI và các thước đo đánh giá, tôi khuyến nghị theo học lộ trình kỹ năng AI Fundamentals.
“Humanity’s Last Exam” là gì?
Khi các LLM phát triển, các nhà nghiên cứu dựa vào tập hợp các câu hỏi đánh giá, gọi là benchmarks, để so sánh hiệu năng và theo dõi tiến bộ. Humanity's Last Exam (HLE) là một thước đo được thiết kế để đo lường năng lực suy luận của LLM, không chỉ là khả năng khớp mẫu. Nó hướng tới đánh giá mức độ một mô hình xử lý các bài toán cấp chuyên gia trên nhiều lĩnh vực học thuật.
Vì sao chúng ta cần một “Kỳ thi cuối cùng”?
Với rất nhiều thước đo đã tồn tại, tại sao lại cần thêm một cái nữa? Những thước đo từng làm khó LLM, như MMLU, nay đã bão hòa, các mô hình thường đạt trên 90%. Ở thời điểm này, các thước đo đó không còn đo được khác biệt có ý nghĩa giữa các mô hình nữa.
HLE là thước đo thế hệ mới, nâng độ khó bằng cách tập hợp các câu hỏi do chuyên gia biên soạn đòi hỏi suy luận nhiều bước, không chỉ đơn thuần là nhớ lại dựa trên khớp mẫu bề mặt.
HLE được xây dựng như thế nào?
Cuối năm 2024, Trung tâm An toàn AI (Centre for AI Safety), một tổ chức phi lợi nhuận về an toàn AI, đã hợp tác với Scale AI, một công ty dữ liệu, để phát triển một thước đo AI khó hơn. Dan Hendrycks dẫn dắt dự án.
Nhóm đã huy động cộng đồng đóng góp các câu hỏi trình độ sau đại học từ nhiều ngành học và đưa ra giải thưởng đáng kể: 50 người đóng góp đứng đầu mỗi người nhận 5.000 USD, và 500 người tiếp theo nhận 500 USD.
Kết quả là một kho câu hỏi cấp chuyên gia lớn trên nhiều môn, như toán học, khoa học máy tính, văn học, phân tích âm nhạc và lịch sử.
Humanity's Last Exam bao gồm những gì?
Bài báo về HLE mô tả thước đo này là "...thước đo đóng có đáp án cuối cùng cho kỹ năng học thuật rộng." Các câu hỏi yêu cầu suy luận nhiều bước, giúp ngăn mô hình đoán mò hay ghi nhớ đáp án.
HLE gồm 2.500 câu hỏi công khai và khoảng 500 câu hỏi bổ sung trong bộ giữ lại riêng tư.
Mỗi câu hỏi phải nguyên gốc, có một đáp án đúng duy nhất và không dễ dàng bị tìm ra bằng một tra cứu web hay cơ sở dữ liệu đơn giản. Khoảng 76% câu hỏi dùng định dạng câu trả lời khớp chính xác, 24% còn lại là trắc nghiệm. Xấp xỉ 14% câu hỏi là đa phương thức, gồm cả văn bản và hình ảnh.
Nhóm HLE áp dụng quy trình thẩm định nghiêm ngặt cho các câu hỏi.
Những phê bình về Humanity’s Last Exam
Kết quả ban đầu cho thấy các mô hình tuyến đầu đạt điểm thấp với các câu hỏi, nhưng lại thể hiện mức tự tin cao. Khoảng cách này cho thấy hiện tượng ảo giác.
Các nhóm độc lập cũng nêu quan ngại. Future House, một phòng thí nghiệm nghiên cứu phi lợi nhuận, đã đăng một blog, "Khoảng 30% câu trả lời hóa học/sinh học của Humanity’s Last Exam có khả năng sai."
Phân tích của họ tập trung vào quy trình phản biện. Người ra đề đưa ra đáp án đúng, nhưng người phản biện chỉ được chỉ dẫn dành năm phút để kiểm tra tính đúng đắn của đáp án. Họ cho rằng quy trình này khiến các đáp án quá phức tạp, gượng ép hoặc mơ hồ lọt qua, thường mâu thuẫn với tài liệu khoa học.
Những người duy trì HLE đã phản hồi bằng cách ủy nhiệm một đợt phản biện ba chuyên gia cho tập con bị tranh cãi. Tính đến ngày 16 tháng 9 năm 2025, họ dự kiến công bố quy trình rà soát cuốn chiếu cho HLE.
Bức tranh các thước đo AI
HLE nằm trong một hệ sinh thái rộng các thước đo kiểm tra những khía cạnh khác nhau của năng lực LLM.
Kiến thức và suy luận
Các thước đo này đánh giá kiến thức học thuật và suy luận.
Hiểu biết đa phương thức
Các thước đo này đo lường suy luận liên quan cả văn bản và hình ảnh.
Kỹ thuật phần mềm và sử dụng công cụ
Những thước đo khác tập trung riêng vào kỹ thuật phần mềm và sử dụng công cụ.
Khung đánh giá tổng thể, đa chỉ số
Trung tâm Nghiên cứu về Mô hình Nền tảng (CRFM) của Stanford phát triển Holistic Evaluation of Language Models (HELM) để hỗ trợ đánh giá AI có trách nhiệm.
HELM đánh giá các mô hình trên một loạt kịch bản chuẩn hóa, như hỏi đáp, tóm tắt, truy vấn quan trọng về an toàn và nội dung xã hội/đạo đức. Các kịch bản này được chấm theo nhiều chiều, không chỉ độ chính xác mà còn hiệu chuẩn, độ bền vững và độc hại.
HELM đã phát triển thành một họ khung liên quan.
Đánh giá an toàn và năng lực nguy hiểm
Các khung an toàn đo lường rủi ro hơn là năng lực trí tuệ.
Các mô hình AI hiện tại đạt điểm thế nào trên các thước đo?
Nhiều bảng xếp hạng công khai theo dõi hiệu năng LLM trên nhiều chỉ số.
Bảng xếp hạng
Dưới đây là một số điểm số tính đến thời điểm viết bài vào tháng 12 năm 2025.
An toàn/năng lực nguy hiểm
Scale LLM Safety Leaderboard, truy cập ngày 8 tháng 12, 2025
Cách sử dụng Humanity’s Last Exam
Đến đây, tôi đã phác thảo HLE là gì và nó được phát triển ra sao. Giờ hãy xem bài kiểm tra này được dùng như thế nào trên thực tế.
Đối với các nhóm nghiên cứu
HLE cung cấp phương pháp đánh giá tiêu chuẩn hóa trên các lĩnh vực. Nó làm nổi bật điểm mạnh và điểm yếu của mô hình. Nó cho thấy khoảng cách giữa mô hình và hiệu suất của chuyên gia con người. Các nhóm có thể dùng các mẫu hình này để định hướng phát triển mô hình và hậu huấn luyện tập trung.
Đối với nhà hoạch định chính sách
HLE cung cấp một chỉ số công khai, toàn cầu về tiến bộ suy luận của AI. Nó tạo điểm tham chiếu chung giữa các quốc gia và cơ quan quản lý, có thể neo thảo luận về ngưỡng, giám sát và quản trị vào thực tế, không phải thổi phồng.
Kết luận
Các thước đo AI định hình cách chúng ta đo lường tiến bộ AI. Khi các thước đo trước đây đã bão hòa, nhu cầu về một thước đo mới, tập trung vào suy luận chứ không chỉ ghi nhớ hay khớp mẫu, trở nên rõ ràng.
Humanity's Last Exam cố gắng lấp khoảng trống đó bằng cách huy động cộng đồng chuyên gia toàn cầu đóng góp các câu hỏi trình độ sau đại học để phơi bày những hạn chế của LLM. Đây không phải là lời phán quyết cuối cùng, nhưng nó làm rõ vị thế hiện tại của AI so với suy luận của chuyên gia con người.
Để biết thêm về LLM và cách chúng hoạt động, tôi khuyến nghị các tài nguyên sau: