Bức tranh AI giữa năm 2026 đang chật kín các mô hình tiên phong kiểu đơn khối cạnh tranh bằng điểm benchmark thô. Sakana AI chọn một hướng khác: thay vì huấn luyện một mô hình nền tảng lớn hơn, họ ra mắt Fugu, một hệ thống điều phối một nhóm các mô hình tiên phong hiện có phía sau một API tương thích với OpenAI duy nhất.
Tuyên bố nổi bật là Sakana Fugu Ultra sánh ngang với Fable 5 và Mythos Preview của Anthropic trên các benchmark về kỹ thuật, khoa học và suy luận, mà không cần truy cập vào hai mô hình bị kiểm soát xuất khẩu đó.
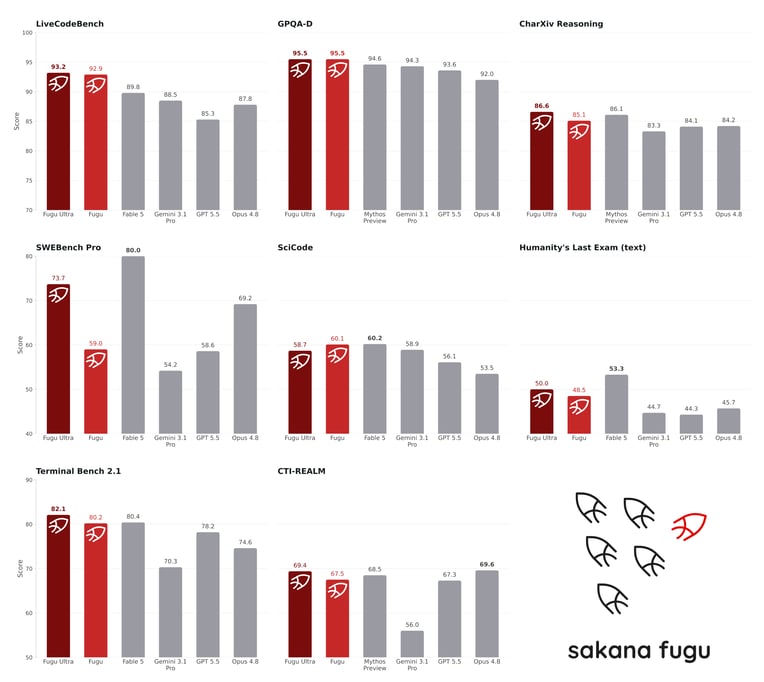
Sakana Fugu ra mắt ngày 22 tháng 6 năm 2026 với hai biến thể: Fugu cho công việc thường nhật nhạy độ trễ, và Fugu Ultra cho các tác vụ phức tạp, nhiều bước. Trên SWE-Bench Pro, Fugu Ultra đạt 73,7%, vượt Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%), và Gemini 3.1 Pro (54,2%).
Mọi con số benchmark đều do Sakana báo cáo và hiện chưa được các phòng thí nghiệm bên thứ ba tái lập độc lập, điều này cần lưu ý khi bạn đọc.
Trong bài này, tôi sẽ trình bày Fugu thực chất là gì, điểm qua các tính năng chính, xem bảng benchmark đầy đủ, và một số trường hợp sử dụng. Bạn cũng có thể xem so sánh của chúng tôi về GPT-5.5 vs Gemini 3.1 Pro để có ngữ cảnh về các mô hình mà Fugu đang cạnh tranh.
Sakana Fugu là gì?
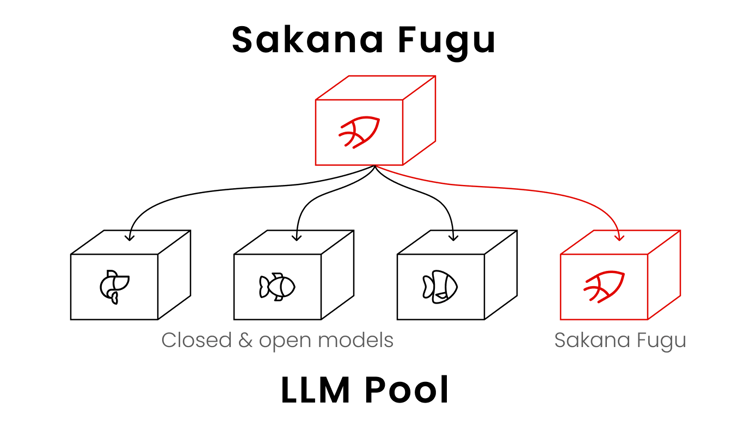
Sakana Fugu là một mô hình ngôn ngữ được huấn luyện để đóng vai trò bộ điều phối: nhận yêu cầu, quyết định tự xử lý hay ủy quyền cho các mô hình chuyên biệt trong nhóm agent, quản lý kiểm chứng và tổng hợp, rồi trả về một phản hồi duy nhất. Từ bên ngoài, bạn chỉ gọi một endpoint. Bên trong, một tập hợp mô hình phối hợp thực hiện công việc.
Sakana AI xây dựng hướng tới kiến trúc này từ khi thành lập. Phòng lab do Llion Jones (đồng tác giả bài "Attention Is All You Need" gốc) và David Ha sáng lập từ lâu đã lập luận rằng các hệ sinh thái mô hình phối hợp vượt trội các mô hình đơn khối biệt lập trên những tác vụ khó, chạy dài.
Fugu là phiên bản sản phẩm hóa của luận điểm đó, dựa trên hai bài báo ICLR 2026: TRINITY (một điều phối viên LLM tiến hóa) và Conductor (học cách điều phối agent bằng ngôn ngữ tự nhiên).
Tại thời điểm viết, Fable 5 và Mythos Preview của Anthropic chưa thể truy cập công khai do kiểm soát xuất khẩu, đồng nghĩa chúng không thể nằm trong nhóm agent của Fugu.
Lập luận của Sakana là định tuyến qua một nhóm mô hình có thể hoán đổi mang lại phương án phòng ngừa thực tiễn trước đúng kiểu gián đoạn truy cập này. Liệu điều đó cấu thành "chủ quyền AI" thực sự hay không còn tranh cãi, nhưng logic vận hành thì vững: nếu một nhà cung cấp hạn chế truy cập, Fugu sẽ định tuyến vòng qua.
Nguồn
Sakana Fugu có gì mới?
Fugu giới thiệu một số ý tưởng phân biệt với cả các mô hình tiên phong thông thường và khung đa-agent truyền thống. Tôi đã nêu những điểm chính dưới đây.
Điều phối học được, không phải pipeline cố định
Hầu hết hệ thống đa-agent yêu cầu nhà phát triển xác định mô hình nào xử lý tác vụ nào. Fugu thì học điều này. Mô hình điều phối được huấn luyện để quyết định khi nào nên ủy quyền, các agent nên trao đổi thế nào, và cách kết hợp đầu ra của họ thành một câu trả lời. Đây là đóng góp cốt lõi từ nghiên cứu TRINITY và Conductor mà tôi đã dẫn ở trên.
Trong thực tế, điều này có nghĩa là độ phức tạp của hệ đa-agent không bao giờ chạm vào code của bạn. Bạn gửi yêu cầu tới một endpoint, và Fugu xử lý việc chọn mô hình, ủy quyền, kiểm chứng, và tổng hợp ở bên trong. Với các đội đã từng cố xây lớp điều phối riêng, sức hấp dẫn rất rõ: bạn nhận được lợi ích phối hợp mà không phải duy trì bộ khung.
Một lưu ý cần nêu: các quyết định định tuyến là độc quyền và không lộ ra cho người dùng. Bạn không thể thấy mô hình nền nào đã xử lý yêu cầu. Với công việc nhạy tuân thủ nơi bạn cần kiểm toán chuỗi suy luận, sự mờ đục này là một hạn chế thực sự.
Nhóm agent có thể hoán đổi
Các mô hình trong nhóm của Fugu không cố định. Khi một mô hình tiên phong mới khả dụng công khai, Sakana dự kiến mất khoảng hai tuần để huấn luyện và đánh giá các phiên bản Fugu cập nhật trước khi triển khai. Điều này nghĩa là hiệu năng của Fugu sẽ cải thiện cùng hệ sinh thái nền tảng, mà người dùng không cần thay đổi tích hợp.
Với Fugu tiêu chuẩn, người dùng cũng có thể loại trừ một số agent khỏi nhóm trong phần cài đặt bảng điều khiển, điều này quan trọng với các đội có yêu cầu về quyền riêng tư dữ liệu hoặc tuân thủ. Nhóm của Fugu Ultra là cố định vì nó dựa vào tập đầy đủ agent để đạt hiệu năng benchmark.
Thiết kế mô hình hai tầng
Fugu và Fugu Ultra phục vụ các loại tải công việc khác nhau. Fugu cân bằng chất lượng với độ trễ thấp, là lựa chọn hợp lý mặc định cho lập trình, rà soát mã, và dịch vụ tương tác. Fugu Ultra điều phối một nhóm sâu hơn các agent chuyên gia và được tinh chỉnh để đạt chất lượng trả lời tối đa trên các bài toán khó, nhiều bước.
Người dùng sớm chọn Fugu Ultra cho các tác vụ như tái lập bài báo, phân tích an ninh mạng, khoa học dữ liệu kiểu Kaggle, và điều tra bằng sáng chế.
Một kỹ sư phần mềm trong giai đoạn beta báo cáo rằng Fugu Ultra phát hiện hơn hai mươi vấn đề rà soát mã, trong khi các công cụ khác chỉ nêu khoảng ba.
Một kỹ sư an ninh mạng cho biết một chỉ dẫn giới hạn phạm vi duy nhất đã dẫn dắt một đánh giá bảo mật hoàn chỉnh từ đầu đến cuối, bao gồm báo cáo sạch với bằng chứng và các bước kiểm tra lại.
Tôi nghĩ nên lưu ý rằng đánh đổi về độ trễ là có thật. Định tuyến và tổng hợp đa-agent tạo thêm overhead. Với truy vấn đơn giản hoặc yêu cầu độ trễ chặt, gọi trực tiếp một mô hình tiên phong đơn lẻ có lẽ sẽ nhanh và rẻ hơn.
API tương thích OpenAI
Cả Fugu và Fugu Ultra đều truy cập qua một API tương thích OpenAI duy nhất. Không cần di trú SDK.
Bạn trỏ client hiện có tới endpoint của Fugu với khóa API của mình và bắt đầu gửi yêu cầu. Đây là lựa chọn có chủ ý để giảm chi phí chuyển đổi cho các đội vốn đang dùng GPT-5.5 hoặc Claude Opus 4.8 qua thư viện client của OpenAI.
Điểm chuẩn Sakana Fugu
Theo bảng so sánh của Sakana, Fugu Ultra dẫn đầu 10/11 benchmark, với GPT-5.5 chỉ thắng MRCRv2. Tất cả điểm số, trừ của Fugu, đều do nhà cung cấp báo cáo. Fable 5 và Mythos Preview bị loại khỏi so sánh vì không thể truy cập công khai và do đó không thể nằm trong nhóm agent của Fugu.
Cho đến thời điểm tôi viết, tôi chưa thấy các phép tái lập độc lập của những con số này xuất hiện trên các bảng xếp hạng bên thứ ba.
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
SWE-Bench Pro
Fugu Ultra đạt 73,7% trên SWE-Bench Pro, vượt Claude Opus 4.8 ở 69,2%, GPT-5.5 ở 58,6%, và Gemini 3.1 Pro ở 54,2%. Trong phần đưa tin về GPT-5.5, chúng tôi ghi nhận mô hình này đạt 58,6% trên benchmark này, thấp hơn Fugu Ultra 15 điểm.
SWE-Bench Pro kiểm tra liệu một mô hình có thể giải quyết các issue GitHub thực trong những kho mã hay không, khiến đây trở thành một trong các benchmark lập trình mang tính thực tiễn cao. Khoảng cách giữa Fugu Ultra và mô hình tốt nhất tiếp theo có thể truy cập công khai là đủ lớn để tạo khác biệt với các đội làm rà soát mã hay sửa lỗi nghiêm túc.
LiveCodeBench và LiveCodeBench Pro
Fugu Ultra đạt 93,2% trên LiveCodeBench và 90,8% trên LiveCodeBench Pro. Điểm tốt tiếp theo là Gemini 3.1 Pro ở 88,5% và Claude Opus 4.8 ở 87,8% trên bản tiêu chuẩn.
LiveCodeBench kiểm tra các bài lập trình thi đấu lấy từ các cuộc thi gần đây, đồng nghĩa rủi ro ô nhiễm dữ liệu huấn luyện thấp hơn so với các benchmark lập trình cũ. Biến thể Pro dùng bài khó hơn. Lợi thế của Fugu ở đây phù hợp với báo cáo beta về hiệu năng rà soát mã mạnh.
Humanity's Last Exam
Fugu Ultra đạt 50,0% trên Humanity's Last Exam, so với Claude Opus 4.8 ở 49,8%, Gemini 3.1 Pro ở 44,4%, và GPT-5.5 ở 41,4%.
Benchmark này kiểm tra kiến thức cấp độ chuyên gia trên các lĩnh vực khoa học và học thuật, với câu hỏi được thiết kế khó ngay cả với chuyên gia. Điểm 50% trên benchmark này là đáng chú ý khi GPT-5.5 ở mức 41,4%. Khoảng cách giữa Fugu Ultra và GPT-5.5 tại đây là lớn nhất trong mọi benchmark của bảng.
GPQA Diamond
Cả Fugu và Fugu Ultra đều đạt 95,5% trên GPQA Diamond, với Gemini 3.1 Pro ở 94,3%, GPT-5.5 ở 93,6%, và Claude Opus 4.8 ở 92,0%.
GPQA Diamond kiểm tra các câu hỏi khoa học cấp độ tiến sĩ trong sinh học, hóa học, và vật lý, do chuyên gia biên soạn và xác minh là khó với người không chuyên. Việc Fugu tiêu chuẩn sánh ngang Fugu Ultra ở đây gợi ý overhead điều phối trên benchmark này không đóng góp nhiều, điều này hợp lý với tác vụ hỏi-đáp không đòi hỏi lập kế hoạch nhiều bước.
TerminalBench 2.1
Fugu Ultra đạt 82,1% trên TerminalBench 2.1, vượt GPT-5.5 ở 78,2%, Claude Opus 4.8 ở 74,6%, và Gemini 3.1 Pro ở 70,3%. TerminalBench kiểm tra các tác vụ lập trình có tính agent cần tương tác với môi trường terminal, gồm thao tác tệp, lệnh shell, và thực thi nhiều bước.
Đây là một trong những benchmark liên quan nhất tới quy trình làm việc thực tế của nhà phát triển, và lợi thế của Fugu Ultra trước GPT-5.5 tại đây phù hợp với trường hợp sử dụng đánh giá an ninh mạng được báo cáo trong giai đoạn beta.
MRCRv2
GPT-5.5 dẫn đầu MRCRv2 với 94,8%, so với Fugu Ultra ở 93,6% và Claude Opus 4.8 ở 87,9%. MRCRv2 kiểm tra khả năng hồi tưởng ngữ cảnh dài, cụ thể là liệu mô hình có thể truy xuất thông tin cụ thể từ các tài liệu rất dài hay không.
Đây là benchmark duy nhất nơi Fugu Ultra không dẫn đầu, điều đáng lưu ý cho các đội có trường hợp sử dụng chính là truy xuất dữ kiện cụ thể từ tài liệu lớn hơn là suy luận nhiều bước hay sinh mã.
Nguồn
Giá và khả dụng của Sakana Fugu
Fugu hiện khả dụng qua bảng điều khiển của Sakana tại console.sakana.ai, với API tương thích OpenAI. Cả Fugu và Fugu Ultra đều có trong mọi gói. Các tầng đăng ký gồm:
- Standard: 20 USD/tháng, mức sử dụng cơ bản, phù hợp với gọi API thỉnh thoảng và thử nghiệm cá nhân
- Pro: 100 USD/tháng, gấp 10 lần mức Standard, phù hợp với các phiên lập trình và nghiên cứu thường xuyên
- Max: 200 USD/tháng, gấp 30 lần mức Standard, phù hợp với tải công việc nặng, chạy dài
Gói trả theo mức dùng tính phí theo số token thay vì hạn mức tháng. Với Fugu Ultra (ID mô hình: fugu-ultra-20260615), giá là 5 USD mỗi triệu token đầu vào và 30 USD mỗi triệu token đầu ra cho độ dài ngữ cảnh tiêu chuẩn.
Với ngữ cảnh trên 272K token, mức giá tăng lên 10 USD đầu vào và 45 USD đầu ra. Đầu vào được cache là 0,50 USD mỗi triệu token, hoặc 1,00 USD trên 272K. Giá tiêu chuẩn của Fugu khớp với mức của mô hình nền tảng đang hoạt động, và Sakana không cộng dồn phí khi nhiều agent chạy đồng thời.
Một hạn chế khu vực cần lưu ý: Fugu hiện chưa khả dụng tại các quốc gia EU hoặc EEA, trong khi Sakana đang xử lý tuân thủ GDPR. Với các đội châu Âu, đây là rào cản tạm thời. Sakana chưa công bố mốc thời gian cho khả dụng tại EU.
Kết luận
Fugu thực sự là một canh bạc khác biệt so với những gì OpenAI, Anthropic và Google đang làm. Thay vì cạnh tranh bằng độ lớn mô hình nền, Sakana lập luận rằng điều phối học được trên một nhóm mô hình tiên phong có thể hoán đổi có thể sánh hoặc vượt bất cứ hệ đơn lẻ nào trên các tác vụ thực sự tốn thời gian: rà soát mã dài, nghiên cứu nhiều bước, đánh giá bảo mật, và tái lập bài báo.
Các con số benchmark, nếu vượt qua xác minh độc lập, ủng hộ lập luận đó trên hầu hết chỉ số quan trọng với nhà phát triển. Tất nhiên, cho đến khi có lại quyền truy cập Fable 5 và Mythos, chúng ta chưa thể so sánh trực tiếp với chúng.
Dẫu vậy, vẫn có vài lưu ý.
Mọi điểm số benchmark do Sakana báo cáo. Lớp định tuyến mờ đục, tạo ma sát cho công việc nhạy tuân thủ. Việc loại trừ EU/EEA hạn chế mức độ tiếp nhận với một phần đáng kể cộng đồng lập trình viên toàn cầu. Và đánh đổi độ trễ trên tác vụ đơn giản là có thật: nếu bạn thực hiện các cuộc gọi API nhanh, một lượt, overhead điều phối của Fugu Ultra là chi phí thuần mà không có lợi ích.
Nơi tôi cho rằng Fugu thực sự có lý là với các đội vận hành quy trình tác tử tầm nhìn dài và vốn đã tự mình quản lý độ phức tạp của thiết lập đa mô hình. Nếu bạn đang duy trì bộ khung điều phối riêng trên Claude và GPT, Fugu Ultra xứng đáng được đánh giá nghiêm túc.
Khung "chủ quyền" có lẽ được nói quá, nhưng giá trị thực tiễn của một endpoint duy nhất có thể định tuyến vòng qua gián đoạn từ nhà cung cấp thì không.
Nếu bạn muốn cập nhật nhanh về bức tranh AI tác tử mà Fugu đang hoạt động trong đó, tôi khuyên bắt đầu với lộ trình kỹ năng AI Agent Fundamentals trên DataCamp, nơi đề cập nền tảng về mô hình ngôn ngữ lớn, agent, và hệ thống đa mô hình.


Bức tranh AI giữa năm 2026 đang chật kín các mô hình tiên phong kiểu đơn khối cạnh tranh bằng điểm benchmark thô. Sakana AI chọn một hướng khác: thay vì huấn luyện một mô hình nền tảng lớn hơn, họ ra mắt Fugu, một hệ thống điều phối một nhóm các mô hình tiên phong hiện có phía sau một API tương thích với OpenAI duy nhất.
Tuyên bố nổi bật là Sakana Fugu Ultra sánh ngang với Fable 5 và Mythos Preview của Anthropic trên các benchmark về kỹ thuật, khoa học và suy luận, mà không cần truy cập vào hai mô hình bị kiểm soát xuất khẩu đó.
Sakana Fugu ra mắt ngày 22 tháng 6 năm 2026 với hai biến thể: Fugu cho công việc thường nhật nhạy độ trễ, và Fugu Ultra cho các tác vụ phức tạp, nhiều bước. Trên SWE-Bench Pro, Fugu Ultra đạt 73,7%, vượt Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%), và Gemini 3.1 Pro (54,2%).
Mọi con số benchmark đều do Sakana báo cáo và hiện chưa được các phòng thí nghiệm bên thứ ba tái lập độc lập, điều này cần lưu ý khi bạn đọc.
Trong bài này, tôi sẽ trình bày Fugu thực chất là gì, điểm qua các tính năng chính, xem bảng benchmark đầy đủ, và một số trường hợp sử dụng. Bạn cũng có thể xem so sánh của chúng tôi về GPT-5.5 vs Gemini 3.1 Pro để có ngữ cảnh về các mô hình mà Fugu đang cạnh tranh.
Sakana Fugu là gì?
Sakana Fugu là một mô hình ngôn ngữ được huấn luyện để đóng vai trò bộ điều phối: nhận yêu cầu, quyết định tự xử lý hay ủy quyền cho các mô hình chuyên biệt trong nhóm agent, quản lý kiểm chứng và tổng hợp, rồi trả về một phản hồi duy nhất. Từ bên ngoài, bạn chỉ gọi một endpoint. Bên trong, một tập hợp mô hình phối hợp thực hiện công việc.
Sakana AI xây dựng hướng tới kiến trúc này từ khi thành lập. Phòng lab do Llion Jones (đồng tác giả bài "Attention Is All You Need" gốc) và David Ha sáng lập từ lâu đã lập luận rằng các hệ sinh thái mô hình phối hợp vượt trội các mô hình đơn khối biệt lập trên những tác vụ khó, chạy dài.
Fugu là phiên bản sản phẩm hóa của luận điểm đó, dựa trên hai bài báo ICLR 2026: TRINITY (một điều phối viên LLM tiến hóa) và Conductor (học cách điều phối agent bằng ngôn ngữ tự nhiên).
Tại thời điểm viết, Fable 5 và Mythos Preview của Anthropic chưa thể truy cập công khai do kiểm soát xuất khẩu, đồng nghĩa chúng không thể nằm trong nhóm agent của Fugu.
Lập luận của Sakana là định tuyến qua một nhóm mô hình có thể hoán đổi mang lại phương án phòng ngừa thực tiễn trước đúng kiểu gián đoạn truy cập này. Liệu điều đó cấu thành "chủ quyền AI" thực sự hay không còn tranh cãi, nhưng logic vận hành thì vững: nếu một nhà cung cấp hạn chế truy cập, Fugu sẽ định tuyến vòng qua.
Nguồn
Sakana Fugu có gì mới?
Fugu giới thiệu một số ý tưởng phân biệt với cả các mô hình tiên phong thông thường và khung đa-agent truyền thống. Tôi đã nêu những điểm chính dưới đây.
Điều phối học được, không phải pipeline cố định
Hầu hết hệ thống đa-agent yêu cầu nhà phát triển xác định mô hình nào xử lý tác vụ nào. Fugu thì học điều này. Mô hình điều phối được huấn luyện để quyết định khi nào nên ủy quyền, các agent nên trao đổi thế nào, và cách kết hợp đầu ra của họ thành một câu trả lời. Đây là đóng góp cốt lõi từ nghiên cứu TRINITY và Conductor mà tôi đã dẫn ở trên.
Trong thực tế, điều này có nghĩa là độ phức tạp của hệ đa-agent không bao giờ chạm vào code của bạn. Bạn gửi yêu cầu tới một endpoint, và Fugu xử lý việc chọn mô hình, ủy quyền, kiểm chứng, và tổng hợp ở bên trong. Với các đội đã từng cố xây lớp điều phối riêng, sức hấp dẫn rất rõ: bạn nhận được lợi ích phối hợp mà không phải duy trì bộ khung.
Một lưu ý cần nêu: các quyết định định tuyến là độc quyền và không lộ ra cho người dùng. Bạn không thể thấy mô hình nền nào đã xử lý yêu cầu. Với công việc nhạy tuân thủ nơi bạn cần kiểm toán chuỗi suy luận, sự mờ đục này là một hạn chế thực sự.
Nhóm agent có thể hoán đổi
Các mô hình trong nhóm của Fugu không cố định. Khi một mô hình tiên phong mới khả dụng công khai, Sakana dự kiến mất khoảng hai tuần để huấn luyện và đánh giá các phiên bản Fugu cập nhật trước khi triển khai. Điều này nghĩa là hiệu năng của Fugu sẽ cải thiện cùng hệ sinh thái nền tảng, mà người dùng không cần thay đổi tích hợp.
Với Fugu tiêu chuẩn, người dùng cũng có thể loại trừ một số agent khỏi nhóm trong phần cài đặt bảng điều khiển, điều này quan trọng với các đội có yêu cầu về quyền riêng tư dữ liệu hoặc tuân thủ. Nhóm của Fugu Ultra là cố định vì nó dựa vào tập đầy đủ agent để đạt hiệu năng benchmark.
Thiết kế mô hình hai tầng
Fugu và Fugu Ultra phục vụ các loại tải công việc khác nhau. Fugu cân bằng chất lượng với độ trễ thấp, là lựa chọn hợp lý mặc định cho lập trình, rà soát mã, và dịch vụ tương tác. Fugu Ultra điều phối một nhóm sâu hơn các agent chuyên gia và được tinh chỉnh để đạt chất lượng trả lời tối đa trên các bài toán khó, nhiều bước.
Người dùng sớm chọn Fugu Ultra cho các tác vụ như tái lập bài báo, phân tích an ninh mạng, khoa học dữ liệu kiểu Kaggle, và điều tra bằng sáng chế.
Một kỹ sư phần mềm trong giai đoạn beta báo cáo rằng Fugu Ultra phát hiện hơn hai mươi vấn đề rà soát mã, trong khi các công cụ khác chỉ nêu khoảng ba.
Một kỹ sư an ninh mạng cho biết một chỉ dẫn giới hạn phạm vi duy nhất đã dẫn dắt một đánh giá bảo mật hoàn chỉnh từ đầu đến cuối, bao gồm báo cáo sạch với bằng chứng và các bước kiểm tra lại.
Tôi nghĩ nên lưu ý rằng đánh đổi về độ trễ là có thật. Định tuyến và tổng hợp đa-agent tạo thêm overhead. Với truy vấn đơn giản hoặc yêu cầu độ trễ chặt, gọi trực tiếp một mô hình tiên phong đơn lẻ có lẽ sẽ nhanh và rẻ hơn.
API tương thích OpenAI
Cả Fugu và Fugu Ultra đều truy cập qua một API tương thích OpenAI duy nhất. Không cần di trú SDK.
Bạn trỏ client hiện có tới endpoint của Fugu với khóa API của mình và bắt đầu gửi yêu cầu. Đây là lựa chọn có chủ ý để giảm chi phí chuyển đổi cho các đội vốn đang dùng GPT-5.5 hoặc Claude Opus 4.8 qua thư viện client của OpenAI.
Điểm chuẩn Sakana Fugu
Theo bảng so sánh của Sakana, Fugu Ultra dẫn đầu 10/11 benchmark, với GPT-5.5 chỉ thắng MRCRv2. Tất cả điểm số, trừ của Fugu, đều do nhà cung cấp báo cáo. Fable 5 và Mythos Preview bị loại khỏi so sánh vì không thể truy cập công khai và do đó không thể nằm trong nhóm agent của Fugu.
Cho đến thời điểm tôi viết, tôi chưa thấy các phép tái lập độc lập của những con số này xuất hiện trên các bảng xếp hạng bên thứ ba.
SWE-Bench Pro
Fugu Ultra đạt 73,7% trên SWE-Bench Pro, vượt Claude Opus 4.8 ở 69,2%, GPT-5.5 ở 58,6%, và Gemini 3.1 Pro ở 54,2%. Trong phần đưa tin về GPT-5.5, chúng tôi ghi nhận mô hình này đạt 58,6% trên benchmark này, thấp hơn Fugu Ultra 15 điểm.
SWE-Bench Pro kiểm tra liệu một mô hình có thể giải quyết các issue GitHub thực trong những kho mã hay không, khiến đây trở thành một trong các benchmark lập trình mang tính thực tiễn cao. Khoảng cách giữa Fugu Ultra và mô hình tốt nhất tiếp theo có thể truy cập công khai là đủ lớn để tạo khác biệt với các đội làm rà soát mã hay sửa lỗi nghiêm túc.
LiveCodeBench và LiveCodeBench Pro
Fugu Ultra đạt 93,2% trên LiveCodeBench và 90,8% trên LiveCodeBench Pro. Điểm tốt tiếp theo là Gemini 3.1 Pro ở 88,5% và Claude Opus 4.8 ở 87,8% trên bản tiêu chuẩn.
LiveCodeBench kiểm tra các bài lập trình thi đấu lấy từ các cuộc thi gần đây, đồng nghĩa rủi ro ô nhiễm dữ liệu huấn luyện thấp hơn so với các benchmark lập trình cũ. Biến thể Pro dùng bài khó hơn. Lợi thế của Fugu ở đây phù hợp với báo cáo beta về hiệu năng rà soát mã mạnh.
Humanity's Last Exam
Fugu Ultra đạt 50,0% trên Humanity's Last Exam, so với Claude Opus 4.8 ở 49,8%, Gemini 3.1 Pro ở 44,4%, và GPT-5.5 ở 41,4%.
Benchmark này kiểm tra kiến thức cấp độ chuyên gia trên các lĩnh vực khoa học và học thuật, với câu hỏi được thiết kế khó ngay cả với chuyên gia. Điểm 50% trên benchmark này là đáng chú ý khi GPT-5.5 ở mức 41,4%. Khoảng cách giữa Fugu Ultra và GPT-5.5 tại đây là lớn nhất trong mọi benchmark của bảng.
GPQA Diamond
Cả Fugu và Fugu Ultra đều đạt 95,5% trên GPQA Diamond, với Gemini 3.1 Pro ở 94,3%, GPT-5.5 ở 93,6%, và Claude Opus 4.8 ở 92,0%.
GPQA Diamond kiểm tra các câu hỏi khoa học cấp độ tiến sĩ trong sinh học, hóa học, và vật lý, do chuyên gia biên soạn và xác minh là khó với người không chuyên. Việc Fugu tiêu chuẩn sánh ngang Fugu Ultra ở đây gợi ý overhead điều phối trên benchmark này không đóng góp nhiều, điều này hợp lý với tác vụ hỏi-đáp không đòi hỏi lập kế hoạch nhiều bước.
TerminalBench 2.1
Fugu Ultra đạt 82,1% trên TerminalBench 2.1, vượt GPT-5.5 ở 78,2%, Claude Opus 4.8 ở 74,6%, và Gemini 3.1 Pro ở 70,3%. TerminalBench kiểm tra các tác vụ lập trình có tính agent cần tương tác với môi trường terminal, gồm thao tác tệp, lệnh shell, và thực thi nhiều bước.
Đây là một trong những benchmark liên quan nhất tới quy trình làm việc thực tế của nhà phát triển, và lợi thế của Fugu Ultra trước GPT-5.5 tại đây phù hợp với trường hợp sử dụng đánh giá an ninh mạng được báo cáo trong giai đoạn beta.
MRCRv2
GPT-5.5 dẫn đầu MRCRv2 với 94,8%, so với Fugu Ultra ở 93,6% và Claude Opus 4.8 ở 87,9%. MRCRv2 kiểm tra khả năng hồi tưởng ngữ cảnh dài, cụ thể là liệu mô hình có thể truy xuất thông tin cụ thể từ các tài liệu rất dài hay không.
Đây là benchmark duy nhất nơi Fugu Ultra không dẫn đầu, điều đáng lưu ý cho các đội có trường hợp sử dụng chính là truy xuất dữ kiện cụ thể từ tài liệu lớn hơn là suy luận nhiều bước hay sinh mã.
Nguồn
Giá và khả dụng của Sakana Fugu
Fugu hiện khả dụng qua bảng điều khiển của Sakana tại console.sakana.ai, với API tương thích OpenAI. Cả Fugu và Fugu Ultra đều có trong mọi gói. Các tầng đăng ký gồm:
Gói trả theo mức dùng tính phí theo số token thay vì hạn mức tháng. Với Fugu Ultra (ID mô hình: fugu-ultra-20260615), giá là 5 USD mỗi triệu token đầu vào và 30 USD mỗi triệu token đầu ra cho độ dài ngữ cảnh tiêu chuẩn.
Với ngữ cảnh trên 272K token, mức giá tăng lên 10 USD đầu vào và 45 USD đầu ra. Đầu vào được cache là 0,50 USD mỗi triệu token, hoặc 1,00 USD trên 272K. Giá tiêu chuẩn của Fugu khớp với mức của mô hình nền tảng đang hoạt động, và Sakana không cộng dồn phí khi nhiều agent chạy đồng thời.
Một hạn chế khu vực cần lưu ý: Fugu hiện chưa khả dụng tại các quốc gia EU hoặc EEA, trong khi Sakana đang xử lý tuân thủ GDPR. Với các đội châu Âu, đây là rào cản tạm thời. Sakana chưa công bố mốc thời gian cho khả dụng tại EU.
Kết luận
Fugu thực sự là một canh bạc khác biệt so với những gì OpenAI, Anthropic và Google đang làm. Thay vì cạnh tranh bằng độ lớn mô hình nền, Sakana lập luận rằng điều phối học được trên một nhóm mô hình tiên phong có thể hoán đổi có thể sánh hoặc vượt bất cứ hệ đơn lẻ nào trên các tác vụ thực sự tốn thời gian: rà soát mã dài, nghiên cứu nhiều bước, đánh giá bảo mật, và tái lập bài báo.
Các con số benchmark, nếu vượt qua xác minh độc lập, ủng hộ lập luận đó trên hầu hết chỉ số quan trọng với nhà phát triển. Tất nhiên, cho đến khi có lại quyền truy cập Fable 5 và Mythos, chúng ta chưa thể so sánh trực tiếp với chúng.
Dẫu vậy, vẫn có vài lưu ý.
Mọi điểm số benchmark do Sakana báo cáo. Lớp định tuyến mờ đục, tạo ma sát cho công việc nhạy tuân thủ. Việc loại trừ EU/EEA hạn chế mức độ tiếp nhận với một phần đáng kể cộng đồng lập trình viên toàn cầu. Và đánh đổi độ trễ trên tác vụ đơn giản là có thật: nếu bạn thực hiện các cuộc gọi API nhanh, một lượt, overhead điều phối của Fugu Ultra là chi phí thuần mà không có lợi ích.
Nơi tôi cho rằng Fugu thực sự có lý là với các đội vận hành quy trình tác tử tầm nhìn dài và vốn đã tự mình quản lý độ phức tạp của thiết lập đa mô hình. Nếu bạn đang duy trì bộ khung điều phối riêng trên Claude và GPT, Fugu Ultra xứng đáng được đánh giá nghiêm túc.
Khung "chủ quyền" có lẽ được nói quá, nhưng giá trị thực tiễn của một endpoint duy nhất có thể định tuyến vòng qua gián đoạn từ nhà cung cấp thì không.
Nếu bạn muốn cập nhật nhanh về bức tranh AI tác tử mà Fugu đang hoạt động trong đó, tôi khuyên bắt đầu với lộ trình kỹ năng AI Agent Fundamentals trên DataCamp, nơi đề cập nền tảng về mô hình ngôn ngữ lớn, agent, và hệ thống đa mô hình.