在金融服务业中使用数据科学和人工智能早已不是新闻。从银行基于信用评分提供贷款、保险公司依据风险定价,到投资基金根据预期风险与回报提供理财建议,数据始终是金融行业的基石。然而,要在数据科学与人工智能上取得成功,金融机构需要加深对机器学习与人工智能的应用。在一次近期网络研讨会上,渣打银行前集团首席数据官、现任TruEra首席战略官Shameek Kundu阐述了如何加速人工智能在金融服务业的落地与采用。
AI应用广而不深
Shameek指出,当下金融服务业中人工智能与机器学习的应用场景十分广泛。以下是一些具有代表性的真实案例。
然而,这并不意味着金融机构已经充分发挥了数据科学与人工智能的价值,行业仍需要更深入地采纳这些技术。淡马锡报告称,几乎所有金融机构都在某种程度上在流程中使用AI。但由于行业普遍存在的障碍,真正在多数流程中大规模采用AI的仅有13%。
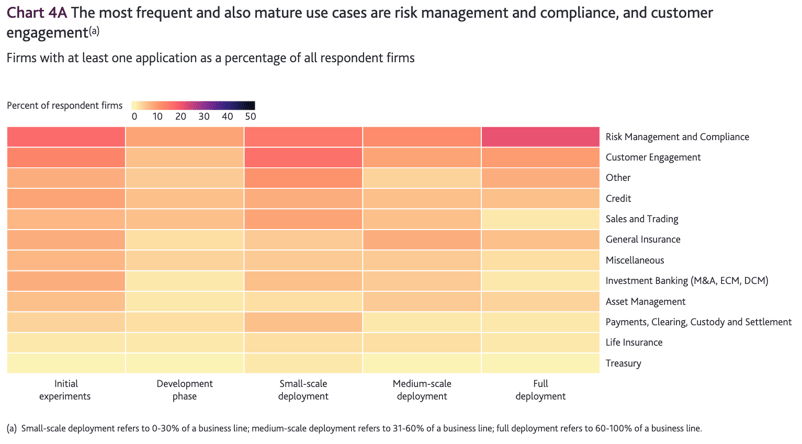 根据英格兰银行机器学习调查,许多AI项目仍处于早期阶段,难以实现全面部署这一终极目标
广泛采用AI面临的障碍
数据质量与可用性受限
监管机构对企业处理数据的方式日益审查,这在美国各州数据隐私法和欧盟法规的出台中可见一斑。此外,由于各地数据隐私法的差异,跨境数据共享依然受限。此类监管使得可用于训练机器学习模型并进行预测的数据量受到限制。
技术生态不成熟且碎片化
作为一个仍在快速发展的新兴领域,机器学习在技术生态上仍显不够成熟且较为碎片化,这也带来了成长的阵痛。
Algorithima的调研显示,当下组织通常需要约一到三个月才能将机器学习模型部署到生产环境。漫长的前置周期反映出成熟的机器学习运维(MLOps)工具匮乏。不过,鉴于该领域发展迅速,MLOps工具的完善只是时间问题。
对机器学习缺乏信任
复杂的机器学习模型往往难以解释其预测结果。由于难以理解这些“黑箱”模型,终端用户也很难信任其输出。
IBM Watson就是典型案例。它曾被誉为医疗保健的未来,但其黑箱模型未能赢得终端用户的信任。医生们理所当然地拒绝将生死攸关的决策交给一个AI黑箱。
同样地,金融监管机构和负责高风险决策(如欺诈检测)的银行从业者也难以信任黑箱模型。尤其在防止歧视与不公平结果、履行信息披露义务的场景中,透明性至关重要。鉴于此,美国联邦储备理事Brainard在2018年11月的一次讲话中表示:“可解释性的挑战会转化为对AI方法适用性的更大不确定性”,并呼吁金融服务企业在使用黑箱模型时保持警惕。
“最后一公里”的落地运营
机器学习项目同样会遭遇“最后一公里”问题——即如何在恰当的时间将结果传递给合适的人。例如,习惯即时响应的手机应用用户,若得知某条推荐需要十分钟才能加载,显然难以接受。
解决“最后一公里”的运营问题,不仅需要MLOps工具生态的成熟,也需要机器学习从业者重视用户体验。
数据人才短缺
要实现AI项目的大规模部署,需要由一支数据专业团队共同协作——包括数据科学家、分析师、工程师以及机器学习科学家。因此,数据人才短缺依然是各行业(包括金融服务业)采纳机器学习的阻碍。
德勤的一项调查显示,23%的AI成熟采用者报告称在AI实施方面存在显著的技能缺口。要弥补这一差距,需要针对特定人才制定聚焦的再培训与技能提升策略。
结语
以上列举的阻碍表明,只要投入足够时间与精力,这些问题均可解决。解决这些难题将使金融服务行业更进一步,释放其在AI采用方面的巨大潜力。
如果您对AI在金融服务中的应用感兴趣,欢迎观看Shameek的点播网络研讨会“在金融服务业扩大全球AI采用”。

在金融服务业中使用数据科学和人工智能早已不是新闻。从银行基于信用评分提供贷款、保险公司依据风险定价,到投资基金根据预期风险与回报提供理财建议,数据始终是金融行业的基石。然而,要在数据科学与人工智能上取得成功,金融机构需要加深对机器学习与人工智能的应用。在一次近期网络研讨会上,渣打银行前集团首席数据官、现任TruEra首席战略官Shameek Kundu阐述了如何加速人工智能在金融服务业的落地与采用。
AI应用广而不深
Shameek指出,当下金融服务业中人工智能与机器学习的应用场景十分广泛。以下是一些具有代表性的真实案例。
然而,这并不意味着金融机构已经充分发挥了数据科学与人工智能的价值,行业仍需要更深入地采纳这些技术。淡马锡报告称,几乎所有金融机构都在某种程度上在流程中使用AI。但由于行业普遍存在的障碍,真正在多数流程中大规模采用AI的仅有13%。
广泛采用AI面临的障碍
数据质量与可用性受限
监管机构对企业处理数据的方式日益审查,这在美国各州数据隐私法和欧盟法规的出台中可见一斑。此外,由于各地数据隐私法的差异,跨境数据共享依然受限。此类监管使得可用于训练机器学习模型并进行预测的数据量受到限制。
技术生态不成熟且碎片化
作为一个仍在快速发展的新兴领域,机器学习在技术生态上仍显不够成熟且较为碎片化,这也带来了成长的阵痛。
Algorithima的调研显示,当下组织通常需要约一到三个月才能将机器学习模型部署到生产环境。漫长的前置周期反映出成熟的机器学习运维(MLOps)工具匮乏。不过,鉴于该领域发展迅速,MLOps工具的完善只是时间问题。
对机器学习缺乏信任
复杂的机器学习模型往往难以解释其预测结果。由于难以理解这些“黑箱”模型,终端用户也很难信任其输出。
IBM Watson就是典型案例。它曾被誉为医疗保健的未来,但其黑箱模型未能赢得终端用户的信任。医生们理所当然地拒绝将生死攸关的决策交给一个AI黑箱。
同样地,金融监管机构和负责高风险决策(如欺诈检测)的银行从业者也难以信任黑箱模型。尤其在防止歧视与不公平结果、履行信息披露义务的场景中,透明性至关重要。鉴于此,美国联邦储备理事Brainard在2018年11月的一次讲话中表示:“可解释性的挑战会转化为对AI方法适用性的更大不确定性”,并呼吁金融服务企业在使用黑箱模型时保持警惕。
“最后一公里”的落地运营
机器学习项目同样会遭遇“最后一公里”问题——即如何在恰当的时间将结果传递给合适的人。例如,习惯即时响应的手机应用用户,若得知某条推荐需要十分钟才能加载,显然难以接受。
解决“最后一公里”的运营问题,不仅需要MLOps工具生态的成熟,也需要机器学习从业者重视用户体验。
数据人才短缺
要实现AI项目的大规模部署,需要由一支数据专业团队共同协作——包括数据科学家、分析师、工程师以及机器学习科学家。因此,数据人才短缺依然是各行业(包括金融服务业)采纳机器学习的阻碍。
德勤的一项调查显示,23%的AI成熟采用者报告称在AI实施方面存在显著的技能缺口。要弥补这一差距,需要针对特定人才制定聚焦的再培训与技能提升策略。
结语
以上列举的阻碍表明,只要投入足够时间与精力,这些问题均可解决。解决这些难题将使金融服务行业更进一步,释放其在AI采用方面的巨大潜力。
如果您对AI在金融服务中的应用感兴趣,欢迎观看Shameek的点播网络研讨会“在金融服务业扩大全球AI采用”。