Der Einsatz von Data Science und KI in Finanzdienstleistungen ist längst kein Novum mehr. Von Banken, die Kredite anhand von Bonitätsscores vergeben, über Versicherer, die Policen risikobasiert bepreisen, bis hin zu Fonds, die Anlageempfehlungen nach erwarteten Risiken und Renditen ausrichten – Daten sind seit jeher das Rückgrat des Sektors. Um mit Data Science und KI wirklich erfolgreich zu sein, müssen Finanzinstitute den Einsatz von Machine Learning und KI jedoch deutlich vertiefen. In einem aktuellen Webinar skizzierte Shameek Kundu, ehemaliger Group CDO bei Standard Chartered und heutiger Chief Strategy Officer bei TruEra, wie sich die KI-Einführung im Finanzsektor beschleunigen lässt.
KI-Anwendungen sind breit, aber oft oberflächlich
Shameek erklärt, dass es heute eine breite Palette an KI- und Machine-Learning-Anwendungsfällen in der Finanzbranche gibt. Hier einige prägnante Beispiele aus der Praxis.
- AXA nutzt prädiktives Underwriting mit Machine Learning, um den Policenabschluss zu beschleunigen
- Optical Character Recognition (OCR) hilft der Citibank, die manuelle Dokumentenverarbeitung zu beschleunigen
- Ermittler der OCBC Bank setzen Machine Learning ein, um betrügerische Transaktionen aufzuspüren
Das bedeutet jedoch nicht, dass Finanzinstitute das volle Potenzial von Data Science und KI ausschöpfen. Für echten Impact braucht es eine tiefgreifende Verankerung dieser Technologien. Temasek berichtet, dass praktisch alle Finanzdienstleister in irgendeiner Form KI in ihren Prozessen nutzen. Dennoch setzen nur 13% KI mehrheitlich in ihren Abläufen ein – gebremst durch branchenweite Hürden.
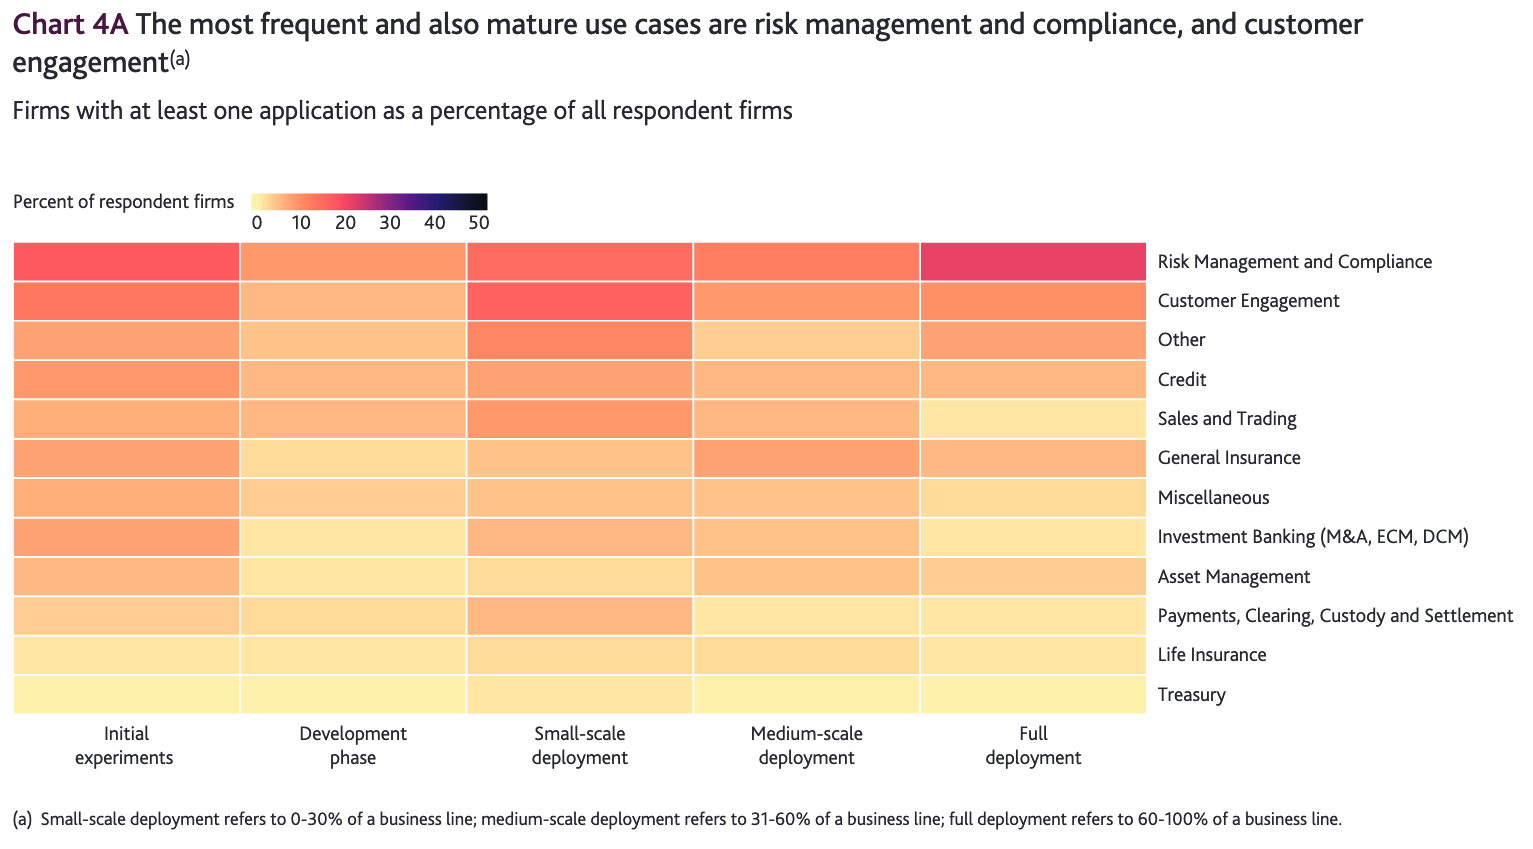 Viele KI-Projekte bleiben in der frühen Phase stecken und schaffen es nicht bis zum flächendeckenden Einsatz, so die Machine-Learning-Umfrage der Bank of England
Hürden für die breite KI-Einführung
Begrenzte Datenqualität und -verfügbarkeit
Regulierungsbehörden schauen Unternehmen zunehmend auf die Finger, wenn es um Datenverarbeitung geht – sichtbar an neuen Datenschutzgesetzen in den USA und der EU. Zudem ist der grenzüberschreitende Datenaustausch aufgrund regional abweichender Datenschutzregeln eingeschränkt. Das führt dazu, dass Machine-Learning-Modelle mit weniger Daten trainiert werden können – und damit schlechtere Vorhersagen liefern.
Unreife und fragmentierte Technologielandschaft
Da sich das noch junge Feld des Machine Learning rasant weiterentwickelt, zeigen sich Kinderkrankheiten in Form einer vergleichsweise unreifen und zersplitterten Technologielandschaft.
Laut einer Umfrage von Algorithima benötigen Unternehmen heute meist ein bis drei Monate, um ein Machine-Learning-Modell in Produktion zu bringen. Diese lange Vorlaufzeit ist ein Symptom fehlender ausgereifter MLOps-Tools. Angesichts des hohen Innovationstempos ist jedoch nur eine Frage der Zeit, bis das MLOps-Ökosystem nachzieht.
Mangelndes Vertrauen in Machine Learning
Komplexe Machine-Learning-Modelle lassen sich schwer interpretieren oder erklären. Ohne Verständnis für Black-Box-Modelle fällt es Endnutzern schwer, deren Ergebnisse zu vertrauen.
Ein prominentes Beispiel ist IBM Watson. Einst als Zukunft des Gesundheitswesens gehandelt, scheiterte das Black-Box-Modell am fehlenden Vertrauen seiner Nutzerinnen und Nutzer. Ärztinnen und Ärzte wollten Leben-und-Tod-Entscheidungen zu Recht nicht einer undurchsichtigen KI überlassen.
Ähnlich schwer tun sich Aufseher und Banker bei hochkritischen Entscheidungen wie Betrugserkennung mit Black-Box-Modellen. Transparenz ist hier essenziell, um Diskriminierung und unfaire Ergebnisse zu vermeiden und Offenlegungspflichten zu erfüllen. Entsprechend sagte die US-Notenbankerin Brainard in einer Rede im November 2018: „Die Herausforderung der Erklärbarkeit kann zu einer höheren Unsicherheit hinsichtlich der Eignung eines KI-Ansatzes führen“ – und rief Finanzinstitute zu besonderer Vorsicht beim Einsatz von Black-Box-Modellen auf.
Last-Mile-Operationalisierung
Auch Machine-Learning-Projekte leiden unter dem Last-Mile-Problem – also der Herausforderung, Ergebnisse zur richtigen Zeit an die richtigen Personen zu bringen. Wer etwa in einer App sofortige Ergebnisse erwartet, wird wenig begeistert sein, wenn eine Empfehlung zehn Minuten zum Laden braucht.
Um die Last-Mile-Operationalisierung zu meistern, braucht es nicht nur reifere MLOps-Werkzeuge, sondern auch mehr Fokus der ML-Teams auf die Nutzererfahrung.
Mangel an Datentalenten
Der flächendeckende Einsatz von KI erfordert interdisziplinäre Datenteams – mit Data Scientists, Analysten, Engineers und Machine-Learning-Expertinnen und -Experten. Entsprechend bleibt der Mangel an Datentalenten ein Bremsklotz für die KI-Einführung – auch im Finanzsektor.
Eine Deloitte-Umfrage zeigt: 23% der fortgeschrittensten KI-Anwender berichten von deutlichen Kompetenzlücken bei der Implementierung. Diese Lücke lässt sich mit einer gezielten Strategie für Reskilling und Weiterbildung schließen.
Fazit
Die genannten Hürden sind lösbar – mit Zeit, Fokus und dem richtigen Vorgehen. Wer sie adressiert, bringt die Finanzbranche einen großen Schritt näher daran, ihr gewaltiges KI-Potenzial zu heben.
Wenn dich der Einsatz von KI in Finanzdienstleistungen interessiert, schau dir unbedingt das On-Demand-Webinar von Shameek an: „Scaling AI Adoption in Financial Services“.




