वित्तीय सेवाओं में डेटा साइंस और AI का उपयोग कोई नई बात नहीं है। बैंकों द्वारा क्रेडिट स्कोर के आधार पर ऋण देना, बीमा कंपनियों द्वारा जोखिमों के आधार पर पॉलिसियों की कीमत तय करना, से लेकर निवेश फंड्स द्वारा अनुमानित जोखिम और रिटर्न के आधार पर वित्तीय परामर्श देना—डेटा हमेशा से वित्तीय क्षेत्र का मुख्य आधार रहा है। हालाँकि, डेटा साइंस और AI में सफल होने के लिए वित्तीय सेवाओं की संस्थाओं को मशीन लर्निंग और AI का उपयोग और गहराई से करना होगा। एक हालिया वेबिनार में, स्टैंडर्ड चार्टर्ड के पूर्व ग्रुप CDO और वर्तमान में TruEra के चीफ स्ट्रेटेजी ऑफिसर, शमीक कुण्डू ने बताया कि वित्तीय सेवाओं में AI को तेज़ी से कैसे अपनाया जा सकता है।
AI का उपयोग व्यापक है, परंतु उथला
शमीक बताते हैं कि आज वित्तीय सेवाओं में AI और मशीन लर्निंग के उपयोग के मामले व्यापक रूप से मौजूद हैं। यहाँ कुछ उल्लेखनीय वास्तविक उदाहरण दिए गए हैं।
- AXA की मशीन लर्निंग आधारित प्रीडिक्टिव अंडरराइटिंग पॉलिसी खरीद प्रक्रिया को सुव्यवस्थित करती है
- ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) Citibank को उनके मैन्युअल दस्तावेज़ प्रसंस्करण में तेजी लाने में मदद करता है
- OCBC Bank के अन्वेषक धोखाधड़ी वाले लेनदेन का पता लगाने के लिए मशीन लर्निंग का उपयोग करते हैं
हालाँकि, इसका अर्थ यह नहीं कि वित्तीय सेवाओं की संस्थाएँ डेटा साइंस और AI का पूरा लाभ उठा रही हैं, क्योंकि इन तकनीकों को गहराई से अपनाना अभी आवश्यक है। Temasek ने रिपोर्ट किया कि लगभग सभी वित्तीय सेवाएँ किसी न किसी स्तर पर अपनी प्रक्रियाओं में AI का उपयोग करती हैं। फिर भी, उद्योग-व्यापी बाधाओं के कारण मात्र 13% संस्थाएँ ही अपनी अधिकांश प्रक्रियाओं में वास्तव में AI का उपयोग कर रही हैं।
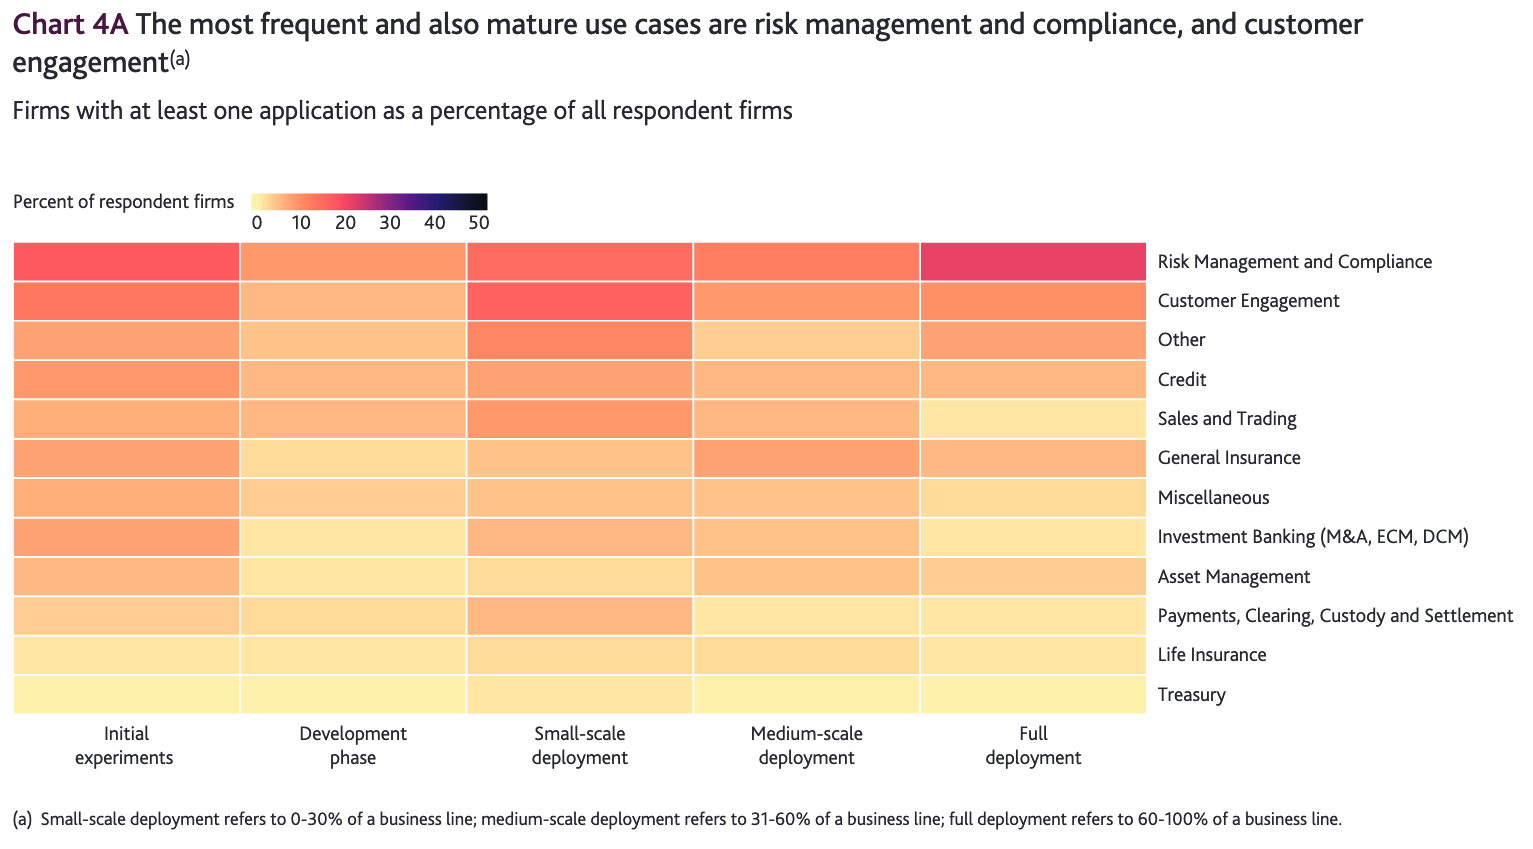 Bank of England के Machine Learning Survey के अनुसार कई AI प्रोजेक्ट अभी शैशव अवस्था में हैं और पूर्ण परिनियोजन के लक्ष्य तक नहीं पहुँच पा रहे हैं
AI के व्यापक अपनाव में बाधाएँ
सीमित डेटा गुणवत्ता और उपलब्धता
नियामक यह जाँच-परख बढ़ा रहे हैं कि कंपनियाँ डेटा को कैसे संसाधित करती हैं, जिसका प्रमाण है संयुक्त राज्य और EU में राज्य/क्षेत्रीय डेटा गोपनीयता क़ानूनों का लागू होना। इसके अलावा, विभिन्न भौगोलिक क्षेत्रों में गोपनीयता क़ानूनों के अंतर के कारण सीमापार डेटा साझा करना सीमित बना हुआ है। ऐसे नियमों के परिणामस्वरूप मशीन लर्निंग मॉडलों को प्रशिक्षण और पूर्वानुमान के लिए उपलब्ध डेटा सीमित हो जाता है।
अपरिपक्व और खंडित प्रौद्योगिकी परिदृश्य
जैसे-जैसे मशीन लर्निंग का यह नवजात क्षेत्र विकसित हो रहा है, उसे अपेक्षाकृत अपरिपक्व और खंडित प्रौद्योगिकी परिदृश्य के रूप में विकास संबंधी चुनौतियों का सामना करना पड़ रहा है।
आज, Algorithima के सर्वे के अनुसार, संगठनों को किसी मशीन लर्निंग मॉडल को प्रोडक्शन में तैनात करने में लगभग एक से तीन महीने लगते हैं। यह लंबा लीड टाइम परिपक्व मशीन लर्निंग ऑपरेशनलाइज़ेशन (MLOps) टूल्स की कमी का लक्षण है। हालाँकि, तेज़ी से हो रहे विकास को देखते हुए MLOps टूलिंग का परिपक्व होना अब केवल समय की बात है।
मशीन लर्निंग पर भरोसे की कमी
जटिल मशीन लर्निंग मॉडल्स की व्याख्या करना या उनकी भविष्यवाणियों को समझाना आसान नहीं होता। ब्लैक-बॉक्स मॉडलों की समझ न होने पर, अंतिम उपयोगकर्ताओं के लिए उनके निष्कर्षों पर भरोसा करना कठिन हो जाता है।
इसका एक उदाहरण है IBM Watson। एक समय स्वास्थ्य सेवा का भविष्य बताए जाने वाले इस ब्लैक-बॉक्स मॉडल पर उसके अंतिम उपयोगकर्ताओं का भरोसा नहीं बन सका। डॉक्टरों ने जीवन-मृत्यु के फैसले किसी AI ब्लैक बॉक्स पर छोड़ने से ठीक ही इनकार किया।
इसी तरह, धोखाधड़ी का पता लगाने जैसे उच्च-दांव वाले निर्णयों पर काम करने वाले वित्तीय सेवाओं के नियामक और बैंकरों के लिए ब्लैक-बॉक्स मॉडलों पर भरोसा करना मुश्किल होता है। खासकर तब जब पारदर्शिता भेदभाव और अनुचित परिणामों को रोकने तथा प्रकटीकरण दायित्वों को पूरा करने के लिए अनिवार्य हो। इसे स्वीकारते हुए, फेडरल रिजर्व की गवर्नर ब्रेनार्ड ने नवंबर 2018 के एक भाषण में कहा, “व्याख्यात्मकता की चुनौती AI दृष्टिकोण की उपयुक्तता के बारे में अधिक अनिश्चितता में बदल सकती है,” और वित्तीय सेवाओं की कंपनियों से ब्लैक-बॉक्स मॉडलों को लागू करते समय सतर्क रहने का आह्वान किया।
लास्ट माइल ऑपरेशनलाइज़ेशन
मशीन लर्निंग प्रोजेक्ट्स को भी “लास्ट माइल” समस्या का सामना करना पड़ता है—यानी सही समय पर सही लोगों तक परिणाम पहुँचाने की चुनौती। उदाहरण के लिए, फ़ोन ऐप उपयोगकर्ता जो तुरंत परिणाम की अपेक्षा रखते हैं, वे यह जानकर प्रसन्न नहीं होंगे कि किसी विशेष सिफारिश को लोड होने में दस मिनट लगते हैं।
लास्ट माइल ऑपरेशनलाइज़ेशन की समस्या का समाधान करने के लिए केवल परिपक्व होती MLOps टूलिंग ही नहीं, बल्कि मशीन लर्निंग विशेषज्ञों द्वारा उपयोगकर्ता अनुभव पर पर्याप्त ध्यान देना भी आवश्यक है।
डेटा टैलेंट की कमी
AI प्रोजेक्ट्स के पूर्ण पैमाने पर परिनियोजन के लिए डेटा पेशेवरों की एक टीम—जिसमें डेटा वैज्ञानिक, विश्लेषक, इंजीनियर, और मशीन लर्निंग वैज्ञानिक शामिल हैं—की आवश्यकता होती है। इस प्रकार, डेटा टैलेंट की कमी विभिन्न उद्योगों, जिनमें वित्तीय सेवाएँ भी शामिल हैं, में मशीन लर्निंग को अपनाने के लिए एक बाधा बनी हुई है।
Deloitte के एक सर्वे से पता चलता है कि सबसे परिपक्व AI अपनाने वालों में से 23% ने AI कार्यान्वयन के लिए महत्वपूर्ण कौशल अंतराल की सूचना दी। इस कौशल अंतर को दूर करने के लिए विशिष्ट प्रतिभाओं के लिए केंद्रित रिस्किलिंग और अपस्किलिंग रणनीति की आवश्यकता है।
निष्कर्ष
उपरोक्त रोडब्लॉक्स दिखाते हैं कि पर्याप्त समय और प्रयास से इन्हें दूर किया जा सकता है। ऐसे मुद्दों का समाधान वित्तीय सेवाओं के क्षेत्र को AI अपनाने की अपनी अपार संभावनाओं को साकार करने के एक कदम और करीब ले आएगा।
यदि आप वित्तीय सेवाओं में AI के उपयोग में रुचि रखते हैं, तो शमीक के ऑन-डिमांड वेबिनार “Scaling AI Adoption in Financial Services” को अवश्य देखें।