El uso de la ciencia de datos y la IA en los servicios financieros no es ninguna novedad. Desde bancos que conceden préstamos según el scoring crediticio, aseguradoras que fijan precios en función del riesgo, hasta fondos de inversión que recomiendan según riesgos y retornos previstos, los datos siempre han sido fundamentales en el sector financiero. Aun así, para triunfar con la ciencia de datos y la IA, las organizaciones financieras deben profundizar en el uso del aprendizaje automático y la IA. En un reciente seminario web, Shameek Kundu, ex CDO del grupo Standard Chartered y actual Chief Strategy Officer en TruEra, explicó cómo acelerar la adopción de la IA en servicios financieros.
La aplicación de la IA es amplia, pero superficial
Shameek señala que hoy existe un abanico muy amplio de casos de uso de IA y aprendizaje automático en servicios financieros. Estos son algunos ejemplos destacados del mundo real.
- La suscripción predictiva con aprendizaje automático de AXA agiliza la compra de pólizas
- El reconocimiento óptico de caracteres (OCR) ayuda a Citibank a acelerar el procesamiento manual de documentos
- Investigadores del OCBC Bank emplean aprendizaje automático para detectar transacciones fraudulentas
Sin embargo, esto no significa que las organizaciones financieras estén exprimiendo al máximo la ciencia de datos y la IA; hace falta una adopción más profunda. Temasek informó de que prácticamente todas las entidades financieras usan IA en sus procesos en cierta medida. Aun así, solo el 13% la utiliza de verdad en la mayoría de sus procesos debido a obstáculos generalizados en el sector.
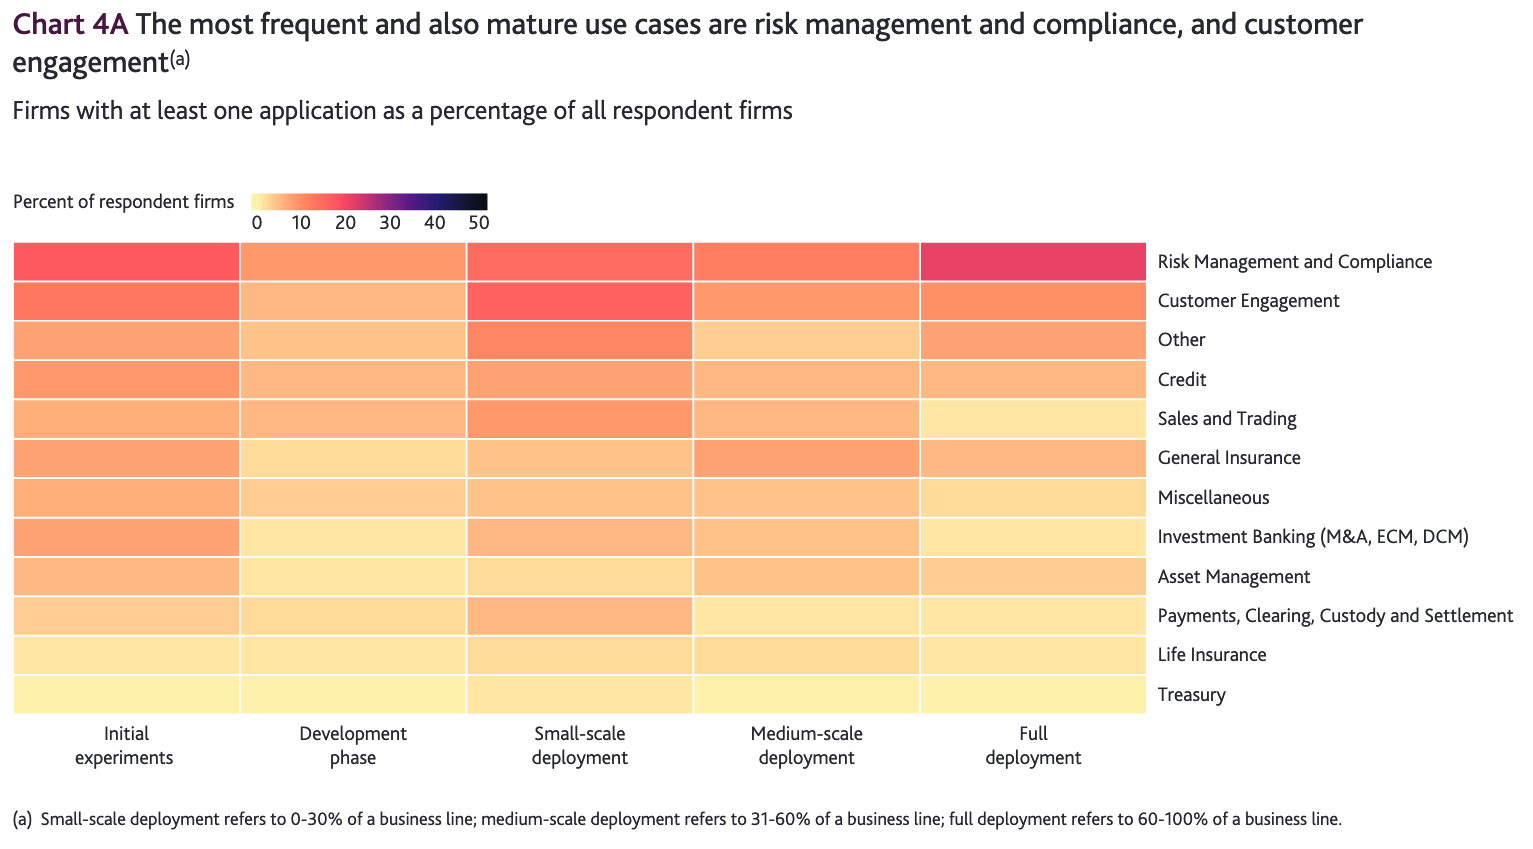 Muchos proyectos de IA se quedan en pañales y no llegan al objetivo final de un despliegue completo, según la encuesta de aprendizaje automático del Banco de Inglaterra
Obstáculos para una adopción generalizada de la IA
Calidad y disponibilidad de datos limitadas
Cada vez más, los reguladores examinan con lupa cómo procesan datos las empresas, como demuestran las leyes estatales de privacidad de datos en Estados Unidos y en la UE. Además, el intercambio transfronterizo de datos sigue siendo limitado por la disparidad geográfica de las normativas de privacidad. Estas regulaciones se traducen en menos datos para entrenar modelos de aprendizaje automático y realizar predicciones.
Un panorama tecnológico inmaduro y fragmentado
A medida que el campo, aún incipiente, del aprendizaje automático evoluciona, sufre dolores de crecimiento en forma de un panorama tecnológico relativamente inmaduro y fragmentado.
Hoy, las organizaciones tardan entre uno y tres meses en llevar un modelo de aprendizaje automático a producción, según una encuesta de Algorithima. Estos plazos largos son un síntoma de la falta de herramientas maduras de operacionalización del aprendizaje automático (MLOps). No obstante, es cuestión de tiempo que el ecosistema de MLOps madure, dado su ritmo vertiginoso de desarrollo.
Falta de confianza en el aprendizaje automático
Los modelos complejos de aprendizaje automático no son fáciles de interpretar ni de explicar sus predicciones. Sin entender estos modelos de caja negra, a los usuarios les cuesta confiar en sus resultados.
Un ejemplo es IBM Watson. En su día se presentó como el futuro de la sanidad, pero su modelo opaco no logró ganarse la confianza de sus usuarios finales. Con razón, los médicos se negaron a delegar decisiones de vida o muerte en una caja negra de IA.
De forma similar, los reguladores y banqueros que trabajan en decisiones críticas como la detección de fraude encuentran difícil confiar en modelos opacos. Más aún cuando la transparencia es clave para evitar discriminación y resultados injustos, y para cumplir con las obligaciones de información. Conscientes de ello, en un discurso de noviembre de 2018, la gobernadora de la Reserva Federal Brainard afirmó: «el reto de la explicabilidad puede traducirse en un mayor nivel de incertidumbre sobre la idoneidad de un enfoque de IA», y pidió a las firmas de servicios financieros mantenerse vigilantes al aplicar modelos de caja negra.
La última milla de la operacionalización
Los proyectos de aprendizaje automático también sufren el problema de la última milla: hacer llegar los resultados a las personas adecuadas en el momento oportuno. Por ejemplo, a quienes usan una app móvil y esperan inmediatez no les va a gustar descubrir que una recomendación tarda diez minutos en cargarse.
Resolver la última milla exige no solo que maduren las herramientas de MLOps, sino también que quienes desarrollan modelos presten atención a la experiencia de usuario.
Falta de talento en datos
El despliegue a gran escala de proyectos de IA requiere un equipo de profesionales de datos: científicos de datos, analistas, ingenieros y especialistas en aprendizaje automático. Por eso, la escasez de talento en datos sigue siendo un freno para la adopción del aprendizaje automático en todos los sectores, también en los servicios financieros.
Una encuesta de Deloitte revela que el 23% de los adoptantes de IA más avanzados reportan una brecha de competencias significativa para su implementación. Para cerrar esa brecha hace falta una estrategia enfocada de recapacitación y formación continua para perfiles clave.
Conclusión
Estos obstáculos demuestran que, con tiempo y esfuerzo, pueden superarse. Abordarlos acercará al sector financiero a liberar todo su potencial de adopción de la IA.
Si te interesa la aplicación de la IA en servicios financieros, no te pierdas el webinar bajo demanda de Shameek sobre «cómo escalar la adopción de la IA en servicios financieros».