O uso de ciência de dados e IA em serviços financeiros não é novidade. De bancos que concedem crédito com base em scores, seguradoras que precificam apólices conforme o risco, a gestoras que oferecem recomendações com base em projeções de risco e retorno, os dados sempre foram peça-chave no setor financeiro. No entanto, para ter sucesso com ciência de dados e IA, as instituições precisam aprofundar o uso de machine learning e IA. Em um webinar recente, Shameek Kundu, ex-CDO global do Standard Chartered e atual Chief Strategy Officer na TruEra, apresentou caminhos para acelerar a adoção de IA em serviços financeiros.
A aplicação de IA é ampla, mas ainda rasa
Shameek explica que hoje existe um conjunto amplo de casos de uso de IA e machine learning em serviços financeiros. Aqui vão alguns exemplos reais de destaque.
- O subscrição preditiva com machine learning da AXA agiliza o processo de compra de apólices
- O reconhecimento óptico de caracteres (OCR) ajuda o Citibank a acelerar o processamento manual de documentos
- Investigadores do OCBC Bank usam machine learning para detectar transações fraudulentas
Isso não significa, porém, que as instituições financeiras estejam tirando o máximo proveito de ciência de dados e IA. É preciso adotar essas tecnologias de forma mais profunda. A Temasek relatou que praticamente todas as empresas de serviços financeiros usam IA em seus processos em algum grau. Ainda assim, apenas 13% realmente utilizam IA na maioria dos processos, por conta de obstáculos generalizados no setor.
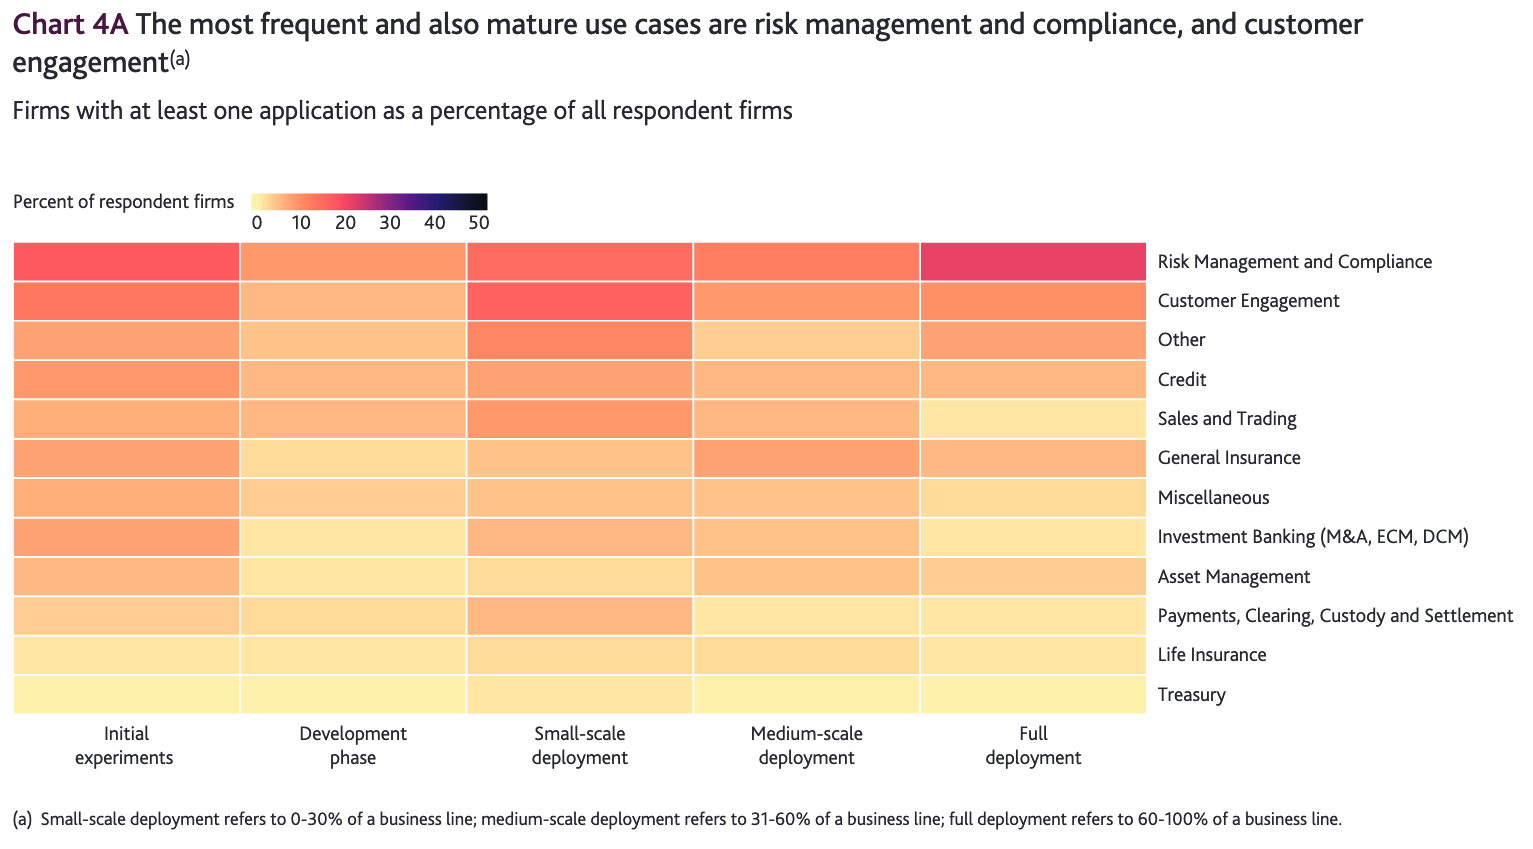 Muitos projetos de IA ainda estão na infância e não chegam ao objetivo final de implantação completa, segundo a pesquisa do Bank of England sobre machine learning
Obstáculos para a adoção ampla de IA
Qualidade e disponibilidade de dados limitadas
Os órgãos reguladores estão cada vez mais atentos a como as empresas processam dados, como mostram as leis estaduais de privacidade nos Estados Unidos e na União Europeia. Além disso, o compartilhamento transfronteiriço de dados é limitado pela variação geográfica das leis de privacidade. Essas regras acabam reduzindo a quantidade de dados disponível para treinar modelos de machine learning e gerar previsões.
Um ecossistema tecnológico imaturo e fragmentado
Como um campo ainda em evolução, o machine learning enfrenta dores de crescimento, refletidas em um ecossistema tecnológico relativamente imaturo e fragmentado.
Hoje, as organizações levam de um a três meses para colocar um modelo de machine learning em produção, segundo pesquisa da Algorithmia. Esse prazo longo é sintoma da falta de ferramentas maduras de operacionalização de machine learning (MLOps). No entanto, é questão de tempo para que o arsenal de MLOps amadureça, dado o ritmo acelerado de desenvolvimento.
Falta de confiança em machine learning
Modelos complexos de machine learning não são fáceis de interpretar ou de explicar suas previsões. Sem compreender esses modelos de "caixa-preta", os usuários finais têm dificuldade em confiar nos resultados.
Um exemplo é o IBM Watson. Apontado como o futuro da saúde, seu modelo de caixa-preta não conquistou a confiança dos usuários finais. Médicos, com razão, recusaram-se a delegar decisões de vida ou morte a uma caixa-preta de IA.
Da mesma forma, reguladores e banqueiros que lidam com decisões críticas, como detecção de fraudes, acham difícil confiar em modelos de caixa-preta. Isso é especialmente relevante quando transparência é essencial para evitar discriminação, resultados injustos e para cumprir obrigações de disclosure. Reconhecendo isso, a diretora do Federal Reserve, Brainard, afirmou em um discurso em novembro de 2018 que "o desafio da explicabilidade pode se traduzir em um nível mais alto de incerteza sobre a adequação de uma abordagem de IA" e pediu que instituições financeiras sejam cautelosas ao aplicar modelos de caixa-preta.
Operacionalização na última milha
Projetos de machine learning também sofrem com o problema da última milha – entregar o resultado certo, para a pessoa certa, no momento certo. Por exemplo, usuários de apps no celular esperam respostas imediatas e não aceitariam saber que uma recomendação leva dez minutos para carregar.
Resolver a última milha exige não só um ecossistema de MLOps mais maduro, mas também que os profissionais de machine learning prestem atenção à experiência do usuário.
Falta de talentos em dados
A implantação em larga escala de projetos de IA requer um time de profissionais de dados – incluindo cientistas de dados, analistas, engenheiros de dados e especialistas em machine learning. Por isso, a escassez de talentos segue como um entrave à adoção de machine learning em diversos setores, inclusive no financeiro.
Uma pesquisa da Deloitte revela que 23% dos adotantes mais maduros de IA relataram um gap significativo de competências para implementar IA. Para fechar essa lacuna, é preciso uma estratégia focada de reskilling e capacitação para perfis específicos.
Conclusão
Os obstáculos acima mostram que, com tempo e esforço, é possível superá-los. Ao endereçar esses pontos, o setor de serviços financeiros fica mais perto de liberar todo o seu potencial com a adoção de IA.
Se você se interessa pela aplicação de IA em serviços financeiros, assista ao webinar on-demand do Shameek sobre "Scaling AI Adoption in Financial Services".