L’utilisation de la data science et de l’IA dans les services financiers n’a rien de nouveau. Des banques qui accordent des prêts sur la base des scores de crédit, aux assureurs qui tarifient les polices selon les risques, en passant par les fonds d’investissement qui proposent des conseils fondés sur les risques et rendements attendus, la donnée a toujours été un pilier du secteur financier. Toutefois, pour réussir en data science et en IA, les acteurs financiers doivent intensifier et approfondir leurs usages du machine learning et de l’IA. Dans un webinaire récent, Shameek Kundu, ancien Group CDO de Standard Chartered et aujourd’hui Chief Strategy Officer chez TruEra, a présenté les leviers pour accélérer l’adoption de l’IA dans les services financiers.
Des usages de l’IA variés, mais encore superficiels
Shameek explique qu’il existe aujourd’hui un large éventail de cas d’usage en IA et en machine learning dans les services financiers. Voici quelques exemples concrets :
- La tarification prédictive en souscription d’AXA fluidifie le parcours d’achat de police grâce au machine learning
- La reconnaissance optique de caractères (OCR) aide Citibank à accélérer le traitement manuel des documents
- Les enquêteurs de l’OCBC Bank s’appuient sur le machine learning pour détecter les transactions frauduleuses
Cela ne signifie pas pour autant que les institutions financières tirent pleinement parti de la data science et de l’IA : une adoption en profondeur reste nécessaire. Temasek rapporte que pratiquement tous les acteurs financiers utilisent l’IA dans leurs processus, au moins en partie. Pourtant, seuls 13 % l’emploient réellement dans la majorité de leurs processus, freinés par des obstacles structurels.
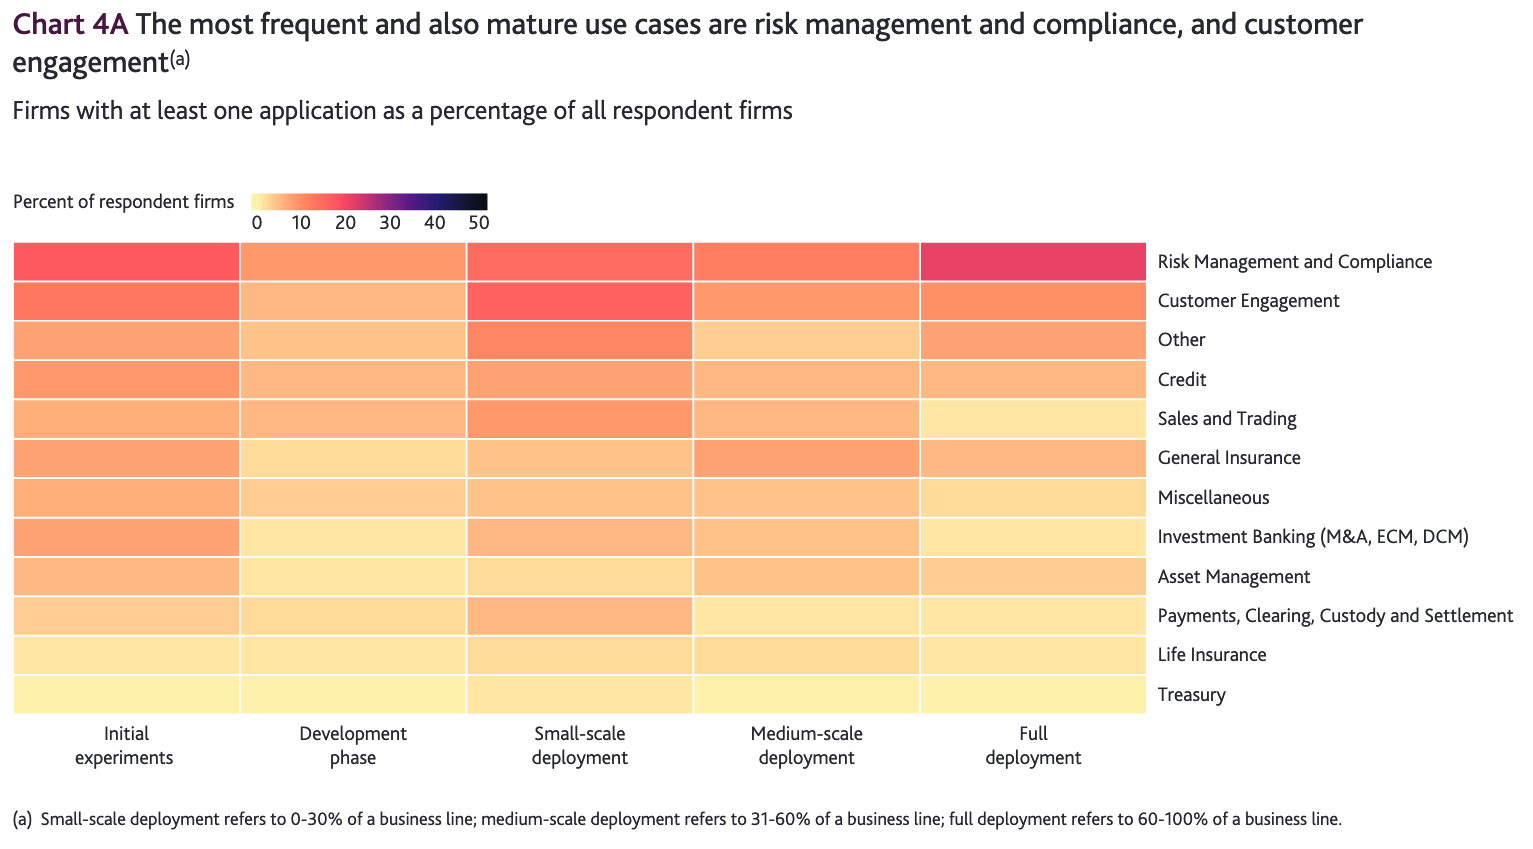 De nombreux projets d’IA restent au stade initial et n’atteignent pas une mise en production complète, selon l’enquête de la Bank of England sur le machine learning
Les obstacles à une adoption à grande échelle de l’IA
Qualité et disponibilité limitées des données
Les régulateurs examinent de plus en plus la manière dont les entreprises traitent les données, comme en témoignent les lois sur la protection des données adoptées aux États-Unis et dans l’UE. Par ailleurs, le partage transfrontalier de données reste limité en raison des disparités géographiques des réglementations. Résultat : des volumes de données restreints pour entraîner les modèles de machine learning et produire des prédictions fiables.
Un paysage technologique encore immature et fragmenté
Champ encore jeune, le machine learning continue d’évoluer et subit des « douleurs de croissance » avec un écosystème technologique relativement immature et morcelé.
Aujourd’hui, il faut en moyenne de un à trois mois pour déployer un modèle de machine learning en production, selon une enquête d’Algorithmia. Ce délai s’explique par l’absence d’outils matures d’industrialisation du machine learning (MLOps). Cela dit, au rythme actuel, l’offre MLOps gagne rapidement en maturité.
Un manque de confiance dans le machine learning
Les modèles de machine learning complexes sont difficiles à interpréter et à expliquer. Faute de compréhension de ces « boîtes noires », les utilisateurs finaux ont du mal à faire confiance à leurs résultats.
L’exemple d’IBM Watson est parlant. Présenté comme l’avenir de la santé, son modèle opaque n’a pas su gagner la confiance des médecins, qui ont refusé, à juste titre, de déléguer des décisions vitales à une IA boîte noire.
De la même façon, les régulateurs et les banquiers impliqués dans des décisions à fort enjeu, comme la détection de fraude, peinent à faire confiance à des modèles non transparents. C’est d’autant plus vrai que la transparence est essentielle pour prévenir les discriminations et résultats inéquitables, et satisfaire aux obligations de transparence. Consciente de cet enjeu, la gouverneure de la Réserve fédérale, Lael Brainard, déclarait dans un discours en novembre 2018 que « le défi de l’explicabilité peut se traduire par un niveau plus élevé d’incertitude quant à la pertinence d’une approche d’IA », appelant les entreprises de services financiers à la vigilance dans l’usage de modèles opaques.
La dernière ligne droite de l’industrialisation
Les projets de machine learning butent aussi sur le « dernier kilomètre » : acheminer le bon résultat à la bonne personne au bon moment. Par exemple, un utilisateur mobile, en quête d’immédiateté, n’acceptera pas qu’une recommandation prenne dix minutes à s’afficher.
Résoudre ce dernier kilomètre suppose non seulement un écosystème MLOps plus mature, mais aussi une attention accrue portée à l’expérience utilisateur par les praticiens du machine learning.
La pénurie de talents data
Le déploiement à grande échelle de projets d’IA mobilise toute une équipe de professionnels de la donnée : data scientists, analystes, ingénieurs, spécialistes du machine learning, etc. La rareté des talents data demeure donc un frein majeur à l’adoption du machine learning, y compris dans la finance.
Une étude Deloitte révèle que 23 % des organisations les plus avancées en IA font état d’un déficit important de compétences pour la mise en œuvre. Combler cet écart nécessite une stratégie ciblée de requalification et de montée en compétences.
Conclusion
Ces obstacles peuvent être levés avec du temps et des efforts. Les surmonter rapprochera le secteur financier de son immense potentiel en matière d’adoption de l’IA.
Si l’application de l’IA aux services financiers vous intéresse, ne manquez pas le webinaire à la demande de Shameek : « Scaling AI Adoption in Financial Services ».