L’uso della data science e dell’IA nei servizi finanziari non è certo una novità. Dalle banche che offrono prestiti in base ai credit score, alle compagnie assicurative che prezzano le polizze in base ai rischi, fino ai fondi d’investimento che propongono consulenza finanziaria sulla base di rischi e rendimenti attesi, i dati sono sempre stati un pilastro del settore finanziario. Tuttavia, per avere successo con data science e IA, le organizzazioni dei servizi finanziari devono approfondire l’uso del machine learning e dell’intelligenza artificiale. In un webinar recente, Shameek Kundu, ex Group CDO di Standard Chartered e attuale Chief Strategy Officer di TruEra, ha illustrato come accelerare l’adozione dell’IA nei servizi finanziari.
L’applicazione dell’IA è ampia ma superficiale
Shameek spiega che oggi nei servizi finanziari esiste un’ampia gamma di casi d’uso per l’IA e il machine learning. Ecco alcuni notevoli esempi reali.
- La sottoscrizione predittiva con machine learning di AXA snellisce il processo di acquisto delle polizze
- L’OCR (Optical Character Recognition) aiuta Citibank ad accelerare l’elaborazione manuale dei documenti
- Gli analisti della OCBC Bank sfruttano il machine learning per rilevare transazioni fraudolente
Tutto questo, però, non significa che le organizzazioni dei servizi finanziari stiano traendo il massimo da data science e IA, perché è necessaria un’adozione più profonda di queste tecnologie. Temasek ha riportato che praticamente tutti i servizi finanziari usano l’IA nei loro processi almeno in parte. Eppure, solo il 13% la utilizza davvero nella maggior parte dei processi, a causa di ostacoli diffusi a livello di settore.
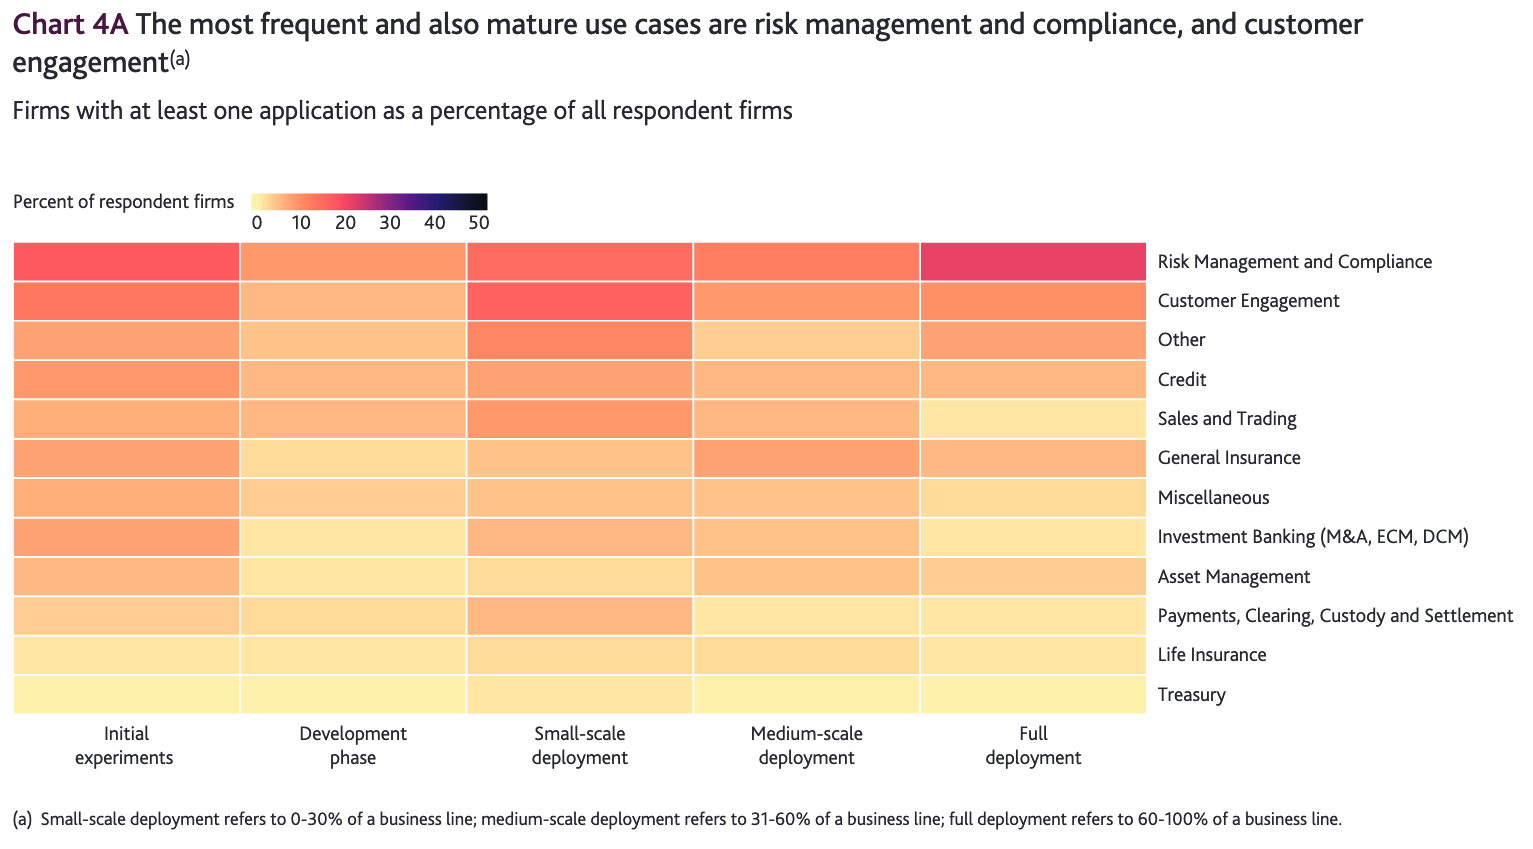 Molti progetti di IA restano nelle fasi iniziali e non riescono a raggiungere l’obiettivo finale del pieno deployment, secondo la Bank of England Machine Learning Survey
Ostacoli all’adozione diffusa dell’IA
Qualità e disponibilità dei dati limitate
I regolatori esaminano sempre più da vicino come le aziende trattano i dati, come dimostrano le leggi sulla privacy dei dati a livello statale negli Stati Uniti e nell’UE. Inoltre, la condivisione transfrontaliera dei dati resta limitata a causa delle differenze geografiche nelle leggi sulla privacy. Tali normative si traducono in dati limitati per addestrare i modelli di machine learning e produrre previsioni.
Un panorama tecnologico immaturo e frammentato
Poiché il campo, ancora agli inizi, del machine learning continua a evolversi, sperimenta dolori di crescita sotto forma di un panorama tecnologico relativamente immaturo e frammentato.
Oggi, secondo un sondaggio di Algorithima, alle organizzazioni servono da uno a tre mesi per portare un modello di machine learning in produzione. I lunghi tempi di attraversamento sono il sintomo della mancanza di strumenti maturi per la messa in produzione del machine learning (MLOps). Tuttavia, è solo questione di tempo prima che gli strumenti MLOps maturino, dato il rapido ritmo di sviluppo.
La mancanza di fiducia nel machine learning
I modelli complessi di machine learning non sono facili da interpretare né da spiegare nelle loro previsioni. Senza comprendere i modelli black box, gli utenti finali fanno fatica a fidarsi dei risultati.
Un caso emblematico è IBM Watson. Un tempo osannato come il futuro dell’healthcare, il suo modello black box non è riuscito a conquistare la fiducia degli utenti finali. Questi medici hanno giustamente rifiutato di delegare decisioni di vita o di morte a una scatola nera di IA.
Allo stesso modo, i regolatori dei servizi finanziari e i banchieri che lavorano su decisioni ad alto impatto, come il rilevamento delle frodi, trovano difficile fidarsi dei modelli black box. Ciò è ancora più vero quando la trasparenza è fondamentale per prevenire discriminazioni e risultati iniqui, e per rispettare gli obblighi di disclosure. Riconoscendolo, la Governatrice della Federal Reserve Brainard ha affermato in un discorso del novembre 2018: “la sfida della spiegabilità può tradursi in un livello più elevato di incertezza sull’idoneità di un approccio di IA”, e ha invitato le aziende dei servizi finanziari a rimanere vigili nell’applicazione di modelli black box.
Operationalizzazione dell’ultimo miglio
I progetti di machine learning affrontano anche il problema dell’ultimo miglio, ossia la sfida di portare i risultati alle persone giuste al momento giusto. Ad esempio, gli utenti di app mobili che si aspettano gratificazione immediata non sarebbero contenti di scoprire che un determinato consiglio impiega dieci minuti a caricarsi.
Risolvere il problema dell’ultimo miglio richiede non solo un panorama di strumenti MLOps più maturo, ma anche che i professionisti del machine learning prestino attenzione all’esperienza dell’utente.
La carenza di talenti nei dati
Il deployment su larga scala dei progetti di IA richiede un team di professionisti dei dati, tra cui data scientist, analyst, engineer e machine learning scientist. Di conseguenza, la carenza di talenti nel campo dei dati resta un ostacolo all’adozione del machine learning in tutti i settori, incluso quello dei servizi finanziari.
Un sondaggio Deloitte rivela che il 23% degli adottanti di IA più maturi ha riportato un notevole gap di competenze per l’implementazione dell’IA. Colmare questo gap richiede una strategia mirata di reskilling e upskilling per talenti specifici.
Conclusione
Gli ostacoli elencati sopra mostrano che possono essere affrontati con tempo e impegno sufficienti. Affrontare questi problemi porterà il settore dei servizi finanziari un passo più vicino a sbloccare il suo enorme potenziale di adozione dell’IA.
Se ti interessa l’applicazione dell’IA nei servizi finanziari, non perderti il webinar on-demand di Shameek su “Scaling AI Adoption in Financial Services”.



