dbt-utils 包是一款强大的工具集,可简化并增强您的数据转换流程。在本指南中,我们将向您介绍 dbt-utils,并展示它如何通过面向常见 SQL 操作的预构建宏来优化您的工作流。
什么是 dbt-utils?
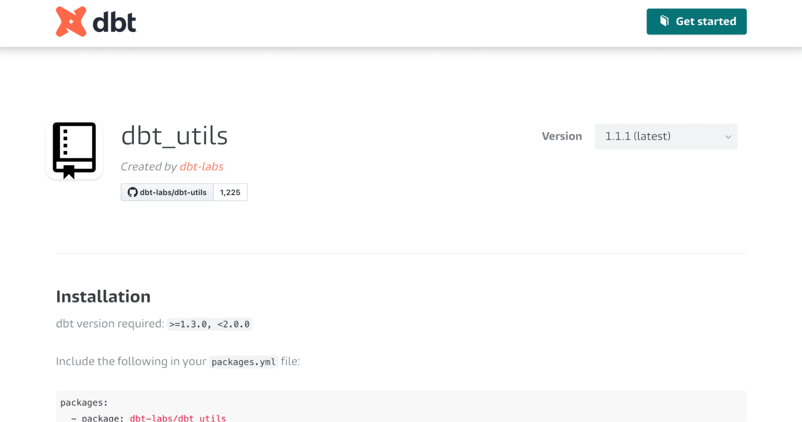
dbt-utils 包
dbt-utils 是 dbt 中的一个包,提供了一套预构建宏,用于增强 dbt 项目的功能。dbt-utils 通过增加抽象层来降低复杂度,从而实现更高效、更一致的数据转换。
如果您熟悉 Python 的库和 R 的包,dbt-utils 包与之类似。
借助这些针对常见结构化查询语言(SQL)操作的标准化宏,dbt-utils 让您无需从零开始编写所有转换代码的繁琐工作。
利用这些工具可以避免重复造轮子,将一组经社区验证的宏集成到您的项目中,提升可维护性,并促成最佳实践文化。
关键特性与功能
dbt-utils 提供多种功能,使数据转换更高效、更顺畅。包括:
1. 标准化宏
dbt-utils 使用 Jinja 模板为常见 SQL 操作(如连接、聚合、过滤等)提供了大量预构建宏。
这些宏是标准化的,确保跨项目的一致性,并减少重复编码的需求。
例如,以下是一些被分析工程师使用的宏:
date_spine:在两个指定日期之间创建连续的日期序列,适用于时间序列分析。pivot:将行动态转换为列,简化交叉表操作。star:从模型中指定的表获取所有字段,并排除 except 参数中列出的字段。union_relations:使用 union all 合并多个结构相同的关系中的数据。generate_series:生成一系列数值数据,适合时间序列分析。surrogate_key:通过连接多个字段生成行的唯一标识符。
借助这些宏,SQL 可以完成原本复杂且重复的任务。
2. 架构与文档辅助
dbt-utils 为数据模型中的架构与文档管理提供了实用工具。这能更容易地跟踪变更并保持项目组织有序。
4. 测试能力
借助 dbt-utils,用户可以轻松编写测试,以确保数据转换的准确性与质量。这些测试可以自动化并集成到持续集成流程中,从而打造更高效、更可靠的数据管道。
为什么要使用 dbt-utils?
那么,为什么要使用这个包呢?
先来看看它的一些好处:
- 简化复杂 SQL:通过使用宏,dbt-utils 简化了复杂 SQL 查询的编写。这能为数据分析师与工程师节省时间和精力,让他们专注于更高层次的分析,而不是陷入代码细节。
- 高效文档化:如前所述,dbt-utils 有助于自动生成文档。
- 提高质量控制:通过将测试功能纳入数据管道,dbt-utils 有助于确保数据转换的准确性与可靠性。
- 自动化数据校验:借助 dbt-utils,可在开发过程中自动化数据校验。这样可以确保对数据模型的任何更改都能立即得到验证,并及早发现潜在问题。
- 开源:dbt-utils 是开源的,许多开发者都能为其贡献代码,这意味着该包会不断更新。
dbt-utils 的安装与设置
下面来看如何将 dbt-utils 包引入到您的数据工作流中。
前提条件
在使用 dbt-utils 之前,必须熟悉 SQL 并理解 dbt(data build tool)的基础知识。您应当已经初始化并配置好一个 dbt 项目。
如果需要复习,您可以查看我们的dbt 入门课程和dbt 教程。
此外,需要确保 dbt core 与 dbt-utils 包的版本匹配。建议检查 dbt 版本之间的兼容性,以避免冲突或使用到已弃用的功能。
分步安装
要开始将 dbt-utils 集成到您的数据技术栈中,首先确保您的开发环境已正确设置。
步骤 1:安装 dbt
首先,确保您的环境中已安装 dbt。您可以通过 pip 安装 dbt:
pip install dbt
技术支持
步骤 2:将 dbt-utils 添加到您的 dbt 项目
要安装 dbt-utils,请在 dbt 项目根目录的 packages.yml 文件中添加以下内容。
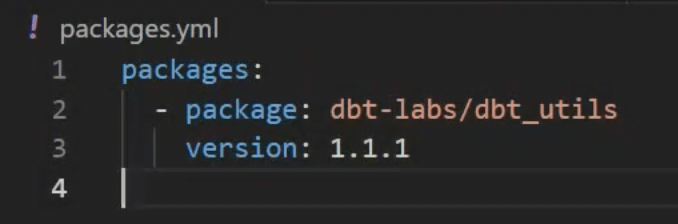
如果此文件不存在,请在 dbt 项目根目录创建该文件,并添加如下内容:
packages:
- package: dbt-labs/dbt_utils
version: "1.1.1" 技术支持
在这个 yaml 文件中,您也需要指定所需的包版本。请确保使用与您已安装的 dbt 版本兼容的最新版本。
步骤 3:安装该包
修改完成后,只需一条命令即可安装。
成功执行该命令将获取并安装 dbt-utils,为增强功能做好准备。
在 dbt 项目目录的终端中运行以下命令:
dbt deps技术支持
此命令会安装 packages.yml 中列出的所有包。
dbt-utils 的关键工具及其应用
dbt-utils 包提供了一组常用的辅助函数,用于简化 dbt 项目中的 SQL 转换。
这些函数帮助开发者避免冗余,专注于各自独特的业务逻辑。
以下是 dbt-utils 中的一些功能:
1. SQL 生成器
dbt-utils 中的 SQL 生成器有助于创建模块化的 SQL 代码。
例如,deduplicate 宏非常适合在保持数据顺序的同时消除重复行。可从模型、表甚至公共表表达式(CTE)中去重。
2. 通用测试
通用测试用于验证表或视图中的数据。它们可以轻松定制以满足特定需求,并为所处理数据的质量提供有价值的洞察。
例如,expression_is_true 宏用于检查某个表达式是否为真。它可灵活用于验证多种条件,例如:
3. Jinja 助手
Jinja 助手用于创建可根据用户输入或变量数据轻松定制的动态 SQL 查询。它们允许在 SQL 语句中使用条件逻辑和循环。
Jinja 模板用于定义和指定这些宏。
例如,pretty_time 宏会返回当前时间戳的字符串。
4. Web 宏
Web 宏与 Jinja 助手类似,但它们专为基于 Web 的项目设计。它们可以实现动态 HTML 的生成和处理,更容易创建交互式与响应式的网页。
一个实用的宏是 get_url_path,用于获取 URL 的页面路径。其语法如下:
{{ dbt_utils.get_url_path(field='page_url') }}技术支持
5. 自省宏
自省宏是指能够访问并处理当前作用域内数据的宏。这允许进行动态且高效的数据处理,减少对额外函数或代码的需求。
例如,get_column_values 宏会将查询结果作为对象返回。
dbt utils 的实践用例
用例 1:简化复杂查询
示例场景:某公司拥有包含客户信息、交易数据和产品数据的大型数据集。他们需要创建一份报告,显示过去一个季度各产品类别的总销售额。
他们无需编写复杂的 SQL 查询来连接多张表并计算各类别的销售额,而是可以使用 dbt utils 轻松提取相关数据,并在其宏或模型中进行处理。
例如,他们可以使用 get_filtered_columns_in_relation 仅筛选与产品数据相关的必要列,然后使用 sum 宏计算各类别的总销售额。
这样可简化流程、提高效率,节省时间并减少错误。
代码实现:
要在一个模拟数据库中实现此方案,您可以按以下步骤进行:
使用 get_filtered_columns_in_relation 宏仅从产品数据中筛选必要的列。此宏可帮助您高效选择相关列。
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
)
select * from product_data技术支持
接下来,创建一个模型来连接产品、交易和客户数据。然后使用 sum 函数计算过去一个季度各产品类别的总销售额。
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
),
transaction_data as (
select
product_id,
sale_amount,
transaction_date
from {{ ref('transactions') }}
where transaction_date >= date_trunc('quarter', current_date) - interval '1 quarter'
),
joined_data as (
select
p.category,
t.sale_amount
from product_data p
join transaction_data t
on p.product_id = t.product_id
)
select
category,
sum(sale_amount) as total_sales
from joined_data
group by category技术支持
定义模型后,运行 dbt 模型以执行转换并生成报告。
dbt run技术支持
以下是上述代码的说明:
get_filtered_columns_in_relation 宏有助于仅从 products 表中选择必要的列(product_id 和 category),从而简化数据集。
随后,将筛选后的产品数据与交易数据进行 SQL 连接,以获取每个产品的销售额。然后使用 sum 聚合函数计算最近一个季度各产品类别的总销售额。
用例 2:通过通用测试确保数据质量
示例场景:
在此用例中,我们将继续使用用例 1 中的同一模拟数据集。不过,这次我们的目标不是创建报告,而是通过对数据运行通用测试来确保数据质量。
代码实现:
以下是为您的数据集实现这些测试的示例:
1. 测试空值占比
在此通用测试中,我们将仅断言符合我们指定非空占比的值。我们将使用 not_null_proportion 测试。
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_null_proportion:
at_least: 0.95技术支持
在此示例中,我们添加了一个可选参数 at_least,将非空占比设置为最大 0.95。
2. 测试空字符串字段
在此示例中,我们将使用 not_empty_string 测试检查 product_id 字段中的空字符串。
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_empty_string技术支持
3. 测试参照完整性
使用 relationships_where 函数将确保 transactions 表中的每个 product_id 都存在于 products 表中。
version: 2
models:
- name: transactions
columns:
- name: product_id
tests:
- dbt_utils.relationships_where:
to: ref('products')
field: product_id技术支持
在此示例中,我们确保 transactions 表中的所有 product_id 值都对应于 表中的有效条目。这是一次基础的关系完整性检查。
请注意,您也可以同时组合多个测试,以覆盖多项完整性检查。
当所有测试都在您的 yaml 配置文件中定义好后,使用 dbt test 命令执行所有定义的架构测试。
dbt test技术支持
dbt utils 的最佳实践
高效利用 dbt-utils
使用 dbt 时,遵循最佳实践对于确保项目高效、有效运行非常重要。使用 dbt-utils 时,请牢记以下要点:
- 合并多个测试,而非分别定义:如前所述,您可以将多个测试合并为一个测试语句。这有助于减少冗余并改善项目整体性能。
- 创建代理键时使用 dbt_utils.surrogate_key 宏:该宏会基于表中的其他列自动生成代理键,为您节省时间和精力。
常见陷阱及规避方法
以下是使用 dbt-utils 时可能遇到的一些常见陷阱及其规避建议:
- 未正确配置自定义宏:如果您要创建自定义宏,请确保在将其纳入项目之前已正确配置并经过测试。
- 未更新至 dbt-utils 最新版本:务必定期更新至 dbt-utils 的最新版本,以便利用新功能与错误修复。
结论
dbt-utils 是一款用于简化、测试和自动化数据建模流程任务的强大工具。它是使用 dbt 的重要组成部分,能在数据模型开发中为您节省时间与精力。
您或许还会觉得这个dbt 教程或这份可替代的数据工程工具清单有用。
如果您有兴趣开始使用 dbt,并希望获得进一步学习,也可以探索我们的dbt 入门课程!


dbt-utils 包是一款强大的工具集,可简化并增强您的数据转换流程。在本指南中,我们将向您介绍 dbt-utils,并展示它如何通过面向常见 SQL 操作的预构建宏来优化您的工作流。
什么是 dbt-utils?
dbt-utils 包
dbt-utils 是 dbt 中的一个包,提供了一套预构建宏,用于增强 dbt 项目的功能。dbt-utils 通过增加抽象层来降低复杂度,从而实现更高效、更一致的数据转换。
如果您熟悉 Python 的库和 R 的包,dbt-utils 包与之类似。
借助这些针对常见结构化查询语言(SQL)操作的标准化宏,dbt-utils 让您无需从零开始编写所有转换代码的繁琐工作。
利用这些工具可以避免重复造轮子,将一组经社区验证的宏集成到您的项目中,提升可维护性,并促成最佳实践文化。
关键特性与功能
dbt-utils 提供多种功能,使数据转换更高效、更顺畅。包括:
1. 标准化宏
dbt-utils 使用 Jinja 模板为常见 SQL 操作(如连接、聚合、过滤等)提供了大量预构建宏。
这些宏是标准化的,确保跨项目的一致性,并减少重复编码的需求。
例如,以下是一些被分析工程师使用的宏:
date_spine:在两个指定日期之间创建连续的日期序列,适用于时间序列分析。pivot:将行动态转换为列,简化交叉表操作。star:从模型中指定的表获取所有字段,并排除except参数中列出的字段。union_relations:使用union all合并多个结构相同的关系中的数据。generate_series:生成一系列数值数据,适合时间序列分析。surrogate_key:通过连接多个字段生成行的唯一标识符。借助这些宏,SQL 可以完成原本复杂且重复的任务。
2. 架构与文档辅助
dbt-utils 为数据模型中的架构与文档管理提供了实用工具。这能更容易地跟踪变更并保持项目组织有序。
4. 测试能力
借助 dbt-utils,用户可以轻松编写测试,以确保数据转换的准确性与质量。这些测试可以自动化并集成到持续集成流程中,从而打造更高效、更可靠的数据管道。
为什么要使用 dbt-utils?
那么,为什么要使用这个包呢?
先来看看它的一些好处:
dbt-utils 的安装与设置
下面来看如何将 dbt-utils 包引入到您的数据工作流中。
前提条件
在使用 dbt-utils 之前,必须熟悉 SQL 并理解 dbt(data build tool)的基础知识。您应当已经初始化并配置好一个 dbt 项目。
如果需要复习,您可以查看我们的dbt 入门课程和dbt 教程。
此外,需要确保 dbt core 与 dbt-utils 包的版本匹配。建议检查 dbt 版本之间的兼容性,以避免冲突或使用到已弃用的功能。
分步安装
要开始将 dbt-utils 集成到您的数据技术栈中,首先确保您的开发环境已正确设置。
步骤 1:安装 dbt
首先,确保您的环境中已安装 dbt。您可以通过 pip 安装 dbt:
步骤 2:将 dbt-utils 添加到您的 dbt 项目
要安装 dbt-utils,请在 dbt 项目根目录的 packages.yml 文件中添加以下内容。
如果此文件不存在,请在 dbt 项目根目录创建该文件,并添加如下内容:
在这个 yaml 文件中,您也需要指定所需的包版本。请确保使用与您已安装的 dbt 版本兼容的最新版本。
步骤 3:安装该包
修改完成后,只需一条命令即可安装。
成功执行该命令将获取并安装 dbt-utils,为增强功能做好准备。
在 dbt 项目目录的终端中运行以下命令:
此命令会安装 packages.yml 中列出的所有包。
dbt-utils 的关键工具及其应用
dbt-utils 包提供了一组常用的辅助函数,用于简化 dbt 项目中的 SQL 转换。
这些函数帮助开发者避免冗余,专注于各自独特的业务逻辑。
以下是 dbt-utils 中的一些功能:
1. SQL 生成器
dbt-utils 中的 SQL 生成器有助于创建模块化的 SQL 代码。
例如,
deduplicate宏非常适合在保持数据顺序的同时消除重复行。可从模型、表甚至公共表表达式(CTE)中去重。2. 通用测试
通用测试用于验证表或视图中的数据。它们可以轻松定制以满足特定需求,并为所处理数据的质量提供有价值的洞察。
例如,
expression_is_true宏用于检查某个表达式是否为真。它可灵活用于验证多种条件,例如:3. Jinja 助手
Jinja 助手用于创建可根据用户输入或变量数据轻松定制的动态 SQL 查询。它们允许在 SQL 语句中使用条件逻辑和循环。
Jinja 模板用于定义和指定这些宏。
例如,
pretty_time宏会返回当前时间戳的字符串。4. Web 宏
Web 宏与 Jinja 助手类似,但它们专为基于 Web 的项目设计。它们可以实现动态 HTML 的生成和处理,更容易创建交互式与响应式的网页。
一个实用的宏是
get_url_path,用于获取 URL 的页面路径。其语法如下:5. 自省宏
自省宏是指能够访问并处理当前作用域内数据的宏。这允许进行动态且高效的数据处理,减少对额外函数或代码的需求。
例如,
get_column_values宏会将查询结果作为对象返回。dbt utils 的实践用例
用例 1:简化复杂查询
示例场景:某公司拥有包含客户信息、交易数据和产品数据的大型数据集。他们需要创建一份报告,显示过去一个季度各产品类别的总销售额。
他们无需编写复杂的 SQL 查询来连接多张表并计算各类别的销售额,而是可以使用 dbt utils 轻松提取相关数据,并在其宏或模型中进行处理。
例如,他们可以使用
get_filtered_columns_in_relation仅筛选与产品数据相关的必要列,然后使用 sum 宏计算各类别的总销售额。这样可简化流程、提高效率,节省时间并减少错误。
代码实现:
要在一个模拟数据库中实现此方案,您可以按以下步骤进行:
使用
get_filtered_columns_in_relation宏仅从产品数据中筛选必要的列。此宏可帮助您高效选择相关列。接下来,创建一个模型来连接产品、交易和客户数据。然后使用 sum 函数计算过去一个季度各产品类别的总销售额。
定义模型后,运行 dbt 模型以执行转换并生成报告。
以下是上述代码的说明:
get_filtered_columns_in_relation宏有助于仅从 products 表中选择必要的列(product_id 和 category),从而简化数据集。随后,将筛选后的产品数据与交易数据进行 SQL 连接,以获取每个产品的销售额。然后使用 sum 聚合函数计算最近一个季度各产品类别的总销售额。
用例 2:通过通用测试确保数据质量
示例场景:
在此用例中,我们将继续使用用例 1 中的同一模拟数据集。不过,这次我们的目标不是创建报告,而是通过对数据运行通用测试来确保数据质量。
代码实现:
以下是为您的数据集实现这些测试的示例:
1. 测试空值占比
在此通用测试中,我们将仅断言符合我们指定非空占比的值。我们将使用
not_null_proportion测试。在此示例中,我们添加了一个可选参数
at_least,将非空占比设置为最大 0.95。2. 测试空字符串字段
在此示例中,我们将使用
not_empty_string测试检查product_id字段中的空字符串。3. 测试参照完整性
使用
relationships_where函数将确保 transactions 表中的每个product_id都存在于 products 表中。在此示例中,我们确保
transactions表中的所有product_id值都对应于 表中的有效条目。这是一次基础的关系完整性检查。请注意,您也可以同时组合多个测试,以覆盖多项完整性检查。
当所有测试都在您的 yaml 配置文件中定义好后,使用 dbt test 命令执行所有定义的架构测试。
dbt utils 的最佳实践
高效利用 dbt-utils
使用 dbt 时,遵循最佳实践对于确保项目高效、有效运行非常重要。使用 dbt-utils 时,请牢记以下要点:
常见陷阱及规避方法
以下是使用 dbt-utils 时可能遇到的一些常见陷阱及其规避建议:
结论
dbt-utils 是一款用于简化、测试和自动化数据建模流程任务的强大工具。它是使用 dbt 的重要组成部分,能在数据模型开发中为您节省时间与精力。
您或许还会觉得这个dbt 教程或这份可替代的数据工程工具清单有用。
如果您有兴趣开始使用 dbt,并希望获得进一步学习,也可以探索我们的dbt 入门课程!