

Cursus
Introductie tot dbt
4 uur
34.5K
Oefen en volg je voortgang.
Ga Verder Met GoogleHet dbt-utils-pakket is een krachtige toolset die je datatransformatieprocessen vereenvoudigt en versterkt. In deze gids maken we je wegwijs in dbt-utils en laten we zien hoe je met de kant-en-klare macro’s voor veelvoorkomende SQL-bewerkingen je workflow kunt stroomlijnen.
dbt-utils-pakket
dbt-utils is een pakket in dbt dat een toolkit met kant-en-klare macro’s biedt om de functionaliteit van dbt-projecten uit te breiden. dbt-utils vermindert complexiteit door abstractielagen toe te voegen, waardoor datatransformatie efficiënter en consistenter wordt.
Als je bekend bent met bibliotheken in Python en packages in R, dan lijkt het dbt-utils-pakket daarop.
Met deze gestandaardiseerde macro’s voor veelvoorkomende Structured Query Language (SQL)-bewerkingen hoef je al het zware werk van transformaties vanaf nul coderen niet meer te doen.
Door deze utilities te gebruiken, hoef je het wiel niet opnieuw uit te vinden: je integreert een reeks community-geteste macro’s in je projecten, wat de onderhoudbaarheid verbetert en best practices stimuleert.
dbt-utils biedt allerlei features en functionaliteiten die datatransformaties efficiënter en gestroomlijnder maken. Denk aan:
dbt-utils biedt een breed scala aan kant-en-klare macro’s voor veelvoorkomende SQL-bewerkingen met Jinja-templating, zoals joins, aggregaties, filtering en meer.
Deze macro’s zijn gestandaardiseerd om consistentie over projecten heen te waarborgen en herhalend codeerwerk te verminderen.
Enkele voorbeelden van macro’s die analytics engineers gebruiken:
date_spine: Maakt een aaneengesloten reeks datums tussen twee opgegeven datums, handig voor tijdreeksanalyse.pivot: Zet rijen dynamisch om naar kolommen, wat kruistabellen vereenvoudigt.star: Haalt alle velden op uit opgegeven tabellen in het model, behalve die in het except-argument.union_relations: Combineert data uit meerdere relaties met dezelfde structuur via een union all.generate_series: Maakt een reeks numerieke data, handig voor tijdreeksanalyse.surrogate_key: Genereert een unieke sleutel voor rijen door meerdere velden te concatenaten.Met deze macro’s kan SQL taken uitvoeren die anders complex en repetitief zijn.
dbt-utils biedt handige tools voor het beheren van schema’s en documentatie binnen datamodellen. Zo houd je wijzigingen gemakkelijker bij en blijft je project georganiseerd.
Met dbt-utils kun je eenvoudig tests schrijven om de nauwkeurigheid en kwaliteit van je datatransformaties te waarborgen. Deze tests kun je automatiseren en integreren in continuous integration-processen, wat leidt tot efficiëntere en betrouwbaardere datapijplijnen.
Waarom zou je dit pakket gebruiken?
Laten we eerst enkele voordelen bekijken:
Kijken we nu hoe je het dbt-utils-pakket aan je dataworkflow toevoegt.
Voordat je dbt-utils gebruikt, is vertrouwdheid met SQL en inzicht in de basis van dbt (data build tool) essentieel. Je zou al een dbt-project moeten hebben geïnitialiseerd en geconfigureerd.
Heb je een opfrisser nodig, bekijk dan onze Introduction to dbt-cursus en de dbt-tutorial.
Daarnaast is het belangrijk dat de versies van je dbt core en het dbt-utils-pakket op elkaar zijn afgestemd. Controleer de compatibiliteit tussen dbt-versies om conflicten of verouderde functionaliteit te voorkomen.
Zorg er eerst voor dat je ontwikkelomgeving correct is ingesteld om dbt-utils te integreren in je datastack.
Zorg er eerst voor dat dbt in je omgeving is geïnstalleerd. Je kunt dbt installeren via pip:
pip install dbt
Om dbt-utils te installeren, voeg je het volgende toe aan je packages.yml-bestand in de hoofdmap van je dbt-project.
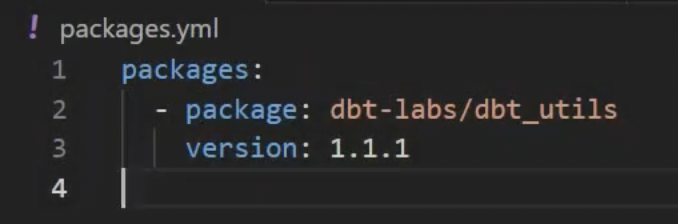
Maak dit bestand aan in de hoofdmap van je dbt-project als het nog niet bestaat, en voeg het volgende toe:
packages:
- package: dbt-labs/dbt_utils
version: "1.1.1" # Use the latest version compatible with your dbt version
In dit yaml-bestand specificeer je ook de benodigde pakketversie. Gebruik de meest recente versie die compatibel is met jouw geïnstalleerde dbt-versie.
Na je wijziging is de installatie nog maar één commando.
Als dit commando succesvol wordt uitgevoerd, haalt het dbt-utils op en installeert het, zodat je klaar bent voor extra functionaliteit.
Voer het volgende commando uit in je terminal binnen de map van je dbt-project:
dbt depsDit commando installeert alle pakketten die in je packages.yml staan.
Het dbt-utils-pakket bevat een set veelvoorkomende helperfuncties die SQL-transformaties binnen dbt-projecten stroomlijnen.
Dankzij deze functies vermijden developers herhaling en kunnen ze zich richten op de unieke businesslogica.
Een greep uit de functies in dbt-utils:
SQL-generators in dbt-utils zijn handig om modulaire SQL-code te maken.
Zo zijn de deduplicate-macro’s uitstekend om dubbele rijen te verwijderen met behoud van de volgorde van de data. Duplicaten kunnen worden verwijderd uit modellen, tabellen en zelfs Common Table Expressions (CTE’s).
Generieke tests worden gebruikt om data in een tabel of view te valideren. Je kunt ze eenvoudig aanpassen aan specifieke eisen en ze geven waardevol inzicht in de kwaliteit van de verwerkte data.
Zo controleert de expression_is_true-macro of een bepaalde expressie waar is. Je kunt dit flexibel inzetten om meerdere voorwaarden te verifiëren, zoals:
Jinja-helpers zijn handig voor het maken van dynamische SQL-queries die je eenvoudig kunt aanpassen op basis van gebruikersinvoer of variabele data. Ze maken voorwaardelijke logica en lussen binnen SQL-statements mogelijk.
Jinja-templates worden gebruikt om deze macro’s te definiëren en te specificeren.
Een voorbeeld is de pretty_time-macro, die een string met de huidige timestamp teruggeeft.
Webmacro’s lijken op Jinja-helpers, maar zijn specifiek ontworpen voor webprojecten. Ze maken dynamische HTML-generatie en -manipulatie mogelijk, waardoor interactieve en responsieve webpagina’s eenvoudiger te bouwen zijn.
Een nuttige macro is get_url_path, die het pad van de pagina-URL ophaalt. Zo ziet de syntax eruit:
{{ dbt_utils.get_url_path(field='page_url') }}Introspectieve macro’s zijn macro’s die toegang hebben tot en data kunnen manipuleren binnen de huidige scope. Dit maakt dynamische en efficiënte dataverwerking mogelijk en vermindert de behoefte aan extra functies of code.
Een voorbeeld is de get_column_values-macro, die de queryresultaten als een object teruggeeft.
Voorbeeldscenario: Een bedrijf heeft een grote dataset met klantinformatie, transactiegegevens en productdata. Ze moeten een rapport maken met de totale omzet per productcategorie in het afgelopen kwartaal.
In plaats van complexe SQL-queries te schrijven om meerdere tabellen te joinen en de omzet per categorie te berekenen, kunnen ze dbt-utils gebruiken om eenvoudig relevante data te extraheren en die te bewerken binnen hun macro’s of modellen.
Zo kunnen ze get_filtered_columns_in_relation gebruiken om alleen de noodzakelijke kolommen met betrekking tot productdata te selecteren en vervolgens een sum-macro gebruiken om de totale omzet per categorie te berekenen.
Dit vereenvoudigt het proces, maakt het efficiënter en bespaart tijd en fouten.
Code-implementatie:
Om deze oplossing in een mockdatabase te implementeren, volg je deze stappen:
Gebruik de get_filtered_columns_in_relation-macro om alleen de noodzakelijke kolommen uit de productdata te filteren. Deze macro helpt je efficiënt relevante kolommen te selecteren.
-- models/product_data_filtered.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
)
select * from product_data
Maak vervolgens een model om de product-, transactie- en klantdata te joinen. Gebruik daarna de sum-functie om de totale omzet per productcategorie in het afgelopen kwartaal te berekenen.
-- models/total_sales_by_category.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
),
transaction_data as (
select
product_id,
sale_amount,
transaction_date
from {{ ref('transactions') }}
where transaction_date >= date_trunc('quarter', current_date) - interval '1 quarter'
),
joined_data as (
select
p.category,
t.sale_amount
from product_data p
join transaction_data t
on p.product_id = t.product_id
)
select
category,
sum(sale_amount) as total_sales
from joined_data
group by category
Nadat je de modellen hebt gedefinieerd, voer je de dbt-modellen uit om de transformaties te draaien en het rapport te genereren.
dbt runToelichting op de code hierboven:
De get_filtered_columns_in_relation-macro helpt om alleen de nodige kolommen (product_id en category) uit de products-tabel te selecteren, waardoor de dataset eenvoudiger wordt.
Vervolgens wordt de gefilterde productdata met SQL gejoint met de transactiedata om de omzetbedragen per product te verkrijgen. Daarna wordt met de sum-aggregatiefunctie de totale omzet per productcategorie binnen het afgelopen kwartaal berekend.
Voorbeeldscenario:
In deze use case werken we verder met dezelfde mockdataset uit Use Case 1. Maar in plaats van een rapport te maken, willen we de datakwaliteit borgen door generieke tests op de data te draaien.
Code-implementatie:
Hieronder vind je voorbeelden van hoe je deze tests voor je dataset kunt implementeren:
In deze generieke test staan we alleen waarden toe die passen binnen het niet-null-aandeel dat we specificeren. We gebruiken hiervoor de not_null_proportion-test.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_null_proportion:
at_least: 0.95
In dit voorbeeld hebben we een extra optioneel argument at_least toegevoegd om het niet-null-aandeel in te stellen op maximaal 0,95.
In dit voorbeeld gebruiken we de not_empty_string-test om te controleren op lege strings in het veld product_id.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_empty_stringMet de functie relationships_where zorgen we ervoor dat elke product_id in de transactions-tabel bestaat in de products-tabel.
# models/transactions.yml
version: 2
models:
- name: transactions
columns:
- name: product_id
tests:
- dbt_utils.relationships_where:
to: ref('products')
field: product_id
In dit voorbeeld zorgen we ervoor dat alle product_id-waarden in de tabel transactions overeenkomen met geldige entries in de tabel. Dit is een basiscontrole van relationele integriteit.
Let op dat je ook meerdere tests tegelijk kunt combineren, zodat je diverse integriteitscontroles dekt.
Zodra alle tests in je yaml-configbestand zijn gedefinieerd, gebruik je het commando dbt test om alle gedefinieerde schematests uit te voeren.
dbt testWanneer je dbt gebruikt, is het belangrijk best practices te volgen om je project efficiënt en effectief te laten draaien. Bij het gebruik van dbt-utils zijn er een paar aandachtspunten:
Hier zijn enkele veelvoorkomende valkuilen bij het gebruik van dbt-utils, met tips om ze te vermijden:
dbt-utils is een krachtige tool om taken in je datamodelleerproces te stroomlijnen, te testen en te automatiseren. Het is een essentieel onderdeel van het werken met dbt en kan je tijd en moeite besparen bij het ontwikkelen van je datamodellen.
Misschien vind je deze dbt-tutorial of deze lijst met alternatieve data-engineeringtools ook nuttig.
Ben je geïnteresseerd om met dbt aan de slag te gaan en wil je verder leren, bekijk dan ook onze Introduction to dbt Course!
Zet je dbt-leerreis vandaag voort!
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

