

Corso
Introduzione a dbt
4 ore
34.5K
Pratica and corso your progress.
Continua Con GoogleIl pacchetto dbt-utils è una potente toolkit che semplifica e migliora i tuoi processi di trasformazione dei dati. In questa guida ti presenteremo dbt-utils, mostrando come può snellire il tuo flusso di lavoro grazie alle sue macro predefinite per le operazioni SQL più comuni.
Pacchetto dbt-utils
dbt-utils è un pacchetto per dbt che fornisce una raccolta di macro predefinite in grado di estendere le funzionalità dei progetti dbt. dbt-utils riduce la complessità aggiungendo livelli di astrazione, consentendo trasformazioni dati più efficienti e coerenti.
Se hai familiarità con le librerie in Python e i pacchetti in R, dbt-utils è qualcosa di analogo.
Con queste macro standardizzate per le comuni operazioni in Structured Query Language (SQL), dbt-utils fa sì che non sia necessario affrontare da zero tutto il lavoro più impegnativo di codifica delle trasformazioni.
Sfruttare queste utility evita di reinventare la ruota, integrando nei tuoi progetti una suite di macro validate dalla community, migliorando la manutenibilità e promuovendo le buone pratiche.
dbt-utils offre diverse funzionalità che rendono la trasformazione dei dati più efficiente e lineare. Tra queste:
dbt-utils mette a disposizione un’ampia gamma di macro predefinite per le comuni operazioni SQL usando il templating Jinja, come join, aggregazioni, filtri e altro.
Queste macro sono standardizzate per garantire coerenza tra progetti e ridurre la necessità di codice ripetitivo.
Ecco, ad esempio, alcune macro usate dagli analytics engineer:
date_spine: crea una sequenza continua di date tra due date specificate, utile per l’analisi delle serie temporali.pivot: trasforma dinamicamente le righe in colonne, semplificando le operazioni di crosstab.star: recupera tutti i campi dalle tabelle specificate nel modello, escludendo quelli indicati nell’argomento except.union_relations: combina dati da più relazioni con la stessa struttura usando un union all.generate_series: genera una serie di dati numerici, utile per le serie temporali.surrogate_key: produce un identificatore univoco per le righe concatenando più campi.Con queste macro, SQL può portare a termine compiti altrimenti complessi e ripetitivi.
dbt-utils fornisce strumenti utili per gestire gli schemi e la documentazione all’interno dei modelli dati. Ciò rende più semplice tracciare le modifiche e mantenere l’organizzazione nei progetti.
Con dbt-utils puoi facilmente scrivere test per garantire accuratezza e qualità delle trasformazioni dati. Questi test possono essere automatizzati e integrati nei processi di continuous integration, rendendo le pipeline dati più efficienti e affidabili.
Perché usare questo pacchetto?
Diamo prima un’occhiata ad alcuni vantaggi:
Vediamo come introdurre il pacchetto dbt-utils nel tuo flusso di lavoro sui dati.
Prima di usare dbt-utils, è fondamentale avere familiarità con SQL e comprendere i fondamenti di dbt (data build tool). Dovresti già avere un progetto dbt inizializzato e configurato.
Se ti serve un ripasso, dai un’occhiata al nostro corso Introduzione a dbt e al tutorial su dbt.
Inoltre, è necessario allineare correttamente le versioni tra il tuo dbt core e il pacchetto dbt-utils. È consigliabile verificare la compatibilità tra le versioni di dbt per evitare conflitti o funzionalità deprecate.
Per iniziare a integrare dbt-utils nel tuo stack dati, assicurati innanzitutto che l’ambiente di sviluppo sia configurato correttamente.
Per prima cosa verifica che dbt sia installato nel tuo ambiente. Puoi installare dbt con pip:
pip install dbt
Per installare dbt-utils, aggiungi quanto segue al file packages.yml nella directory radice del tuo progetto dbt.
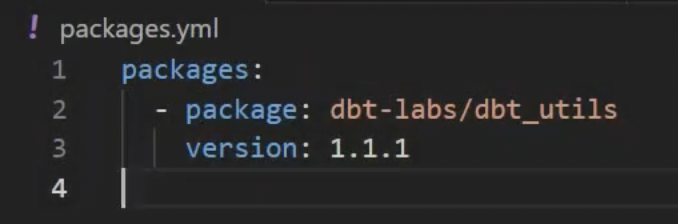
Crea questo file nella root del progetto dbt se non esiste e aggiungi quanto segue:
packages:
- package: dbt-labs/dbt_utils
version: "1.1.1" # Use the latest version compatible with your dbt version
In questo file yaml specificherai anche la versione necessaria del pacchetto. Assicurati di usare l’ultima versione compatibile con la tua versione di dbt installata.
Dopo la modifica, l’installazione è a un solo comando di distanza.
L’esecuzione corretta di questo comando scaricherà e installerà dbt-utils, preparandoti a funzionalità avanzate.
Esegui il seguente comando nel terminale all’interno della directory del tuo progetto dbt:
dbt depsQuesto comando installa tutti i pacchetti elencati in packages.yml.
Il pacchetto dbt-utils fornisce una suite di funzioni di supporto comuni che semplificano le trasformazioni SQL all’interno dei progetti dbt.
Queste funzioni aiutano gli sviluppatori a evitare ridondanze e a concentrarsi sulla logica di business specifica.
Ecco alcune funzioni di dbt-utils:
I generator di SQL in dbt-utils sono utili per creare codice SQL modulare.
Ad esempio, le macro deduplicate sono ottime per eliminare le righe duplicate mantenendo l’ordine dei dati. I duplicati possono essere rimossi da modelli, tabelle e persino Common Table Expressions (CTE).
I test generici servono a validare i dati in una tabella o in una vista. Possono essere facilmente personalizzati in base a requisiti specifici e offrono informazioni preziose sulla qualità dei dati elaborati.
Per esempio, la macro expression_is_true verifica che una certa espressione sia vera. Può essere usata in modo flessibile per controllare diverse condizioni, come:
Gli helper Jinja sono utili per creare query SQL dinamiche, facilmente personalizzabili in base all’input dell’utente o a dati variabili. Consentono logica condizionale e cicli all’interno delle istruzioni SQL.
I template Jinja sono usati per definire e specificare queste macro.
Un esempio è la macro pretty_time, che restituisce una stringa con il timestamp corrente.
Le macro web sono simili agli helper Jinja, ma sono progettate specificamente per progetti web. Consentono la generazione e la manipolazione dinamica di HTML, semplificando la creazione di pagine web interattive e responsive.
Una macro utile è get_url_path, che ricava il path della pagina dall’URL. Ecco com’è la sintassi:
{{ dbt_utils.get_url_path(field='page_url') }}Le macro introspettive sono macro che possono accedere e manipolare i dati all’interno dell’ambito corrente. Ciò consente un’elaborazione dei dati dinamica ed efficiente, riducendo la necessità di funzioni o codice aggiuntivi.
Un esempio è la macro get_column_values, che restituisce i risultati della query come oggetto.
Scenario di esempio: un’azienda ha un ampio dataset con informazioni sui clienti, dati sulle transazioni e dati sui prodotti. Deve creare un report che mostri le vendite totali per ciascuna categoria di prodotto nell’ultimo trimestre.
Invece di scrivere query SQL complesse per fare join di più tabelle e calcolare le vendite per categoria, può usare dbt-utils per estrarre facilmente i dati rilevanti e manipolarli all’interno delle macro o dei modelli.
Per esempio, può usare get_filtered_columns_in_relation per filtrare solo le colonne necessarie relative ai dati dei prodotti e poi usare la macro di somma per calcolare le vendite totali per categoria.
Questo semplifica il processo e lo rende più efficiente, facendo risparmiare tempo e riducendo gli errori.
Implementazione del codice:
Per implementare questa soluzione in un database di esempio, puoi seguire questi passaggi:
Usa la macro get_filtered_columns_in_relation per filtrare solo le colonne necessarie dai dati dei prodotti. Questa macro ti aiuterà a selezionare in modo efficiente le colonne rilevanti.
-- models/product_data_filtered.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
)
select * from product_data
Poi crea un modello per fare il join dei dati di prodotto, transazione e cliente. Quindi usa la funzione di somma per calcolare le vendite totali per ciascuna categoria di prodotto nell’ultimo trimestre.
-- models/total_sales_by_category.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
),
transaction_data as (
select
product_id,
sale_amount,
transaction_date
from {{ ref('transactions') }}
where transaction_date >= date_trunc('quarter', current_date) - interval '1 quarter'
),
joined_data as (
select
p.category,
t.sale_amount
from product_data p
join transaction_data t
on p.product_id = t.product_id
)
select
category,
sum(sale_amount) as total_sales
from joined_data
group by category
Dopo aver definito i modelli, esegui i modelli dbt per applicare le trasformazioni e generare il report.
dbt runEcco una spiegazione del codice sopra:
La macro get_filtered_columns_in_relation aiuta a selezionare solo le colonne necessarie (product_id and category) dalla tabella products, semplificando il dataset.
Successivamente, i dati filtrati dei prodotti vengono uniti ai dati delle transazioni tramite SQL per ottenere gli importi delle vendite per ciascun prodotto. Quindi calcola le vendite totali per ogni categoria di prodotto nell’ultimo trimestre usando la funzione di aggregazione sum.
Scenario di esempio:
In questo caso d’uso continueremo a lavorare con lo stesso dataset di esempio del Caso d’uso 1. Tuttavia, invece di creare un report, l’obiettivo è garantire la qualità dei dati eseguendo test generici.
Implementazione del codice:
Di seguito alcuni esempi di come implementare questi test per il tuo dataset:
In questo test generico, accetteremo solo valori che rispettano la proporzione di non-null che specifichiamo. Lo faremo usando il test not_null_proportion.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_null_proportion:
at_least: 0.95
In questo esempio, abbiamo incluso un argomento opzionale aggiuntivo at_least per impostare la proporzione di non-null a un massimo di 0,95.
In questo esempio useremo il test not_empty_string per cercare stringhe vuote nel campo product_id.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_empty_stringUsando la funzione relationships_where ci assicuriamo che ogni product_id nella tabella delle transazioni esista nella tabella dei prodotti.
# models/transactions.yml
version: 2
models:
- name: transactions
columns:
- name: product_id
tests:
- dbt_utils.relationships_where:
to: ref('products')
field: product_id
In questo esempio, ci assicuriamo che tutti i valori di product_id nella tabella transactions corrispondano a voci valide nella tabella . Si tratta di un controllo di base dell’integrità delle relazioni.
Tieni presente che puoi anche combinare più test contemporaneamente per coprire diversi controlli di integrità.
Una volta definiti tutti i test nel file di configurazione yaml, usa il comando dbt test per eseguire tutti i test di schema definiti.
dbt testQuando usi dbt, è importante seguire le best practice per assicurarti che il tuo progetto giri in modo efficiente ed efficace. Con dbt-utils, tieni a mente alcuni punti chiave:
Ecco alcuni errori comuni che potresti incontrare usando dbt-utils, con suggerimenti per evitarli:
dbt-utils è uno strumento potente per semplificare, testare e automatizzare le attività nel tuo processo di modellazione dei dati. È una parte essenziale dell’uso di dbt e può farti risparmiare tempo e impegno nello sviluppo dei modelli dati.
Potrebbero esserti utili anche questo tutorial su dbt o questo elenco di strumenti alternativi per data engineering.
Se vuoi iniziare con dbt e ti serve ulteriore formazione, esplora anche il nostro corso Introduzione a dbt!
Continua oggi il tuo percorso di apprendimento su dbt!
Corso
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



