
Kurs
Einführung in dbt
4 Std.
33.5K
Das Paket dbt-utils ist ein leistungsstarkes Toolkit, das deine Datentransformationen vereinfacht und auf ein neues Niveau hebt. In diesem Leitfaden lernst du dbt-utils kennen und erfährst, wie vorgefertigte Makros für gängige SQL-Operationen deinen Workflow deutlich schlanker machen.
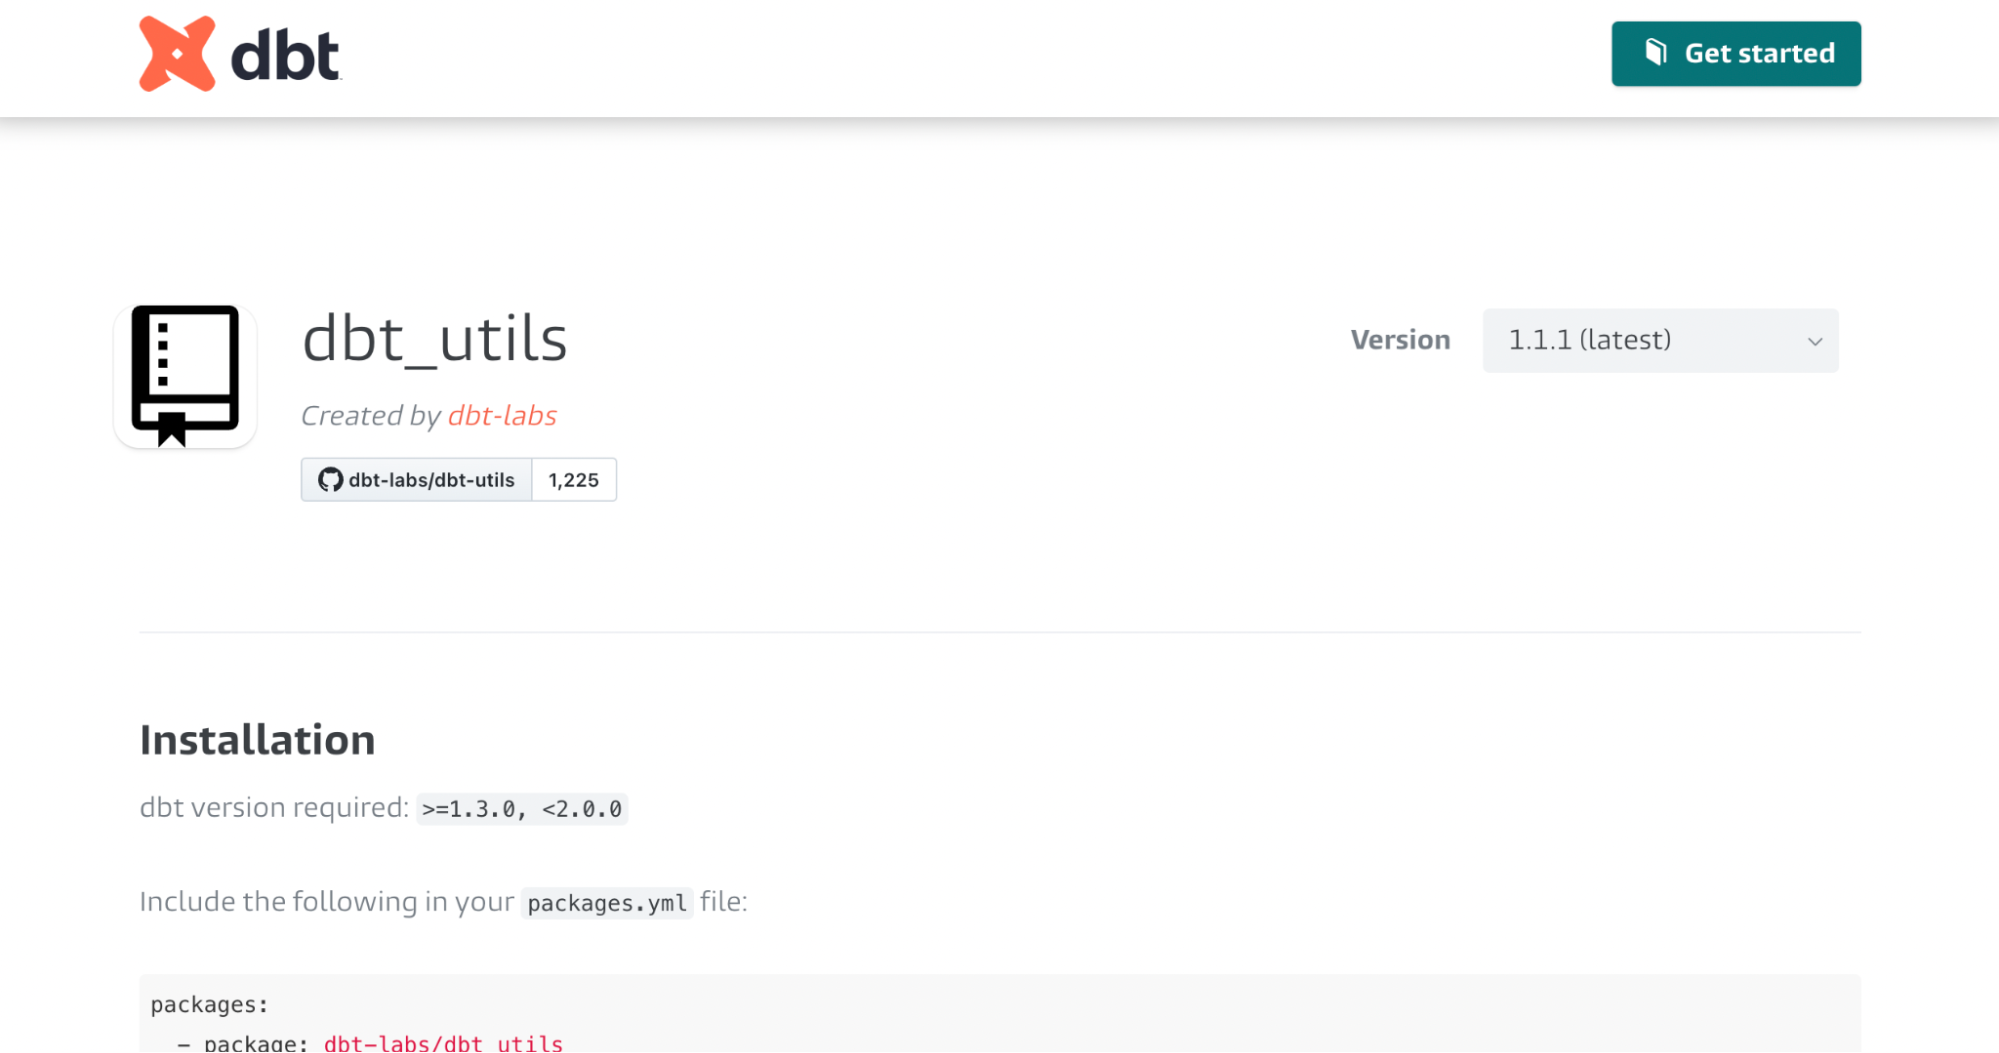
dbt-utils Paket
dbt-utils ist ein Paket in dbt, das eine Sammlung vorgefertigter Makros bereitstellt und so den Funktionsumfang von dbt-Projekten erweitert. dbt-utils reduziert Komplexität durch sinnvolle Abstraktionen und ermöglicht effizientere, konsistentere Datentransformationen.
Wenn du mit Bibliotheken in Python oder Packages in R vertraut bist, ist dbt-utils in etwa das Pendant in dbt.
Mit standardisierten Makros für häufige Structured Query Language (SQL)-Operationen entfällt das mühsame Coden aller Transformationen von Grund auf.
Durch diese Utilities musst du das Rad nicht neu erfinden: Du integrierst erprobte Community-Makros in deine Projekte, steigerst die Wartbarkeit und förderst Best Practices.
dbt-utils bietet eine Reihe an Funktionen, die Datentransformationen effizienter und reibungsloser machen. Dazu zählen:
dbt-utils stellt eine breite Palette vorgefertigter Makros für gängige SQL-Operationen mit Jinja-Templating bereit, zum Beispiel für Joins, Aggregationen, Filter und mehr.
Diese Makros sind standardisiert, um Konsistenz über Projekte hinweg zu sichern und redundantes Coding zu vermeiden.
Beispielsweise nutzen Analytics Engineers häufig folgende Makros:
date_spine: Erstellt eine lückenlose Folge von Daten zwischen zwei Stichtagen – ideal für Zeitreihenanalysen.pivot: Wandelt Zeilen dynamisch in Spalten um und vereinfacht Kreuztabellen.star: Holt alle Felder aus angegebenen Tabellen im Modell und schließt dabei die im Argument except genannten aus.union_relations: Führt Daten aus mehreren Relationen mit gleicher Struktur via union all zusammen.generate_series: Erstellt eine Zahlenreihe – nützlich u. a. für Zeitreihen.surrogate_key: Erzeugt einen eindeutigen Schlüssel pro Zeile, indem mehrere Felder verkettet werden.Mit diesen Makros lässt sich SQL für Aufgaben einsetzen, die sonst aufwendig und repetitiv wären.
dbt-utils bietet nützliche Tools zum Verwalten von Schemas und Dokumentation innerhalb deiner Datenmodelle. So behältst du Änderungen im Blick und sorgst für Struktur im Projekt.
Mit dbt-utils können Tests für die Genauigkeit und Qualität deiner Transformationen einfach geschrieben, automatisiert und in Continuous-Integration-Prozesse integriert werden. Das macht Datenpipelines effizienter und zuverlässiger.
Warum also dieses Paket einsetzen?
Werfen wir zunächst einen Blick auf die Vorteile:
Schauen wir uns an, wie du dbt-utils in deinen Daten-Workflow einbindest.
Bevor du dbt-utils nutzt, solltest du mit SQL vertraut sein und die Grundlagen von dbt (data build tool) verstehen. Ein initialisiertes und konfiguriertes dbt-Projekt sollte bereits vorliegen.
Wenn du eine Auffrischung brauchst, sieh dir unseren Introduction to dbt Kurs und das dbt Tutorial an.
Wichtig ist auch, dass Versionen von dbt Core und dem dbt-utils Paket zusammenpassen. Prüfe die Kompatibilität, um Konflikte oder veraltete Funktionen zu vermeiden.
Stelle zuerst sicher, dass deine Entwicklungsumgebung korrekt eingerichtet ist.
Prüfe zunächst, ob dbt in deiner Umgebung installiert ist. Du kannst dbt per pip installieren:
pip install dbt
Um dbt-utils zu installieren, ergänze Folgendes in der Datei packages.yml im Root-Verzeichnis deines dbt-Projekts.
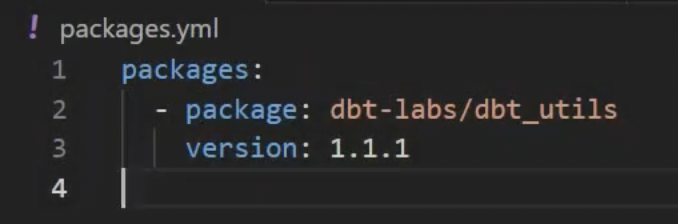
Erstelle diese Datei im Projekt-Root, falls sie nicht existiert, und füge Folgendes ein:
packages:
- package: dbt-labs/dbt_utils
version: "1.1.1" # Verwende die neueste Version, die zu deiner dbt-Version passt
In der YAML-Datei gibst du auch die benötigte Paketversion an. Achte darauf, die neueste mit deiner dbt-Version kompatible Version zu verwenden.
Nach der Änderung trennt dich nur noch ein Befehl von der Installation.
Bei erfolgreicher Ausführung wird dbt-utils geladen und installiert – die erweiterten Funktionen stehen bereit.
Führe im Terminal im Projektverzeichnis folgenden Befehl aus:
dbt depsDieser Befehl installiert alle in deiner packages.yml aufgeführten Pakete.
Das dbt-utils Paket bringt eine Reihe häufig benötigter Hilfsfunktionen mit, die SQL-Transformationen in dbt-Projekten verschlanken.
So vermeiden Entwickler Redundanzen und können sich auf die geschäftskritische Logik konzentrieren.
Hier einige Funktionen aus dbt-utils:
SQL-Generatoren in dbt-utils helfen dir, modularen SQL-Code zu erstellen.
Beispielsweise eignen sich die deduplicate-Makros hervorragend, um Dubletten zu entfernen und dabei die Reihenfolge der Daten zu bewahren. Duplikate lassen sich aus Modellen, Tabellen und sogar Common Table Expressions (CTEs) entfernen.
Generische Tests validieren Daten in einer Tabelle oder View. Sie lassen sich leicht anpassen und liefern wertvolle Einblicke in die Datenqualität.
Das Macro expression_is_true prüft zum Beispiel, ob ein bestimmter Ausdruck wahr ist. Damit lässt sich flexibel verschiedenes prüfen, etwa:
Jinja-Helfer eignen sich, um dynamische SQL-Abfragen zu erzeugen, die sich leicht anhand von Nutzereingaben oder Variablen anpassen lassen. Sie erlauben bedingte Logik und Schleifen in SQL-Statements.
Jinja-Templates definieren und spezifizieren diese Makros.
Ein Beispiel ist das Macro pretty_time, das einen String mit dem aktuellen Zeitstempel zurückgibt.
Web-Makros ähneln Jinja-Helfern, sind aber speziell für Web-Projekte gedacht. Sie erlauben dynamische HTML-Generierung und -Manipulation – hilfreich für interaktive, responsive Seiten.
Ein nützliches Macro ist get_url_path, das den Seitenpfad einer URL ermittelt. So sieht die Syntax aus:
{{ dbt_utils.get_url_path(field='page_url') }}Introspektive Makros können auf Daten im aktuellen Kontext zugreifen und sie verarbeiten. Das ermöglicht dynamische, effiziente Datenverarbeitung und spart zusätzliche Funktionen oder Code.
Ein Beispiel ist das Macro get_column_values, das die Abfrageergebnisse als Objekt zurückgibt.
Beispielszenario: Ein Unternehmen hat einen großen Datensatz mit Kunden-, Transaktions- und Produktdaten. Benötigt wird ein Bericht über den Gesamtumsatz je Produktkategorie im letzten Quartal.
Statt komplexe SQL-Abfragen zu schreiben, um mehrere Tabellen zu joinen und Umsätze je Kategorie zu berechnen, können sie dbt-utils nutzen, um relevante Daten leicht zu extrahieren und in Makros oder Modellen zu verarbeiten.
So lässt sich etwa get_filtered_columns_in_relation einsetzen, um nur die für Produktdaten nötigen Spalten zu filtern, und anschließend mit einem Summen-Makro den Umsatz je Kategorie berechnen.
Das vereinfacht den Prozess, macht ihn effizienter, spart Zeit und reduziert Fehler.
Code-Implementierung:
Um die Lösung in einer Mock-Datenbank umzusetzen, könntest du so vorgehen:
Nutze das Macro get_filtered_columns_in_relation, um nur die benötigten Spalten aus den Produktdaten zu selektieren. Damit wählst du relevante Spalten effizient aus.
-- models/product_data_filtered.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
)
select * from product_data
Erstelle danach ein Modell, das Produkt-, Transaktions- und Kundendaten joint. Verwende dann die Summenfunktion, um den Gesamtumsatz je Produktkategorie im letzten Quartal zu berechnen.
-- models/total_sales_by_category.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
),
transaction_data as (
select
product_id,
sale_amount,
transaction_date
from {{ ref('transactions') }}
where transaction_date >= date_trunc('quarter', current_date) - interval '1 quarter'
),
joined_data as (
select
p.category,
t.sale_amount
from product_data p
join transaction_data t
on p.product_id = t.product_id
)
select
category,
sum(sale_amount) as total_sales
from joined_data
group by category
Nachdem die Modelle definiert sind, führe die dbt-Modelle aus, um die Transformationen zu erstellen und den Bericht zu generieren.
dbt runErläuterung zum obigen Code:
Das Macro get_filtered_columns_in_relation hilft, nur die nötigen Spalten (product_id und category) aus der products-Tabelle auszuwählen und den Datensatz zu verschlanken.
Anschließend wird das gefilterte Produktset mit den Transaktionsdaten gejoint, um die Umsätze je Produkt zu erhalten. Danach werden die Gesamtumsätze je Kategorie für das letzte Quartal mithilfe einer Summenaggregation berechnet.
Beispielszenario:
Wir arbeiten weiter mit dem Mock-Datensatz aus Use Case 1. Statt eines Berichts sichern wir nun die Datenqualität, indem wir generische Tests ausführen.
Code-Implementierung:
So könntest du diese Tests in deinem Datensatz umsetzen:
In diesem generischen Test erzwingen wir einen Mindestanteil nicht-nullbarer Werte. Wir nutzen dazu den Test not_null_proportion.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_null_proportion:
at_least: 0.95
Hier haben wir das optionale Argument at_least gesetzt und verlangen mindestens 0,95 nicht-nullbare Werte.
In diesem Beispiel nutzen wir den Test not_empty_string, um leere Strings im Feld product_id zu erkennen.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_empty_stringMit der Funktion relationships_where stellen wir sicher, dass jede product_id in der Transaktionstabelle auch in der products-Tabelle existiert.
# models/transactions.yml
version: 2
models:
- name: transactions
columns:
- name: product_id
tests:
- dbt_utils.relationships_where:
to: ref('products')
field: product_id
In diesem Beispiel prüfen wir, dass alle Werte von product_id in der Tabelle transactions gültigen Einträgen in der Tabelle entsprechen. Das ist eine grundlegende Beziehungsprüfung.
Beachte: Du kannst auch mehrere Tests kombinieren, um verschiedene Integritätsprüfungen gleichzeitig abzudecken.
Sobald alle Tests in deiner YAML-Konfiguration definiert sind, führe mit dem dbt test-Befehl alle Schema-Tests aus.
dbt testMit dbt solltest du Best Practices befolgen, damit dein Projekt performant und stabil läuft. Beim Einsatz von dbt-utils sind vor allem diese Punkte wichtig:
Diese Fallstricke tauchen bei dbt-utils häufig auf – so gehst du ihnen aus dem Weg:
dbt-utils ist ein starkes Werkzeug, um Aufgaben in deinem Datenmodellierungsprozess zu verschlanken, zu testen und zu automatisieren. Es ist ein wesentlicher Baustein beim Arbeiten mit dbt und spart dir Zeit und Aufwand bei der Entwicklung deiner Datenmodelle.
Hilfreich sind außerdem dieses dbt Tutorial sowie die Übersicht über alternativen Data-Engineering-Tools.
Wenn du mit dbt loslegen möchtest und noch weiterlernen willst, schau dir auch unseren Introduction to dbt Course an!
Setze deine dbt-Lernreise heute fort!
Kurs
Lernpfad
Lernpfad
Blog
Nisha Arya Ahmed
15 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Laiba Siddiqui
6 Min.





