
Cours
Introduction à dbt
4 h
33.5K
Le package dbt-utils est une boîte à outils puissante qui simplifie et améliore vos processus de transformation de données. Dans ce guide, nous vous présentons dbt-utils et montrons comment il peut fluidifier votre flux de travail grâce à ses macros prêtes à l'emploi pour les opérations SQL courantes.
Package dbt-utils
dbt-utils est un package pour dbt qui propose une boîte à outils de macros prêtes à l'emploi afin d'étendre les fonctionnalités de vos projets dbt. dbt-utils réduit la complexité en ajoutant des couches d'abstraction, ce qui permet des transformations de données plus efficaces et plus cohérentes.
Si vous êtes familier avec les bibliothèques en Python et les packages en R, dbt-utils joue un rôle similaire.
Grâce à ces macros standardisées pour les opérations SQL courantes, dbt-utils vous évite d'avoir à coder toutes les transformations à partir de zéro.
En tirant parti de ces utilitaires, vous évitez de « réinventer la roue » en intégrant à vos projets une suite de macros validées par la communauté, ce qui améliore la maintenabilité et favorise l'adoption des bonnes pratiques.
dbt-utils propose une variété de fonctionnalités qui rendent les transformations de données plus rapides et plus fluides, notamment :
dbt-utils offre un large éventail de macros prêtes à l'emploi pour les opérations SQL courantes via le templating Jinja : jointures, agrégations, filtrage, et bien plus.
Ces macros sont standardisées pour assurer la cohérence entre projets et réduire le code répétitif.
Par exemple, voici quelques macros utilisées par les analytics engineers :
date_spine : crée une séquence continue de dates entre deux bornes, utile pour l'analyse de séries temporelles.pivot : transforme des lignes en colonnes dynamiquement, facilitant les tableaux croisés.star : récupère tous les champs des tables spécifiées dans le modèle, à l'exception de ceux fournis dans l'argument except.union_relations : combine des données de plusieurs relations de même structure via un union all.generate_series : génère une série de valeurs numériques, pratique pour les séries temporelles.surrogate_key : produit un identifiant unique pour les lignes en concaténant plusieurs champs.Avec ces macros, SQL peut accomplir des tâches autrement complexes et répétitives.
dbt-utils propose des outils utiles pour gérer les schémas et la documentation au sein des modèles de données. Vous suivez plus facilement les changements et maintenez l'organisation de vos projets.
Avec dbt-utils, vous pouvez facilement écrire des tests pour garantir l'exactitude et la qualité de vos transformations. Ces tests peuvent être automatisés et intégrés dans vos processus d'intégration continue, pour des pipelines de données plus fiables et efficaces.
Alors, pourquoi utiliser ce package ?
Commençons par quelques avantages :
Voyons comment intégrer le package dbt-utils dans votre flux de travail de données.
Avant d'utiliser dbt-utils, il est indispensable de maîtriser SQL et de comprendre les fondamentaux de dbt (data build tool). Vous devez déjà avoir initialisé et configuré un projet dbt.
Si besoin, consultez notre cours Introduction to dbt et ce tutoriel dbt.
Par ailleurs, alignez clairement les versions entre votre dbt core et le package dbt-utils. Vérifiez la compatibilité entre versions de dbt pour éviter conflits ou fonctionnalités obsolètes.
Pour commencer à intégrer dbt-utils dans votre stack data, assurez-vous d'abord que votre environnement de développement est correctement configuré.
Vérifiez d'abord que dbt est installé dans votre environnement. Vous pouvez installer dbt via pip :
pip install dbt
Pour installer dbt-utils, ajoutez l'entrée suivante à votre fichier packages.yml à la racine du projet dbt.
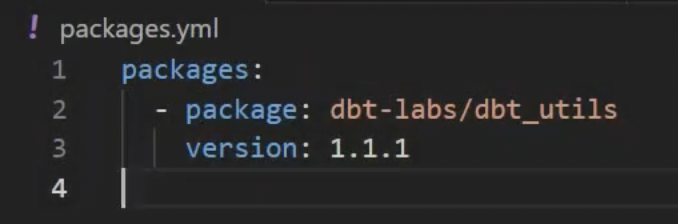
Créez ce fichier à la racine du projet s'il n'existe pas et ajoutez :
packages:
- package: dbt-labs/dbt_utils
version: "1.1.1" # Utilisez la dernière version compatible avec votre version de dbt
Dans ce fichier yaml, vous spécifiez également la version nécessaire du package. Assurez-vous d'utiliser la dernière version compatible avec votre installation de dbt.
Après modification, l'installation se fait en une simple commande.
L'exécution réussie de cette commande récupère et installe dbt-utils, vous donnant accès aux fonctionnalités étendues.
Lancez la commande suivante dans votre terminal, à la racine du projet dbt :
dbt depsCette commande installe tous les packages listés dans packages.yml.
Le package dbt-utils fournit une suite de fonctions d'assistance courantes qui rationalisent les transformations SQL au sein des projets dbt.
Ces fonctions aident les développeurs à éviter les redondances et à se concentrer sur la logique métier propre à leur contexte.
Voici quelques fonctions de dbt-utils :
Les générateurs SQL de dbt-utils sont utiles pour produire du code SQL modulaire.
Par exemple, les macros deduplicate sont excellentes pour éliminer les doublons tout en préservant l'ordre des données. Les doublons peuvent être supprimés dans des modèles, des tables, voire des CTE (Common Table Expressions).
Les tests génériques servent à valider les données d'une table ou d'une vue. Ils sont facilement personnalisables selon vos besoins et offrent une visibilité précieuse sur la qualité des données traitées.
Par exemple, la macro expression_is_true vérifie si une expression est vraie. Elle s'utilise de manière flexible pour valider différentes conditions, comme :
Les helpers Jinja facilitent la création de requêtes SQL dynamiques, facilement personnalisables selon des entrées utilisateur ou des variables. Ils permettent d'introduire des conditions et des boucles dans vos requêtes.
Les templates Jinja servent à définir et paramétrer ces macros.
Par exemple, la macro pretty_time retourne une chaîne correspondant à l'horodatage courant.
Les macros web sont proches des helpers Jinja, mais pensées pour les projets orientés web. Elles permettent une génération et une manipulation dynamiques de HTML, afin de créer plus facilement des pages interactives et responsives.
Une macro utile est get_url_path, qui récupère le chemin de page d'une URL. Voici la syntaxe :
{{ dbt_utils.get_url_path(field='page_url') }}Les macros introspectives peuvent accéder aux données dans le scope courant et les manipuler. Elles permettent un traitement dynamique et efficace des données, réduisant le besoin de fonctions ou de code supplémentaires.
Par exemple, la macro get_column_values renvoie les résultats de la requête sous forme d'objet.
Scénario : une entreprise dispose d'un vaste jeu de données sur ses clients, ses transactions et ses produits. Elle doit créer un rapport montrant le total des ventes par catégorie de produits sur le dernier trimestre.
Plutôt que d'écrire des requêtes SQL complexes pour joindre plusieurs tables et calculer les ventes de chaque catégorie, elle peut utiliser dbt-utils pour extraire facilement les données pertinentes et les manipuler dans des macros ou modèles.
Par exemple, elle peut utiliser get_filtered_columns_in_relation pour ne conserver que les colonnes nécessaires liées aux produits, puis utiliser une somme pour calculer le total des ventes par catégorie.
Le processus est ainsi simplifié et plus efficace, ce qui fait gagner du temps et réduit les erreurs.
Implémentation :
Pour mettre en œuvre cette solution dans une base factice, suivez ces étapes :
Utilisez la macro get_filtered_columns_in_relation pour ne sélectionner que les colonnes nécessaires issues des données produits. Cette macro vous aide à cibler rapidement les colonnes pertinentes.
-- models/product_data_filtered.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
)
select * from product_data
Créez ensuite un modèle pour joindre données produits, transactions et clients. Utilisez ensuite la fonction de somme pour calculer le total des ventes par catégorie de produits sur le dernier trimestre.
-- models/total_sales_by_category.sql
with product_data as (
select
{{ dbt_utils.get_filtered_columns_in_relation(
relation=ref('products'),
include=['product_id', 'category']
) }}
from {{ ref('products') }}
),
transaction_data as (
select
product_id,
sale_amount,
transaction_date
from {{ ref('transactions') }}
where transaction_date >= date_trunc('quarter', current_date) - interval '1 quarter'
),
joined_data as (
select
p.category,
t.sale_amount
from product_data p
join transaction_data t
on p.product_id = t.product_id
)
select
category,
sum(sale_amount) as total_sales
from joined_data
group by category
Après avoir défini les modèles, exécutez-les avec dbt pour lancer les transformations et générer le rapport.
dbt runExplication du code ci-dessus :
La macro get_filtered_columns_in_relation permet de sélectionner uniquement les colonnes nécessaires (product_id et category) de la table products, ce qui simplifie le jeu de données.
Ensuite, les données produits filtrées sont jointes aux transactions en SQL pour récupérer les montants de vente par produit. On calcule enfin le total des ventes par catégorie sur le dernier trimestre via la fonction d'agrégation sum.
Scénario :
Dans ce cas d'usage, nous continuons avec le même jeu de données factice que pour le cas 1. Mais au lieu de produire un rapport, l'objectif est d'assurer la qualité des données en exécutant des tests génériques.
Implémentation :
Voici des exemples de mise en œuvre de ces tests sur votre jeu de données :
Dans ce test générique, nous n'acceptons que les valeurs respectant la proportion de non-null que nous fixons. Nous utilisons pour cela le test not_null_proportion.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_null_proportion:
at_least: 0.95
Dans cet exemple, nous ajoutons l'argument optionnel at_least pour définir une proportion de non-null d'au moins 0,95.
Ici, nous utilisons le test not_empty_string pour vérifier les chaînes vides dans le champ product_id.
# models/products.yml
version: 2
models:
- name: products
columns:
- name: product_id
tests:
- dbt_utils.not_empty_stringL'utilisation de la fonction relationships_where garantit que chaque product_id de la table transactions existe bien dans la table products.
# models/transactions.yml
version: 2
models:
- name: transactions
columns:
- name: product_id
tests:
- dbt_utils.relationships_where:
to: ref('products')
field: product_id
Dans cet exemple, nous nous assurons que toutes les valeurs de product_id dans la table transactions correspondent à des entrées valides dans la table . Il s'agit d'un contrôle basique d'intégrité des relations.
Notez que vous pouvez aussi combiner plusieurs tests pour couvrir différents contrôles d'intégrité.
Une fois tous les tests définis dans votre fichier de configuration yaml, utilisez la commande dbt test pour exécuter l'ensemble des tests de schéma définis.
dbt testAvec dbt, il est essentiel de suivre les bonnes pratiques pour garantir la performance de votre projet. Avec dbt-utils, gardez notamment à l'esprit :
Voici quelques écueils courants lors de l'utilisation de dbt-utils, et des conseils pour les éviter :
dbt-utils est un outil puissant pour rationaliser, tester et automatiser les tâches de votre modélisation des données. C'est un composant essentiel de l'écosystème dbt qui vous fait gagner du temps dans le développement de vos modèles.
Vous pouvez également consulter ce tutoriel dbt et cette sélection d'outils alternatifs pour data engineers.
Si vous souhaitez vous lancer avec dbt et aller plus loin, explorez aussi notre cours Introduction to dbt !
Poursuivez votre parcours d'apprentissage dbt dès aujourd'hui !
Cours
Cursus
Cursus