Last chance! 50% off DataCamp Premium
Sale ends in
Python 是跨各类技术领域最受欢迎的编程语言之一,尤其在数据科学和机器学习中应用广泛。Python 提供了易于编码、面向对象的高级语言,并配有庞大的库生态以覆盖多种用例。其库数量超过 20 万个。
Python 之所以对数据科学如此重要,其中一个原因在于其庞大的数据处理、数据可视化、机器学习和深度学习库集合。由于 Python 拥有如此丰富的数据科学生态,要在一篇文章中覆盖全部内容几乎不可能。本文的顶级库清单仅聚焦于以下五个主要领域:
还有许多其他领域未在本清单中涵盖;例如,MLOps、大数据与计算机视觉。本文列表不分先后,也不构成任何形式的排名。
NumPy 是使用最广泛的开源 Python 库之一,主要用于科学计算。其内置数学函数可实现高速计算,并支持多维数据与大型矩阵,也常用于线性代数。与列表相比,NumPy 数组常被优先使用,因为其占用内存更少、使用更方便且更高效。
根据 NumPy 官网,这是一个旨在在 Python 中实现数值计算的开源项目。它创建于 2005 年,基于早期的 Numeric 和 Numarray 库之上构建。NumPy 的一大优势在于其采用经修改的 BSD 许可证发布,因此永远可供所有人免费使用。
NumPy 在 GitHub 上以开放方式开发,由 NumPy 及更广泛的科学 Python 社区协作共识推进。您可以在我们的Numpy 入门课程中了解更多信息。
⭐ GitHub Stars: 25K | 总下载量:24 亿
Pandas 是数据科学中常用的开源库,主要用于数据分析、数据处理与数据清洗。Pandas 让数据建模与数据分析操作变得简单,无需编写大量代码。正如其官网所述,pandas 是一个快速、强大、灵活且易用的开源数据分析与处理工具。该库的一些关键特性包括:
上手 pandas 十分简单直接。您可以查看 DataCamp 的使用 pandas 分析警务活动课程,学习如何在真实数据集上使用 pandas。
⭐ GitHub Stars: 41K | 总下载量:16 亿
尽管 Pandas 仍是小规模数据的默认选择,Polars 已成为高性能数据处理的标准。它由 Rust 编写,使用“惰性求值”引擎来处理通常会让内存受限机器崩溃的数据集(10GB–100GB+)。与按顺序执行操作的 Pandas 不同,Polars 会端到端优化查询,并在所有可用 CPU 核心上并行运行。
它旨在作为重负载工作负载的即插即用升级,语法通常更易读,且较传统 DataFrame 快 10–50 倍。
下面是一个从巨型 CSV 数据集中执行筛选、分组与聚合选择的代码示例:
import polars as pl

# Lazy evaluation: Nothing runs until .collect() is called
# allowing Polars to optimize the query plan beforehand
q = (
    pl.scan_csv("massive_dataset.csv")
    .filter(pl.col("category") == "Technology")
    .group_by("region")
    .agg(pl.col("sales").sum())
)

df = q.collect() # Executes in parallel
⭐ GitHub Stars: 40K+ | 状态:高性能标准
Matplotlib 是一个功能广泛的库,用于创建静态、交互式与动画的 Python 可视化。大量第三方包扩展并构建在 Matplotlib 之上,包括多个更高层的绘图接口(如 Seaborn、HoloViews、ggplot 等)。
Matplotlib 的设计目标是在功能上与 MATLAB 相当,同时具备使用 Python 的优势。它还具有免费开源的优点。用户可以用多种图形类型来可视化数据,包括但不限于散点图、直方图、条形图、误差图和箱线图。更重要的是,所有可视化都可用寥寥数行代码实现。
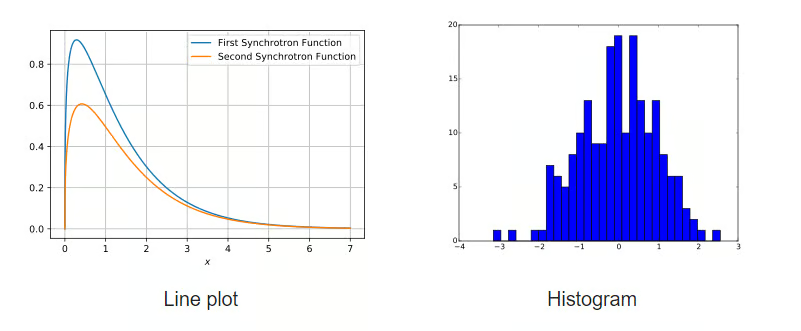
使用 Matplotlib 开发的示例图
通过这篇分步教程开始学习 Matplotlib。
⭐ GitHub Stars: 18.7K | 总下载量:6.53 亿
另一款基于 Matplotlib 的流行 Python 数据可视化框架,Seaborn 是一个高级接口,用于创建美观且有用的统计可视化,这对于研究与理解数据至关重要。该库与 NumPy 和 pandas 的数据结构紧密关联。Seaborn 背后的驱动力在于使可视化成为数据分析与探索的核心组成部分;因此,其绘图算法使用包含完整数据集的数据帧。
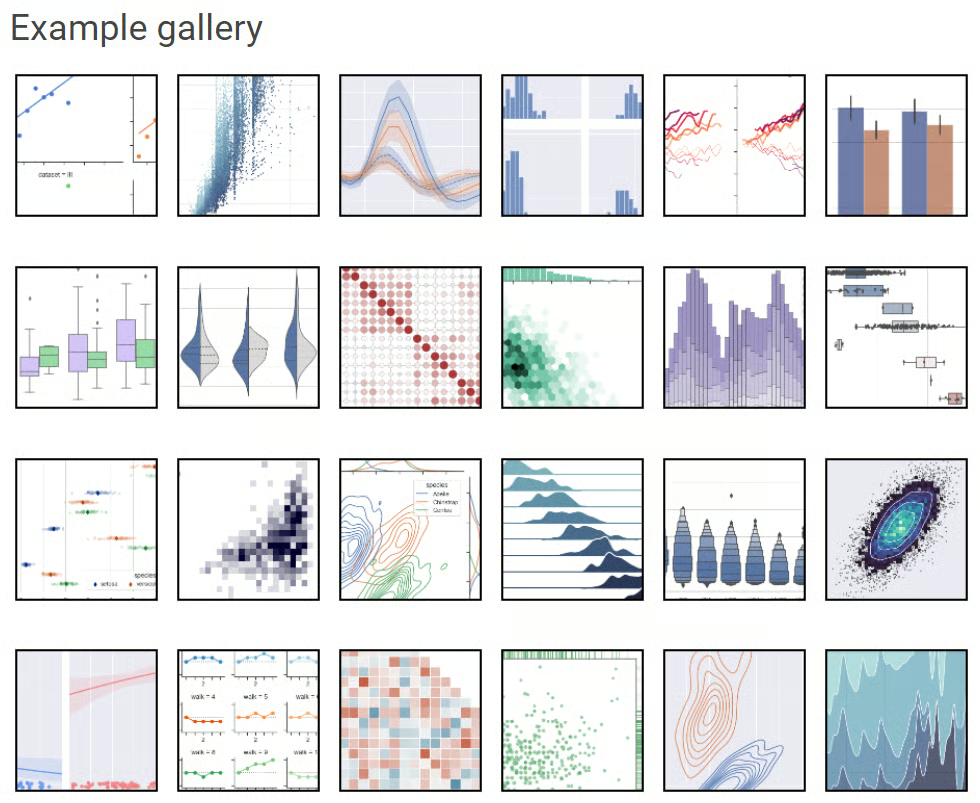
Seaborn 示例画廊
这篇Seaborn 新手教程是帮助您熟悉这一活跃可视化库的优质资源。
⭐ GitHub Stars: 11.6K | 总下载量:1.8 亿
极受欢迎的开源绘图库 Plotly 可用于创建交互式数据可视化。Plotly 构建于 Plotly JavaScript 库(plotly.js)之上,可用于创建基于 Web 的数据可视化,这些可视化既可以保存为 HTML 文件,也可以通过 Dash 在 Jupyter 笔记本和 Web 应用中显示。
它提供 40 多种独特图表类型,如散点图、直方图、折线图、条形图、饼图、误差棒、箱线图、多坐标轴、火花线、树状图以及 3D 图。Plotly 还提供等高线图,这在其他数据可视化库中并不常见。
如果您需要交互式可视化或类似仪表盘的图形,Plotly 是 Matplotlib 与 Seaborn 的一个不错替代。它目前可在 MIT 许可证下使用。
今天就通过这门Plotly 可视化课程开始掌握 Plotly。
⭐ GitHub Stars: 14.7K | 总下载量:1.9 亿
机器学习与 scikit-learn 几乎密不可分。Scikit-learn 是 Python 中使用最广泛的机器学习库之一。它构建于 NumPy、SciPy 与 Matplotlib 之上,是在 BSD 许可证下可商用的开源 Python 库。它是处理预测性数据分析任务的简单高效工具。
Scikit-learn 最初于 2007 年作为 Google 编程之夏项目发布,是一个社区驱动的项目;不过其可持续性也得益于机构与私人资助。
scikit-learn 的最大优点在于非常易用。
import numpy as np

from sklearn import datasets, linear_model

from sklearn.metrics import mean_squared_error, r2_score

# Load the diabetes dataset

diabetes_X, diabetes_y = datasets.load_diabetes(return_X_y=True)

# Use only one feature

diabetes_X = diabetes_X[:, np.newaxis, 2]

# Split the data into training/testing sets

diabetes_X_train = diabetes_X[:-20]

diabetes_X_test = diabetes_X[-20:]

# Split the targets into training/testing sets

diabetes_y_train = diabetes_y[:-20]

diabetes_y_test = diabetes_y[-20:]

# Create linear regression object

regr = linear_model.LinearRegression()

# Train the model using the training sets

regr.fit(diabetes_X_train, diabetes_y_train)

# Make predictions using the testing set

diabetes_y_pred = regr.predict(diabetes_X_test)
致谢:代码摘自 scikit-learn 官方文档。
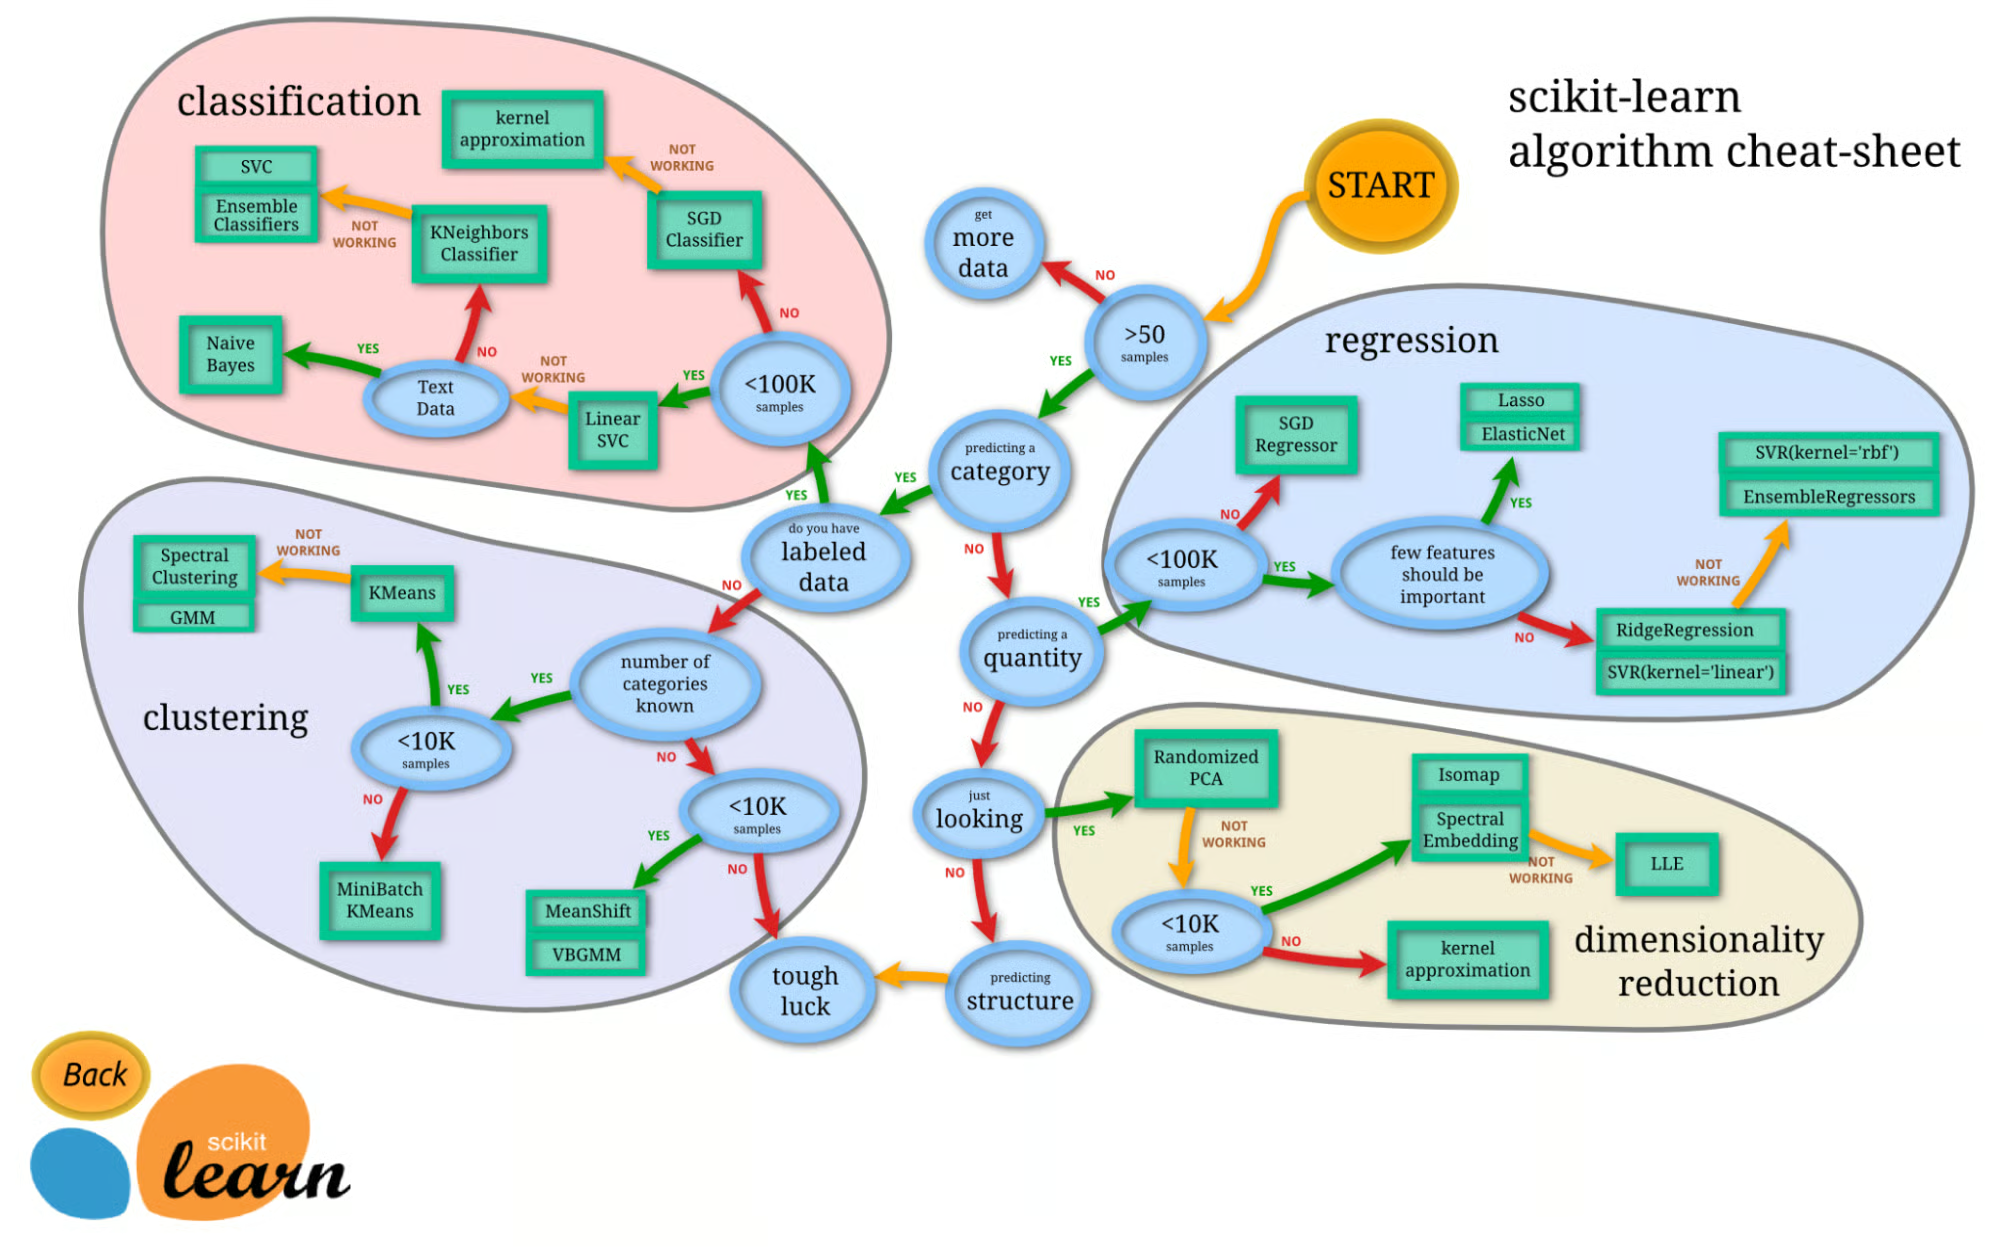
您可以通过这篇scikit-learn 入门教程亲自试用。
⭐ GitHub Stars: 57K | 总下载量:7.03 亿
数据科学家只交付静态 PDF 报告的时代已经过去。Streamlit 可在数分钟内将 Python 脚本变成交互且可分享的 Web 应用。它无需具备 HTML、CSS 或 JavaScript 知识。到 2025 年,它已被广泛用于构建内部工具、仪表盘原型,以及面向相关方的交互式模型演示。
通过诸如 st.write() 与 st.slider() 这样简单的 API 调用,您就能构建一个可随数据变化实时响应的前端,弥合分析与工程之间的鸿沟。
⭐ GitHub Stars: 42K+ | 状态:交付必备
最初是一个 Web 开发工具,Pydantic 现已成为 AI 技术栈的基石。它利用 Python 类型注解执行数据验证与设置管理。在 LLM 时代,确保数据(以及模型输出)严格匹配特定模式至关重要。
Pydantic 为 LangChain 与 Hugging Face 等库提供引擎支持,确保来自 AI 模型的混乱 JSON 输出被强制转换为结构化、有效的 Python 对象,从而不会破坏下游代码。
⭐ GitHub Stars: 26K+ | 状态:关键基础设施
LightGBM 是极为流行的开源梯度提升库,采用基于树的算法。它具备以下优点:
它可同时用于有监督的分类与回归任务。您可以查看其官方文档或 GitHub 了解更多这一出色框架的信息。
⭐ GitHub Stars: 15.8K | 总下载量:1.62 亿
XGBoost 是另一款广泛使用的分布式梯度提升库,旨在具备可移植性、灵活性与高效性。它支持在梯度提升框架内实现机器学习算法。XGBoost 提供(GBDT)梯度提升决策树,即并行树提升,能够快速而准确地解决众多数据科学问题。同一套代码可运行在主要的分布式环境(Hadoop、SGE、MPI)上,进而解决无数问题。
过去几年,XGBoost 因帮助个人与团队几乎在所有 Kaggle 结构化数据竞赛中获胜而声名鹊起。XGBoost 的优势包括:
XGBoost 由活跃的社区成员开发与维护,并在 Apache 许可证下许可使用。如果您想了解更多,请查看这篇XGBoost 教程。
⭐ GitHub Stars: 25.2K | 总下载量:1.79 亿
Catboost 是一款快速、可扩展、高性能的基于决策树的梯度提升库,用于排序、分类、回归等机器学习任务,支持 Python、R、Java 与 C++。它支持在 CPU 与 GPU 上计算。
作为 MatrixNet 算法的继承者,它广泛用于排序任务、预测与推荐。由于其通用性强,可应用于广泛领域与多种问题。
根据其 代码库,CatBoost 的优势包括:
⭐ GitHub Stars: 7.5K | 总下载量:5300 万
Statsmodels 提供用于估计多种统计模型、进行统计检验与统计数据探索的类与函数。随后,它会为每个估计器提供全面的结果统计项,并可将结果精度与现有统计软件包进行对比测试。
该库中大多数检验结果至少已与另一款统计软件(R、Stata 或 SAS)进行过校验。statsmodels 的一些特性包括:
如果您想深入了解,可从这门statsmodels 入门课程开始。
⭐ GitHub Stars: 9.2K | 总下载量:1.61 亿
RAPIDS 这套开源软件库可在 GPU 上完整执行端到端的数据科学与分析流水线。借助 Dask,它可无缝扩展自 GPU 工作站至多 GPU 服务器与多节点集群。该项目由 NVIDIA 支持,也依赖于 Numba、Apache Arrow 及许多其他开源项目。
cuDF 是一款 GPU DataFrame 库,用于加载、连接、聚合、过滤与其他方式处理数据。它基于 Apache Arrow 的列式内存格式开发,提供与 pandas 类似的 API,数据工程师与数据科学家会感到非常熟悉,从而无需深入 CUDA 编程细节即可轻松加速工作流。
cuML 是一组库,实现了机器学习算法与数学基元函数,并与其他 RAPIDS 项目共享兼容的 API。它使数据科学家、研究人员与软件工程师能够在 GPU 上运行传统的表格型机器学习任务,而无需深入 CUDA 编程细节。cuML 的 Python API 通常与 scikit-learn API 匹配。
这是一款开源的超参数优化框架,主要用于自动化超参数搜索。它利用 Python 的循环、条件与语法自动寻找最优超参数,能够搜索大型空间并裁剪无前景的试验以加快结果产出。最重要的是,它易于在大型数据集上并行化与扩展。
其 GitHub 代码库列出的关键特性:
⭐ GitHub Stars: 9.1K | 总下载量:1800 万
这是一款极受欢迎的开源机器学习库,使用极少代码即可在 Python 中自动化机器学习工作流。它是一款端到端的模型管理与机器学习工具,能显著加速实验周期。
与其他开源机器学习库相比,PyCaret 提供低代码解决方案,可将数百行代码替换为寥寥数行,从而成倍提升实验速度与效率。
PyCaret 目前在 MIT 许可证下提供使用。若要了解更多,您可以查阅其官方文档或 GitHub 代码库,或阅读这篇PyCaret 入门教程。
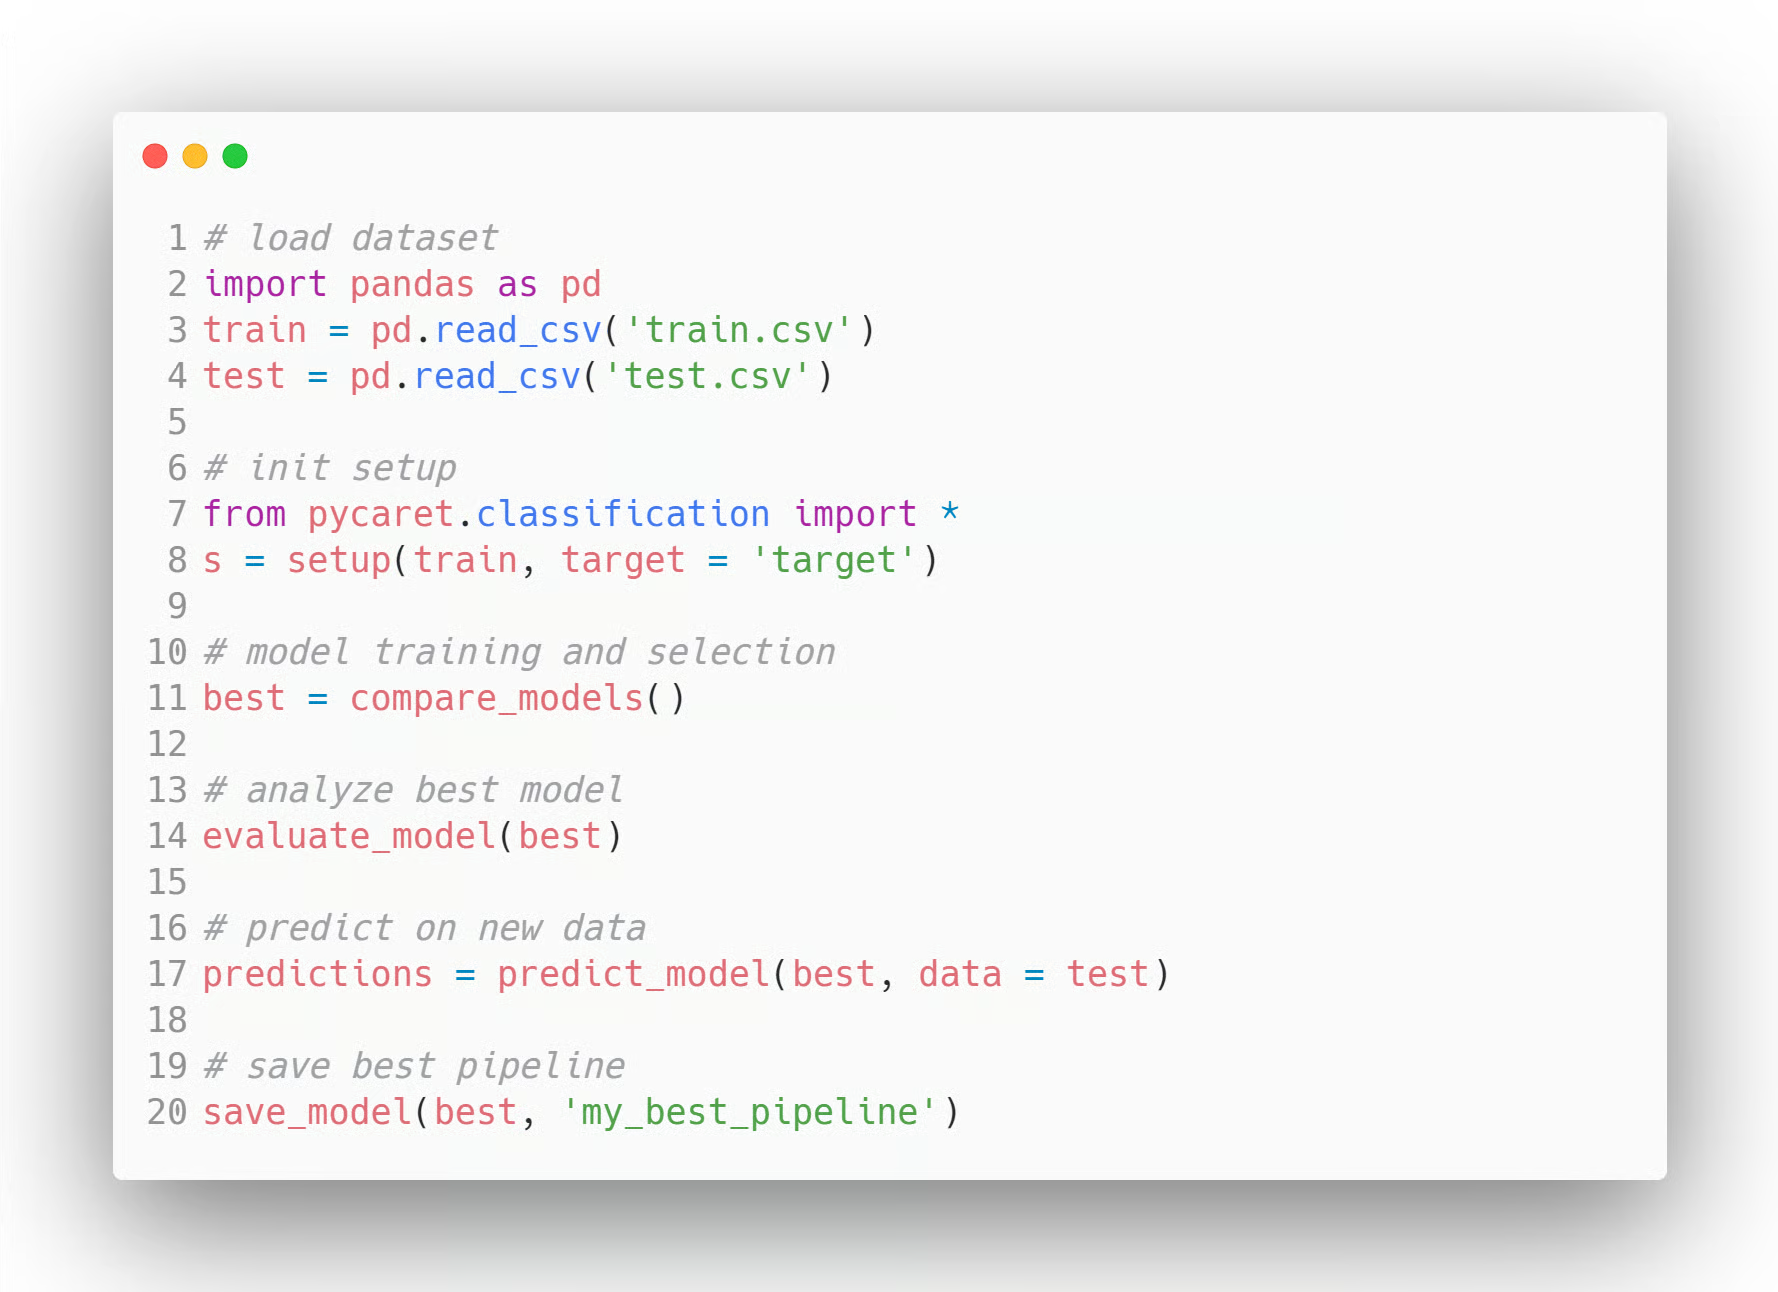
PyCaret 中的示例模型工作流 - 来源
⭐ GitHub Stars: 8.1K | 总下载量:390 万
H2O 是一个机器学习与预测分析平台,可在大数据之上构建机器学习模型。同时,它还便于在企业环境中将这些模型投入生产。
H2O 的核心代码由 Java 编写。其算法使用 Java Fork/Join 框架进行多线程处理,并实现于 H2O 的分布式 Map/Reduce 框架之上。
H2O 采用 Apache License 2.0 许可,适用于 Python、R 与 Java 语言。要进一步了解 H2O AutoML,请查看其官方文档。
⭐ GitHub Stars: 10.6K | 总下载量:1510 万
Auto-sklearn 是一个自动化机器学习工具包,是 scikit-learn 模型的合适替代。它会自动执行超参数调优与算法选择,为机器学习从业者节省大量时间。其设计体现了元学习、集成构建与贝叶斯优化的最新进展。
作为 scikit-learn 的扩展,auto-sklearn 使用贝叶斯优化搜索过程,为给定数据集找到表现最佳的模型流水线。
auto-sklearn 十分易用,且可用于有监督的分类与回归任务。
import autosklearn.classification

cls = autosklearn.classification.AutoSklearnClassifier()

cls.fit(X_train, y_train)

predictions = cls.predict(X_test)
来源:示例摘自 auto-sklearn 的官方文档。
想了解更多 auto-sklearn 信息,请查看其 GitHub 代码库。
⭐ GitHub Stars: 7.3K | 总下载量:67.5 万
FLAML 是一个轻量级 Python 库,可自动找出准确的机器学习模型。它会自动选择学习器与超参数,为机器学习从业者节省大量时间与精力。根据其 GitHub 代码库,FLAML 的一些特性包括:
仅用三行代码,您即可获得一个具备 scikit-learn 风格的、由这一快速 AutoML 引擎驱动的估计器。
from flaml import AutoML

automl = AutoML()

automl.fit(X_train, y_train, task="classification")来源:示例摘自官方GitHub 代码库
⭐ GitHub Stars: 3.5K | 总下载量:45.6 万
与其他聚焦速度的 AutoML 库不同,AutoGluon(由亚马逊开发)侧重于稳健性与最先进的准确率。它以“多层堆叠集成”策略而闻名,这常使其在表格数据基准上胜过人工调优的模型。
它不仅支持表格数据,还支持多模态问题。这意味着您可以在同时包含文本、图像与数值列的数据集上训练单个预测器,而无需复杂的特征工程。
以下代码片段展示了 AutoGluon 的语法:
from autogluon.tabular import TabularPredictor
predictor = TabularPredictor(label='class').fit(train_data)
# AutoGluon automatically trains, tunes, and ensembles multiple models
⭐ GitHub Stars: 10K+ | 状态:同类最佳准确率
TensorFlow 是由 Google Brain 团队开发的一款流行的开源高性能数值计算库,是深度学习研究领域的中坚力量。
如其官网所述,TensorFlow 是一个端到端的开源机器学习平台。它为机器学习研究人员与开发者提供了广泛而多样的工具、库与社区资源。
使 TensorFlow 备受欢迎与广泛使用的一些特性包括:
若想了解更多 TensorFlow,请查看其官方指南或 GitHub 代码库,或跟随这篇分步TensorFlow 教程亲自上手。
⭐ GitHub Stars: 180K | 总下载量:3.84 亿
PyTorch 是一款能大幅加速从研究原型到生产部署之旅的机器学习框架。它是用于深度学习的优化张量库,可在 GPU 与 CPU 上运行,被视为 TensorFlow 的替代方案。随着时间推移,PyTorch 的受欢迎程度在 Google 趋势上已超越 TensorFlow。
它由 Facebook 开发并维护,目前在 BSD 许可证下提供使用。
根据其官网,PyTorch 的关键特性包括:
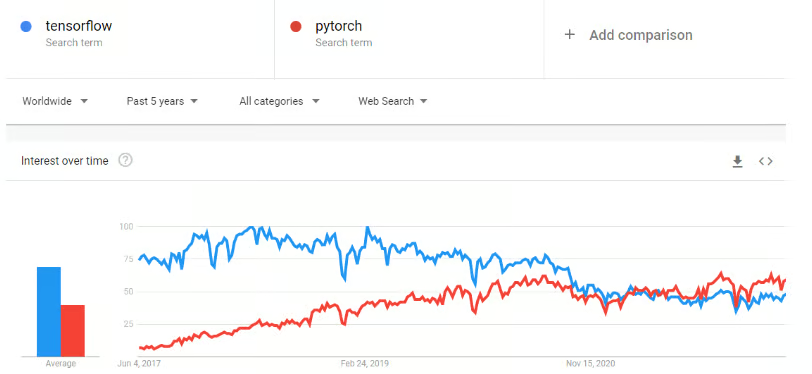
⭐ GitHub Stars: 74K | 总下载量:1.19 亿
FastAI 是一个深度学习库,为用户提供可轻松实现当前最先进结果的高级组件。同时,它也包含可相互替换的低级组件,以便开发新方法。其目标是在不明显牺牲易用性、灵活性或性能的前提下,同时实现上述两点。
特性:
要进一步了解该项目,请查看其官方文档。
⭐ GitHub Stars: 25.1K | 总下载量:610 万
Keras 是为人类而非机器设计的深度学习 API。Keras 遵循降低认知负担的最佳实践:提供一致、简洁的 API,尽量减少常见用例所需的用户操作,并给出清晰且可执行的错误信息。Keras 如此直观,以至于 TensorFlow 在 TF 2.0 版本中将其作为默认 API 采用。
Keras 提供更简单的神经网络表达机制,还包含用于模型开发、数据集处理、图形可视化等方面的一流工具。
特性:
想了解更多 Keras,请查看其官方文档,或学习这门入门课程:用 Keras 进行深度学习。
⭐ GitHub Stars: 60.2K | 总下载量:1.63 亿
PyTorch Lightning 为 PyTorch 提供了一个高级接口。其高性能、轻量级框架可以组织 PyTorch 代码,将研究与工程解耦,使深度学习实验更易理解与复现。它被开发用于创建可无缝运行在分布式硬件上的可扩展深度学习模型。
根据其官网,PyTorch Lightning 的设计使您可以将更多时间投入研究、而非工程。稍作重构即可:
想进一步了解该库,请查看其官方网站。
⭐ GitHub Stars: 25.6K | 总下载量:1820 万
JAX 是 Google 开发的高性能数值计算库。若说 PyTorch 是用户友好的标准,那么 JAX 则是研究人员(包括 DeepMind)为追求极致速度所使用的“F1 赛车”。它允许将 NumPy 代码自动编译,通过 XLA(加速线性代数)在加速器(GPU/TPU)上运行。
其对原生 Python 函数进行自动微分的能力,使其成为从零开发新算法的宠儿,尤其是在生成式建模与物理仿真中。
⭐ GitHub Stars: 35K+ | 状态:研究标准
spaCy 是一个工业级、开源的 Python 自然语言处理库。spaCy 擅长大规模信息抽取任务。它由精心进行内存管理的 Cython 自底向上编写而成。如果您的应用需要处理大规模网页数据,spaCy 是理想选择。
特性:
想了解更多 spaCy,请查看其官方网站或 GitHub 代码库。您也可使用这份实用的spaCY 速查表快速熟悉其功能。
⭐ GitHub Stars: 28K | 总下载量:8100 万
Hugging Face Transformers 是由 Hugging Face 推出的开源库。Transformers 允许通过 API 轻松下载并训练最先进的预训练模型。使用预训练模型可降低您的计算成本与碳足迹,并节省从零训练模型所需的时间。这些模型适用于多种模态,包括:
transformers 库支持与三大主流深度学习库的无缝集成:PyTorch、TensorFlow 与 JAX。您可以在某一框架中用三行代码训练模型,再在另一框架中加载进行推理。每个 Transformer 的架构都在独立的 Python 模块中定义,便于在实验与研究中进行定制。
该库目前在 Apache License 2.0 下提供使用。
若想了解更多 transformers,请查看其官方网站或 GitHub 代码库,并阅读我们的Transformers 与 Hugging Face 入门教程。
⭐ GitHub Stars: 119K | 总下载量:6200 万
LangChain 是大型语言模型(LLM)的行业标准编排框架。它允许开发者将不同组件“链”在一起,例如将某个 LLM(如 GPT 5.2)与其他计算或知识来源连接。
它抽象了与提示词打交道的复杂性,使您可以轻松构建能够使用工具(如计算器、Google 搜索或 Python REPL)来解决多步推理问题的“代理”。
from langchain.chains import LLMChain
# Example: Creating a chain that takes user input and formats it
# before sending to an LLM
chain = prompt | llm | output_parser
result = chain.invoke({"topic": "Data Science"})
⭐ GitHub Stars: 123K+ | 状态:生成式 AI 必备
当 LangChain 负责推理时,LlamaIndex 则负责数据。它是 RAG(检索增强生成) 的领先框架。它专注于摄取、索引与检索您的私有数据(PDF、SQL 数据库、Excel 表等),以便 LLM 能够准确回答相关问题。
到 2025 年,“与您的文档对话”已成为标准的业务需求,而 LlamaIndex 提供了优化的数据结构,使其高效执行并尽量避免幻觉。
⭐ GitHub Stars: 35K+ | 状态:RAG 标准
若要让 LLM“记住”信息,您需要向量数据库。ChromaDB 是一款开源、AI 原生的向量数据库,已成为 Python 开发者的默认选择。它处理将文本嵌入(把词语转换为数字列表)并存储以供语义搜索的复杂过程。
不同于只进行精确关键词匹配的传统 SQL 数据库,ChromaDB 允许按语义进行查询,使其成为现代 AI 应用的长期记忆后端。
⭐ GitHub Stars: 25K+ | 状态:向量存储标准
为您的数据科学、机器学习或自然语言处理任务选择合适的 Python 库,是一个会显著影响项目成功与否的关键决策。面对琳琅满目的库,务必综合考量多种因素以做出明智选择。以下是指导您的关键考虑点:
通过仔细评估这些因素,您可以在为数据科学或机器学习项目选择 Python 库时做出明智决策。请记住,最适合您项目的库取决于您希望实现的具体需求与目标。
若要开启您的数据科学职业生涯,请学习Python 数据科学家职业路径。
DataCamp 上的 Python 库课程
课程
课程
课程