Anthropic 刚刚发布了 Claude Haiku 4.5,这是其产品线中最新且体量最小的模型。距离上一次 Haiku 发布已近一年,而这一版本表现令人惊喜。尽管定位为轻量模型,它的性能已可与 Claude Sonnet 4 相媲美(后者在五个月前还被认为是最佳编程模型),在某些方面甚至更胜一筹。
此次发布,Anthropic 继续保持 Haiku 小而实惠的定位,同时增强了推理能力并带来一系列先进新特性。下文将详细展开。
一如既往,Anthropic 的发布说明语气颇为大胆,至于这些说法能否站得住脚,还需要真实世界的测试与社区反馈。但就目前而言,我们已有许多内容可供拆解,包括 Anthropic 的内部基准测试结果以及我对 Haiku 4.5 的亲身测试。
在本文中,我还将解读它与其他 Anthropic 模型,以及 GPT 和 Gemini 的对比表现。您也可以查看我们针对另一款新模型Claude Sonnet 4.5以及Claude Agents SDK的单独指南。
什么是 Claude Haiku 4.5?
Claude Haiku 4.5 是 Anthropic 推出的一款小型、低成本 AI 模型。该模型支持 200,000 令牌的上下文窗口,最多可输出 64,000 个令牌,并可处理文本与图像。4.5 也是首个引入扩展思考、计算机使用与上下文感知等高级功能的 Haiku 版本,我们会在下一节展开讨论。
据 Anthropic 称,依赖 AI 执行实时、低延迟任务(如聊天助手、客服代理或结对编程)的用户,将会欣赏 Haiku 4.5 在高智能与卓越速度之间的平衡。
值得注意的是,两周前发布的 Claude Sonnet 4.5 仍是 Anthropic 的最佳编程模型。与此同时,Haiku 4.5 旨在以更低价格提供接近前沿的性能,非常适合可扩展、对成本敏感的工作负载。
Haiku 4.5 是 Anthropic 最便宜的模型吗?
Claude Haiku 4.5 的定价为每百万输入令牌 1 美元、每百万输出令牌 5 美元。相比 Sonnet 系列仍便宜许多,但相较上一代 Haiku 3.5,这次价格上调了 25%。
在 Haiku 产品家族内,价格逐步攀升。更早的版本(如 Haiku 3)比对应的 Sonnet 模型大约便宜 12 倍。如今差距缩小至约 3 倍,也就是说 Haiku 4.5 比 Sonnet 4.5 大约便宜三倍。
即便如此,从性能提升来看,这次涨价仍然物有所值。基准测试显示,Haiku 4.5 的表现几乎与 Sonnet 4 打平,在某些方面还接近 Sonnet 4.5。因此,当您需要在大规模场景中具备更强的思考能力和复杂问题求解时,它是不二之选。但对于不需要太多智能的常规任务,继续使用 Haiku 3.5 更合适。
Claude Haiku 4.5 的新功能
Haiku 4.5 带来了此前只在 Sonnet、Opus 等前沿模型中提供的多项高级能力。这些特性在保持低成本的同时,缩小了轻量模型与大型模型之间的差距。
扩展思考
Haiku 4.5 增加了类似 Sonnet 模型的扩展思考模式。启用后,模型会在回复前为自己留出更多时间处理复杂问题。它还会以可视化且透明的方式呈现部分思考链,在处理过程中展示部分内部推理。这种可见性更便于判断模型的逻辑,并在处理更困难、分步骤的任务时更信任其输出。
计算机使用
计算机使用功能让模型可以像人一样与计算机交互,例如移动光标、点击按钮、通过虚拟键盘输入或填写表单。
它能理解任意软件界面的截图,并决定下一步操作,无论是滚动、输入文本还是打开链接。实际效果上,这意味着 Claude 可以独立操作计算器或记事本等工具,甚至处理自研软件应用。
那么表现如何?在计算机使用基准测试中,Claude Haiku 4.5 的成功率为 50.7%,即大约一半任务能成功完成。这相较 Sonnet 3.5 首次给出的 14% 基准有大幅提升,且以三分之一的价格超过了 Sonnet 4 的 42.2% 分数。对于一款紧凑模型而言,这是在真实计算机交互中的一个令人印象深刻的里程碑。
上下文感知
上下文感知指模型会跟踪对话中已使用的上下文窗口(令牌)量。这有助于它更高效地管理 200k 的有限上下文窗口,避免在任务中途耗尽上下文。
例如,当 Haiku 发现接近上下文上限时,它可以自动总结早期步骤,存储关键细节,并移除较早任务的完整上下文,为新的上下文腾出空间。
测试 Claude Haiku 4.5
我使用 Claude 网页端与 Haiku 4.5 进行了对话,并给了它一些编程任务,看看它的表现如何。
1. 基础记账应用
在此前的Claude Sonnet 4.5 测试中,我们让它构建了一个简单的健康习惯应用。这次我想看看 Haiku 4.5 处理类似需求的表现:一个个人支出追踪器。实话说,我很惊艳。
在成本仅为其一小部分、速度大约翻倍的情况下,Haiku 4.5 根据我的提示交付了一个完整响应式的应用。最终效果与 Sonnet 4.5 产出一样准确、现代。
我的提示如下:
“我想做一个应用,帮助我以简单、可视化且具有激励性的方式记录个人支出。我希望设计风格平静有序——可以使用柔和的蓝色、灰色,并点缀一点金色。应用应让我轻松记录每日支出、进行分类(如餐饮、出行、账单、娱乐),并用简洁的图表可视化开销。我希望有一个月度汇总页面,展示总支出、储蓄以及一段时间内的趋势。此外需要有预算目标板块,用于追踪储蓄目标的进度,并能为每条记录添加备注或收据。理想情况下,界面要友好现代,帮助我更专注于理财,而不是感到压力。”
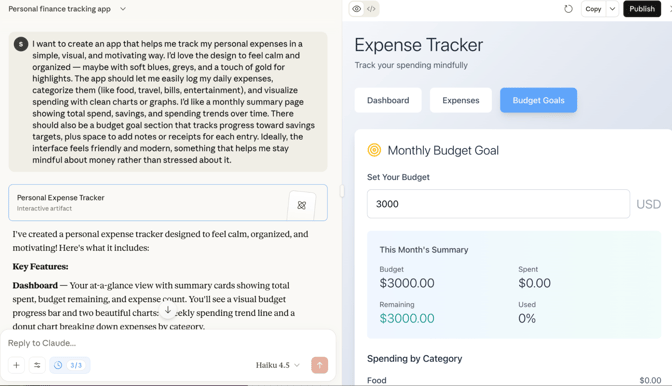
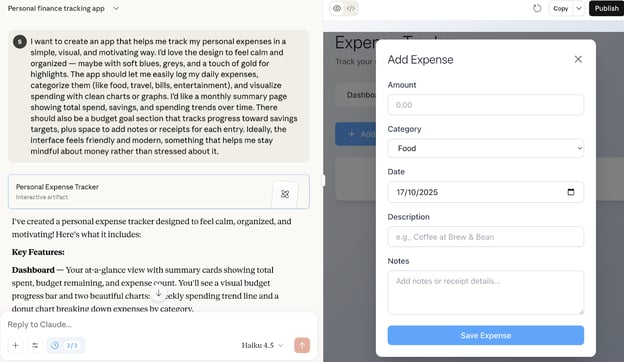
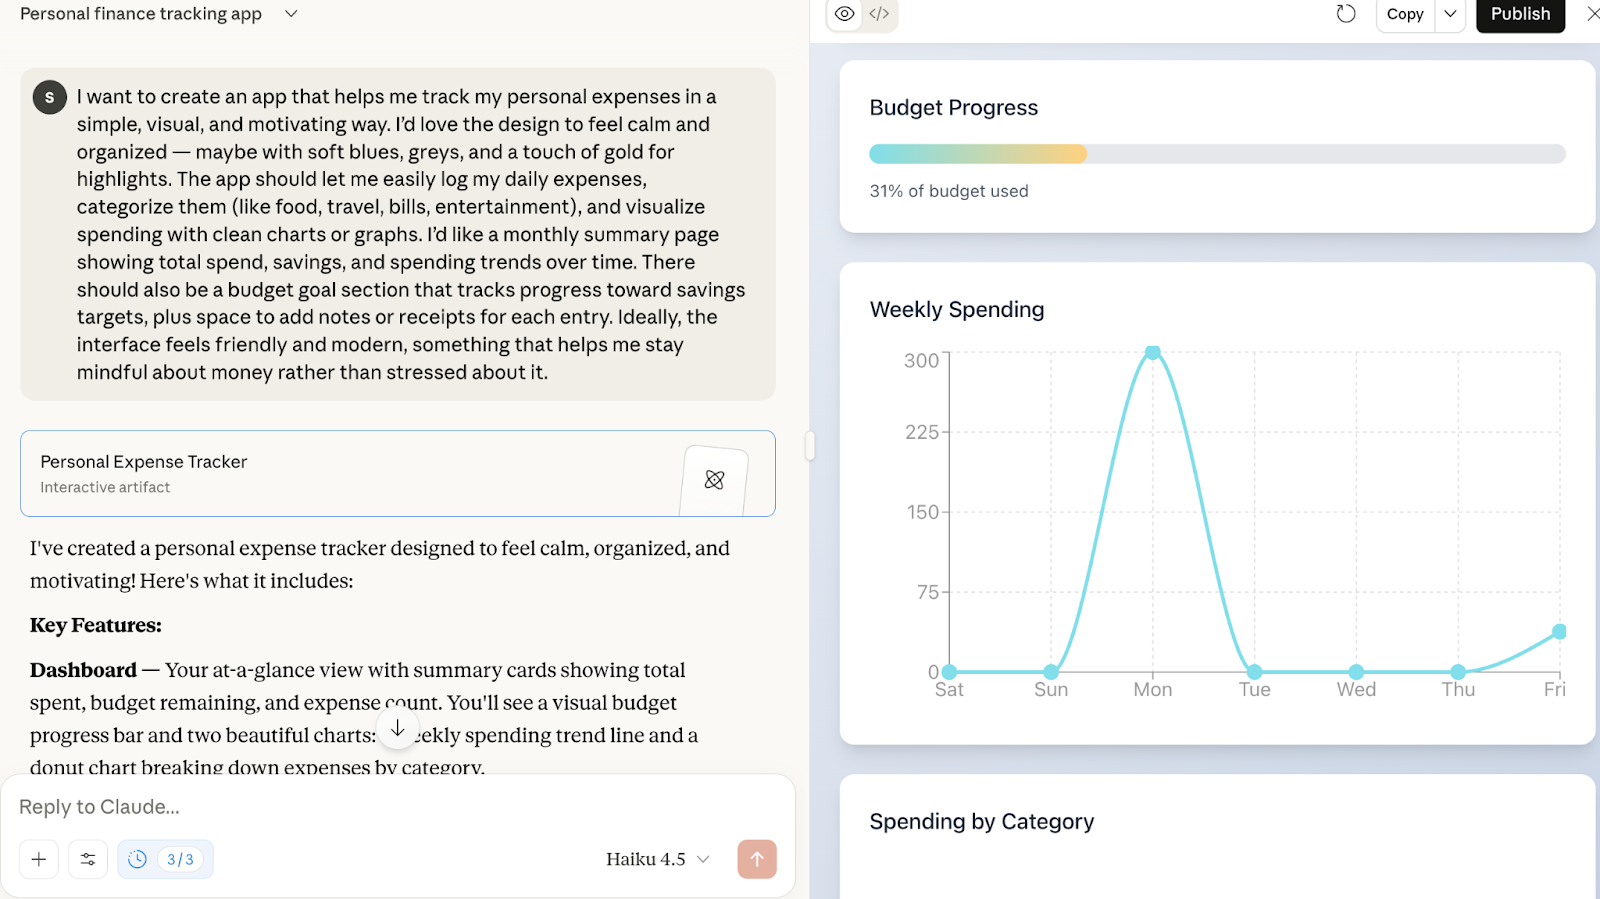
它很快就在浏览器中开始编码,并在数秒内生成了一个可运行的完整原型。应用包含多个页面,并有与需求相契合的细节:
预算目标(Budget Goals)板块,您可以设定支出上限并随时间追踪进度。
在开销(expenses)选项卡下,您可以记录购买、选择类别、添加备注并附上日期。
仪表盘视图(Dashboard)用图表与条形图可视化消费模式。
最让我印象深刻的是它执行指令的流畅度。仅凭这一条详细提示,Haiku 4.5 就把整个应用搭建了出来。
截图测试
接着,我想看看 Haiku 4.5 处理视觉输入的能力。我上传了一张截图,并提示它“创建与截图中相同的应用,但将左侧菜单栏移到页眉(header)区域。”
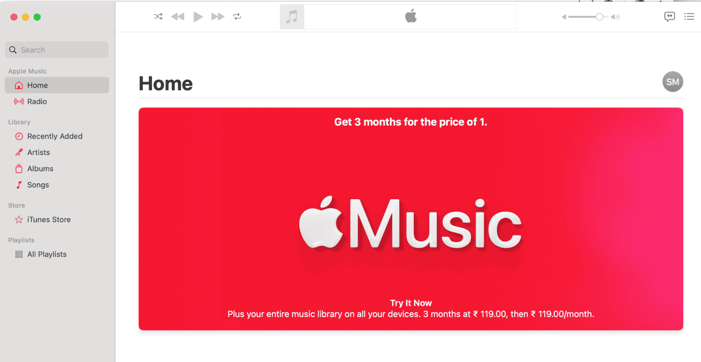
输出: 模型立刻生成了与截图非常相似的界面,并按要求将菜单整齐地重排到页面顶部。
不过该版本是静态的,每个菜单区块显示的内容都相同。于是我追加了一条提示来补充功能性:
“为菜单栏中的各部分添加功能。目前页面代表 Home 区域。
- ‘Recently Added’ 区域应显示用户最近添加的歌曲列表。
- ‘Artists’ 区域应按热门艺人组织歌曲。
- ‘Albums’ 区域应使用文件夹样式的结构按专辑分类歌曲。
- ‘Songs’ 区域应包含搜索栏,允许用户搜索歌曲;在搜索栏下方显示用户最近互动过的歌曲列表。”
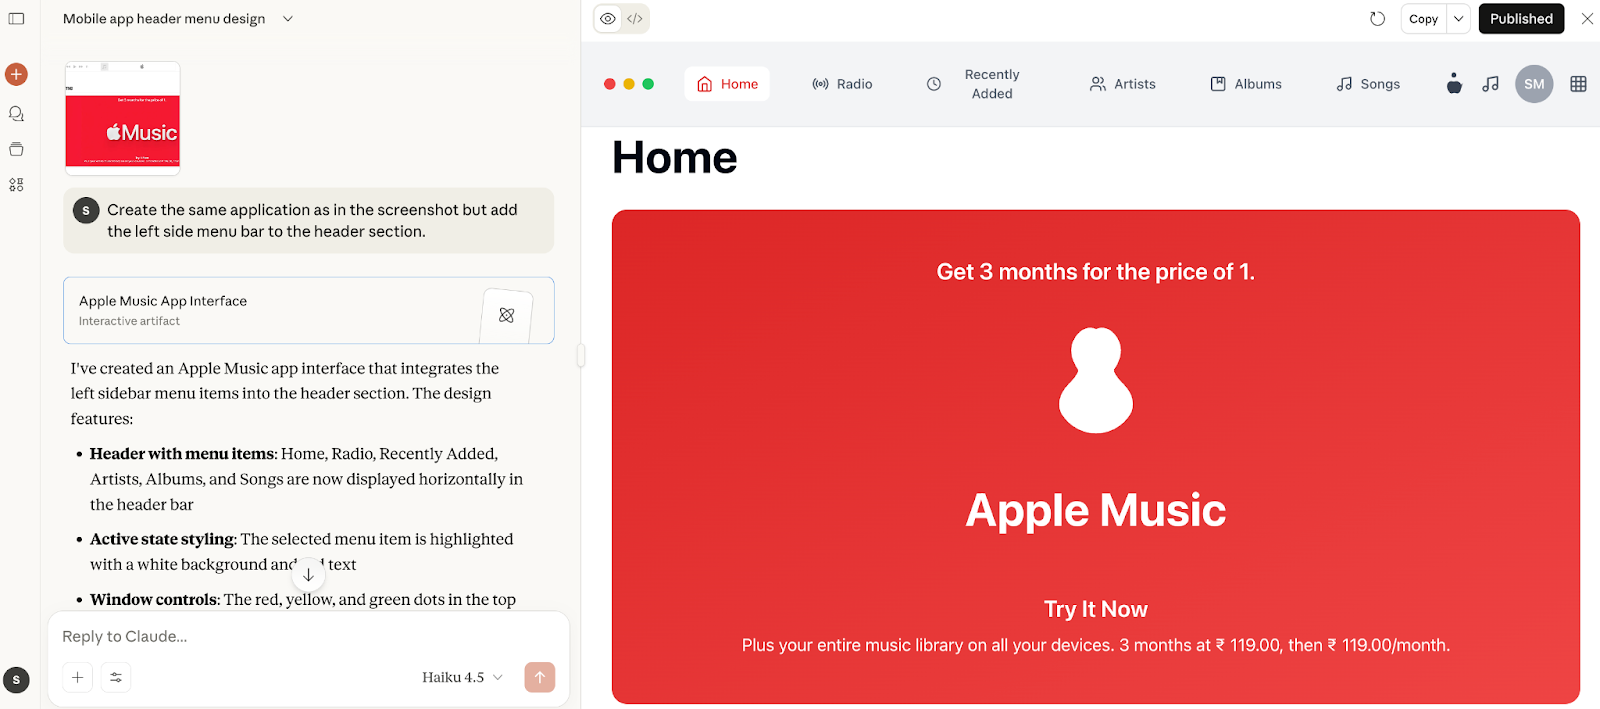
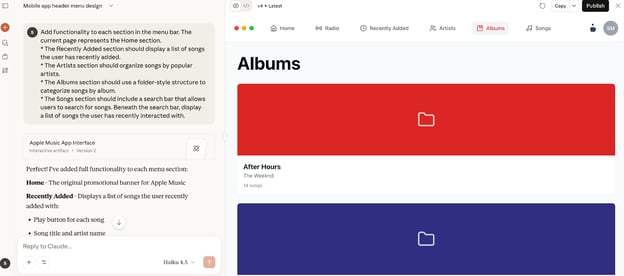
输出: Haiku 再次快速响应,扩展了 UI 以包含所有所需功能。如下图所示为“Albums”区域。
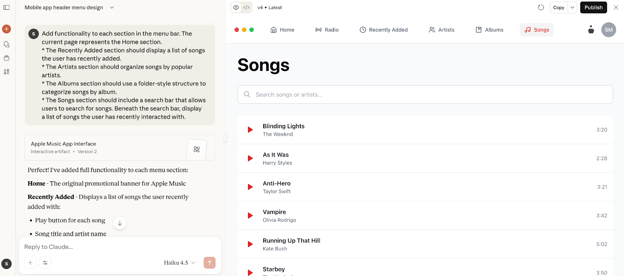
下图为“Songs”区域的界面。
Claude Haiku 4.5 基准测试
随 Haiku 4.5 一同发布的,还有与 Sonnet 4.5、Sonnet 4、GPT-5 和Gemini 2.5 Pro的完整基准对比。综合考虑速度与成本,这些数字确实相当亮眼。
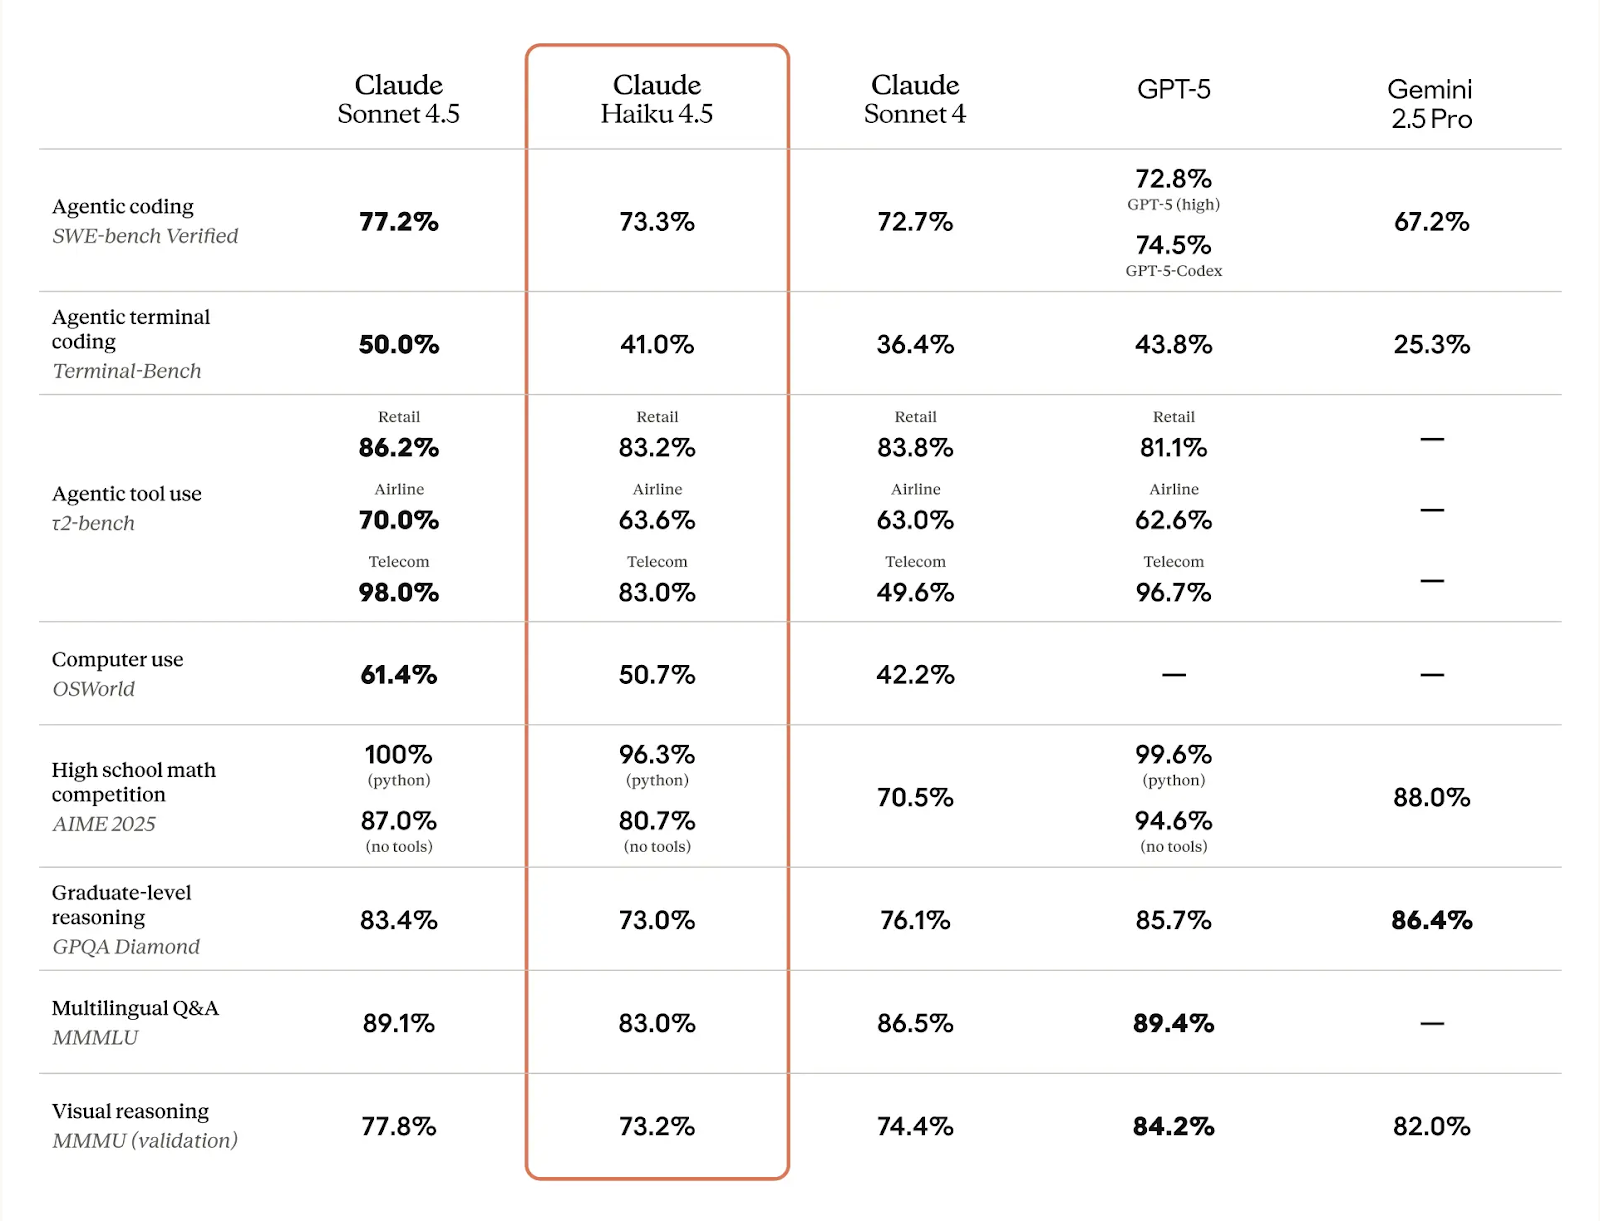
为便于理解,以下是 Anthropic 的测试方式以及 Haiku 4.5 的亮点:
代理式编程
Anthropic 使用 SWE-bench Verified 基准测试其 AI 模型,该测试衡量模型修复 GitHub 仓库中 500 个真实缺陷的能力。Anthropic 称为确保统计可靠性,结果取 50 次独立运行的平均值。结果显示,Claude Haiku 4.5 的准确率达到 73.3%,仅次于 Claude Sonnet 4.5,甚至超过了 Sonnet 4 模型。
计算机使用
在计算机使用测试中,Anthropic 采用 OSWorld-Verified 框架。该数据集评估模型在打开文件、管理设置、与网站交互等真实计算机任务中的执行效果。Haiku 4.5 再次表现强劲,排名仅次于 Sonnet 4.5,并领先 Sonnet 4。
视觉推理
Anthropic 使用 MMMU(大规模多学科多模态理解)基准来测试视觉推理。该基准衡量模型在多个领域中对文本与图像进行理解和推理的能力。结果在 128k 思考预算下,取 10 次运行平均,显示GPT-5以 84.2% 的准确率领先,Claude Sonnet 4 和 Haiku 4.5 紧随其后,分别为 74.4% 与 73.2%。
如何访问 Claude Haiku 4.5
Claude Haiku 4.5 可通过多种渠道获取。Anthropic 直接提供聊天访问与 API 访问。诸如 Amazon Bedrock 与 Google Cloud Vertex AI 等自定义 AI 代理构建平台也已集成 Haiku 4.5,开发者可在这些平台上用 Haiku 4.5 驱动自定义 AI 代理。
聊天访问
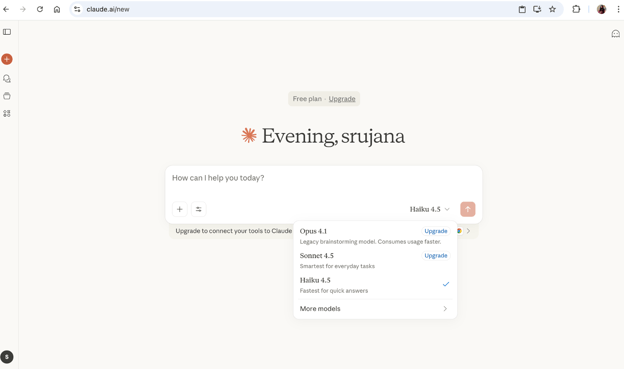
您可以在 Claude 网页端或 Claude 移动应用中直接与 Haiku 4.5 对话。我的测试使用的是网页版本,只需在可用模型列表中选择 Haiku 即可。它对免费层用户也开放,但有一定使用限制。
API 访问
您可以在 Anthropic Console 注册并从中复制您的API 密钥。然后,您可以在终端中结合 cURL 命令使用该密钥,模型会以 JSON 格式返回响应。Anthropic 也提供官方 SDK(Python 与 TypeScript),让您无需每次手动调用 API,便可通过代码便捷地使用 Claude 模型(如 Sonnet 或 Haiku)。
您也可以在 Python 应用中借助 requests 库使用该 API。
如果您想通过 Anthropic API 使用 Claude 解决真实世界任务,建议查看这门实践课程。
Haiku 4.5 用例
我认为 Haiku 4.5 为多模型组合与多代理架构带来了更聪明的实现方式。例如,Anthropic 着重介绍的最常见方案是将 Sonnet 4.5 与 Haiku 4.5 搭配使用。
在该方案中,Sonnet 4.5 充当“规划者”,将复杂问题拆解为更小、定义明确的子任务;随后由多个 Haiku 4.5 实例并行执行这些任务。由于并行处理,同时又有 Sonnet 4.5 负责规划,这种工作流既更快,又更准确。
另一个理想用例是需要实时交互与低延迟的场景,如聊天助手、客服机器人或结对编程伙伴。其响应性与效率使其非常适合这类“常在线”应用。
此外,当您为用户构建免费层 AI 代理时,如果使用 Sonnet 4.5,则所有模型使用成本都将由您承担,规模化后费用会迅速攀升,难以承受。
在这些情况下,使用 Haiku 的性价比要高得多,其价格约为每百万输入令牌 1 美元、每百万输出令牌 5 美元,而高端模型分别为 3 美元和 15 美元。
结论
我喜欢 Anthropic 让 Haiku 4.5 的性能达到与 Sonnet 4(五个月前的最强模型)相当的水平,同时将速度提升至 2 倍、价格降至三分之一。
老实说,这感觉就像以三分之一的价格,换个名字买到了 Sonnet 4。
Anthropic 还表示,Haiku 4.5 在某些任务上甚至超越了 Sonnet。因此,这次发布无疑壮大了 Haiku 家族;目前来自社区的反馈总体积极,尤其赞赏其更高的使用上限,让用户可以在不触顶的情况下运行更长的提示或对话。
总的来说,Haiku 4.5 仍是 Sonnet 4 的最佳替代方案,兼顾更低成本、更快性能与强大能力。它对多代理架构、实时交互及其他高性价比 AI 方案尤为有用。


Anthropic 刚刚发布了 Claude Haiku 4.5,这是其产品线中最新且体量最小的模型。距离上一次 Haiku 发布已近一年,而这一版本表现令人惊喜。尽管定位为轻量模型,它的性能已可与 Claude Sonnet 4 相媲美(后者在五个月前还被认为是最佳编程模型),在某些方面甚至更胜一筹。
此次发布,Anthropic 继续保持 Haiku 小而实惠的定位,同时增强了推理能力并带来一系列先进新特性。下文将详细展开。
一如既往,Anthropic 的发布说明语气颇为大胆,至于这些说法能否站得住脚,还需要真实世界的测试与社区反馈。但就目前而言,我们已有许多内容可供拆解,包括 Anthropic 的内部基准测试结果以及我对 Haiku 4.5 的亲身测试。
在本文中,我还将解读它与其他 Anthropic 模型,以及 GPT 和 Gemini 的对比表现。您也可以查看我们针对另一款新模型Claude Sonnet 4.5以及Claude Agents SDK的单独指南。
什么是 Claude Haiku 4.5?
Claude Haiku 4.5 是 Anthropic 推出的一款小型、低成本 AI 模型。该模型支持 200,000 令牌的上下文窗口,最多可输出 64,000 个令牌,并可处理文本与图像。4.5 也是首个引入扩展思考、计算机使用与上下文感知等高级功能的 Haiku 版本,我们会在下一节展开讨论。
据 Anthropic 称,依赖 AI 执行实时、低延迟任务(如聊天助手、客服代理或结对编程)的用户,将会欣赏 Haiku 4.5 在高智能与卓越速度之间的平衡。
值得注意的是,两周前发布的 Claude Sonnet 4.5 仍是 Anthropic 的最佳编程模型。与此同时,Haiku 4.5 旨在以更低价格提供接近前沿的性能,非常适合可扩展、对成本敏感的工作负载。
Haiku 4.5 是 Anthropic 最便宜的模型吗?
Claude Haiku 4.5 的定价为每百万输入令牌 1 美元、每百万输出令牌 5 美元。相比 Sonnet 系列仍便宜许多,但相较上一代 Haiku 3.5,这次价格上调了 25%。
在 Haiku 产品家族内,价格逐步攀升。更早的版本(如 Haiku 3)比对应的 Sonnet 模型大约便宜 12 倍。如今差距缩小至约 3 倍,也就是说 Haiku 4.5 比 Sonnet 4.5 大约便宜三倍。
即便如此,从性能提升来看,这次涨价仍然物有所值。基准测试显示,Haiku 4.5 的表现几乎与 Sonnet 4 打平,在某些方面还接近 Sonnet 4.5。因此,当您需要在大规模场景中具备更强的思考能力和复杂问题求解时,它是不二之选。但对于不需要太多智能的常规任务,继续使用 Haiku 3.5 更合适。
Claude Haiku 4.5 的新功能
Haiku 4.5 带来了此前只在 Sonnet、Opus 等前沿模型中提供的多项高级能力。这些特性在保持低成本的同时,缩小了轻量模型与大型模型之间的差距。
扩展思考
Haiku 4.5 增加了类似 Sonnet 模型的扩展思考模式。启用后,模型会在回复前为自己留出更多时间处理复杂问题。它还会以可视化且透明的方式呈现部分思考链,在处理过程中展示部分内部推理。这种可见性更便于判断模型的逻辑,并在处理更困难、分步骤的任务时更信任其输出。
计算机使用
计算机使用功能让模型可以像人一样与计算机交互,例如移动光标、点击按钮、通过虚拟键盘输入或填写表单。
它能理解任意软件界面的截图,并决定下一步操作,无论是滚动、输入文本还是打开链接。实际效果上,这意味着 Claude 可以独立操作计算器或记事本等工具,甚至处理自研软件应用。
那么表现如何?在计算机使用基准测试中,Claude Haiku 4.5 的成功率为 50.7%,即大约一半任务能成功完成。这相较 Sonnet 3.5 首次给出的 14% 基准有大幅提升,且以三分之一的价格超过了 Sonnet 4 的 42.2% 分数。对于一款紧凑模型而言,这是在真实计算机交互中的一个令人印象深刻的里程碑。
上下文感知
上下文感知指模型会跟踪对话中已使用的上下文窗口(令牌)量。这有助于它更高效地管理 200k 的有限上下文窗口,避免在任务中途耗尽上下文。
例如,当 Haiku 发现接近上下文上限时,它可以自动总结早期步骤,存储关键细节,并移除较早任务的完整上下文,为新的上下文腾出空间。
测试 Claude Haiku 4.5
我使用 Claude 网页端与 Haiku 4.5 进行了对话,并给了它一些编程任务,看看它的表现如何。
1. 基础记账应用
在此前的Claude Sonnet 4.5 测试中,我们让它构建了一个简单的健康习惯应用。这次我想看看 Haiku 4.5 处理类似需求的表现:一个个人支出追踪器。实话说,我很惊艳。
在成本仅为其一小部分、速度大约翻倍的情况下,Haiku 4.5 根据我的提示交付了一个完整响应式的应用。最终效果与 Sonnet 4.5 产出一样准确、现代。
我的提示如下:
“我想做一个应用,帮助我以简单、可视化且具有激励性的方式记录个人支出。我希望设计风格平静有序——可以使用柔和的蓝色、灰色,并点缀一点金色。应用应让我轻松记录每日支出、进行分类(如餐饮、出行、账单、娱乐),并用简洁的图表可视化开销。我希望有一个月度汇总页面,展示总支出、储蓄以及一段时间内的趋势。此外需要有预算目标板块,用于追踪储蓄目标的进度,并能为每条记录添加备注或收据。理想情况下,界面要友好现代,帮助我更专注于理财,而不是感到压力。”
它很快就在浏览器中开始编码,并在数秒内生成了一个可运行的完整原型。应用包含多个页面,并有与需求相契合的细节:
预算目标(Budget Goals)板块,您可以设定支出上限并随时间追踪进度。
在开销(expenses)选项卡下,您可以记录购买、选择类别、添加备注并附上日期。
仪表盘视图(Dashboard)用图表与条形图可视化消费模式。
最让我印象深刻的是它执行指令的流畅度。仅凭这一条详细提示,Haiku 4.5 就把整个应用搭建了出来。
截图测试
接着,我想看看 Haiku 4.5 处理视觉输入的能力。我上传了一张截图,并提示它“创建与截图中相同的应用,但将左侧菜单栏移到页眉(header)区域。”
输出: 模型立刻生成了与截图非常相似的界面,并按要求将菜单整齐地重排到页面顶部。
不过该版本是静态的,每个菜单区块显示的内容都相同。于是我追加了一条提示来补充功能性:
“为菜单栏中的各部分添加功能。目前页面代表 Home 区域。
输出: Haiku 再次快速响应,扩展了 UI 以包含所有所需功能。如下图所示为“Albums”区域。
下图为“Songs”区域的界面。
Claude Haiku 4.5 基准测试
随 Haiku 4.5 一同发布的,还有与 Sonnet 4.5、Sonnet 4、GPT-5 和Gemini 2.5 Pro的完整基准对比。综合考虑速度与成本,这些数字确实相当亮眼。
为便于理解,以下是 Anthropic 的测试方式以及 Haiku 4.5 的亮点:
代理式编程
Anthropic 使用 SWE-bench Verified 基准测试其 AI 模型,该测试衡量模型修复 GitHub 仓库中 500 个真实缺陷的能力。Anthropic 称为确保统计可靠性,结果取 50 次独立运行的平均值。结果显示,Claude Haiku 4.5 的准确率达到 73.3%,仅次于 Claude Sonnet 4.5,甚至超过了 Sonnet 4 模型。
计算机使用
在计算机使用测试中,Anthropic 采用 OSWorld-Verified 框架。该数据集评估模型在打开文件、管理设置、与网站交互等真实计算机任务中的执行效果。Haiku 4.5 再次表现强劲,排名仅次于 Sonnet 4.5,并领先 Sonnet 4。
视觉推理
Anthropic 使用 MMMU(大规模多学科多模态理解)基准来测试视觉推理。该基准衡量模型在多个领域中对文本与图像进行理解和推理的能力。结果在 128k 思考预算下,取 10 次运行平均,显示GPT-5以 84.2% 的准确率领先,Claude Sonnet 4 和 Haiku 4.5 紧随其后,分别为 74.4% 与 73.2%。
如何访问 Claude Haiku 4.5
Claude Haiku 4.5 可通过多种渠道获取。Anthropic 直接提供聊天访问与 API 访问。诸如 Amazon Bedrock 与 Google Cloud Vertex AI 等自定义 AI 代理构建平台也已集成 Haiku 4.5,开发者可在这些平台上用 Haiku 4.5 驱动自定义 AI 代理。
聊天访问
您可以在 Claude 网页端或 Claude 移动应用中直接与 Haiku 4.5 对话。我的测试使用的是网页版本,只需在可用模型列表中选择 Haiku 即可。它对免费层用户也开放,但有一定使用限制。
API 访问
您可以在 Anthropic Console 注册并从中复制您的API 密钥。然后,您可以在终端中结合 cURL 命令使用该密钥,模型会以 JSON 格式返回响应。Anthropic 也提供官方 SDK(Python 与 TypeScript),让您无需每次手动调用 API,便可通过代码便捷地使用 Claude 模型(如 Sonnet 或 Haiku)。
您也可以在 Python 应用中借助 requests 库使用该 API。
如果您想通过 Anthropic API 使用 Claude 解决真实世界任务,建议查看这门实践课程。
Haiku 4.5 用例
我认为 Haiku 4.5 为多模型组合与多代理架构带来了更聪明的实现方式。例如,Anthropic 着重介绍的最常见方案是将 Sonnet 4.5 与 Haiku 4.5 搭配使用。
在该方案中,Sonnet 4.5 充当“规划者”,将复杂问题拆解为更小、定义明确的子任务;随后由多个 Haiku 4.5 实例并行执行这些任务。由于并行处理,同时又有 Sonnet 4.5 负责规划,这种工作流既更快,又更准确。
另一个理想用例是需要实时交互与低延迟的场景,如聊天助手、客服机器人或结对编程伙伴。其响应性与效率使其非常适合这类“常在线”应用。
此外,当您为用户构建免费层 AI 代理时,如果使用 Sonnet 4.5,则所有模型使用成本都将由您承担,规模化后费用会迅速攀升,难以承受。
在这些情况下,使用 Haiku 的性价比要高得多,其价格约为每百万输入令牌 1 美元、每百万输出令牌 5 美元,而高端模型分别为 3 美元和 15 美元。
结论
我喜欢 Anthropic 让 Haiku 4.5 的性能达到与 Sonnet 4(五个月前的最强模型)相当的水平,同时将速度提升至 2 倍、价格降至三分之一。
老实说,这感觉就像以三分之一的价格,换个名字买到了 Sonnet 4。
Anthropic 还表示,Haiku 4.5 在某些任务上甚至超越了 Sonnet。因此,这次发布无疑壮大了 Haiku 家族;目前来自社区的反馈总体积极,尤其赞赏其更高的使用上限,让用户可以在不触顶的情况下运行更长的提示或对话。
总的来说,Haiku 4.5 仍是 Sonnet 4 的最佳替代方案,兼顾更低成本、更快性能与强大能力。它对多代理架构、实时交互及其他高性价比 AI 方案尤为有用。