作为数据素养月的一部分,本系列将澄清数据世界中的关键概念,回答您可能不好意思问的问题,并在此过程中保持趣味性。如果您想从头开始,请阅读系列的第一篇文章:什么是数据集?
您是否听过“相关性不代表因果性”这句话?这是一个常见陷阱,不仅会让数据爱好者犯错,也会让专业人士栽跟头。本文将探讨相关性与因果性的关键区别,澄清一些误区,并通过真实案例帮助您避免在数据解读中最严重的错误之一。
什么是相关性?
相关性衡量的是两件事之间的关系。也就是说,当一件事上升时,另一件事是会上升还是下降?下面的散点图展示了2017 年美国社区调查的数据。横轴是美国 50 个州的平均年收入,纵轴是这些州的平均月租。随着收入增加,租金支付也随之提高。
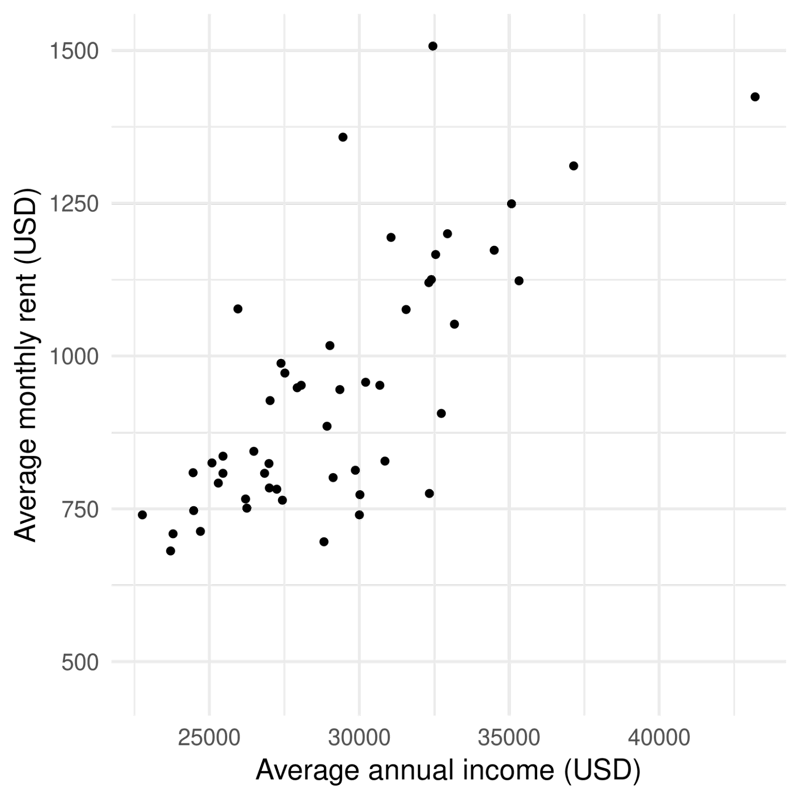
年收入与平均月租(单位:美元)的比较
如果当一方上升时另一方也上升——就像这个例子那样——我们称之为正相关。如果当一方上升时另一方下降,则称为负相关。
在统计学和数据科学中,相关性有更精确的含义,通常是指两个变量之间线性关系的强度。在下方的散点图变体中,我们为数据拟合了一条直线。该直线与点的走势较为接近,表明收入与租金之间存在线性关系。
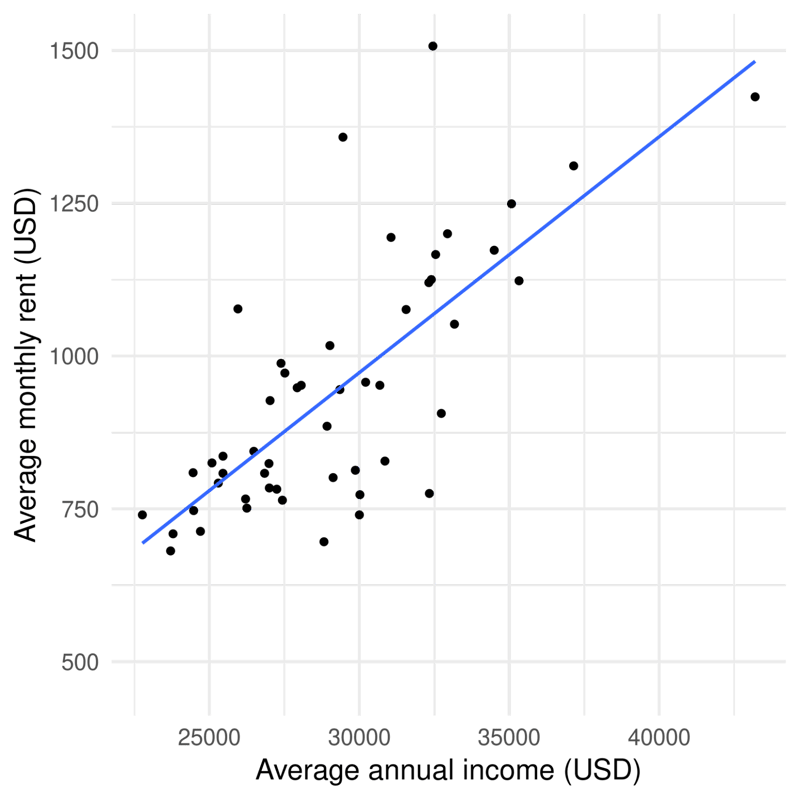
在两个变量之间拟合的一条直线,表明二者之间存在正向关系
相比之下,在下面这个使用经典 diamonds 数据集的示例中,如果我们将钻石的价格与其克拉重量作图,并绘制一条最佳拟合线,您会看到这条线向上弯曲。也就是说,价格增长快于线性增长。
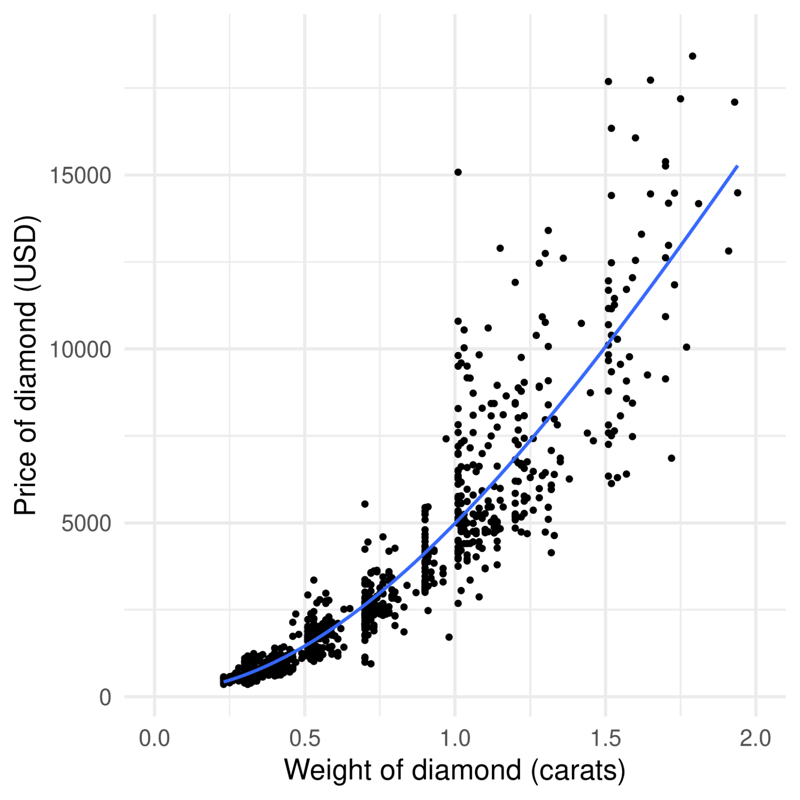
相关性能够捕捉到二者之间的正向关系——随着重量增加,价格也随之上升——但无法反映这种关系的非线性特征。
什么是因果性?
因果性是比相关性更强的陈述。它意味着一件事的变化会导致另一件事发生变化。您在医学建议中经常会看到因果性的例子,例如“吸烟会导致癌症”或“服用布洛芬可减轻疼痛”。
在日常生活中也有许多因果性的例子。健康饮食会带来更好的生活方式结果,健身会让您体型更好,而在DataCamp 学习会让您更懂数据。
相关性-因果性谬误
相关性-因果性谬误指的是人们仅凭相关性就断定存在因果关系。在收入与租金的例子中,数据表明租金支付与收入呈正相关。然而,经济学很复杂,仅凭这些数据不足以断言更高的收入会导致更高的租金支付。
这种谬误在大多数社会中普遍存在,因为每个从事市场营销的人都希望您相信,购买他们的产品会让您的生活变得更好,而无须花时间进行严谨的科学实验来验证。这一理念在 The Tamperer 上世纪 90 年代的流行单曲 If you Buy This Record (Your Life Will Be Better) 中被推向了逻辑极致。相关性可能出现于三种主要情况,而因果性则未必如此。
巧合关系
只要数据量足够大,两个完全不相关的事物也可能表现出相关性。下面的例子来自 Tyler Vigen 精彩的伪相关网站。该折线图显示,美国缅因州的离婚率与人均人造黄油消费量高度相关。
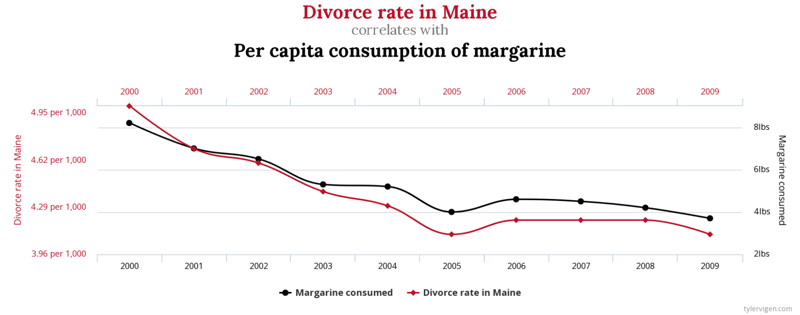
认为人们吃多少人造黄油会影响一个州范围内的离婚率显然荒谬,因此我们不能声称存在因果关系。这里展示的相关性纯属巧合。
即便是投资者也难逃这一逻辑谬误。超级碗指标声称,如果国家橄榄球联合会的球队赢得超级碗,总体股市将上涨;如果美式橄榄球联合会的球队获胜,股市将下跌。
混杂变量
当第三个因素(“混杂变量”)同时影响表面上的原因与结果时,也会出现相关性。
一个经典例子是,晒伤与冰淇淋销量相关。要是说吃冰淇淋会导致晒伤增多,就太可笑了。更合理的解释是,在炎热晴朗的天气里,人们更可能吃冰淇淋,也更可能去日光浴。因此,天气就是混杂变量。
2001 年,一篇科学论文指出,多吃蔬菜和橄榄油的人皮肤不易起皱。这一观察本身是成立的,但Ben Goldacre 在一次 TED 演讲中指出,营养学家抓住这一结果不放,开始宣称吃橄榄油会让您更少长皱纹。这忽略了若干混杂因素的影响。与其他食用油相比,橄榄油更贵,所以能够经常食用橄榄油的人更可能从事日晒较少的室内工作,也更不太可能吸烟,更不用说研究中未考虑到的成百上千种其他生活方式差异了。
反向因果
反向因果是指人们混淆了因与果的方向。一个滑稽的例子是,当风力发电机转得更快时,您也会检测到更大的风速,于是得出“风是由风力发电机旋转产生的”这一结论。稍微想一想,您就会意识到,因果应当反过来:风导致风力发电机旋转。
在医学数据分析中,理解因果方向是一个常见难题。比如,抑郁与大麻使用呈正相关。也就是说,抑郁的人更可能吸食大麻。举例来说,这篇论文发现,2016 年抑郁人群近乎每日吸食大麻的几率比非抑郁人群高出 216%。
关于究竟是谁导致谁,长期以来争论不休。是吸食大麻导致抑郁,还是抑郁使人更倾向于吸食大麻?这篇论文表明,因果可能双向发生。也有证据显示,使用大麻可能引发抑郁的发生;不过更有力的证据指向相反的关联,即抑郁可能导致大麻使用的开始或频率增加。
如何建立因果性?
判定因果性比想象中更棘手。要建立因果性,您需要满足以下四点。
- 相关性:虽然两个事物之间存在相关性并不保证存在因果性,但它是必要条件。如果不存在相关性,就不可能存在因果关系。
- 时间先后关系:您认定的“原因”必须先于您认为的“结果”发生。
- 作用机制:必须能够解释第一件事如何会导致第二件事。
- 控制混杂变量:需要通过严谨的实验设计、数据收集与统计方法来控制可能的混杂变量的影响。
观察性研究与实验性研究
在探索变量关系时,研究大致分为两类。
- 观察性研究以不干预数据产生过程的方式收集数据。前面提到的橄榄油研究就是例子:它记录的是人们的饮食,而不是规定某些人必须用橄榄油烹饪、另一些人不能用。
- 实验会将受试者随机分配到不同“处理”中。这在药物测试中很常见,一些人服用真实药物,另一些人服用安慰剂。
观察性研究通常很难甚至无法确定因果性。然而,经过恰当设计与实施的实验可以确定因果关系。您可以在我们下一篇《数据解密:什么是 A/B 测试》中了解更多有关实验的内容。
想要了解更多?
总而言之,相关性-因果性谬误已被广泛研究,也是您在提升数据能力的早期最容易踩中的大坑之一。请记住以下几点:
- 相关性衡量的是两件事之间的关系。
- 您并不能总是从相关关系推断出因果关系。
- 要判定因果性,您需要进行实验。
若要进一步提升您的技能,请学习统计学入门,开启您的数据素养之旅。数据解密系列的下一篇将更深入地探讨实验,聚焦于一种名为A/B 测试的实践。在此期间,欢迎查看以下资源:

作为数据素养月的一部分,本系列将澄清数据世界中的关键概念,回答您可能不好意思问的问题,并在此过程中保持趣味性。如果您想从头开始,请阅读系列的第一篇文章:什么是数据集?
您是否听过“相关性不代表因果性”这句话?这是一个常见陷阱,不仅会让数据爱好者犯错,也会让专业人士栽跟头。本文将探讨相关性与因果性的关键区别,澄清一些误区,并通过真实案例帮助您避免在数据解读中最严重的错误之一。
什么是相关性?
相关性衡量的是两件事之间的关系。也就是说,当一件事上升时,另一件事是会上升还是下降?下面的散点图展示了2017 年美国社区调查的数据。横轴是美国 50 个州的平均年收入,纵轴是这些州的平均月租。随着收入增加,租金支付也随之提高。
年收入与平均月租(单位:美元)的比较
如果当一方上升时另一方也上升——就像这个例子那样——我们称之为正相关。如果当一方上升时另一方下降,则称为负相关。
在统计学和数据科学中,相关性有更精确的含义,通常是指两个变量之间线性关系的强度。在下方的散点图变体中,我们为数据拟合了一条直线。该直线与点的走势较为接近,表明收入与租金之间存在线性关系。
在两个变量之间拟合的一条直线,表明二者之间存在正向关系
相比之下,在下面这个使用经典 diamonds 数据集的示例中,如果我们将钻石的价格与其克拉重量作图,并绘制一条最佳拟合线,您会看到这条线向上弯曲。也就是说,价格增长快于线性增长。
相关性能够捕捉到二者之间的正向关系——随着重量增加,价格也随之上升——但无法反映这种关系的非线性特征。
什么是因果性?
因果性是比相关性更强的陈述。它意味着一件事的变化会导致另一件事发生变化。您在医学建议中经常会看到因果性的例子,例如“吸烟会导致癌症”或“服用布洛芬可减轻疼痛”。
在日常生活中也有许多因果性的例子。健康饮食会带来更好的生活方式结果,健身会让您体型更好,而在DataCamp 学习会让您更懂数据。
相关性-因果性谬误
相关性-因果性谬误指的是人们仅凭相关性就断定存在因果关系。在收入与租金的例子中,数据表明租金支付与收入呈正相关。然而,经济学很复杂,仅凭这些数据不足以断言更高的收入会导致更高的租金支付。
这种谬误在大多数社会中普遍存在,因为每个从事市场营销的人都希望您相信,购买他们的产品会让您的生活变得更好,而无须花时间进行严谨的科学实验来验证。这一理念在 The Tamperer 上世纪 90 年代的流行单曲 If you Buy This Record (Your Life Will Be Better) 中被推向了逻辑极致。相关性可能出现于三种主要情况,而因果性则未必如此。
巧合关系
只要数据量足够大,两个完全不相关的事物也可能表现出相关性。下面的例子来自 Tyler Vigen 精彩的伪相关网站。该折线图显示,美国缅因州的离婚率与人均人造黄油消费量高度相关。
认为人们吃多少人造黄油会影响一个州范围内的离婚率显然荒谬,因此我们不能声称存在因果关系。这里展示的相关性纯属巧合。
即便是投资者也难逃这一逻辑谬误。超级碗指标声称,如果国家橄榄球联合会的球队赢得超级碗,总体股市将上涨;如果美式橄榄球联合会的球队获胜,股市将下跌。
混杂变量
当第三个因素(“混杂变量”)同时影响表面上的原因与结果时,也会出现相关性。
一个经典例子是,晒伤与冰淇淋销量相关。要是说吃冰淇淋会导致晒伤增多,就太可笑了。更合理的解释是,在炎热晴朗的天气里,人们更可能吃冰淇淋,也更可能去日光浴。因此,天气就是混杂变量。
2001 年,一篇科学论文指出,多吃蔬菜和橄榄油的人皮肤不易起皱。这一观察本身是成立的,但Ben Goldacre 在一次 TED 演讲中指出,营养学家抓住这一结果不放,开始宣称吃橄榄油会让您更少长皱纹。这忽略了若干混杂因素的影响。与其他食用油相比,橄榄油更贵,所以能够经常食用橄榄油的人更可能从事日晒较少的室内工作,也更不太可能吸烟,更不用说研究中未考虑到的成百上千种其他生活方式差异了。
反向因果
反向因果是指人们混淆了因与果的方向。一个滑稽的例子是,当风力发电机转得更快时,您也会检测到更大的风速,于是得出“风是由风力发电机旋转产生的”这一结论。稍微想一想,您就会意识到,因果应当反过来:风导致风力发电机旋转。
在医学数据分析中,理解因果方向是一个常见难题。比如,抑郁与大麻使用呈正相关。也就是说,抑郁的人更可能吸食大麻。举例来说,这篇论文发现,2016 年抑郁人群近乎每日吸食大麻的几率比非抑郁人群高出 216%。
关于究竟是谁导致谁,长期以来争论不休。是吸食大麻导致抑郁,还是抑郁使人更倾向于吸食大麻?这篇论文表明,因果可能双向发生。也有证据显示,使用大麻可能引发抑郁的发生;不过更有力的证据指向相反的关联,即抑郁可能导致大麻使用的开始或频率增加。
如何建立因果性?
判定因果性比想象中更棘手。要建立因果性,您需要满足以下四点。
观察性研究与实验性研究
在探索变量关系时,研究大致分为两类。
观察性研究通常很难甚至无法确定因果性。然而,经过恰当设计与实施的实验可以确定因果关系。您可以在我们下一篇《数据解密:什么是 A/B 测试》中了解更多有关实验的内容。
想要了解更多?
总而言之,相关性-因果性谬误已被广泛研究,也是您在提升数据能力的早期最容易踩中的大坑之一。请记住以下几点:
若要进一步提升您的技能,请学习统计学入门,开启您的数据素养之旅。数据解密系列的下一篇将更深入地探讨实验,聚焦于一种名为A/B 测试的实践。在此期间,欢迎查看以下资源: