几乎所有数据科学项目都离不开对变量间相关性的研究。相关性是两组变量之间关系的统计性概括。它是探索性数据分析的核心内容之一,也是众多高级机器学习技术的关键组成部分。如果您正考虑进入数据科学领域,那么在学习旅程中的某个阶段,您必然需要掌握相关性。
在本教程中,我们将解释什么是相关性,以及它在开展数据科学项目时的意义。我们还将了解用于衡量变量之间关系强度与方向的不同相关系数。我们会用 Python 代码给出如何以简洁方式度量与可视化相关性的实用示例。
什么是相关性?
相关性是对两个变量之间关系或依赖性的统计分析。相关性使我们能够研究两组变量之间关系的强度和方向。
研究相关性在许多数据科学任务中都非常有用。首先,它是探索性数据分析的关键环节;也就是我们对数据所做的初步研究,以了解其外观、概括其主要特征,并发现模式与异常。
其次,相关性在现实世界中有许多应用。它能帮助我们回答一些问题,例如民主与经济增长之间是否存在联系,或者汽车使用是否与空气污染程度相关。
最后,相关性的研究在机器学习领域至关重要。例如,如果两个或多个变量紧密相关(通常称为多重共线性),某些算法将无法正常工作。相关性也是主成分分析(一种线性降维技术)的基础,而这在机器学习项目中非常有用。
相关性有不同类型:
- 正相关:当两个变量的取值同向变化时,称它们为正相关。例如,在下图中,随着 X 的取值增加,Y 的取值也以恒定速率增加:
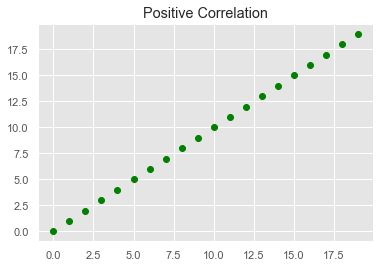
- 零相关:变量 X 与 Y 的变化之间不存在关系。在这种情况下,取值完全随机,不显示任何相关性迹象,如下图所示:
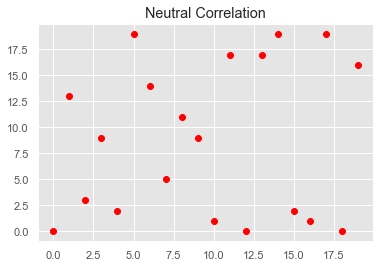
- 负相关:当变量 X 与 Y 的取值反向变化时,它们为负相关,即随着 X 的取值增加,Y 的取值以恒定速率减少:
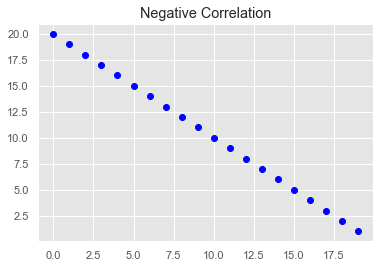
绘制数据是发现变量间相关性类型最快、最有效的方法。可视化两个变量依赖关系的典型方式是散点图。散点图中,x 轴为第一个变量的取值,y 轴为第二个变量的取值。前面的三幅图就是散点图的类型。查看这个视频教程,了解如何在 Python 中创建散点图。
不过,有时我们不仅需要可视化相关性,还需要衡量相关性的强弱。这就需要用到相关系数。
相关系数
相关系数是一种统计性概括,用于度量两个变量之间相关关系的强度与方向。
相关系数的一个优势在于,它以标准化方式估计两个变量之间的相关性,这意味着系数的值总是在同一量表上,范围为 -1.0 到 1.0。
相关系数有多种。选择哪一种取决于我们对变量关系结构的了解程度。不过,数据科学家通常会采用最常见的一种:皮尔逊相关系数。
皮尔逊相关系数
皮尔逊相关系数(r)用于衡量两个变量之间线性关系的强度。它通过将变量 X 和 Y 的协方差除以各自标准差的乘积来计算,如下式所示:
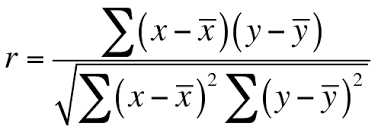
该系数基于两个假设。其一,假设两个变量服从正态(高斯)分布。如果数据不满足正态分布,则其他系数可能更可靠。
其二,假设两变量之间存在线性关系,即数据的变化可以用线性函数建模(即它们的取值以恒定速率同时增加或减少)。如果两变量之间的关系越接近一条直线,它们的(线性)相关性就越强,皮尔逊相关系数的绝对值就越高。例如,在下一幅图中,所有数据点都可被一条直线完美拟合,相关系数等于 1.0。
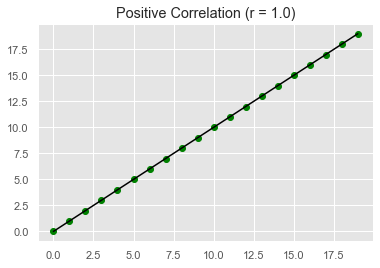
系数为 -1.0 表示完全负相关,而系数为 1.0 表示完全正相关。相反,系数为 0.0 表示变量之间不存在线性相关。
当系数值接近零时,解释会变得更加困难。为此,人们提出了一些经验法则来帮助解读系数值。其中较为流行的一种由 Dennis E. Hinkle 及其合著者在其著作Applied Statistics for the Behavioral Sciences中提出:
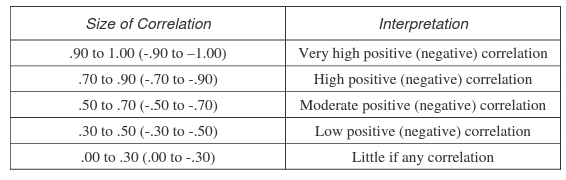 解读相关系数的经验法则。Hinkle、Wiersma 与 Jurs。
需要强调的是,皮尔逊相关系数接近 0.0 只意味着变量之间没有线性关系。但也可能存在很强的非线性关系。若两变量之间的关系为非线性,随着某个变量的变化,增长或减少的速率可能发生改变,在数据中呈现出类似曲线的形态。这类趋势更适合用非线性函数(如二次或三次函数)来建模。
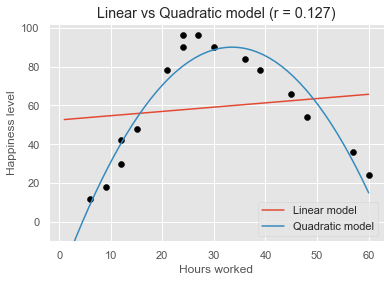
例如,下图展示了员工的幸福感如何随着每周工作时长而变化。可以看到,随着工作小时数增加,幸福感也上升,但在大约 35 小时后开始下降。线性模型(红线)并不适合拟合这些数据。而二次模型(蓝线,亦即次数为 2 的多项式模型)似乎更能贴合这条弯曲的曲线。当关系为非线性时,相关性通常会低估其强度。在我们的示例中,系数为 0.127,几乎无法反映幸福感与工作时长之间的非线性关系。
其他相关系数
皮尔逊相关系数最大的局限在于假设两变量之间为线性关系。然而,更多情况下,变量之间呈现非线性关系。此外,手头数据可能并不服从高斯分布。为弥补这一缺陷,统计学家提出了其他类型的估计量,即斯皮尔曼 rho 与肯德尔 tau 相关系数。
皮尔逊系数假设线性关系,而斯皮尔曼与肯德尔系数仅假设变量之间是单调关系。在单调关系中,变量倾向于沿同一相对方向变化,但不一定以恒定速率。换言之,所有线性关系都是单调的,但并非所有单调关系都是线性的。
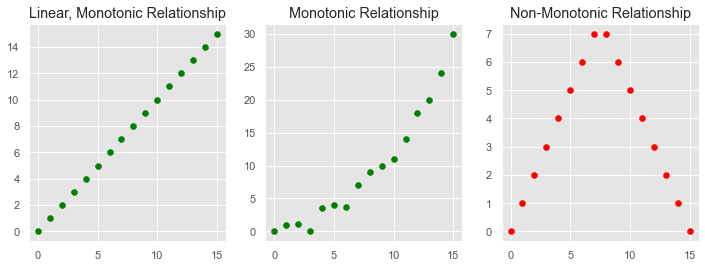
与依据变量的协方差与标准差计算系数不同,它们基于变量取值的相对秩次来计算。此特性使其对极端值具有鲁棒性,并适合处理某些类型的非线性。
与皮尔逊相关系数一样,斯皮尔曼与肯德尔系数的取值在 -1 到 1 之间,分别对应完全负相关与完全正相关。
不过,在大多数情况下,数据科学家通常仍采用皮尔逊相关系数。基于秩的估计量更适合小数据集与特定假设检验。
在 Python 中计算相关性
有多种 Python 包可以帮助我们度量相关性。本节将聚焦三大常用包中的相关函数:SciPy、NumPy 与 pandas。
为演示这些函数,假设我们想研究一家由 16 名员工组成、发展良好的初创公司中,工作经验(以年计)与薪资(以美元计)之间的关系。
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
技术支持
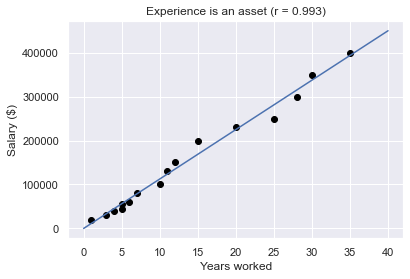
从下图可以看到,这两个变量之间存在强烈的正相关关系,这意味着更有经验的员工往往拥有更高的薪资。
SciPy 是执行统计运算的优秀库。scipy.stats 模块提供了 pearsonr(x, y) 函数,用于计算两组数据样本之间的皮尔逊相关系数。
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
技术支持
我们也可以以同样的方式计算斯皮尔曼与肯德尔系数:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
技术支持
NumPy 是一个流行的包,提供了大量高级数学函数,其中包括返回皮尔逊相关系数矩阵的 np.corrcoef():
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
技术支持
相关矩阵是一张显示变量间相关系数的表格。表中每个单元格都显示两变量之间的相关性。矩阵对角线包含每个变量与其自身之间的系数,恒为 1.0。矩阵中的其他值表示“经验”与“薪资”之间的相关性。在本例中,由于我们只对两变量计算相关性,这些值相同。
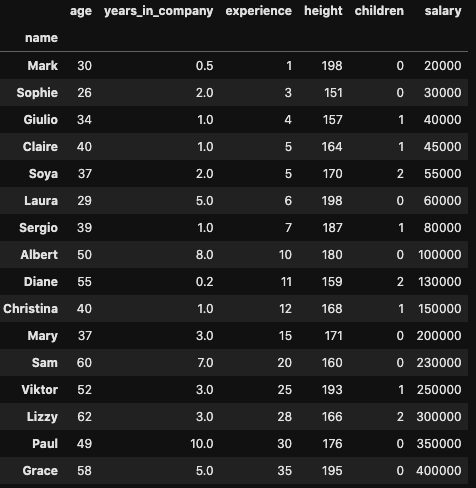
最后,我们通常需要对存储在 pandas DataFrame 中的变量计算相关性。设想我们有一个包含这家初创公司员工信息的 DataFrame:
如果想计算两列之间的相关性,可以使用 pandas 的 .corr() 方法,如下所示:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
技术支持
.corr() 包含参数 "method",可用于计算三种相关系数。默认情况下计算的是皮尔逊系数。
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
技术支持
如果我们想要探索所有变量对之间的相关性,只需直接对 DataFrame 使用 .corr() 方法,即可得到包含所有变量对系数的相关矩阵:
df.corr()
技术支持
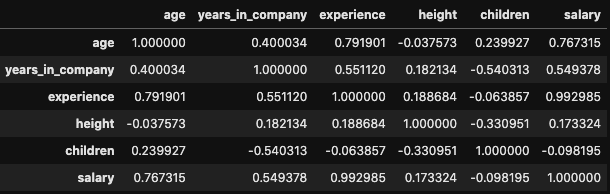
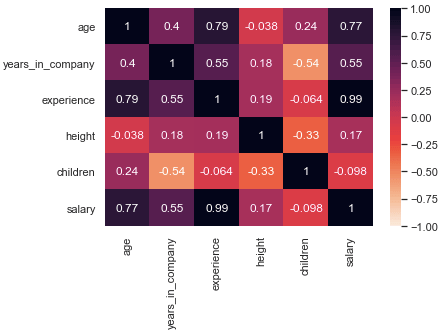
当 DataFrame 包含许多列时,相关矩阵可能非常庞大且难以解读。为了更高效地提炼矩阵中的信息,我们可以使用热力图——一种数据可视化技术,其中每个值都会根据其在给定量表上的强度以颜色表示。创建热力图最快的方法是使用 seaborn 库中的 heatmap() 函数:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
技术支持
相关性不等于因果性
如果不强调一个重要提醒,我们就无法结束本教程:相关性不等于因果性。
相关性只量化两个变量之间关系的强度与方向。即便两个变量之间存在很强的相关性,我们也不能据此得出其中一个导致了另一个的结论。若强相关并非因果关系,我们称其为伪相关。
以下两种情形可能导致伪相关:
- 首先,可能存在第三个“混杂”变量在同时影响这两个变量。设想某人群中冰淇淋消费与中暑人数之间存在强正相关。若因此得出“吃冰淇淋会导致中暑”的结论便荒谬了。事实上,两者都取决于第三个变量,很可能是气温。气温越高,喜欢吃冰淇淋的人越多,同时更容易发生中暑。
- 其次,需要对相关性保持谨慎的另一个原因是,变量之间的依赖关系可能纯属偶然。这种情况经常发生,在样本较小时更为常见。
最后,还有一个需要谨慎对待相关性的原因在于我们所处的世界很复杂。两个变量之间更强的相关性很容易让我们误以为一个导致了另一个。认为某一结果只有单一原因的观念被称为单因论,但现实中这种情况很少。某个结果背后可能由多个变量共同作用。因此,要考虑因果性,首先需要把系统中的所有要素纳入考虑,并不仅通过定量(如统计方法),也要通过定性方式进行评估。
基于以上原因,在对数据中的关系作出任何结论之前,都应进行更全面、更细致的分析,以识别可能存在的伪相关。
结论
希望您喜欢本教程。相关性是每位有志成为数据科学家的人士都应学习的重要主题。在 DataCamp,我们提供大量统计学课程,涵盖相关性、因果性以及其他关键统计概念,既有Python,也有R。
在打下坚实基础之后,我们建议您试试DataLab——DataCamp 的 AI 加持数据笔记本,让您无需安装烦恼即可编写代码并应用所学。


几乎所有数据科学项目都离不开对变量间相关性的研究。相关性是两组变量之间关系的统计性概括。它是探索性数据分析的核心内容之一,也是众多高级机器学习技术的关键组成部分。如果您正考虑进入数据科学领域,那么在学习旅程中的某个阶段,您必然需要掌握相关性。
在本教程中,我们将解释什么是相关性,以及它在开展数据科学项目时的意义。我们还将了解用于衡量变量之间关系强度与方向的不同相关系数。我们会用 Python 代码给出如何以简洁方式度量与可视化相关性的实用示例。
什么是相关性?
相关性是对两个变量之间关系或依赖性的统计分析。相关性使我们能够研究两组变量之间关系的强度和方向。
研究相关性在许多数据科学任务中都非常有用。首先,它是探索性数据分析的关键环节;也就是我们对数据所做的初步研究,以了解其外观、概括其主要特征,并发现模式与异常。
其次,相关性在现实世界中有许多应用。它能帮助我们回答一些问题,例如民主与经济增长之间是否存在联系,或者汽车使用是否与空气污染程度相关。
最后,相关性的研究在机器学习领域至关重要。例如,如果两个或多个变量紧密相关(通常称为多重共线性),某些算法将无法正常工作。相关性也是主成分分析(一种线性降维技术)的基础,而这在机器学习项目中非常有用。
相关性有不同类型:
绘制数据是发现变量间相关性类型最快、最有效的方法。可视化两个变量依赖关系的典型方式是散点图。散点图中,x 轴为第一个变量的取值,y 轴为第二个变量的取值。前面的三幅图就是散点图的类型。查看这个视频教程,了解如何在 Python 中创建散点图。
不过,有时我们不仅需要可视化相关性,还需要衡量相关性的强弱。这就需要用到相关系数。
相关系数
相关系数是一种统计性概括,用于度量两个变量之间相关关系的强度与方向。
相关系数的一个优势在于,它以标准化方式估计两个变量之间的相关性,这意味着系数的值总是在同一量表上,范围为 -1.0 到 1.0。
相关系数有多种。选择哪一种取决于我们对变量关系结构的了解程度。不过,数据科学家通常会采用最常见的一种:皮尔逊相关系数。
皮尔逊相关系数
皮尔逊相关系数(r)用于衡量两个变量之间线性关系的强度。它通过将变量 X 和 Y 的协方差除以各自标准差的乘积来计算,如下式所示:
该系数基于两个假设。其一,假设两个变量服从正态(高斯)分布。如果数据不满足正态分布,则其他系数可能更可靠。
其二,假设两变量之间存在线性关系,即数据的变化可以用线性函数建模(即它们的取值以恒定速率同时增加或减少)。如果两变量之间的关系越接近一条直线,它们的(线性)相关性就越强,皮尔逊相关系数的绝对值就越高。例如,在下一幅图中,所有数据点都可被一条直线完美拟合,相关系数等于 1.0。
系数为 -1.0 表示完全负相关,而系数为 1.0 表示完全正相关。相反,系数为 0.0 表示变量之间不存在线性相关。
当系数值接近零时,解释会变得更加困难。为此,人们提出了一些经验法则来帮助解读系数值。其中较为流行的一种由 Dennis E. Hinkle 及其合著者在其著作Applied Statistics for the Behavioral Sciences中提出:
需要强调的是,皮尔逊相关系数接近 0.0 只意味着变量之间没有线性关系。但也可能存在很强的非线性关系。若两变量之间的关系为非线性,随着某个变量的变化,增长或减少的速率可能发生改变,在数据中呈现出类似曲线的形态。这类趋势更适合用非线性函数(如二次或三次函数)来建模。
例如,下图展示了员工的幸福感如何随着每周工作时长而变化。可以看到,随着工作小时数增加,幸福感也上升,但在大约 35 小时后开始下降。线性模型(红线)并不适合拟合这些数据。而二次模型(蓝线,亦即次数为 2 的多项式模型)似乎更能贴合这条弯曲的曲线。当关系为非线性时,相关性通常会低估其强度。在我们的示例中,系数为 0.127,几乎无法反映幸福感与工作时长之间的非线性关系。
其他相关系数
皮尔逊相关系数最大的局限在于假设两变量之间为线性关系。然而,更多情况下,变量之间呈现非线性关系。此外,手头数据可能并不服从高斯分布。为弥补这一缺陷,统计学家提出了其他类型的估计量,即斯皮尔曼 rho 与肯德尔 tau 相关系数。
皮尔逊系数假设线性关系,而斯皮尔曼与肯德尔系数仅假设变量之间是单调关系。在单调关系中,变量倾向于沿同一相对方向变化,但不一定以恒定速率。换言之,所有线性关系都是单调的,但并非所有单调关系都是线性的。
与依据变量的协方差与标准差计算系数不同,它们基于变量取值的相对秩次来计算。此特性使其对极端值具有鲁棒性,并适合处理某些类型的非线性。
与皮尔逊相关系数一样,斯皮尔曼与肯德尔系数的取值在 -1 到 1 之间,分别对应完全负相关与完全正相关。
不过,在大多数情况下,数据科学家通常仍采用皮尔逊相关系数。基于秩的估计量更适合小数据集与特定假设检验。
在 Python 中计算相关性
有多种 Python 包可以帮助我们度量相关性。本节将聚焦三大常用包中的相关函数:SciPy、NumPy 与 pandas。
为演示这些函数,假设我们想研究一家由 16 名员工组成、发展良好的初创公司中,工作经验(以年计)与薪资(以美元计)之间的关系。
从下图可以看到,这两个变量之间存在强烈的正相关关系,这意味着更有经验的员工往往拥有更高的薪资。
SciPy 是执行统计运算的优秀库。scipy.stats 模块提供了 pearsonr(x, y) 函数,用于计算两组数据样本之间的皮尔逊相关系数。
我们也可以以同样的方式计算斯皮尔曼与肯德尔系数:
NumPy 是一个流行的包,提供了大量高级数学函数,其中包括返回皮尔逊相关系数矩阵的 np.corrcoef():
相关矩阵是一张显示变量间相关系数的表格。表中每个单元格都显示两变量之间的相关性。矩阵对角线包含每个变量与其自身之间的系数,恒为 1.0。矩阵中的其他值表示“经验”与“薪资”之间的相关性。在本例中,由于我们只对两变量计算相关性,这些值相同。
最后,我们通常需要对存储在 pandas DataFrame 中的变量计算相关性。设想我们有一个包含这家初创公司员工信息的 DataFrame:
如果想计算两列之间的相关性,可以使用 pandas 的 .corr() 方法,如下所示:
.corr() 包含参数 "method",可用于计算三种相关系数。默认情况下计算的是皮尔逊系数。
如果我们想要探索所有变量对之间的相关性,只需直接对 DataFrame 使用 .corr() 方法,即可得到包含所有变量对系数的相关矩阵:
当 DataFrame 包含许多列时,相关矩阵可能非常庞大且难以解读。为了更高效地提炼矩阵中的信息,我们可以使用热力图——一种数据可视化技术,其中每个值都会根据其在给定量表上的强度以颜色表示。创建热力图最快的方法是使用 seaborn 库中的 heatmap() 函数:
相关性不等于因果性
如果不强调一个重要提醒,我们就无法结束本教程:相关性不等于因果性。
相关性只量化两个变量之间关系的强度与方向。即便两个变量之间存在很强的相关性,我们也不能据此得出其中一个导致了另一个的结论。若强相关并非因果关系,我们称其为伪相关。
以下两种情形可能导致伪相关:
最后,还有一个需要谨慎对待相关性的原因在于我们所处的世界很复杂。两个变量之间更强的相关性很容易让我们误以为一个导致了另一个。认为某一结果只有单一原因的观念被称为单因论,但现实中这种情况很少。某个结果背后可能由多个变量共同作用。因此,要考虑因果性,首先需要把系统中的所有要素纳入考虑,并不仅通过定量(如统计方法),也要通过定性方式进行评估。
基于以上原因,在对数据中的关系作出任何结论之前,都应进行更全面、更细致的分析,以识别可能存在的伪相关。
结论
希望您喜欢本教程。相关性是每位有志成为数据科学家的人士都应学习的重要主题。在 DataCamp,我们提供大量统计学课程,涵盖相关性、因果性以及其他关键统计概念,既有Python,也有R。
在打下坚实基础之后,我们建议您试试DataLab——DataCamp 的 AI 加持数据笔记本,让您无需安装烦恼即可编写代码并应用所学。