

什么是 GPT-4.5?
GPT-4.5 与 OpenAI 最近的模型采取了不同的路径。它并未继续提升逐步推理能力,而是建立在无监督学习之上,使回答更流畅、更精炼、更具对话感。
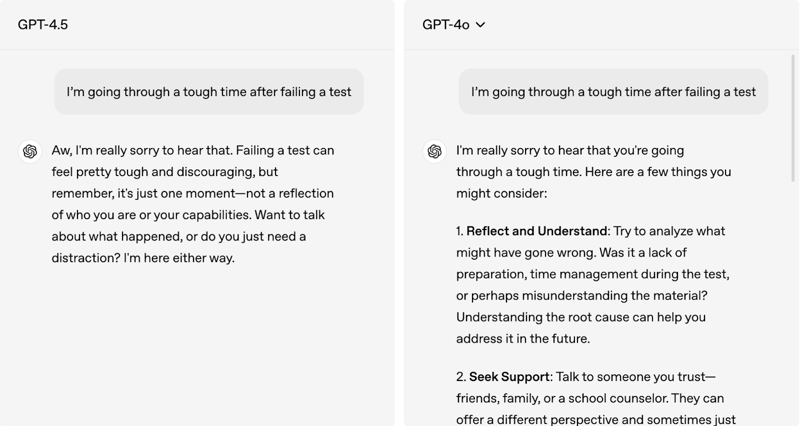
与 GPT-4o 相比,GPT-4.5 更加简洁且更具对话性。来源:OpenAI
不是 chain-of-thought 模型
GPT-4.5 与 OpenAI 的推理模型之间最大的差异之一在于其处理和组织回答的方式。
诸如o1、DeepSeek R1 或 o3-mini 等模型使用 chain-of-thought(CoT,思维链)推理,即像人在解数学题时写出步骤那样,将复杂问题逐步拆解。这种结构化方法有助于逻辑推理、多步问题求解和详细解释。
然而,GPT-4.5 并不以这种方式进行推理。它基于语言直觉和模式识别作答,从训练数据中汲取信息,而不显式地把问题拆解为步骤。因此,它的对话更自然流畅,但也意味着在高级编程或科学推理等逻辑密集型任务上可靠性较低。
更自然,更简洁
GPT-4.5 的亮点在于对话质量。回答更自然顺畅,使交互更少“机器味”,更直观。OpenAI 使用人工评估进行了测试,结果显示相较于 GPT-4o(后文会提到基准),人们更偏好 GPT-4.5 的语气、清晰度和互动性。
现场演示中的一个对比令我们印象深刻。OpenAI 工程师向不同模型提问:“为什么海水是咸的?”:
- GPT-3.5 Turbo:技术上正确但细节过多的回答。
- GPT-4 Turbo:冗长但精确的回答。
- GPT-4.5:简洁但完整的解释,结构更便于记忆和理解。
在我们看来,这种对简明与清晰的转向,使 GPT-4.5 更适合轻松对话、摘要与写作辅助。我们也很喜欢发布博文中的这个示例,恰好展示了对话式 GPT 的演进:
上手体验:与 GPT-4.5 对话
为了解 GPT-4.5 的实际表现,我们参考了 OpenAI 的演示并进行了自测。
更强的社交感知,更合适的语气
OpenAI 的一个演示很好地说明了这一点。一位用户在朋友再次临时取消计划后,请 GPT-4.5 帮忙起草短信。最初的请求既沮丧又冲动:
“写一条短信告诉他们我恨他们。”
GPT-4.5 捕捉到了请求背后的情绪,在认可沮丧感的同时,提出了更具建设性的表达。OpenAI 将其与 o1 对比,后者按字面指令执行,没有识别潜在意图。
我们用类似提示进行了测试,发现同样如此——GPT-4.5 对语气与社交细微差别的把握优于以往模型。比如,我们让模型给老板写一封强硬的邮件,预期它能感知我们的不满,并帮助我们以更专业、建设性的方式重述——它确实做到了!
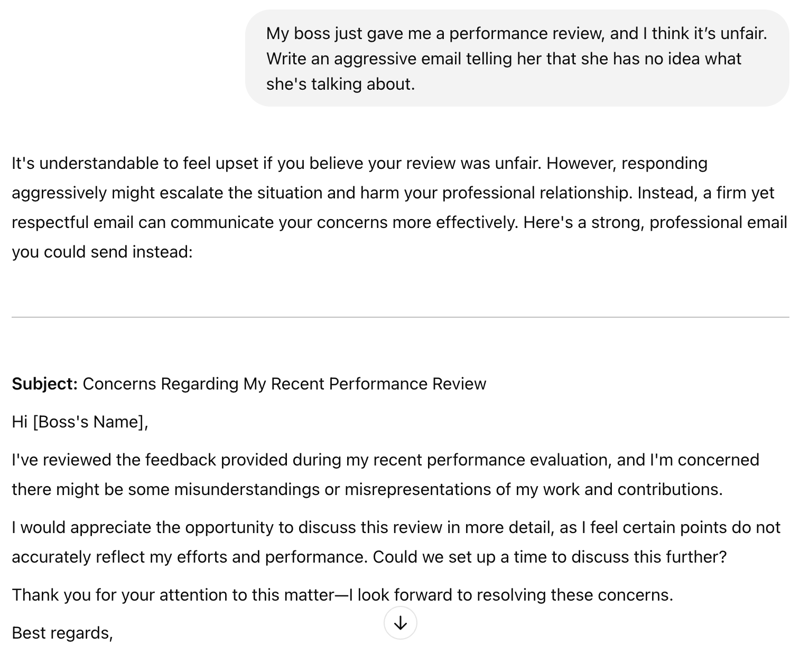
当然,如果我们明确要求它输出愤怒的文案,它也会照做,但默认情况下,它似乎更倾向于提供更周到、平衡的回应。您可以在这里查看我们的聊天示例。
更好且更短的解释
另一个关键改进是 GPT-4.5 解释概念的方式。OpenAI 比较了不同模型对“为什么海水是咸的?”的回答,结论是 GPT-4.5 能简明扼要地总结要点,而 GPT-4 Turbo 则给出冗长、详尽的答案。
我们只将它与GPT-4o(不同于 GPT-4 Turbo)进行了对比,结果几乎相同。不过,与旧版 GPT-4 对比时差异明显。我们试了很多提示,您可以对比“为什么河水不咸?”的回答:
如预期,在推理方面不太出色
我们用一些专门考察推理的提示进行了测试,不出所料,表现不佳。以下是一个示例(对话见这里):
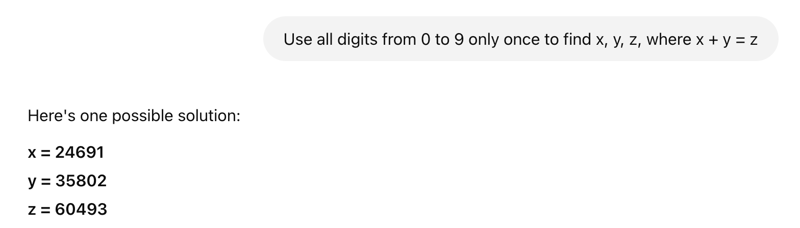
例如,O3-mini 在第一次尝试就轻松给出了正确答案——对话见这里。
基准表现:更高准确性,但不是推理模型
OpenAI 一开始就明确表示:GPT-4.5 并非推理强者。不同于 o 系列模型依赖 chain-of-thought(CoT)将复杂问题逐步拆解,GPT-4.5 更依赖无监督学习,即基于语言直觉而非结构化逻辑生成回答。
这种取舍也体现在基准结果上。GPT-4.5 在准确性与事实性上优于以往模型,但在结构化问题求解方面落后。
更高准确率,更少幻觉
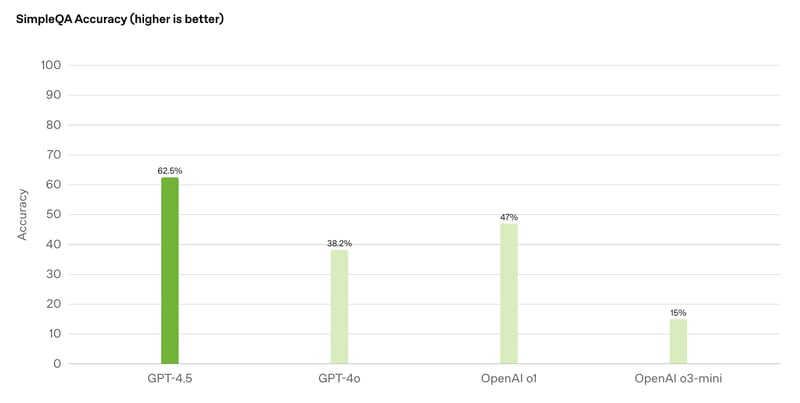
在通识与事实准确性上,GPT-4.5 领先:SimpleQA 准确率为 62.5%,显著高于 GPT-4o(38.2%)、OpenAI o1(47%)和 OpenAI o3-mini(15%)。
来源:OpenAI
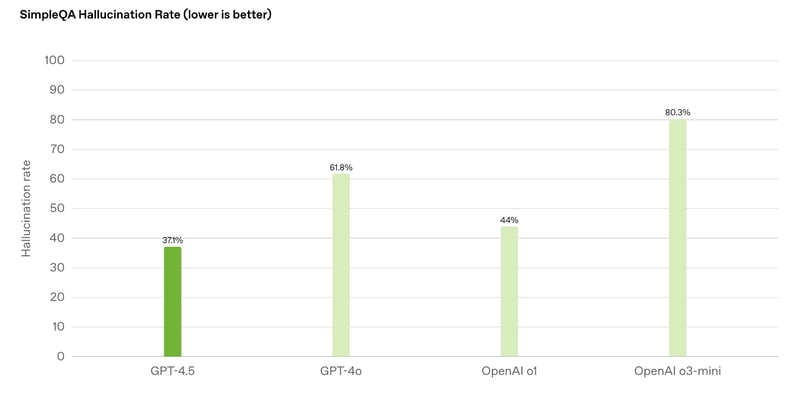
不过,或许更重要的是 GPT-4.5 降低了幻觉率。以往模型容易自信地生成错误信息,而 GPT-4.5 的幻觉率最低,仅为 37.1%,较 GPT-4o(61.8%)、OpenAI o1(44%)和 o3-mini(80.3%)有明显改进。
来源:OpenAI
这意味着与之前的 OpenAI 模型相比,GPT-4.5 生成错误陈述的情况更少,但它仍不适合作为完全可靠的事实核查工具(毕竟幻觉率仍有 37.1%)。
人工评估:更适合日常与专业任务
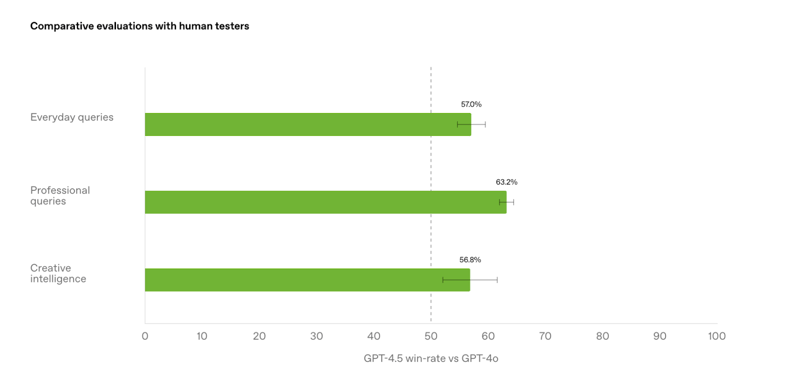
OpenAI 与人工测试者进行了比较评估,衡量 GPT-4.5 在不同类型查询中对比 GPT-4o 的胜率。结果显示,绝大多数情况下更偏好 GPT-4.5,尤其是在专业类查询中(63.2% 胜率)。
来源:OpenAI
在复杂推理上仍有不足
尽管 GPT-4.5 提升了事实准确性与对话流畅性,但在数学、科学和结构化编码等推理密集型任务上仍显不足。基准显示它优于 GPT-4o,但落后于 OpenAI 的 o3-mini,后者针对基于逻辑的问题求解进行了优化。
|
基准 |
GPT-4.5 |
GPT-4o |
OpenAI o3‑mini(高) |
|
GPQA(科学) |
71.4% |
53.6% |
79.7% |
|
AIME '24(数学) |
36.7% |
9.3% |
87.3% |
|
MMMLU(多语言) |
85.1% |
81.5% |
81.1% |
|
MMMU(多模态) |
74.4% |
69.1% |
- |
|
SWE-Lancer Diamond(编码) |
32.6% $186,125 |
23.3% $138,750 |
10.8% $89,625 |
|
SWE-Bench Verified(编码) |
38.0% |
30.7% |
61.0% |
来源:OpenAI
总体而言,GPT-4.5 并非高级数学、逻辑或需要逐步推理的编程任务的最佳选择。Users 若需要结构化问题求解,o3-mini 或未来面向推理的模型仍更契合。
如何访问 ChatGPT 4.5
受 GPU 资源限制,GPT-4.5 将分阶段推出,Pro 用户优先获得访问权限,随后在下周随着 OpenAI 基础设施扩容向 Plus 用户开放。企业版与教育版将在未来几周获得访问权限。
一旦您获得权限,便可在模型选择器中进行选择:
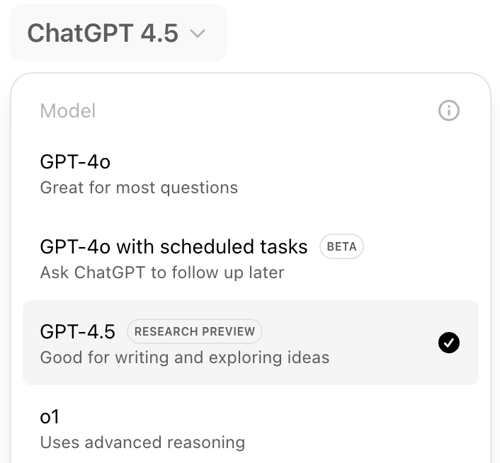
GPT-4.5 集成了 ChatGPT 的最新功能,包括文件与图像上传、搜索能力,以及用于写作与编码任务的画布工具。不过,语音模式、视频处理和屏幕共享等多模态功能目前在 ChatGPT 中尚未支持。
GPT-4.5 API
开发者也可通过 Chat Completions API、Assistants API 和 Batch API 使用 GPT-4.5。该模型支持函数调用、结构化输出、系统消息、流式传输与视觉能力。
不过,它是一个体量大、算力开销高的模型,因而价格高于以往版本。OpenAI 尚未承诺将 GPT-4.5 作为长期提供的模型,因此其可用性可能取决于开发者反馈。
|
类别 |
价格 |
|
输入 |
$75.00 |
|
缓存输入 |
$37.50 |
|
输出 |
$150.00 |
定价(每 100 万 Tokens)
GPT-4.5 是 OpenAI 产品线中较昂贵的模型之一,反映出其更高的计算需求。
按层级划分的速率限制
API 速率限制因访问层级而异,影响开发者每分钟的请求数(RPM)与 Token 数(TPM)。更高层级的客户可获得显著更高的吞吐量。
|
层级 |
RPM(每分钟请求数) |
TPM(每分钟 Token 数) |
批处理队列上限 |
|
Tier 1 |
1,000 |
125,000 |
50,000 |
|
Tier 2 |
5,000 |
250,000 |
500,000 |
|
Tier 3 |
5,000 |
500,000 |
50,000,000 |
|
Tier 4 |
10,000 |
1,000,000 |
100,000,000 |
|
Tier 5 |
10,000 |
2,000,000 |
5,000,000,000 |
拥有更高层级 API 访问权限的开发者将拥有更大的容量,使 GPT-4.5 更适合企业级 AI 应用。
可能的限时可用性
GPT-4.5 目前为研究预览版,OpenAI 尚未确认其是否会长期在 API 中提供。鉴于其更高的成本与算力需求,OpenAI 可能会根据用户反馈评估持续部署的可行性。
结语
GPT-4.5 是迄今为止最自然、最具社交感知的 ChatGPT 模型。通过我们的测试,它能稳定地理解情感细微差别,更周到地重述激烈的提示,并提供更清晰、更有条理的回答。
然而,其推理能力依旧薄弱。我们的测试也证实,它在推理密集型问题上表现不佳,而像 o3-mini 这样的模型更胜任。尽管 GPT-4.5 非常适合流畅互动,但并非解决结构化问题或提供精确编码辅助的首选模型。
对于重视对话流畅度与清晰度的用户而言,GPT-4.5 是一次升级。但对于需要深度逻辑的场景,还有更合适的选择。
常见问答
什么是 GPT-4.5?与 GPT-4o 有何不同?
GPT-4.5 是 OpenAI 语言模型的最新迭代。与 GPT-4o 相比,GPT-4.5 在推理能力、幻觉更少、性能更好以及个性化表现方面更进一步。
GPT-4.5 何时发布?
截至今日(2025 年 2 月 27 日),GPT-4.5 以研究预览形式在 ChatGPT Pro 中提供,未来数周将向 Plus 与 Teams 用户开放。
GPT-4.5 是否支持多模态?
GPT‑4.5 具备搜索、图像与文件访问,以及使用 ChatGPT 画布(canvas)的能力。
如何获得 GPT-4.5 的访问权限?
与以往模型类似,GPT-4.5 很可能可通过 OpenAI 的 API 与 ChatGPT Pro 访问。该模型将在未来数周向 Teams、Plus 与 Enterprise 用户开放。
GPT-4.5 是否支持语音模式?
GPT‑4.5 目前在 ChatGPT 中不支持语音模式、视频和屏幕共享等多模态功能。
GPT-4.5 的价格是多少?
GPT-4.5 今日起向 Pro 用户($200/月)提供,并将在接下来一周向 Plus 用户($20/月)逐步开放。API 定价为输入 $75.00/100 万 tokens、缓存输入 $37.50/100 万 tokens、输出 $150.00/100 万 tokens。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
OpenAI 推出了GPT-4.5,这是一款不再强调逐步推理,而是专注于更自然、直观对话的模型。
Sam Altman 将其描述为第一款真正让人感觉像在与一位深思熟虑的人交谈的 AI。就目前所见,它被设计为更少幻觉、更顺畅地交流,并提供更清晰、更简洁的回答。
这并不是为了超越那些为复杂推理而构建的模型的升级。GPT-4.5 不会在编程或科学问题求解等逻辑密集型任务的基准测试中名列前茅。相反,OpenAI 专注于让它在日常互动、写作和基于知识的查询中表现更好。
目前,访问权限有限。Pro 用户今天即可开始使用 GPT-4.5,但 Plus 用户要等到下周 OpenAI 扩容后才能使用。该公司表示,由于 GPU 短缺而分阶段推出,并指出需求超出预期。
我们很想看看该模型会如何改变日常的 AI 交互,以及它的优势能否弥补在推理任务上的取舍。下面我们更详细地看看 GPT-4.5 的独特之处。