
DeepSeek-R1 的蒸馏模型
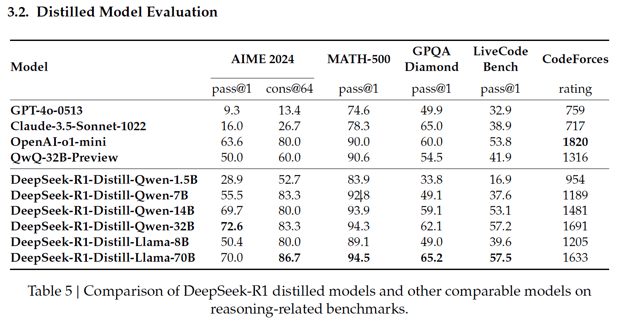
AI 中的蒸馏,是指从更大的模型中创建更小、更高效的模型,在降低计算需求的同时尽可能保留其推理能力。DeepSeek 将该技术应用于 R1,基于 Qwen 与 Llama 架构创建了一系列蒸馏模型。
基于 Qwen 的蒸馏模型
DeepSeek 基于 Qwen 的蒸馏模型强调效率与可扩展性,在性能与计算需求之间取得平衡。
DeepSeek-R1-Distill-Qwen-1.5B
这是最小的蒸馏模型,在 MATH-500 上取得了 83.9%。MATH-500 测试模型通过逻辑推理与多步求解处理高中水平数学问题的能力。该结果显示,尽管体量小巧,模型依然能较好完成基础数学任务。
不过,它在 LiveCodeBench(16.9%)上的表现明显下滑。该基准用于评估编码能力,凸显其在编程任务上的局限。
DeepSeek-R1-Distill-Qwen-7B
Qwen-7B 在 MATH-500 上表现亮眼,得分 92.8%,展现出强大的数学推理能力。在 GPQA Diamond(49.1%)上也有不错表现,该基准评估事实问答能力,说明其在数学与事实推理间取得了良好平衡。
但其在 LiveCodeBench(37.6%)与 CodeForces(1189 评级)上的表现,表明它不太适合复杂编码任务。
DeepSeek-R1-Distill-Qwen-14B
该模型在 MATH-500(93.9%)上的成绩不错,能够处理更复杂的数学问题。在 GPQA Diamond 上的 59.1% 也表明其具备事实推理能力。
其在 LiveCodeBench(53.1%)与 CodeForces(1481 评级)上的结果,显示在编程与与编程相关的推理任务上仍有提升空间。
DeepSeek-R1-Distill-Qwen-32B
最大的 Qwen 系列模型在 AIME 2024 上取得同侪中最高分(72.6%),该基准评估高级多步数学推理。它在 MATH-500(94.3%)与 GPQA Diamond(62.1%)上同样表现出色,展现了在数学与事实推理上的实力。
其在 LiveCodeBench(57.2%)与 CodeForces(1691 评级)的成绩表明其通用性较强,但相比专注于编码的模型,仍未对编程任务做到最优。
基于 Llama 的蒸馏模型
DeepSeek 基于 Llama 的蒸馏模型侧重高性能与高级推理能力,尤其擅长需要数学与事实精度的任务。
DeepSeek-R1-Distill-Llama-8B
Llama-8B 在 MATH-500(89.1%)上表现良好,在 GPQA Diamond(49.0%)上也有不错成绩,显示其能够处理数学与事实推理。不过,在 LiveCodeBench(39.6%)与 CodeForces(1205 评级)等编码基准上得分较低,相比基于 Qwen 的模型,其在编程相关任务上存在局限。
DeepSeek-R1-Distill-Llama-70B
作为体量最大的蒸馏模型,Llama-70B 在 MATH-500(94.5%)上取得了所有蒸馏模型中的最佳成绩,并在 AIME 2024 上获得 86.7% 的高分,是高级数学推理的优秀之选。
它在 LiveCodeBench(57.5%)与 CodeForces(1633 评级)上的表现也不错,说明其在编码任务上的胜任度高于大多数其他模型。在这一领域,它可与 OpenAI 的 o1-mini 或 GPT-4o 相媲美。
如何访问 DeepSeek-R1
您可以通过两种主要方式访问 DeepSeek-R1:基于网页的 DeepSeek Chat 平台,以及 DeepSeek API,可按需选择最合适的方式。
网页访问:DeepSeek Chat 平台
DeepSeek Chat 平台提供了直观的方式与 DeepSeek-R1 交互。您可以直接前往聊天页面,或在首页点击Start Now 进入。
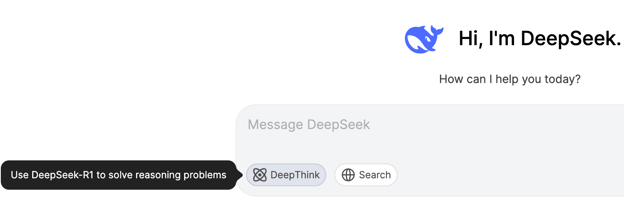
注册后,您可以选择“Deep Think”模式,体验 Deepseek-R1 的逐步推理能力。
API 访问:DeepSeek 的 API
如需将 DeepSeek-R1 集成到您的应用中,可通过 DeepSeek API 进行编程式访问。
开始之前,您需要在DeepSeek 平台注册并获取 API 密钥。
该 API 与 OpenAI 的格式兼容,如果您熟悉 OpenAI 的工具,集成会相当直接。更多说明请参阅DeepSeek 的 API 文档。
DeepSeek-R1 定价
截至 2025 年 5 月,聊天平台可免费使用 R1 模型。
API 提供两种模型——deepseek-chat(DeepSeek-V3)与 deepseek-reasoner(DeepSeek-R1)——其定价结构如下(每 100 万 tokens):
|
MODEL |
CONTEXT LENGTH |
MAX COT TOKENS |
MAX OUTPUT TOKENS |
1M TOKENS INPUT PRICE (CACHE HIT) |
1M TOKENS INPUT PRICE (CACHE MISS) |
1M TOKENS OUTPUT PRICE |
|
deepseek-chat |
64K |
- |
8K |
$0.07 $0.014 |
$0.27 $0.14 |
$1.10 $0.28 |
|
deepseek-reasoner |
64K |
32K |
8K |
$0.14 |
$0.55 |
$2.19 |
为确保获取最新定价信息并了解如何计算 CoT(链式思维)推理的费用,请访问DeepSeek 定价页面。
DeepSeek-R1 vs. OpenAI O1:基准表现
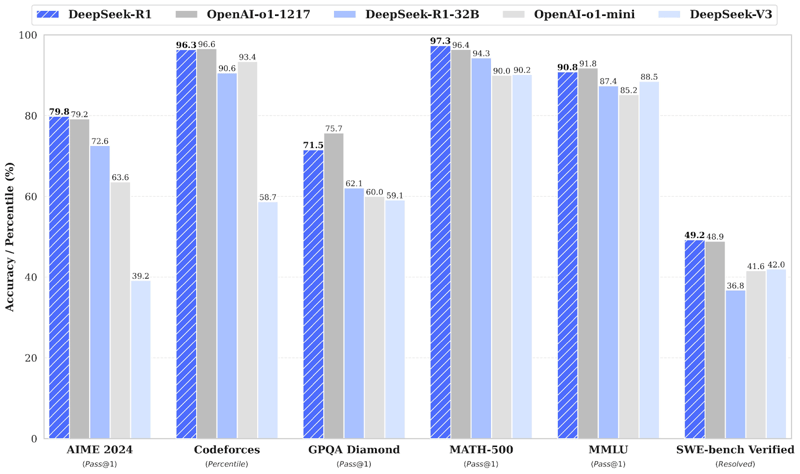
DeepSeek-R1 在多个基准上直接对标 OpenAI o1,且经常与之持平或超越。
数学基准:AIME 2024 与 MATH-500
在数学基准上,DeepSeek-R1 表现强劲。于 AIME 2024(评估高级多步数学推理)中,DeepSeek-R1 得分 79.8%,略高于 OpenAI o1-1217 的 79.2%。
在 MATH-500 上,DeepSeek-R1 以 97.3% 的优异成绩领先,略高于 OpenAI o1-1217 的 96.4%。该基准测试涵盖多样的高中数学问题,要求细致推理。
编码基准:Codeforces 与 SWE-bench Verified
Codeforces 基准以相对于人类参赛者的百分位衡量模型的编码与算法推理能力。OpenAI o1-1217 以 96.6% 领先,DeepSeek-R1 以 96.3% 紧随其后,差距极小。
SWE-bench Verified 评估软件工程任务中的推理。DeepSeek-R1 以 49.2% 的成绩表现强劲,略高于 OpenAI o1-1217 的 48.9%。这使 DeepSeek-R1 在软件验证等专业推理任务中具备竞争力。
通识基准:GPQA Diamond 与 MMLU
在事实推理方面,GPQA Diamond 衡量回答通用知识问题的能力。DeepSeek-R1 得分 71.5%,落后于 OpenAI o1-1217 的 75.7%,显示后者在事实推理任务上略占优势。
在涵盖多学科并评估多任务语言理解的 MMLU 上,OpenAI o1-1217 以 91.8% 略高于 DeepSeek-R1 的 90.8%。
DeepSeek 的后续影响
DeepSeek-R1 的发布引发了深远影响,波及股市、重塑 AI 经济学,并引发有关模型开发实践的争议。
对股市的影响
DeepSeek 推出以远低于竞争对手成本提供先进 AI 能力的 R1 模型,导致多家美国大型科技公司的股价大幅下跌。
例如,英伟达股价一度下跌近 18%,市值蒸发约 6000 亿美元。投资者担忧,DeepSeek 的高效 AI 模型可能会削弱对高性能硬件的需求,而这类硬件传统上由英伟达等公司供给。
杰文斯悖论与 AI 模型的商品化
像 DeepSeek-R1 这样的开放权重模型正在降低成本,并迫使 AI 公司重新思考定价策略。这在鲜明的价格对比中可见一斑:
- OpenAI 的 o1 每百万输出 tokens 价格为 60 美元
- DeepSeek-R1 每百万输出 tokens 价格为 2.19 美元
一些业内人士提到杰文斯悖论——效率提高可能导致总体消费增加。微软 CEO Satya Nadella就曾暗示,随着 AI 变得更便宜,需求将激增。
不过,我也赞同经济学人对这一问题的平衡观点:完全形式的杰文斯效应非常罕见,且取决于价格是否是采用的主要障碍。鉴于“目前只有 5% 的美国企业在使用 AI,7% 计划采用”,杰文斯效应可能有限。许多企业仍然觉得 AI 集成困难或并非刚需。
OpenAI 指控 DeepSeek 进行蒸馏
伴随其颠覆性影响,DeepSeek 也卷入了争议。OpenAI 指控 DeepSeek 对其模型进行蒸馏——本质上是从 OpenAI 的专有系统中提取知识,并以更小更高效的模型复现其性能。
迄今为止,OpenAI 尚未提供该指控的直接证据,在许多人看来,这更像是在 AI 版图变化之际安抚投资者的策略性举动。
DeepSeek-R1-0528
2025 年 5 月 28 日,DeepSeek 发布了其推理模型的升级版本:DeepSeek-R1-0528。该更新带来多项关键改进:
- 在推理与事实任务上的基准表现提升
- 前端交互能力增强,聊天体验更顺畅
- 降低幻觉率,提升事实可靠性
- 支持 JSON 输出与函数调用,更适合结构化推理与工具使用
尽管新增了这些能力,API 端点并未改变——DeepSeek-R1-0528 完全向后兼容。开发者可继续使用相同接口,同时享受新模型带来的改进。
您可以 在 DeepSeek Chat 平台上试用,或前往 Hugging Face 获取开源权重。
基准提升
根据发布公告中的基准图表,DeepSeek-R1-0528 相比前代有更好表现,并与 OpenAI 的 o3 与 Gemini 2.5 Pro 激烈竞争:
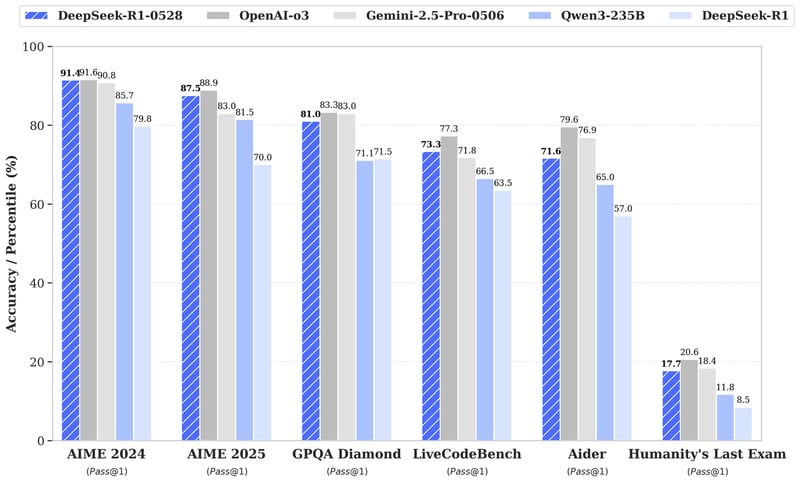
来源:DeepSeek
结语
DeepSeek-R1 是面向推理的强劲竞争者,整体表现与 OpenAI 的 o1 不相上下。尽管 OpenAI 的 o1 在编码与事实推理上或许略占优势,但我认为 DeepSeek-R1 的开源属性与高性价比访问方式,使其颇具吸引力。
FAQs
DeepSeek-R1 如何处理多语言查询?
DeepSeek-R1 针对英语和中文进行了优化,但在其他语言上的表现可能会下降。部分输出在处理推理任务时可能会混用中英文。未来更新有望改善这一限制。
DeepSeek-R1 能否针对特定任务或行业进行微调?
可以。作为开源模型,只要具备必要的计算资源与数据,DeepSeek-R1 就可以针对特定任务进行微调。这种灵活性使其对需要领域定制应用的研究者与机构尤其有吸引力。
DeepSeek-R1 的输出长度是否有限制?
可以,DeepSeek-R1 的输出 tokens 上限取决于访问方式。例如,API 的 deepseek-reasoner 模型支持最多 64,000 个输出 tokens,其中包含推理步骤(链式思维)与最终答案。
在本地运行 DeepSeek-R1 需要什么硬件?
在本地运行 DeepSeek-R1 或其蒸馏模型需要高性能 GPU 或 TPU,尤其是更大的模型,如 DeepSeek-R1-Distill-Llama-70B。较小的蒸馏版本(如 Qwen-1.5B)更适合资源受限的系统。
DeepSeek 的 API 中上下文缓存如何工作,能节省多少?
上下文缓存会存储重复的输入 tokens 以降低成本。例如,在多轮对话中复用输入时,系统会以显著更低的价格从缓存中检索这些 tokens。该功能对包含大量重复查询的工作流尤为有益。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
2025 年 1 月,DeepSeek 发布了 DeepSeek-R1,这是其推理模型研发的又一进步。它相较于早期的 DeepSeek-R1-Lite-Preview 有所升级,也表明他们有意与 OpenAI 的 o1 正面竞争。
此后,DeepSeek 持续改进该模型。2025 年 5 月,他们发布了升级版本 DeepSeek-R1-0528,在基准测试表现、幻觉率以及功能调用和 JSON 输出支持等新能力上都有提升。
尽管 DeepSeek 在某些方面可能略落后于竞争对手,但其开源特性与大幅更低的定价,使其对 AI 社群极具吸引力。
在这篇博客中,我将解析 DeepSeek-R1 的关键功能、开发过程、蒸馏模型、如何访问、定价,以及它与 OpenAI 模型的比较。
我最初在 DeepSeek-R1 发布当天写下本文,如今已更新加入其后续影响的章节——包括它对股市的冲击、AI 经济学(涵盖杰文斯悖论与 AI 模型商品化),以及 OpenAI 指控 DeepSeek 对其模型进行蒸馏。此外,我也新增了关于全新 DeepSeek-R1-0528 的更新内容。
我们通过免费周报 The Median 为读者持续带来最新 AI 动态,梳理本周重点新闻。订阅即可用几分钟把握要点:
什么是 DeepSeek-R1?
DeepSeek-R1 是由中国 AI 公司 DeepSeek 开发的开源推理模型,用于处理需要逻辑推断、数学解题与实时决策的任务。
像 DeepSeek-R1 和 OpenAI 的 o1 这样的推理模型,与传统语言模型的不同之处在于它们能够展示得出结论的过程。
借助 DeepSeek-R1,您可以追踪其推理逻辑,从而更易理解并在必要时质疑其输出。这种能力让推理模型在需要结果可解释的领域(如科研或复杂决策)中更具优势。
DeepSeek-R1 之所以尤其具有竞争力与吸引力,在于其开源属性。不同于专有模型,开源使开发者与研究人员能够在一定技术限制(如资源需求)内进行探索、修改与部署。
DeepSeek-R1 是如何开发的?
本节将从其前身 DeepSeek-R1-Zero 讲起,介绍 DeepSeek-R1 的开发历程。
DeepSeek-R1-Zero
DeepSeek-R1 起步于 R1-Zero,这是一种完全通过强化学习训练的模型。虽然这一方法使其具备了强大的推理能力,但也带来明显缺点:输出常常难以阅读,且模型有时会在回答中混用多种语言。这些限制使 R1-Zero 在真实场景中的实用性不足。
纯强化学习的挑战
仅依赖强化学习会产出逻辑上正确却结构较差的输出。缺乏有监督数据的引导,模型难以有效表达其推理过程。对于需要清晰、精确结果的用户而言,这是一个障碍。
DeepSeek-R1 的改进
为解决上述问题,DeepSeek 在 R1 的开发中将强化学习与有监督微调相结合。这种混合方法引入了精心整理的数据集,提升了模型的可读性与连贯性。诸如语言混用与碎片化推理等问题大幅减少,使模型更适用于实际应用。
如需进一步了解 DeepSeek-R1 的开发过程,建议阅读其发布论文。