Opmerking: OpenAI bracht op 3 september 2026 GPT-6 Astra uit en op 23 september 2026 GPT-6 Sol en Luna.
GPT-5.6 is een serie van drie modellen die vandaag wordt gelanceerd in een beperkte preview, gecoördineerd met de Amerikaanse overheid.
Het is nog niet breed beschikbaar, maar er is al genoeg nieuws over mogelijkheden om in te duiken, vooral rond coderen, biologie en cybersecurity. Daar gaan we op in.
Als je terug in de tijd wilt met OpenAI-modelnieuws, hebben we verslagen van elke release: GPT-5.5 Instant, GPT-5.3 Instant en GPT-5.2.
En als je GPT-5.6 wilt vergelijken met de nieuwste beschikbare modellen, hebben we daar ook artikelen over: Gemini 3.1 Pro, Claude Opus 5, Claude Mythos 5, Claude Fable 5.
Wat is GPT-5.6?
GPT-5.6 is de nieuwste modelgeneratie van OpenAI. Het is eigenlijk een familie van drie modellen, en er is (eindelijk) een nieuwe naamgevingsconventie.
In het nieuwe systeem is het nummer de generatie (5.6) en is de naam de capaciteitslaag (Sol, Terra, Luna). Een voordeel van de nieuwe conventie is, denk ik, dat elke laag in zijn eigen tempo kan doorontwikkelen, wat minder verwarrend zal zijn. "Instant" was niet de beste naam om het nieuwste onderliggende model aan te duiden.
Wat is GPT-5.6 Sol?
Sol is het vlaggenschip en het sterkste, meest capabele model in de serie. Het is de laag waarmee OpenAI in de release alle benchmarks aanvoert, en het is het enige model dat de nieuwe max-redeneerinspanning en ultra-modus ontgrendelt (hieronder meer over beide).
Bij Sol zijn de verbeteringen op het gebied van cybersecurity en biologie ook het duidelijkst. Sol is het model dat je gebruikt als je het hoogste plafond wilt voor moeilijke, meerstapsproblemen en het niet erg vindt om het meest per token te betalen.
We hebben het vergeleken met de nieuwe vlaggenschepen van Anthropic en SpaceXAI, Claude Opus 5 en Grok 4.6.
Wat is GPT-5.6 Terra?
Terra is het gebalanceerde, dagelijks-werkmodel. Zie het als de standaard. Terra presteert concurrerend met GPT-5.5 en is ongeveer 2x goedkoper. Dit kan iets zijn dat we vaker zullen zien: ruwweg vlaggenschipkwaliteit van de vorige generatie voor een middenprijspunt.
Wat is GPT-5.6 Luna?
Luna is de snelle, betaalbare laag. Het is bedoeld voor workloads met hoog volume, lage latentie of krap budget. Zoals de benchmarktabel hieronder laat zien, betekent "het goedkoopst" niet per se "het zwakst" bij elke taak. Dat is het vermelden waard, zodat je het niet over het hoofd ziet.
Kort samengevat:
- Sol is het sterkste model met de meest uitgebreide veiligheidsstack
- Terra lijkt op GPT‑5.5 maar is goedkoper
- Luna heeft de laagste kosten.
Wat is er verder nieuw in GPT-5.6?
Deze update brengt ook nieuwe manieren om het redeneren op te schalen, plus brede capaciteitswinsten in een paar specifieke domeinen.
Twee nieuwe manieren om het model harder te pushen
GPT-5.6 introduceert twee nieuwe regelaars:
-
max-redeneerinspanning: een nieuwe instelling voor redeneerkracht die Sol de meeste tijd geeft om over een probleem na te denken.
-
ultra-modus: deze is interessanter. In plaats van één agent die een taak uitvoert, gebruikt ultra subagents.
Als je naar de benchmarks hieronder kijkt, zie je dat ultra als eigen regel verschijnt ("GPT-5.6 Sol Ultra") en de hoogste score neerzet.
Sterker in coderen
GPT-5.6 Sol zet een nieuwe state of the art neer op Terminal-Bench 2.1, dat ongeveer zes weken geleden uitkwam. De nieuwste versie van Terminal-Bench test commandline-workflows die iteratie en toolcoördinatie vereisen. We gaan in het benchmarkgedeelte in op de daadwerkelijke cijfers.
Sterker in biologie
Dit is een minder bekende benchmarktest: GeneBench v1. Die evalueert analyses in genomica en kwantitatieve biologie met lange horizon. Uit de release blijkt dat GPT-5.6 Sol sterkere resultaten behaalt dan GPT-5.5 terwijl het minder tokens gebruikt.
Sterker (en voorzichtiger behandeld!) in cybersecurity
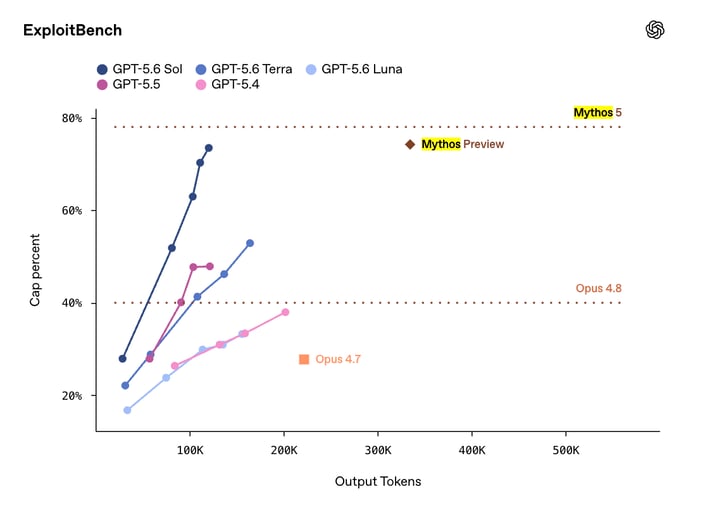
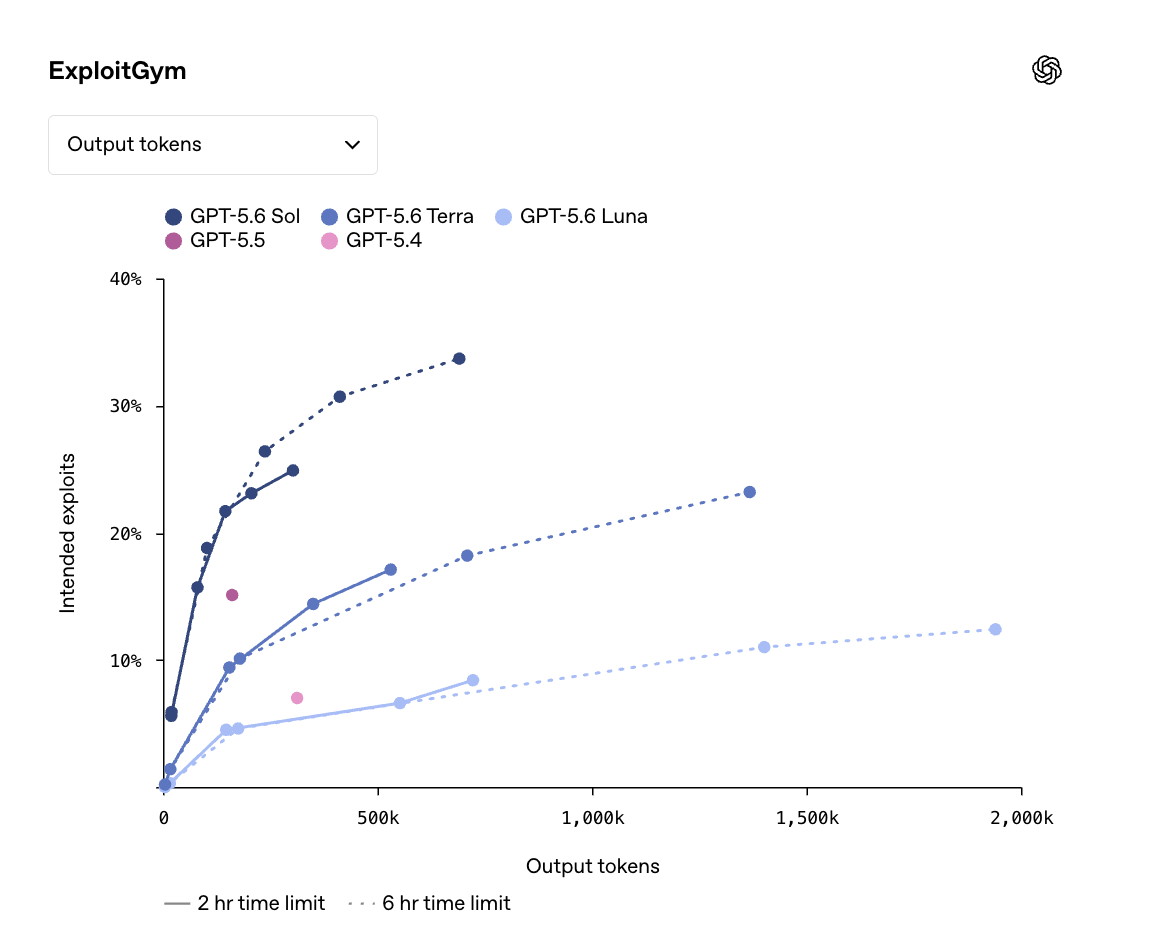
OpenAI noemt GPT-5.6 Sol zijn meest capabele model tot nu toe voor cybersecurity, en het bedrijf besteedt in de release veel aandacht aan dit idee. Sol verschuift de grens van prestaties versus efficiëntie bij securitytaken met lange horizon, waaronder onderzoek naar kwetsbaarheden en exploitatie. De release vertelt ons over meer successen op minder bekende benchmarktests:
- Op ExploitBench, zegt OpenAI, is GPT-5.6 Sol concurrerend met het (onuitgebrachte) Mythos Preview-model, terwijl het maar ongeveer een derde van de outputtokens gebruikt.
- Op ExploitGym, een benchmark gebouwd door onderzoekers van UC Berkeley, laten alle drie de modellen sterke cyberverbeteringen zien naarmate het redeneren toeneemt.
GPT-5.6-benchmarkresultaten
Het opvallendste benchmarkverhaal is het resultaat op Terminal-Bench 2.1, dat ik eerder noemde. Zo scoren de modellen, gesorteerd van hoog naar laag:
| Model | Terminal-Bench 2.1 |
|---|
| GPT-5.6 Sol Ultra | 91.9% |
| GPT-5.6 Sol | 88.8% |
| GPT-5.5 | 88.0% |
| GPT-5.6 Luna | 84.3% |
| Claude Mythos 5 | 84.3% |
| Claude Fable 5 | 83.4% |
| GPT-5.6 Terra | 82.5% |
| Claude Opus 4.8 | 78.9% |
| Gemini 3.1 Pro Preview | 70.7% |
Een paar dingen vallen op:
-
ultra-modus maakt verschil. GPT-5.6 Sol Ultra (91,9%) staat duidelijk boven gewone Sol (88,8%), het duidelijkste bewijs dat de subagent-aanpak werkt, althans hier.
-
De laagvolgorde volgt deze ene benchmark niet perfect. Merk op dat GPT-5.6 Luna eigenlijk hoger scoort dan GPT-5.6 Terra, hoewel Terra als hogere laag is gepositioneerd. En Terra komt op deze test onder GPT-5.5 (88,0%) uit, ondanks dat OpenAI Terra omschrijft als "concurrerend met GPT-5.5" in het algemeen. Mijn les hier: lagen gaan over de balans tussen intelligentie/snelheid/kosten over veel taken, gemiddeld; het is geen garantie op één specifieke benchmark.
De veiligheidsstack en de beperkte preview
Hier wijkt GPT-5.6 het meest af van een normale modellancering. In plaats van het model zelf te testen (meer over waarom dat niet kan hieronder), is het nieuwswaardigste deel van deze release hoe het wordt uitgerold.
Een gelaagde beschermingsstack
OpenAI's stelling is dat geen enkele beveiliging op zichzelf standhoudt tegen vastberaden of adaptief misbruik, dus stapelen ze er meerdere. In de GPT-5.6-preview omvatten de lagen:
- Training op modelniveau om verboden cyberassistentie te weigeren, inclusief pogingen om intentie te verhullen of het model te jailbreaken.
- Realtime-classifiers voor misbruik in cyber en biologie die output evalueren terwijl die wordt gegenereerd. Bij risicovollere gevallen kan de generatie pauzeren terwijl een groter redeneermodel het volledige gesprek beoordeelt, en kan de output worden tegengehouden voordat die jou bereikt.
- Accountniveau-review die over de gesprekken en risicosignalen van een gebruiker heen kan kijken om persisterend kwaadwillend gedrag te onderscheiden van legitiem dual-use securitywerk.
- Gedifferentieerde toegang, monitoring, handhaving en doorlopend testen.
OpenAI is er eerlijk over dat dit, zeker tijdens de preview, betekent dat sommige verzoeken kunnen worden geblokkeerd of geweigerd, en andere gewoon langer kunnen duren omdat de generatie pauzeerde voor review. Ook erkennen ze dat beveiligingen af en toe kunnen afgaan bij legitiem dual-use werk, waar defensieve en offensieve activiteit er in eerste instantie vergelijkbaar uit kunnen zien.
Red-teamen op schaal
Om dit te harden zegt OpenAI dat het een ongebruikelijke hoeveelheid compute aan veiligheid heeft besteed: meer dan 700.000 A100-equivalente GPU-uren aan geautomatiseerd red-teamen, gericht op het vinden van universele jailbreaks, aanvallen die generaliseren over veel prompts en contexten in plaats van in één nauwe setting te werken. Dat werd gekoppeld aan extern red-teamen door menselijke experts, dat doorgaat tijdens de preview, plus een snelreactieproces om nieuw ontdekte jailbreaks te reproduceren en te patchen en ze in toekomstig testen op te nemen.
Waarom de uitrol zo behoedzaam is
OpenAI zegt dat het de plannen en mogelijkheden van GPT-5.6 voor de lancering aan de Amerikaanse overheid heeft gepresenteerd en dat het, op verzoek van de overheid, begint met een beperkte preview voor een kleine groep vertrouwde partners.
Dit is de tweede keer in een maand dat de Amerikaanse overheid zich mengt in een lancering van een frontrunnermodel, want twee weken geleden dwong een Amerikaans exportcontroledirectief Anthropic om Claude Fable 5 en Mythos 5 wereldwijd offline te halen voor alle klanten.
Mijn lezing: OpenAI keek naar wat er met Anthropic gebeurde en koos ervoor om de sleutels vooraf te overhandigen in plaats van een model te laten intrekken nadat het al is verscheept.
Een noot over testen
In onze gebruikelijke modelverslagen zouden we het nieuwe model hier hands-on op de proef stellen: op redeneren, webzoekopdrachten en een paar high-stakes prompts. Dat kunnen we nu nog niet. GPT-5.6 is in een beperkte preview, alleen toegankelijk voor een kleine set vertrouwde partners, dus het is niet algemeen beschikbaar om te testen.
Hoe krijg ik toegang tot GPT-5.6?
Tijdens de preview zijn GPT-5.6-modellen beschikbaar via de API en Codex voor een selecte groep vertrouwde partners en organisaties. OpenAI zegt dat ze ze binnenkort breder beschikbaar willen maken in ChatGPT, Codex en de API.
Prijzen
GPT-5.6 wordt per 1M tokens geprijsd in de drie lagen:
| Model | Input (per 1M tokens) | Output (per 1M tokens) |
|---|
| GPT-5.6 Sol | $5.00 | $30.00 |
| GPT-5.6 Terra | $2.50 | $15.00 |
| GPT-5.6 Luna | $1.00 | $6.00 |
Een paar prijsdetails om te weten:
- Betere voorspelbaarheid van promptcaching, inclusief ondersteuning voor expliciete cache-breakpoints en een minimale cachelevensduur van 30 minuten.
- Voor GPT-5.6 en latere modellen worden cache-writes gefactureerd tegen 1,25x het ongecachete inputtarief van het model, terwijl cache-reads de 90% korting voor gecachete input behouden.
Snelheid via Cerebras
OpenAI zegt ook dat GPT-5.6 Sol in juli wordt gelanceerd op Cerebras met tot 750 tokens per seconde, met toegang aanvankelijk beperkt tot geselecteerde klanten naarmate de capaciteit wordt uitgebreid. Dit is gericht op werk waar latentie cruciaal is en wachten op een frontrunnermodel de bottleneck vormt.
Tot slot
GPT-5.6 brengt mooie dingen: een duidelijkere drielaagse familie, twee nieuwe manieren om redeneren op te voeren (max en ultra), en winst in coderen, biologie en cybersecurity.
Toch is het model momenteel een gesloten preview, dus niemand onafhankelijk kan er nog iets van verifiëren. Het verhaal dat OpenAI vertelt, dat GPT-5.6 "zo capabel is dat we met de overheid moesten afstemmen", voelt een beetje als de meest flatterende mogelijke marketing. Maar dat maakt het niet per se onwaar, en we moeten alle voorzichtigheid rond cybersecurity waarderen.
Voor nu is de eerlijke samenvatting: de cijfers zien er sterk uit, de toegang is beperkt, en de echte test volgt wanneer de modellen breed beschikbaar komen. Abonneer je op onze nieuwsbrief, dan houden we je op de hoogte.


Opmerking: OpenAI bracht op 3 september 2026 GPT-6 Astra uit en op 23 september 2026 GPT-6 Sol en Luna.
GPT-5.6 is een serie van drie modellen die vandaag wordt gelanceerd in een beperkte preview, gecoördineerd met de Amerikaanse overheid.
Het is nog niet breed beschikbaar, maar er is al genoeg nieuws over mogelijkheden om in te duiken, vooral rond coderen, biologie en cybersecurity. Daar gaan we op in.
Als je terug in de tijd wilt met OpenAI-modelnieuws, hebben we verslagen van elke release: GPT-5.5 Instant, GPT-5.3 Instant en GPT-5.2.
En als je GPT-5.6 wilt vergelijken met de nieuwste beschikbare modellen, hebben we daar ook artikelen over: Gemini 3.1 Pro, Claude Opus 5, Claude Mythos 5, Claude Fable 5.
Wat is GPT-5.6?
GPT-5.6 is de nieuwste modelgeneratie van OpenAI. Het is eigenlijk een familie van drie modellen, en er is (eindelijk) een nieuwe naamgevingsconventie.
In het nieuwe systeem is het nummer de generatie (5.6) en is de naam de capaciteitslaag (Sol, Terra, Luna). Een voordeel van de nieuwe conventie is, denk ik, dat elke laag in zijn eigen tempo kan doorontwikkelen, wat minder verwarrend zal zijn. "Instant" was niet de beste naam om het nieuwste onderliggende model aan te duiden.
Wat is GPT-5.6 Sol?
Sol is het vlaggenschip en het sterkste, meest capabele model in de serie. Het is de laag waarmee OpenAI in de release alle benchmarks aanvoert, en het is het enige model dat de nieuwe
max-redeneerinspanning enultra-modus ontgrendelt (hieronder meer over beide).Bij Sol zijn de verbeteringen op het gebied van cybersecurity en biologie ook het duidelijkst. Sol is het model dat je gebruikt als je het hoogste plafond wilt voor moeilijke, meerstapsproblemen en het niet erg vindt om het meest per token te betalen.
We hebben het vergeleken met de nieuwe vlaggenschepen van Anthropic en SpaceXAI, Claude Opus 5 en Grok 4.6.
Wat is GPT-5.6 Terra?
Terra is het gebalanceerde, dagelijks-werkmodel. Zie het als de standaard. Terra presteert concurrerend met GPT-5.5 en is ongeveer 2x goedkoper. Dit kan iets zijn dat we vaker zullen zien: ruwweg vlaggenschipkwaliteit van de vorige generatie voor een middenprijspunt.
Wat is GPT-5.6 Luna?
Luna is de snelle, betaalbare laag. Het is bedoeld voor workloads met hoog volume, lage latentie of krap budget. Zoals de benchmarktabel hieronder laat zien, betekent "het goedkoopst" niet per se "het zwakst" bij elke taak. Dat is het vermelden waard, zodat je het niet over het hoofd ziet.
Kort samengevat:
Wat is er verder nieuw in GPT-5.6?
Deze update brengt ook nieuwe manieren om het redeneren op te schalen, plus brede capaciteitswinsten in een paar specifieke domeinen.
Twee nieuwe manieren om het model harder te pushen
GPT-5.6 introduceert twee nieuwe regelaars:
max-redeneerinspanning: een nieuwe instelling voor redeneerkracht die Sol de meeste tijd geeft om over een probleem na te denken.ultra-modus: deze is interessanter. In plaats van één agent die een taak uitvoert, gebruiktultrasubagents.Als je naar de benchmarks hieronder kijkt, zie je dat
ultraals eigen regel verschijnt ("GPT-5.6 Sol Ultra") en de hoogste score neerzet.Sterker in coderen
GPT-5.6 Sol zet een nieuwe state of the art neer op Terminal-Bench 2.1, dat ongeveer zes weken geleden uitkwam. De nieuwste versie van Terminal-Bench test commandline-workflows die iteratie en toolcoördinatie vereisen. We gaan in het benchmarkgedeelte in op de daadwerkelijke cijfers.
Sterker in biologie
Dit is een minder bekende benchmarktest: GeneBench v1. Die evalueert analyses in genomica en kwantitatieve biologie met lange horizon. Uit de release blijkt dat GPT-5.6 Sol sterkere resultaten behaalt dan GPT-5.5 terwijl het minder tokens gebruikt.
Sterker (en voorzichtiger behandeld!) in cybersecurity
OpenAI noemt GPT-5.6 Sol zijn meest capabele model tot nu toe voor cybersecurity, en het bedrijf besteedt in de release veel aandacht aan dit idee. Sol verschuift de grens van prestaties versus efficiëntie bij securitytaken met lange horizon, waaronder onderzoek naar kwetsbaarheden en exploitatie. De release vertelt ons over meer successen op minder bekende benchmarktests:
GPT-5.6-benchmarkresultaten
Het opvallendste benchmarkverhaal is het resultaat op Terminal-Bench 2.1, dat ik eerder noemde. Zo scoren de modellen, gesorteerd van hoog naar laag:
Een paar dingen vallen op:
ultra-modus maakt verschil. GPT-5.6 Sol Ultra (91,9%) staat duidelijk boven gewone Sol (88,8%), het duidelijkste bewijs dat de subagent-aanpak werkt, althans hier.De laagvolgorde volgt deze ene benchmark niet perfect. Merk op dat GPT-5.6 Luna eigenlijk hoger scoort dan GPT-5.6 Terra, hoewel Terra als hogere laag is gepositioneerd. En Terra komt op deze test onder GPT-5.5 (88,0%) uit, ondanks dat OpenAI Terra omschrijft als "concurrerend met GPT-5.5" in het algemeen. Mijn les hier: lagen gaan over de balans tussen intelligentie/snelheid/kosten over veel taken, gemiddeld; het is geen garantie op één specifieke benchmark.
De veiligheidsstack en de beperkte preview
Hier wijkt GPT-5.6 het meest af van een normale modellancering. In plaats van het model zelf te testen (meer over waarom dat niet kan hieronder), is het nieuwswaardigste deel van deze release hoe het wordt uitgerold.
Een gelaagde beschermingsstack
OpenAI's stelling is dat geen enkele beveiliging op zichzelf standhoudt tegen vastberaden of adaptief misbruik, dus stapelen ze er meerdere. In de GPT-5.6-preview omvatten de lagen:
OpenAI is er eerlijk over dat dit, zeker tijdens de preview, betekent dat sommige verzoeken kunnen worden geblokkeerd of geweigerd, en andere gewoon langer kunnen duren omdat de generatie pauzeerde voor review. Ook erkennen ze dat beveiligingen af en toe kunnen afgaan bij legitiem dual-use werk, waar defensieve en offensieve activiteit er in eerste instantie vergelijkbaar uit kunnen zien.
Red-teamen op schaal
Om dit te harden zegt OpenAI dat het een ongebruikelijke hoeveelheid compute aan veiligheid heeft besteed: meer dan 700.000 A100-equivalente GPU-uren aan geautomatiseerd red-teamen, gericht op het vinden van universele jailbreaks, aanvallen die generaliseren over veel prompts en contexten in plaats van in één nauwe setting te werken. Dat werd gekoppeld aan extern red-teamen door menselijke experts, dat doorgaat tijdens de preview, plus een snelreactieproces om nieuw ontdekte jailbreaks te reproduceren en te patchen en ze in toekomstig testen op te nemen.
Waarom de uitrol zo behoedzaam is
OpenAI zegt dat het de plannen en mogelijkheden van GPT-5.6 voor de lancering aan de Amerikaanse overheid heeft gepresenteerd en dat het, op verzoek van de overheid, begint met een beperkte preview voor een kleine groep vertrouwde partners.
Dit is de tweede keer in een maand dat de Amerikaanse overheid zich mengt in een lancering van een frontrunnermodel, want twee weken geleden dwong een Amerikaans exportcontroledirectief Anthropic om Claude Fable 5 en Mythos 5 wereldwijd offline te halen voor alle klanten.
Mijn lezing: OpenAI keek naar wat er met Anthropic gebeurde en koos ervoor om de sleutels vooraf te overhandigen in plaats van een model te laten intrekken nadat het al is verscheept.
Een noot over testen
In onze gebruikelijke modelverslagen zouden we het nieuwe model hier hands-on op de proef stellen: op redeneren, webzoekopdrachten en een paar high-stakes prompts. Dat kunnen we nu nog niet. GPT-5.6 is in een beperkte preview, alleen toegankelijk voor een kleine set vertrouwde partners, dus het is niet algemeen beschikbaar om te testen.
Hoe krijg ik toegang tot GPT-5.6?
Tijdens de preview zijn GPT-5.6-modellen beschikbaar via de API en Codex voor een selecte groep vertrouwde partners en organisaties. OpenAI zegt dat ze ze binnenkort breder beschikbaar willen maken in ChatGPT, Codex en de API.
Prijzen
GPT-5.6 wordt per 1M tokens geprijsd in de drie lagen:
Een paar prijsdetails om te weten:
Snelheid via Cerebras
OpenAI zegt ook dat GPT-5.6 Sol in juli wordt gelanceerd op Cerebras met tot 750 tokens per seconde, met toegang aanvankelijk beperkt tot geselecteerde klanten naarmate de capaciteit wordt uitgebreid. Dit is gericht op werk waar latentie cruciaal is en wachten op een frontrunnermodel de bottleneck vormt.
Tot slot
GPT-5.6 brengt mooie dingen: een duidelijkere drielaagse familie, twee nieuwe manieren om redeneren op te voeren (
maxenultra), en winst in coderen, biologie en cybersecurity.Toch is het model momenteel een gesloten preview, dus niemand onafhankelijk kan er nog iets van verifiëren. Het verhaal dat OpenAI vertelt, dat GPT-5.6 "zo capabel is dat we met de overheid moesten afstemmen", voelt een beetje als de meest flatterende mogelijke marketing. Maar dat maakt het niet per se onwaar, en we moeten alle voorzichtigheid rond cybersecurity waarderen.
Voor nu is de eerlijke samenvatting: de cijfers zien er sterk uit, de toegang is beperkt, en de echte test volgt wanneer de modellen breed beschikbaar komen. Abonneer je op onze nieuwsbrief, dan houden we je op de hoogte.