Nota: OpenAI ha rilasciato GPT-6 Astra il 3 settembre 2026 e GPT-6 Sol e Luna il 23 settembre 2026.
GPT-5.6 è una serie di tre modelli che oggi debutta in una preview limitata coordinata con il governo degli Stati Uniti.
Non è ancora disponibile per l'uso generalizzato, ma ci sono già molte novità sulle capacità da esaminare, soprattutto su coding, biologia e cybersecurity, di cui parleremo.
Se vuoi tornare indietro nel tempo sulle novità dei modelli OpenAI, abbiamo una raccolta di approfondimenti per ogni release: GPT-5.5 Instant, GPT-5.3 Instant e GPT-5.2.
E se vuoi confrontare GPT-5.6 con i modelli più recenti disponibili, abbiamo articoli anche per quelli: Gemini 3.1 Pro, Claude Opus 5, Claude Mythos 5, Claude Fable 5.
Cos'è GPT-5.6?
GPT-5.6 è la nuova generazione di modelli di OpenAI. In realtà è una famiglia di tre modelli e (finalmente) c'è una nuova convenzione di denominazione.
Nel nuovo sistema, il numero indica la generazione (5.6) e il nome il livello di capacità (Sol, Terra, Luna). Un vantaggio che immagino della nuova convenzione è che ogni livello può avanzare con la propria tabella di marcia, risultando meno confuso. "Instant" non era il nome migliore per indicare l'ultimo modello sottostante.
Cos'è GPT-5.6 Sol?
Sol è il modello di punta, il più forte e capace della serie. È il livello con cui OpenAI guida tutti i benchmark nel rilascio ed è l'unico modello che sblocca la nuova impostazione di ragionamento max e la modalità ultra (più avanti su entrambe).
Sol è anche dove i progressi in cybersecurity e biologia sono più evidenti. È il modello da usare se vuoi il tetto massimo più alto su problemi difficili e multi-step e non ti dispiace pagare di più per token.
Lo abbiamo confrontato con i nuovi modelli di punta di Anthropic e SpaceXAI, Claude Opus 5 e Grok 4.6.
Cos'è GPT-5.6 Terra?
Terra è il modello bilanciato per il lavoro quotidiano. Puoi considerarlo il predefinito. Terra offre prestazioni in linea con GPT-5.5 pur costando circa la metà. Potremmo vederlo ripetersi: qualità da top di gamma della generazione precedente a un prezzo di fascia media.
Cos'è GPT-5.6 Luna?
Luna è il livello veloce e conveniente. È pensato per carichi ad alto volume, sensibili alla latenza o attenti al budget. Come mostra la tabella dei benchmark qui sotto, "più economico" non significa necessariamente "più debole" in ogni attività. Vale la pena sottolinearlo per non sottovalutarlo.
In sintesi:
- Sol è il modello più potente con il pacchetto di sicurezza più ampio
- Terra è simile a GPT‑5.5 ma più economico
- Luna ha il costo più basso.
Cos'altro c'è di nuovo con GPT-5.6?
Questo aggiornamento introduce anche nuovi modi per aumentare il ragionamento, oltre a ampi miglioramenti delle capacità in alcuni domini specifici.
Due nuovi modi per spingere di più il modello
GPT-5.6 introduce due nuovi controlli:
-
max reasoning effort: una nuova impostazione dello sforzo di ragionamento che dà a Sol più tempo per riflettere su un problema.
-
ultra mode: questa è più interessante. Invece di un singolo agente che lavora a un compito, ultra usa sottoagenti.
Se guardi i benchmark qui sotto, vedrai che ultra compare come una sua riga ("GPT-5.6 Sol Ultra") e ottiene il punteggio più alto.
Coding più forte
GPT-5.6 Sol stabilisce un nuovo stato dell'arte su Terminal-Bench 2.1, uscito circa sei settimane fa. L'ultima versione di Terminal-Bench testa flussi di lavoro da riga di comando che richiedono iterazione e coordinamento di strumenti. Entreremo nei numeri nella sezione benchmark.
Biologia più forte
Questo è un benchmark meno conosciuto: GeneBench v1. Valuta analisi di genomica e biologia quantitativa a lungo orizzonte. Dal rilascio vediamo che GPT-5.6 Sol ottiene risultati migliori di GPT-5.5 usando meno token.
Cybersecurity più forte (e gestita con maggior cautela!)
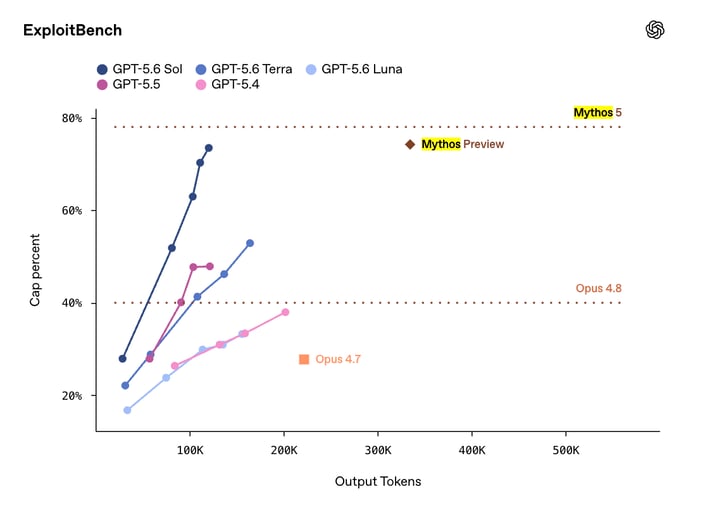
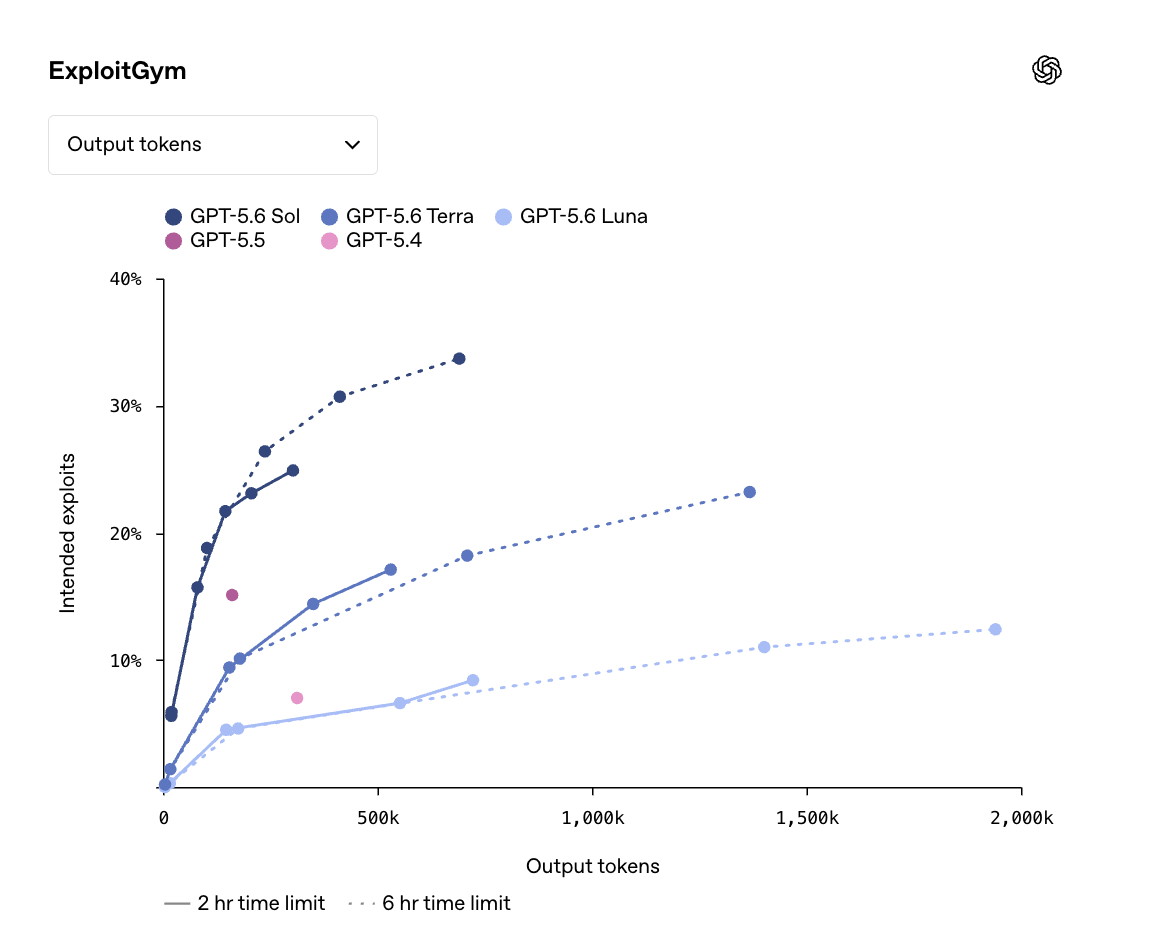
OpenAI definisce GPT-5.6 Sol il suo modello più capace finora per la cybersecurity e dedica molto spazio a questo aspetto nel rilascio. Sol sposta il confine prestazioni-efficienza su compiti di sicurezza a lungo orizzonte, inclusi ricerca di vulnerabilità e exploitation. Il rilascio ci parla di altri successi su benchmark meno noti:
- Su ExploitBench, OpenAI afferma che GPT-5.6 Sol è competitivo con il modello (non rilasciato) Mythos Preview utilizzando solo circa un terzo dei token di output.
- Su ExploitGym, un benchmark creato da ricercatori di UC Berkeley, tutti e tre i modelli mostrano forti miglioramenti cyber al crescere del ragionamento.
Risultati dei benchmark di GPT-5.6
Il risultato di punta nei benchmark è quello su Terminal-Bench 2.1, che ho citato prima. Ecco come si posizionano i modelli, dal punteggio più alto al più basso:
| Model | Terminal-Bench 2.1 |
|---|
| GPT-5.6 Sol Ultra | 91.9% |
| GPT-5.6 Sol | 88.8% |
| GPT-5.5 | 88.0% |
| GPT-5.6 Luna | 84.3% |
| Claude Mythos 5 | 84.3% |
| Claude Fable 5 | 83.4% |
| GPT-5.6 Terra | 82.5% |
| Claude Opus 4.8 | 78.9% |
| Gemini 3.1 Pro Preview | 70.7% |
Saltano all'occhio alcune cose:
-
La modalità ultra fa la differenza. GPT-5.6 Sol Ultra (91,9%) è chiaramente sopra il Sol "liscio" (88,8%), la prova più netta che l'approccio con sottoagenti funziona, almeno qui.
-
L'ordinamento dei livelli non segue perfettamente questo singolo benchmark. Nota che GPT-5.6 Luna in realtà supera GPT-5.6 Terra, anche se Terra è presentato come un livello superiore. E Terra si posiziona sotto GPT-5.5 (88,0%) in questo test, nonostante OpenAI lo descriva come "competitivo con GPT-5.5" nel complesso. La lezione credo sia questa: i livelli riguardano l'equilibrio intelligenza/velocità/costo su molte attività, in media; non garantiscono un risultato su un singolo benchmark.
Lo stack di sicurezza e la preview limitata
È qui che GPT-5.6 si discosta maggiormente da un normale lancio di modello. Invece di testare il modello in prima persona (più avanti spiego perché non possiamo), la parte più rilevante di questa release è come viene distribuito.
Uno stack di salvaguardie a livelli
Secondo OpenAI, nessuna singola salvaguardia resiste a un uso improprio determinato o adattivo, quindi ne stratifica diverse. Nella preview di GPT-5.6, i livelli includono:
- Training a livello di modello per rifiutare assistenza cyber vietata, comprese tentate dissimulazioni di intento o jailbreak del modello.
- Classificatori in tempo reale per uso improprio in ambito cyber e biologico che valutano l'output mentre viene generato. Nei casi a rischio più elevato, la generazione può essere messa in pausa mentre un modello di ragionamento più grande rivede l'intera conversazione e l'output può essere trattenuto prima che ti raggiunga.
- Revisione a livello di account che può analizzare le conversazioni di un utente e i segnali di rischio per distinguere un comportamento malevolo persistente da legittime attività dual-use di sicurezza.
- Accesso differenziato, monitoraggio, enforcement e test continui.
OpenAI chiarisce che, soprattutto durante la preview, questo significa che alcune richieste potrebbero essere bloccate o rifiutate, e altre potrebbero semplicemente richiedere più tempo perché la generazione è stata messa in pausa per revisione. Riconosce anche che le salvaguardie potrebbero occasionalmente attivarsi su lavori legittimi dual-use, dove attività difensive e offensive possono apparire simili a prima vista.
Red teaming su larga scala
Per irrobustire il tutto, OpenAI afferma di aver dedicato una quantità insolita di compute alla sicurezza: oltre 700.000 ore GPU equivalenti A100 di red teaming automatizzato mirato a trovare jailbreak universali, attacchi che si generalizzano su molti prompt e contesti invece di funzionare in un'unica impostazione ristretta. Ciò è stato affiancato da red teaming umano di esperti terzi, che continua per tutta la preview, oltre a un processo di risposta rapida per riprodurre e correggere i jailbreak appena scoperti e integrarli nei test futuri.
Perché il rollout è così cauto
OpenAI afferma di aver presentato in anteprima piani e capacità di GPT-5.6 al governo degli Stati Uniti prima del lancio e, su richiesta del governo, di iniziare con una preview limitata per un piccolo gruppo di partner fidati.
Questo rende la seconda volta in un mese che il governo statunitense interviene nel lancio di un modello di frontiera, perché due settimane fa una direttiva di controllo all'export degli Stati Uniti ha costretto Anthropic a rimuovere Claude Fable 5 e Mythos 5 per tutti i clienti nel mondo.
La mia lettura: OpenAI ha osservato cosa è successo ad Anthropic e ha scelto di consegnare le chiavi in anticipo, invece di farsi ritirare un modello dopo la distribuzione.
Una nota sui test
Nei nostri soliti approfondimenti sui modelli, qui metteremmo alla prova il nuovo modello, hands-on, su ragionamento, ricerca web e un prompt o due ad alto rischio. Al momento non possiamo farlo. GPT-5.6 è in una preview limitata riservata a un piccolo set di partner fidati, quindi non è generalmente disponibile per i test.
Come posso accedere a GPT-5.6?
Durante la preview, i modelli GPT-5.6 sono disponibili tramite API e Codex per un gruppo selezionato di partner e organizzazioni fidati. OpenAI afferma di volerli rendere presto più ampiamente disponibili su ChatGPT, Codex e API.
Prezzi
GPT-5.6 è prezzato per 1M di token sui tre livelli:
| Model | Input (per 1M token) | Output (per 1M token) |
|---|
| GPT-5.6 Sol | $5.00 | $30.00 |
| GPT-5.6 Terra | $2.50 | $15.00 |
| GPT-5.6 Luna | $1.00 | $6.00 |
Alcuni dettagli sui prezzi da conoscere:
- Caching dei prompt più prevedibile, con supporto per breakpoint espliciti e una durata minima della cache di 30 minuti.
- Per GPT-5.6 e modelli successivi, le scritture in cache sono fatturate a 1,25x rispetto alla tariffa di input non in cache del modello, mentre le letture in cache mantengono lo sconto del 90% sull'input cache-ato.
Velocità via Cerebras
OpenAI afferma anche che lancerà GPT-5.6 Sol su Cerebras fino a 750 token al secondo a luglio, con accesso inizialmente limitato a clienti selezionati man mano che la capacità si espande. È pensato proprio per i lavori sensibili alla latenza, dove l'attesa di un modello di frontiera è il collo di bottiglia.
Considerazioni finali
GPT-5.6 porta cose positive: una famiglia a tre livelli più chiara, due nuovi modi per spingere il ragionamento (max e ultra) e progressi in coding, biologia e cybersecurity.
Resta il fatto che il modello è attualmente in una preview chiusa, quindi nessuno indipendente può ancora verificarne le affermazioni. La storia che racconta OpenAI, ovvero che GPT-5.6 è "così capace da doverci coordinare con il governo", suona un po' come il marketing più lusinghiero possibile. Ma allo stesso tempo, questo non la rende falsa, e bisogna apprezzare tutta la cautela sulla cybersecurity.
Per ora, il riassunto onesto è: i numeri sembrano forti, l'accesso è ristretto e la vera prova, letteralmente, arriverà quando i modelli saranno ampiamente disponibili. Iscriviti alla nostra newsletter e ti terremo aggiornato.







Nota: OpenAI ha rilasciato GPT-6 Astra il 3 settembre 2026 e GPT-6 Sol e Luna il 23 settembre 2026.
GPT-5.6 è una serie di tre modelli che oggi debutta in una preview limitata coordinata con il governo degli Stati Uniti.
Non è ancora disponibile per l'uso generalizzato, ma ci sono già molte novità sulle capacità da esaminare, soprattutto su coding, biologia e cybersecurity, di cui parleremo.
Se vuoi tornare indietro nel tempo sulle novità dei modelli OpenAI, abbiamo una raccolta di approfondimenti per ogni release: GPT-5.5 Instant, GPT-5.3 Instant e GPT-5.2.
E se vuoi confrontare GPT-5.6 con i modelli più recenti disponibili, abbiamo articoli anche per quelli: Gemini 3.1 Pro, Claude Opus 5, Claude Mythos 5, Claude Fable 5.
Cos'è GPT-5.6?
GPT-5.6 è la nuova generazione di modelli di OpenAI. In realtà è una famiglia di tre modelli e (finalmente) c'è una nuova convenzione di denominazione.
Nel nuovo sistema, il numero indica la generazione (5.6) e il nome il livello di capacità (Sol, Terra, Luna). Un vantaggio che immagino della nuova convenzione è che ogni livello può avanzare con la propria tabella di marcia, risultando meno confuso. "Instant" non era il nome migliore per indicare l'ultimo modello sottostante.
Cos'è GPT-5.6 Sol?
Sol è il modello di punta, il più forte e capace della serie. È il livello con cui OpenAI guida tutti i benchmark nel rilascio ed è l'unico modello che sblocca la nuova impostazione di ragionamento
maxe la modalitàultra(più avanti su entrambe).Sol è anche dove i progressi in cybersecurity e biologia sono più evidenti. È il modello da usare se vuoi il tetto massimo più alto su problemi difficili e multi-step e non ti dispiace pagare di più per token.
Lo abbiamo confrontato con i nuovi modelli di punta di Anthropic e SpaceXAI, Claude Opus 5 e Grok 4.6.
Cos'è GPT-5.6 Terra?
Terra è il modello bilanciato per il lavoro quotidiano. Puoi considerarlo il predefinito. Terra offre prestazioni in linea con GPT-5.5 pur costando circa la metà. Potremmo vederlo ripetersi: qualità da top di gamma della generazione precedente a un prezzo di fascia media.
Cos'è GPT-5.6 Luna?
Luna è il livello veloce e conveniente. È pensato per carichi ad alto volume, sensibili alla latenza o attenti al budget. Come mostra la tabella dei benchmark qui sotto, "più economico" non significa necessariamente "più debole" in ogni attività. Vale la pena sottolinearlo per non sottovalutarlo.
In sintesi:
Cos'altro c'è di nuovo con GPT-5.6?
Questo aggiornamento introduce anche nuovi modi per aumentare il ragionamento, oltre a ampi miglioramenti delle capacità in alcuni domini specifici.
Due nuovi modi per spingere di più il modello
GPT-5.6 introduce due nuovi controlli:
maxreasoning effort: una nuova impostazione dello sforzo di ragionamento che dà a Sol più tempo per riflettere su un problema.ultramode: questa è più interessante. Invece di un singolo agente che lavora a un compito,ultrausa sottoagenti.Se guardi i benchmark qui sotto, vedrai che
ultracompare come una sua riga ("GPT-5.6 Sol Ultra") e ottiene il punteggio più alto.Coding più forte
GPT-5.6 Sol stabilisce un nuovo stato dell'arte su Terminal-Bench 2.1, uscito circa sei settimane fa. L'ultima versione di Terminal-Bench testa flussi di lavoro da riga di comando che richiedono iterazione e coordinamento di strumenti. Entreremo nei numeri nella sezione benchmark.
Biologia più forte
Questo è un benchmark meno conosciuto: GeneBench v1. Valuta analisi di genomica e biologia quantitativa a lungo orizzonte. Dal rilascio vediamo che GPT-5.6 Sol ottiene risultati migliori di GPT-5.5 usando meno token.
Cybersecurity più forte (e gestita con maggior cautela!)
OpenAI definisce GPT-5.6 Sol il suo modello più capace finora per la cybersecurity e dedica molto spazio a questo aspetto nel rilascio. Sol sposta il confine prestazioni-efficienza su compiti di sicurezza a lungo orizzonte, inclusi ricerca di vulnerabilità e exploitation. Il rilascio ci parla di altri successi su benchmark meno noti:
Risultati dei benchmark di GPT-5.6
Il risultato di punta nei benchmark è quello su Terminal-Bench 2.1, che ho citato prima. Ecco come si posizionano i modelli, dal punteggio più alto al più basso:
Saltano all'occhio alcune cose:
La modalità
ultrafa la differenza. GPT-5.6 Sol Ultra (91,9%) è chiaramente sopra il Sol "liscio" (88,8%), la prova più netta che l'approccio con sottoagenti funziona, almeno qui.L'ordinamento dei livelli non segue perfettamente questo singolo benchmark. Nota che GPT-5.6 Luna in realtà supera GPT-5.6 Terra, anche se Terra è presentato come un livello superiore. E Terra si posiziona sotto GPT-5.5 (88,0%) in questo test, nonostante OpenAI lo descriva come "competitivo con GPT-5.5" nel complesso. La lezione credo sia questa: i livelli riguardano l'equilibrio intelligenza/velocità/costo su molte attività, in media; non garantiscono un risultato su un singolo benchmark.
Lo stack di sicurezza e la preview limitata
È qui che GPT-5.6 si discosta maggiormente da un normale lancio di modello. Invece di testare il modello in prima persona (più avanti spiego perché non possiamo), la parte più rilevante di questa release è come viene distribuito.
Uno stack di salvaguardie a livelli
Secondo OpenAI, nessuna singola salvaguardia resiste a un uso improprio determinato o adattivo, quindi ne stratifica diverse. Nella preview di GPT-5.6, i livelli includono:
OpenAI chiarisce che, soprattutto durante la preview, questo significa che alcune richieste potrebbero essere bloccate o rifiutate, e altre potrebbero semplicemente richiedere più tempo perché la generazione è stata messa in pausa per revisione. Riconosce anche che le salvaguardie potrebbero occasionalmente attivarsi su lavori legittimi dual-use, dove attività difensive e offensive possono apparire simili a prima vista.
Red teaming su larga scala
Per irrobustire il tutto, OpenAI afferma di aver dedicato una quantità insolita di compute alla sicurezza: oltre 700.000 ore GPU equivalenti A100 di red teaming automatizzato mirato a trovare jailbreak universali, attacchi che si generalizzano su molti prompt e contesti invece di funzionare in un'unica impostazione ristretta. Ciò è stato affiancato da red teaming umano di esperti terzi, che continua per tutta la preview, oltre a un processo di risposta rapida per riprodurre e correggere i jailbreak appena scoperti e integrarli nei test futuri.
Perché il rollout è così cauto
OpenAI afferma di aver presentato in anteprima piani e capacità di GPT-5.6 al governo degli Stati Uniti prima del lancio e, su richiesta del governo, di iniziare con una preview limitata per un piccolo gruppo di partner fidati.
Questo rende la seconda volta in un mese che il governo statunitense interviene nel lancio di un modello di frontiera, perché due settimane fa una direttiva di controllo all'export degli Stati Uniti ha costretto Anthropic a rimuovere Claude Fable 5 e Mythos 5 per tutti i clienti nel mondo.
La mia lettura: OpenAI ha osservato cosa è successo ad Anthropic e ha scelto di consegnare le chiavi in anticipo, invece di farsi ritirare un modello dopo la distribuzione.
Una nota sui test
Nei nostri soliti approfondimenti sui modelli, qui metteremmo alla prova il nuovo modello, hands-on, su ragionamento, ricerca web e un prompt o due ad alto rischio. Al momento non possiamo farlo. GPT-5.6 è in una preview limitata riservata a un piccolo set di partner fidati, quindi non è generalmente disponibile per i test.
Come posso accedere a GPT-5.6?
Durante la preview, i modelli GPT-5.6 sono disponibili tramite API e Codex per un gruppo selezionato di partner e organizzazioni fidati. OpenAI afferma di volerli rendere presto più ampiamente disponibili su ChatGPT, Codex e API.
Prezzi
GPT-5.6 è prezzato per 1M di token sui tre livelli:
Alcuni dettagli sui prezzi da conoscere:
Velocità via Cerebras
OpenAI afferma anche che lancerà GPT-5.6 Sol su Cerebras fino a 750 token al secondo a luglio, con accesso inizialmente limitato a clienti selezionati man mano che la capacità si espande. È pensato proprio per i lavori sensibili alla latenza, dove l'attesa di un modello di frontiera è il collo di bottiglia.
Considerazioni finali
GPT-5.6 porta cose positive: una famiglia a tre livelli più chiara, due nuovi modi per spingere il ragionamento (
maxeultra) e progressi in coding, biologia e cybersecurity.Resta il fatto che il modello è attualmente in una preview chiusa, quindi nessuno indipendente può ancora verificarne le affermazioni. La storia che racconta OpenAI, ovvero che GPT-5.6 è "così capace da doverci coordinare con il governo", suona un po' come il marketing più lusinghiero possibile. Ma allo stesso tempo, questo non la rende falsa, e bisogna apprezzare tutta la cautela sulla cybersecurity.
Per ora, il riassunto onesto è: i numeri sembrano forti, l'accesso è ristretto e la vera prova, letteralmente, arriverà quando i modelli saranno ampiamente disponibili. Iscriviti alla nostra newsletter e ti terremo aggiornato.