

课程
Claude 模型入门
3 小时
15K
实践并学习路径你的进步。
使用 Google 继续Anthropic 又发布了一款全新的「第二好」模型。
这次是 Claude Opus 5,官方定位为接近前沿智能,但定价仅为 Claude Fable 5 的一半。更重要的是,Opus 5 在多个编码与知识工作评测(包括 Frontier-Bench 和 GDPval-AA)上实际优于 Fable 5。它仅次于仍未广泛开放的 Mythos 5。
下面我们将带您了解 Opus 5 的新特性、更多基准测试表现、Anthropic 对其对齐与安全性的表述,以及价格信息。
Opus 5 是 Anthropic「Opus」序列的最新版本。按整体能力排序,它低于 Mythos,但高于 Sonnet 与 Haiku。
Anthropic 表示其 最新模型「深思熟虑且积极主动」(他们总有点拟人化)。同时强调该模型面向日常使用,对 AI 工程师而言,这意味着其效率足以长期稳定运行。
在 Frontier-Bench 与 GDPval-AA 等编码与知识工作评测中,Anthropic 称 Opus 5 已是其模型中的最新 SOTA。不过在网络安全任务上仍落后于 Mythos 5,详情见我们的 Mythos 5 文章。
如需查看与竞品及同门模型的正面对比,请参考以下比较指南:
在 Anthropic 自身的表述中,有两点最为突出:其一,转向把任务真正做完,而不是停留在看似合理的回答;其二,视觉输出质量显著提升。
Opus 5 最大的质变在于:它更愿意持续工作,直到任务真正成功。Anthropic 给出了这样的画面感示例:
相较于满足于「看似合理」的回答,这种持续迭代直至成功的倾向,似乎正是 Opus 5 在 Frontier-Bench 等 Agent 评测中跃升的推动力。
Anthropic 还指出,Opus 5 的视觉输出能力较以往模型有实质性提升,例如可生成类似风洞可视化的气流示意图(如围绕汽车的气流)。这是个很有说服力的例子;如果您的工作涉及生成图示,这是个好消息。
此表仅包含 Anthropic 自家的模型。我查阅了各自的发布信息并尽量对齐可比项。与竞品的对比会在下一部分展开。
说明:「未披露」或「未发布」表示该模型在相应发布中未包含该项评测,并非得分为零。
| Benchmark | Haiku 4.5 | Sonnet 4.6 | Opus 4.7 | Opus 4.8 | Sonnet 5 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 73.3% | 79.6% | 87.6% | 88.6% | — | 95.0% | 96.0% |
| SWE-bench Pro | — | 58.1% | 64.3% | 69.2% | 63.2% | 80.3% | 79.2% |
| Terminal-Bench | 41% | 67.0% (2.1) | 69.4% (2.0) | 74.6% (2.1) | 80.4% (2.1) | 88.0% (2.1) | not published |
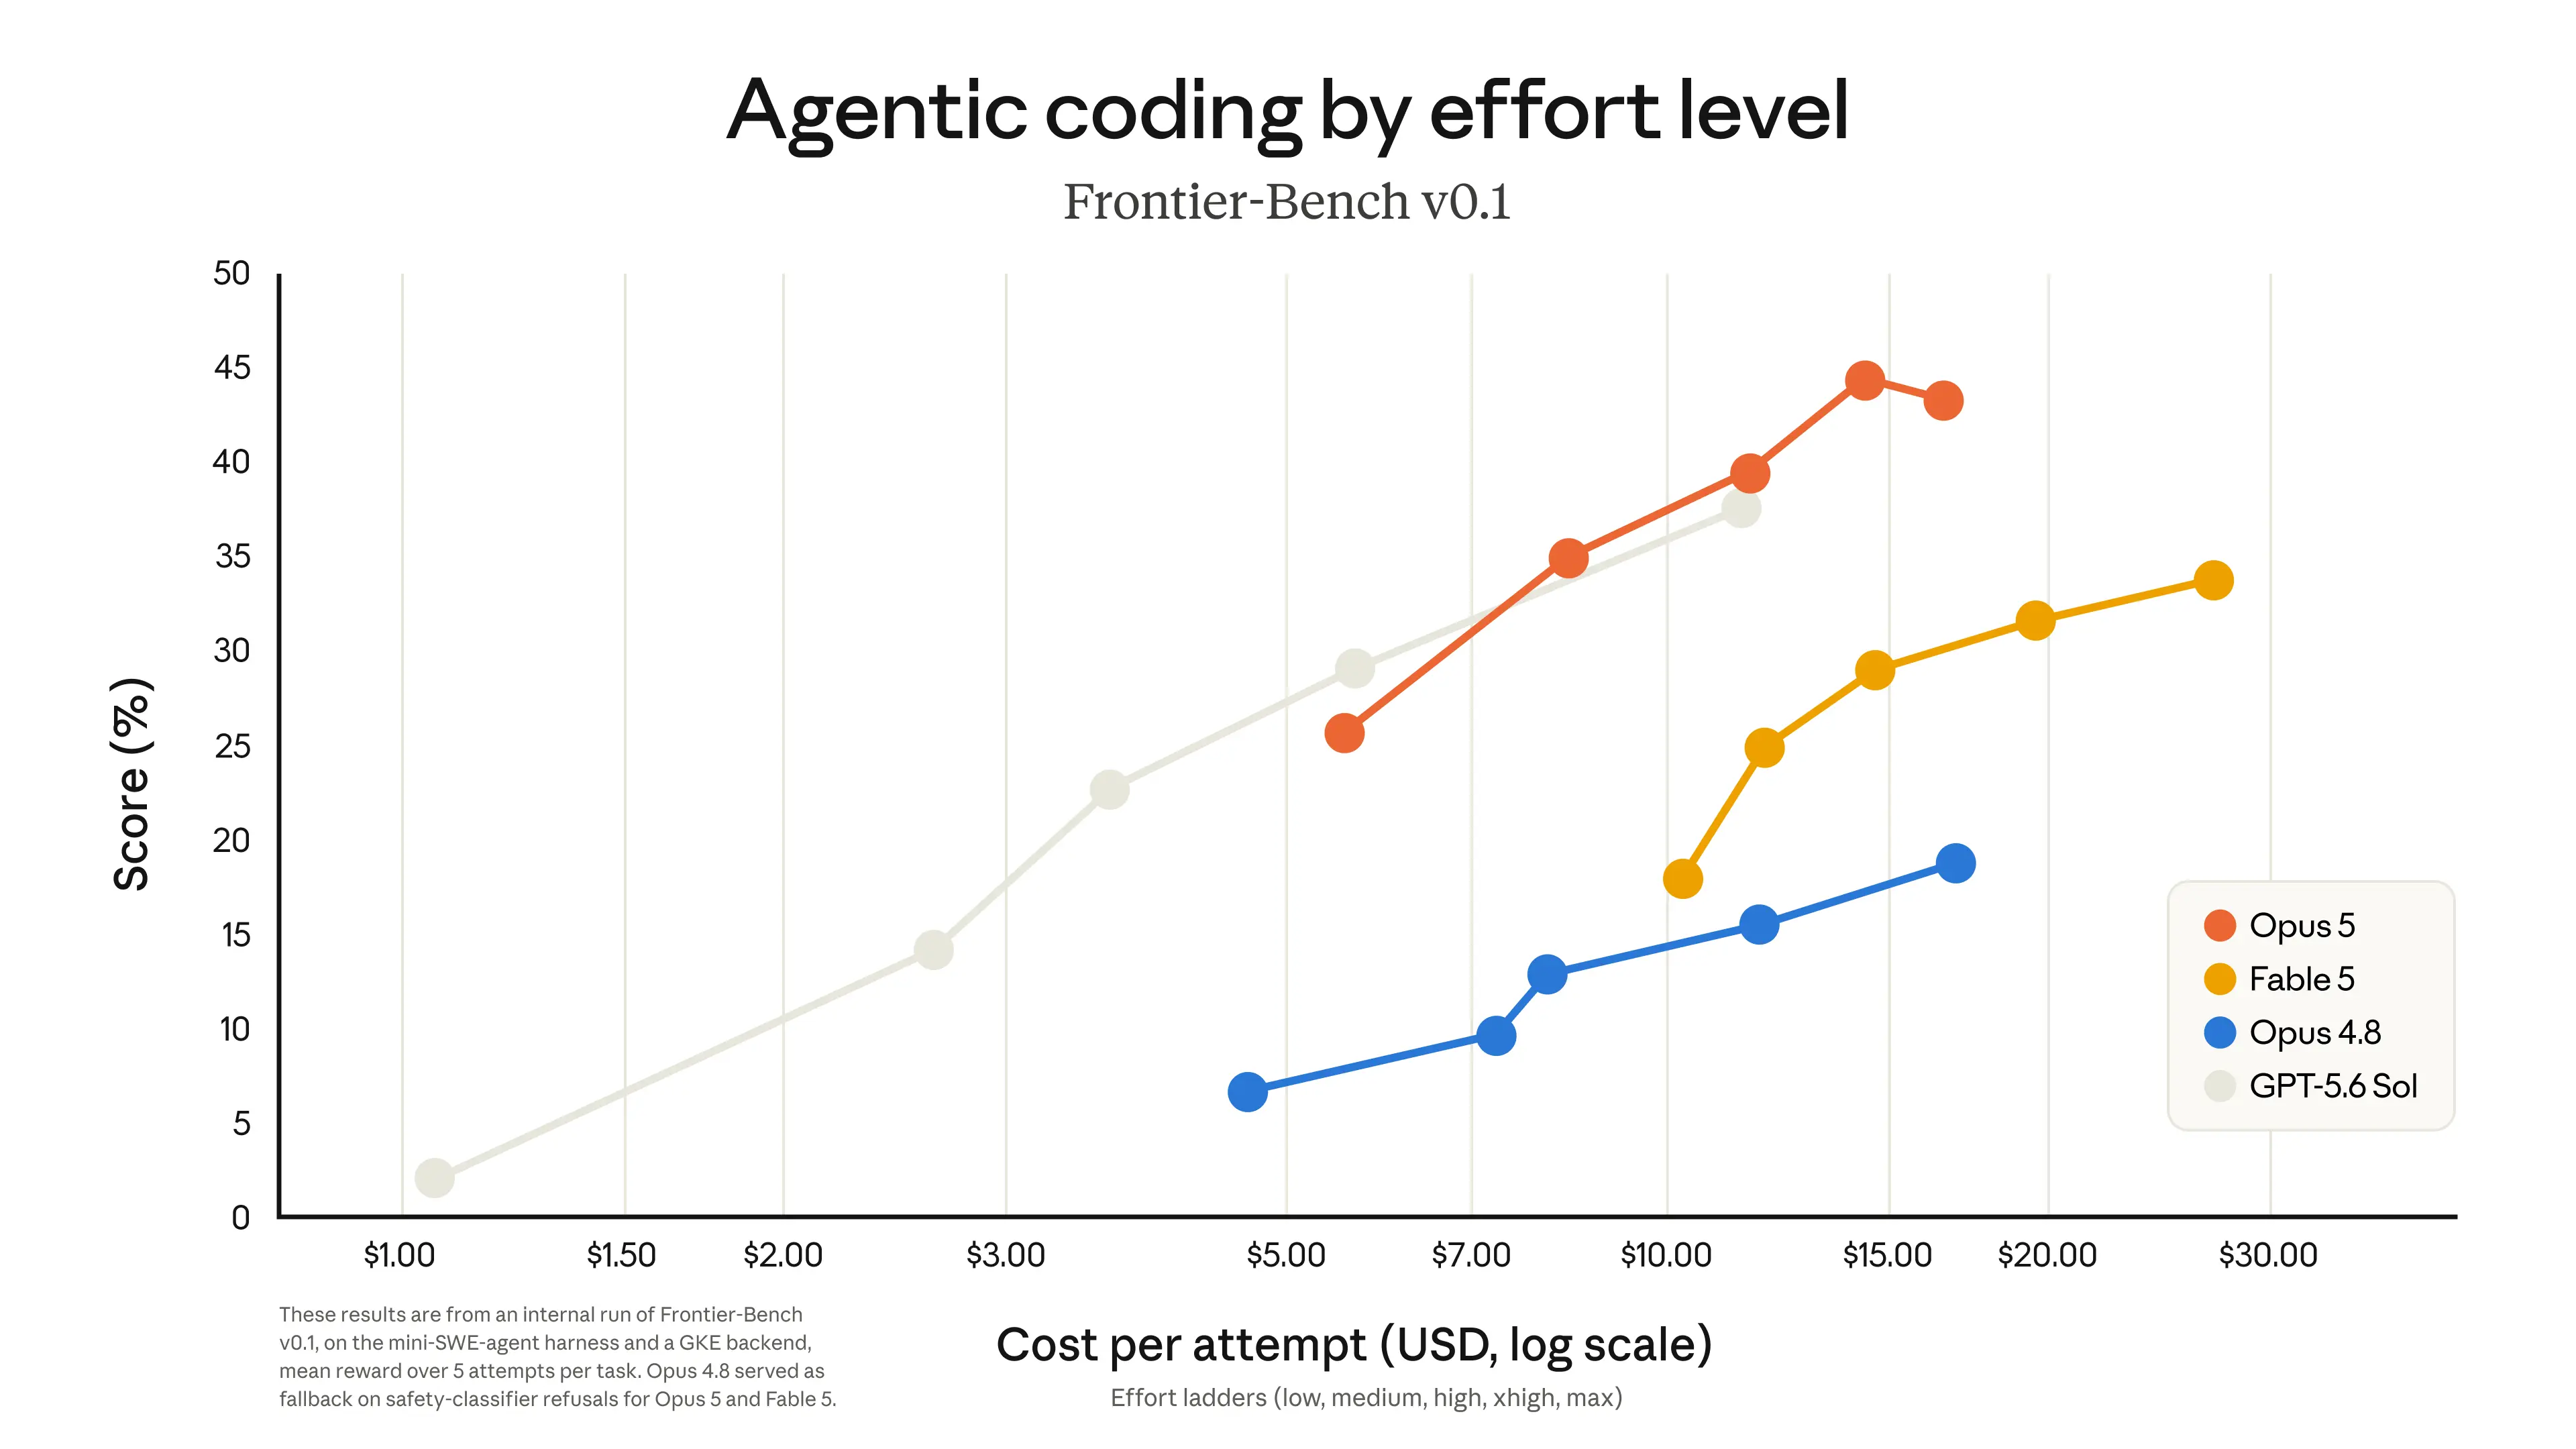
| Frontier-Bench v0.1 (new eval) | — | — | — | 18.7% | — | 33.7% | 43.3% |
| GDPval-AA / v2 (Elo, /2000) | — | — | 1,753 | 1,890 (v1) / 1,593 (v2) | 1,618 (v2) | 1,747 (v2) | 1,861 (v2) |
| Misaligned-behavior audit (lower = better) | — | — | — | not disclosed | not disclosed | not disclosed | 2.3 (best yet) |
| Price ($/MTok in/out) | $1/$5 | $3/$15 | $5/$25 | $5/$25 | $2–3/$10–15 | $10/$50 | $5/$25 |
从上表可见,Opus 5 在 Frontier-Bench v0.1(43.3% vs. 33.7%)和 GDPval-AA v2(1861 vs. 1747)上实际领先其更昂贵的兄长——而价格仅为 Fable 5 的一半。
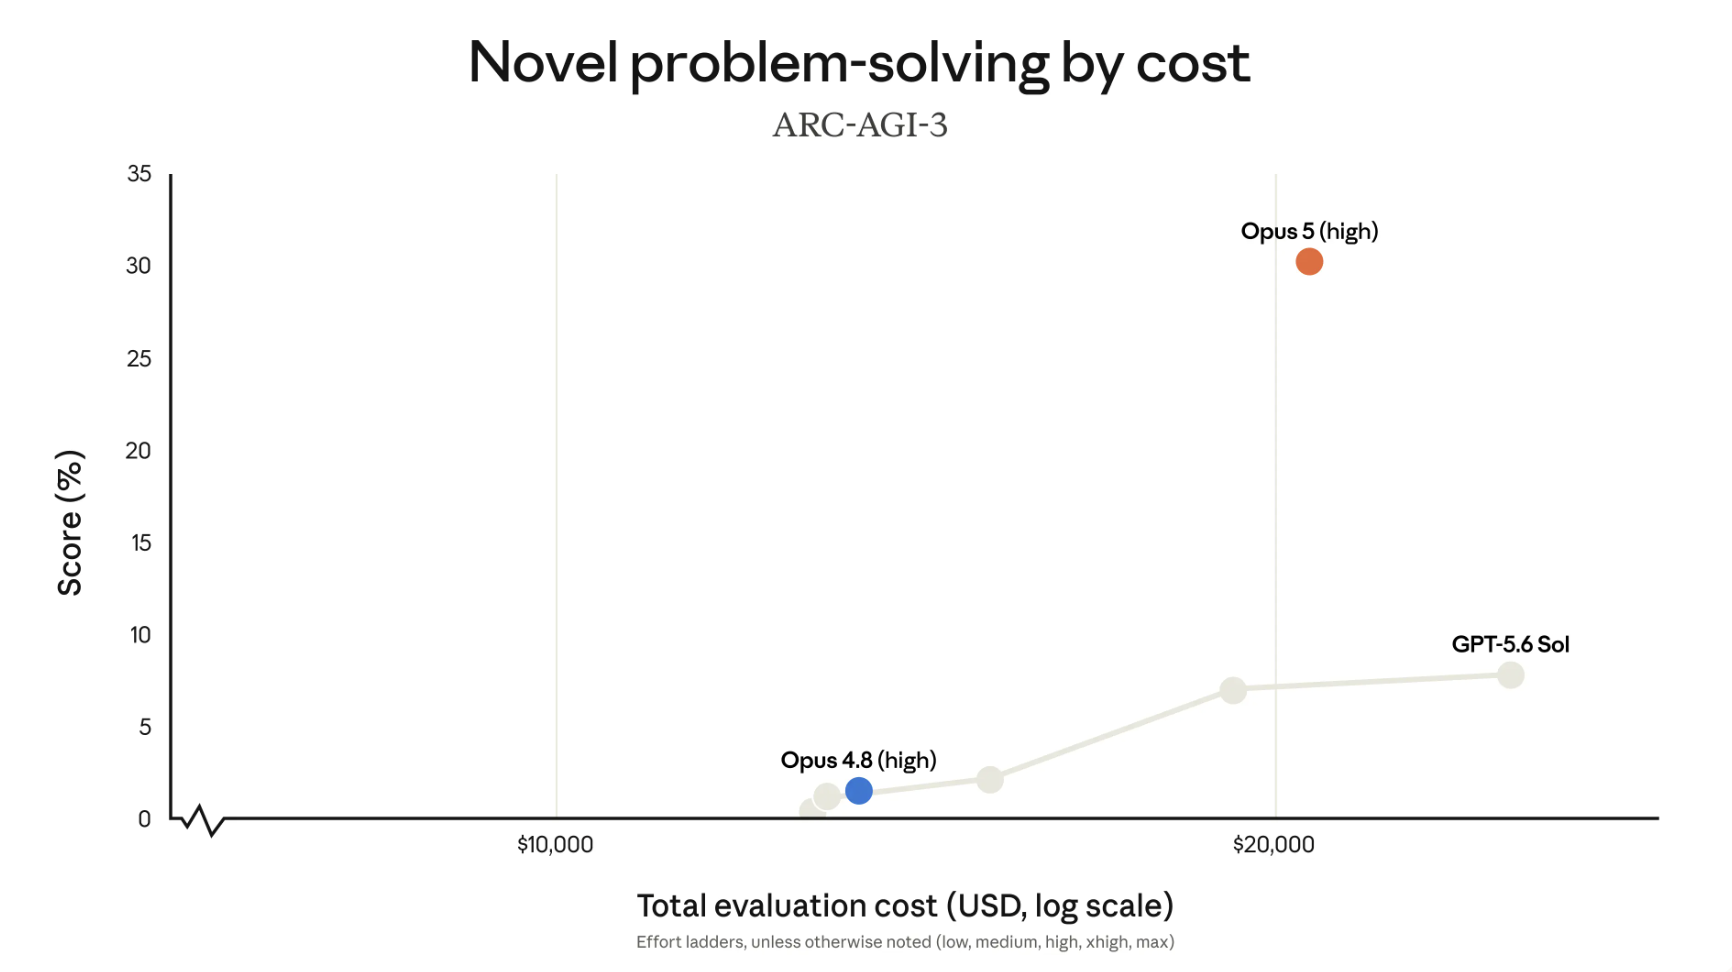
这一组对比体现了最清晰的代际跃迁:在 ARC-AGI-3 上,Opus 5 从 1.5% 跃升至 30.2%;在 Frontier-Bench v0.1 上,如表所示也实现了翻倍以上的提升(43.3% vs. 18.7%)。别忘了,Opus 4.8 发布才两个月。
下表对比直接取自 Anthropic、OpenAI 和 Google 的模型发布公告中公布的基准结果。我选择了足够多模型提供可比分数的行,以确保有意义。仅以相对、模糊表述呈现的评测被排除在外。
| Category | Benchmark | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 | Gemini 3.6 Flash | Gemini 3.5 Flash-Lite | Gemini 3.5 Flash | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Knowledge Work | GDPval-AA v2 (Elo) | 1861 | 1736 | — | 1593 | 1591.8 | 1493.7 | 1421 | — | 1348.8 | 962.3 |
| Coding | SWE-Bench Pro | 79.2% | 64.6% | — | 63.4% | 62.7% | 59.4% | — | 54.2% | — | 54.2% |
| Coding | DeepSWE v1.1 | 68.8% | 72.7% | — | 69.6% | 67.2% | 67% | 49% | — | 37% (baseline) | 11.8% |
| Coding | Terminal-Bench 2.1 | — | 88.8% | 91.9% | 87.4% | 84.7% | 85.6% | — | 54% (vs 3.1 Flash-Lite baseline 31%) | — | 70.7% |
| Coding | Frontier-Bench v0.1 (terminal coding) | 43.3% | 37.5% | — | — | — | — | — | — | — | — |
| Computer Use | BrowseComp | 90.8% | 90.4% | 92.2% | 87.5% | 83.3% | 84.4% | — | — | — | 85.9% |
| Computer Use | OSWorld 2.0* | 70.6% | 62.6% | — | 50.2% | 45.6% | 47.5% | — | — | — | — |
| Abstract Reasoning | ARC-AGI-3 | 30.2% | 7.78% | — | 0.8% | 0.18% | 0.43% | — | — | — | 0.42% |
| Tool Use | AutomationBench | 26.0% | 18.1% | — | 15.2% | 14.9% | 12.9% | — | — | 14.5% |
— |
需要说明:此处所有数值均由发布该模型的实验室自行报告,并在其自有评测框架、提示设置,以及(在某些情况下)思维/推理层级配置下获得。
在更困难、更具新颖性的推理任务(ARC-AGI-3、Frontier-Bench、AutomationBench)上,Opus 5 领先;而在更成熟的编码评测(如 SWE-Bench Pro 和 DeepSWE)上,GPT-5.6 Sol 略胜一筹。这可能意味着 Opus 5 在开放式或非模板化问题求解方面更有优势,而 Sol 在定义清晰、训练充分的编码任务上表现更强。
Gemini 的近期发布聚焦于 Flash 级、成本高效的模型,而非前沿旗舰,因此多数行要么没有 Gemini 数据,要么只有 Flash/Flash-Lite 的数值,且与 Opus 5 和 GPT-5.6 相比差距较大。这个对比更多反映了模型层级的差异,而非谷歌在前沿能力上的水平。
在两者重合的评测中,Opus 5 在新颖推理与 Agent 任务(ARC-AGI-3、BrowseComp、OSWorld 2.0、AutomationBench)上领先;而 GPT-5.6 Sol 在长周期编码(DeepSWE)上略胜。Sol Ultra、Terra 与 Luna 多数出现在 Opus 5 未公布分数的其他编码评测中,因此这更像是「Anthropic 的单一旗舰 vs. OpenAI 的全系家族」而非一对一的干净对比。
Opus 5 今日已在 Claude 全平台上线,价格与其前代保持一致:
快速模式的速度约为默认模式的 2.5 倍,价格为 Opus 5 基础费率的两倍(在 Claude Platform 上,或通过 Claude Code 的用量积分)——与 Opus 4.8 的结构相同。
开发者可通过 API 使用模型字符串 claude-opus-5 进行访问。
两项相关功能将随 Opus 5 一同以测试版推出:
与早期 Opus 版本相同,Opus 5 的通用访问不涉及数据留存要求。
如果您最近觉得我们在频繁撰写关于 Claude 模型的内容,确实如此。Anthropic 正在以高频节奏提升模型能力与效率。
如今,Anthropic 推出了整体上优于其此前最佳模型 Fable 5 的产品。价格更低,且报告了迄今为止最好的对齐指标。
接下来会是什么?Haiku 目前是 Anthropic 最老的模型,我们仍在等待其升级至 5 系列。这只是一个猜测,但 Anthropic 常常带来惊喜。
与 DataCamp 一起学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续