
观察第一张图,不费力就能发现几处明显伪影:
- 天花板出现不自然的扭曲效果,灯具重复、错位,且呈拉伸或悬浮状。
- 部分桌子形状怪异、角度不一致且重叠不自然;某些椅子仿佛部分融化或与地面融合。
- 右侧卡座结构呈现不自然的“融化”外观,内部椅子变形且与环境脱节。
您可以在 Hugging Face 上用相同的提示及以下参数与随机种子复现该结果:
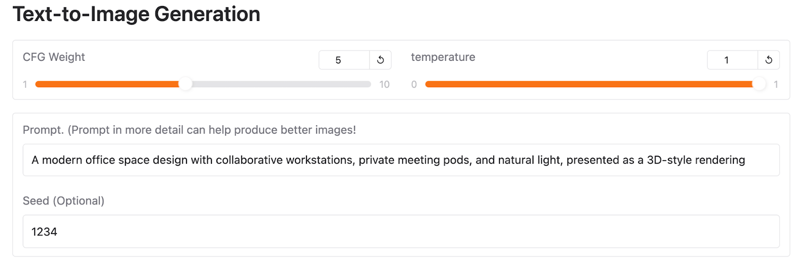
尽管尝试了不同参数与随机种子,我仍未能用 Janus-Pro-7B 产出更好的结果。同样,这只是一个例子,证据不足以对任一模型下广泛结论。
Janus-Pro 基准测试
Janus-Pro 在多项基准上接受了测试,以衡量其在多模态理解与文生图方面的表现。结果显示其较前代 Janus 有所提升,并跻身同类模型的领先行列。
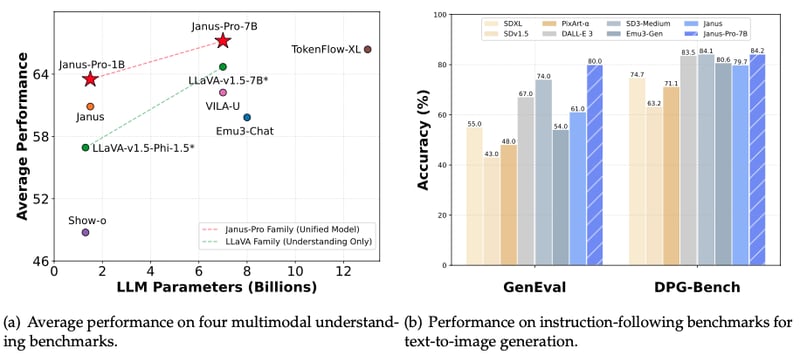
上图左侧的图表展示了 Janus-Pro 在四个多模态理解基准上的表现——DeepSeek 团队对 POPE、MME-Perception、GQA 与 MMMU 的准确率取了平均。关键点是,Janus-Pro-7B 优于更小的 Janus-Pro-1B,也超过了 LLaVA-v1.5-7B 与 VILA-U 等其他多模态模型。
右侧图表将 Janus-Pro-7B 与其他领先模型在文生图指令遵循基准上进行了比较,具体包括 GenEval 与 DPG-Bench:
- 在评估模型对文本提示的遵循度以生成图像的 GenEval 上,Janus-Pro-7B 得分 80.0%,高于 DALL-E 3(67%)与 SD3-Medium(74%)。
- 在测试对细致提示执行准确性的 DPG-Bench 上,Janus-Pro-7B 得分 84.2%,领先于所有其他模型。
如何使用 Janus-Pro
您可以通过几种方式免去复杂配置来体验 Janus-Pro。
Hugging Face 在线演示
最快的测试方式是使用其 Hugging Face Spaces 演示,您可直接在浏览器中输入提示并生成文本或图像,无需安装或设置。
使用 Gradio 的本地 GUI
如果您更倾向于本地、且界面友好的使用方式,DeepSeek 提供了基于 Gradio 的演示。您可以在本机通过 Web GUI 与 Janus-Pro 交互。使用方法请参见 Janus 的官方 GitHub 仓库。
Conclusion
Janus-Pro 是 DeepSeek 在多模态 AI 领域的最新动作,作为开源替代方案对标 DALL-E 3。它在训练、数据规模与解耦架构方面均有改进,更高效地处理文本与图像。
在我与 DALL-E 3 的对比中,Janus-Pro 的文生图表现存在一些短板,生成了较明显的伪影与不一致;但在多模态理解任务上表现良好。需要强调的是,这只是有限测试,尚不足以对其整体能力做出普遍结论。
FAQs
在本地运行 Janus-Pro 需要什么硬件?
对于 1B 等较小模型,Janus-Pro 可在消费级 GPU 上运行。对于更大的 7B 模型,建议使用具备充足显存的高端 GPU,例如 NVIDIA A100 或同等级别。
Janus-Pro 适合实时应用吗?
尽管 Janus-Pro 功能强大,其表现仍取决于运行硬件。实时应用可能需要较高的计算资源,尤其是 7B 模型。
Janus-Pro 是否支持英文以外的语言?
是的,Janus-Pro 包含旨在增强多语言能力的数据集,其中包括中文对话数据等,使其适用于多语种任务。
Janus-Pro 能生成高分辨率图像吗?
目前,Janus-Pro 生成的图像分辨率为 384×384 像素。
Janus-Pro 能针对特定应用进行微调吗?
可以。作为开源模型,Janus-Pro 可使用领域专用数据集进行微调,以满足定制化应用需求。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
DeepSeek-R1 的发布震动了整个 AI 行业,令 NVIDIA 和多家美国 AI 巨头股价大幅下挫。
如今 DeepSeek 又推出了其最新的多模态模型 Janus-Pro,支持文本与图像生成。与 R1 一样,Janus Pro 同为开源,并在多项基准测试中表现强劲。简而言之,它是在多模态 AI 领域对 OpenAI 的 DALL-E 3 和 Stability AI 的 Stable Diffusion 的有力竞争者。
在这篇博文中,我将介绍 Janus Pro 是什么、多模态 AI 的含义、其工作原理以及如何使用它。我还会用几条提示与 DALL-E 3 做对比。
What Is Janus-Pro?
Janus-Pro 是 DeepSeek 最新的多模态 AI 模型,旨在处理同时涉及文本与图像的任务。相较初代 Janus,它在训练策略、数据集规模和模型尺寸(提供 1B 与 7B 参数版本)上均有所提升。
Janus vs. Janus Pro-7b。来源:Janus-Pro 发布论文。
与只擅长单一输入类型的 AI 模型不同,Janus-Pro 这样的多模态模型能够理解并连接这两种模态。例如,您可以上传一张图片并提出文本问题——如识别场景中的物体、读取并解读图像中的文字,甚至分析其上下文。
Janus-Pro 的文字识别。来源:Janus-Pro 发布论文。
Janus-Pro 能根据文本提示生成高质量图像,例如创作精细的艺术作品、产品设计,或基于具体指令的逼真可视化。同时它也能分析视觉输入,如识别照片中的物体、读取并解读图像内文字,或回答关于图表与示意图的问题。
Janus-Pro 的文生图。来源:Janus-Pro 发布论文。
Janus-Pro 提供两种规模——1B 与 7B 参数——可根据您的硬件灵活选择。
How Does Janus-Pro Work?
Janus-Pro 既能理解也能生成文本与图像,并通过相较前代的一些巧妙改进实现这一点。下面用更易理解的方式介绍其关键组件。
解耦的视觉编码
Janus-Pro 的一大亮点是并不使用单一系统同时处理视觉理解与视觉生成,而是将这两项流程分离(解耦视觉编码)。
例如,当您上传图片并就其提问时,Janus-Pro 会用专门的系统来“读取”图像并提取关键信息。而当您要求它根据文本描述生成图像时,则会切换到另一套专注于生成的系统。这样的分离让模型在两类任务上都能表现更好——避免了用一个系统硬做所有事情所带来的折中。
改进的训练流程
Janus-Pro 的训练分三阶段,每个阶段都用于细化其能力:
更大的数据与模型规模
Janus-Pro 等量结合真实世界数据与合成数据 进行扩展。这种混合既提升了结果质量,也改善了在图像生成等任务中的稳定性。
Janus-Pro vs. DALL-E 3
本节我将从多模态理解与文生图两方面,对比 Janus-Pro-7B 与 DALL-E 3。该对比旨在提供两者的实用直观感受,但并不能替代系统化的基准评测深度。
多模态理解
我上传了下面这张图,向 Janus-Pro-7B 与 DALL-E 3 都提了这个问题:
“用一句话概括这张图的主要结论是什么?”
来源:Janus-Pro 的 GitHub 页面。
以下是两者的回答:
Janus-Pro:这张图的主要结论是,Janus 模型在多模态理解任务上取得了最高的平均表现,同时在文生图的指令遵循基准上也展现了很高的准确率。
DALL-E 3:Janus-Pro 系列模型,尤其是 Janus-Pro-7B,在理解与指令遵循的基准中优于其他多模态模型,展现了在文本与图像任务上的强劲能力。
两者都较好地概括了图表,但 Janus-Pro 将其称为 “Janus 模型”,未能与 Janus-Pro 做出区分;而 DALL-E 3 明确指出了 “Janus-Pro 系列模型,尤其是 Janus-Pro-7B”,在语境把握上更准确。
这只是一个孤立示例,无法据此下普遍结论。
文生图
我尝试了一个在实践中可能有真实用途的提示:
“一套现代化办公空间设计,包含协作工位、私密会议舱与自然采光,以 3D 风格渲染呈现”
DALL-E 3 生成了下面这张图,基本覆盖了提示中的所有要素:现代办公空间、协作工位、私密会议舱、自然采光以及 3D 风格渲染。不过仔细观察会发现不少伪影,例如:
我在 Hugging Face 上向 Janus-Pro-7B 发出相同提示。模型生成了五张图,都不太理想: