

Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleRilis DeepSeek-R1 mengguncang industri AI, menyebabkan penurunan saham yang signifikan bagi NVIDIA dan perusahaan AI besar di Amerika.
Kini DeepSeek memperkenalkan Janus-Pro, model multimodal terbarunya yang dirancang untuk pembuatan teks dan gambar. Seperti R1, Janus Pro bersifat open-source dan memberikan hasil tolok ukur yang kuat. Singkatnya, ini adalah pesaing serius bagi DALL-E 3 dari OpenAI dan Stable Diffusion dari Stability AI di ranah AI multimodal.
Dalam blog ini, saya akan menjelaskan Janus Pro: apa itu, apa arti AI multimodal, bagaimana cara kerjanya, dan cara mengaksesnya. Saya juga akan membandingkannya dengan DALL-E 3 pada beberapa prompt.
Janus-Pro adalah model AI multimodal terbaru dari DeepSeek, dirancang untuk menangani tugas yang melibatkan teks dan gambar sekaligus. Model ini memperkenalkan beberapa peningkatan dibandingkan Janus versi awal, termasuk strategi pelatihan yang lebih baik, himpunan data yang lebih besar, dan skala ukuran model (tersedia dalam versi 1B dan 7B parameter).
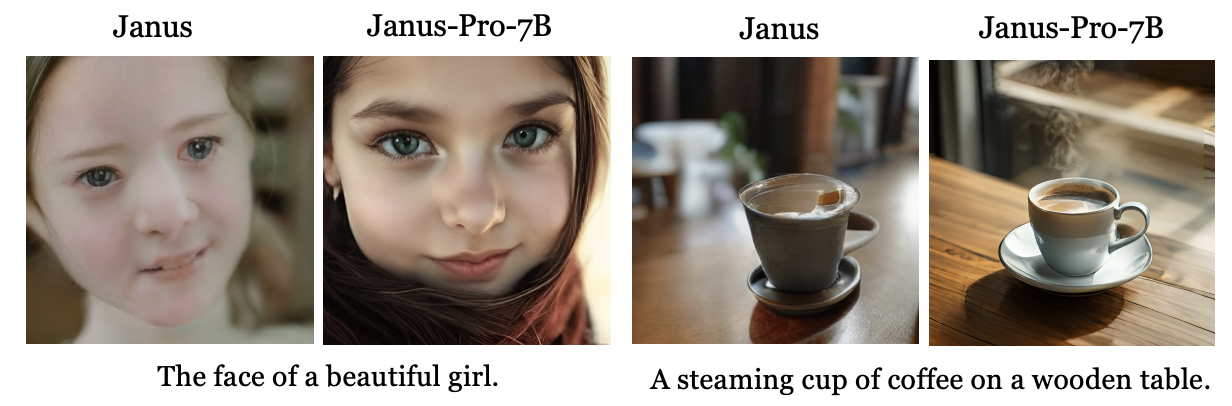
Janus vs. Janus Pro-7b. Sumber: makalah rilis Janus-Pro.
Berbeda dari model AI yang hanya mengkhususkan pada satu jenis input, model AI multimodal seperti Janus-Pro dibangun untuk memahami dan menghubungkan dua modalitas tersebut. Misalnya, Anda dapat mengunggah gambar dan mengajukan pertanyaan berbasis teks tentangnya—seperti mengidentifikasi objek di dalam adegan, menafsirkan teks dalam gambar, atau bahkan menganalisis konteksnya.
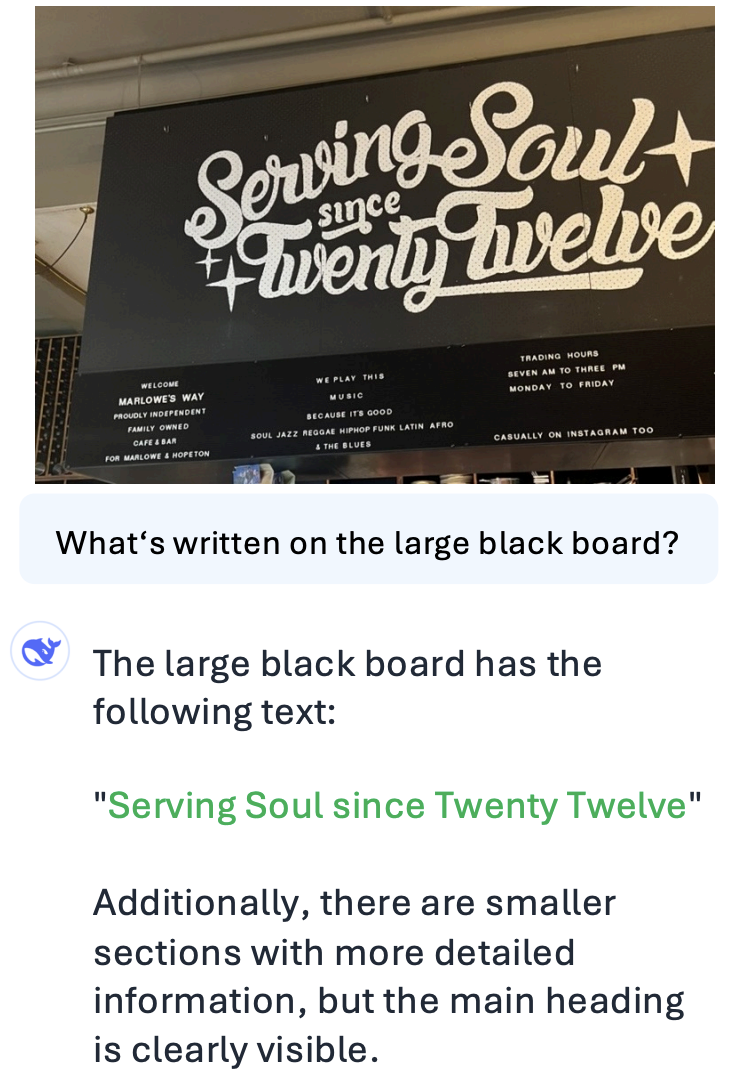
Pengenalan teks dengan Janus-Pro. Sumber: makalah rilis Janus-Pro.
Janus-Pro dapat menghasilkan gambar berkualitas tinggi dari prompt teks, seperti membuat karya seni detail, desain produk, atau visualisasi realistis berdasarkan instruksi spesifik. Model ini juga dapat menganalisis input visual, seperti mengidentifikasi objek dalam foto, membaca dan menafsirkan teks dalam gambar, atau menjawab pertanyaan tentang bagan atau diagram.
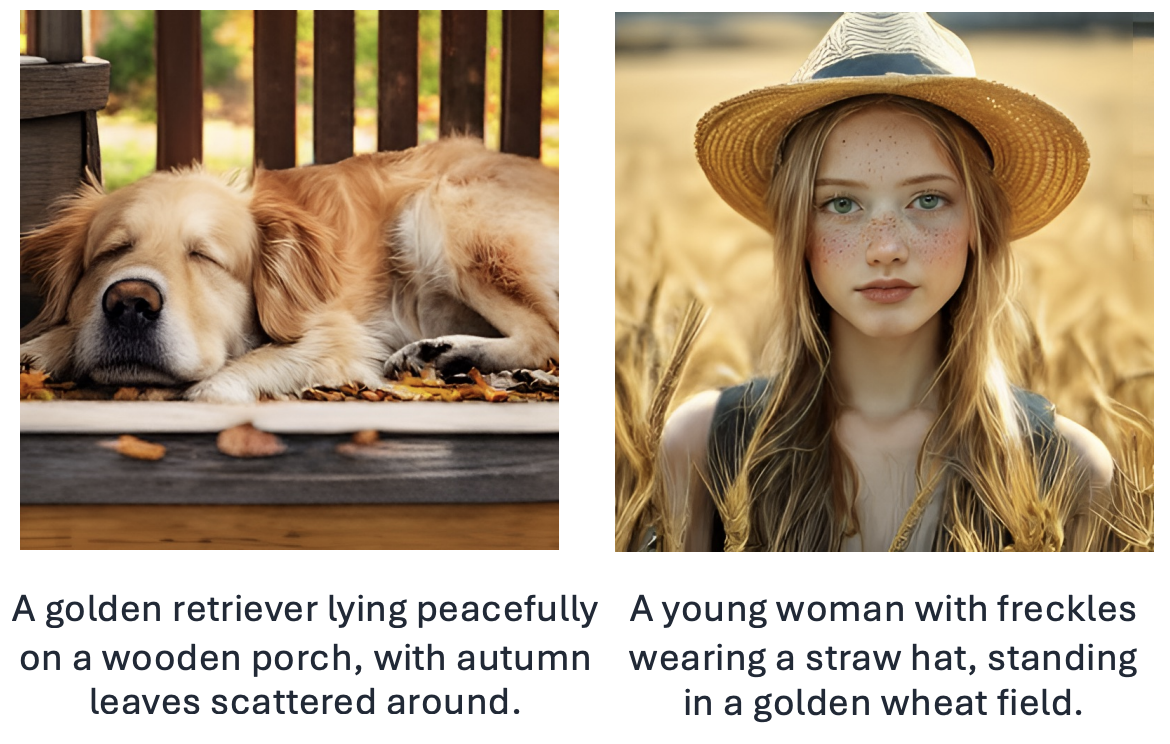
Generasi teks ke gambar dengan Janus-Pro. Sumber: makalah rilis Janus-Pro.
Janus-Pro hadir dalam dua ukuran—1B dan 7B parameter—memberikan fleksibilitas sesuai perangkat keras Anda.
Janus-Pro dirancang untuk memahami dan menghasilkan teks serta gambar, dan hal ini dicapai dengan beberapa peningkatan cerdas dibanding pendahulunya. Berikut penjelasan komponen utamanya dengan cara yang lebih mudah dicerna.
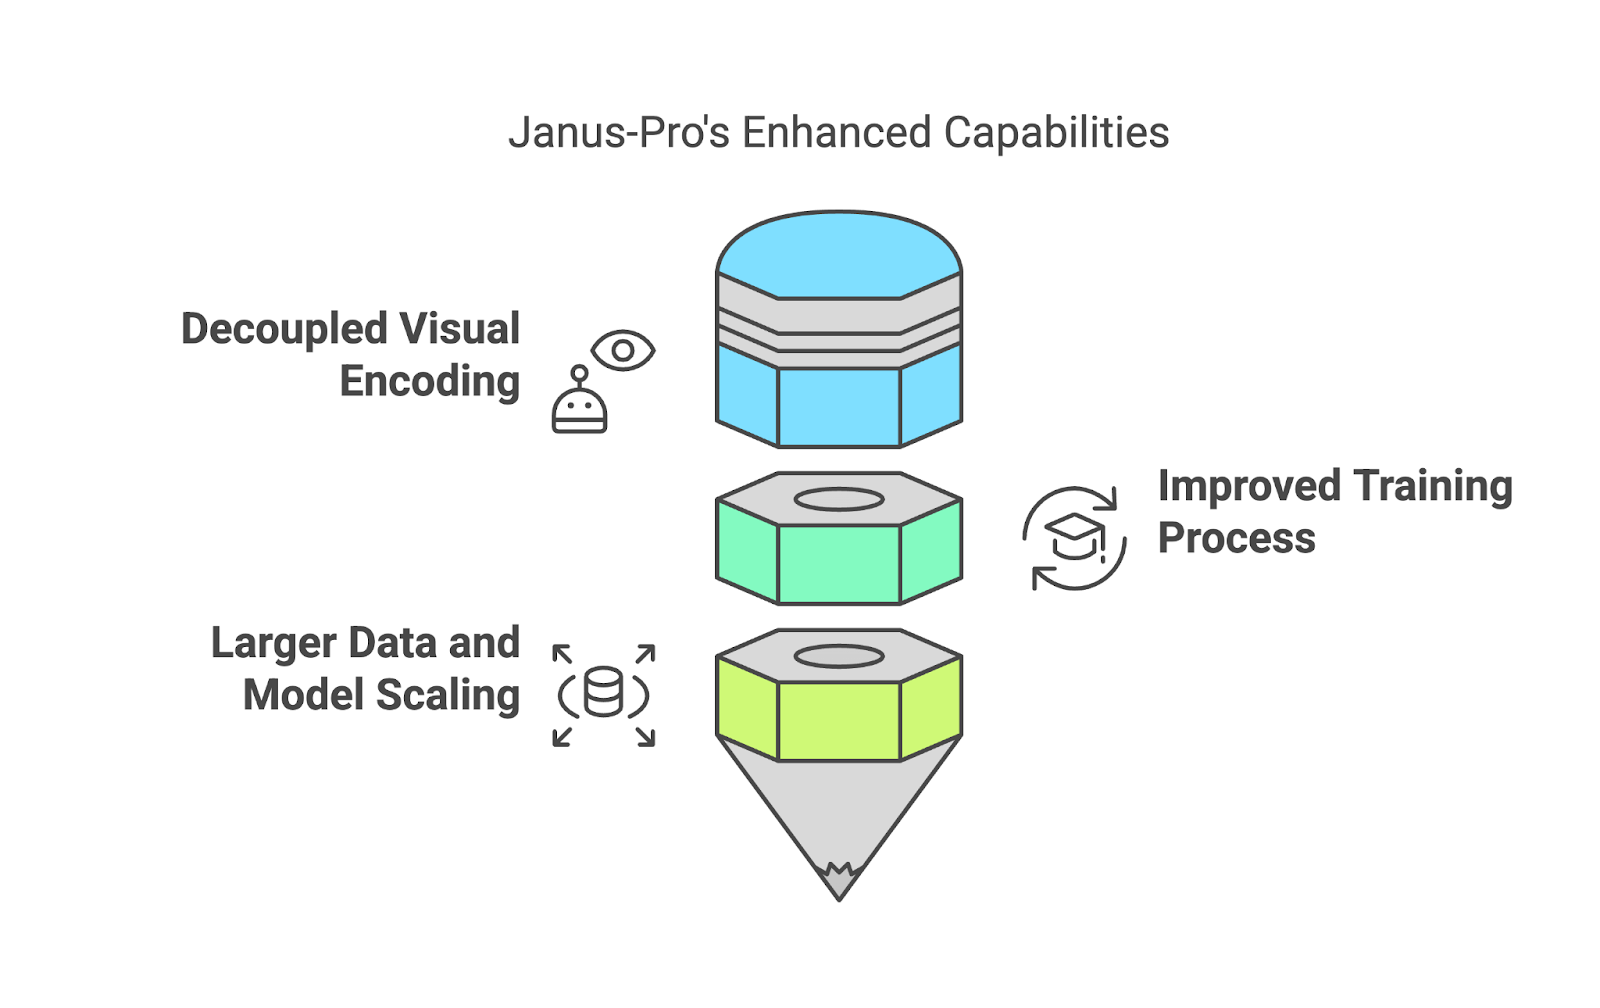
Salah satu fitur menonjol Janus-Pro adalah tidak menggunakan satu sistem tunggal untuk menangani interpretasi dan pembuatan visual sekaligus. Sebaliknya, proses tersebut dipisahkan (decoupled visual encoding).
Misalnya, saat Anda mengunggah gambar dan mengajukan pertanyaan tentangnya, Janus-Pro menggunakan sistem khusus untuk “membaca” gambar dan menemukan hal yang penting. Di sisi lain, ketika Anda memintanya membuat gambar dari deskripsi teks, model beralih ke sistem berbeda yang berfokus pada pembuatan visual. Pemisahan ini memungkinkan model melakukan kedua tugas tersebut dengan lebih baik—menghindari kompromi yang terjadi ketika satu sistem dipaksa menangani semuanya.
Pelatihan Janus-Pro dibagi menjadi tiga tahap, masing-masing dirancang untuk menyempurnakan kapabilitasnya:
Janus-Pro meningkatkan kemampuannya dengan menggunakan data dunia nyata dan data sintetis dalam porsi yang sama. Campuran ini tidak hanya memastikan hasil yang lebih berkualitas, tetapi juga meningkatkan stabilitas saat menjalankan tugas seperti pembuatan gambar.
Di bagian ini, saya akan membandingkan Janus-Pro-7B dan DALL-E 3 dalam pemahaman multimodal dan generasi teks-ke-gambar. Perbandingan ini dimaksudkan untuk memberi Anda gambaran praktis tentang performa model-model tersebut, namun bukan pengganti pengukuran tolok ukur sistematis yang mendalam.
Saya mengunggah gambar di bawah dan menanyakan hal yang sama kepada Janus-Pro-7B dan DALL-E 3:
“Dalam satu kalimat, apa inti utama dari gambar ini?”
Sumber: halaman GitHub Janus-Pro.
Berikut tanggapannya:
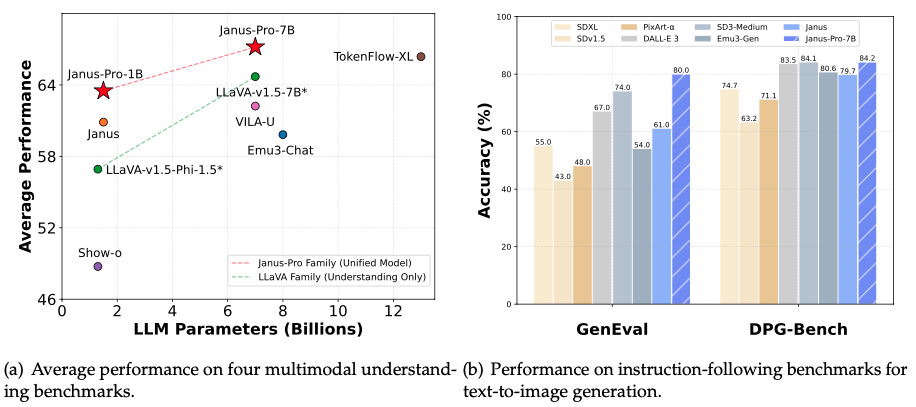
Janus-Pro: Inti utama gambar ini adalah bahwa model Janus mencapai performa rata-rata tertinggi pada tugas pemahaman multimodal, sekaligus menunjukkan akurasi tinggi pada tolok ukur pemenuhan instruksi untuk generasi teks-ke-gambar.
DALL-E 3: Model Janus-Pro, khususnya Janus-Pro-7B, melampaui model multimodal lain dalam tolok ukur pemahaman dan pemenuhan instruksi, menunjukkan kapabilitas kuat di seluruh tugas teks dan gambar.
Kedua model merangkum grafik dengan baik, tetapi Janus-Pro salah menyebut “model Janus,” gagal membedakannya dari Janus-Pro. Sementara itu, DALL-E 3 secara spesifik menyebut “model Janus-Pro, khususnya Janus-Pro-7B,” yang menunjukkan pemahaman konteks lebih baik.
Ini hanya contoh terisolasi, jadi kita tidak bisa menarik kesimpulan umum apa pun.
Saya mencoba prompt ini karena mungkin benar-benar berguna dalam praktik:
“Desain ruang kantor modern dengan workstation kolaboratif, pod rapat privat, dan cahaya alami, disajikan sebagai rendering bergaya 3D”
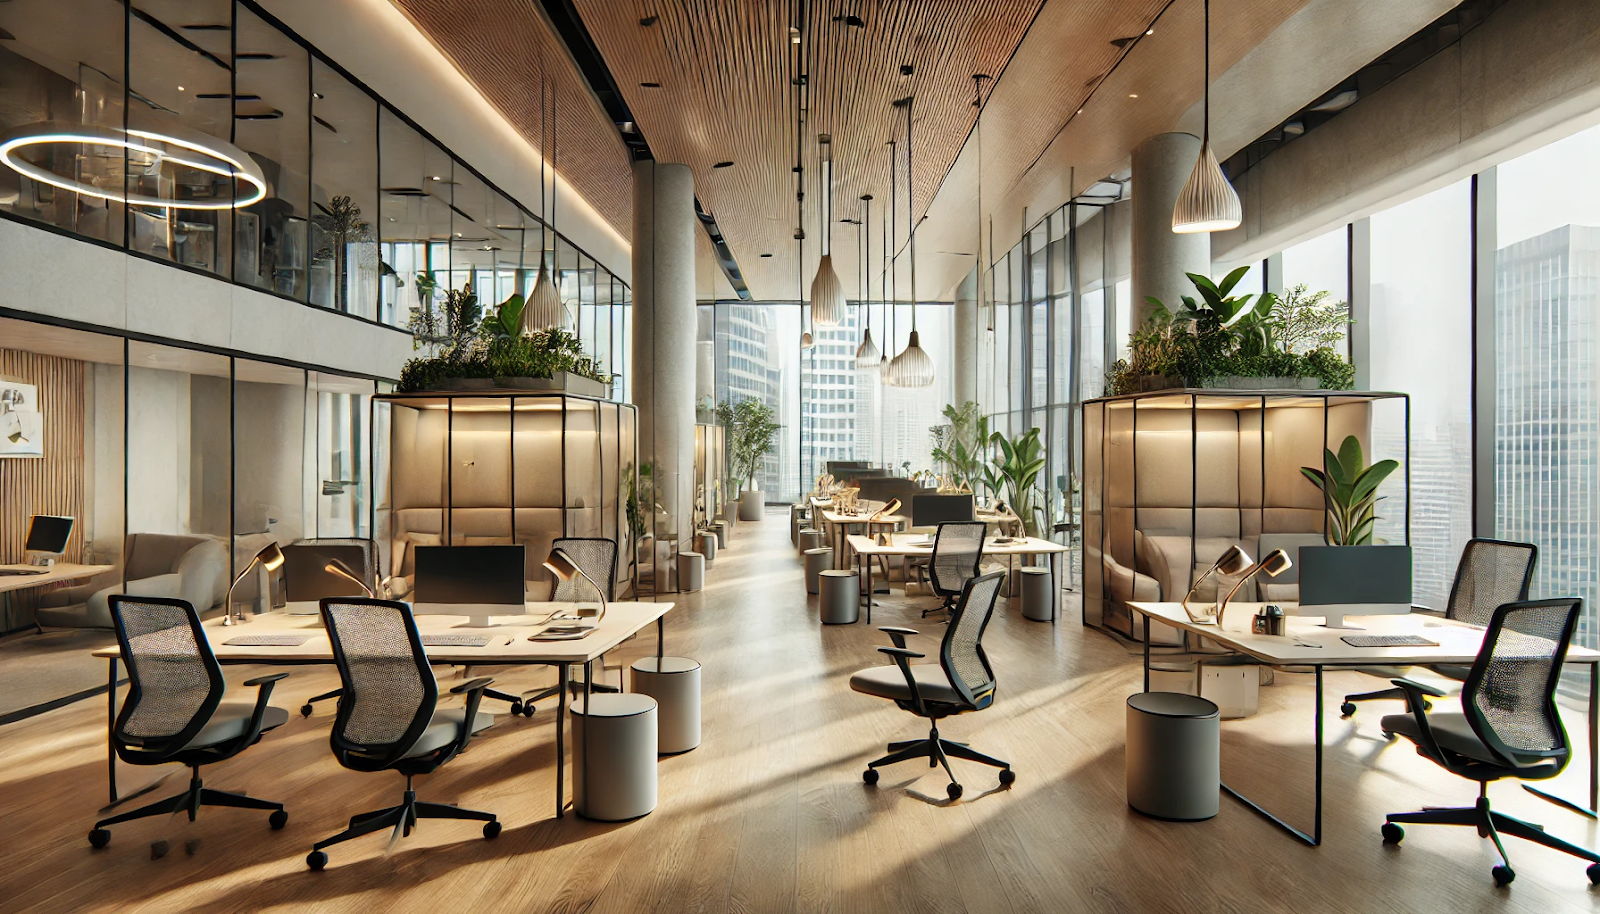
DALL-E 3 menghasilkan gambar di bawah ini, yang mencentang semua elemen dalam prompt: ruang kantor modern, workstation kolaboratif, pod rapat privat, cahaya alami, dan rendering bergaya 3D. Namun, saat Anda melihat lebih dekat, ada cukup banyak artefak, seperti:
Saya memberi prompt Janus-Pro-7B di Hugging Face. Model menghasilkan lima gambar, dan semuanya terlihat cukup buruk:
Dengan melihat gambar pertama, kita bisa menemukan beberapa artefak besar tanpa banyak usaha:
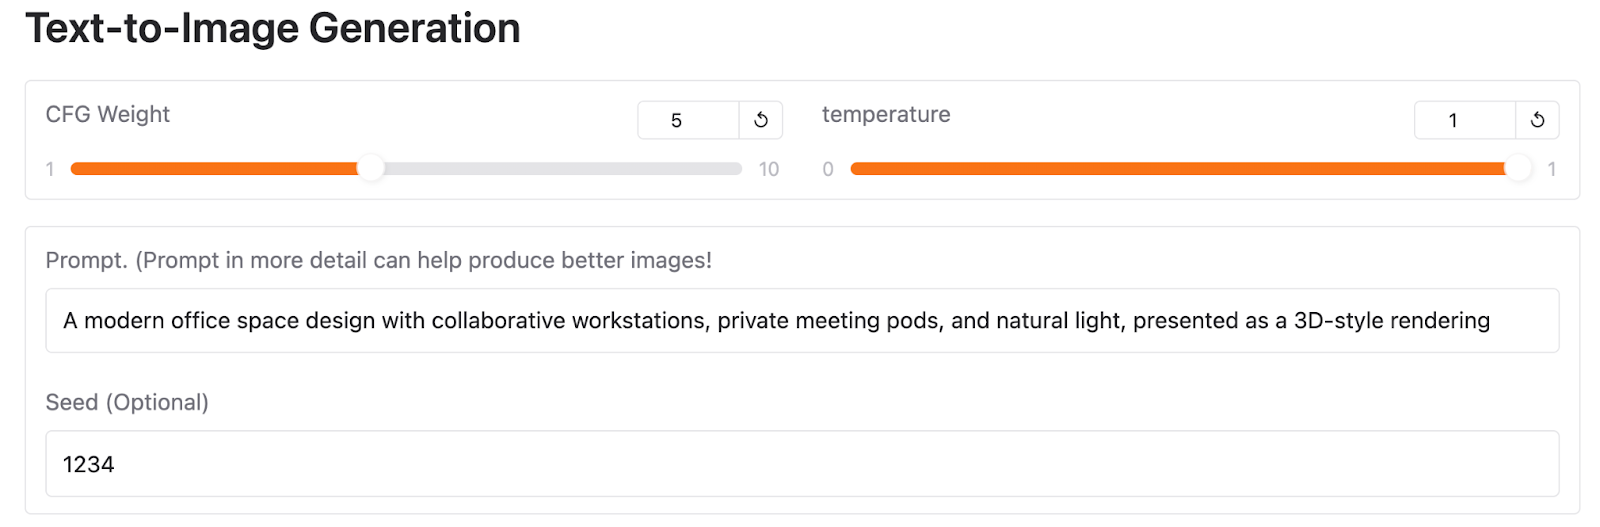
Anda bisa mereproduksi hasil ini di Hugging Face dengan menggunakan prompt yang sama serta parameter dan seed berikut:
Meski bereksperimen dengan berbagai parameter dan seed, saya tidak berhasil menghasilkan keluaran yang lebih baik dengan Janus-Pro-7B. Sekali lagi, ini hanya satu contoh dan tidak cukup memberikan bukti untuk membuat kesimpulan luas tentang salah satu model.
Janus-Pro telah diuji pada berbagai tolok ukur untuk mengukur performanya dalam pemahaman multimodal dan generasi teks-ke-gambar. Hasilnya menunjukkan peningkatan dibandingkan pendahulunya, Janus, dan menempatkannya di antara model dengan performa terbaik di kategorinya.
Sumber: halaman GitHub Janus-Pro.
Bagan kiri pada gambar di atas menunjukkan performa Janus-Pro pada empat tolok ukur pemahaman multimodal—tim DeepSeek merata-ratakan akurasi POPE, MME-Perception, GQA, dan MMMU. Inti utamanya adalah Janus-Pro-7B mengungguli versi yang lebih kecil, Janus-Pro-1B, serta model multimodal lain seperti LLaVA-v1.5-7B dan VILA-U.
Bagan kanan membandingkan Janus-Pro-7B dengan model terkemuka lainnya pada tolok ukur pemenuhan instruksi untuk generasi teks-ke-gambar, khususnya GenEval dan DPG-Bench:
Anda dapat mencoba Janus-Pro tanpa penyiapan yang rumit melalui beberapa cara.
Cara tercepat untuk menguji Janus-Pro adalah melalui demo Hugging Face Spaces, di mana Anda bisa memasukkan prompt dan langsung menghasilkan teks atau gambar di peramban. Ini tidak memerlukan instalasi atau penyiapan.
Jika Anda lebih menyukai penyiapan lokal dengan antarmuka yang ramah pengguna, DeepSeek menyediakan demo berbasis Gradio. Ini memungkinkan Anda berinteraksi dengan Janus-Pro melalui GUI berbasis web di mesin Anda. Untuk menggunakannya, ikuti instruksi pada repositori GitHub resmi Janus.
Janus-Pro adalah langkah terbaru DeepSeek di ranah AI multimodal, menawarkan alternatif open-source untuk model seperti DALL-E 3. Model ini meningkatkan pendahulunya dengan pelatihan yang lebih baik, himpunan data yang lebih besar, dan arsitektur terpisah untuk menangani teks dan gambar secara lebih efektif.
Dalam perbandingan langsung saya dengan DALL-E 3, Janus-Pro menunjukkan beberapa kelemahan pada generasi teks-ke-gambar, menghasilkan artefak dan inkonsistensi yang terlihat. Namun, performanya baik pada tugas pemahaman multimodal. Meski demikian, ini hanya uji terbatas dan belum cukup untuk menarik kesimpulan umum tentang kapabilitas keseluruhan model.
Pelajari AI dengan kursus-kursus ini!
Program
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




