

Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Pratica and corso your progress.
Continua Con GoogleIl lancio di DeepSeek-R1 ha scosso l’industria dell’IA, causando cali significativi delle azioni di NVIDIA e delle principali aziende statunitensi del settore.
DeepSeek ha ora presentato Janus-Pro, il suo ultimo modello multimodale progettato per la generazione di testo e immagini. Come R1, Janus Pro è open source e ottiene ottimi risultati nei benchmark. In poche parole, è un concorrente serio di DALL·E 3 di OpenAI e di Stable Diffusion di Stability AI nel campo dell’IA multimodale.
In questo blog ti spiegherò cos’è Janus Pro, cosa significa IA multimodale, come funziona e come accedervi. Lo confronterò anche con DALL·E 3 su alcuni prompt.
Janus-Pro è il più recente modello di IA multimodale di DeepSeek, progettato per gestire attività che coinvolgono sia testo che immagini. Introduce diversi miglioramenti rispetto al modello Janus originale, tra cui strategie di training migliori, dataset più grandi e dimensioni del modello scalate (disponibile nelle versioni da 1B e 7B parametri).
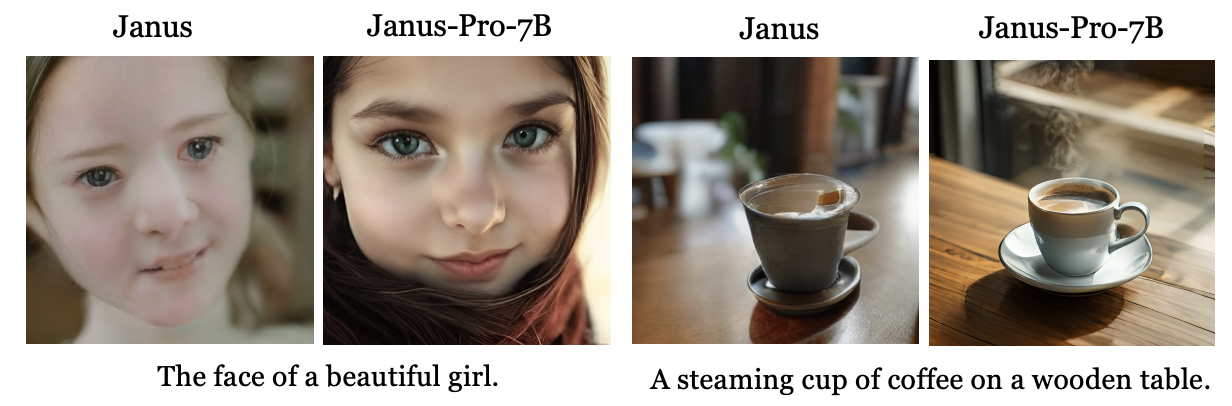
Janus vs. Janus Pro-7b. Fonte: paper di rilascio di Janus-Pro.
A differenza dei modelli di IA specializzati in un solo tipo di input, i modelli multimodali come Janus-Pro sono costruiti per comprendere e collegare queste due modalità. Ad esempio, puoi caricare un’immagine e porre una domanda in testo su di essa—come identificare gli oggetti nella scena, interpretare il testo presente nell’immagine o persino analizzarne il contesto.
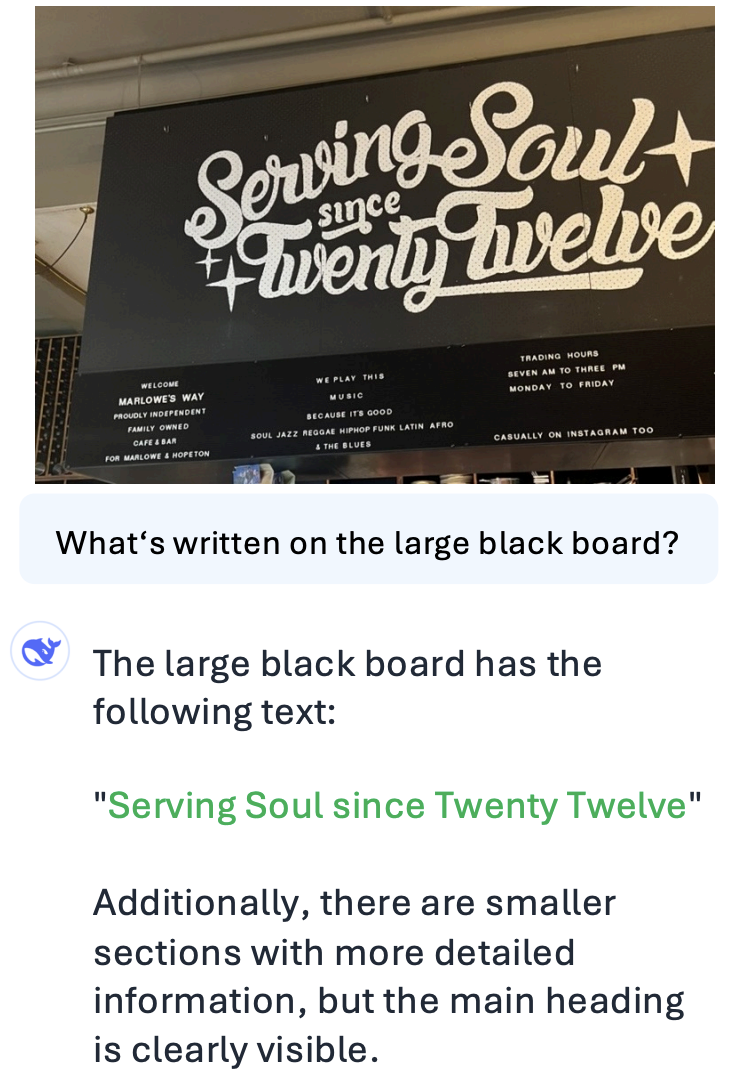
Riconoscimento del testo con Janus-Pro. Fonte: paper di rilascio di Janus-Pro.
Janus-Pro può generare immagini di alta qualità a partire da prompt testuali, ad esempio creando artwork dettagliati, design di prodotto o visualizzazioni realistiche basate su istruzioni specifiche. Può anche analizzare input visivi, come identificare oggetti in una foto, leggere e interpretare il testo in un’immagine o rispondere a domande su un grafico o uno schema.
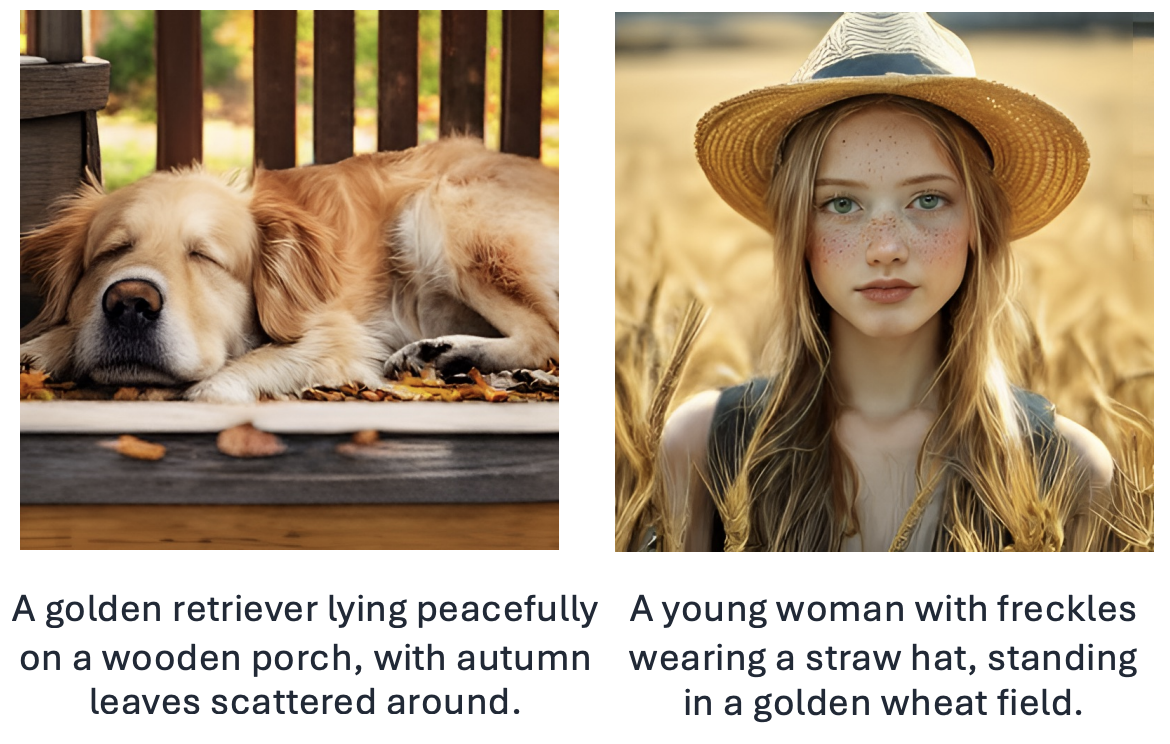
Generazione da testo a immagine con Janus-Pro. Fonte: paper di rilascio di Janus-Pro.
Janus-Pro è disponibile in due dimensioni—1B e 7B parametri—offrendo flessibilità in base al tuo hardware.
Janus-Pro è progettato per comprendere e generare sia testo che immagini, e ci riesce grazie ad alcuni miglioramenti intelligenti rispetto al suo predecessore. Ecco i componenti chiave spiegati in modo semplice.
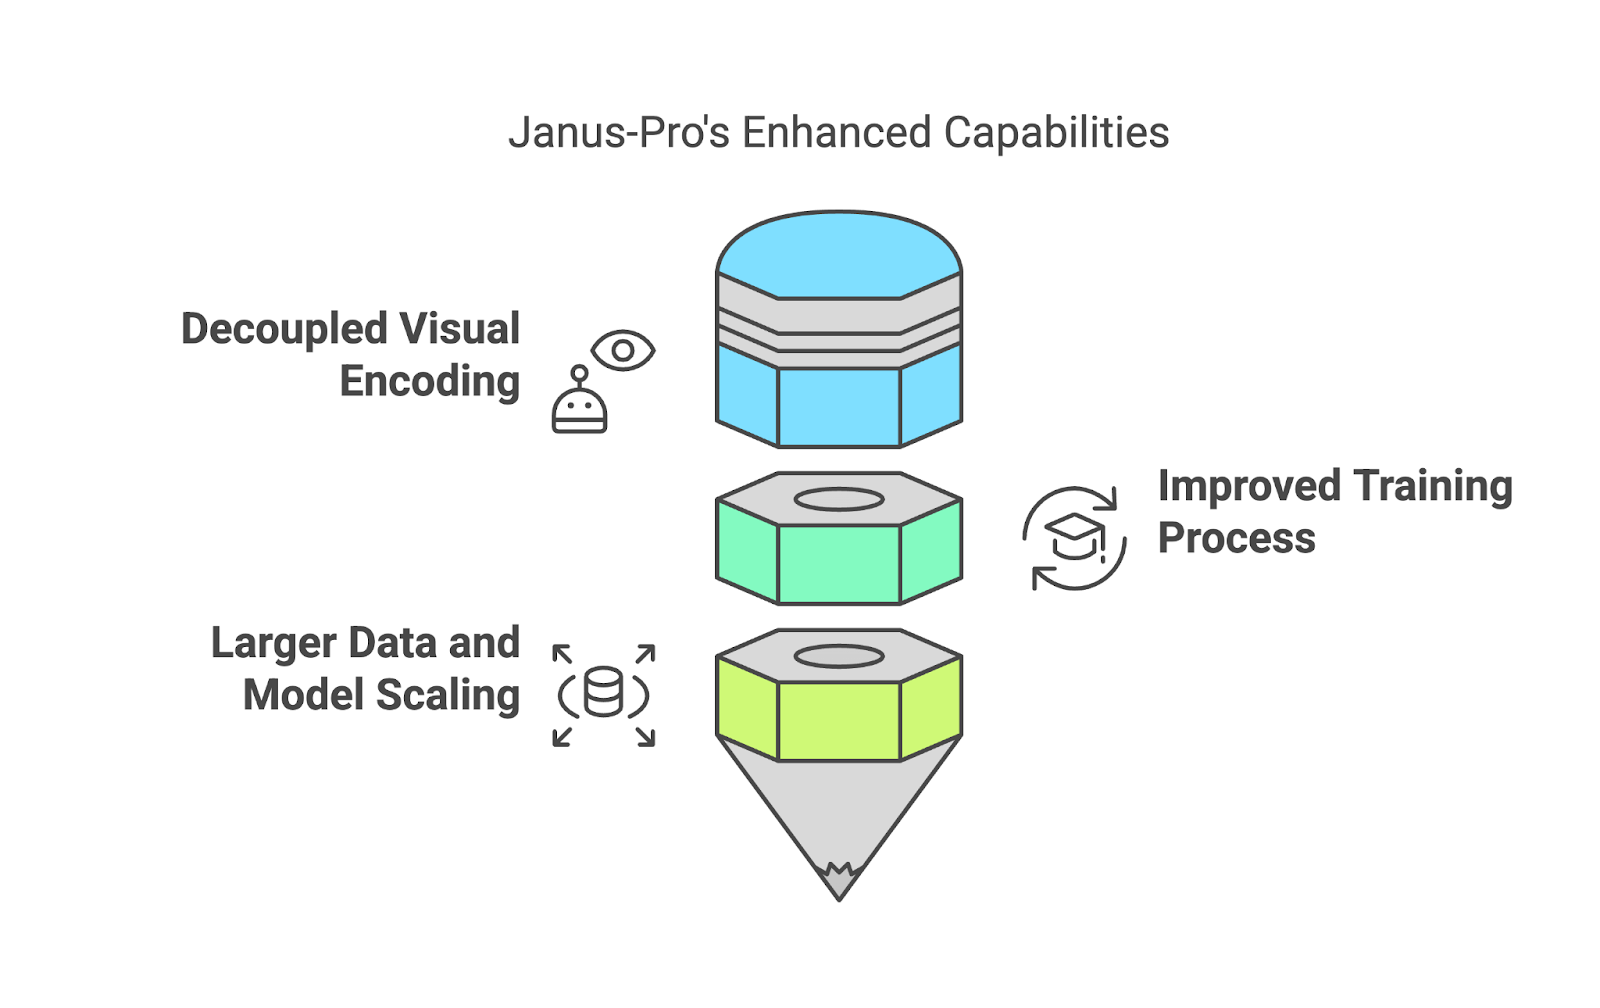
Una delle caratteristiche più distintive di Janus-Pro è che non usa un unico sistema per interpretare e creare contenuti visivi. Invece, separa questi processi (codifica visiva disaccoppiata).
Per esempio, quando carichi un’immagine e fai una domanda al riguardo, Janus-Pro utilizza un sistema specializzato per “leggere” l’immagine e capire cosa è importante. Dall’altro lato, quando gli chiedi di creare un’immagine da una descrizione testuale, passa a un sistema diverso, focalizzato sulla generazione visiva. Questa separazione consente al modello di svolgere meglio entrambe le attività—evitando i compromessi che si hanno quando un solo sistema deve gestire tutto.
Il training di Janus-Pro è diviso in tre fasi, ciascuna pensata per affinare le sue capacità:
Janus-Pro scala le sue capacità utilizzando in parti uguali dati reali e dati sintetici. Questo mix non solo garantisce risultati di qualità superiore, ma migliora anche la stabilità in attività come la generazione di immagini.
In questa sezione confronterò Janus-Pro-7B e DALL·E 3 nella comprensione multimodale e nella generazione da testo a immagine. Questo confronto serve a darti un’idea pratica dei modelli in azione, ma non sostituisce la profondità di misurazioni benchmark sistematiche.
Ho caricato l’immagine qui sotto e ho chiesto sia a Janus-Pro-7B che a DALL·E 3:
«In una frase, qual è il messaggio principale di questa immagine?»
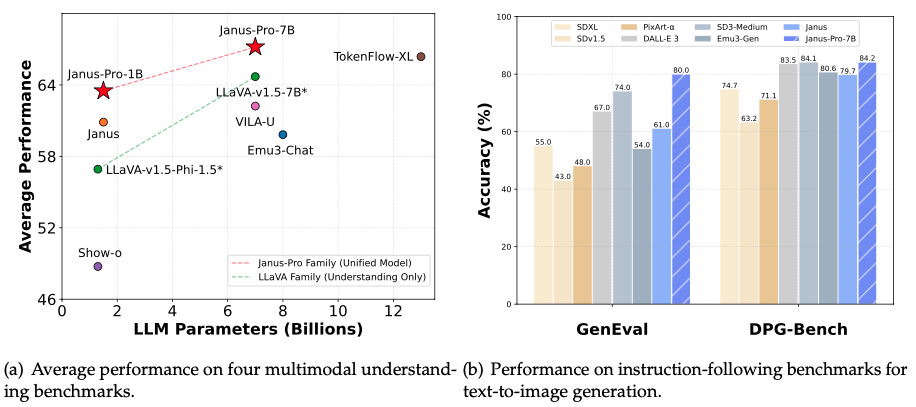
Fonte: pagina GitHub di Janus-Pro.
Ecco le risposte:
Janus-Pro: Il messaggio principale di questa immagine è che il modello Janus raggiunge le migliori prestazioni medie nei compiti di comprensione multimodale, mostrando al contempo un’elevata accuratezza nei benchmark di rispetto delle istruzioni per la generazione da testo a immagine.
DALL·E 3: I modelli Janus-Pro, in particolare Janus-Pro-7B, superano altri modelli multimodali sia nei benchmark di comprensione sia in quelli di rispetto delle istruzioni, dimostrando forti capacità su compiti di testo e immagine.
Sebbene entrambi i modelli riassumano bene il grafico, Janus-Pro si riferisce erroneamente a «Janus» senza distinguerlo da Janus-Pro. DALL·E 3, invece, identifica specificamente i «modelli Janus-Pro, in particolare Janus-Pro-7B», mostrando una migliore comprensione del contesto.
Questo è solo un esempio isolato, quindi non possiamo trarre conclusioni generali.
Ho provato questo prompt perché potrebbe avere un’utilità reale nella pratica:
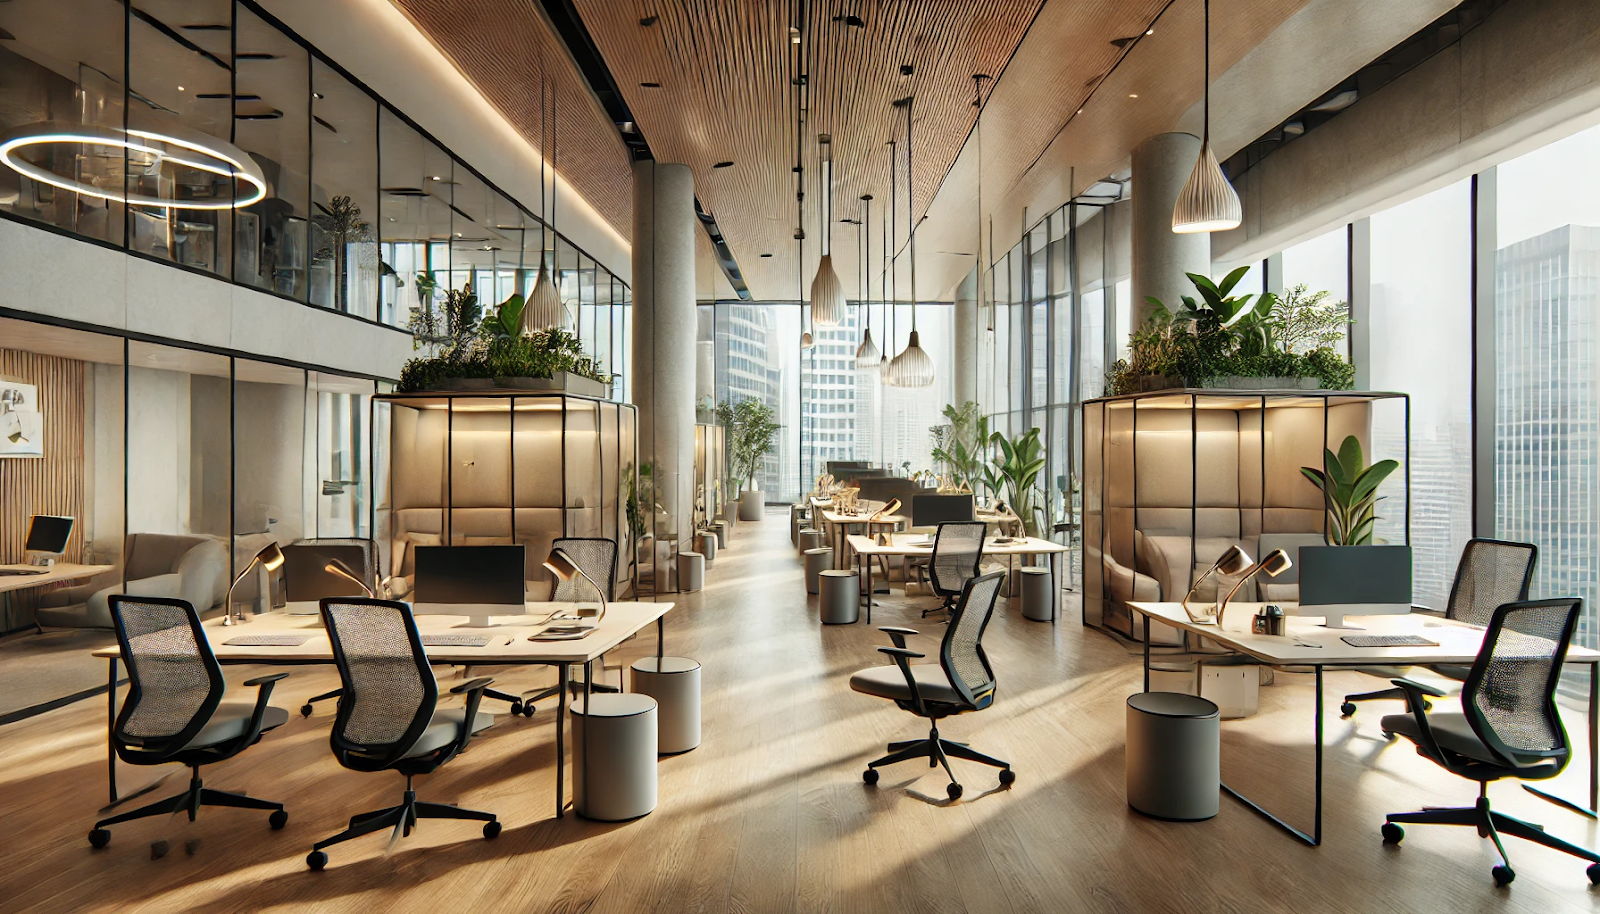
«Un progetto di spazio ufficio moderno con postazioni collaborative, pod per riunioni private e luce naturale, presentato come un render in stile 3D»
DALL·E 3 ha generato l’immagine qui sotto, che rispetta tutti gli elementi del prompt: spazio ufficio moderno, postazioni collaborative, pod per riunioni private, luce naturale e render in stile 3D. Tuttavia, osservando da vicino, si notano diversi artefatti, come:
Ho inviato il prompt a Janus-Pro-7B su Hugging Face. Il modello ha generato cinque immagini, e tutte sembrano piuttosto scarse:
Guardando la prima immagine, si possono individuare senza troppa fatica alcuni artefatti importanti:
Puoi riprodurre questo risultato su Hugging Face usando lo stesso prompt e i seguenti parametri e seed:
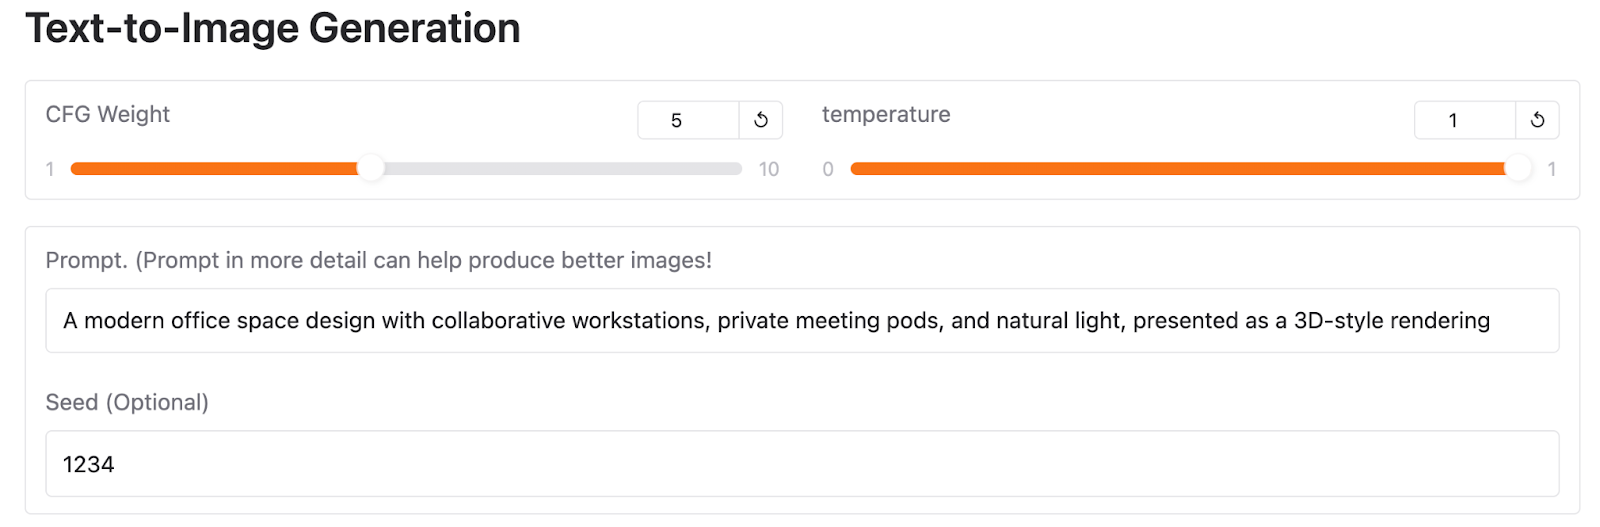
Nonostante vari esperimenti con parametri e seed diversi, non sono riuscito a ottenere output migliori con Janus-Pro-7B. Ancora una volta, questo è solo un esempio e non fornisce prove sufficienti per trarre conclusioni ampie su nessuno dei due modelli.
Janus-Pro è stato testato su più benchmark per misurarne le prestazioni sia nella comprensione multimodale sia nella generazione da testo a immagine. I risultati mostrano miglioramenti rispetto al suo predecessore, Janus, e lo collocano tra i modelli con le performance migliori nella sua categoria.
Fonte: pagina GitHub di Janus-Pro.
Il grafico a sinistra dell’immagine sopra mostra le prestazioni di Janus-Pro su quattro benchmark di comprensione multimodale—il team DeepSeek ha mediato l’accuratezza di POPE, MME-Perception, GQA e MMMU. La conclusione principale è che Janus-Pro-7B supera la sua versione più piccola, Janus-Pro-1B, oltre ad altri modelli multimodali come LLaVA-v1.5-7B e VILA-U.
Il grafico a destra confronta Janus-Pro-7B con altri modelli leader nei benchmark di rispetto delle istruzioni per la generazione da testo a immagine, in particolare GenEval e DPG-Bench:
Puoi provare Janus-Pro senza configurazioni complesse utilizzando alcuni metodi diversi.
Il modo più rapido per testare Janus-Pro è tramite la demo su Hugging Face Spaces, dove puoi inserire prompt e generare testo o immagini direttamente nel browser. Non richiede installazione o setup.
Se preferisci un setup locale con un’interfaccia intuitiva, DeepSeek fornisce una demo basata su Gradio. Ti consente di interagire con Janus-Pro tramite una GUI web sulla tua macchina. Per usarla, segui le istruzioni sul repository GitHub ufficiale di Janus.
Janus-Pro è la mossa più recente di DeepSeek nel campo dell’IA multimodale, offrendo un’alternativa open source a modelli come DALL·E 3. Migliora il suo predecessore grazie a un training migliore, dataset più ampi e un’architettura disaccoppiata per gestire testo e immagini in modo più efficace.
Nel mio confronto diretto con DALL·E 3, Janus-Pro ha mostrato alcune debolezze nella generazione da testo a immagine, producendo artefatti e incoerenze evidenti. Tuttavia, si è comportato bene nei compiti di comprensione multimodale. Detto questo, si tratta solo di un test limitato e non fornisce prove sufficienti per trarre conclusioni generali sulle capacità complessive del modello.
Impara l’IA con questi corsi!
Programma
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



