为了理解客户行为与购买模式,关联规则挖掘已成为企业不可或缺的工具。该技术用于识别经常被一同购买的商品,帮助企业优化商品陈列、促销策略与推荐系统。此类分析通过清晰揭示交易数据中隐藏的趋势,从而改进业务策略。
Apriori 算法因其简单易懂且效果实用而成为挖掘关联规则的常用方法。与其他复杂方法不同,Apriori 思路直观,既适合初学者,也能在真实业务中取得良好表现。
本文将解释 Apriori 算法,结合清晰示例演示其工作流程,并展示如何高效使用它。如果您想动手实践机器学习概念,欢迎查看我们的 Machine Learning Scientist in Python 职业路径。
什么是 Apriori 算法?
正如您在我们的 Python 关联规则挖掘教程中将会看到,Apriori 是一种用于从交易型数据库中提取频繁项集并生成关联规则的算法。它基于这样一个原理:如果某个项集是频繁的,那么它的所有子集也必须是频繁的。该假设有助于减少需要检查的候选项集数量,从而提升效率。
项集与交易
Apriori 的数据集通常由一笔笔交易构成,每笔交易是一组被同时购买的商品。例如,某超市的销售数据可能包含如下交易:
- 牛奶、面包、黄油
- 牛奶、尿布、啤酒、面包
- 尿布、啤酒、黄油
上述每笔交易都代表一次购买所包含的商品篮。我们的 Python 篮子分析课程 将更详细地介绍该概念在 Python 中的应用。
支持度、置信度与提升度
关联规则挖掘依赖三项关键度量:
支持度:某个商品在数据集中出现的频率。其计算方式为:
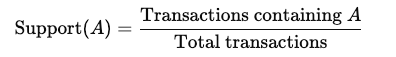
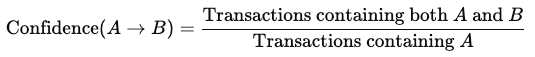
置信度:在购买了商品 A 的前提下购买商品 B 的可能性,计算为:
提升度:规则强度,衡量购买 A 时购买 B 的可能性相较于独立购买时提升了多少:
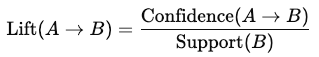
提升度大于 1 表明商品之间存在较强的正相关关系。
Apriori 算法的工作原理
下面我们来看 Apriori 算法如何工作。
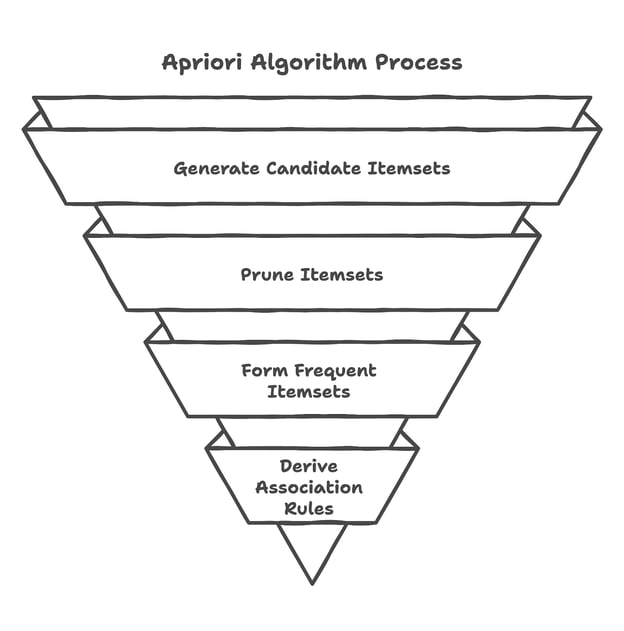
分步过程
- 生成候选项集:算法先识别单个商品并统计出现次数,以确定频繁项。
- 基于最小支持度进行剪枝:出现频率低于最小支持度阈值的项集将被移除。
- 生成频繁项集:通过组合较小的频繁项集来生成更大的项集,并反复迭代直到无法形成新的频繁项集。
- 生成关联规则:基于置信度与提升度提取规则,以确定具有意义的关系。
示例演练
考虑如下交易数据集:
- 牛奶、面包
- 牛奶、黄油
- 牛奶、面包、黄油
- 面包、黄油
在最小支持度为 50% 的情况下,算法识别出频繁项集,并提取如下规则:
- 牛奶 → 面包:置信度:66.7%
- 面包 → 黄油:置信度:66.7%
这些规则有助于企业理解购买行为并优化库存管理。
在 Python 中实现 Apriori 算法
本节将介绍如何用 Python 实现 Apriori 算法。
环境配置
要在 Python 中使用 Apriori,请先安装必要的库:
pip install mlxtend pandas技术支持
加载与准备数据
接下来加载包并准备数据:
import pandas as pd
from mlxtend.frequent_patterns import apriori, association_rules
data = {
'Milk': [1, 1, 0, 1, 0, 1, 0, 1, 1, 0],
'Bread': [1, 0, 1, 1, 1, 0, 1, 0, 1, 1],
'Butter': [0, 1, 1, 1, 1, 1, 0, 1, 1, 0],
'Eggs': [1, 0, 0, 1, 1, 1, 1, 0, 0, 1],
'Cheese': [0, 1, 1, 0, 1, 1, 0, 1, 0, 1],
'Diaper': [0, 1, 0, 1, 0, 1, 1, 1, 0, 0],
'Beer': [1, 0, 1, 0, 1, 0, 1, 0, 1, 1]
}
df = pd.DataFrame(data)技术支持
应用 Apriori 算法
然后应用该算法。
frequent_itemsets = apriori(df, min_support=0.5, use_colnames=True)技术支持
接着,获取关联规则:
frequent_itemsets = apriori(df, min_support=0.5, use_colnames=True)
rules = association_rules(frequent_itemsets, metric='confidence', min_threshold=0.6)
print(rules[['antecedents', 'consequents', 'support', 'confidence', 'lift']])
antecedents consequents support confidence lift
0 (Butter) (Milk) 0.5 0.714286 1.190476
1 (Milk) (Butter) 0.5 0.833333 1.190476
2 (Bread) (Eggs) 0.5 0.714286 1.190476
3 (Eggs) (Bread) 0.5 0.833333 1.190476
4 (Bread) (Beer) 0.6 0.857143 1.428571
5 (Beer) (Bread) 0.6 1.000000 1.428571
6 (Butter) (Cheese) 0.5 0.714286 1.190476
7 (Cheese) (Butter) 0.5 0.833333 1.190476技术支持
上述支持度数值(0.5 至 0.6)表明这些关联出现在全部交易的 50%–60% 中。
上述置信度分数(0.71 至 1.0)体现规则的可靠性,其中如 啤酒 → 面包 的置信度为 100%,代表必然关系。
上述提升度数值(约 1.2 至 1.4)表明是中等但有意义的关联,即这些商品对一起出现的频率略高于随机情况。
解读结果
为更好理解 Apriori 生成的关联规则,我们可使用 Matplotlib 进行可视化。散点图有助于考察置信度与提升度的关系,热力图可展示不同项组合的支持度。
import matplotlib.pyplot as plt
import networkx as nx
plt.figure(figsize=(8,6))
plt.scatter(rules['confidence'], rules['lift'], alpha=0.7, color='b')
plt.xlabel('Confidence')
plt.ylabel('Lift')
plt.title('Confidence vs Lift in Association Rules')
plt.grid()
plt.show()
G = nx.DiGraph()
for _, row in rules.iterrows():
G.add_edge(tuple(row['antecedents']), tuple(row['consequents']), weight=row['confidence'])
plt.figure(figsize=(10, 6))
pos = nx.spring_layout(G)
nx.draw(G, pos, with_labels=True, node_color='lightblue', edge_color='gray', node_size=3000, font_size=10)
edge_labels = {(tuple(row['antecedents']), tuple(row['consequents'])): f"{row['confidence']:.2f}"
for _, row in rules.iterrows()}
nx.draw_networkx_edge_labels(G, pos, edge_labels=edge_labels)
plt.title("Association Rules Network")
plt.show()技术支持
散点图有助于识别关联更强的规则,而网络图能直观展示不同商品之间的联系。这些洞见可用于零售决策、推荐系统与欺诈检测。
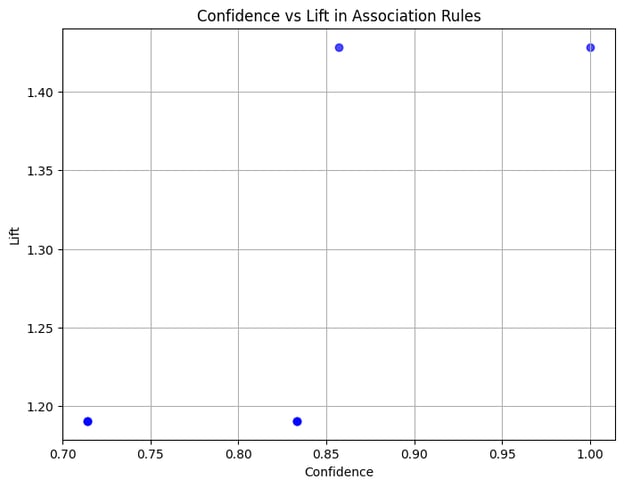
该散点图展示了所生成关联规则的置信度与提升度之间的关系,主要观察包括:
- 数据点的置信度分布在 0.7 至 1.0 之间。
- 提升度大多落在 1.19 至 1.43 之间,说明这些规则虽非极强,但具备一定意义。
- 当置信度为 1.0 且提升度为 1.43(啤酒 → 面包)时,意味着只要出现啤酒,交易中必定包含面包,是一条高度可靠的规则。
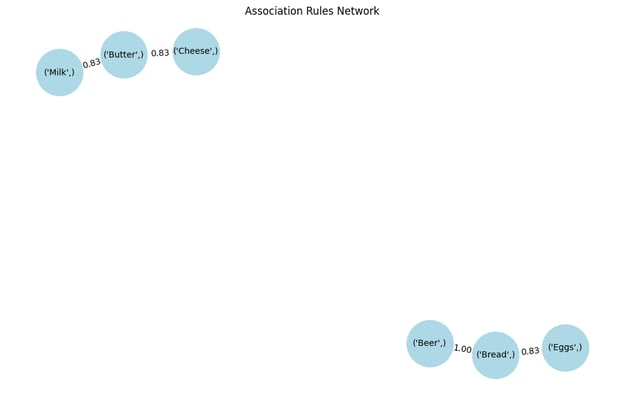
网络图直观展示了不同商品之间的关联关系:
- 牛奶与黄油 关联较强,意味着购买其一的顾客往往也会购买另一件。
- 面包与鸡蛋 也呈现类似关系,反映出常见的购买模式。
- 啤酒与面包 的置信度最高(1.0),即所有包含啤酒的交易也都会包含面包。
Apriori 算法的应用
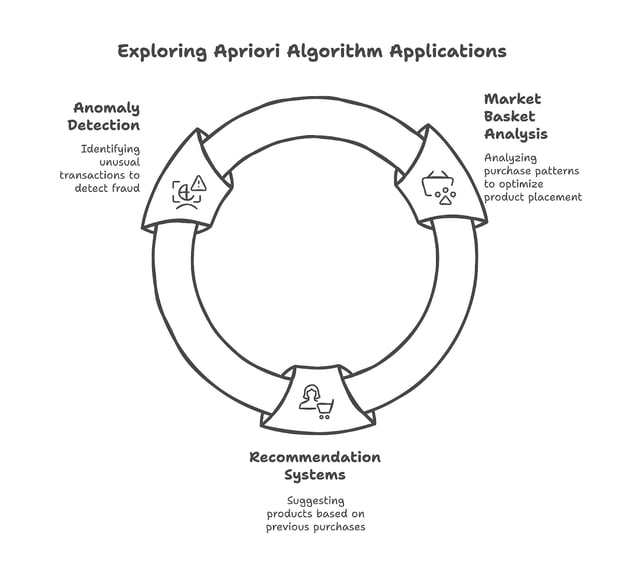
Apriori 算法被广泛应用于解决各类商业问题。以下为主要场景。
篮子分析(Market Basket Analysis)
零售商利用 Apriori 分析购买模式,从而优化商品摆放,促进联动购买。例如,若面包与黄油经常同时出现,商店可能将其放置在相邻位置以提升销量。想进一步了解篮子分析,请参阅我们的 R 语言篮子分析教程。
推荐系统
在线平台会基于既往购买记录使用 Apriori 推荐产品。例如,顾客购入笔记本电脑后,系统可能推荐鼠标或键盘等配件。
异常检测
在欺诈检测中,Apriori 通过与期望模式对比来识别异常交易。如果某笔信用卡交易与既定规则显著偏离,可能会触发安全校验。在异常检测中,虽然 Apriori 并非直接用于识别异常,但它可帮助发现与常见购买模式显著不同的稀有或意外项组合。
优势与局限
使用 Apriori 算法既有优势也有不足,下面将分别说明。
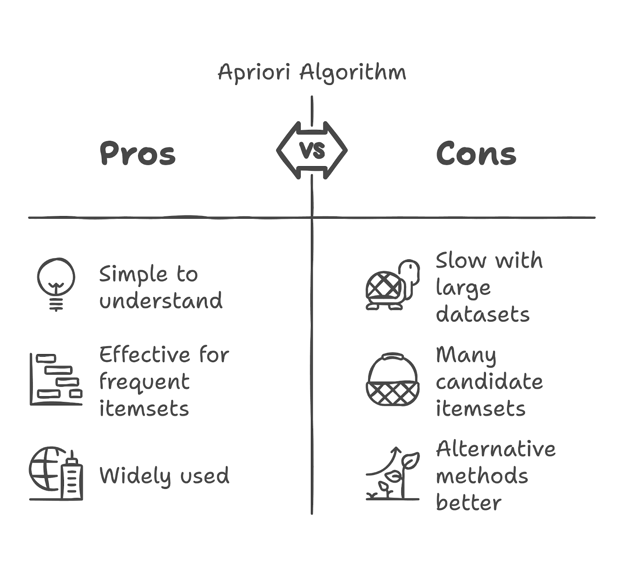
优势
Apriori 易于理解,且在结构化数据集中发现频繁项集方面行之有效。它广泛应用于零售、医疗等行业的模式发现。
局限
由于会生成大量候选项集,该算法在处理大型数据集时运行较慢。在数据量很大时,FP-Growth 等替代方法通常性能更佳。
结论
Apriori 依然是发现数据中关联关系的高实用性技术之一。尽管在计算上存在一定挑战,但它能提供对提升客户体验与增加销售具有价值的洞见。
虽然在大型数据集上并非速度最快的方法,但它仍是数据挖掘、分析与机器学习领域的重要工具。若想进一步学习,请探索 Python 机器学习,并通过我们的 Machine Learning Scientist in Python 职业路径迈向机器学习科学家之路。


为了理解客户行为与购买模式,关联规则挖掘已成为企业不可或缺的工具。该技术用于识别经常被一同购买的商品,帮助企业优化商品陈列、促销策略与推荐系统。此类分析通过清晰揭示交易数据中隐藏的趋势,从而改进业务策略。
Apriori 算法因其简单易懂且效果实用而成为挖掘关联规则的常用方法。与其他复杂方法不同,Apriori 思路直观,既适合初学者,也能在真实业务中取得良好表现。
本文将解释 Apriori 算法,结合清晰示例演示其工作流程,并展示如何高效使用它。如果您想动手实践机器学习概念,欢迎查看我们的 Machine Learning Scientist in Python 职业路径。
什么是 Apriori 算法?
正如您在我们的 Python 关联规则挖掘教程中将会看到,Apriori 是一种用于从交易型数据库中提取频繁项集并生成关联规则的算法。它基于这样一个原理:如果某个项集是频繁的,那么它的所有子集也必须是频繁的。该假设有助于减少需要检查的候选项集数量,从而提升效率。
项集与交易
Apriori 的数据集通常由一笔笔交易构成,每笔交易是一组被同时购买的商品。例如,某超市的销售数据可能包含如下交易:
上述每笔交易都代表一次购买所包含的商品篮。我们的 Python 篮子分析课程 将更详细地介绍该概念在 Python 中的应用。
支持度、置信度与提升度
关联规则挖掘依赖三项关键度量:
支持度:某个商品在数据集中出现的频率。其计算方式为:
置信度:在购买了商品 A 的前提下购买商品 B 的可能性,计算为:
提升度:规则强度,衡量购买 A 时购买 B 的可能性相较于独立购买时提升了多少:
提升度大于 1 表明商品之间存在较强的正相关关系。
Apriori 算法的工作原理
下面我们来看 Apriori 算法如何工作。
分步过程
示例演练
考虑如下交易数据集:
在最小支持度为 50% 的情况下,算法识别出频繁项集,并提取如下规则:
这些规则有助于企业理解购买行为并优化库存管理。
在 Python 中实现 Apriori 算法
本节将介绍如何用 Python 实现 Apriori 算法。
环境配置
要在 Python 中使用 Apriori,请先安装必要的库:
加载与准备数据
接下来加载包并准备数据:
应用 Apriori 算法
然后应用该算法。
接着,获取关联规则:
上述支持度数值(0.5 至 0.6)表明这些关联出现在全部交易的 50%–60% 中。
上述置信度分数(0.71 至 1.0)体现规则的可靠性,其中如 啤酒 → 面包 的置信度为 100%,代表必然关系。
上述提升度数值(约 1.2 至 1.4)表明是中等但有意义的关联,即这些商品对一起出现的频率略高于随机情况。
解读结果
为更好理解 Apriori 生成的关联规则,我们可使用 Matplotlib 进行可视化。散点图有助于考察置信度与提升度的关系,热力图可展示不同项组合的支持度。
散点图有助于识别关联更强的规则,而网络图能直观展示不同商品之间的联系。这些洞见可用于零售决策、推荐系统与欺诈检测。
该散点图展示了所生成关联规则的置信度与提升度之间的关系,主要观察包括:
网络图直观展示了不同商品之间的关联关系:
Apriori 算法的应用
Apriori 算法被广泛应用于解决各类商业问题。以下为主要场景。
篮子分析(Market Basket Analysis)
零售商利用 Apriori 分析购买模式,从而优化商品摆放,促进联动购买。例如,若面包与黄油经常同时出现,商店可能将其放置在相邻位置以提升销量。想进一步了解篮子分析,请参阅我们的 R 语言篮子分析教程。
推荐系统
在线平台会基于既往购买记录使用 Apriori 推荐产品。例如,顾客购入笔记本电脑后,系统可能推荐鼠标或键盘等配件。
异常检测
在欺诈检测中,Apriori 通过与期望模式对比来识别异常交易。如果某笔信用卡交易与既定规则显著偏离,可能会触发安全校验。在异常检测中,虽然 Apriori 并非直接用于识别异常,但它可帮助发现与常见购买模式显著不同的稀有或意外项组合。
优势与局限
使用 Apriori 算法既有优势也有不足,下面将分别说明。
优势
Apriori 易于理解,且在结构化数据集中发现频繁项集方面行之有效。它广泛应用于零售、医疗等行业的模式发现。
局限
由于会生成大量候选项集,该算法在处理大型数据集时运行较慢。在数据量很大时,FP-Growth 等替代方法通常性能更佳。
结论
Apriori 依然是发现数据中关联关系的高实用性技术之一。尽管在计算上存在一定挑战,但它能提供对提升客户体验与增加销售具有价值的洞见。
虽然在大型数据集上并非速度最快的方法,但它仍是数据挖掘、分析与机器学习领域的重要工具。若想进一步学习,请探索 Python 机器学习,并通过我们的 Machine Learning Scientist in Python 职业路径迈向机器学习科学家之路。