{count, plural, one {कोर्स} other {कोर्स}}
बिज़नेस के लिए मशीन लर्निंग
{hours} घंटा
47.8K
एसोसिएशन रूल माइनिंग ग्राहकों के व्यवहार और खरीदारी पैटर्न समझने के लिए व्यवसायों के लिए अनिवार्य हो गई है। यह तकनीक उन वस्तुओं की पहचान करती है जो अक्सर साथ खरीदी जाती हैं, जिससे कंपनियों को उत्पाद प्लेसमेंट, प्रोमोशंस और सिफारिशों को अनुकूलित करने में मदद मिलती है। ऐसा विश्लेषण लेन-देन डेटा में छिपे रुझानों को स्पष्ट रूप से उजागर कर व्यवसायिक रणनीतियों में सुधार करता है।
एप्रियोरी एल्गोरिद्म अपनी सादगी और व्यावहारिक परिणामों के कारण इन एसोसिएशन रूल्स को माइन करने की एक लोकप्रिय विधि है। अन्य जटिल तरीकों के विपरीत, एप्रियोरी सीधा-सादा है, जिससे यह शुरुआती लोगों के लिए उपयुक्त और व्यवहार में प्रभावी बनता है।
यह लेख एप्रियोरी एल्गोरिद्म की व्याख्या करता है, उसके वर्कफ़्लो को स्पष्ट उदाहरणों के साथ दर्शाता है, और इसे प्रभावी ढंग से उपयोग करना सिखाता है। यदि आप मशीन लर्निंग अवधारणाओं पर हाथ आज़माना चाहते हैं, तो हमारा Machine Learning Scientist in Python करियर ट्रैक देखें।
जैसा कि आप हमारे Association Rule Mining in Python Tutorial से जानेंगे, एप्रियोरी एक ऐसा एल्गोरिद्म है जिसे ट्रांज़ैक्शनल डाटाबेस से आवृत्त (frequent) आइटमसेट निकालने और एसोसिएशन रूल्स जेनरेट करने के लिए डिज़ाइन किया गया है। यह सिद्धांत पर आधारित है कि यदि कोई आइटमसेट आवृत्त है, तो उसके सभी सबसेट भी आवृत्त होने चाहिए। यह धारणा संभावित आइटमसेट की संख्या घटाने में मदद करती है जिन्हें जाँचना आवश्यक है, जिससे प्रक्रिया कुशल हो जाती है।
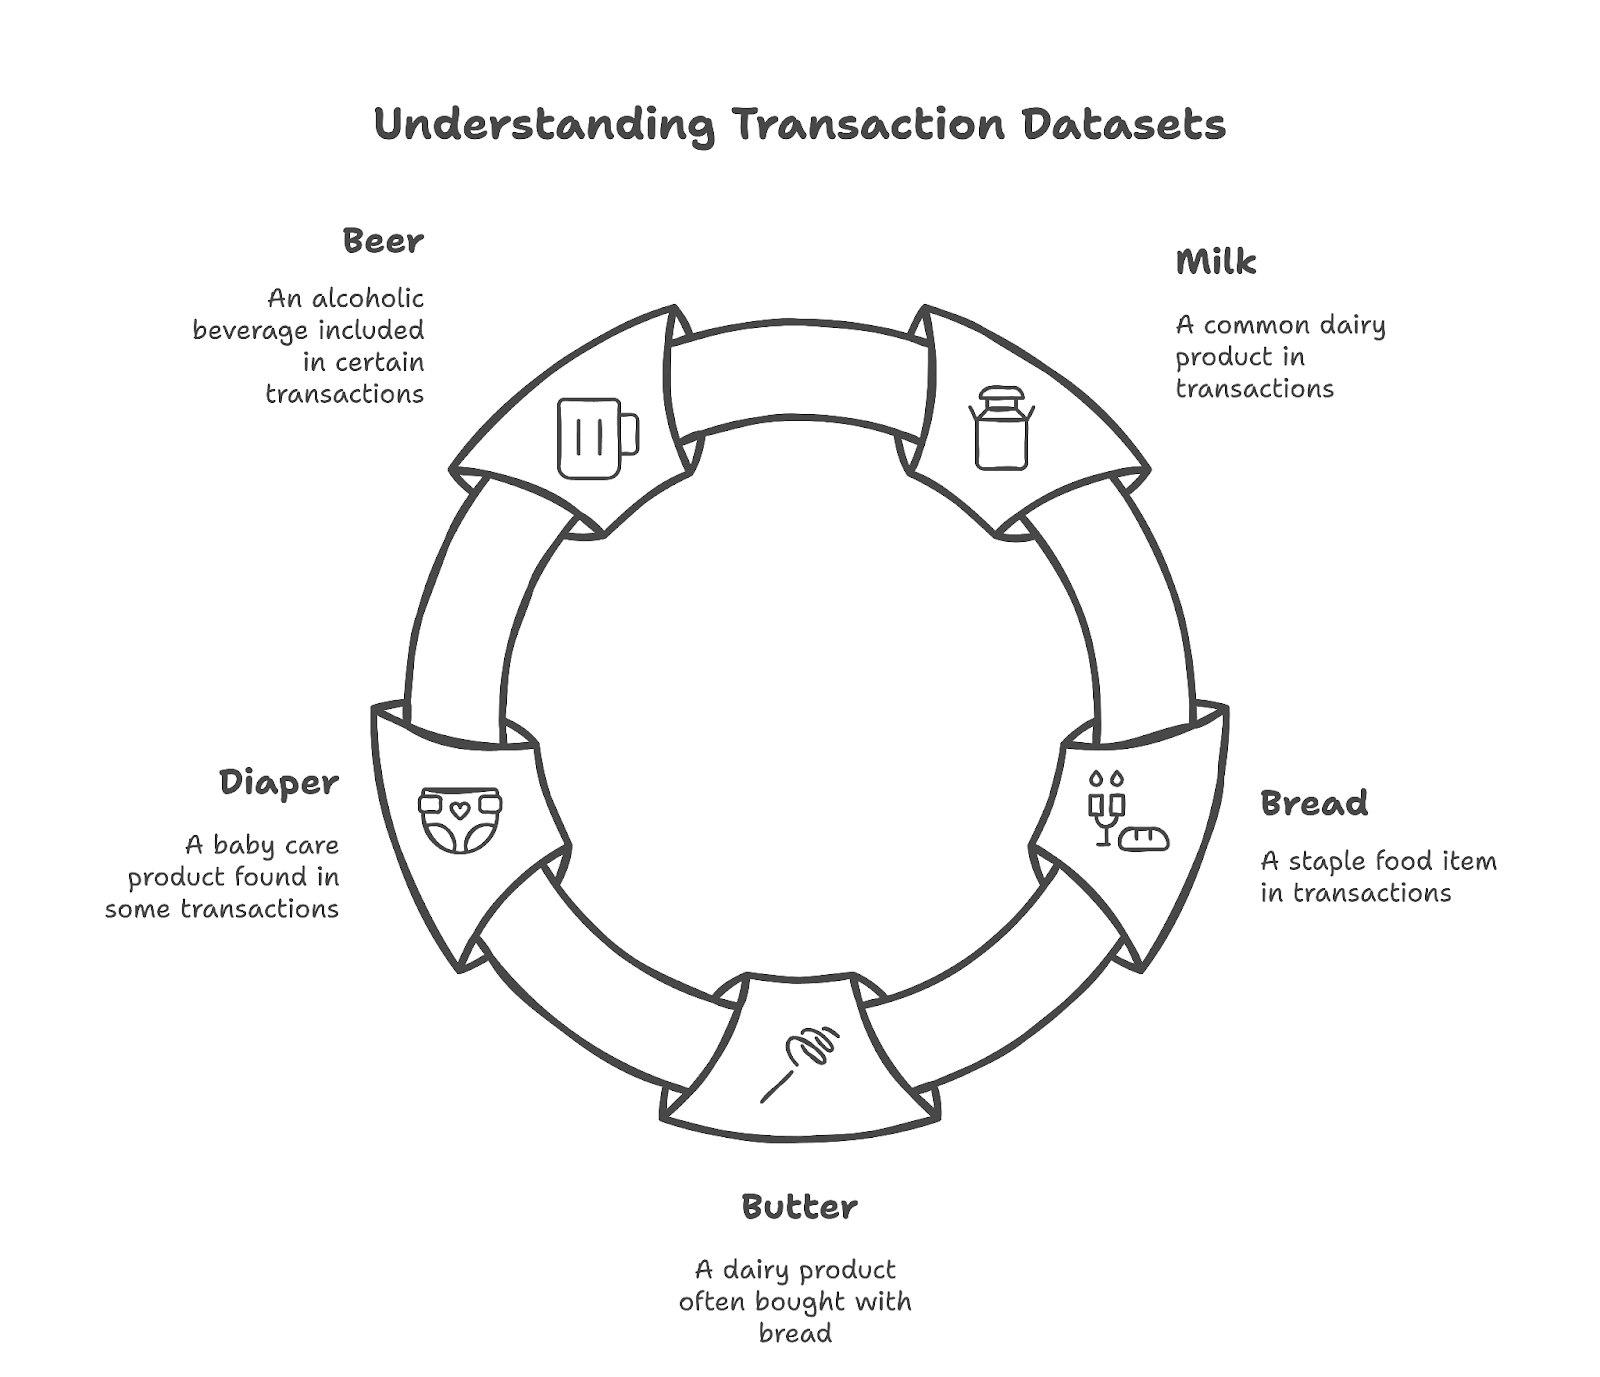
एप्रियोरी के लिए डेटासेट आमतौर पर ट्रांज़ैक्शन से बना होता है, जहाँ प्रत्येक ट्रांज़ैक्शन साथ खरीदी गई वस्तुओं का एक समूह होता है। उदाहरण के लिए, किसी सुपरमार्केट की बिक्री डेटा में निम्न ट्रांज़ैक्शन हो सकते हैं:
इनमें से प्रत्येक ट्रांज़ैक्शन एक ही खरीद में वस्तुओं की टोकरी का प्रतिनिधित्व करता है। हमारा Market Basket Analysis in Python कोर्स इस अवधारणा के पाइथन में अनुप्रयोग पर अधिक विस्तार से बताता है।
एसोसिएशन रूल माइनिंग तीन प्रमुख मीट्रिक पर निर्भर करता है:
Support: वह आवृत्ति जिससे कोई आइटम डेटासेट में दिखाई देता है। इसे इस प्रकार निकाला जाता है:
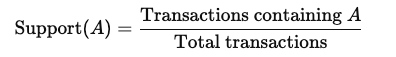
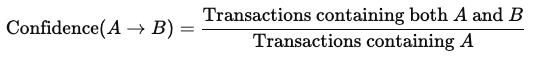
Confidence: जब आइटम A खरीदा जाता है तो आइटम B के खरीदे जाने की संभावना, जिसे इस प्रकार दिया जाता है:
Lift: किसी रूल की ताकत, जो मापती है कि जब आइटम A खरीदा जाता है, तो आइटम B के खरीदे जाने की संभावना स्वतंत्र रूप से खरीदे जाने की तुलना में कितनी अधिक है:
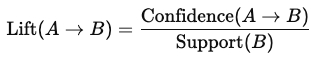
लिफ्ट का मान 1 से अधिक होने पर वस्तुओं के बीच मजबूत सकारात्मक संबंध का संकेत मिलता है।
अब जानें कि एप्रियोरी एल्गोरिद्म कैसे काम करता है।
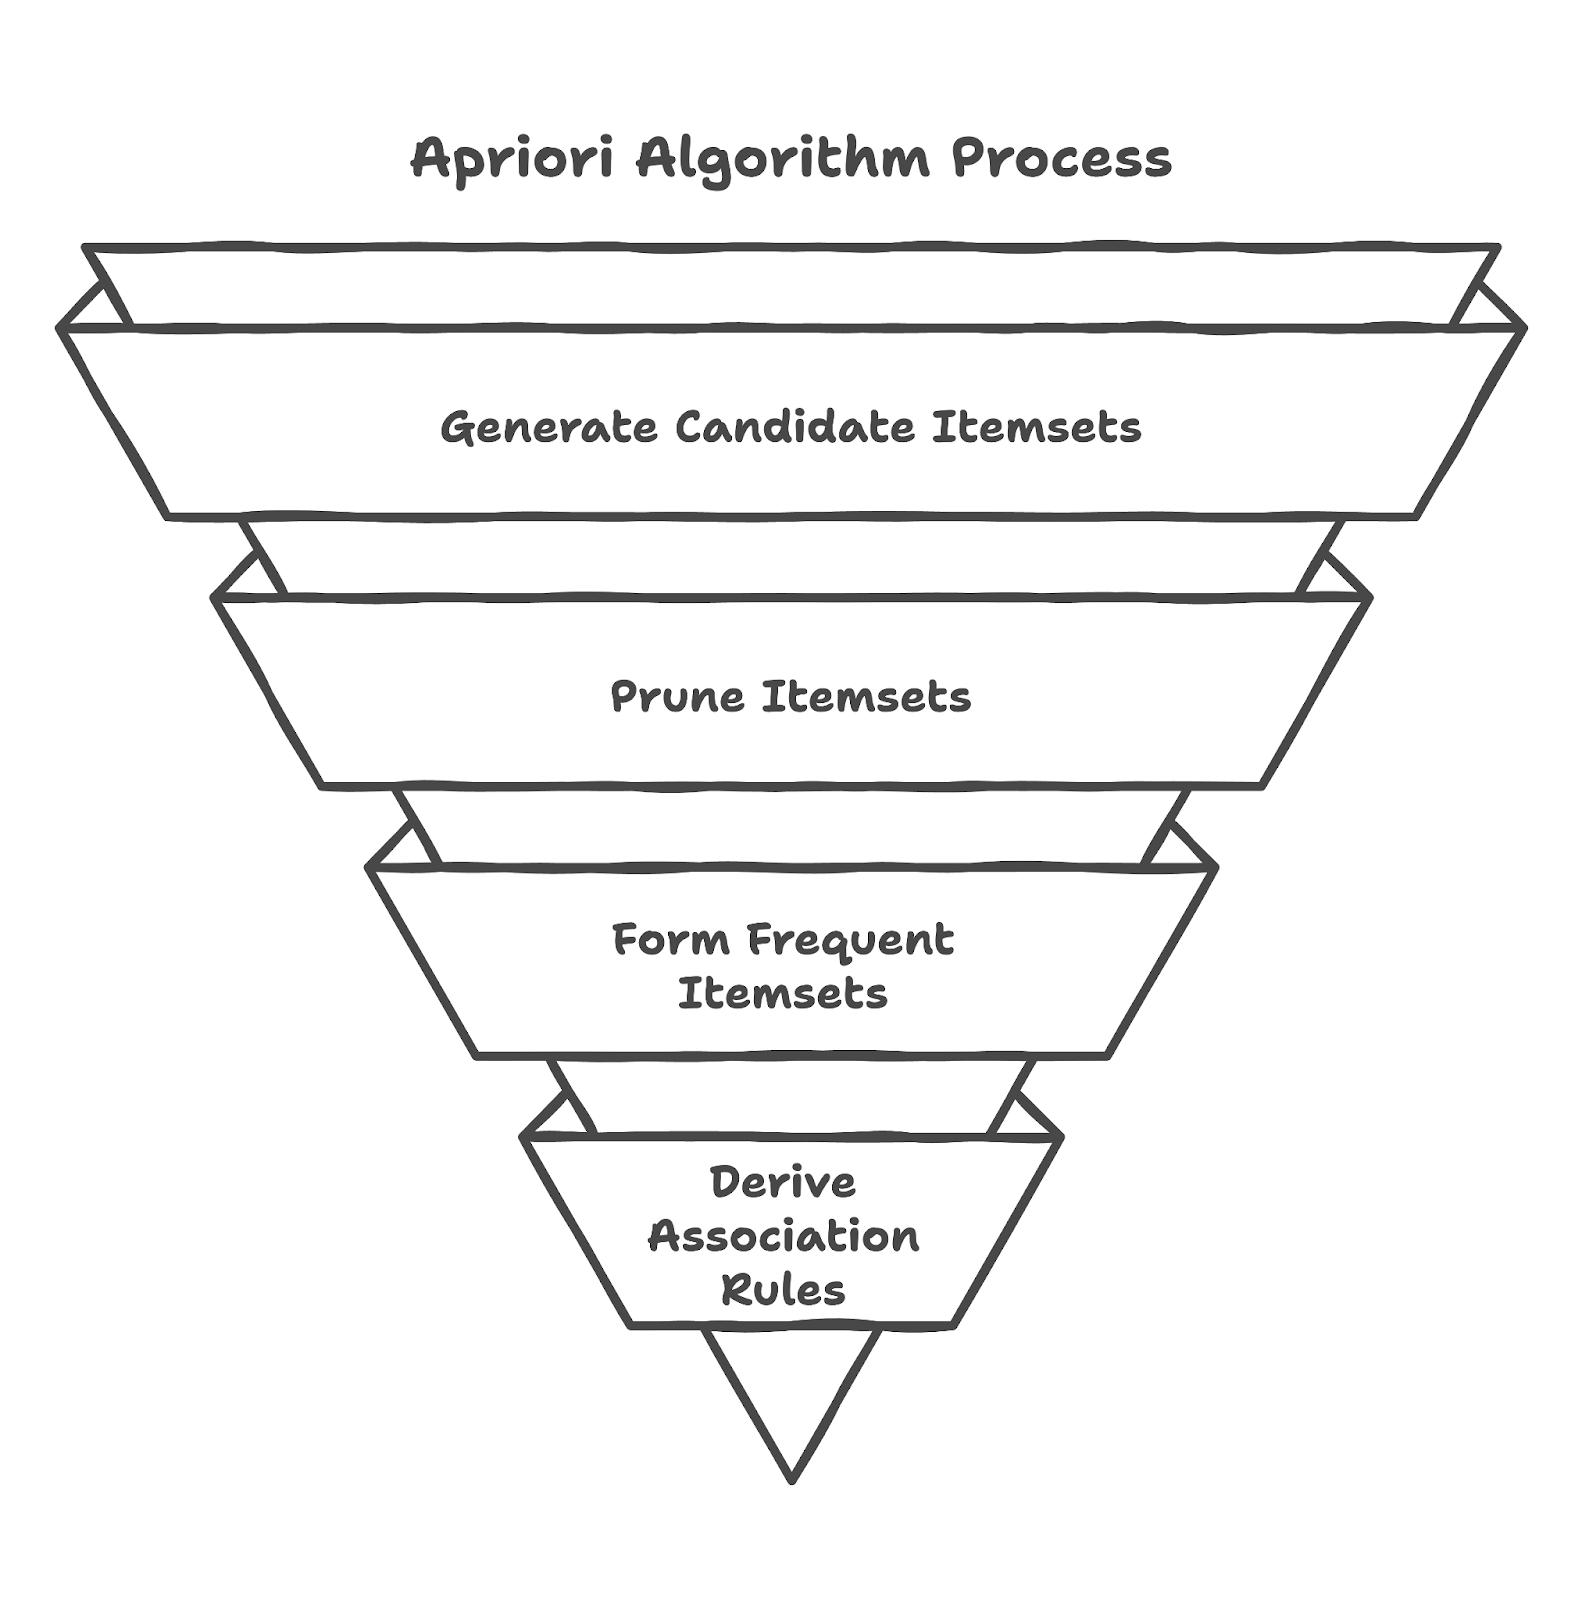
मान लें कि एक डेटासेट में ये ट्रांज़ैक्शन हैं:
50% के न्यूनतम सपोर्ट का उपयोग करते हुए, एल्गोरिद्म आवृत्त आइटमसेट की पहचान करता है और निम्न जैसे रूल निकालता है:
ये रूल व्यवसायों को खरीदारी व्यवहार समझने और अपनी इन्वेंटरी को अनुकूलित करने में मदद करते हैं।
इस खंड में, आप Python में एप्रियोरी एल्गोरिद्म लागू करना सीखेंगे।
Python में एप्रियोरी का उपयोग करने के लिए आवश्यक लाइब्रेरी इंस्टॉल करें:
pip install mlxtend pandasअगला चरण पैकेज लोड करना और डेटा तैयार करना है:
import pandas as pd
from mlxtend.frequent_patterns import apriori, association_rules

# Expanded dataset
data = {
    'Milk': [1, 1, 0, 1, 0, 1, 0, 1, 1, 0],
    'Bread': [1, 0, 1, 1, 1, 0, 1, 0, 1, 1],
    'Butter': [0, 1, 1, 1, 1, 1, 0, 1, 1, 0],
    'Eggs': [1, 0, 0, 1, 1, 1, 1, 0, 0, 1],
    'Cheese': [0, 1, 1, 0, 1, 1, 0, 1, 0, 1],
    'Diaper': [0, 1, 0, 1, 0, 1, 1, 1, 0, 0],
    'Beer': [1, 0, 1, 0, 1, 0, 1, 0, 1, 1]
}
df = pd.DataFrame(data)अब एल्गोरिद्म लागू करें।
# Generating frequent itemsets
frequent_itemsets = apriori(df, min_support=0.5, use_colnames=True)
इसके बाद, हम एसोसिएशन रूल्स प्राप्त करते हैं:
# Generating frequent itemsets
frequent_itemsets = apriori(df, min_support=0.5, use_colnames=True)

# Generating association rules
rules = association_rules(frequent_itemsets, metric='confidence', min_threshold=0.6)
print(rules[['antecedents', 'consequents', 'support', 'confidence', 'lift']])
 antecedents consequents  support  confidence      lift
0    (Butter)      (Milk)      0.5    0.714286  1.190476
1      (Milk)    (Butter)      0.5    0.833333  1.190476
2     (Bread)      (Eggs)      0.5    0.714286  1.190476
3      (Eggs)     (Bread)      0.5    0.833333  1.190476
4     (Bread)      (Beer)      0.6    0.857143  1.428571
5      (Beer)     (Bread)      0.6    1.000000  1.428571
6    (Butter)    (Cheese)      0.5    0.714286  1.190476
7    (Cheese)    (Butter)      0.5    0.833333  1.190476
यहाँ सपोर्ट मान (0.5 से 0.6) दर्शाते हैं कि ये एसोसिएशन सभी ट्रांज़ैक्शन में 50–60% में दिखाई देती हैं।
यहाँ कॉन्फिडेंस स्कोर (0.71 से 1.0) रूल्स की विश्वसनीयता दिखाते हैं, जिनमें Beer → Bread जैसा रूल पूरी तरह निश्चित है (100% कॉन्फिडेंस)।
यहाँ लिफ्ट मान (~1.2 से 1.4) मध्यम लेकिन सार्थक एसोसिएशन का संकेत देते हैं, यानी ये वस्तु-युग्म यादृच्छिक संयोग से कुछ अधिक बार साथ दिखाई देते हैं।
एप्रियोरी एल्गोरिद्म द्वारा उत्पन्न एसोसिएशन रूल्स को बेहतर समझने के लिए हम उन्हें Matplotlib से विज़ुअलाइज़ कर सकते हैं। एक स्कैटर प्लॉट कॉन्फिडेंस बनाम लिफ्ट की जाँच में मदद करता है, जबकि हीटमैप विभिन्न आइटम संयोजनों के सपोर्ट को दिखाता है।
import matplotlib.pyplot as plt
import networkx as nx
# Scatter plot of confidence vs lift
plt.figure(figsize=(8,6))
plt.scatter(rules['confidence'], rules['lift'], alpha=0.7, color='b')
plt.xlabel('Confidence')
plt.ylabel('Lift')
plt.title('Confidence vs Lift in Association Rules')
plt.grid()
plt.show()
# Visualizing association rules as a network graph
G = nx.DiGraph()
for _, row in rules.iterrows():
    G.add_edge(tuple(row['antecedents']), tuple(row['consequents']), weight=row['confidence'])
plt.figure(figsize=(10, 6))
pos = nx.spring_layout(G)
nx.draw(G, pos, with_labels=True, node_color='lightblue', edge_color='gray', node_size=3000, font_size=10)
edge_labels = {(tuple(row['antecedents']), tuple(row['consequents'])): f"{row['confidence']:.2f}"
               for _, row in rules.iterrows()}
nx.draw_networkx_edge_labels(G, pos, edge_labels=edge_labels)

plt.title("Association Rules Network")
plt.show()
स्कैटर प्लॉट मज़बूत संबंधों वाले रूल्स की पहचान में मदद करता है, जबकि नेटवर्क ग्राफ विभिन्न वस्तुओं के बीच के संबंधों को दृश्य रूप से दर्शाता है। ये इनसाइट्स रिटेल, रिकमेंडेशंस और फ्रॉड डिटेक्शन में निर्णय-निर्माण का मार्गदर्शन करती हैं।
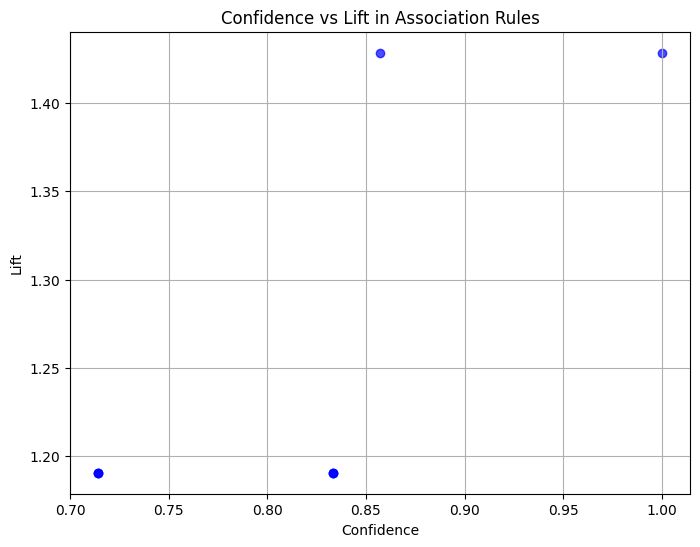
स्कैटर प्लॉट जनरेट किए गए एसोसिएशन रूल्स के लिए कॉन्फिडेंस और लिफ्ट के बीच संबंध दिखाता है। प्रमुख अवलोकन इस प्रकार हैं:
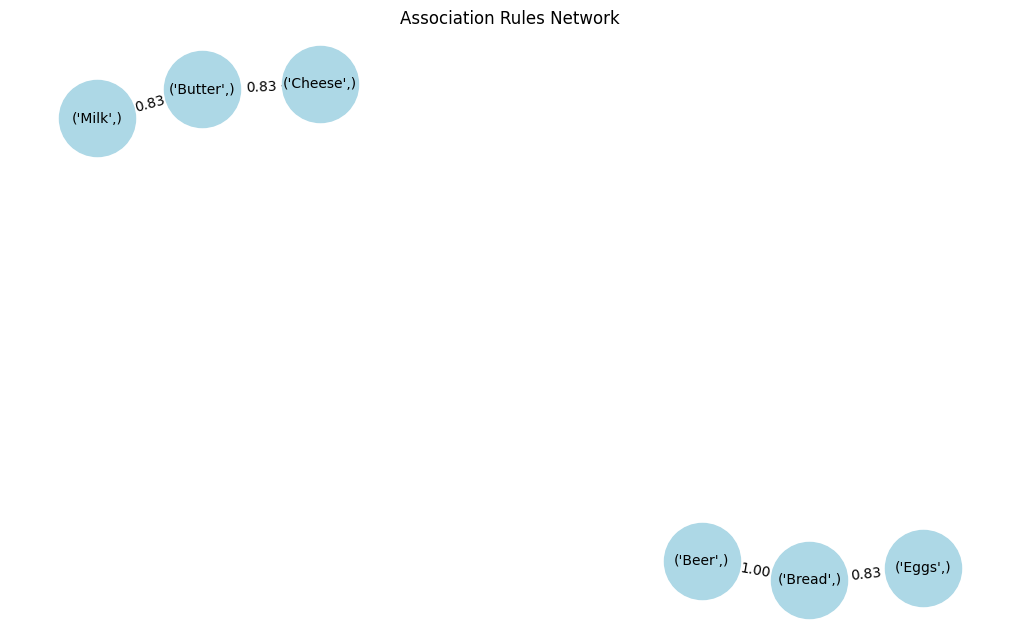
नेटवर्क ग्राफ विभिन्न वस्तुओं के बीच के एसोसिएशन को दृश्य रूप में दर्शाता है:
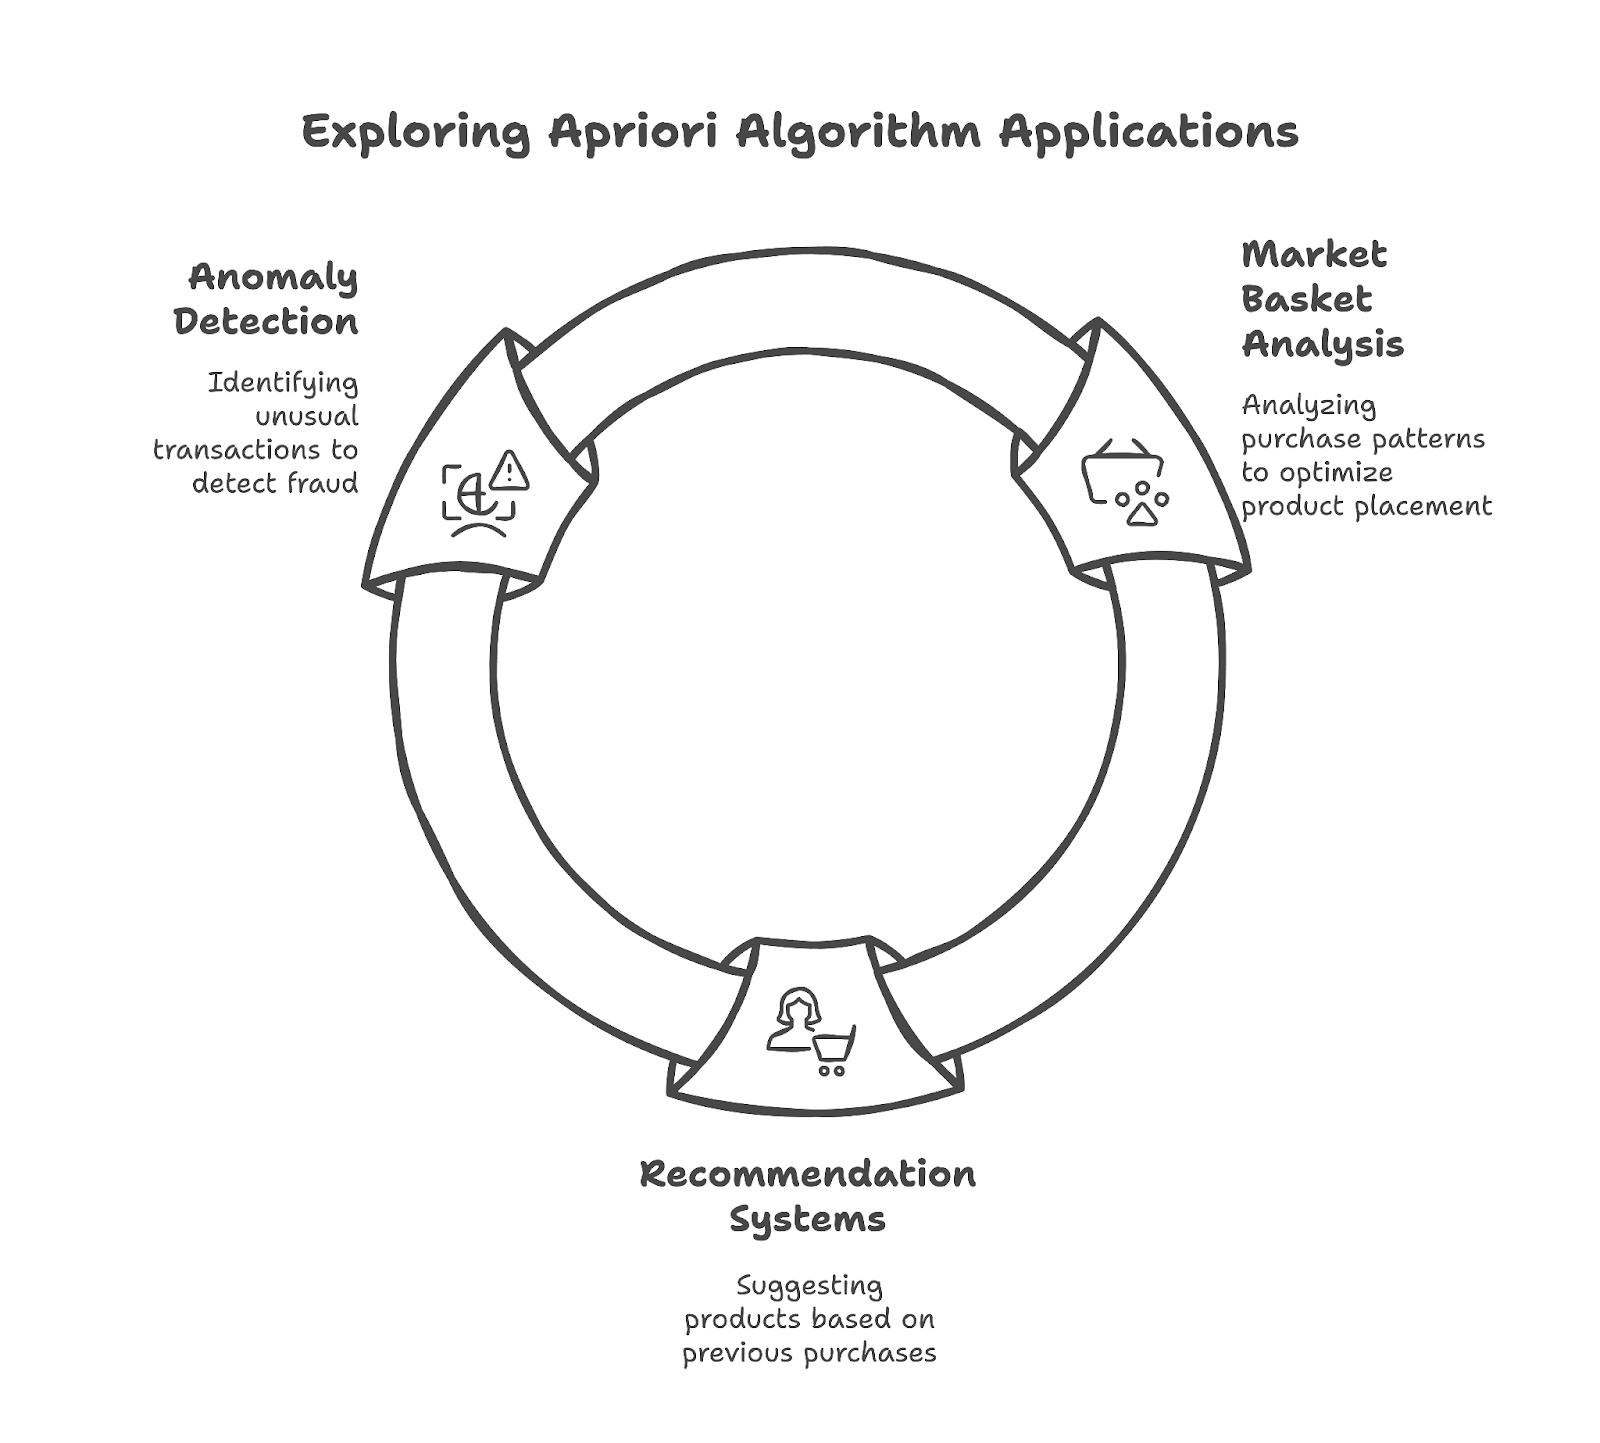
व्यवसाय एप्रियोरी एल्गोरिद्म का व्यापक रूप से विभिन्न समस्याएँ सुलझाने में उपयोग करते हैं। आइए इन्हें नीचे जानें।
रिटेलर एप्रियोरी का उपयोग खरीद पैटर्न का विश्लेषण करने में करते हैं, जिससे वे संयुक्त खरीद को प्रोत्साहित करने हेतु उत्पादों की व्यवस्था कर सकें। उदाहरण के लिए, यदि ब्रेड और बटर अक्सर साथ दिखाई देते हैं, तो स्टोर उन्हें पास-पास रख सकता है ताकि बिक्री बढ़े। मार्केट बास्केट विश्लेषण के बारे में अधिक जानें हमारे market basket analysis using R ट्यूटोरियल से।
ऑनलाइन प्लेटफ़ॉर्म पूर्व खरीद के आधार पर उत्पाद सुझाने के लिए एप्रियोरी का उपयोग करते हैं। यदि कोई ग्राहक लैपटॉप खरीदता है, तो सिफारिशों में माउस या कीबोर्ड जैसे एक्सेसरीज़ शामिल हो सकते हैं।
फ्रॉड डिटेक्शन में, एप्रियोरी अपेक्षित पैटर्न की तुलना कर असामान्य ट्रांज़ैक्शन की पहचान करता है। यदि कोई क्रेडिट कार्ड ट्रांज़ैक्शन स्थापित रूल्स से काफी भिन्न है, तो सुरक्षा जाँच ट्रिगर हो सकती है। एनोमली डिटेक्शन में, भले एप्रियोरी सीधे एनोमली की पहचान न करे, यह दुर्लभ या अप्रत्याशित आइटम संयोजनों का पता लगाने में मदद कर सकता है जो सामान्य खरीद पैटर्न से काफ़ी अलग होते हैं।
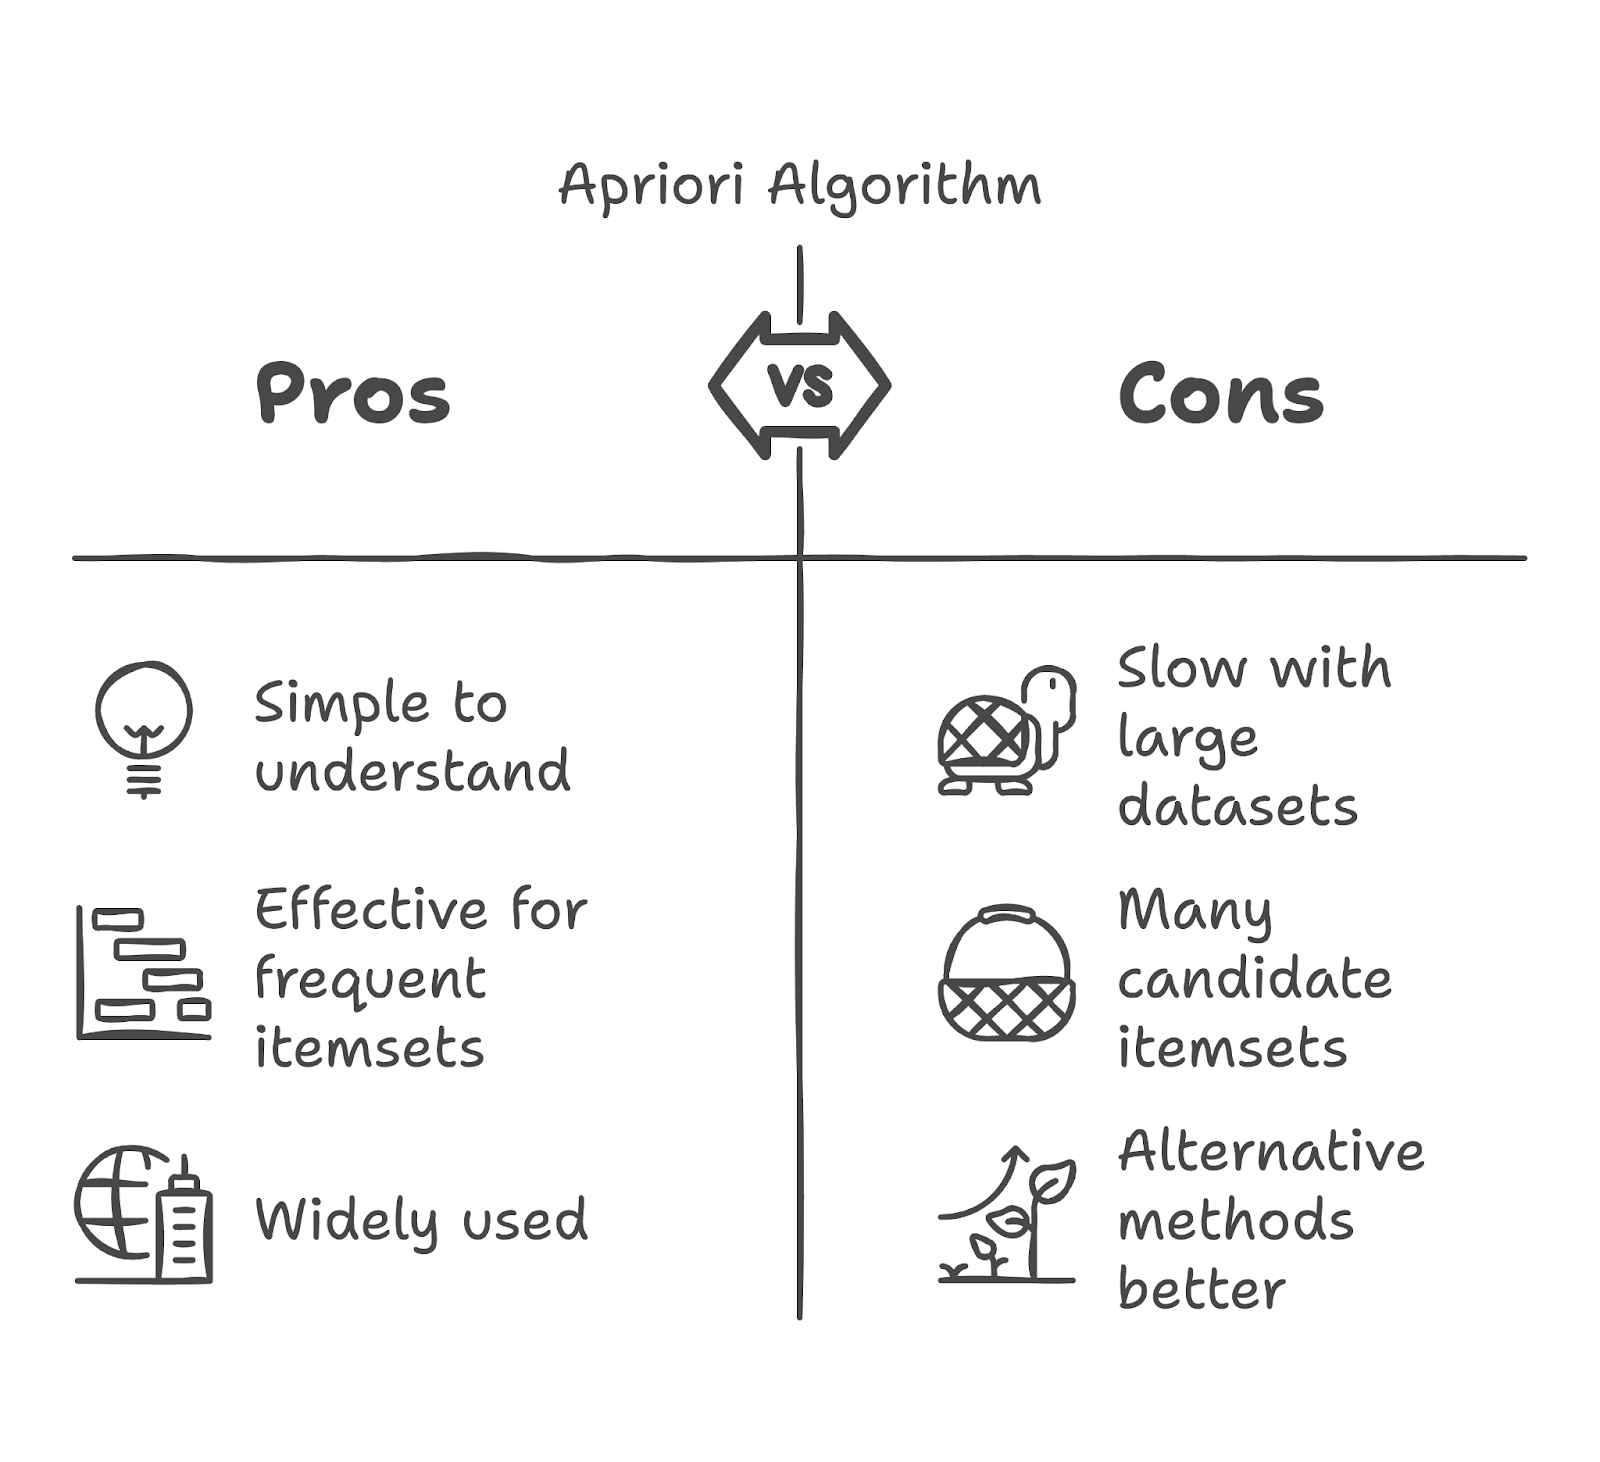
एप्रियोरी एल्गोरिद्म के कई लाभ और हानियाँ हैं, जैसा कि आप नीचे जानेंगे।
एप्रियोरी समझने में सरल है और संरचित डेटासेट्स में आवृत्त आइटमसेट खोजने में प्रभावी है। यह रिटेल और हेल्थकेयर जैसी इंडस्ट्रीज़ में पैटर्न खोजने के लिए व्यापक रूप से उपयोग होता है।
एल्गोरिद्म बड़े डेटासेट के साथ काम करते समय धीमा हो जाता है क्योंकि यह कई उम्मीदवार आइटमसेट जनरेट करता है। उच्च डेटा वॉल्यूम के मामलों में, FP-Growth जैसी वैकल्पिक विधियाँ बेहतर प्रदर्शन देती हैं।
एप्रियोरी डेटा में एसोसिएशन खोजने की सबसे उपयोगी तकनीकों में बना हुआ है। कम्प्यूटेशनल चुनौतियों के बावजूद, यह मूल्यवान इनसाइट्स देता है जिनका उपयोग व्यवसाय ग्राहक अनुभव सुधारने और बिक्री बढ़ाने में करते हैं।
हालाँकि बड़े डेटासेट के लिए यह सबसे तेज़ तरीका नहीं है, फिर भी यह डेटा माइनिंग, एनालिटिक्स और मशीन लर्निंग के क्षेत्र में एक आवश्यक टूल बना रहता है। और जानने के लिए, Python के साथ मशीन लर्निंग का अन्वेषण करें और हमारे Machine Learning Scientist in Python करियर ट्रैक की ओर बढ़ें।
शीर्ष DataCamp कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}