GLM 4.7 Flash 正在迅速成为本地“代理式”编码的热门选择。许多开发者会将其与 llama.cpp 和 LM Studio 等工具配合使用。不过,仍有不少人在安装配置、让模型正确运行以及确保工具调用按预期工作等方面遇到问题。
本教程聚焦于用 Claude Code 搭配 Ollama 在本地运行 GLM 4.7 Flash 的最简单且最可靠的方法。目标是减少阻力,帮助您在不增加不必要复杂性的情况下完成可用的配置。
本指南适用于所有操作系统——无论您使用 Linux、Windows,还是 macOS。完成后,您将能在本地运行 GLM 4.7 Flash,并通过 Ollama 正确集成至 Claude Code。
先决条件
开始之前,请确保您的系统满足以下最低软硬件要求。
硬件:
- 至少 16 GB 显存的 NVIDIA GPU
- 建议 24 GB 显存,以在更大上下文下获得更流畅的推理
- 16–32 GB 系统内存
- 至少 25 GB 可用磁盘空间
如果没有 GPU,模型也可以在 CPU 上运行,但性能会明显变慢,且需要较高的内存。
软件:
- 推荐 Linux 或 macOS。Windows 用户请使用启用 GPU 直通的 WSL2。
- 必须安装与 CUDA 版本兼容的 NVIDIA GPU 驱动
- 安装 CUDA Toolkit 13.1
- 若缺少或不兼容 CUDA/驱动,Ollama 通常会回退到 CPU 模式,速度会慢得多。
如果缺少或不兼容 CUDA 工具包或 NVIDIA 驱动,Ollama 将回退到 CPU 模式,速度明显更慢。
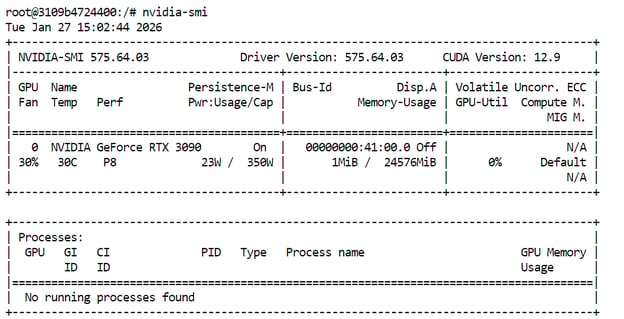
要验证您的 GPU 和 CUDA 驱动是否正确安装,请在终端运行以下命令:
nvidia-smi技术支持
若一切就绪,您应能看到 GPU 型号、可用显存以及 CUDA 版本等信息。
1. 安装 Ollama
Ollama 是我们用于在本地运行 GLM 4.7 Flash 并以 Claude Code 能可靠交互的方式对外暴露的运行时。其在各平台上的安装都很简单。
在 Linux 上,您可以用一条命令安装 Ollama:
curl -fsSL https://ollama.com/install.sh | sh技术支持
在 macOS 和 Windows 上,请直接从 Ollama 官网下载安装程序,并按屏幕指引操作。
来源: Ollama
Ollama 作为后台服务运行,并会自动检查更新。当有可用更新时,您可在 Ollama 菜单中选择“重启以更新”。
安装完成后,打开终端检查 Ollama 是否安装成功:
ollama -v技术支持
您应会看到类似以下的输出:
ollama version is 0.15.2技术支持
如果运行 ollama -v 报错,通常表示 Ollama 服务尚未启动。请手动启动 Ollama 服务器:
ollama serve技术支持
保持该进程运行,另开一个新的终端窗口,然后执行:
ollama -v技术支持
当版本命令可以正常输出后,Ollama 已就绪,可进入下一步教程。
2. 拉取并运行 GLM-4.7-Flash
安装并启动 Ollama 后,下一步是下载 GLM 4.7 Flash 模型并验证其是否正常工作。此步骤可确保在与 Claude Code 集成前,模型已在本地成功运行。
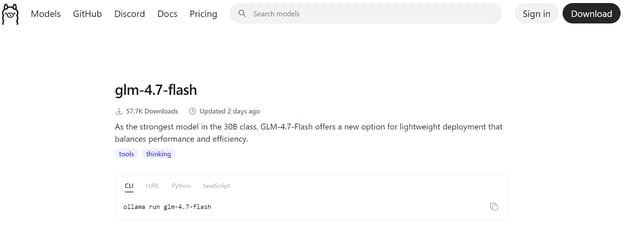
来源: glm-4.7-flash
首先从 Ollama 的注册库下载模型:
ollama pull glm-4.7-flash技术支持
这将下载模型文件并保存在本地。下载时长取决于您的网络速度,可能需要几分钟。

下载完成后,以交互式聊天模式运行模型,做一次快速健全性检查:
ollama run glm-4.7-flash技术支持
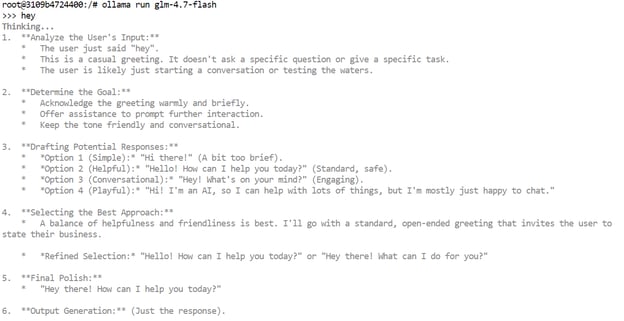
输入一个简单提示(如问候语)并回车。几秒内您应能收到回复。
如果您在 GPU 上运行,将会发现响应非常快;根据模型配置,输出中可能包含内部思考标记或推理踪迹。
您也可以通过 Ollama 的本地 HTTP API 测试模型。这有助于确认外部工具能与模型通信。
运行以下命令:
curl http://localhost:11434/api/chat -d '{
  "model": "glm-4.7-flash",
  "messages": [{"role":"user","content":"Hello!"}]
}'技术支持
3. 设置上下文长度
Claude Code 以及大多数代理式编码工具在较大的上下文窗口(常达 64k tokens)下效果最佳。然而,对于 GLM 4.7 Flash,合理选择上下文长度对性能与稳定性都很重要。
使用非常大的上下文会显著降低生成速度。实际中,吞吐量可能从每秒 100+ tokens 降至每秒 2 个 tokens。某些情况下,如果上下文设置过高,模型还可能陷入长时间的思考循环。
我们测试了多种上下文大小,发现 10k 对 Claude Code 的工作流并不够用;20k 则在二者间取得了良好平衡——既足以支持编码任务,又能保持快速响应,并减少不必要的思考循环。
首先,停止正在运行的 Ollama 服务器。您可以在终端中按 Ctrl + C 或结束该进程。
接着,在启动服务器前通过设置环境变量,以自定义的上下文长度重启 Ollama:
OLLAMA_CONTEXT_LENGTH=20000 ollama serve技术支持
这会让 Ollama 以最多 20,000 个 token 的上下文窗口加载模型。
在新的终端窗口中运行:
ollama ps技术支持
这可确认 GLM 4.7 Flash 正在 GPU 上运行,且上下文长度设置无误。至此,模型已为与 Claude Code 的稳定高速配合做好配置。
NAME                    ID              SIZE     PROCESSOR    CONTEXT    UNTIL
glm-4.7-flash:latest    d1a8a26252f1    21 GB    100% GPU     20000      About a minute from now 技术支持
4. 安装 Claude Code
Claude Code 是 Anthropic 推出的基于终端的编码代理,可用自然语言帮助您编写、编辑、重构并理解代码。它为代理式工作流而生,能直接在命令行处理多步编码任务。
与 Ollama 结合后,Claude Code 可轻松搭配 GLM 4.7 Flash 等本地模型,让一切在本地运行、代码留在您的机器上。
在 macOS、Linux 或使用 WSL 的 Windows 上,使用官方安装脚本安装 Claude Code:
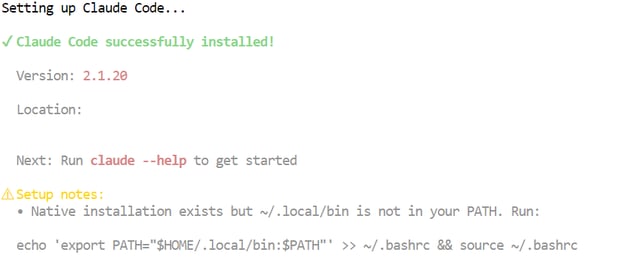
curl -fsSL https://claude.ai/install.sh | bash技术支持
该命令会下载并安装 Claude Code 及所需依赖。安装完成后,claude 命令即可在终端中使用。
5. 将 Claude Code 连接到 Ollama
现在已安装好 Ollama 与 Claude Code,下一步是将 Claude Code 连接到本地 Ollama 服务器,并配置其使用 GLM 4.7 Flash 模型。
先为项目创建一个工作目录。Claude Code 将在此目录中运行并管理文件:
mkdir <project-name>
cd <project-name>技术支持
Ollama 现已提供内置方式来启动 Claude Code,并自动配置其与本地 Ollama 运行时通信。这是推荐且最可靠的做法。
通过 Ollama 以交互方式启动 Claude Code:
ollama launch claude技术支持
若要直接使用 GLM 4.7 Flash 模型启动 Claude Code,运行:
ollama launch claude --model glm-4.7-flash技术支持
这可确保 Claude Code 使用本地的 GLM 4.7 Flash 模型,而非远程或默认模型。
一切就绪后,您将在终端中看到 Claude Code 的界面。
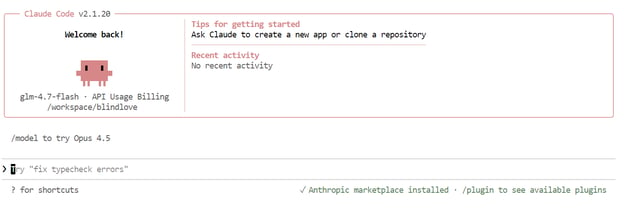
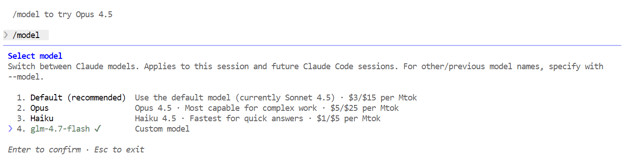
在 Claude Code 内,使用以下命令确认其正在使用本地模型:
/model技术支持
如果输出显示 glm-4.7-flash,说明已配置完成,Claude Code 成功运行在您的本地 Ollama 模型之上。
7. 在 Ollama 中使用 Claude Code
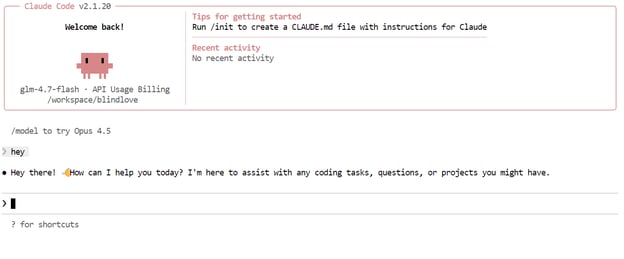
配置完成后,您即可开始使用由本地 GLM 4.7 Flash 模型驱动的 Claude Code。首先尝试一个简单的问候。通常一两秒内即可收到回复;若在 GPU 上运行,速度会尤为明显。
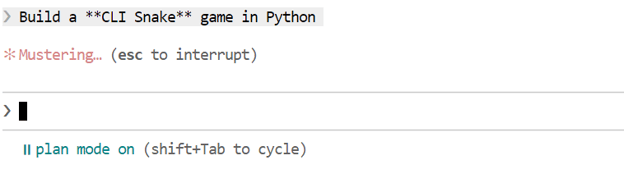
接下来尝试一个更贴近实战的编码任务:让 Claude Code 用 Python 构建一个 CLI 版贪吃蛇游戏。在生成代码前,先切换到规划模式,让模型先概述方案。您可以按 Shift + Tab 两次切换规划模式。
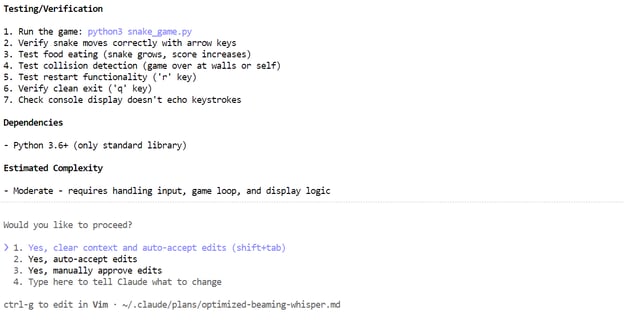
 生成方案后,请先审阅;若思路可行,再让 Claude Code 执行该方案。
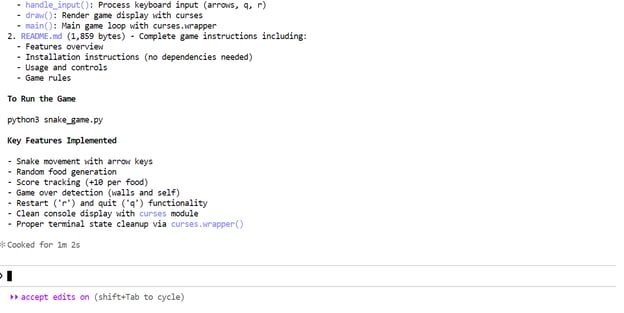
 几分钟内,它就会创建所需文件,解释贪吃蛇游戏的功能,并提供清晰的运行指南。
 打开新的终端窗口,确保在同一项目目录中。然后用以下命令启动游戏:
python3 snake_game.py技术支持
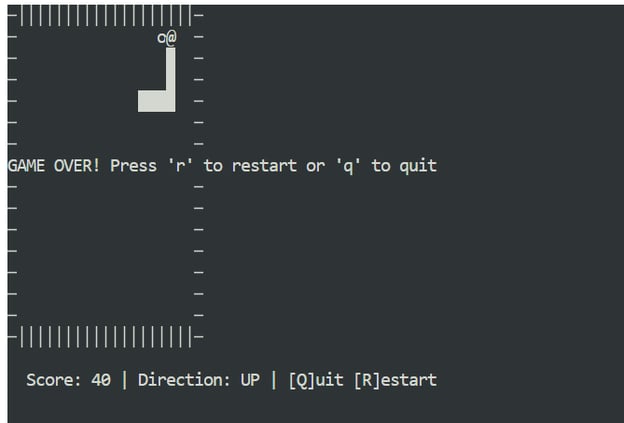
游戏开箱即用,无需额外配置。它是一个简单的终端版贪吃蛇,与经典的诺基亚 3310 版本颇为相似。虽简单,却很好地展示了用 Claude Code 与 Ollama 进行本地代理式编码的速度与效率。
结语
在 Ollama 上用 GLM 4.7 Flash 运行 Claude Code 展示了本地代理式编码的长足进步。您可以获得快速响应、强大的代码生成能力,并完全掌控数据,无需依赖云端模型。
配置完成后,即便是多步编码任务,整个流程也丝滑可靠。
一个重要的体会是,更大的上下文窗口和更复杂的设置并不总是更好。采用合理默认值,整个配置过程约需五分钟(不含模型下载时间,后者取决于您的网络)。
如果您已下载好该模型的 GGUF 文件,配置会更快。此时可完全跳过模型下载,只需通过创建一个 Modelfile 将现有 GGUF 文件注册到 Ollama。
这样您可以一次性定义生成参数,并在不同运行与工具间一致复用该模型。
在与 GGUF 文件同一目录下创建名为 Modelfile 的文件:
FROM ./glm-4.7-flash.gguf

PARAMETER temperature 0.8
PARAMETER top_p 0.95
PARAMETER repeat_penalty 1.0技术支持
您可以按需调整以下参数:
- Temperature:0.7 到 1.0
- Top-p:0.95 到 1.0
- Repeat penalty:禁用或设为 1.0
将模型注册到 Ollama:
ollama create glm-4.7-flash-local -f Modelfile技术支持
模型创建后,您可以直接以聊天模式运行:
ollama run glm-4.7-flash-local技术支持
现在,该模型可像其他 Ollama 模型一样使用,并可无缝集成到 Claude Code 中。
我曾在 Claude Code 中用 GLM 4.7 Flash 构建应用与游戏,过程非常有趣。在无网络或网络不稳定的偏远环境下工作,依然能掌控全局、稳定运行,并手握强大的编码代理——这种掌控感与独立性难以替代。
如果您想进一步了解本文涉及的工具,推荐阅读以下资源:


GLM 4.7 Flash 正在迅速成为本地“代理式”编码的热门选择。许多开发者会将其与 llama.cpp 和 LM Studio 等工具配合使用。不过,仍有不少人在安装配置、让模型正确运行以及确保工具调用按预期工作等方面遇到问题。
本教程聚焦于用 Claude Code 搭配 Ollama 在本地运行 GLM 4.7 Flash 的最简单且最可靠的方法。目标是减少阻力,帮助您在不增加不必要复杂性的情况下完成可用的配置。
本指南适用于所有操作系统——无论您使用 Linux、Windows,还是 macOS。完成后,您将能在本地运行 GLM 4.7 Flash,并通过 Ollama 正确集成至 Claude Code。
先决条件
开始之前,请确保您的系统满足以下最低软硬件要求。
硬件:
如果没有 GPU,模型也可以在 CPU 上运行,但性能会明显变慢,且需要较高的内存。
软件:
如果缺少或不兼容 CUDA 工具包或 NVIDIA 驱动,Ollama 将回退到 CPU 模式,速度明显更慢。
要验证您的 GPU 和 CUDA 驱动是否正确安装,请在终端运行以下命令:
若一切就绪,您应能看到 GPU 型号、可用显存以及 CUDA 版本等信息。
1. 安装 Ollama
Ollama 是我们用于在本地运行 GLM 4.7 Flash 并以 Claude Code 能可靠交互的方式对外暴露的运行时。其在各平台上的安装都很简单。
在 Linux 上,您可以用一条命令安装 Ollama:
在 macOS 和 Windows 上,请直接从 Ollama 官网下载安装程序,并按屏幕指引操作。
来源: Ollama
Ollama 作为后台服务运行,并会自动检查更新。当有可用更新时,您可在 Ollama 菜单中选择“重启以更新”。
安装完成后,打开终端检查 Ollama 是否安装成功:
您应会看到类似以下的输出:
如果运行
ollama -v报错,通常表示 Ollama 服务尚未启动。请手动启动 Ollama 服务器:保持该进程运行,另开一个新的终端窗口,然后执行:
当版本命令可以正常输出后,Ollama 已就绪,可进入下一步教程。
2. 拉取并运行 GLM-4.7-Flash
安装并启动 Ollama 后,下一步是下载 GLM 4.7 Flash 模型并验证其是否正常工作。此步骤可确保在与 Claude Code 集成前,模型已在本地成功运行。
来源: glm-4.7-flash
首先从 Ollama 的注册库下载模型:
这将下载模型文件并保存在本地。下载时长取决于您的网络速度,可能需要几分钟。
下载完成后,以交互式聊天模式运行模型,做一次快速健全性检查:
输入一个简单提示(如问候语)并回车。几秒内您应能收到回复。
如果您在 GPU 上运行,将会发现响应非常快;根据模型配置,输出中可能包含内部思考标记或推理踪迹。
您也可以通过 Ollama 的本地 HTTP API 测试模型。这有助于确认外部工具能与模型通信。
运行以下命令:
3. 设置上下文长度
Claude Code 以及大多数代理式编码工具在较大的上下文窗口(常达 64k tokens)下效果最佳。然而,对于 GLM 4.7 Flash,合理选择上下文长度对性能与稳定性都很重要。
使用非常大的上下文会显著降低生成速度。实际中,吞吐量可能从每秒 100+ tokens 降至每秒 2 个 tokens。某些情况下,如果上下文设置过高,模型还可能陷入长时间的思考循环。
我们测试了多种上下文大小,发现 10k 对 Claude Code 的工作流并不够用;20k 则在二者间取得了良好平衡——既足以支持编码任务,又能保持快速响应,并减少不必要的思考循环。
首先,停止正在运行的 Ollama 服务器。您可以在终端中按
Ctrl + C或结束该进程。接着,在启动服务器前通过设置环境变量,以自定义的上下文长度重启 Ollama:
这会让 Ollama 以最多 20,000 个 token 的上下文窗口加载模型。
在新的终端窗口中运行:
这可确认 GLM 4.7 Flash 正在 GPU 上运行,且上下文长度设置无误。至此,模型已为与 Claude Code 的稳定高速配合做好配置。
4. 安装 Claude Code
Claude Code 是 Anthropic 推出的基于终端的编码代理,可用自然语言帮助您编写、编辑、重构并理解代码。它为代理式工作流而生,能直接在命令行处理多步编码任务。
与 Ollama 结合后,Claude Code 可轻松搭配 GLM 4.7 Flash 等本地模型,让一切在本地运行、代码留在您的机器上。
在 macOS、Linux 或使用 WSL 的 Windows 上,使用官方安装脚本安装 Claude Code:
该命令会下载并安装 Claude Code 及所需依赖。安装完成后,
claude命令即可在终端中使用。5. 将 Claude Code 连接到 Ollama
现在已安装好 Ollama 与 Claude Code,下一步是将 Claude Code 连接到本地 Ollama 服务器,并配置其使用 GLM 4.7 Flash 模型。
先为项目创建一个工作目录。Claude Code 将在此目录中运行并管理文件:
Ollama 现已提供内置方式来启动 Claude Code,并自动配置其与本地 Ollama 运行时通信。这是推荐且最可靠的做法。
通过 Ollama 以交互方式启动 Claude Code:
若要直接使用 GLM 4.7 Flash 模型启动 Claude Code,运行:
这可确保 Claude Code 使用本地的 GLM 4.7 Flash 模型,而非远程或默认模型。
一切就绪后,您将在终端中看到 Claude Code 的界面。
在 Claude Code 内,使用以下命令确认其正在使用本地模型:
如果输出显示
glm-4.7-flash,说明已配置完成,Claude Code 成功运行在您的本地 Ollama 模型之上。7. 在 Ollama 中使用 Claude Code
配置完成后,您即可开始使用由本地 GLM 4.7 Flash 模型驱动的 Claude Code。首先尝试一个简单的问候。通常一两秒内即可收到回复;若在 GPU 上运行,速度会尤为明显。
接下来尝试一个更贴近实战的编码任务:让 Claude Code 用 Python 构建一个 CLI 版贪吃蛇游戏。在生成代码前,先切换到规划模式,让模型先概述方案。您可以按 Shift + Tab 两次切换规划模式。
游戏开箱即用,无需额外配置。它是一个简单的终端版贪吃蛇,与经典的诺基亚 3310 版本颇为相似。虽简单,却很好地展示了用 Claude Code 与 Ollama 进行本地代理式编码的速度与效率。
结语
在 Ollama 上用 GLM 4.7 Flash 运行 Claude Code 展示了本地代理式编码的长足进步。您可以获得快速响应、强大的代码生成能力,并完全掌控数据,无需依赖云端模型。
配置完成后,即便是多步编码任务,整个流程也丝滑可靠。
一个重要的体会是,更大的上下文窗口和更复杂的设置并不总是更好。采用合理默认值,整个配置过程约需五分钟(不含模型下载时间,后者取决于您的网络)。
如果您已下载好该模型的 GGUF 文件,配置会更快。此时可完全跳过模型下载,只需通过创建一个 Modelfile 将现有 GGUF 文件注册到 Ollama。
这样您可以一次性定义生成参数,并在不同运行与工具间一致复用该模型。
在与 GGUF 文件同一目录下创建名为
Modelfile的文件:您可以按需调整以下参数:
将模型注册到 Ollama:
模型创建后,您可以直接以聊天模式运行:
现在,该模型可像其他 Ollama 模型一样使用,并可无缝集成到 Claude Code 中。
我曾在 Claude Code 中用 GLM 4.7 Flash 构建应用与游戏,过程非常有趣。在无网络或网络不稳定的偏远环境下工作,依然能掌控全局、稳定运行,并手握强大的编码代理——这种掌控感与独立性难以替代。
如果您想进一步了解本文涉及的工具,推荐阅读以下资源: