Courses
Claude 模型入门
3小时
14.3K
过去几天里,关于 Anthropic 下一次发布的传闻不绝于耳。尽管许多人期待的是 Claude Sonnet 5,但今年的首个版本却以 Claude Opus 4.6 的形式到来。
凭借 100 万 token 的上下文窗口、自适应思考、对话压缩,以及一系列位居榜首的基准测试成绩,Claude Opus 4.6 相较 Opus 4.5 进一步提升。用 Anthropic 的话说,他们升级了自家“最聪明”的模型。与模型同时发布的,还有 Claude Code 和 PowerPoint 版 Claude 中的智能体团队功能。
本文将全面介绍 Claude Opus 4.6 的新变化,涵盖新功能、基准测试结果,并通过多个上手示例对其进行实测。
如需了解最新 Claude 功能,建议查看我们的 Claude Cowork 与 Claude Code 指南,以及我们的 OpenClaw 教程。想与其他竞品对比,可阅读 Muse Spark vs Claude Opus 4.6 与 GPT-5.4 vs Claude Opus 4.6 指南。
Claude Opus 4.6 是 Anthropic 最新的大语言模型。作为 Opus 4.5 的延续版本,它代表了公司“最聪明”模型梯队的一次重要升级。
从发布博文看,Anthropic 称其更注重智能体式编码、深度推理与自我纠错。也就是说,从一次性行动转向了持续行动。
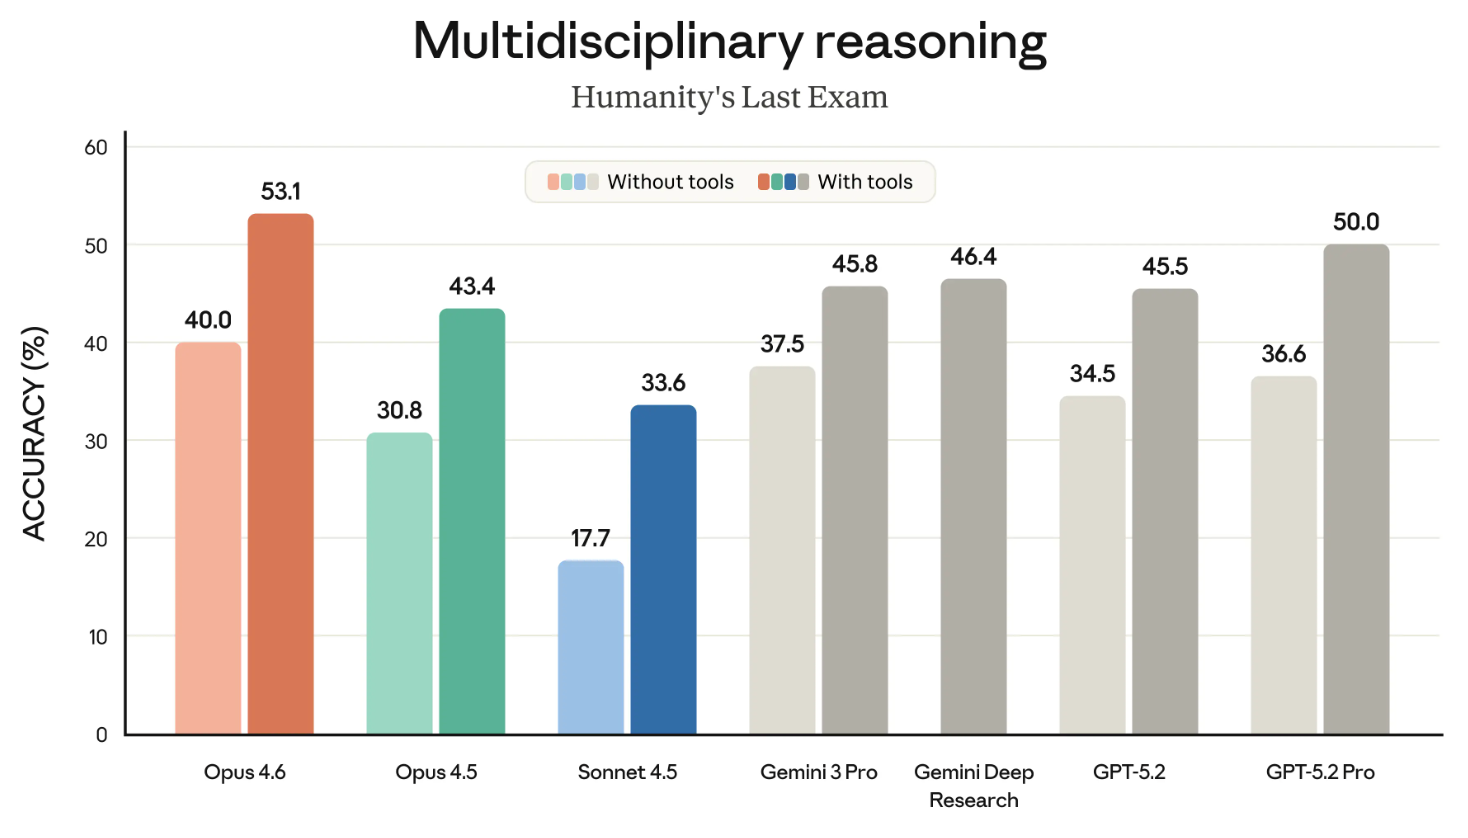
Opus 4.6 旨在更周密地规划,长期保持更强的连贯性,并能识别自身工作中的错误。这使得 Claude Opus 4.6 在多项基准中名列前茅,包括在 Terminal-Bench 2.0 编码评测中获得最高分,并在 Humanity’s Last Exam 中击败其他前沿模型。
最令我印象深刻的是 上下文窗口 的提升。测试版提供 100 万 tokens,使新模型与 Gemini 3 看齐,能够在不丢失上下文的情况下处理更多信息。
与此同时,Anthropic 已发布 Opus 的后继版本。建议阅读我们的 Claude Opus 4.7 指南,及时了解最新进展。
Claude Opus 4.6 带来多项值得关注的新功能,其中许多聚焦于智能体式工作流。以下为要点概览:
智能体团队是对以往版本中“子智能体”的改进。它允许您同时启动多个完全独立的 Claude 实例并行工作。其中一个会作为“主”智能体进行协调,其他“队友”负责实际执行。
最有意思的是,每个队员都有自己的上下文窗口,从而支持更扎实的执行。各个队友之间也可以直接沟通。
当然,这一功能也可能带来成本上的副作用。由于每个智能体都有独立的上下文窗口,token 消耗可能会很快。Anthropic 因此建议在复杂度更高的场景中使用该功能。
Claude Opus 4.6 的一个贴心功能是上下文压缩。该易用性提升能帮助您在长流程工作中避免触及上下文上限后性能下降的问题。通常,您会撞上上下文“天花板”,性能开始劣化。
借助对话压缩,Claude Opus 4.6 能在对话接近 token 阈值时自动检测,并将现有对话概括为精炼的块(压缩块)。
该功能既能保留交互要点,又能释放空间以便继续工作。如果您计划使用需要长时间运行的任务型智能体,这将以大幅改善的“记忆力”帮助其保持在正轨上。
Claude Opus 4.6 有两个相关特性:判断是否需要扩展思考,以及在扩展思考中投入多大力度。
自适应思考会让模型判断您的提示复杂度。根据简单或复杂程度,它会决定是否采用扩展思考。Claude 不再使用手动设置的 token 数量,而是会根据每次请求的复杂度动态调整预算。
“投入力度”参数让您设置 Claude 在花费 tokens 时是更积极还是更保守。实质上,您可以在 token 效率与回答的周全程度之间做平衡。
在 API 中使用 Claude Opus 4.6 时,您可以手动设置这些参数。例如:
我们近期介绍了 Excel 版 Claude,展示了该加载项如何在 Excel 侧边面板中帮助您完成多种任务。除了改进这一工具的功能外,Anthropic 还宣布了 PowerPoint 版 Claude。
该集成会遵循您的幻灯片母版、字体与版式。您可以提供公司模板并让其构建特定部分,或选择一张幻灯片并让其将密集文本转换为原生、可编辑的图表。
其重点在于生成可编辑的 PowerPoint 对象,而非“幻灯片图片”,这让它成为真正的生产力工具,而不仅仅是创意生成器。
PowerPoint 版 Claude 目前面向 Max 与企业用户开放研究预览。
Opus 4.6 的诸多亮点围绕更难的编码任务与更深的推理能力。这些能力的基础在于:同时把多重约束放在心中、跨多步推理以及发现错误的能力。
基于此,我们让 Opus 4.6 经历了一系列多步逻辑、数学与编码挑战。我们希望能暴露一些 LLM 的常见弱点——比如级联计算错误、空间推理(老大难问题),以及涉及约束的问题。我们还加入了一个特定的调试任务,因为 Anthropic 的公告称 Opus 4.6 在根因分析与其他调试问题上表现出色。
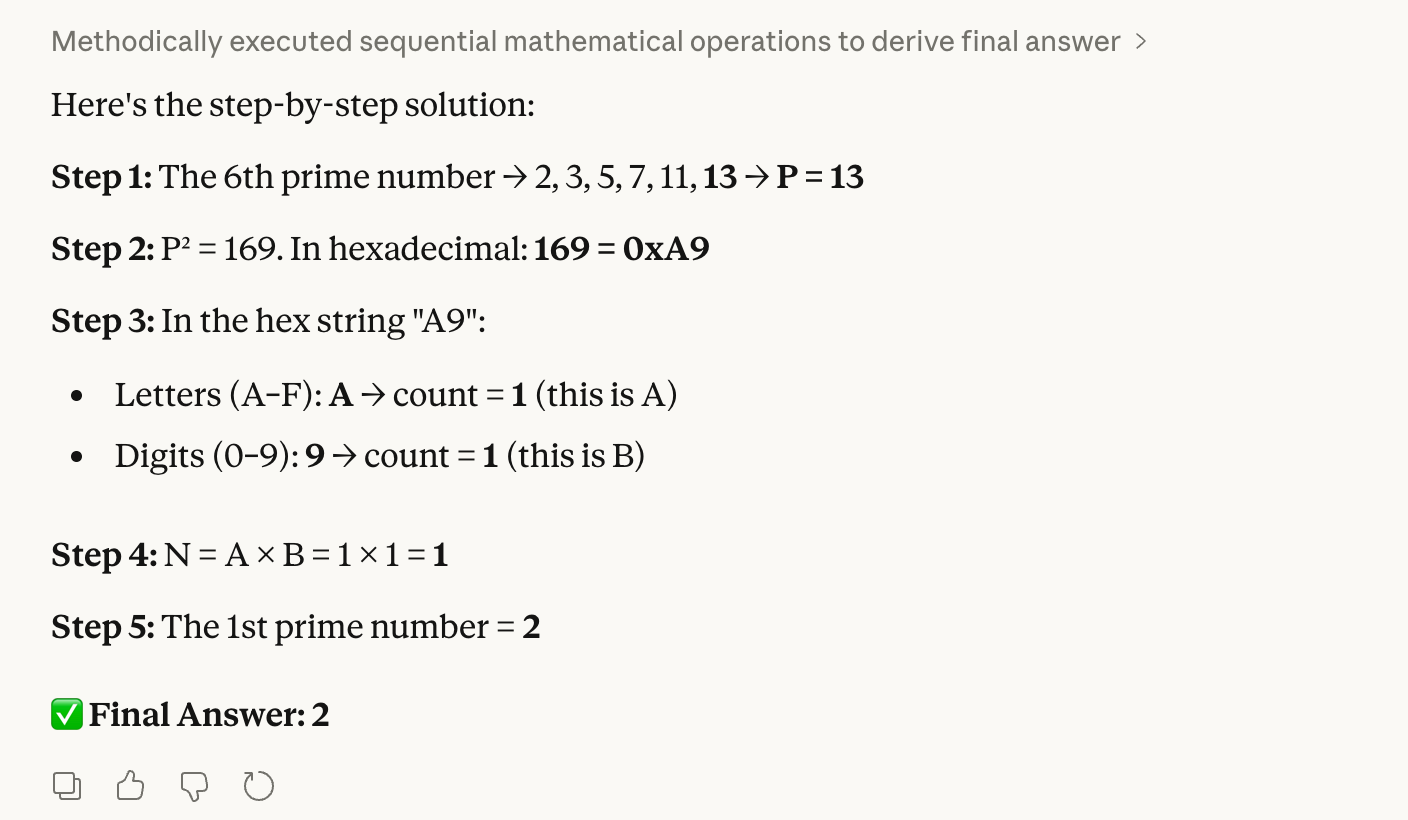
第一个测试结合了素数、十六进制与计数:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
看起来有点复杂,但这个测试对我们人类来说相当容易验证。我们知道正确答案是 2,因为第 6 个素数是 13;13 的平方是 169,十六进制为 “A9”。这包含 1 个字母 × 1 个数字,相乘为 1,而第 1 个素数是 2。
担心之处在于模型可能在十六进制转换上栽跟头,从而导致最终答案完全错误。如您所见,Opus 4.6 毫无障碍:
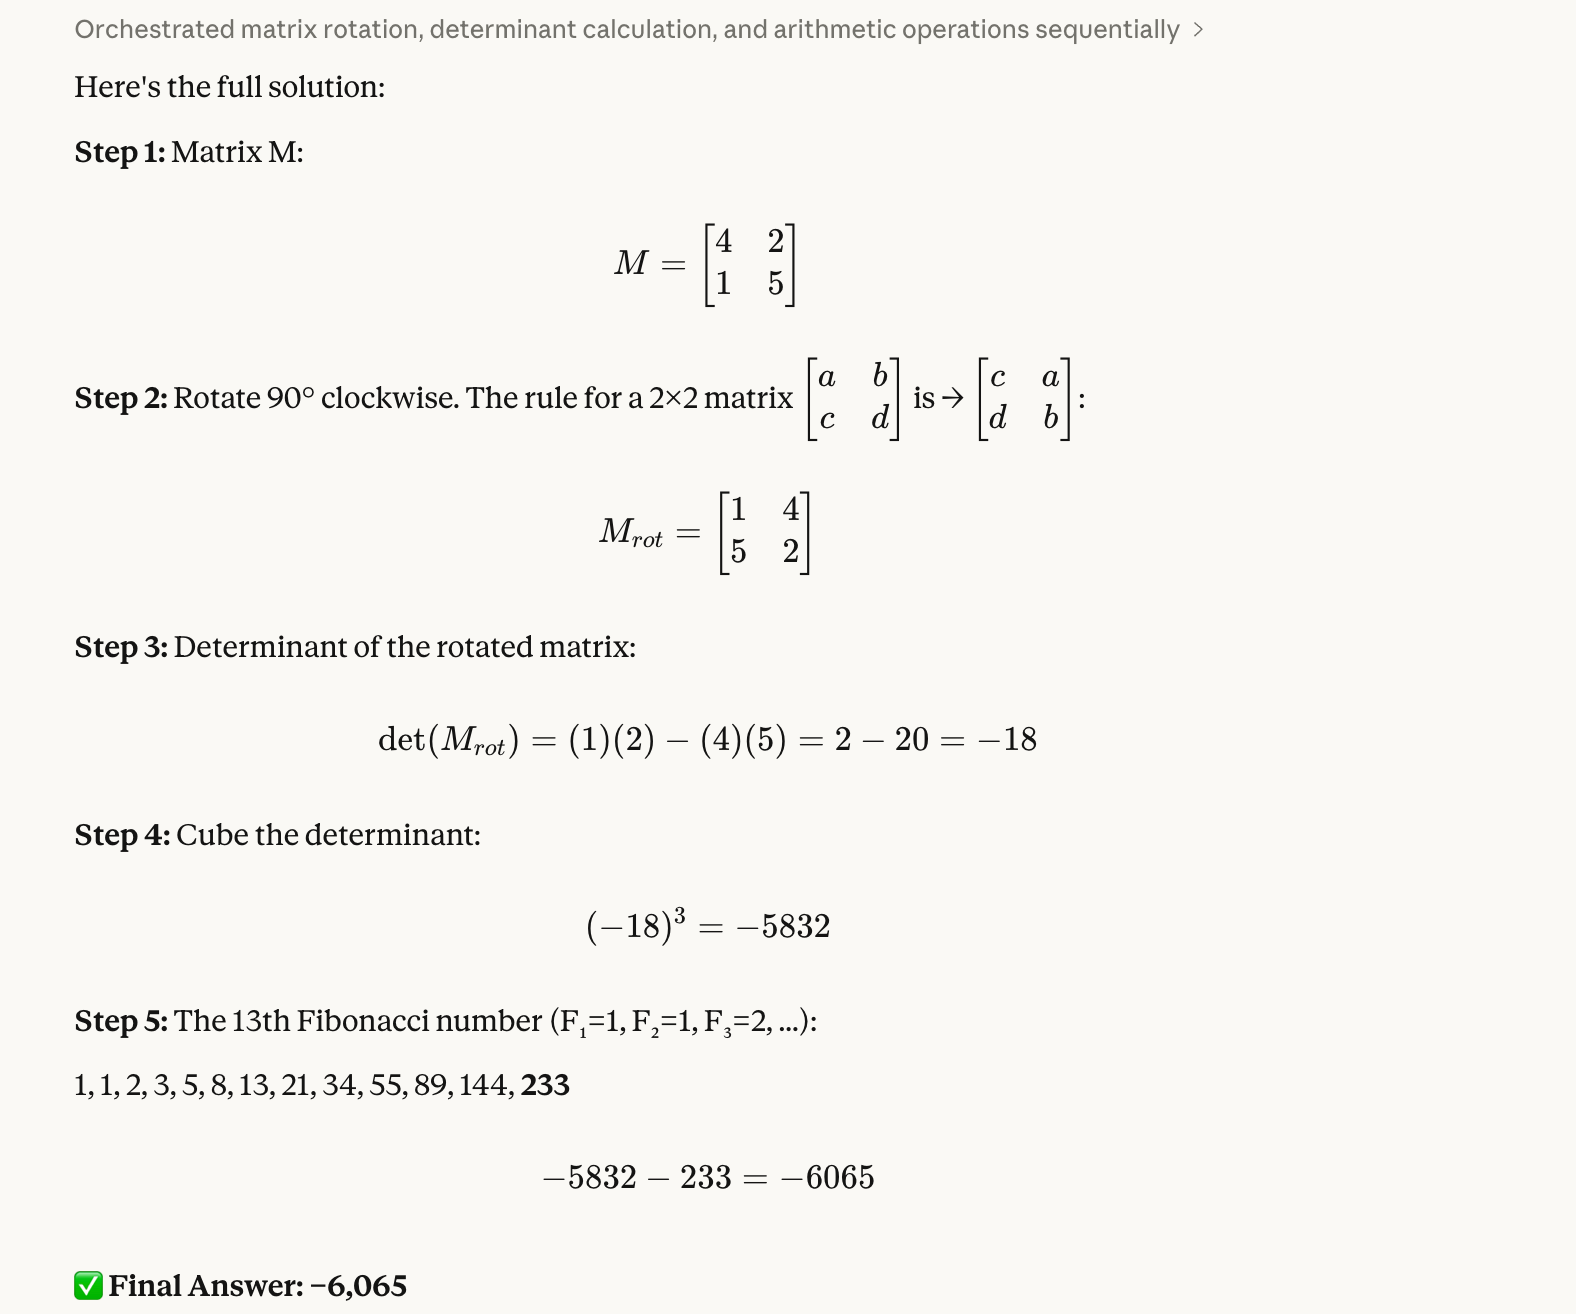
第二个测试考察空间推理与负数处理:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
这个测试在我们这端的验证稍费工夫。正确答案是 -6,065。因为旋转后的矩阵为 [[1, 4], [5, 2]];用 Python 计算其行列式得到 -18,立方为 -5,832;最后减去 233,得到 -6,065。
我们选择此测试,是因为经验告诉我们模型常会错误地交换矩阵元素,或者在中途丢失负号。同样,Opus 4.6 轻松通过:
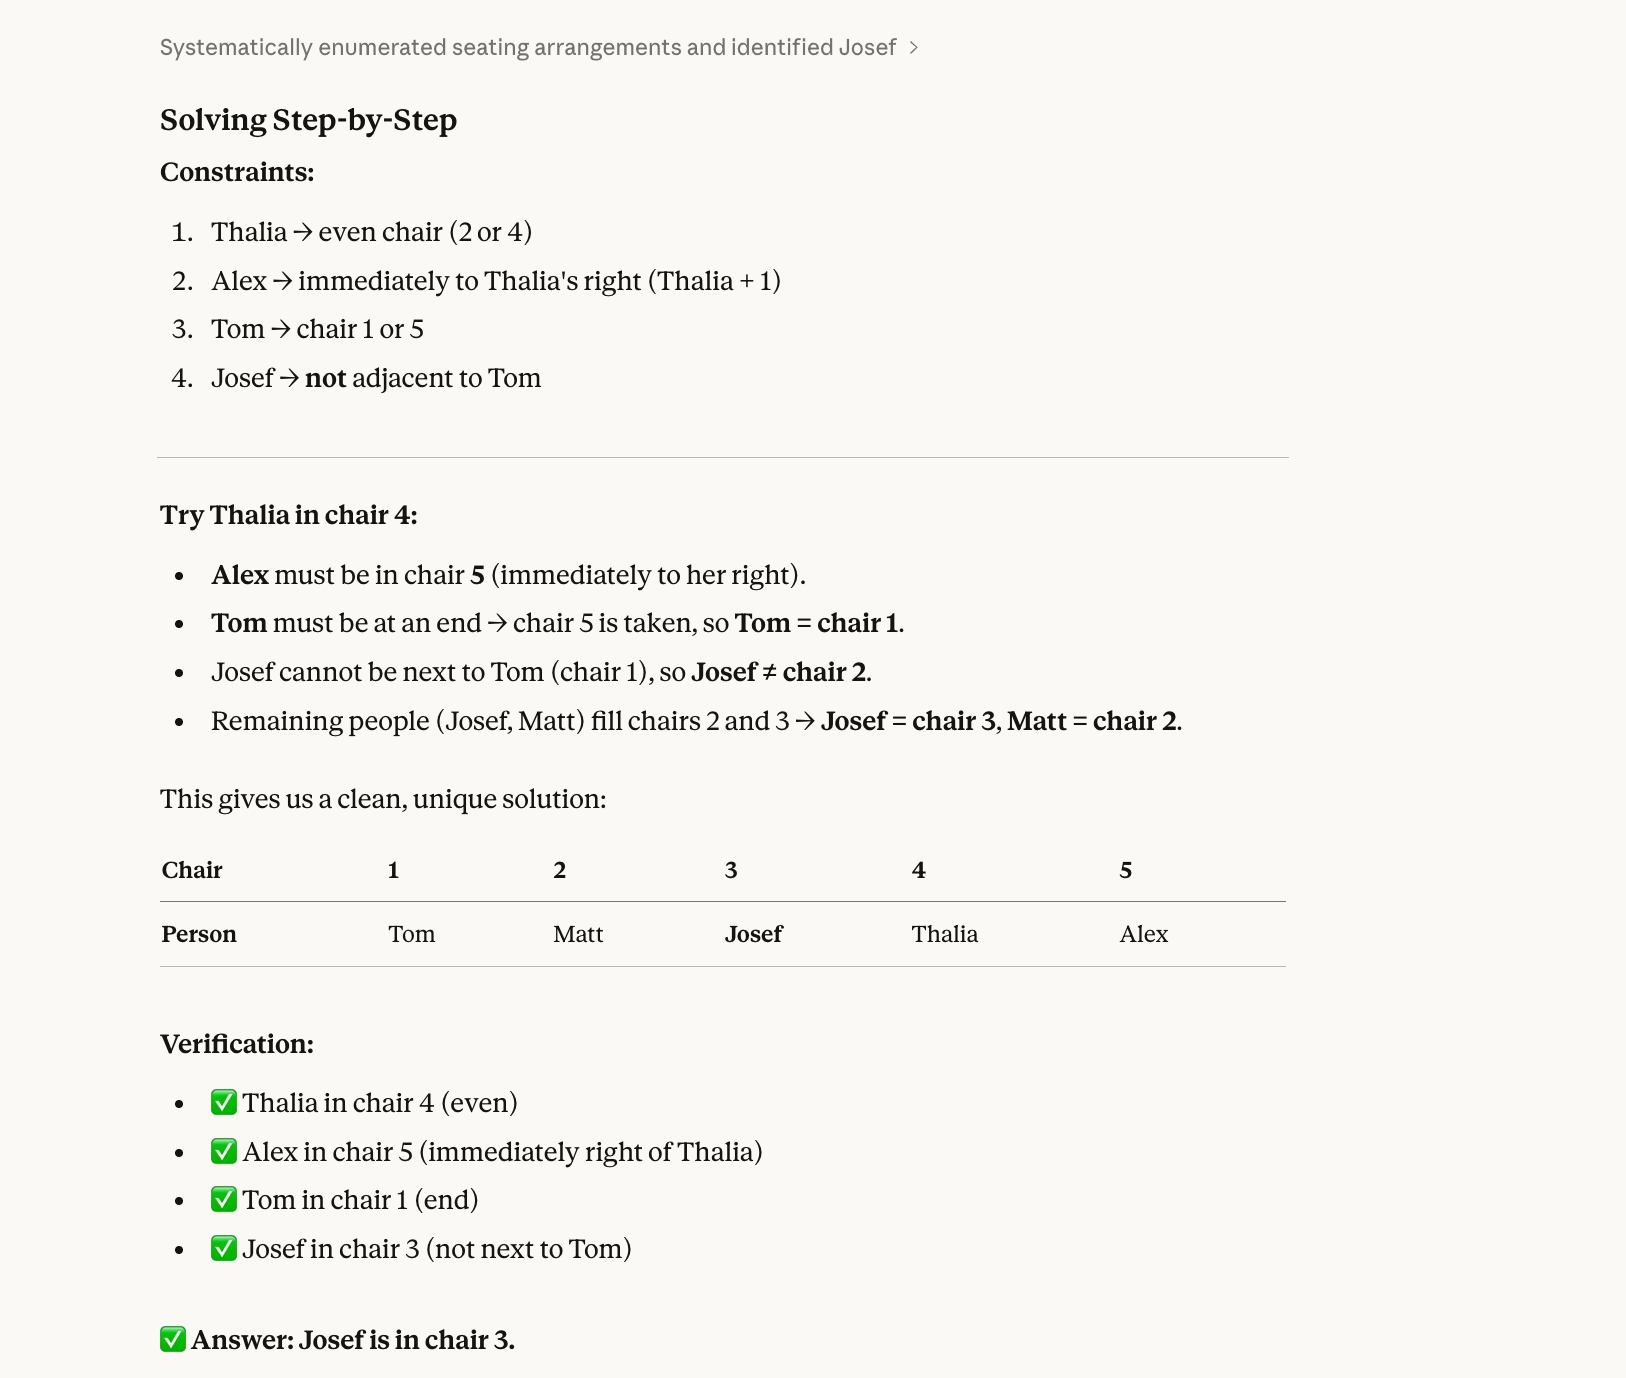
第三个测试是需要回溯的约束满足问题:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
该题正确答案是 Josef。(Alex-1,Matt-2,Josef-3,Thalia-4,Tom-5。)动点脑筋用纸笔也能推出来。
模型在这类问题上出错的根本原因在于,历史上模型往往是顺序求解而非整体求解。它读到“Thalia 在偶数位”后就先随便定一个(比如第 2 位),却不检查该选择是否与所有其他约束兼容。然后继续填写,最终遇到冲突,但那时已经“把自己写进死胡同”,不会回退去尝试把 Thalia 放在第 4 位。
Opus 4.6 同样答对了:
第四个测试评估空间想象与物理直觉:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
为了验证这一题,我确实把腕表取下来了转了转。
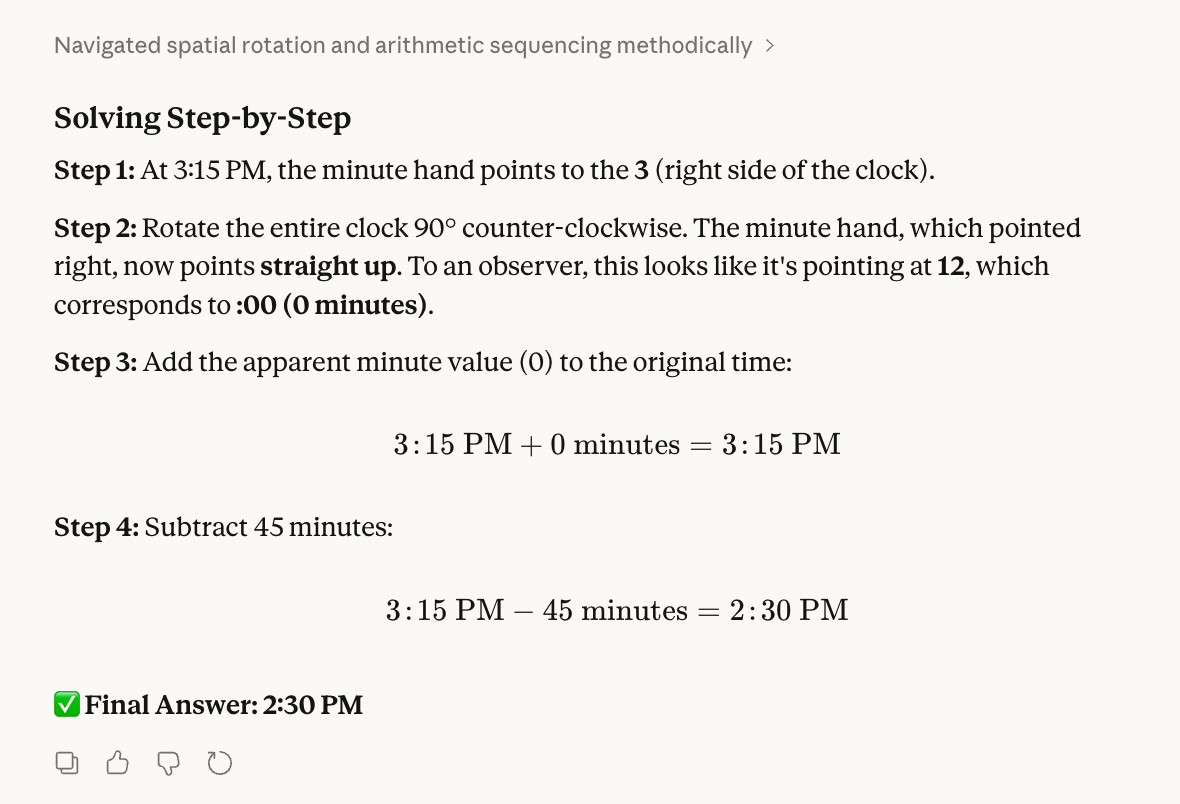
正确答案是下午 2:30。3:15 时,分针指向“3”。当我把“12”朝向左侧窗户时,“3”移动到了“12”的位置。然后我把 0 加到 3:15 上,再减去 45 分钟,得到下午 2:30。
在设计该测试时,我们预计模型可能会把旋转表盘与移动指针混淆。我们也听说模型常觉得“加 0”可疑,于是会强行给出别的数。
不过,Opus 4.6 成功解决了这个问题,也给出了正确答案:
第五个测试将同余算术与素数筛选结合:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
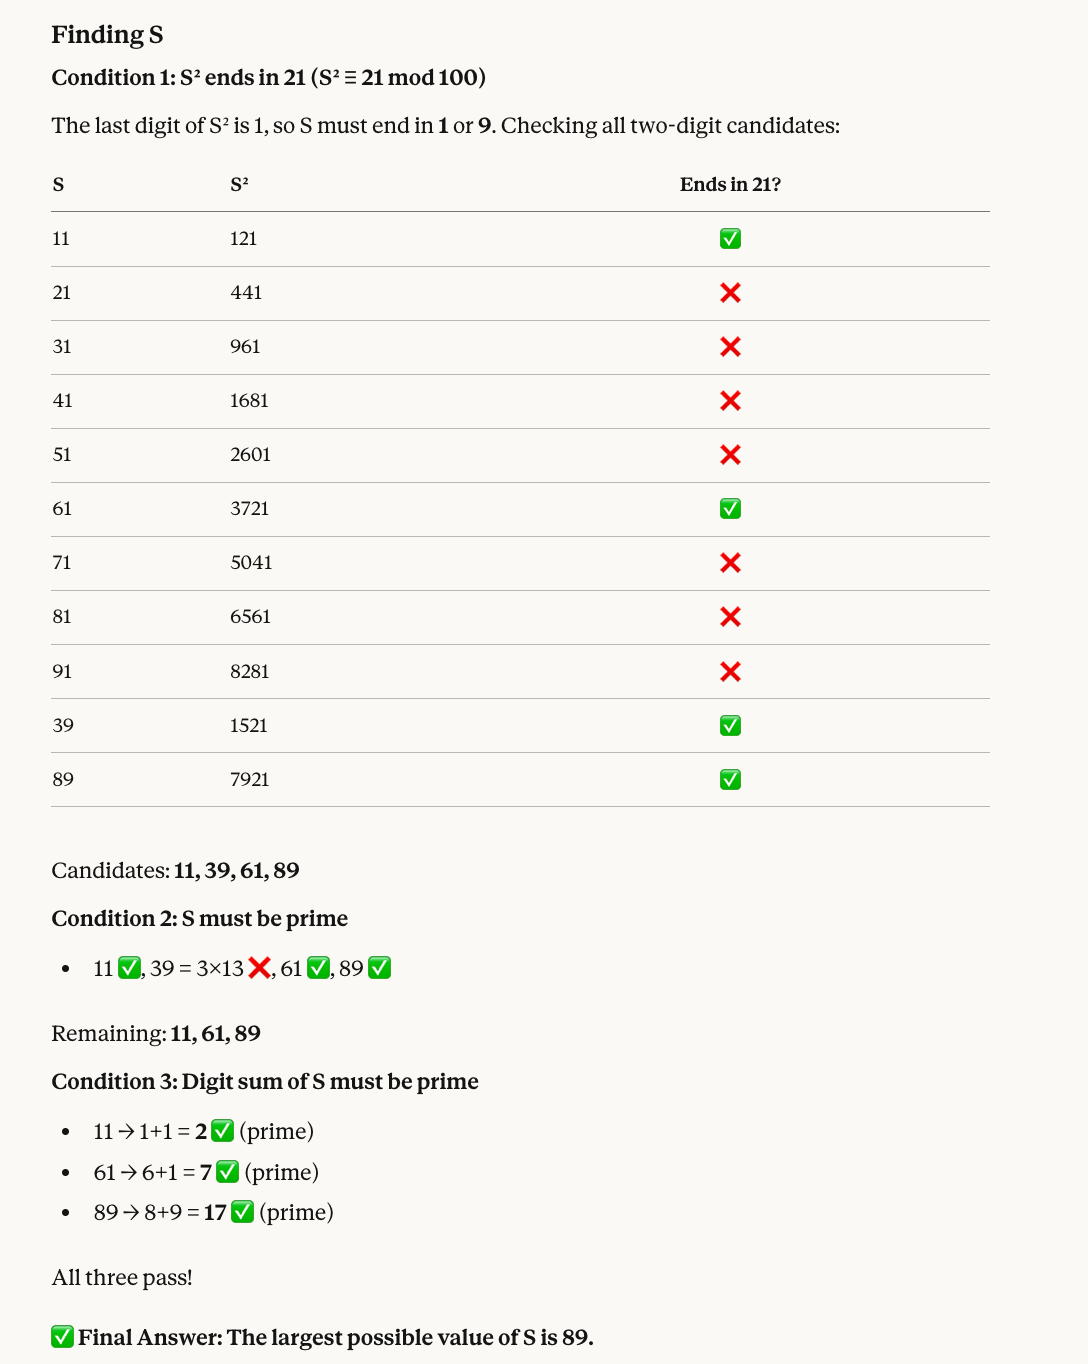
之所以答案是 89,原因如下:平方末两位为 21 的数包括 11、39、61 和 89。其中 39 不是素数,剩下 11、61 和 89。它们的数位和分别是 2、7 和 17(均为素数),因此最大的为 89。
Opus 4.6 依旧答对了,这次还给出了一个有用的示意图:
接下来的测试把阶乘计算、字符串操作与素数链在一起:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
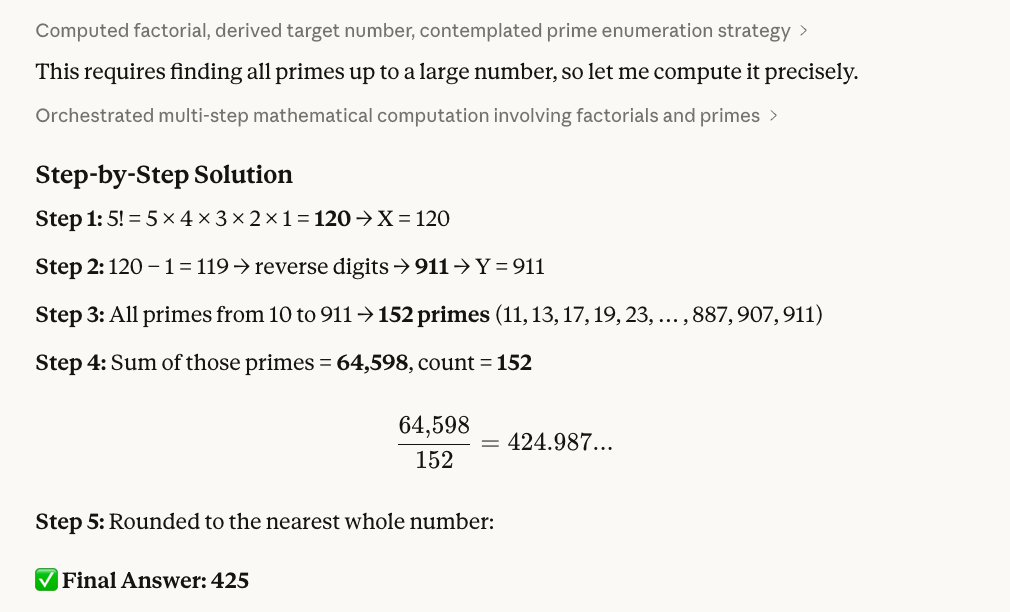
我们这样验证出 425 是正确答案的:5! = 120;减 1 得 119;反转数字得 911。随后用一些 R 代码(如下图所示)可见 10 到 911 之间共有 152 个素数,它们的和为 64,598。最后用 R 计算并取整:64,598 ÷ 152 ≈ 425。
以下为我们使用的 R 脚本:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")下一个测试直指 Opus 4.6 的一大主张:诊断代码中的缺陷。我们知道模型常能逐行正确跟踪代码,但未能把跟踪结果与底层缺陷联系起来。
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
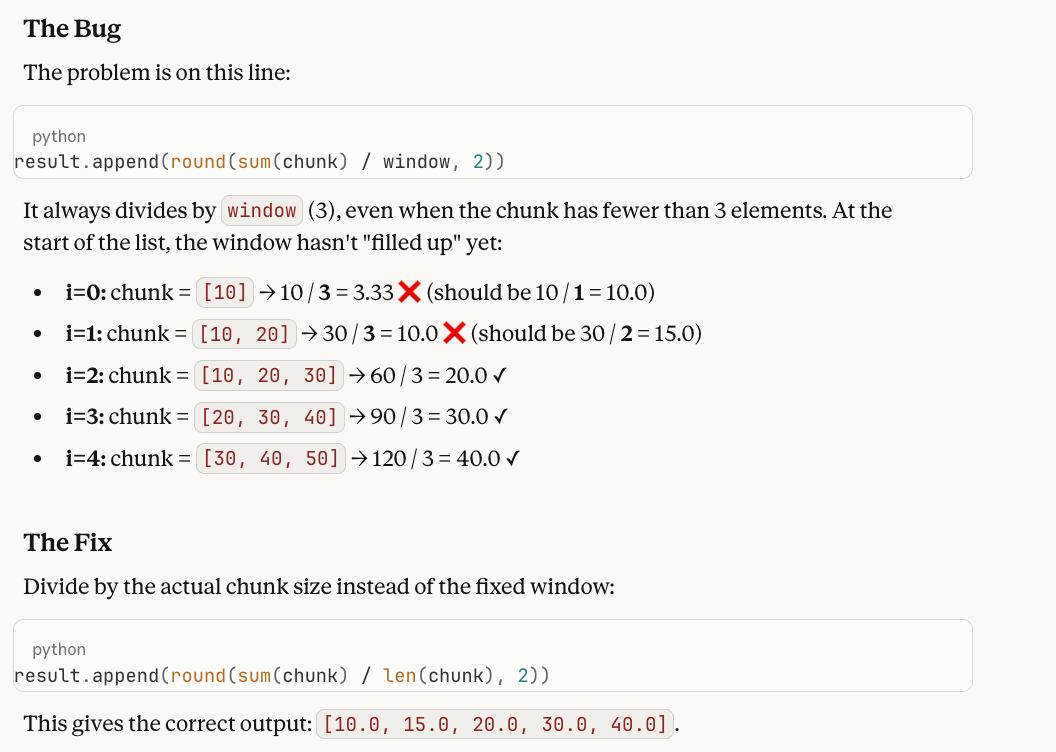
答案及其作为测试的理由如下:该函数始终用 window (3) 作为除数,即便在列表起始处片段元素不足 3 个时也是如此。错误输出为 [3.33, 10.0, 20.0, 30.0, 40.0],但前两项应为 10.0 与 15.0,因为对应片段分别只有 1 个与 2 个元素。修复方法是将 / window 改为 / len(chunk)。
我们喜欢这个测试,因为模型常会完美地跟踪循环,却给出“输出看起来正确”的结论——它们看到逐步的计算过程,却没意识到用 3 去除单个元素是错误的。这要求模型同时把意图(滑动平均应做什么)与执行(代码实际做了什么)放在一起,找出两者之间的差距。
最后一个测试没有数学,只有反事实推理。
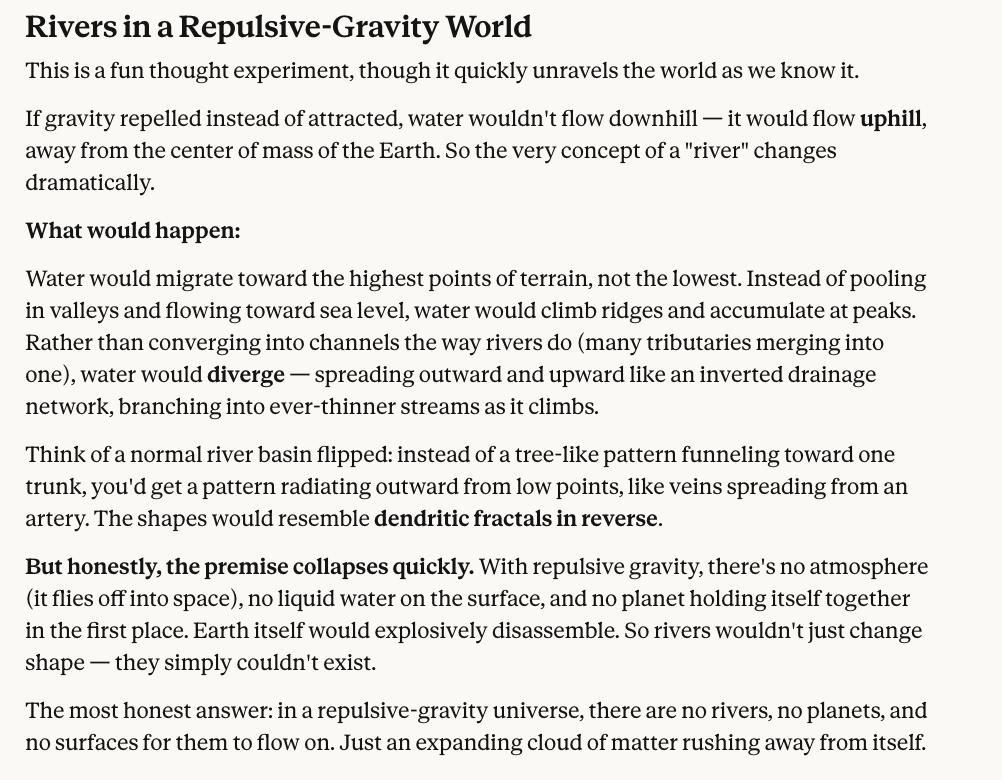
In a world where gravity repels objects instead of attracting them, what shape would rivers take?诚然,这道题没有唯一正确答案,我们也很难设身处地去想。但我们希望模型至少能推演其影响,而我们认为 Claude Opus 4.6 的回答相当有道理。
总之,长话短说,Opus 4.6 拿下满分。不过正如您所见,其中一道题的答案略带主观性,您也可以自行判定。
Opus 4.6 至少在四项重要基准中稳居第一:
Terminal-Bench 2.0 是智能体式编码基准;Humanity’s Last Exam 测试复杂推理;GDPval-AA 评估知识型工作的表现;BrowseComp 衡量模型在线查找难觅信息的能力。
Claude 系列长期被认为是最擅长编码的模型之一。我们先看看 Terminal-Bench 2.0 的结果。
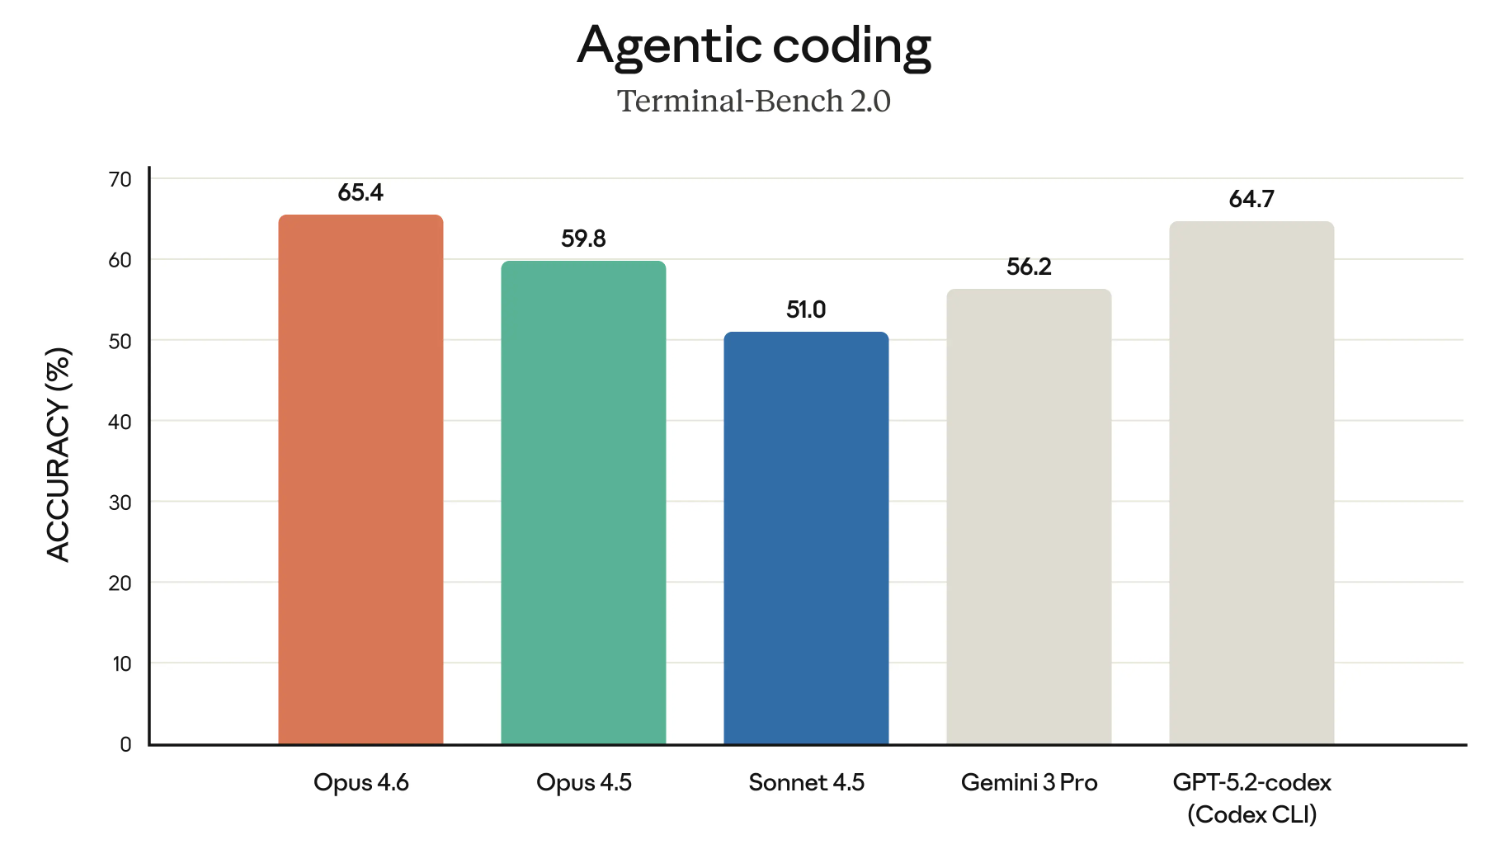
如果上图似乎在突出 Opus 4.6 与 GPT-5.2-codex 的对比——这大概是刻意为之。Anthropic 近期在多个领域正面挑战 OpenAI,并在为企业用例立论。
Humanity’s Last Exam 是最知名的基准之一,我们都在密切关注。它评估模型的一般性推理能力。
下图展示了各前沿模型在 HLE 基准上“使用工具”与“不使用工具”的成绩。(“使用工具”指模型获准使用如网页搜索、代码执行等外部能力。)
这张图或许拆成两张会更好。撇开这一小问题,结论很清晰:Opus 4.6 在“使用工具”与“不使用工具”两类中均居首。
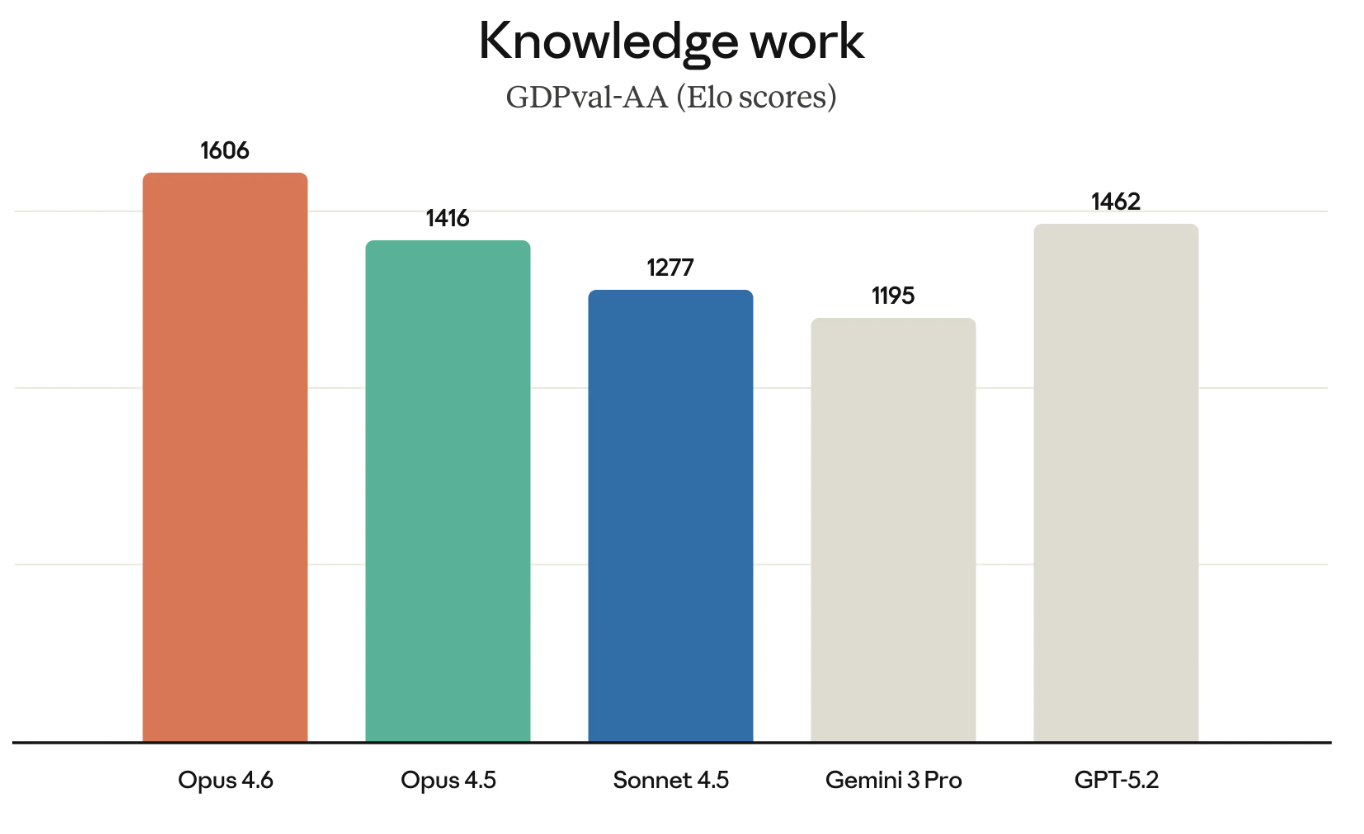
顾名思义,GDPval-AA 测试被认为具有经济价值的知识型工作。比如运行财务模型或进行研究。
GDPval-AA 及类似基准的重要性日益上升,因为它们真正衡量的是企业实际愿意付费的工作。Opus 4.6 在 GDPval-AA 上的成功,也是在直接向 GPT 模型套件发起挑战,因为 OpenAI 与 Anthropic 正在争夺大量相同客户。
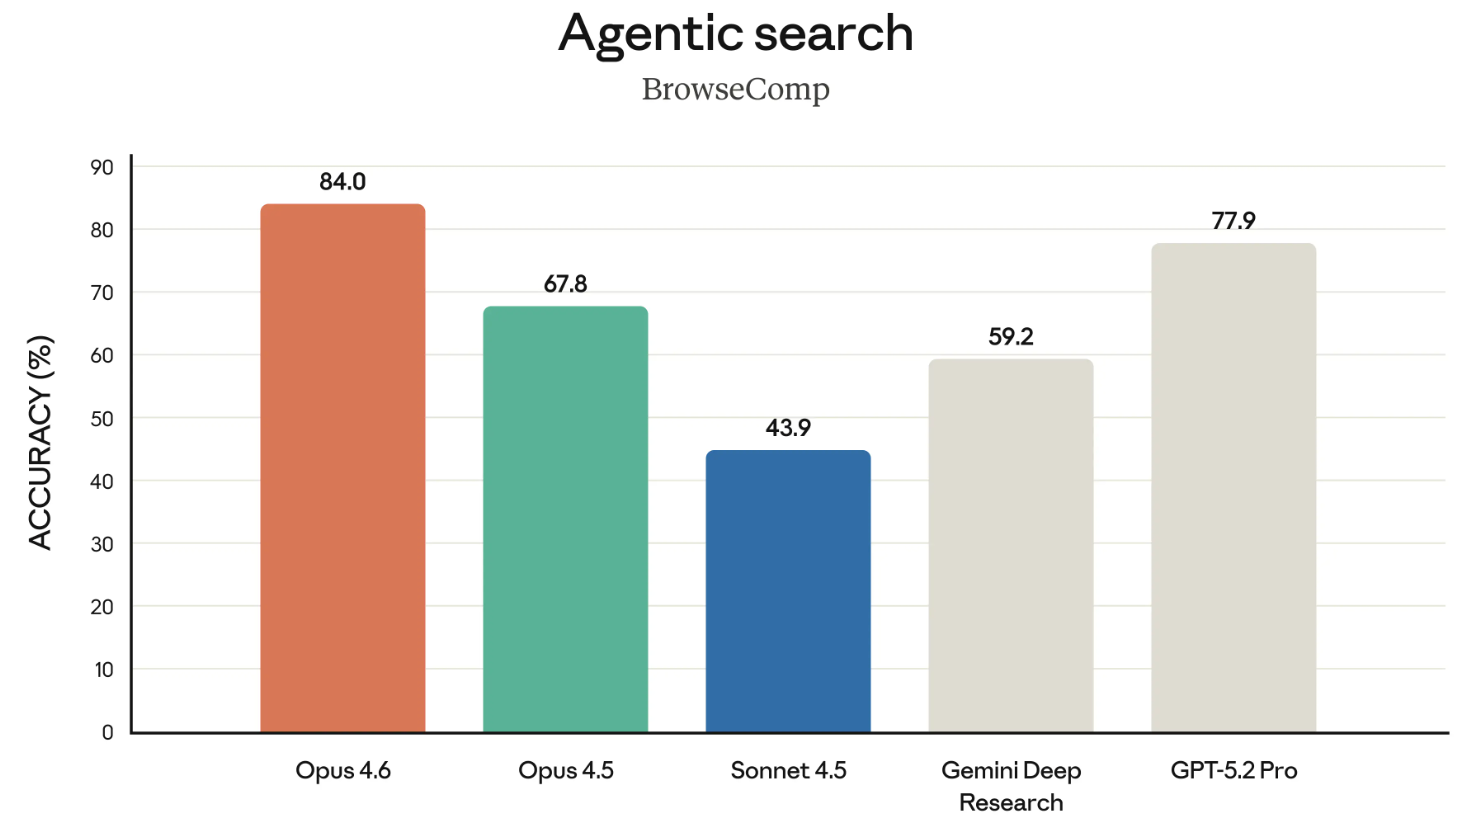
BrowseComp 是本次发布中最后一个值得一提的基准。它衡量模型在线追踪难以发现的信息的能力。历史上,BrowseComp 实际上是 OpenAI 为展示其模型搜索能力而开发的。
此次发布中,Anthropic 直接链接到了 OpenAI 2025 年 4 月关于 BrowseComp 的公告,以强调 Opus 4.6 在该基准上位居榜首,这一举动带有几分“还以彼人之道”的意味。
撰文时,Opus 4.6 已广泛可用。但若想访问 Opus 4.6,您需要升级至专业账户,这还带来其他权益,例如可在 Excel 中使用 Claude。
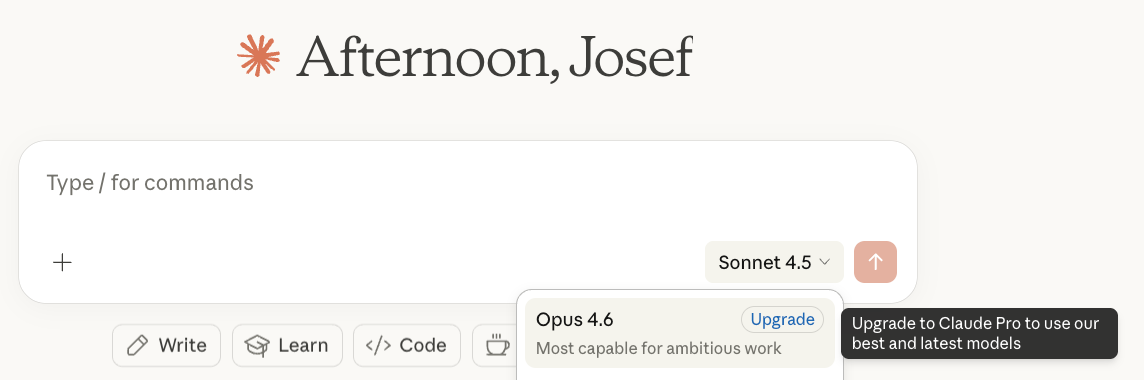
如果您是开发者,应在 Claude API 中使用 claude-opus-4-6。定价未变:仍为每百万 tokens $5/$25。若您对这两个数字感到困惑,请注意第一个数字是发送 tokens 至模型(也就是您的提示)的费用,第二个数字是模型生成返回 tokens(回答)的费用。
Claude Opus 4.6 在 GPDVal-AA 等重要基准中名列前茅,该基准衡量模型在经济重要任务上的表现,这正是大型企业客户关心的。OpenAI 可能会对这一进展感到不安,因为在 Opus 4.6 发布前数小时,他们宣布了 OpenAI Frontier,这是一款用于在生产环境中构建、部署和管理 AI 智能体的新企业平台。
换言之,OpenAI 不是在模型基准上正面竞争,而是把重心放在其模型套件的基础设施上,具体做法是为 AI 智能体提供共享的业务上下文、权限,并让其能够随时间接收与学习反馈。在基准上丢失阵地的同时,OpenAI 表示其平台更能让智能体在企业中真正发挥作用。
这究竟是战略转向,还是默认在模型竞赛中落了下风,就见仁见智了。
总体而言,我们对 Anthropic 带来的 Claude Opus 4.6 印象深刻,并期待上手体验智能体团队功能。若您想进一步了解 Claude 家族,欢迎查看 Introduction to Claude Models 课程。
在 DataCamp 学习 AI
Courses
Courses
Courses