Programa
AI Engineering with LangChain
21 h
O Claude Code recompensa um tipo de disciplina que a maioria das ferramentas de desenvolvimento não exige. Se você já usa a ferramenta há um tempo, deve ter notado que algumas sessões entregam exatamente o que você quer, enquanto outras torram tokens sem sair do lugar. A própria equipe da Anthropic constatou que tentativas sem direcionamento só têm êxito em cerca de 33% dos casos, e o criador da ferramenta abandona de 10% a 20% das sessões.
A diferença está nos padrões que você cria ao redor da ferramenta, não nos prompts que digita.
Este artigo mostra como esses padrões funcionam na prática, com base em fluxos de trabalho de produção de empresas como Abnormal AI, incident.io e Trail of Bits.
Se você precisa relembrar a configuração e os recursos principais, nosso guia do Claude Code 2.1 cobre tudo. Aqui, partimos do pressuposto de que você já conhece o básico e quer extrair mais da ferramenta.
Para uma visão mais ampla de como agentes raciocinam e onde os padrões deste tutorial se encaixam, recomendo se inscrever na nossa trilha de aprendizado AI Agent Fundamentals, que aborda todos os princípios por trás disso.
Cada decisão que o Claude toma sem orientação pode ter alta acurácia, o que parece ótimo isoladamente, mas quando isso se acumula ao longo de um recurso com muitos pontos de decisão, a chance de dar tudo certo cai bastante. Supondo 80% de acerto em 20 decisões, temos 0,8^20 — ou seja, só cerca de 1% de chance de uma implementação totalmente correta.
O planejamento reduz essas 20 decisões ambíguas a uma especificação revisada em que cada uma chega perto de 100%, porque você já decidiu antes.

O fluxo de planejamento que melhor escala é um ciclo de anotações, como sugere Boris Tane. Você pede ao Claude para rascunhar um plan.md, abre no seu editor e adiciona comentários inline onde o Claude errou a mão ou deixou algo ambíguo: "use drizzle:generate, não SQL bruto" ou "isso deve ser PATCH, não PUT."
Depois você envia o plano anotado de volta com a frase de segurança "address all notes, don't implement yet." Essa frase é importante porque, sem ela, o Claude ignora o plano e começa a codar na hora. O ciclo se repete até o plano ficar sem ambiguidades; aí sim o Claude implementa com bem menos desvios, porque todas as decisões já foram tomadas.
# plan.md — annotation cycle

## Step 3: Database migration
Create a new migration for the users table.
> NOTE: use drizzle:generate, not raw SQL
> NOTE: add created_at with default NOW()

## Step 4: API endpoint
Add PUT /users/:id endpoint.
> NOTE: this should be PATCH, not PUT. Partial updates only.

# After annotating, send back with:
# "address all notes, don't implement yet"Se o ciclo de anotações parecer pesado, o plan mode integrado do Claude Code é uma opção mais leve:
Os planos são salvos em ~/.claude/plans/, então sobrevivem à compactação e a reinícios de sessão, o que torna o plan mode nativo um padrão sólido para a maioria das tarefas. Para recursos muito grandes, escrever uma especificação completa logo de cara também funciona bem: um desenvolvedor passou duas horas em um spec de 12 etapas e economizou de 6 a 10 horas na implementação.
Independente da abordagem, colar um bom código open source junto com o pedido de plano melhora visivelmente o resultado, porque o Claude trabalha melhor com uma referência funcional do que com descrições abstratas.
O planejamento também escala horizontalmente via git worktrees. Engenheiros da incident.io rodam 4-5 sessões paralelas do Claude em branches separadas, cada uma com seu próprio plano. Um engenheiro gastou US$ 8 em crédito do Claude e produziu uma implementação que melhorou o tempo de geração de APIs em 18%, economizando 30 segundos em uma ferramenta usada diariamente por todo o time.
Alguns desenvolvedores vão além, executando worktrees concorrentes que implementam abordagens diferentes para o mesmo problema e comparando os resultados.
Seu arquivo CLAUDE.md tem um orçamento que você provavelmente não conhece. A análise do HumanLayer sobre o funcionamento interno do Claude Code descobriu que o sistema injeta um lembrete acima das suas instruções: "This context may or may not be relevant to your tasks."
O Claude filtra ativamente o que segue, em vez de tratar tudo como comando persistente. Além disso, modelos de ponta seguem algo em torno de 150 a 200 instruções antes que a aderência caia, e o próprio system prompt do Claude Code consome cerca de 50 delas. Sobra algo entre 100 e 150 espaços para suas regras. O HumanLayer mantém seu arquivo abaixo de 60 linhas.

Você pode observar esse orçamento em ação. Adicione uma linha ao seu CLAUDE.md dizendo "always address me as Mr. Tinkleberry" e veja quão rápido o Claude para de usar — geralmente em poucos milhares de tokens. Quando o nome some, suas instruções foram priorizadas para baixo pelo mecanismo de atenção, e todo o resto do seu CLAUDE.md perde influência junto.
A forma de trabalhar dentro desse orçamento é a divulgação progressiva. Seu CLAUDE.md raiz fica curto e focado nas regras que valem em qualquer lugar. Para algo específico de domínio, referencie um arquivo separado sem incorporá-lo inline: "Ao trabalhar com o sistema de pagamentos, leia primeiro docs/payment-architecture.md."
O Claude lê o arquivo referenciado só quando entra naquela parte do codebase, mantendo seu orçamento de instruções livre para regras prioritárias. Uma empresa que consome bilhões de tokens por mês estrutura o CLAUDE.md do monorepo assim, com cada time recebendo um orçamento de tokens para sua seção:
# Monorepo CLAUDE.md — progressive disclosure

## Python
- Always use type hints for function signatures
- Test with: pytest -x --tb=short

## <Internal CLI Tool>
- <usage example>
- Always validate input before processing
- Never use raw SQL, prefer the ORM
For <complex usage> or <error> see path/to/<tool>_docs.md
Arquivos CLAUDE.md em subdiretórios ampliam isso. Coloque um CLAUDE.md em src/persistence/ com instruções específicas de banco de dados e outro em src/api/ com convenções de endpoints.
O Claude carrega automaticamente arquivos CLAUDE.md do diretório de trabalho até a raiz do projeto, então os arquivos de subdiretório só ativam quando o Claude está trabalhando naquela área. Isso mantém seu arquivo raiz geral, enquanto dá ao Claude orientações específicas exatamente onde precisa.
Um erro comum: não dê @ em arquivos de documentação dentro do CLAUDE.md. Isso incorpora o arquivo inteiro a cada execução e consome seu orçamento de instruções antes mesmo da conversa começar.
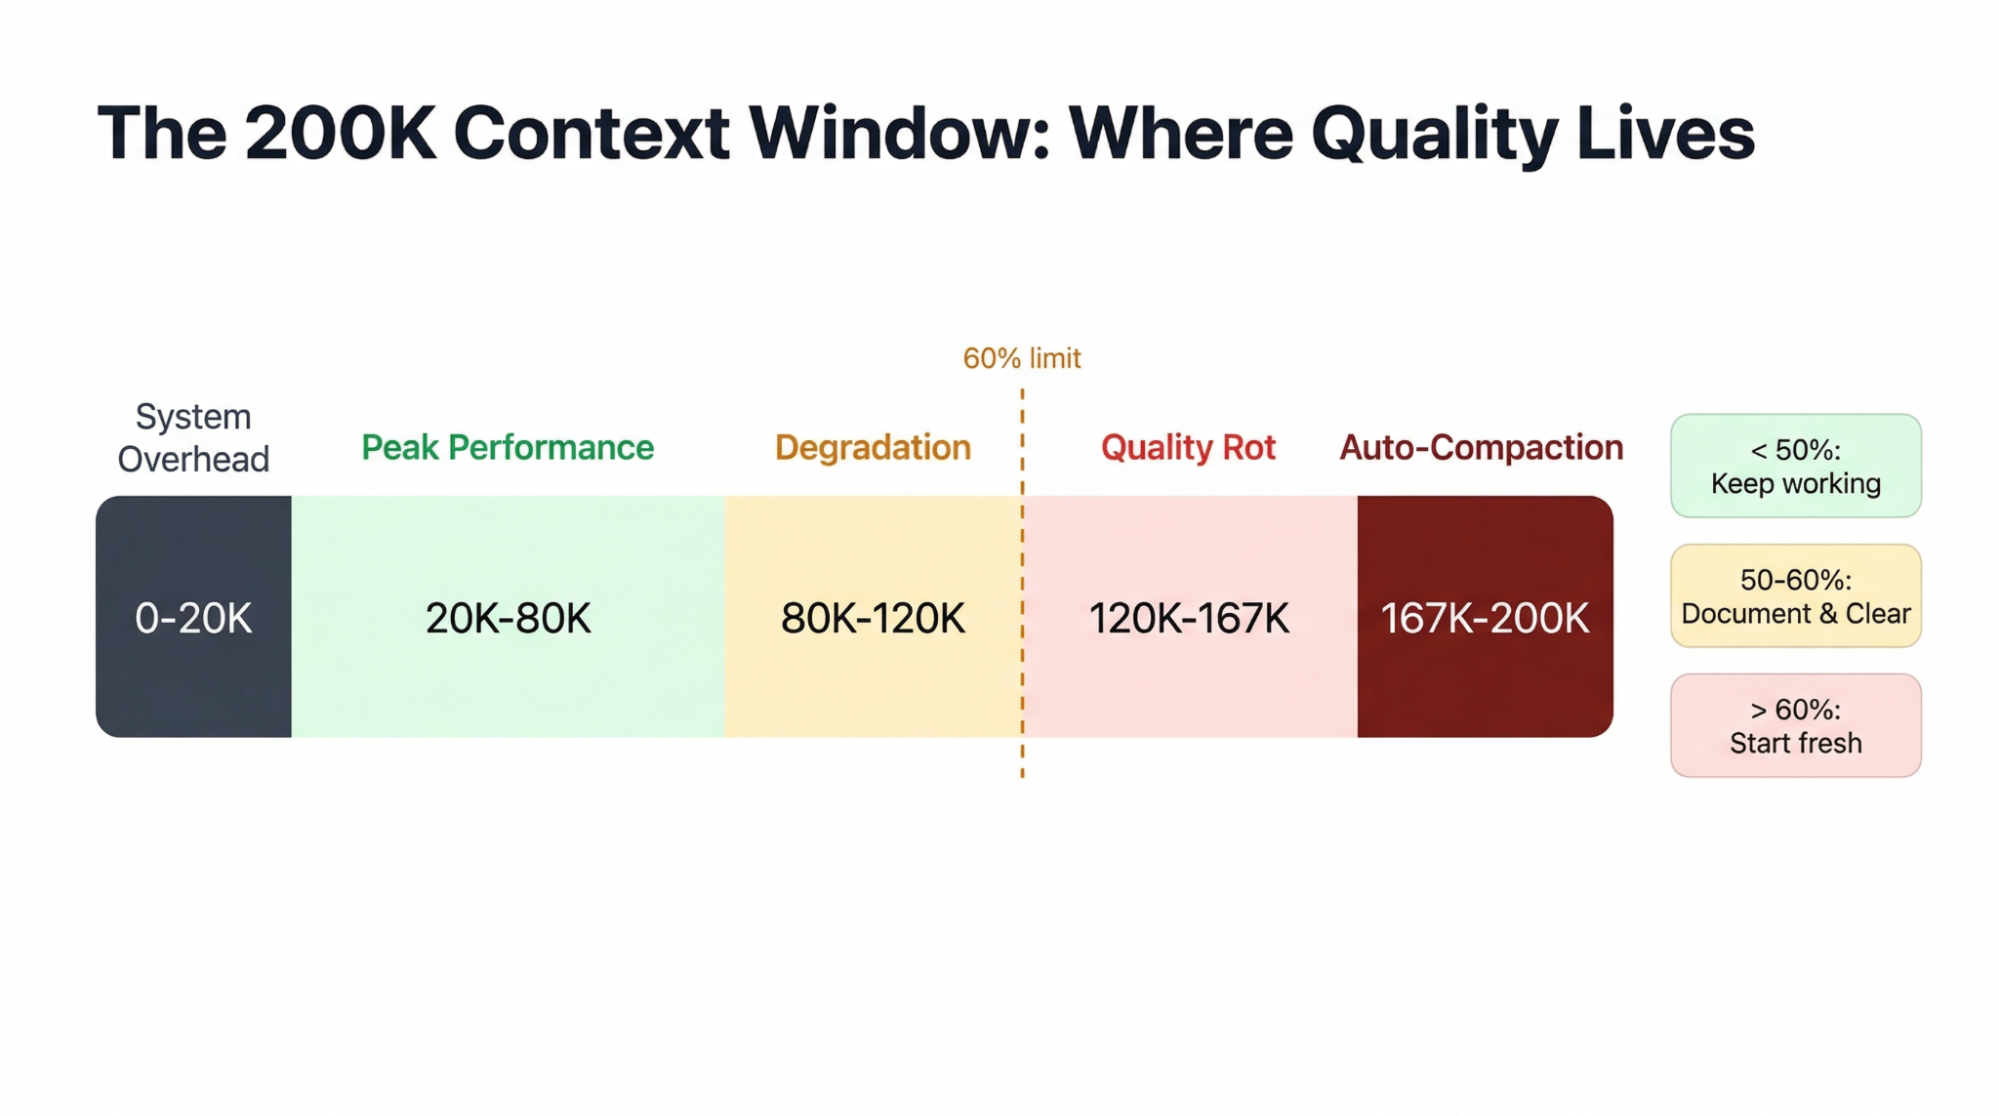
O Claude Code oferece 200K tokens de contexto, mas a janela utilizável é menor do que parece.
Uma sessão nova de monorepo consome cerca de 20K tokens carregando o system prompt, definições de ferramentas e CLAUDE.md antes de você digitar qualquer coisa. Cada servidor MCP adiciona esquemas de ferramentas que ocupam contexto de forma permanente, então o limite prático é de uns 5 a 8 servidores antes de começar a espremê-lo do trabalho real.
O que piora isso é o quão cedo a qualidade cai. Vários praticantes chegaram independentemente ao mesmo limite: não deixe o contexto passar de 60% da capacidade.
A saída do Claude começa a degradar entre 20% e 40% da janela, muito antes de atingir o limite, porque o mecanismo de atenção dá menos peso às instruções anteriores conforme o contexto enche.
A auto-compactação dispara por volta de 83,5% — e é com perda: um desenvolvedor perdeu 3 horas de refatoração quando o processo apagou todo o histórico de decisões de migração no meio da sessão, retendo só uns 20%-30% dos detalhes.
A melhor defesa é o padrão Document & Clear. Quando o contexto ficar pesado:
Despeje seu plano e progresso atuais em um arquivo markdown
Rode /clear para resetar a sessão
Recomece com o Claude lendo esse arquivo
Assim você ganha a janela cheia de 200K apenas com o que escolheu preservar, o que é melhor que /compact porque você controla exatamente o que sobrevive.
Um comando /catchup customizado deixa a transição mais suave: após limpar, ele lê todos os arquivos alterados no branch atual do git, então o Claude retoma de onde parou sem o histórico de conversa antigo.
<!-- .claude/commands/catchup.md -->
Rebuild context after a /clear. Read all files modified on the
current branch compared to main. For each file, understand the
changes made. Then summarize what's been implemented so far and
what work remains.

Changed files on this branch:
$ git diff --name-only mainEu uso uma /transfer-context skill que vai além. Quando a sessão começa a degradar, o comando despeja um arquivo de handoff estruturado com trabalho concluído, decisões em aberto, armadilhas a evitar e caminhos de arquivos relevantes. A próxima sessão lê esse arquivo e retoma de onde a anterior parou — só com a informação que importa, sem a gordura do histórico de conversa.
Você também pode poupar contexto carregando ferramentas sob demanda. Um projeto recuperou cerca de 15.000 tokens por sessão usando ganchos UserPromptSubmit para injetar definições de skills só quando o prompt do usuário disparasse palavras-chave relevantes, em vez de pré-carregar tudo na inicialização.
A regra mais simples por trás de tudo isso: uma tarefa por conversa. Começar do zero custa 20K tokens, o que é nada comparado à perda de qualidade de uma sessão poluída.
Mesmo um CLAUDE.md bem estruturado é seguido só em cerca de 70% dos casos. Para preferências de estilo de código, tudo bem. Para regras de segurança como "não faça push na main" ou "não delete dados de produção", não. Os hooks fecham essa lacuna para 100% ao executar scripts de shell em pontos específicos do fluxo do Claude.
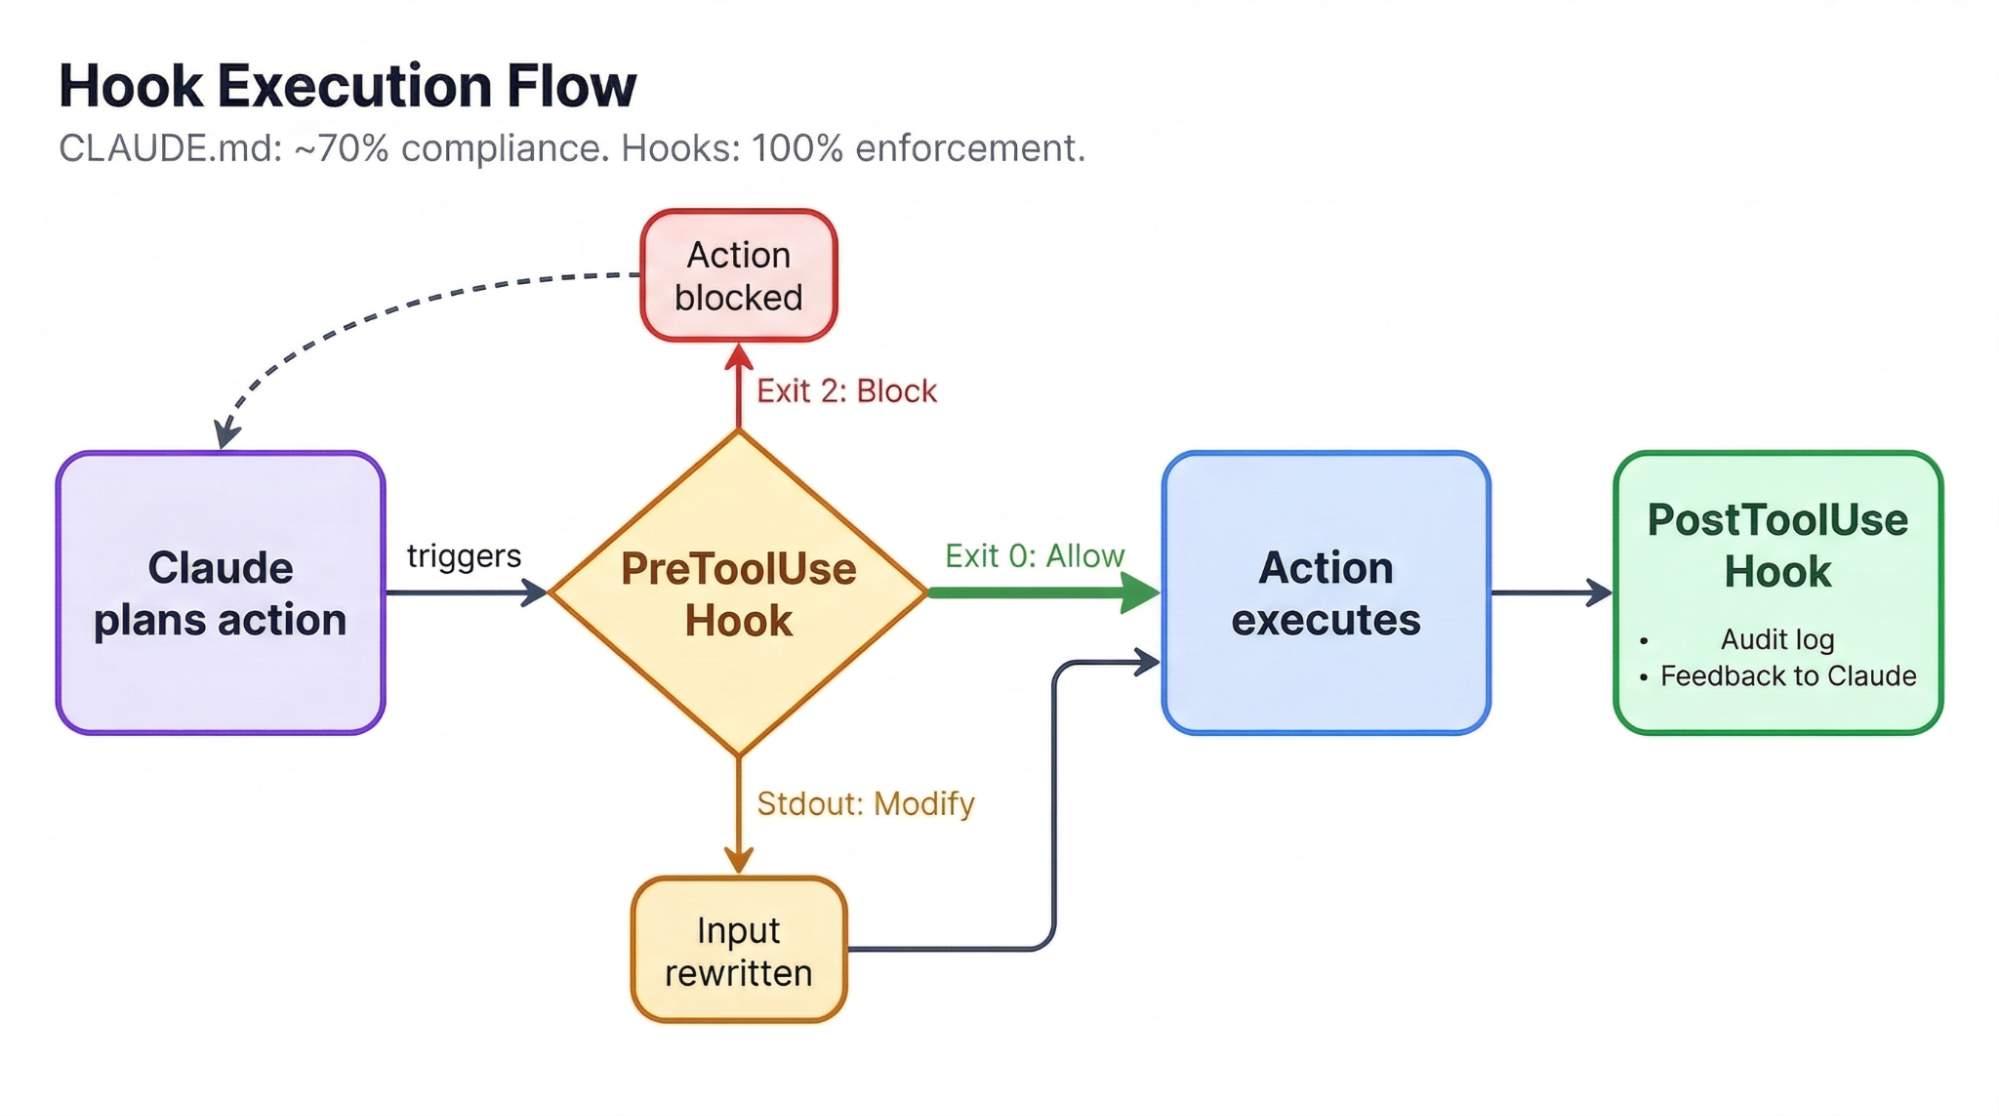
Existem dois tipos que valem conhecer. Hooks de bloqueio no envio rodam como eventos PreToolUse e barram ações na hora: código de saída 2 bloqueia a ação e obriga o Claude a tentar outra coisa. Hooks de dica fornecem feedback sem bloquear, como rodar um linter após cada edição e devolver a saída sem interromper o fluxo do Claude.
A configuração pública de hooks mais completa faz o seguinte:
Bloqueia comandos rm -rf (sugerindo trash no lugar),
Impede pushes diretos na main,
Registra todas as mutações com timestamp, e
Roda um gate anti-racionalização.
Esse gate usa o Haiku para revisar respostas do Claude em busca de desculpas como "problemas pré-existentes" ou "fora de escopo". Quando flagra o Claude comemorando vitória antes da hora, rejeita a resposta com feedback específico e obriga o Claude a continuar. Uma configuração mais leve roda automaticamente Prettier e checks de TypeScript após cada edição de arquivo:
{
  "hooks": {
	"PostToolUse": [
  	{
    	"matcher": "Edit|Write",
    	"hooks": [
      	{
        	"type": "command",
        	"command": "prettier --write \"$CLAUDE_FILE_PATHS\""
      	}
    	]
  	}
	]
  }
}
Uma armadilha a evitar: nunca bloqueie as ferramentas Edit ou Write no meio do plano. Bloquear na hora da escrita quebra o raciocínio em múltiplas etapas, porque o Claude perde a noção de onde estava. Deixe terminar de escrever e valide via hooks de PostToolUse ou checks de pre-commit. Nosso tutorial de hooks do Claude Code traz mais padrões para você expandir.
Sem testes, a única forma do Claude verificar seu trabalho é o próprio julgamento — que degrada conforme o contexto enche. Testes criam um oráculo externo que continua acurado, não importa há quanto tempo a sessão está rodando.
Cada ciclo de vermelho para verde dá ao Claude feedback sem ambiguidades, e ele pode iterar por toda a suíte sem intervenção humana, tornando o desenvolvimento orientado a testes (TDD) o padrão mais forte para trabalhar com ferramentas de coding agentic.
O fluxo que a Anthropic recomenda segue uma sequência específica:
1. Write tests first
   > "Write tests for the auth module using pytest.
  	TDD approach, no mock implementations."

2. Confirm tests fail
   > "Run the tests. They should all fail."

3. Commit the failing tests as a checkpoint

4. Implement until green
   > "Write the implementation. Do not modify the tests.
  	Keep going until all tests pass."
Essa última instrução importa mais do que parece. Às vezes, o Claude muda os testes para fazê-los passar em vez de corrigir a implementação. Comitar os testes antes cria uma rede de segurança: se o Claude os alterar, o diff mostra exatamente o que mudou, e você pode reverter.
Para frontend, uma variante visual desse loop funciona muito bem: se você der ao Claude um mock de design mais um servidor MCP do Puppeteer, ele tira um screenshot após implementar, compara com o mock e itera. Esse ciclo de verificação gera uma melhora de 2 a 3 vezes na qualidade quando o Claude consegue checar sua própria saída contra um alvo visual.
Os dados oficiais da Anthropic indicam custo médio de US$ 6 por desenvolvedor/dia em preços de API, com 90% dos desenvolvedores abaixo de US$ 12/dia. Por mês, isso dá algo como US$ 100–200 por desenvolvedor no Sonnet 4.6.
O plano de assinatura Max muda a conta completamente. Um desenvolvedor acompanhou 8 meses de uso, com cerca de 10 bilhões de tokens, e viu que seu custo equivalente na API passaria de US$ 15.000, enquanto a assinatura Max real ficou em cerca de US$ 800: economia de 93%.
Mais de 90% dos tokens dele foram leituras de cache — por isso a precificação por uso na API dói bem mais do que uma assinatura fixa. O ponto de equilíbrio do plano Max fica em algo entre US$ 100 e US$ 200/mês em uso equivalente de API — um patamar que qualquer usuário diário atinge rápido.
|
Modelo de preço |
Custo mensal |
Melhor para |
|
API (Sonnet 4.6) |
~US$ 100–200 |
Uso leve, até 30 min/dia |
|
API (Opus 4.6) |
~US$ 300–800 |
Trabalho complexo multi-arquivo |
|
Max (US$ 100/mês) |
US$ 100 fixos |
Usuários diários, breakeven em ~US$ 100 equivalentes de API |
|
Max (US$ 200/mês) |
US$ 200 fixos |
Power users, 5+ horas/dia |
A escolha do modelo também é uma otimização. O modo "opusplan" do Claude Code roteia o Opus 4.6 para planejamento e alterna automaticamente para o Sonnet 4.6 na geração de código, garantindo raciocínio de nível Opus onde mais importa, enquanto usa as tarifas 5x mais baratas do Sonnet para os tokens de implementação.
O Sonnet 4.6 foi preferido ao Opus 4.5 por 59% dos usuários do Claude Code nos testes internos da Anthropic e tende a produzir código mais limpo, com menos overengineering. Para fluxos pesados em subagentes, CLAUDE_CODE_SUBAGENT_MODEL="claude-sonnet-4-5-20250929" roda os subagentes no Sonnet mantendo o Opus para o orquestrador.
Garanta que você evite as três maiores fontes de desperdício de tokens:
Não limpar o contexto entre tarefas
Leituras redundantes de arquivos por uma estrutura ruim do CLAUDE.md
Prompts vagos que jogam o Claude em loops de tentativa e erro
Corrigir só essas três costuma cortar o uso de tokens pela metade.
Antes de encerrar, vamos ver problemas comuns que desenvolvedores enfrentam ao trabalhar com o Claude Code — e como resolvê-los.
O modo de falha mais doloroso é a perda de contexto. O padrão Document & Clear, apresentado na seção de gestão de contexto, existe justamente por isso: nunca deixe uma sessão longa ser seu único registro de decisões. Faça commits com frequência, despeje o progresso em arquivos e trate cada sessão como descartável.
O Claude também gera código confiante e plausível para tecnologias que não conhece bem. Se você está trabalhando em uma linguagem ou framework que não consegue verificar pessoalmente, todo output exige escrutínio extra. Como disse um desenvolvedor: "Já me meti em uma ENRASCADA usando LLMs com tecnologias que eu não domino. Mas com algo que eu conheço, os LLMs turbinaram demais a minha velocidade."
Overengineering é uma tendência frequente. O Claude cria abstrações extras, funções auxiliares não solicitadas e refatorações prematuras — a menos que você peça para não fazer. Adicionar "use a abordagem mais simples possível" ao seu CLAUDE.md ajuda, e organizar o codebase por domínios de problema (em vez de camadas técnicas) reduz a carga cognitiva para o Claude e para humanos.
A falha mais dramática registrada: ao construir um app de fonética, o Claude deletou todos os arquivos de áudio de fonemas para os quais um desenvolvedor tinha permissão de uso e os substituiu por sons gerados por IA. Renomeou arquivos e "se convenceu de que havia rotulado errado, apesar de não conseguir distinguir os fonemas relevantes."
Lição aprendida: sempre faça commit ou backup de arquivos insubstituíveis antes de dar acesso ao Claude.
O conselho da própria Anthropic para sessões que saem dos trilhos é surpreendentemente honesto: salve seu estado antes de deixar o Claude trabalhar, deixe rodar e então aceite o resultado — ou recomece do zero, em vez de ficar brigando com correções.
O quanto confiar commits ao Claude depende da sua cobertura de testes e tolerância a risco. Alguns desenvolvedores fazem commit por slash command dezenas de vezes ao dia, usando o PR como gate. Em codebases de produção com clientes pagantes, revisar cada diff vale a fricção.
Para mais detalhes, o Claude Code Overview da Anthropic é a fonte canônica a partir da qual a maioria dos conteúdos da comunidade se baseia. Se você quiser ampliar o que cobrimos aqui e praticar vários recursos do Claude Code, estes tutoriais valem a leitura:
Vários projetos open source também reúnem as práticas discutidas neste artigo em configurações prontas para uso:
obra/superpowers — um framework de skills componível que já traz enforcement de TDD, brainstorming socrático, planejamento granular e code review automático entre tarefas. Agora é um plugin oficial no marketplace da Anthropic.
github/spec-kit — toolkit oficial do GitHub para Spec-Driven Development. Estrutura o trabalho como Constituição → Especificar → Planejar → Tarefas, tornando o spec a fonte única da verdade em qualquer agente de código.
bmad-code-org/BMAD-METHOD — um framework ágil completo com 12+ personas de agentes (Arquiteto, QA, Scrum Master) e 34+ fluxos de trabalho cobrindo todo o ciclo de desenvolvimento.
wshobson/commands — 57 comandos de barra prontos para produção para você colocar em .claude/commands/, incluindo 15 fluxos de trabalho multiagente.
awesome-claude-code — o diretório de referência do ecossistema com skills, hooks, comandos, agentes e plugins. Comece por aqui para explorar o que existe.
Todo padrão deste artigo aponta para a mesma ideia: restrinja o Claude de forma agressiva antes da execução e dê a ele um jeito de verificar a própria saída. O planejamento elimina a ambiguidade. CLAUDE.md e hooks definem limites. Testes fornecem verificação. Higiene de contexto mantém tudo funcionando entre sessões.
Se for começar por uma mudança, escolha o Document & Clear. O custo do apodrecimento de contexto entre sessões é muito maior que os 20K tokens para recomeçar. Depois disso:
Adicione um hook de pre-commit que bloqueia commits quando os testes falham
Comece toda tarefa multi-arquivo com um plano antes de tocar no código
Mantenha seu CLAUDE.md abaixo de 100 instruções e use arquivos de subdiretório para regras específicas de domínio
Adicionamos recentemente uma nova trilha de habilidades sobre AI Engineering with LangChain. O conteúdo do curso é IA-nativo, para você aprender com um agente tutor pessoal ao seu lado. Recomendo conferir para se tornar fera em projetar fluxos de trabalho de IA.
Cursos de IA
Programa
Curso
Programa
blog
Abid Ali Awan
8 min
Tutorial
Abid Ali Awan
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min