
{count, plural, other {课程}}
Claude 模型入门
{hours} 小时
14.9K
几周前,我在所有项目中安装了 claude-mem。从那以后,它在 259 次会话中捕获了 6,814 条观察,覆盖十个不同的代码库,全部存放在我笔记本电脑上一个 39 MB 的 SQLite 文件中。
在此之前,每次 Claude Code 会话都从零开始。我会打开一个新会话,前十分钟都在重新解释项目结构。我们前一天一起修复的那个认证 bug?Claude 完全不知道。它会重新阅读已分析过的文件,然后得出我们已经纠正过的同样错误的假设。
claude-mem 是一个 Claude Code 插件,通过捕获会话中的发生并将其提供给未来的会话来解决这个问题。
本文将介绍其底层工作原理、如何规避常见坑完成安装、如何根据预算进行调优,以及在生产环境运行前需要了解的事项。
claude-mem 是一个Claude Code 插件,它:
~/.claude-mem/claude-mem.db它以插件形式运行,而不是MCP 服务器。
这个区别很重要:插件会在会话开始和每次工具调用等生命周期事件上自动触发,而 MCP 服务器会处于空闲状态,直到 Claude 决定调用它们。
采用 MCP 的做法,只有当 Claude 想到去检索时才会发生。claude-mem 无需 Claude 主动选择,就能捕获并注入。
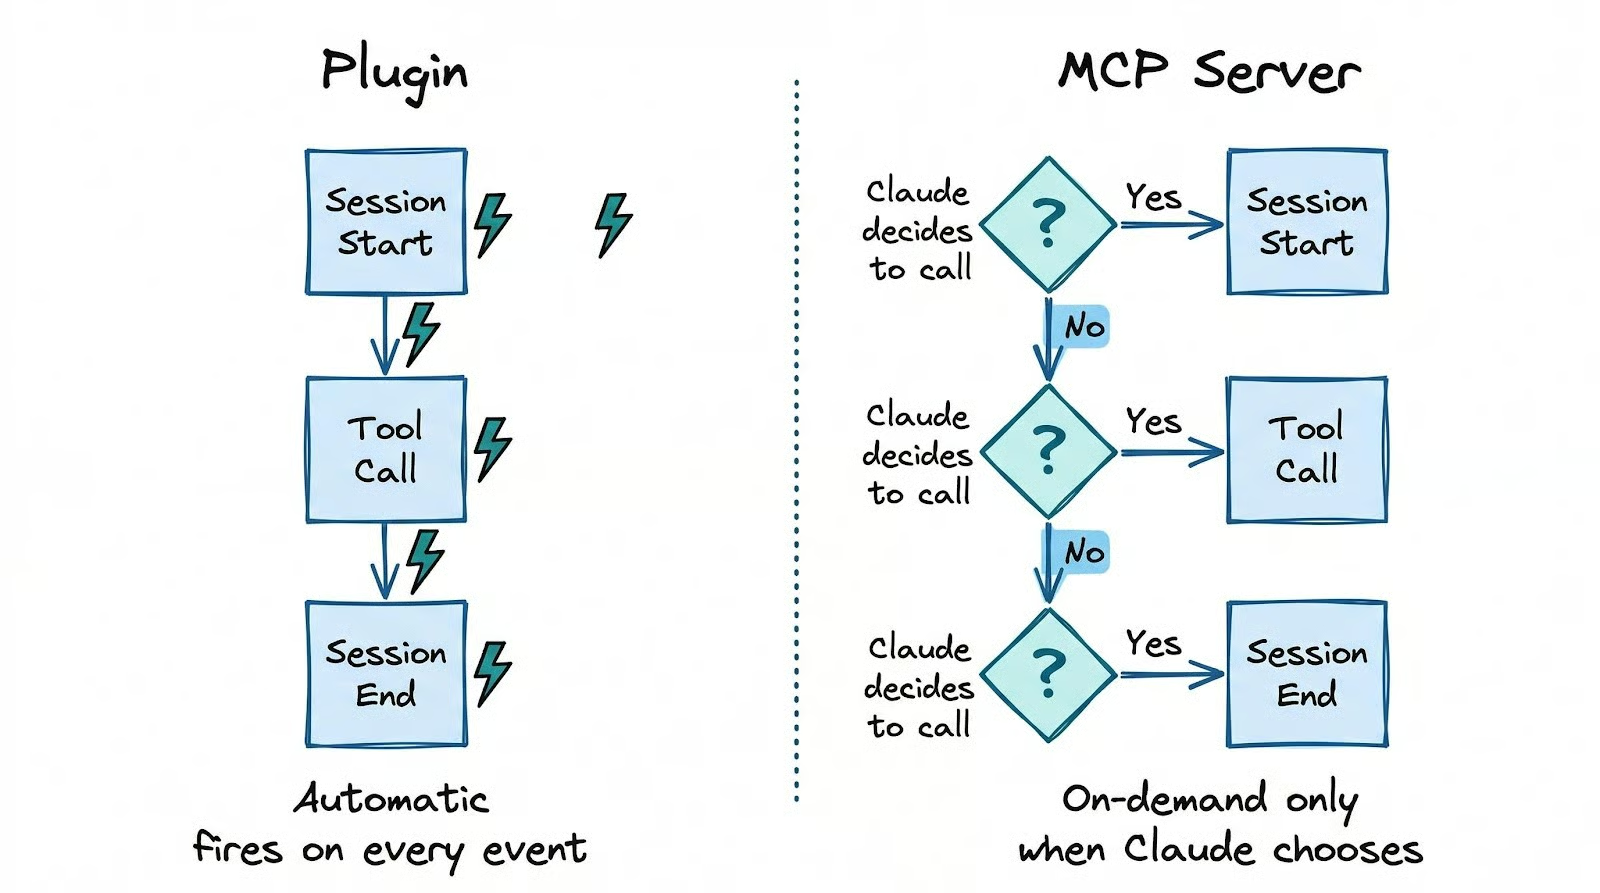
所有数据都留在您的机器上,压缩使用您现有的 Claude Code 认证,因此无需单独的 API 密钥或账户。
要让它跑起来,只需在 Claude Code 会话中执行两条命令:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
之后重启 Claude Code。
常见错误是改为运行 npm install -g claude-mem,这只会安装 SDK 库。Hooks(钩子)不会被注册,worker 不会启动,结果什么都不工作。
只有通过插件市场的路径才能获得完整安装。唯一硬性前置条件是 Node.js 18+。其余(Bun、uv、SQLite)会在首次运行时自动安装。
要验证安装是否真的成功,请检查三点。首先,curl http://localhost:37777/api/health 应返回 {"status":"ok"}。如果失败,说明后台 worker 没有启动。最常见的原因是 Node.js 版本低于 18。
其次,检查 ~/.claude/hooks.json 是否包含 claude-mem 条目。如果该文件未在 PostToolUse 和 SessionStart 下列出 claude-mem,说明钩子未注册,无论 worker 是否存活都不会进行捕获。
第三,在浏览器中打开 http://localhost:37777 查看 Web 查看器,它会在您工作时显示实时流入的观察。
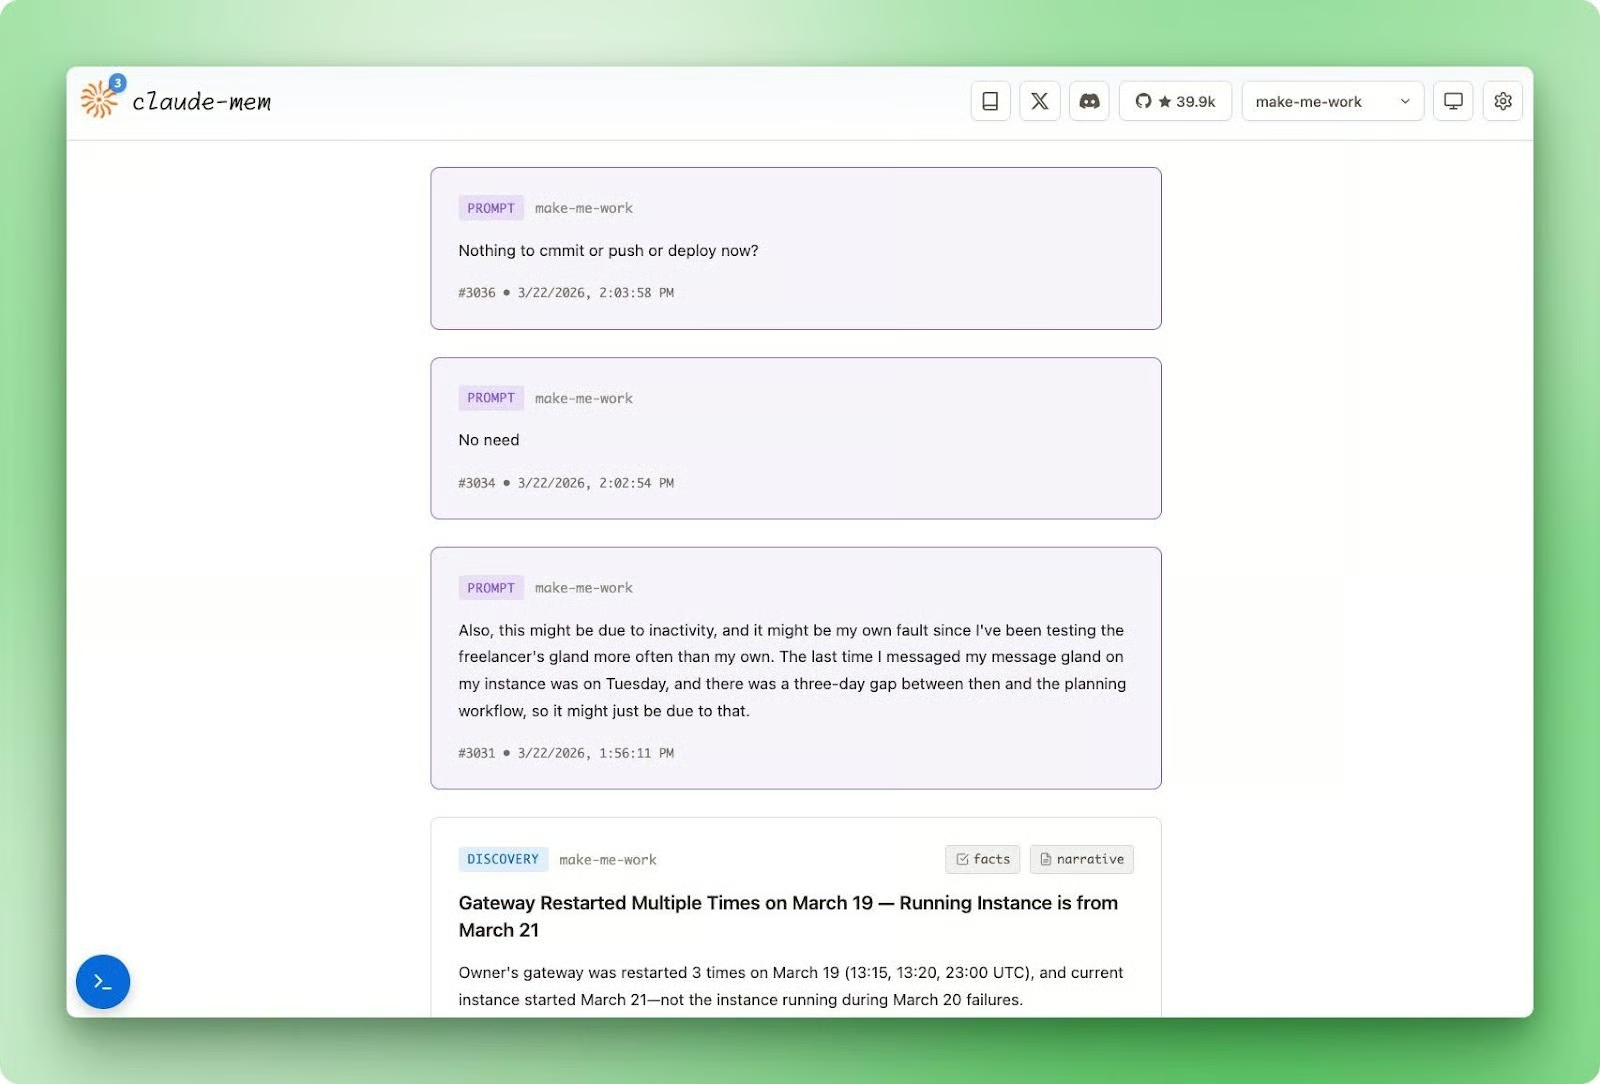
第一次会话在 SessionStart 不会注入上下文,因为数据库为空,但从第一次工具调用开始就会累积观察。
到第二次会话时,claude-mem 就会有会话摘要和一批待注入的观察。
先跑一遍这份验证清单,可以避免三次会话后才发现一直没有捕获任何内容。Web 查看器是最可靠的信号:如果您在工具调用后看到观察出现,就说明一切连接正确。
安装后,claude-mem 会在后台静默运行,覆盖五个生命周期钩子。理解每个钩子的作用,有助于解释该工具的行为方式。
这五个钩子映射到会话的自然时间线:
SessionStart 查询数据库,并将近期工作的压缩索引注入到您的上下文窗口UserPromptSubmit 记录会话并存储您的提示PostToolUse 在每次工具调用后触发,将原始输出通过非阻塞 HTTP POST(平均 8ms)发送给后台 worker 进行压缩Stop 当您暂停或空闲时生成会话级摘要SessionEnd 标记会话完成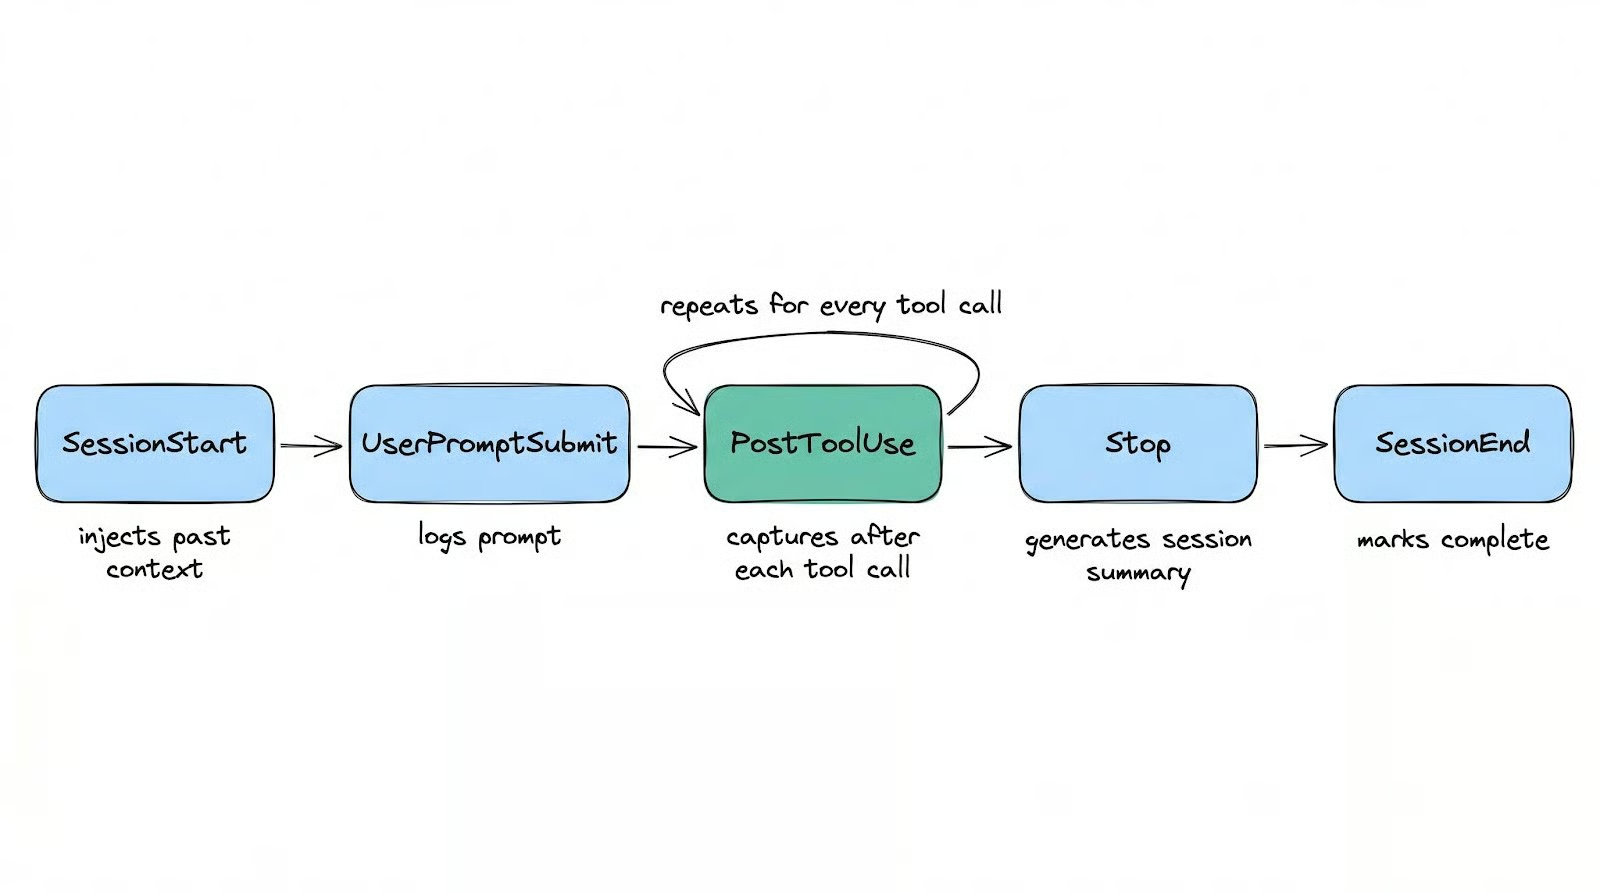
SessionStart 会用会话摘要、按类型分组的观察标题以及时间戳来构建被注入的索引:这是一个可搜索的近期工作地图,Claude 在整个会话中都可以引用,您无需额外操作。
PostToolUse 在每次工具调用后触发。它通过非阻塞 HTTP POST 将原始输出发送到后台 worker,worker 使用 Claude Agent SDK 将其压缩为结构化观察。
其结构如下所示:
|
字段 |
包含内容 |
|
|
以下之一: |
|
|
简明、可搜索的字符串 |
|
|
离散事实数组(约 50 个 token,加载便宜) |
|
|
说明性文本(约 155–500 个 token,仅按需加载) |
|
|
语义标签,如 how-it-works、problem-solution、gotcha、trade-off |
按调用捕获使 claude-mem 有别于那类在会话结束时用一次 AI 调用做总结的工具。
如果您的会话在重构中途崩溃,那些工具会丢失自上次完成会话以来的一切。claude-mem 则会保留到上一次工具调用为止的每条观察。
而 Stop 钩子会生成不同的内容:一个会话级摘要,包含 request、investigated、learned、completed 和 next_steps 等字段。它们让 Claude 在不加载每条观察的情况下获得高层次的事件地图。
存下成千上万条观察是一回事,把正确的内容在不烧 token 的前提下加载到上下文窗口是另一回事。
最天真的做法是把历史上下文一股脑塞进提示。claude-mem 的文档给出了量化:典型的天真加载会向上下文窗口发送 35,000 个 token,其中大约 2,000 个是相关的,信号率仅 6%。
一个三层检索系统能把这个比例提升到 80% 以上,让 Claude 通过 claude-mem 渐进式地加载上下文:
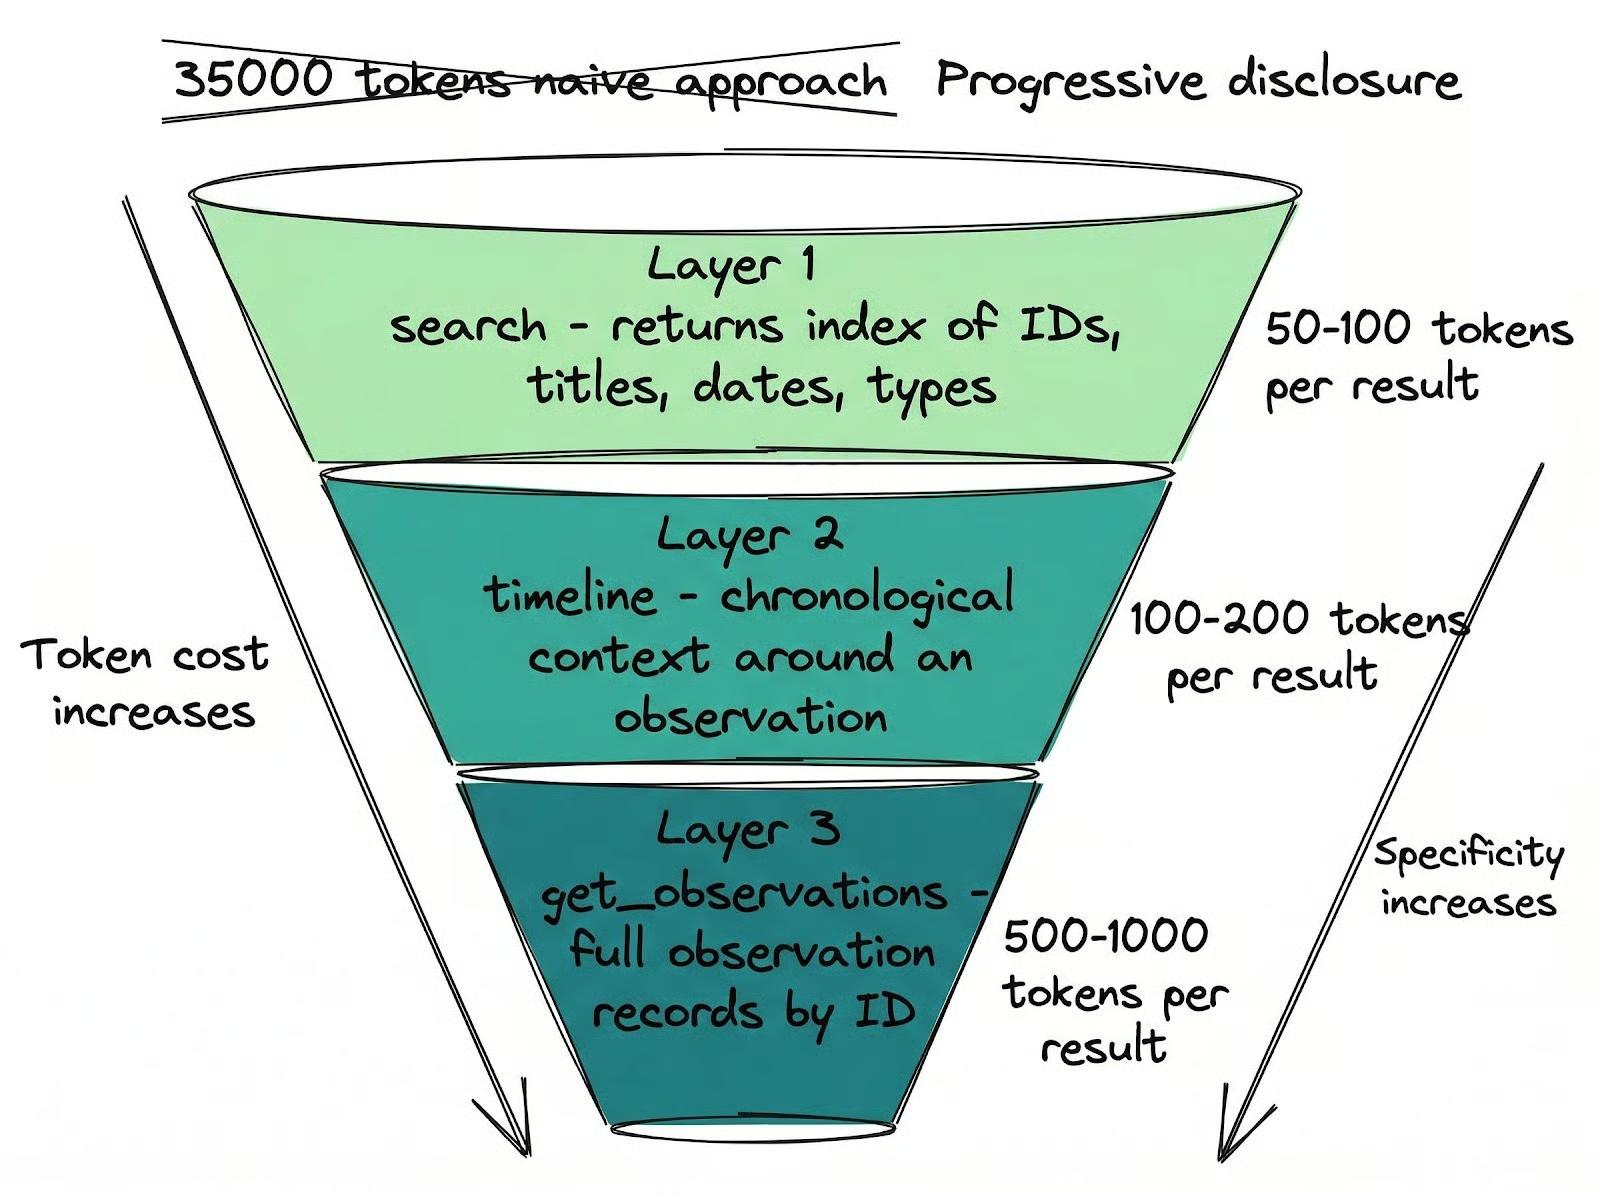
get_observations 按 ID 批量获取完整观察记录。成本:每条结果 500–1,000 个 token。只拉取真正需要的内容。这种检索规训并不会自我执行。
claude-mem 注册了一个名为 __IMPORTANT 的 MCP 工具,其唯一目的就是提醒 Claude 遵循这三步模式。
没有它,Claude 会跳过廉价层,直接抓取所有细节,等于推翻整个架构。为强制检索规训而不得不加入一个具名工具,这也如实反映了系统是如何围绕 Claude 的实际行为被设计出来的。
这些检索工具并不仅在会话开始时使用。
会话中,当您询问 Claude 以往工作的相关内容时,它会直接搜索记忆。
您可以让它分析跨会话的工作模式,找回您已遗忘的细节(“我把那个 API key 保存在哪里了?”,“我们当时怎么实现的认证流程?”),或者在几周未碰的项目上从中断处继续。
当您同时处理多个代码库和会话时,细节从您自己的记忆中流失得比想象中更快。claude-mem 通过让 Claude 访问所有发生过的事情来填补这个空白,哪怕是您本人已经忘掉的部分。
三周后,我的观察中有 61% 的类型是 discovery。Claude 更多地捕获它对代码库的认知,而不仅是它进行的更改。
在 259 次会话中,我有 1,729 条会话摘要,平均每次会话约 6–7 条。只有捕获持续进行、而非只在末尾进行,这种跨多会话的连续性才成为可能。
这就是“总结一次会话”和“真正记住它”的区别。
所有设置都可通过 http://localhost:37777 的 Web 界面“Settings”标签访问。您也可以通过环境变量设置,或直接编辑 ~/.claude-mem/settings.json。
首先需要了解的设置是 CLAUDE_MEM_MODEL,用于控制负责压缩的模型。默认是 haiku,这是 Claude 模型序列中最便宜的选项。
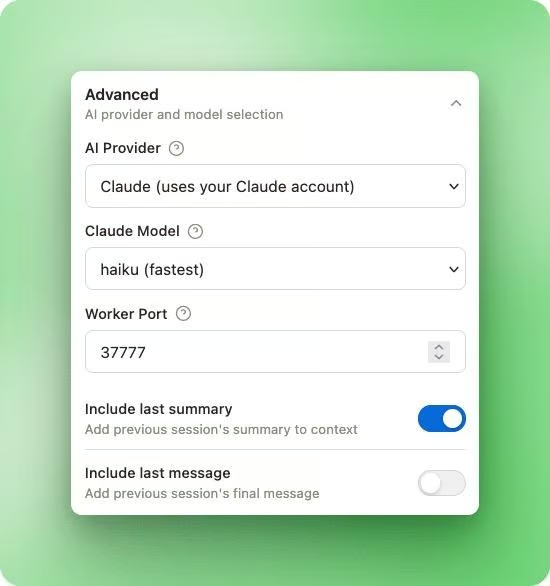
您也可以通过 CLAUDE_MEM_PROVIDER 完全切换压缩提供方,可选 claude、gemini 或 openrouter。
将压缩跑在 Gemini Flash Lite 或免费 OpenRouter 模型(如 xiaomi/mimo-v2-flash:free)上,可使额外成本降为零(不计您已有的 Claude Code 订阅)。
我自己使用 haiku,每次会话 30 条观察。按每次压缩约 400 个输入 token、150 个输出 token 计,总计约 16,500 个 token/会话。以 haiku 的价格,一个月的高强度使用成本远低于 1 美元。
三周、十个项目下来,压缩质量没有出现问题。
有两个设置控制会话开始时加载多少上下文:
CLAUDE_MEM_CONTEXT_OBSERVATIONS:在 SessionStart 注入的观察总数(默认 50,范围 1–200)CLAUDE_MEM_CONTEXT_FULL_COUNT:其中显示完整 narrative 字段的数量(默认 5,范围 0–20)其余仅显示标题、类型和日期。所有上下文注入都限定在您正在处理的项目目录内,因此其他项目的观察不会干扰您的上下文。
您可以通过 Web 界面按项目预览具体注入内容并调整这些数量。
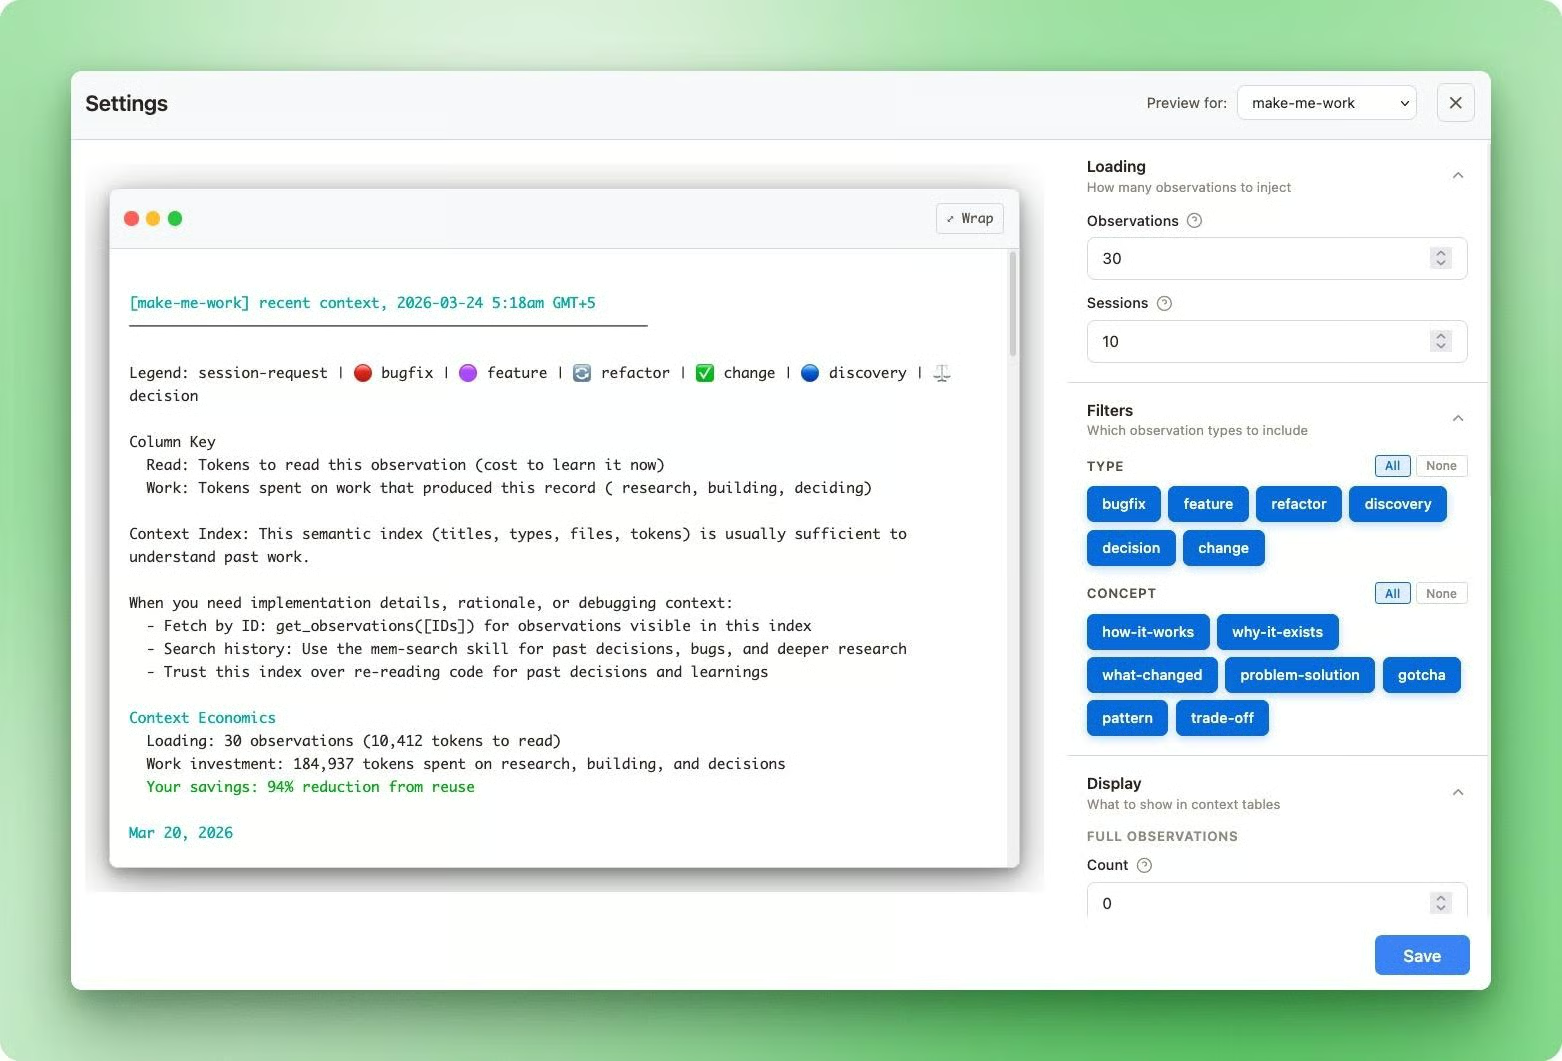
有一点值得预期:在新项目的第一周,您的上下文窗口可能比平时更快被填满。
我几乎在最初那段时间就卸载了 claude-mem,因为会话比以前更快触达上下文上限。
实际上是 claude-mem 在从零学习项目,记录大量新观察,并在会话开始时全部注入。
大约一周后,随着 Claude 已经映射了代码库,新发现的量下降,会话时长开始比安装插件前更长。
如果您遇到这种早期开销,暂时降低 CLAUDE_MEM_CONTEXT_OBSERVATIONS,等初始学习期结束后再调回。
CLAUDE_MEM_SKIP_TOOLS 允许将特定工具排除在捕获之外。
默认已跳过噪声较大的工具,如 TodoWrite、AskUserQuestion 和 BashTool。除非您有自定义工具产生不希望存储的输出,否则大概无需调整。它是逗号分隔列表,添加工具很直接。
如果您处理 API key 或凭据,请在提示中用 <private> 标签包裹它们,以将该内容排除在存储之外。
claude-mem 会在创建观察前剔除这些标签中的任何内容。
它不会主动扫描文件内容,因此从磁盘加载的环境变量不受影响,但您直接粘贴到提示中的任何内容则会受影响。使用 <private> 标签意味着保护是“主动选择加入”:您需要记得使用它。
Claude Code 已内置记忆功能,但都无法自动捕获上下文。
CLAUDE.md 文件是在会话开始时加载的静态 Markdown,适合项目规则与偏好,但约 200 行后遵循度就会下降。没有搜索、没有检索。您写下一次指令,只能指望 Claude 遵循。
Auto Memory(在 Claude Code v2.1.59 中新增)让 Claude 自行决定在会话间保存什么。它将非结构化笔记存放在 ~/.claude/projects/<project>/memory/,并在启动时加载 MEMORY.md 文件的前 200 行。
实践中,被保存的内容未必符合您的预期,且事后无法搜索或筛选。最终只是一份文本文件,记录的决定 Claude 也未必会理会。
内置选项还包括 /compact 命令,它会总结您的对话以腾出上下文空间。 CLAUDE.md 文件能幸存是因为会从磁盘重新读取,但其他一切都会消失:对话性指令、会话中段上下文、任何您说过但没写到某处的内容。
claude-mem 覆盖了上述方案的空白:自动、持续捕获,配合结构化压缩与关注 token 成本的检索。它也不是唯一做这件事的插件。
|
工具 |
架构 |
存储 |
搜索 |
捕获时机 |
定价 |
跨机器 |
团队记忆 |
|
Claude 内置 |
原生 |
本地 markdown |
无 |
手动 |
免费 |
通过 git 同步 |
通过共享 CLAUDE.md |
|
claude-mem |
插件(hooks) |
本地 SQLite + FTS5 |
FTS5 关键词 |
按工具调用 |
免费 |
否 |
否 |
|
memsearch |
插件(hooks + skill) |
本地 markdown + Milvus |
稠密向量 + BM25 混合 |
会话结束 |
免费 |
否 |
否 |
|
supermemory |
插件(hooks + 云) |
云端 |
语义 + 时间 |
会话结束 |
付费 |
是 |
是 |
|
mem0(自托管) |
MCP 服务器 |
本地 Qdrant + Ollama |
语义向量 |
会话结束 |
免费 |
否 |
否 |
memsearch 是最接近的免费替代方案,如果您想要用 markdown 文件而非数据库,并且不希望有后台进程运行。它在一个隔离的子代理中执行检索,因此搜索结果不会混入您的主上下文窗口。如果您偏好更简单的设置且不需要按调用捕获,可以选择它。
supermemory 适合需要跨机器同步与共享团队记忆的场景,但需要付费订阅。
自托管的mem0 技术栈则完全不同:使用 Qdrant 和 Neo4j 进行基于图的实体追踪,零额外成本,但部署更重,只有在您已运行相关基础设施时才值得。
claude-mem 处于中间位置。完全本地、免费、按调用捕获并进行结构化压缩。权衡是有一个监听 37777 端口的后台 worker 进程,以及一些尚未打磨平滑的边角。
安全性是最大的担忧。
一份2026 年 2 月的社区审计将风险评为“高”,相关问题仍未关闭。
37777 端口上的 HTTP API 没有任何认证:您机器上的任何进程都能读取所有存储的观察、查看您的设置(包括明文的任何 API 密钥),并向数据库注入任意记忆。
默认主机绑定是 0.0.0.0 而非 127.0.0.1,在云端 VM 或无防火墙的机器上意味着 API 将暴露到网络。
此外,smart_unfold 与 smart_outline 工具存在路径遍历漏洞,且没有目录边界检查。
仅在个人开发机器上运行它。
可靠性方面也有一些尖锐边角。
ChromaDB 集成存在已知的子进程泄漏:有用户追踪到 19 小时内产生 184 个孤儿进程,消耗约 16 GB 内存。
根因是损坏的 ONNX 模型触发了无限重试循环。建议改用 FTS5(SQLite 内置全文检索引擎),无需 ChromaDB,且据我经验一直稳定可靠。
在搭载 Apple Silicon 的 macOS 上,启用 ChromaDB 时 worker 冷启动可能超过硬编码的 5 秒超时,导致 SessionStart 钩子失败。仅 FTS5 的设置不受影响。另有一个活动中的 bug: search 与 timeline MCP 工具的参数模式为空,Claude 无法向它们传递查询。 get_observations 工作正常。
对于个人机器上的本地开发而言,这些问题并非致命。但在安装一个能访问您整个会话历史的工具前,了解这些问题很有价值。
三周之后,我最大的感受是有很多事情我不再做了。我不再在每次会话开始时重新解释项目结构。我不再重走我们已经走过的调试路径。Claude 带着上下文而来,我们从上次停下的地方继续。
这种效果得益于架构设计,而非更简单的替代做法。只在会话末尾捕获,意味着会话崩溃时会丢失一切。没有分层检索就倾倒历史,意味着把 token 花在噪音上。这里的设计是有意为之,理解它们有助于您“调教”工具,而非“盲信”工具。
上文提到的安全漏洞是真实存在且仍未修复的。这值得在个人开发机器上使用;在云端 VM 或共享机器上使用则不值得,除非这些问题被修补。对于本地的个人开发,这些权衡是可控的。
如果您想更深入,DataCamp 的《Introduction to Claude》是理解 Claude Code 工作原理并在其上叠加插件的扎实起点。
热门 DataCamp 课程
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}