Cursus
Introductie tot Claude-modellen
3 uur
14.6K
Een paar weken geleden heb ik claude-mem op al mijn projecten geïnstalleerd. Sindsdien heeft het 6.814 observaties vastgelegd over 259 sessies, verspreid over tien verschillende codebases, allemaal opgeslagen in een SQLite-bestand van 39 MB op mijn laptop.
Daarvóór begon elke Claude Code-sessie vanaf nul. Ik opende een nieuwe sessie en bracht de eerste tien minuten door met het opnieuw uitleggen van de projectstructuur. De authenticatiebug die we de dag ervoor samen hadden gefixt? Claude had geen idee. Het las bestanden opnieuw die al geanalyseerd waren en kwam vervolgens uit op dezelfde verkeerde aannames die we al hadden gecorrigeerd.
claude-mem is een Claude Code-plugin die dit oplost door vast te leggen wat er tijdens een sessie gebeurt en dat beschikbaar te maken voor toekomstige sessies.
In dit artikel laat ik zien hoe het onder de motorkap werkt, hoe je het installeert zonder in veelvoorkomende valkuilen te trappen, hoe je het afstemt op je budget en wat je moet weten voordat je het in productie draait.
claude-mem is een Claude Code-plugin die:
~/.claude-mem/claude-mem.dbHet draait als een plugin, niet als een MCP-server.
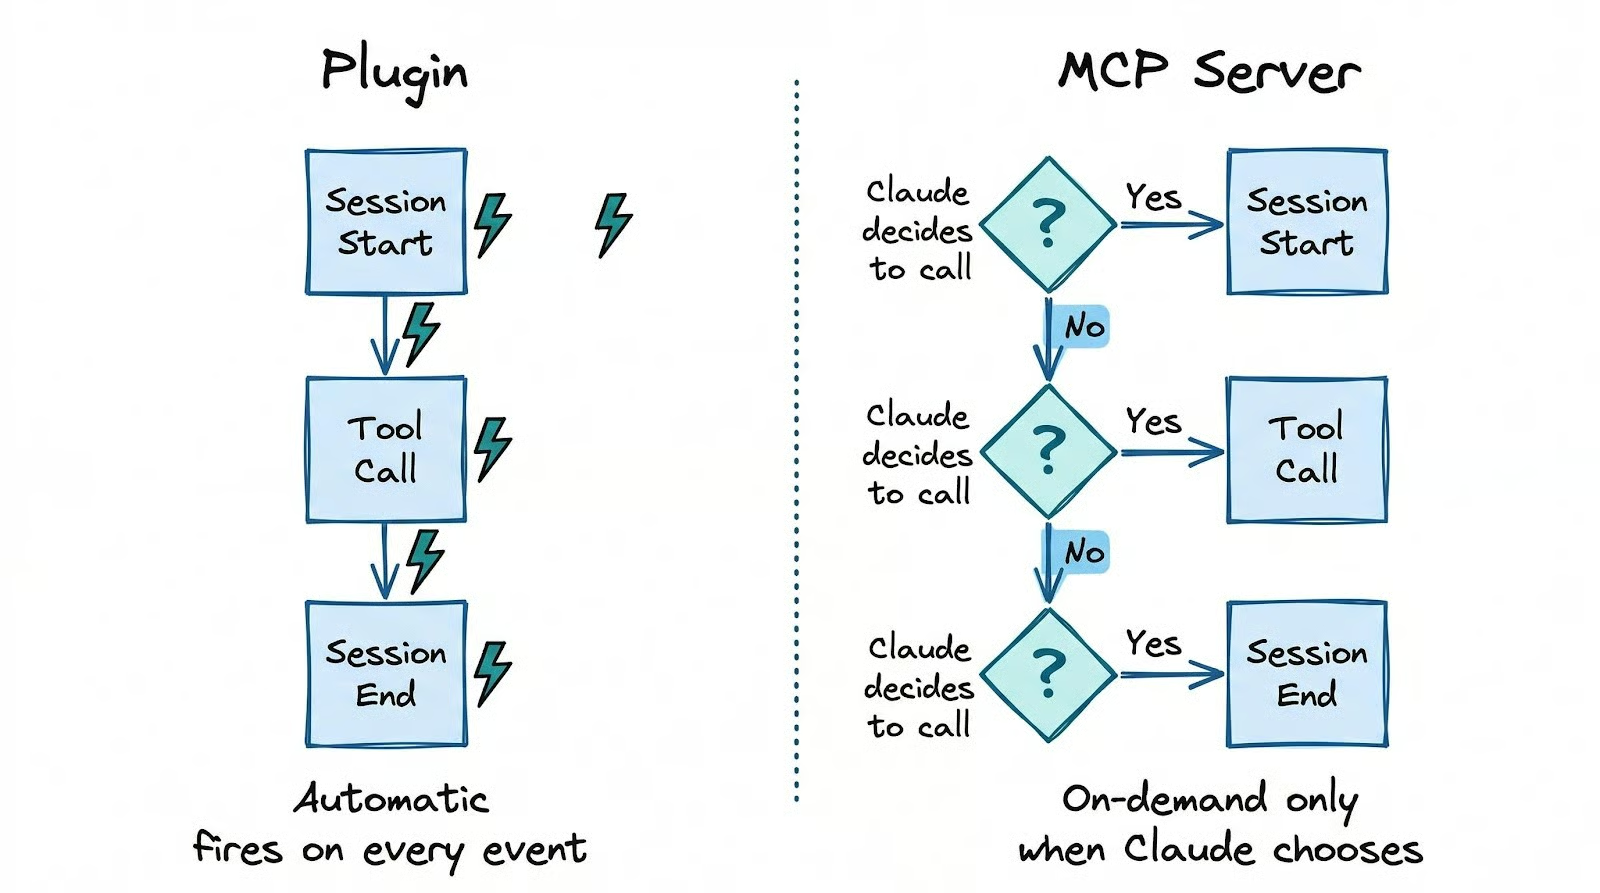
Dat onderscheid is belangrijk: plugins vuren automatisch op lifecycle-events zoals start van sessie en elke toolcall, terwijl MCP-servers niets doen totdat Claude besluit ze aan te roepen.
Met een MCP-aanpak gebeurt retrieval alleen wanneer Claude eraan denkt om erom te vragen. claude-mem legt vast en injecteert zonder dat Claude daarvoor hoeft te kiezen.
Alles blijft op je machine, en de compressie draait op je bestaande Claude Code-authenticatie, dus er is geen aparte API-sleutel of account nodig.
Het werkend krijgen kost twee commando's binnen een Claude Code-sessie:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Start daarna Claude Code opnieuw.
De veelgemaakte fout is in plaats daarvan npm install -g claude-mem draaien, wat alleen de SDK-bibliotheek installeert. Hooks worden niet geregistreerd, de worker start nooit en niets werkt.
Het pad via de pluginmarktplaats is de enige optie die je de volledige setup geeft. De enige harde vereiste is Node.js 18+. Alles daarbuiten (Bun, uv, SQLite) wordt bij de eerste run automatisch geïnstalleerd.
Om te verifiëren dat de installatie echt gelukt is, check je drie dingen. Ten eerste zou curl http://localhost:37777/api/health moeten teruggeven {"status":"ok"}. Als dat faalt, is de achtergrondworker niet gestart. De meest voorkomende oorzaak is een Node.js-versie lager dan 18.
Ten tweede, controleer of ~/.claude/hooks.json claude-mem vermeldt. Als het bestand claude-mem niet noemt onder PostToolUse en SessionStart, zijn de hooks niet geregistreerd, en zal er niets worden vastgelegd, ongeacht of de worker draait.
Ten derde, open http://localhost:37777 in een browser om de webviewer te zien, die observaties in real time toont terwijl je werkt.
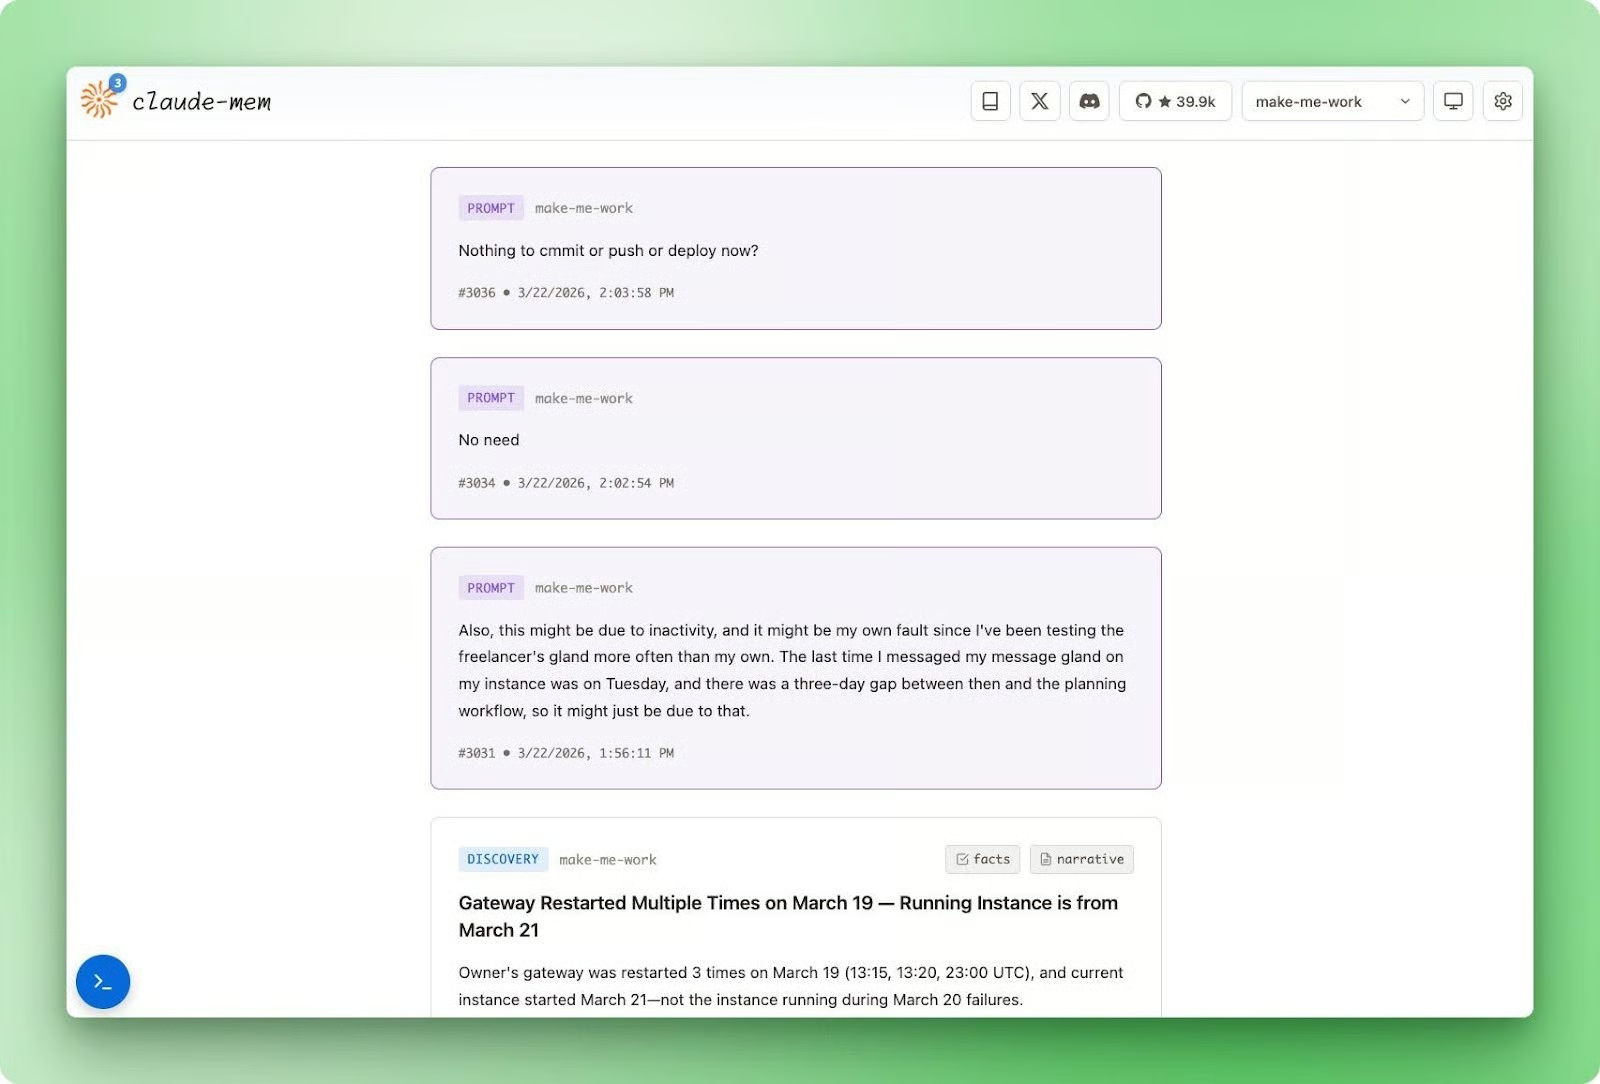
De eerste sessie levert geen geïnjecteerde context op bij SessionStart omdat de database leeg is, maar observaties beginnen zich op te bouwen vanaf de eerste toolcall.
Tegen de tweede sessie heeft claude-mem een sessiesamenvatting en een batch observaties om te injecteren.
De checklist vooraf doorlopen voorkomt dat je er na drie sessies achter komt dat er nooit iets is vastgelegd. De webviewer is het betrouwbaarste signaal: als je observaties ziet verschijnen na een toolcall, zit alles goed aangesloten.
Eenmaal geïnstalleerd draait claude-mem stilletjes op de achtergrond over vijf lifecycle-hooks. Begrijpen wat elke hook doet, verklaart waarom de tool zich gedraagt zoals hij doet.
De vijf hooks volgen de natuurlijke tijdlijn van een sessie:
SessionStart bevraagt de database en injecteert een gecomprimeerde index van recent werk in je contextvensterUserPromptSubmit logt de sessie en slaat je prompt opPostToolUse vuurt na elke toolcall en stuurt de ruwe output naar een achtergrondworker voor compressieStop genereert een sessie-overkoepelende samenvatting wanneer je pauzeert of idle bentSessionEnd markeert de sessie als voltooid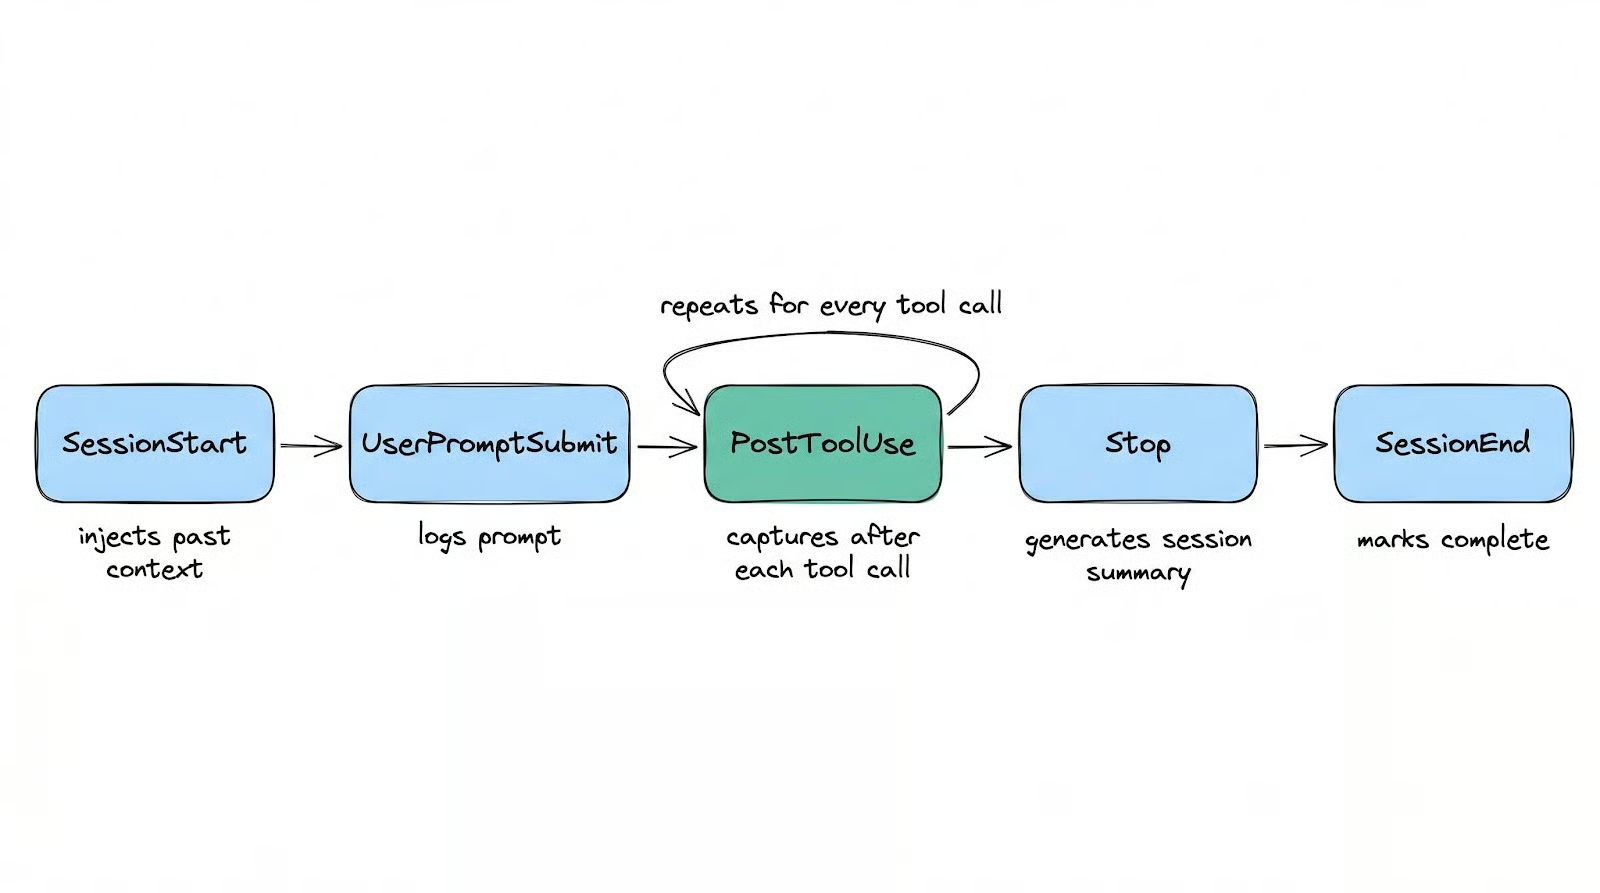
SessionStart bouwt die geïnjecteerde index op uit sessiesamenvattingen, observatietitels gegroepeerd op type en tijdstempels: een doorzoekbare kaart van recent werk waar Claude de hele sessie naar kan verwijzen zonder dat jij iets hoeft te doen.
PostToolUse vuurt na elke toolcall. Het stuurt de ruwe output naar een achtergrondworker via een niet-blokkerende HTTP POST (gemiddeld 8 ms), en de worker comprimeert dit tot een gestructureerde observatie met de Claude Agent SDK.
Zo ziet die structuur eruit:
|
Veld |
Wat het bevat |
|
|
Eén van |
|
|
Een bondige, doorzoekbare string |
|
|
Een array met afzonderlijke feiten (~50 tokens, goedkoop om te laden) |
|
|
Een prozauitleg (~155–500 tokens, alleen op aanvraag geladen) |
|
|
Semantische tags zoals how-it-works, problem-solution, gotcha, trade-off |
De vastlegging per call is wat claude-mem onderscheidt van tools die aan het einde van de sessie samenvatten met één AI-call.
Als je sessie crasht halverwege een refactor, verliezen die tools alles sinds de laatst voltooide sessie. claude-mem heeft elke observatie tot aan de laatste toolcall.
De Stop-hook levert iets anders op: een sessie-overkoepelende samenvatting met velden als request, investigated, learned, completed en next_steps. Die geven Claude een hoogover kaart van wat er is gebeurd zonder elke individuele observatie te hoeven laden.
Duizenden observaties opslaan is één ding. De juiste in een contextvenster laden zonder je tokens te verbranden is iets anders.
De naïeve aanpak is om historische context in de prompt te dumpen. De documentatie van claude-mem zet daar cijfers op: een typische naïeve load stuurt 35.000 tokens naar het contextvenster, waarvan er ongeveer 2.000 relevant blijken. Dat is 6% signaal.
Een drietraps retrievalsysteem duwt dat boven de 80% door Claude context stapsgewijs te laten laden via claude-mem:
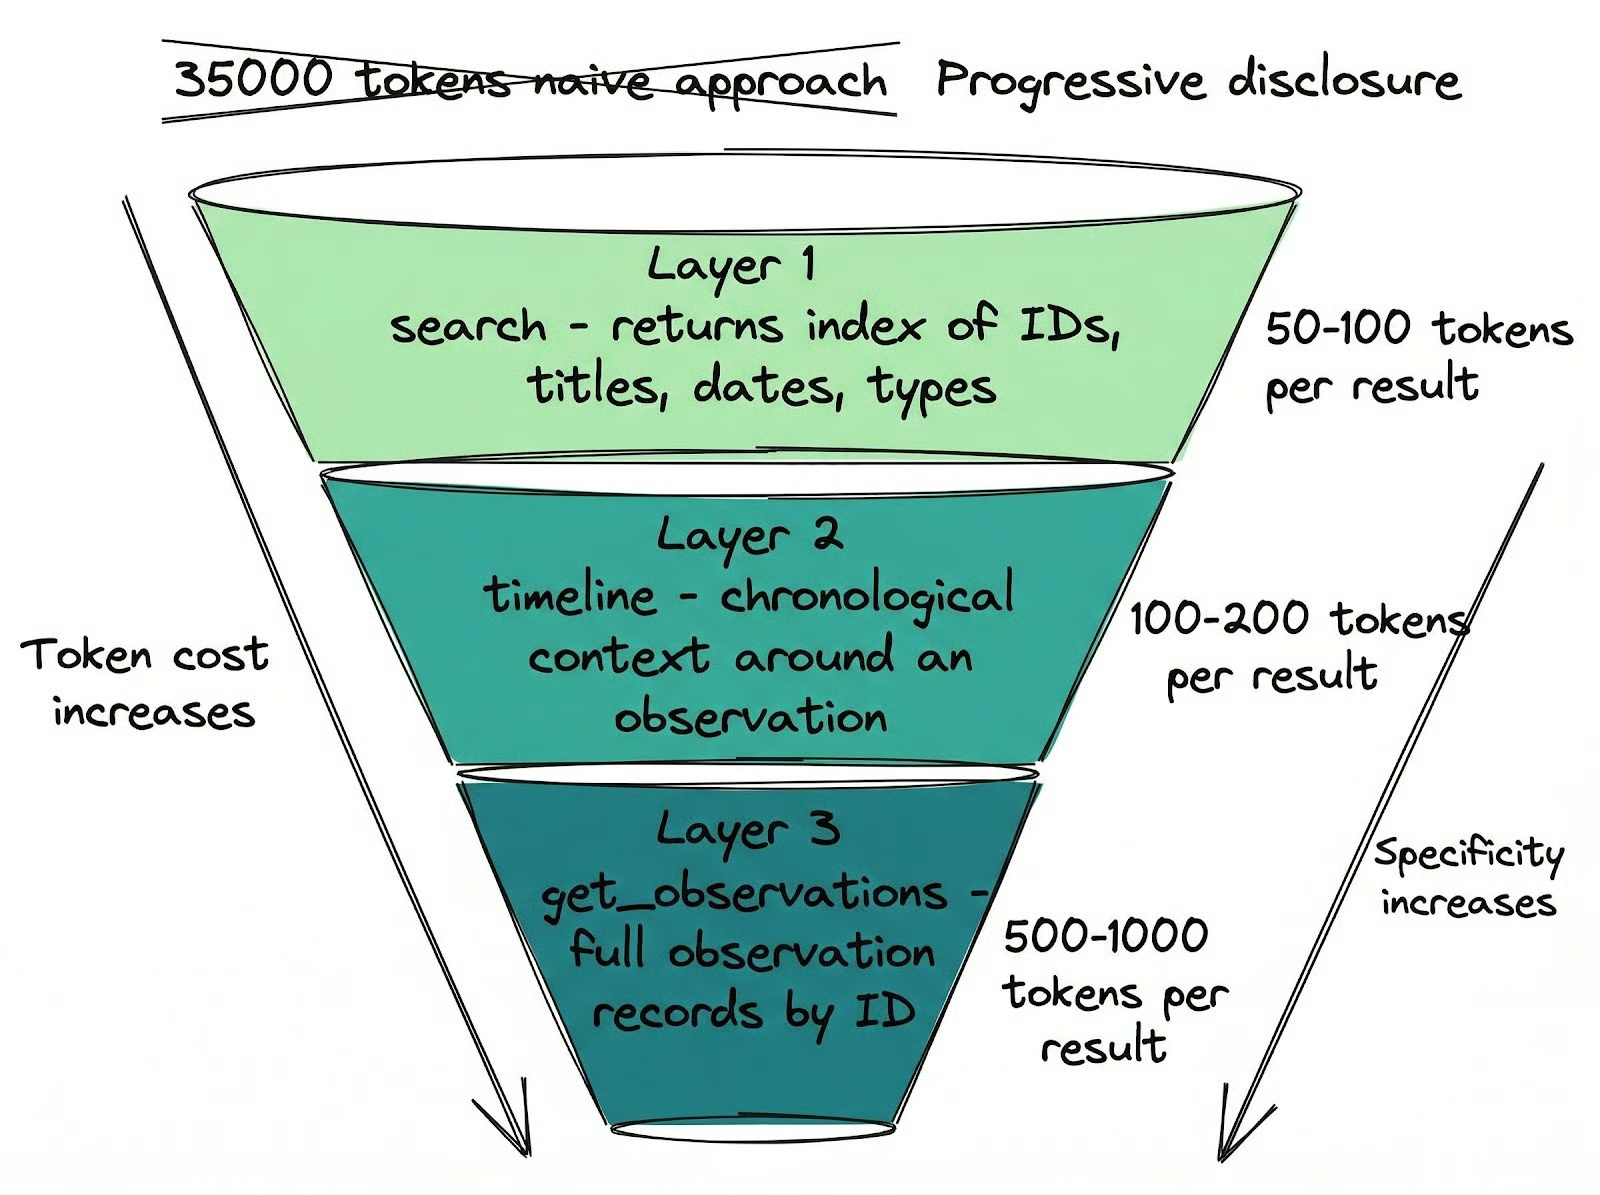
get_observations haalt volledige observatierecords per ID in batches op. Kosten: 500–1.000 tokens per resultaat. Haal alleen wat je echt nodig hebt.Die retrievaldiscipline handhaaft zichzelf niet.
claude-mem registreert een MCP-tool die letterlijk __IMPORTANT heet en maar één doel heeft: Claude eraan herinneren dit drietrapspatroon te volgen.
Zonder die tool slaat Claude de goedkope lagen over en haalt alles op in volledige detail, waarmee de hele architectuur onderuitgaat. Dat er een benoemde tool moest worden toegevoegd puur om retrievaldiscipline af te dwingen, geeft een realistisch beeld van hoe het systeem is ontworpen rond het daadwerkelijke gedrag van Claude.
Deze retrievaltools worden niet alleen bij de start van een sessie gebruikt.
Tijdens een sessie, wanneer je Claude iets vraagt over eerder werk, doorzoekt het direct het geheugen.
Je kunt het je werkpatronen over sessies laten analyseren, details terugvinden die je bent vergeten ("waar heb ik die API-sleutel opgeslagen?", "hoe hebben we de auth-flow geïmplementeerd?"), of verdergaan waar je gebleven was aan een project dat je al weken niet hebt aangeraakt.
Als je meerdere codebases en sessies tegelijk beheert, lekken details sneller uit je eigen geheugen dan je denkt. claude-mem vult dat gat door Claude toegang te geven tot alles wat er is gebeurd, zelfs de dingen die jij persoonlijk bent vergeten.
Na drie weken is 61% van mijn observaties getypeerd als discovery. Claude legt vooral vast wat het over een codebase leert, niet alleen de wijzigingen die het doorvoert.
Over 259 sessies heb ik 1.729 sessiesamenvattingen, gemiddeld zo'n 6–7 per sessie. Die continuïteit over meerdere sessies is alleen mogelijk omdat de vastlegging continu draait, niet alleen aan het einde.
Dat is het verschil tussen een sessie samenvatten en hem echt onthouden.
Alle instellingen van claude-mem zijn toegankelijk via de web-UI op http://localhost:37777 onder het tabblad Settings. Je kunt ze ook als omgevingsvariabelen zetten of ~/.claude-mem/settings.json direct bewerken.
De eerste instelling om te kennen is CLAUDE_MEM_MODEL, die bepaalt welk model de compressie afhandelt. De standaard is haiku, al de goedkoopste optie in Claude’s modellijn.
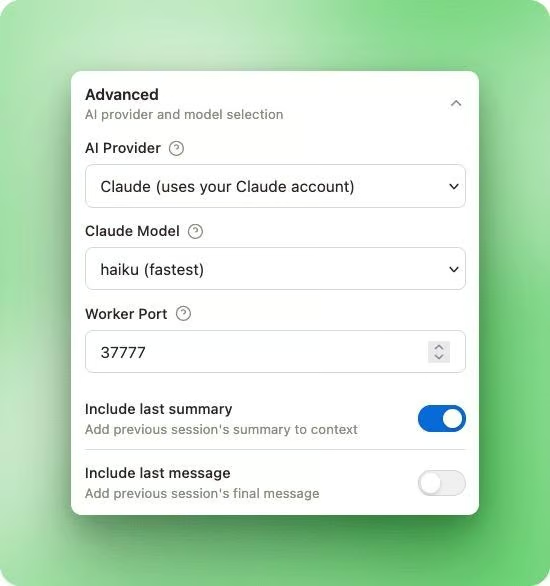
Je kunt de compressieprovider ook helemaal wisselen met CLAUDE_MEM_PROVIDER, dat claude, gemini of openrouter accepteert.
Compressie draaien op Gemini Flash Lite of een gratis OpenRouter-model zoals xiaomi/mimo-v2-flash:free brengt de kosten terug naar nul bovenop je bestaande Claude Code-abonnement.
Ik draai de mijne op haiku met 30 observaties per sessie. Bij ongeveer 400 inputtokens en 150 outputtokens per compressiecall komt dat neer op zo’n 16.500 tokens per sessie. Tegen haiku-tarieven kost een maand zwaar gebruik ruim onder een dollar.
Na drie weken over tien projecten is de kwaliteit van de compressie geen probleem geweest.
Twee instellingen bepalen hoeveel context er bij de start van een sessie wordt geladen:
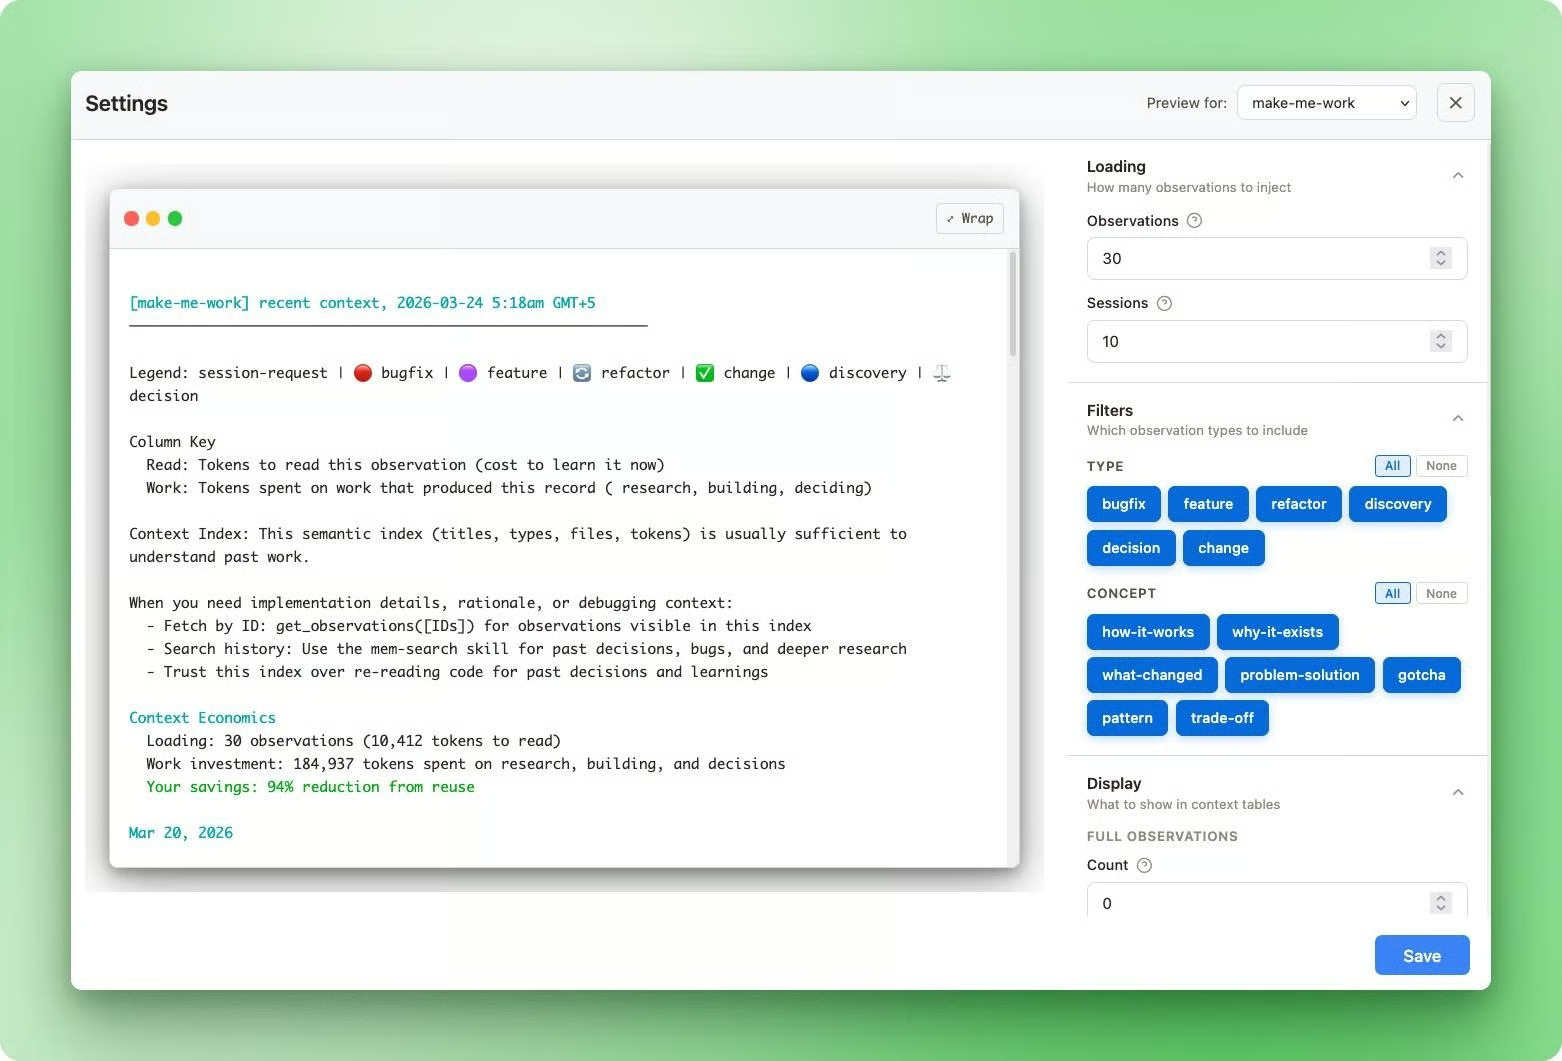
CLAUDE_MEM_CONTEXT_OBSERVATIONS: totaal aantal observaties dat bij SessionStart wordt geïnjecteerd (standaard 50, bereik 1–200)CLAUDE_MEM_CONTEXT_FULL_COUNT: hoeveel daarvan uitgebreide details tonen met het volledige narrative-veld (standaard 5, bereik 0–20)De rest toont alleen een titel, type en datum. Alle contextinjectie is gescopeerd op de projectmap waarin je werkt, zodat observaties van andere projecten je context niet vervuilen.
Je kunt precies bekijken wat er wordt geïnjecteerd en deze aantallen per project aanpassen via de web-UI.
Eén ding om op te rekenen: in de eerste week bij een nieuw project kan je contextvenster sneller vollopen dan normaal.
Ik overwoog bijna claude-mem te verwijderen in die beginperiode omdat sessies eerder de contextlimiet bereikten dan voorheen.
Wat er gebeurde, was dat claude-mem het project vanaf nul aan het leren was en een hoog volume aan nieuwe observaties vastlegde die allemaal bij de start van de sessie werden geïnjecteerd.
Na ongeveer een week daalde het volume aan nieuwe ontdekkingen omdat Claude de codebase al in kaart had, en sessies begonnen langer te duren dan vóórdat ik de plugin installeerde.
Als je tegen die vroege overhead aanloopt, verlaag CLAUDE_MEM_CONTEXT_OBSERVATIONS tijdelijk en verhoog het weer zodra de initiële leerperiode voorbij is.
CLAUDE_MEM_SKIP_TOOLS laat je specifieke tools uitsluiten van vastlegging.
De standaardinstellingen slaan al tools met veel ruis over zoals TodoWrite, AskUserQuestion en BashTool. Waarschijnlijk hoef je hier niets aan te passen, tenzij je een custom tool hebt die output genereert die je niet wilt opslaan. Het is een kommagescheiden lijst, dus tools toevoegen is eenvoudig.
Als je met API-sleutels of credentials werkt, zet ze dan in <private>-tags in je prompts om die inhoud uit te sluiten van opslag.
claude-mem stript alles binnen die tags voordat het een observatie aanmaakt.
Het scant bestandsinhoud niet proactief, dus omgevingsvariabelen die vanaf schijf worden geladen lopen geen risico, maar alles wat je direct in een prompt plakt wel. De <private>-tagbenadering betekent dat de bescherming opt-in is: je moet er zelf aan denken om die te gebruiken.
Claude Code wordt al geleverd met geheugenfeatures, maar geen daarvan legt context automatisch vast.
CLAUDE.md-bestanden zijn statische markdown die bij de start van de sessie wordt geladen, handig voor projectregels en voorkeuren, maar beperkt tot ongeveer 200 regels voordat de naleving afneemt. Geen zoekfunctie, geen retrieval. Je schrijft je instructies één keer en hoopt dat Claude zich eraan houdt.
Auto Memory, toegevoegd in Claude Code v2.1.59, maakt Claude zelf verantwoordelijk voor het beslissen wat er tussen sessies wordt bewaard. Het slaat ongestructureerde notities op in ~/.claude/projects/<project>/memory/ en laadt de eerste 200 regels van een MEMORY.md-bestand bij het opstarten.
In de praktijk komt wat wordt opgeslagen niet altijd overeen met wat jij zou willen, en er is geen manier om het achteraf te doorzoeken of te filteren. Je eindigt met een tekstbestand vol beslissingen waar Claude mogelijk wel of niet op let.
Het /compact-commando vult de ingebouwde opties aan door je gesprek samen te vatten om contextruimte vrij te maken. CLAUDE.md-bestanden overleven omdat ze opnieuw vanaf schijf worden gelezen, maar al het andere verdwijnt: conversatie-instructies, mid-sessiecontext, alles wat je zei maar nergens hebt opgeschreven.
claude-mem vult het gat dat geen van deze opties dekt: automatische, continue vastlegging met gestructureerde compressie en tokenbewuste retrieval. Het is ook niet de enige plugin die dit doet.
|
Tool |
Architectuur |
Opslag |
Zoeken |
Moment van vastleggen |
Prijs |
Cross-machine |
Teamgeheugen |
|
Claude ingebouwd |
Native |
Lokale markdown |
Geen |
Handmatig |
Gratis |
Via git-sync |
Via gedeelde CLAUDE.md |
|
claude-mem |
Plugin (hooks) |
Lokale SQLite + FTS5 |
FTS5-zoekwoorden |
Per toolcall |
Gratis |
Nee |
Nee |
|
memsearch |
Plugin (hooks + skill) |
Lokale markdown + Milvus |
Hybride dense + BM25 |
Einde van sessie |
Gratis |
Nee |
Nee |
|
supermemory |
Plugin (hooks + cloud) |
Cloud |
Semantisch + temporeel |
Einde van sessie |
Betaald |
Ja |
Ja |
|
mem0 (self-hosted) |
MCP-server |
Lokale Qdrant + Ollama |
Semantische vector |
Einde van sessie |
Gratis |
Nee |
Nee |
memsearch is het dichtstbijzijnde gratis alternatief als je markdownbestanden wilt in plaats van een database en geen achtergrondproces wilt draaien. Het voert retrieval uit in een geïsoleerde subagent, waardoor zoekresultaten nooit in je hoofdcontextvenster terechtkomen. Gebruik het als je een eenvoudigere setup verkiest en geen vastlegging per call nodig hebt.
supermemory is de juiste keuze als je cross-machine sync en gedeeld teamgeheugen nodig hebt, al is er een betaald abonnement vereist.
De self-hosted mem0-stack kiest een totaal andere benadering: Qdrant en Neo4j voor grafgebaseerde entiteitstracking, geen extra kosten, maar een zwaardere setup die pas de moeite waard is als je die infrastructuur al draait.
claude-mem zit daar tussenin. Volledig lokaal, gratis, vastlegging per call met gestructureerde compressie. Het compromis is een achtergrondworker op poort 37777 en enkele ruwe randjes die nog niet zijn gladgestreken.
Het beveiligingsplaatje is de grootste zorg.
Een community-audit in februari 2026 beoordeelde het risico als HOOG, en de issues staan nog open.
De HTTP-API op poort 37777 heeft nul authenticatie: elk proces op je machine kan elke opgeslagen observatie lezen, je instellingen bekijken (inclusief eventuele API-sleutels in platte tekst) en willekeurige herinneringen in de database injecteren.
De standaard hostbinding was 0.0.0.0 in plaats van 127.0.0.1, wat op cloud-VM’s of machines zonder firewall betekent dat de API aan het netwerk is blootgesteld.
De tools smart_unfold en smart_outline hebben bovendien een path traversal-kwetsbaarheid zonder directorygrenscontroles.
Draai dit alleen op een persoonlijke devmachine.
Ook qua betrouwbaarheid zijn er een paar scherpe randjes.
De ChromaDB-integratie heeft een bekende subprocess-lek: één gebruiker telde 184 verweesde processen in 19 uur, goed voor zo’n 16 GB RAM.
De worteloorzaak was een corrupt ONNX-model dat oneindige retryloops triggerde. Blijf bij FTS5 (de ingebouwde full-text search engine van SQLite), die zonder ChromaDB werkt en in mijn ervaring betrouwbaar is.
Op macOS met Apple Silicon kan de cold start van de worker de hardgecodeerde timeout van 5 seconden overschrijden wanneer ChromaDB is ingeschakeld, waardoor de SessionStart-hook faalt. Dit raakt FTS5-only setups niet. Er is ook een actieve bug waarbij de MCP-tools search en timeline lege parameterschema’s hebben, waardoor Claude er geen queries aan kan doorgeven. get_observations werkt prima.
Dit zijn geen showstoppers voor lokale ontwikkeling op een persoonlijke machine. Maar het is wel goed om te weten voordat je iets installeert dat toegang heeft tot je volledige sessiegeschiedenis.
Na drie weken merk ik vooral wat ik níet meer doe. Ik leg niet meer aan het begin van elke sessie de projectstructuur opnieuw uit. Ik herhaal niet meer het debugpad dat we al liepen. Claude komt binnen met context, en we gaan verder waar we gebleven waren.
De architectuur maakt dit mogelijk op een manier die eenvoudigere benaderingen niet doen. Één keer vastleggen aan het einde van de sessie betekent alles verliezen als een sessie crasht. Geschiedenis dumpen zonder retrievallagen betekent tokens besteden aan ruis. De ontwerpkeuzes hier zijn bewust, en ze kennen helpt je de tool te tunen in plaats van hem alleen te vertrouwen.
De hierboven genoemde beveiligingsgaten zijn reëel en nog open. Dit is de moeite waard op een persoonlijke devmachine. Het is het niet waard op een cloud-VM of gedeelde machine totdat die issues zijn gepatcht. Maar voor lokale solodevelopment zijn de trade-offs beheersbaar.
Wil je dieper duiken, dan is DataCamps Introduction to Claude een solide startpunt om te begrijpen hoe Claude Code werkt, vóór je er plugins bovenop zet.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus